Checklist audit SEO kỹ thuật: 16 bước chạy được với crawler
Một checklist SEO kỹ thuật thực tế, theo đúng thứ tự chúng tôi làm việc với một website. Mỗi bước cho biết cần kiểm tra gì, cách kiểm tra trong crawler, và mục kiểm tra nào của Neova đánh dấu nó.
Checklist nhìn nhanh
| # | Lĩnh vực | Đạt khi |
|---|---|---|
| 1 | robots.txt | Trả về 200, dưới 500 KiB |
| 2 | Tài nguyên bị chặn | 0 file CSS hoặc JS bị disallow |
| 3 | Noindex | Chỉ ở nơi có chủ ý |
| 4 | Canonical | Đích trả về 200, index được |
| 5 | Link hỏng | 0 URL nội bộ 4xx hoặc 5xx |
| 6 | Redirect | 1 bước nhảy, 301 hoặc 308 |
| 7 | HTTPS | 1 phiên bản trả về 200 |
| 8 | XML Sitemaps | Chỉ URL 200 có thể index |
| 9 | Độ sâu nhấp | Trang quan trọng ở độ sâu 3 trở xuống |
| 10 | Trang mồ côi | 0 trang index được |
| 11 | Trùng lặp | 1 URL cho mỗi trang |
| 12 | hreflang | Đủ mọi link trả về |
| 13 | Kết xuất | Nội dung chính trong HTML gốc |
| 14 | Tốc độ | LCP 2,5 giây, INP 200 ms, CLS 0,1 |
| 15 | Dữ liệu có cấu trúc | 0 lỗi cú pháp |
| 16 | Log và bot AI | Trang quan trọng được truy cập, 0 lần chặn |
Thứ tự rất quan trọng. Một trang không crawl được sẽ không được index, và một trang không được index thì chưa cần sửa schema. Hãy làm từ trên xuống.
Trước khi bắt đầu: thiết lập lần crawl audit
- Crawl toàn bộ website, hoặc một mẫu cho mỗi template. Trên website lớn, một mẫu cho mỗi nhóm trang tìm ra phần lớn các khuôn mẫu lỗi trong vài phút.
- Bật sitemap XML. Những trang có trong sitemap nhưng không link nào tới chỉ được tìm thấy theo cách này.
- Kết xuất một mẫu bằng JavaScript nếu website dùng framework JavaScript, để bước 13 có dữ liệu.
- Kết nối Google Search Console. Lượt nhấp và kết luận index của chính Google cho bạn biết phát hiện nào chạm tới những trang quan trọng.
- Giữ tốc độ lịch sự trừ khi website là của bạn.
Nếu bạn chưa từng chạy một lần crawl, hướng dẫn cách crawl một website nói về thiết lập, và hướng dẫn crawler SEO kỹ thuật nói về cách đọc kết quả. Để có một khung dài hơn với lập luận đằng sau từng mảng, xem khung checklist audit SEO kỹ thuật trên SEO ProCheck.
Khả năng crawl: robots.txt và tài nguyên bị chặn
- 1. robots.txt trả lời, đọc được và chỉ chặn những gì cần chặn. Tải nó về, đọc mọi quy tắc, và đối chiếu các quy tắc với URL đã crawl. Google đọc 500 KiB đầu của file và bỏ qua phần còn lại. Trong crawler, tìm các URL nội bộ bị robots.txt chặn và quyết định, từng mẫu một, xem việc chặn đó có chủ ý hay không. Công cụ kiểm tra robots.txt của Neova giải thích mọi dòng bằng lời lẽ đơn giản, đúng như Google mô tả, kèm các URL đã crawl mà mỗi quy tắc khớp, và có thể thử một bản nháp trước khi đưa lên. Mục kiểm tra: Không truy cập được robots.txt hoặc file quá lớn, URL nội bộ bị robots.txt disallow.
- 2. Trang dùng được script, style và ảnh mà nó cần. Nếu robots.txt chặn một file JavaScript hoặc CSS, công cụ tìm kiếm sẽ kết xuất trang mà không có nó. Trong crawler, crawl cả tài nguyên, rồi liệt kê các trang dùng file bị disallow. Mục kiểm tra: Trang HTML dùng file JavaScript bị robots.txt disallow.
Đặc tả robots.txt của Google có giới hạn 500 KiB và cách đọc từng mã trạng thái của file.
Khả năng index: noindex và canonical
- 3. Trang index được không mang noindex lạc chỗ. Một thẻ noindex còn sót từ staging là một trong những lý do phổ biến nhất khiến trang rơi khỏi chỉ mục. Kiểm tra thẻ meta robots và header X-Robots-Tag, và đảm bảo chúng thống nhất. Trong crawler, đọc danh sách trang noindex: mỗi trang nên có mặt ở đó một cách có chủ ý. Mục kiểm tra: Có chỉ thị noindex, Noindex khác nhau giữa HTML và HTTP header.
- 4. Canonical trỏ tới URL index được và trả về 200. Canonical là một gợi ý, và một gợi ý trỏ tới redirect, lỗi hay trang noindex là loại công cụ tìm kiếm thường bỏ qua. Trong crawler, xem cột canonical cạnh trạng thái của đích. Khi đã kết nối Search Console, tìm thêm các trang mà Google chọn canonical khác. Mục kiểm tra: Canonical trỏ tới URL bị redirect, Google chọn canonical khác với canonical đã khai báo.
Hướng dẫn của Google về hợp nhất URL trùng lặp giải thích cách canonical được cân nhắc.
Mã trạng thái, redirect và HTTPS
- 5. Không có internal link tới URL 4xx hoặc 5xx, và không có soft 404. Internal link hỏng lãng phí crawl và làm mất người dùng. Soft 404 khó tìm hơn: một trang ghi không tìm thấy nhưng trả về 200. Trong crawler, sắp xếp theo mã trạng thái, rồi mở inlink của từng lỗi để tìm link cần sửa. Với soft 404, tìm trong title và H1 các cụm từ không tìm thấy. Mục kiểm tra: URL nội bộ trả về 4xx, 5xx hoặc không phản hồi, Thẻ title hoặc H1 chứa cụm từ soft 404.
- 6. Không có chuỗi redirect, vòng lặp hay redirect tạm thời giữa các URL nội bộ. Mỗi bước nhảy tốn thời gian, Googlebot đi theo tối đa 10 bước, và một chuỗi kết thúc ở lỗi sẽ làm mất hẳn trang. Trong crawler, liệt kê mọi redirect với các bước nhảy và trạng thái cuối cùng, rồi cập nhật internal link để trỏ tới URL cuối cùng. Mục kiểm tra: URL nội bộ nằm trong chuỗi redirect, URL nội bộ dùng redirect tạm thời.
- 7. Một phiên bản của website trả về 200, qua HTTPS. http và https, có và không có www: ba trong bốn phiên bản nên redirect tới phiên bản thứ tư. Kiểm tra URL bắt đầu của Neova đọc website trước khi lần crawl bắt đầu và cho biết mỗi phiên bản làm gì. Mục kiểm tra: URL bắt đầu được phục vụ qua HTTP mà không redirect sang HTTPS.
Trang của Google về redirect và Google Search nói về nên dùng loại redirect nào, và FAQ về redirect và mã trạng thái HTTP trên SEO ProCheck trả lời các câu hỏi thường gặp.
Sitemap XML và hreflang
- 8. Sitemap XML liệt kê mọi trang index được, và không gì khác. Sitemap là cách website nói với công cụ tìm kiếm URL nào quan trọng. Một file chứa tối đa 50.000 URL và 50 MB khi chưa nén. Redirect, lỗi, trang noindex và URL đã canonical sang URL khác nằm trong đó sẽ gửi tín hiệu lẫn lộn, còn những trang index được bị thiếu thì rất dễ bị bỏ sót. Trong crawler, crawl sitemap sau khi crawl link, rồi so sánh hai danh sách theo cả hai chiều. Neova tải những trang chỉ có trong sitemap ở một bước riêng và đếm chúng riêng. Mục kiểm tra: URL index được không nằm trong sitemap XML nào, URL noindex nằm trong sitemap XML, URL có redirect nằm trong sitemap XML.
Xem tổng quan về sitemap của Google để biết định dạng và giới hạn.
- 12. Bộ hreflang đầy đủ và trỏ tới đúng URL. Mỗi trang trong một bộ nên liệt kê mọi phiên bản khác và chính nó, mỗi đích nên trả lại link, và mỗi đích nên là URL index được trả về 200. Mã ngôn ngữ và khu vực phải hợp lệ. Trong crawler, đọc hreflang từ phần head của HTML và HTTP Link header, rồi kiểm tra trạng thái và link trả về của từng đích. Mục kiểm tra: Thiếu link trả về của hreflang, Hreflang trỏ tới URL không trả về 200.
Hướng dẫn của Google về các phiên bản bản địa hóa của trang có quy tắc và ví dụ.
Cấu trúc website: độ sâu, trang mồ côi và trùng lặp
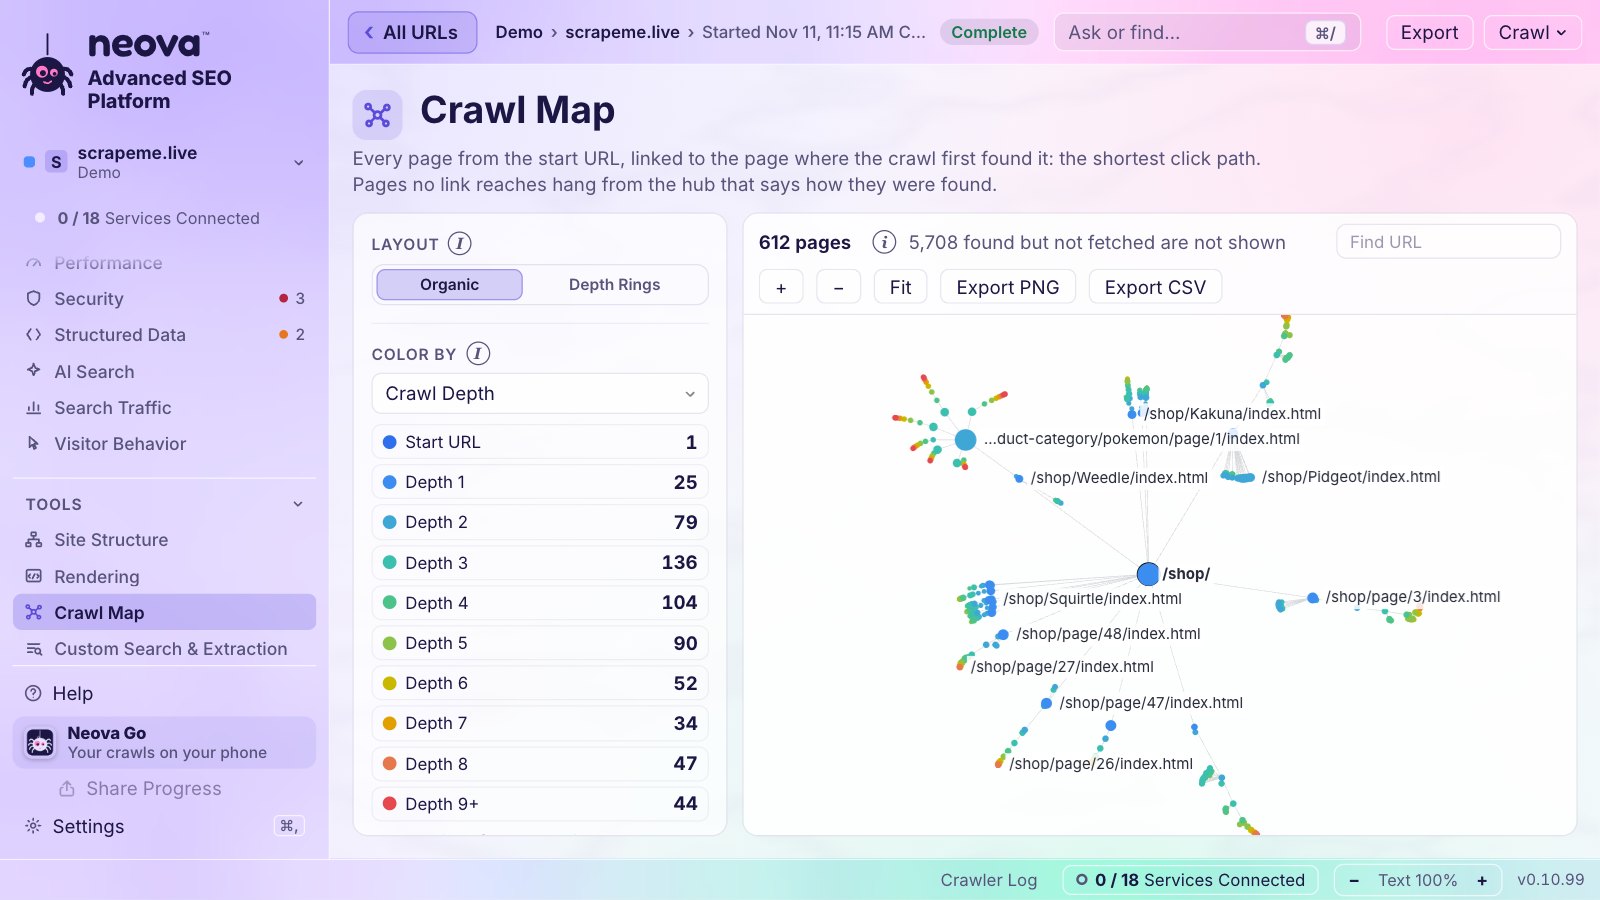
- 9. Trang quan trọng nằm cách trang chủ vài cú nhấp. Những trang nằm sâu trong cấu trúc được tìm thấy muộn hơn và được crawl ít hơn. Trong crawler, sắp xếp các trang index được theo độ sâu crawl và xem những gì nằm ở mức 4 trở lên. Neova đánh dấu các trang index được từ độ sâu 4. Mục kiểm tra: URL index được ở độ sâu crawl từ 4 trở lên.
- 10. Không có trang mồ côi và không có trang chỉ tới được qua ngõ cụt. Trang mồ côi là trang index được mà không internal link nào tới. Bạn tìm ra nó bằng cách so lần crawl với sitemap, log server hoặc Search Console. Tìm thêm cả những trang chỉ tới được qua redirect, canonical hoặc link nofollow. Mục kiểm tra: URL mồ côi trả về 200 và index được, URL chỉ tới được qua redirect.
- 11. Không có trang trùng lặp hay biến thể URL cạnh tranh nhau. Cùng một trang dưới hai kiểu chữ hoa thường, có và không có dấu gạch chéo cuối, hoặc với tham số theo thứ tự khác sẽ làm chia nhỏ tín hiệu. Trong crawler, so sánh HTML của các biến thể URL, rồi nhóm các trang có văn bản và title trùng lặp hoặc gần trùng lặp. Mục kiểm tra: Các biến thể URL trả về cùng một HTML, Nội dung gần trùng lặp giữa các trang HTML.
Trên website lớn, chính những vấn đề này quyết định bot dành lượt truy cập ở đâu; hướng dẫn crawl budget nói về khía cạnh đó.
Kết xuất, tốc độ và dữ liệu có cấu trúc
- 13. Title, link và nội dung chính nằm trong HTML gốc. Google kết xuất JavaScript, đôi khi rất lâu sau lần crawl, và nhiều crawler khác chỉ đọc HTML mà server gửi. Trong crawler, kết xuất một mẫu cho mỗi template và so trang đã kết xuất với HTML gốc. Neova đánh dấu mỗi trang là Kết xuất phía máy chủ, Đã hydrate hoặc Cần JavaScript. Mục kiểm tra: Phần lớn nội dung chính chỉ xuất hiện trong HTML đã kết xuất, Chỉ thị noindex bị JavaScript xóa. Hướng dẫn crawler SEO JavaScript đi sâu hơn.
- 14. Phản hồi server và Core Web Vitals ở mức tốt. Tốt nghĩa là LCP từ 2,5 giây trở xuống, INP từ 200 ms trở xuống và CLS từ 0,1 trở xuống. Trong crawler, chạy Lighthouse trên một trang cho mỗi template, và đọc Chrome UX Report để có dữ liệu người dùng thật. Neova làm cả hai, việc thứ hai với khóa Chrome UX Report của riêng bạn. Mục kiểm tra: Thời gian phản hồi của server chậm trong dữ liệu lab hoặc field, CLS vượt 0,1 trong dữ liệu lab hoặc field.
- 15. Dữ liệu có cấu trúc hợp lệ và khớp với trang. Markup có lỗi cú pháp sẽ bị bỏ qua, và markup không khớp với trang cũng là vấn đề. Trong crawler, xác thực schema trên mọi trang và so sánh nó trong từng template. Mục kiểm tra: Dữ liệu có cấu trúc có lỗi cú pháp, Dữ liệu có cấu trúc thiếu thuộc tính bắt buộc hoặc khác với văn bản hiển thị.
Để hiểu nền tảng, xem tài liệu của Google về Core Web Vitals và giới thiệu về dữ liệu có cấu trúc.
Log server và bot AI
- 16. Log cho thấy bot dành lượt truy cập cho đúng URL, và bot AI nhận được đúng những gì bạn muốn cho chúng. Lần crawl cho thấy website phục vụ gì. Log server cho thấy Googlebot, Bingbot và bot AI thực sự yêu cầu gì, và nhận lại gì. Chỉ tính một yêu cầu là Googlebot khi địa chỉ của nó được xác minh; chuỗi user agent rất dễ giả mạo. Sau đó tìm những trang quan trọng mà bot không bao giờ ghé, và những lượt bot truy cập rơi vào lỗi. Với bot AI, kiểm tra robots.txt cho phép từng bot tải gì, và server thực sự trả cho nó những gì, vì một quy tắc firewall hay CDN có thể chặn một crawler mà robots.txt cho phép. Mục kiểm tra: Tỷ lệ phản hồi 3xx, 4xx hoặc 5xx cho bot tìm kiếm đang tăng, Yêu cầu dùng user agent của bot tìm kiếm AI bị chặn.
Trong Neova, log server đến từ một file log Apache hoặc Nginx, hoặc từ chính tài khoản Cloudflare của bạn, và chỉ tính bot khi địa chỉ của chúng nằm trong danh sách mà mỗi công ty công bố. Chế độ xem Những gì mỗi trợ lý AI nhận được yêu cầu các trang mẫu dưới tên 10 agent AI và cho thấy ai được truy cập đầy đủ. Các hướng dẫn phân tích file log và bot AI nói sâu về cả hai, và Google giải thích cách xác minh Googlebot.
Checklist này trên chính website của chúng tôi
Chúng tôi chạy cùng danh sách này trên chính website của mình. Một lần crawl Neova đầy đủ seoprocheck.com ngày 17 tháng 10 năm 2026 đã tải 10.222 URL trong 61 phút, trong đó 4.561 là trang HTML trả về 200, với độ hoàn chỉnh 99,98%. Những gì nó đánh dấu:
| Mục đánh dấu | Số lượng |
|---|---|
| Meta description dài hơn 155 ký tự | 582 |
| Thẻ title dài hơn 60 ký tự | 557 |
| Title trùng lặp | 56 |
| Canonical trỏ tới URL nội bộ khác | 5 |
| Ảnh không có alt text | 2 |
Lượt rà soát SEO trên neova.app của chúng tôi ngày 20 tháng 11 năm 2026 tìm ra năm điều mà checklist bao quát, tất cả đều được sửa trong cùng ngày:
| Bước | Trước | Sau |
|---|---|---|
| 7. Phiên bản http:// | 200 | 301 sang https |
| 5. Địa chỉ không tồn tại | 503 | 404 |
| 1. Script email của Cloudflare | Bị chặn trên 1.320 trang | Được phép |
| 1. File favicon | Nằm sau Disallow: / | Được phép |
| Meta description | Một số dài hơn 160 | Từ 160 trở xuống, 1.354 trang |
Lỗi favicon hiện rõ trên Google: khi các file bị chặn, một chữ cái đơn giản hiện cạnh neova.app thay vì logo. 1.358 URL trong sitemap của website ở 15 ngôn ngữ đã vượt qua bước hreflang với đủ mọi link trả về.
Khi đã đi hết danh sách, hãy sửa, rồi crawl lại. Xác minh sửa lỗi của Neova chỉ tải lại những URL mà một mục kiểm tra đã đánh dấu và cho biết bao nhiêu URL đã được sửa, còn So sánh các lần crawl cho thấy những gì đã thay đổi giữa hai lần crawl. Neova chạy 694 mục kiểm tra; tải Neova để chạy chúng trên website của bạn.

Câu hỏi
Checklist audit SEO kỹ thuật là gì?
Một danh sách những yếu tố quyết định công cụ tìm kiếm có crawl, kết xuất và index được một website hay không, được làm theo một thứ tự cố định. Làm theo cùng một cách mỗi lần biến bản audit thành một quy trình thường lệ.
Các bước của một bản audit SEO kỹ thuật là gì?
Crawl website cùng sitemap XML, rồi kiểm tra khả năng crawl, khả năng index, mã trạng thái và redirect, sitemap, cấu trúc website và trùng lặp, thẻ quốc tế, kết xuất, tốc độ và dữ liệu có cấu trúc, và cuối cùng là log server. Sửa trước những vấn đề chạm tới nhiều trang index được nhất, rồi crawl lại.
Tôi nên audit SEO kỹ thuật bao lâu một lần?
Một bản audit đầy đủ mỗi năm một hoặc hai lần, và một lần crawl nhẹ hơn sau mỗi lần phát hành quan trọng. Website thay đổi thường xuyên sẽ có lợi từ lần crawl theo lịch hằng tuần được so với lần trước.
Tôi có thể chạy checklist này với công cụ miễn phí không?
Với website nhỏ thì có. Gói Free của Neova crawl tối đa 1.000 URL mỗi lần crawl với mọi mục kiểm tra, kết xuất JavaScript và Search Console. Log server và ảnh chụp Core Web Vitals có trong các gói trả phí. Xem hướng dẫn SEO crawler miễn phí để biết các lựa chọn khác.
Tôi có cần log server cho một bản audit SEO kỹ thuật không?
Không cần để bắt đầu. Một lần crawl bao quát phần lớn checklist. Log bổ sung những gì bot thực sự đã làm, điều quan trọng nhất trên website lớn và khi các trang chậm được index.