Checklist Audit SEO Teknis: 16 Langkah yang Bisa Dijalankan dengan Crawler
Checklist SEO teknis yang praktis, sesuai urutan kami menelusuri sebuah situs. Setiap langkah menjelaskan apa yang dicek, cara mengeceknya di crawler, dan pemeriksaan Neova mana yang menandainya.
Checklist Sekilas
| # | Area | Lolos jika |
|---|---|---|
| 1 | robots.txt | Menjawab 200, di bawah 500 KiB |
| 2 | Resource yang diblokir | 0 CSS atau JS yang di-disallow |
| 3 | Noindex | Hanya jika disengaja |
| 4 | Canonical | Target menjawab 200, dapat diindeks |
| 5 | Link rusak | 0 internal 4xx atau 5xx |
| 6 | Redirect | 1 lompatan, 301 atau 308 |
| 7 | HTTPS | 1 versi menjawab 200 |
| 8 | Sitemap XML | Hanya URL 200 yang bisa diindeks |
| 9 | Kedalaman klik | Halaman penting di kedalaman 3 atau kurang |
| 10 | Orphan | 0 yang dapat diindeks |
| 11 | Duplikat | 1 URL per halaman |
| 12 | hreflang | Semua link balik ada |
| 13 | Rendering | Teks utama di HTML mentah |
| 14 | Kecepatan | LCP 2,5 detik, INP 200 ms, CLS 0,1 |
| 15 | Structured data | 0 error sintaks |
| 16 | Log dan bot AI | Halaman penting dikunjungi, 0 blokir |
Urutannya penting. Halaman yang tidak bisa di-crawl tidak akan diindeks, dan halaman yang tidak diindeks belum perlu diperbaiki schema-nya. Kerjakan dari atas.
Sebelum Mulai: Siapkan Crawl Audit
- Crawl seluruh situs, atau sampel per template. Di situs besar, sampel per grup halaman menemukan sebagian besar pola dalam hitungan menit.
- Aktifkan XML Sitemap. Halaman yang tercantum di sitemap tetapi tidak dijangkau link hanya bisa ditemukan dengan cara ini.
- Render sampel dengan JavaScript jika situs memakai framework JavaScript, agar langkah 13 punya data.
- Hubungkan Google Search Console. Klik dan putusan indeks dari Google sendiri memberi tahu temuan mana yang menyentuh halaman penting.
- Jaga kecepatan tetap sopan kecuali situsnya milik Anda.
Jika Anda belum pernah menjalankan crawl, panduan cara crawl website membahas setup-nya, dan panduan crawler SEO teknis membahas cara membaca hasilnya. Untuk kerangka yang lebih panjang dengan alasan di balik setiap area, lihat kerangka checklist audit SEO teknis di SEO ProCheck.
Crawlability: robots.txt dan Resource yang Diblokir
- 1. robots.txt menjawab, bisa diurai, dan hanya memblokir yang seharusnya. Ambil file-nya, baca setiap aturan, dan cocokkan aturannya dengan URL yang di-crawl. Google membaca 500 KiB pertama file itu dan mengabaikan sisanya. Di crawler, cari URL internal yang diblokir robots.txt dan putuskan, satu pola demi satu pola, apakah pemblokiran itu disengaja. Penguji robots.txt di Neova menjelaskan setiap baris dengan bahasa sederhana, sesuai dokumentasi Google, beserta URL hasil crawl yang cocok dengan setiap aturan, dan bisa menguji draf sebelum dirilis. Pemeriksaan: robots.txt tidak dapat dijangkau atau terlalu besar, URL internal di-disallow oleh robots.txt.
- 2. Halaman bisa memakai skrip, style, dan gambar yang dibutuhkannya. Jika robots.txt memblokir file JavaScript atau CSS, mesin pencari merender halaman tanpa file itu. Di crawler, crawl juga resource-nya, lalu buat daftar halaman yang memakai file yang di-disallow. Pemeriksaan: Halaman HTML memakai file JavaScript yang di-disallow robots.txt.
Spesifikasi robots.txt dari Google memuat batas 500 KiB dan cara membaca setiap status code file tersebut.
Indexability: Noindex dan Canonical
- 3. Halaman yang dapat diindeks tidak membawa noindex nyasar. Noindex sisa dari staging adalah salah satu alasan paling umum halaman keluar dari indeks. Cek tag meta robots dan header X-Robots-Tag, dan pastikan keduanya sejalan. Di crawler, baca daftar halaman noindex: masing-masing harus ada di sana dengan sengaja. Pemeriksaan: Direktif noindex ada, Noindex berbeda antara HTML dan header HTTP.
- 4. Canonical mengarah ke URL yang dapat diindeks dan menjawab 200. Canonical adalah petunjuk, dan petunjuk yang mengarah ke redirect, error, atau halaman noindex cenderung diabaikan mesin pencari. Di crawler, lihat kolom canonical di samping status targetnya. Dengan Search Console terhubung, cari juga halaman yang canonical-nya dipilih lain oleh Google. Pemeriksaan: Canonical mengarah ke URL yang di-redirect, Google memilih canonical yang berbeda dari yang dideklarasikan.
Panduan Google tentang menggabungkan URL duplikat menjelaskan bagaimana canonical dipertimbangkan.
Status Code, Redirect, dan HTTPS
- 5. Tidak ada link internal ke URL 4xx atau 5xx, dan tidak ada soft 404. Link internal rusak membuang crawl dan kehilangan pengunjung. Soft 404 lebih sulit ditemukan: halaman yang menyebut not found tetapi menjawab 200. Di crawler, urutkan berdasarkan status code, lalu buka inlink setiap error untuk menemukan link yang perlu diperbaiki. Untuk soft 404, cari frasa not found di title dan H1. Pemeriksaan: URL internal mengembalikan 4xx, 5xx, atau tidak merespons, Title atau H1 memuat frasa soft 404.
- 6. Tidak ada rantai redirect, loop, atau redirect sementara antar-URL internal. Setiap lompatan memakan waktu, Googlebot mengikuti paling banyak 10, dan rantai yang berakhir di error membuat halaman hilang sepenuhnya. Di crawler, buat daftar setiap redirect beserta lompatan dan status akhirnya, lalu perbarui link internal agar mengarah ke URL final. Pemeriksaan: URL internal berada dalam rantai redirect, URL internal memakai redirect sementara.
- 7. Satu versi situs menjawab 200, melalui HTTPS. http dan https, dengan dan tanpa www: tiga dari empat seharusnya redirect ke yang keempat. Pemeriksaan URL Awal di Neova membaca situs sebelum crawl dimulai dan menjelaskan apa yang dilakukan setiap versi. Pemeriksaan: URL awal disajikan melalui HTTP tanpa redirect ke HTTPS.
Halaman Google tentang redirect dan Google Search membahas redirect mana yang dipakai, dan FAQ redirect dan HTTP status code di SEO ProCheck menjawab pertanyaan umumnya.
XML Sitemap dan hreflang
- 8. XML Sitemap mencantumkan setiap halaman yang dapat diindeks, dan tidak ada yang lain. Sitemap adalah cara situs memberi tahu mesin pencari URL mana yang penting. Satu file berisi paling banyak 50.000 URL dan 50 MB tanpa kompresi. Redirect, error, halaman noindex, dan URL yang di-canonical-kan di dalamnya mengirim sinyal campur aduk, dan halaman dapat diindeks yang tidak tercantum mudah terlewat. Di crawler, crawl sitemap setelah link, lalu bandingkan kedua daftar dari dua arah. Neova mengambil halaman yang hanya tercantum di sitemap sebagai langkah terpisah dan menghitungnya tersendiri. Pemeriksaan: URL yang dapat diindeks tidak ada di sitemap XML mana pun, URL noindex tercantum di sitemap XML, URL yang di-redirect tercantum di sitemap XML.
Lihat ringkasan sitemap dari Google untuk format dan batasnya.
- 12. Set hreflang lengkap dan mengarah ke URL yang benar. Setiap halaman dalam satu set harus mencantumkan semua versi lain dan dirinya sendiri, setiap target harus membalas link-nya, dan setiap target harus berupa URL dapat diindeks yang menjawab 200. Kode bahasa dan wilayah harus valid. Di crawler, baca hreflang dari head HTML dan header HTTP Link, lalu cek status setiap target dan link baliknya. Pemeriksaan: Link balik hreflang tidak ada, Hreflang mengarah ke URL non-200.
Panduan Google tentang versi halaman yang dilokalkan memuat aturan dan contohnya.
Struktur Situs: Kedalaman, Orphan, dan Duplikat
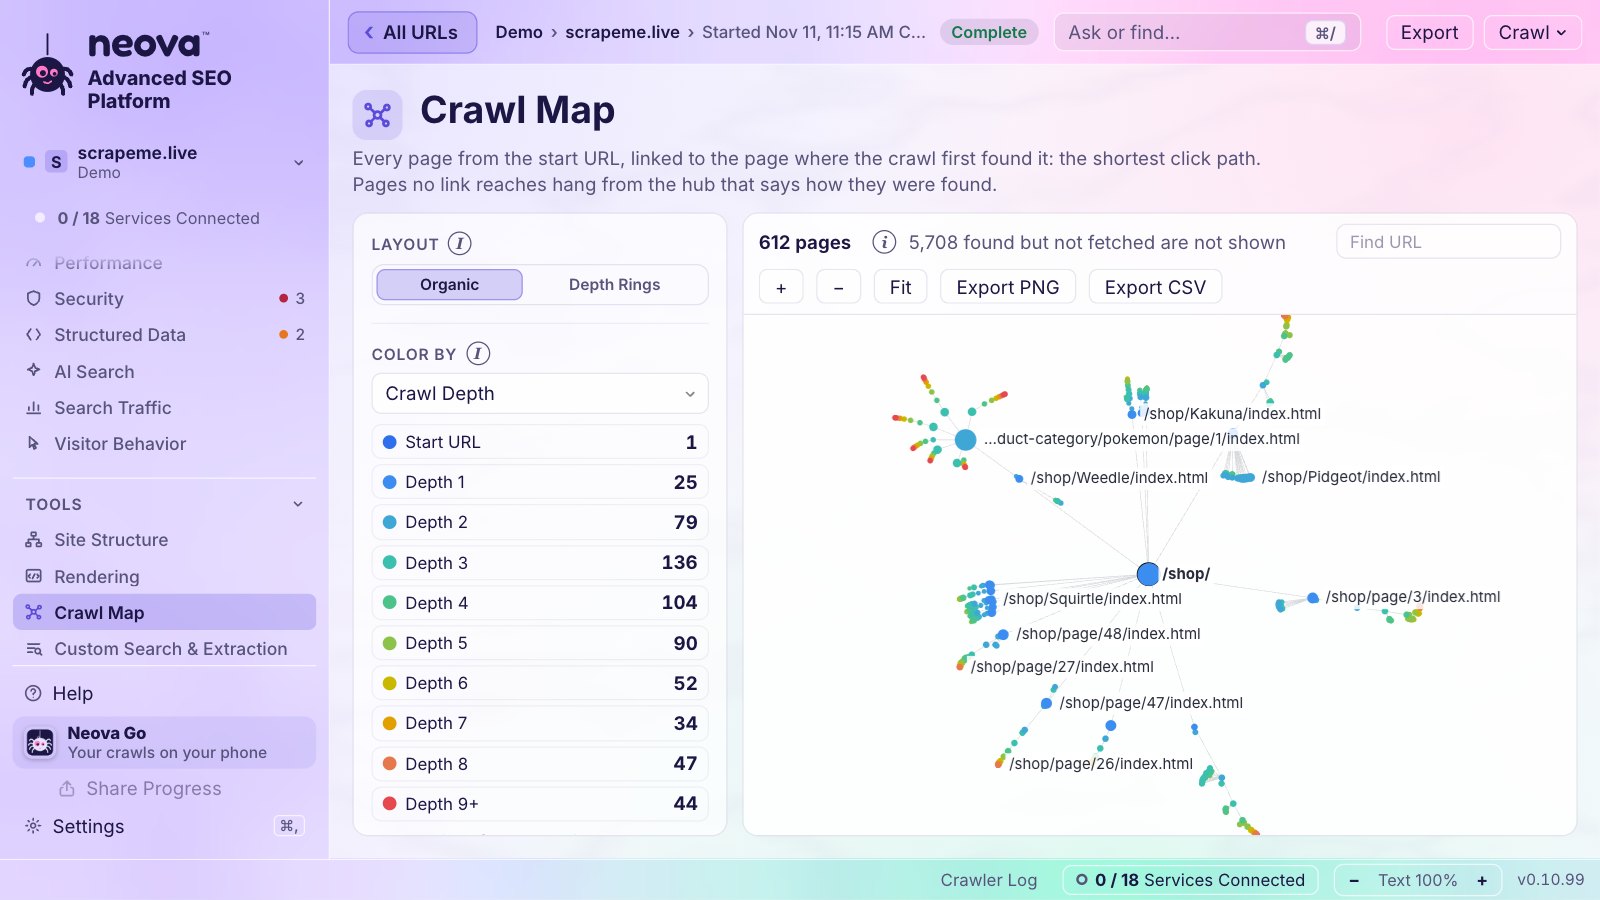
- 9. Halaman penting berada beberapa klik dari beranda. Halaman yang dalam di struktur ditemukan lebih lambat dan lebih jarang di-crawl. Di crawler, urutkan halaman yang dapat diindeks berdasarkan crawl depth dan lihat apa yang berada di kedalaman 4 atau lebih. Neova menandai halaman dapat diindeks mulai kedalaman 4. Pemeriksaan: URL yang dapat diindeks berada di kedalaman crawl 4 atau lebih.
- 10. Tidak ada halaman orphan dan tidak ada halaman yang hanya dijangkau lewat jalan buntu. Orphan adalah halaman dapat diindeks yang tidak dijangkau link internal apa pun. Anda menemukannya dengan membandingkan crawl dengan sitemap, log server, atau Search Console. Cari juga halaman yang hanya dijangkau melalui redirect, canonical, atau link nofollow. Pemeriksaan: URL orphan mengembalikan 200 dan dapat diindeks, URL hanya dapat dijangkau melalui redirect.
- 11. Tidak ada halaman duplikat atau varian URL yang saling bersaing. Halaman yang sama dengan dua bentuk huruf besar-kecil, dengan dan tanpa trailing slash, atau dengan parameter dalam urutan berbeda memecah sinyal. Di crawler, bandingkan HTML varian URL, lalu kelompokkan halaman dengan teks dan title yang duplikat atau nyaris duplikat. Pemeriksaan: Varian URL mengembalikan HTML yang sama, Konten nyaris duplikat antarhalaman HTML.
Di situs besar, masalah yang sama menentukan ke mana bot menghabiskan kunjungannya; panduan crawl budget membahas sisi itu.
Rendering, Kecepatan, dan Structured Data
- 13. Title, link, dan teks utama ada di HTML mentah. Google merender JavaScript, kadang jauh setelah crawl, dan banyak crawler lain hanya membaca HTML yang dikirim server. Di crawler, render sampel per template dan bandingkan halaman hasil render dengan HTML mentah. Neova menandai setiap halaman Dirender di server, Hydrated, atau Memerlukan JavaScript. Pemeriksaan: Sebagian besar teks utama hanya muncul di HTML hasil render, Direktif noindex dihapus oleh JavaScript. Panduan crawler SEO JavaScript membahasnya lebih dalam.
- 14. Respons server dan Core Web Vitals berada di rentang baik. Baik berarti LCP 2,5 detik atau kurang, INP 200 ms atau kurang, dan CLS 0,1 atau kurang. Di crawler, jalankan Lighthouse di satu halaman per template, dan baca Chrome UX Report untuk data pengunjung sungguhan. Neova melakukan keduanya, yang kedua dengan kunci Chrome UX Report Anda sendiri. Pemeriksaan: Waktu respons server lambat di data lab atau data lapangan, CLS lebih dari 0,1 di data lab atau data lapangan.
- 15. Structured data valid dan sesuai dengan halaman. Markup dengan error sintaks diabaikan, dan markup yang tidak sesuai dengan halaman juga masalah. Di crawler, validasi schema di setiap halaman dan bandingkan di dalam setiap template. Pemeriksaan: Structured data memiliki error sintaks, Structured data tidak memiliki properti wajib atau berbeda dari teks yang terlihat.
Untuk latar belakangnya, lihat penjelasan Google tentang Core Web Vitals dan pengantar structured data.
Log Server dan Crawler AI
- 16. Log menunjukkan bot menghabiskan kunjungannya di URL yang tepat, dan crawler AI mendapat apa yang Anda maksudkan. Crawl menunjukkan apa yang disajikan situs. Log server menunjukkan apa yang benar-benar diminta Googlebot, Bingbot, dan crawler AI, serta apa yang mereka terima. Hitung sebuah request sebagai Googlebot hanya jika alamatnya terverifikasi; string user agent mudah dipalsukan. Lalu cari halaman penting yang tidak pernah dikunjungi bot, dan kunjungan bot yang mendarat di error. Untuk crawler AI, cek apa yang diizinkan robots.txt untuk diambil masing-masing, dan apa yang benar-benar diberikan server, karena aturan firewall atau CDN bisa memblokir crawler yang diizinkan robots.txt. Pemeriksaan: Pangsa respons 3xx, 4xx, atau 5xx untuk bot pencarian meningkat, Permintaan dengan user agent crawler pencarian AI diblokir.
Di Neova, log server berasal dari file log Apache atau Nginx, atau dari akun Cloudflare Anda sendiri, dan menghitung bot hanya jika alamatnya ada di daftar yang dipublikasikan setiap perusahaan. Tampilan Yang disajikan ke setiap asisten AI meminta halaman sampel sebagai 10 agent AI dan menunjukkan siapa yang mendapat akses penuh. Panduan analisis file log dan crawler AI membahas keduanya secara mendalam, dan Google menjelaskan cara memverifikasi Googlebot.
Checklist Ini di Situs Kami Sendiri
Kami menjalankan daftar yang sama di situs kami sendiri. Crawl penuh Neova atas seoprocheck.com pada 17 Oktober 2026 mengambil 10.222 URL dalam 61 menit, 4.561 di antaranya halaman HTML yang menjawab 200, dengan kelengkapan 99,98%. Yang ditandainya:
| Tanda | Jumlah |
|---|---|
| Meta description lebih dari 155 karakter | 582 |
| Title lebih dari 60 karakter | 557 |
| Title duplikat | 56 |
| Canonical ke URL internal lain | 5 |
| Gambar tanpa alt text | 2 |
Pemeriksaan SEO kami atas neova.app pada 20 November 2026 menemukan lima hal yang dicakup checklist ini, semuanya diperbaiki di hari yang sama:
| Langkah | Sebelum | Sesudah |
|---|---|---|
| 7. Versi http:// | 200 | 301 ke https |
| 5. Alamat tak dikenal | 503 | 404 |
| 1. Skrip email Cloudflare | Diblokir di 1.320 halaman | Diizinkan |
| 1. File favicon | Di balik Disallow: / | Diizinkan |
| Meta description | Sebagian lebih dari 160 | 160 atau kurang, 1.354 halaman |
Masalah favicon terlihat di Google: dengan file-nya diblokir, yang tampil di samping neova.app hanya huruf polos, bukan logo. 1.358 URL sitemap situs ini dalam 15 bahasa lolos langkah hreflang dengan semua link balik terpasang.
Setelah Anda menyelesaikan daftar ini, perbaiki, lalu crawl lagi. Verifikasi perbaikan di Neova hanya mengambil ulang URL yang ditandai sebuah pemeriksaan dan menyebutkan berapa yang sudah diperbaiki, dan Bandingkan crawl menunjukkan apa yang berubah di antara dua crawl. Neova menjalankan 694 pemeriksaan; unduh Neova untuk menjalankannya di situs Anda.

Pertanyaan
Apa itu checklist audit SEO teknis?
Daftar hal yang menentukan apakah mesin pencari bisa meng-crawl, merender, dan mengindeks sebuah situs, dikerjakan dalam urutan tetap. Mengerjakannya dengan cara yang sama setiap kali mengubah audit menjadi rutinitas.
Apa saja langkah audit SEO teknis?
Crawl situs beserta XML Sitemap-nya, lalu cek crawlability, indexability, status code dan redirect, sitemap, struktur situs dan duplikat, tag internasional, rendering, kecepatan dan structured data, dan terakhir log server. Perbaiki dulu masalah yang menyentuh paling banyak halaman dapat diindeks, lalu crawl lagi.
Seberapa sering saya harus menjalankan audit SEO teknis?
Audit penuh sekali atau dua kali setahun, dan crawl yang lebih ringan setelah setiap rilis besar. Situs yang sering berubah terbantu oleh crawl terjadwal mingguan yang dibandingkan dengan crawl sebelumnya.
Bisakah saya menjalankan checklist ini dengan tool gratis?
Untuk situs kecil, bisa. Paket Free Neova meng-crawl hingga 1.000 URL per crawl dengan semua pemeriksaan, rendering JavaScript, dan Search Console. Log server dan snapshot Core Web Vitals tersedia di paket berbayar. Lihat panduan crawler SEO gratis untuk pilihan lain.
Apakah saya butuh log server untuk audit SEO teknis?
Tidak untuk memulai. Crawl mencakup sebagian besar checklist. Log menambahkan apa yang benar-benar dilakukan bot, yang paling penting di situs besar dan saat halaman lambat terindeks.