Crawl beberapa situs sekaligus, dan pantau secara live
Beberapa situs sekaligus, masing-masing dengan kecepatannya sendiri, di peta langsung setiap URL yang masuk.

Dibuat oleh SEO, untuk SEO. Neova melakukan crawl dari komputer Anda sendiri, lalu memberi tahu tanda mana yang penting dan apa yang diperbaiki dulu, menulis tiketnya, membuat laporan untuk klien, dan terus memantau situsnya. Dua menit video, lalu semuanya.
Crawl hanyalah awalnya. Inilah yang dilakukan Neova dengan hasilnya.
Beberapa situs sekaligus, masing-masing dengan kecepatannya sendiri, di peta langsung setiap URL yang masuk.

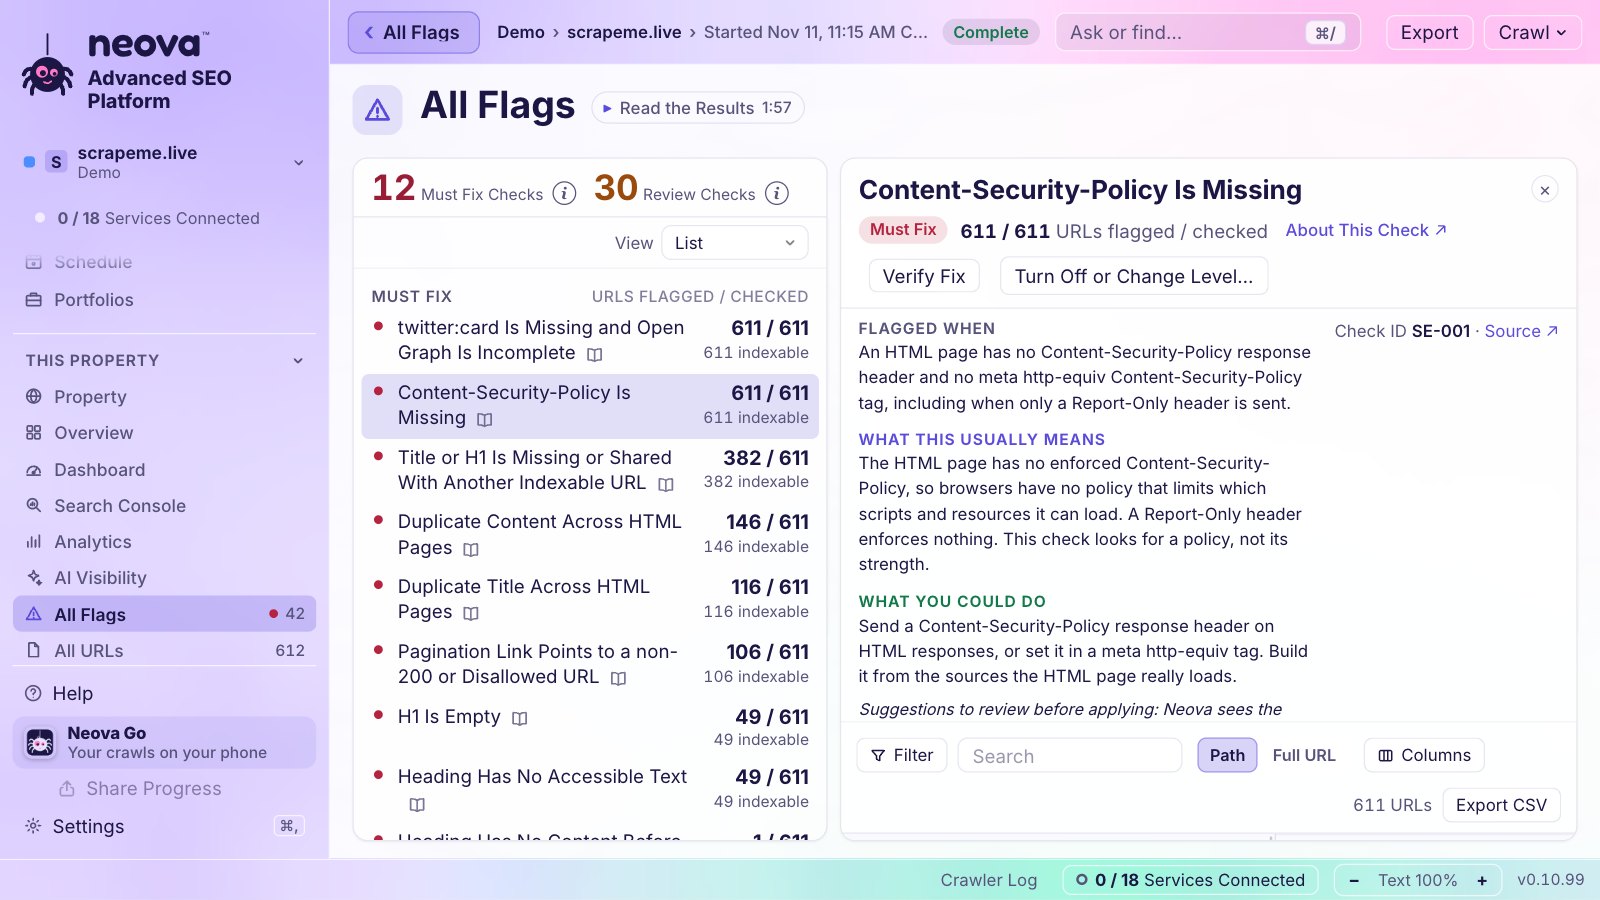
Setiap tanda menjelaskan kenapa muncul, biasanya berarti apa, dan dari mana aturannya.

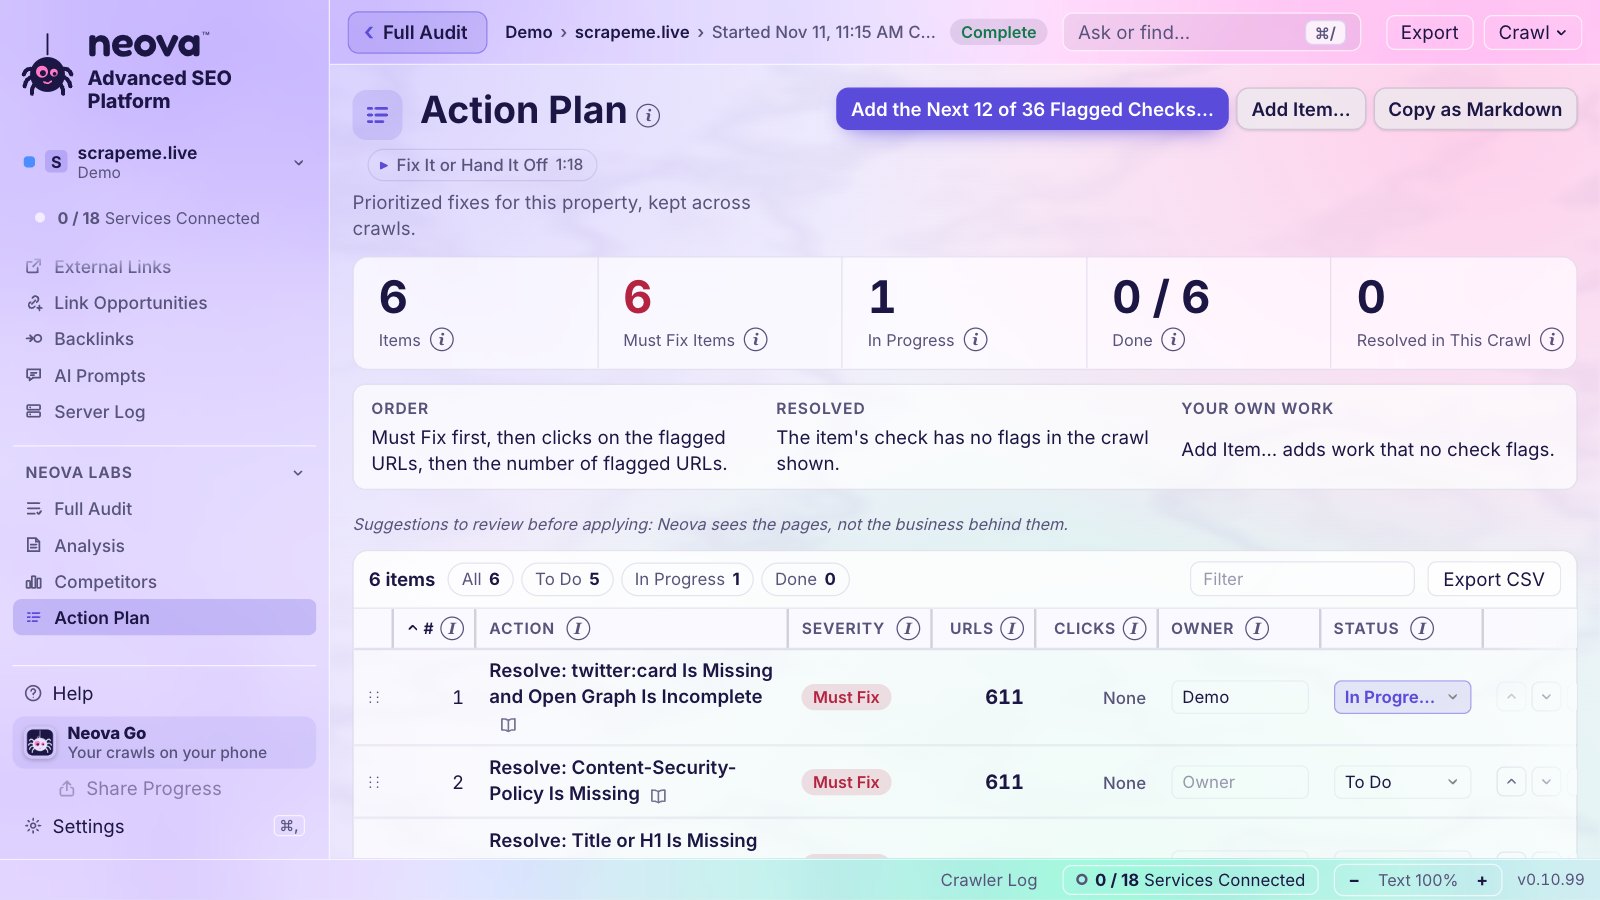
Tanda menjadi pekerjaan: penanggung jawab, status, Harus diperbaiki lebih dulu, tersimpan dari crawl ke crawl.

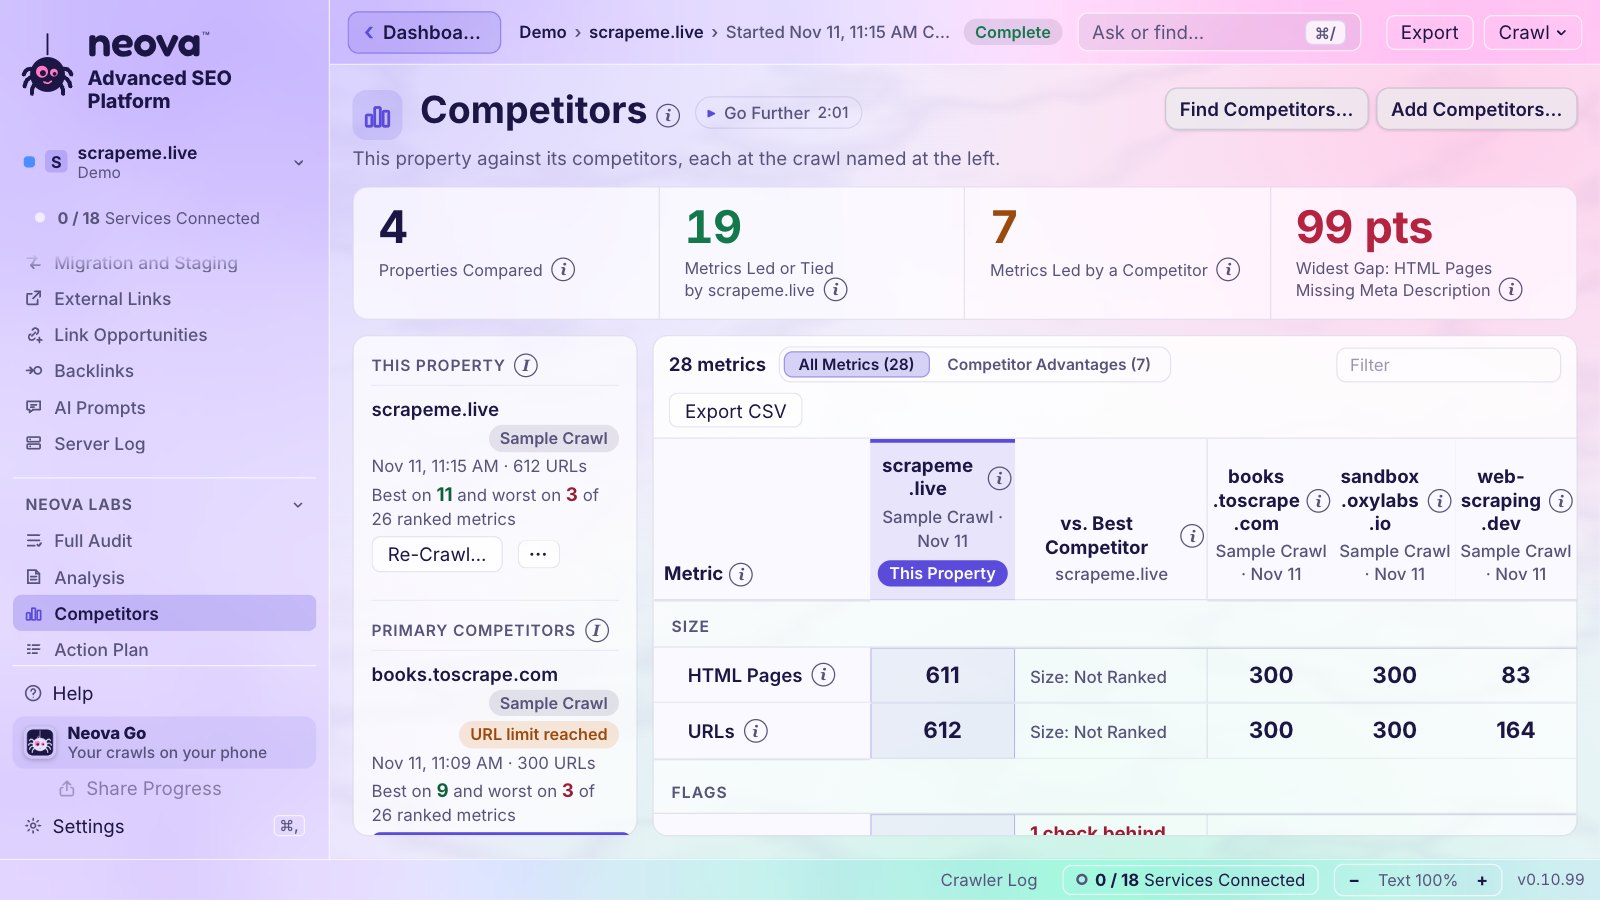
Tempel daftar. Neova mengukur setiap crawl dari sitemap mereka, lalu menunjukkan siapa yang unggul, metrik demi metrik.

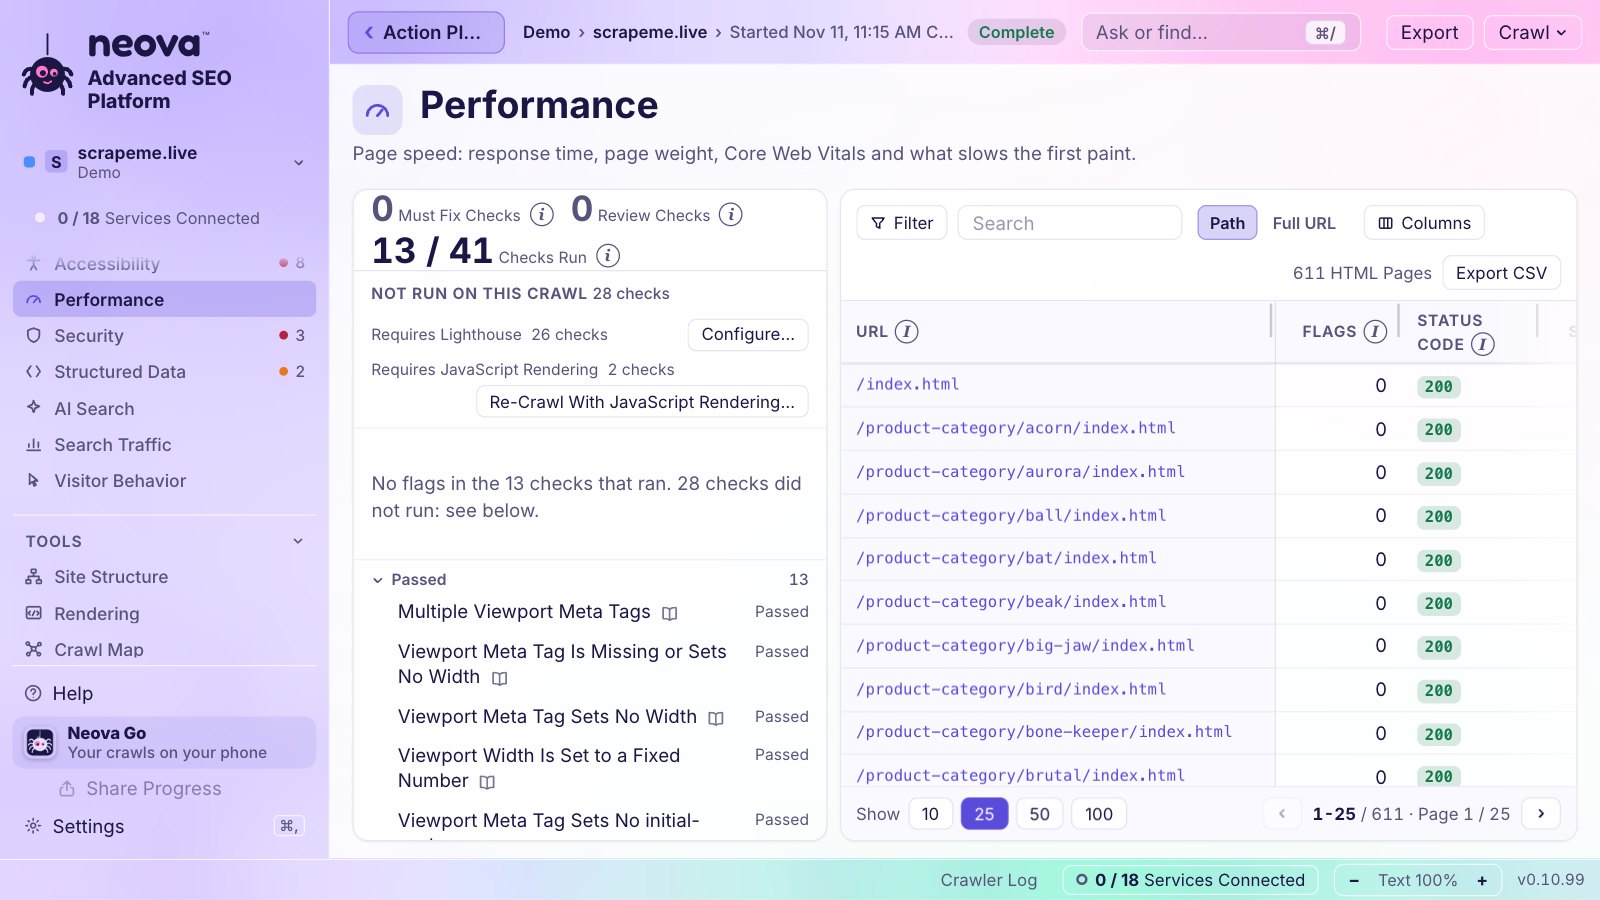
Apa yang didapat pengunjung nyata di ponsel, per grup halaman, dengan peringatan saat nilainya berubah.

Buka ekspor mereka dan jalankan pemeriksaan Neova pada temuannya. Tetap pakai tool yang Anda suka.
Tutup jendelanya. Crawl terus berjalan di menu bar, dan ponsel Anda menampilkan setiap properti.

Semua yang diterima klien Anda, dari satu tempat, dienkripsi di komputer Anda sebelum tautan apa pun dibagikan.
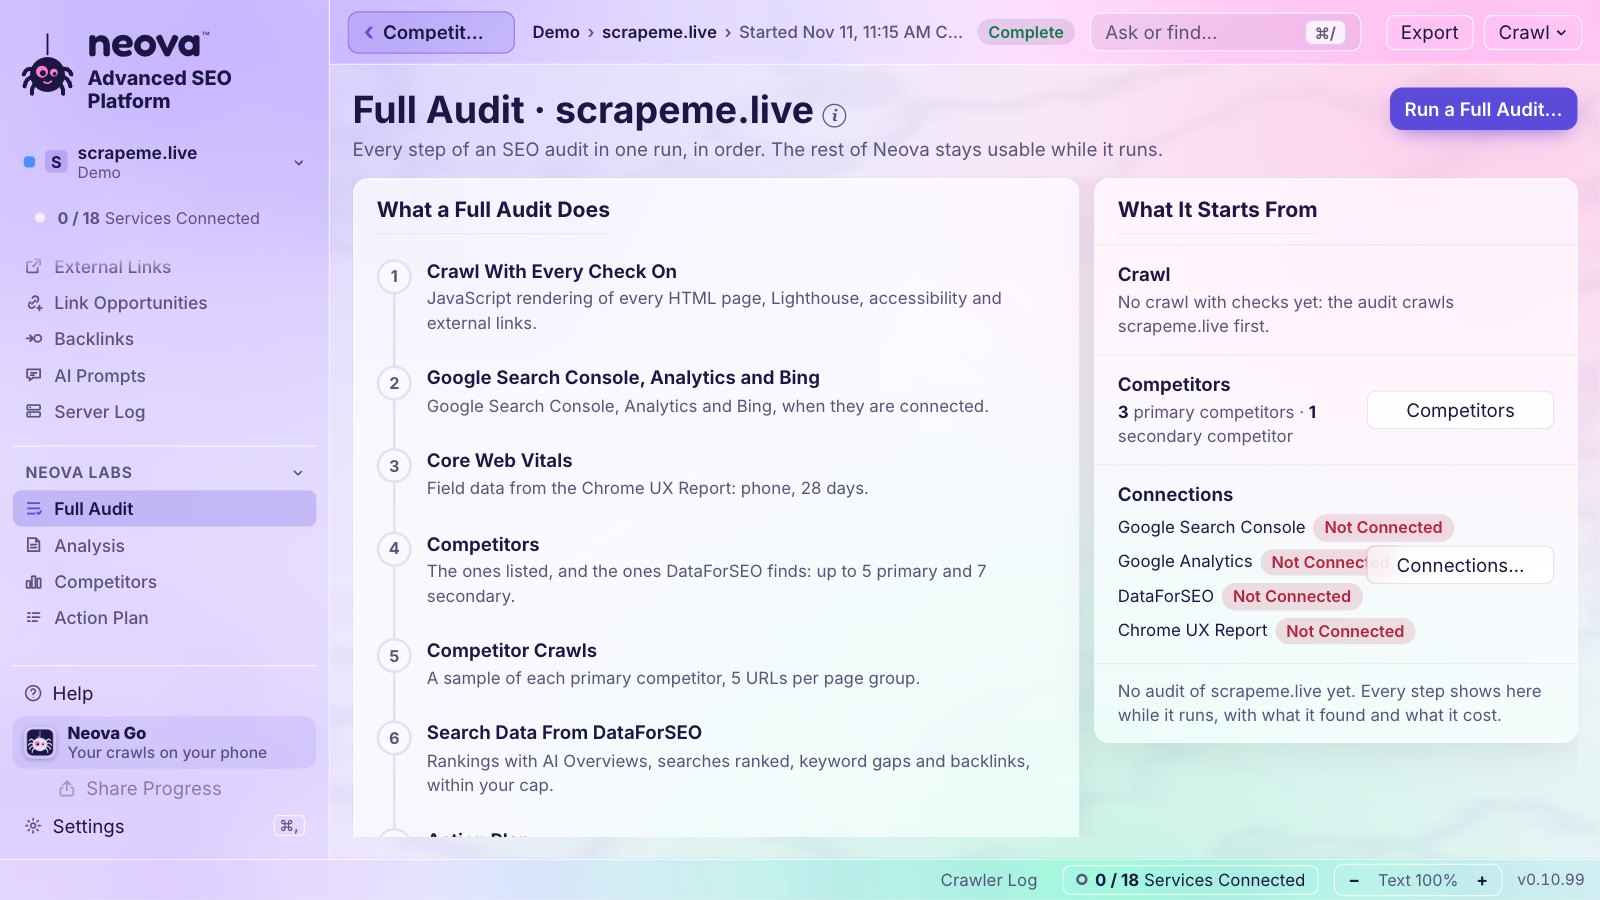
Crawl, Google, Bing dan Analytics, Core Web Vitals, pesaing, rencana, dan PDF, dalam sekali jalan.

Maskot animasi yang duduk di desktop Anda dan mengawasi crawl Anda. Ia memberi tahu saat sebuah crawl membutuhkan Anda, menjawab pertanyaan Anda tentang crawl itu, dan membawa Anda ke layar yang tepat dengan satu klik. Opsional, dan mati sampai Anda memilih satu.
31 layanan, semuanya opsional: Neova tetap bekerja tanpa satu pun, dan bisa lebih banyak dengan layanan tersebut.
Buka sebuah area untuk melihat semua fiturnya, atau cari di semuanya.
Log langsung dari crawl: setiap URL yang diambil dengan kode status berwarna dan waktu responsnya, setiap langkah ditebalkan, kegagalan berwarna merah dan peringatan berwarna kuning; Salin log menyimpan setiap baris untuk tim dukungan.
Mengikuti internal link dari URL awal, dan sitemap XML jika diaktifkan, seperti cara mesin pencari menemukan sebuah situs.
Hanya meng-crawl URL yang Anda tempel atau unggah dari file, tidak ada yang lain.
Membaca situs sebelum crawl dimulai dan memilih versi (http atau https, dengan atau tanpa www) yang menjawab 200, sambil menjelaskan apa yang dilakukan versi lainnya.
Menanyakan apakah subdomain yang ditemukan Neova ikut di-crawl, dan subdomain mana saja.
Meng-crawl seluruh situs tanpa batas URL, kecuali Anda menetapkannya.
Hanya meng-crawl folder yang Anda ketik, dan menilai kelengkapannya berdasarkan URL sitemap XML di bawah folder itu.
Meng-crawl sejumlah halaman tertentu dari setiap grup halaman, sehingga situs besar diaudit dalam hitungan menit dengan setiap template tercakup.
Tiga tingkat dalam satu pilihan: Hanya crawl, Audit situs (menambahkan Core Web Vitals dan draf Rencana tindakan) dan Audit lengkap (menambahkan pesaing, data pencarian dan analisis).
Menambahkan URL awal tambahan dari file TXT atau CSV, atau yang Anda tempel, untuk menjangkau halaman yang tidak ditautkan dari mana pun.
Meng-crawl URL yang tercantum di sitemap XML yang dideklarasikan robots.txt, setelah halaman yang dijangkau lewat link.
Membaca sitemap XML tambahan yang Anda sebutkan, selain yang dideklarasikan robots.txt, untuk setiap crawl properti ini.
Memilih sumber daya apa saja yang ikut di-crawl selain halaman HTML: gambar, CSS, JavaScript, dan PDF.
Halaman dulu mengambil setiap halaman HTML sebelum gambar dan file, jadi inti audit selesai lebih dulu; Menurut kedalaman mengambil yang paling dekat dengan URL awal lebih dulu.
Mencatat link di menu, footer, dan filter tanpa mengikutinya, sementara link di isi halaman selalu diikuti.
Meng-crawl atau melewati URL berdasarkan pola regex, satu per baris, dengan kolom untuk menguji sebuah URL terhadap pola tersebut.
Satu daftar pengecualian yang dipakai setiap crawl, siapa pun yang memulainya: jendela aplikasi, jadwal, atau asisten AI.
Menulis ulang URL dengan aturan regex sebelum di-crawl, misalnya untuk membuang parameter pelacakan, atau untuk memindahkan link situs staging ke situs live, serta sitemap XML situs live ke host staging.
Mempertahankan atau membuang query string saat crawl.
Meng-crawl internal link yang bertanda rel=nofollow jika Anda menginginkannya.
Menganggap /Page dan /page sebagai satu URL.
Mengizinkan crawl yang dimulai di sebuah folder untuk keluar dari folder itu.
Batas URL, Batas kedalaman crawl, Maks URL per folder, Maks panjang URL, dan Maks parameter kueri, agar faceted navigation tetap terkendali.
Secara default meng-crawl 3 URL per detik dan otomatis memangkas kecepatannya menjadi separuh saat server melambat atau menjawab 429 atau 503, dengan mematuhi Retry-After.
Memberi jarak pada setiap permintaan sesuai kecepatan yang diminta, termasuk robots.txt dan sitemap XML, jadi situs tidak pernah dibanjiri permintaan sekaligus.
Setelah Anda mengonfirmasi bahwa situs itu milik Anda, kecepatan bisa naik hingga 50 URL per detik dan robots.txt bisa diabaikan, untuk situs Anda sendiri atau server staging.
Secara default crawl sebagai NeovaBot, atau sebagai Googlebot, Bingbot, Applebot, crawler AI seperti GPTBot dan ClaudeBot, alat SEO, browser, atau string kustom.
Mematuhi robots.txt live, mengabaikannya untuk situs milik Anda, atau mematuhi draf yang disimpan di Penguji robots.txt untuk melihat dampak sebuah perubahan.
Merender halaman HTML di Chrome setelah crawl, semuanya atau beberapa per grup halaman, lalu membandingkan halaman yang dirender dengan HTML mentah; nonaktif secara default.
Menunggu jaringan tenang dan halaman berhenti berubah, sampai batas waktu stabil, dan memberi tahu jika sebuah halaman masih berubah.
Memberi tahu di atas hasil saat crawl berjalan tanpa render, berapa pemeriksaan yang tidak bisa dijalankan karenanya, dan menawarkan Crawl ulang dengan render.
Mengambil setiap URL dengan Chrome seperti pengunjung, untuk situs dengan proteksi bot; Anda sendiri yang menyelesaikan CAPTCHA dan Neova menunggu Anda.
Mengirim autentikasi HTTP, cookie, dan header kustom hanya ke situs yang di-crawl, untuk situs staging dan area yang memerlukan login.
Membuat header rahasia untuk situs yang Anda kelola, hanya dikirim ke situs itu, beserta aturan untuk diserahkan ke tim IT-nya agar firewall meloloskan Neova.
Menyimpan konfigurasi dengan sebuah nama untuk dipakai lagi di situs mana pun, dengan pengaturannya terlihat sekilas.
Memberi sebuah properti pengaturan crawl sendiri yang menjadi titik awal Crawl baru, Crawl ulang, dan jadwalnya, dengan Atur ulang ke default.
Menampilkan pengaturan yang paling sering diubah orang, atau semua pengaturan dengan catatan cara kerja masing-masing.
Mencantumkan setiap pengaturan yang berbeda dari default sebelum crawl dimulai, masing-masing dengan link Edit.
Membaca beberapa halaman lebih dulu, lalu memberi tahu berapa URL yang tercantum di sitemap XML, gambar dan file yang bisa diharapkan, serta ruang disk yang dibutuhkan dibandingkan ruang yang tersedia.
Memberi tahu dari halaman sampel berapa gambar per halaman, parameter apa yang dibawa link, dan alamat mana yang ditulis salah.
Memeriksa koneksi Google milik properti sebelum crawl atau audit dimulai, dan menahannya dengan Masuk lagi, Crawl tanpa data ini, atau Batal jika login-nya bermasalah.
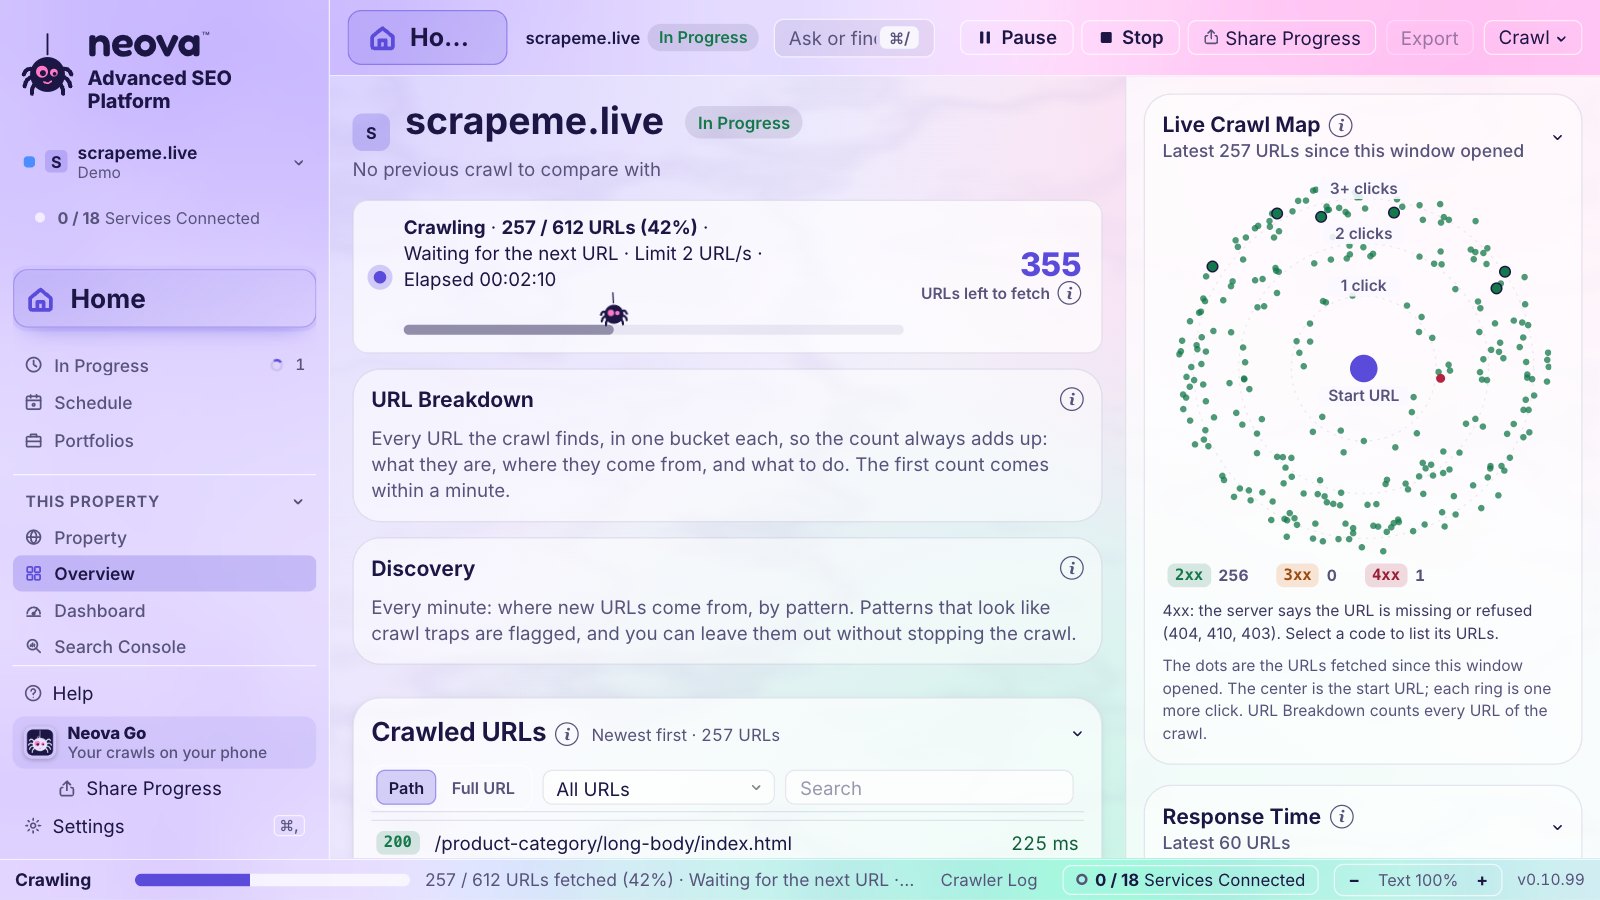
Menampilkan crawl selagi berjalan: langkah bernomor, apa yang sedang dikerjakan, URL yang tersisa, dan setiap kotak di bawahnya, masing-masing bisa dilipat.
Menampilkan langkah-langkah menurut namanya (Meng-crawl situs web, Meng-crawl XML Sitemaps, Meng-crawl sumber daya, Merender halaman, Menjalankan 694 pemeriksaan) beserta apa yang diambil di setiap langkah.
Memberi tahu dalam satu baris apa yang sedang dikerjakan crawl saat ini dan alamat yang terakhir diambil.
Tiga bilah di bawah progres: Halaman HTML, Gambar, serta CSS, skrip, dan file lain, masing-masing berapa yang diambil dari yang ditemukan.
Menampilkan URL yang masih harus diambil, lalu URL yang masih harus diperiksa, dengan huruf besar dan sebuah bilah.
Setiap menit, memberi tahu dari mana URL baru berasal menurut polanya, menandai bentuk crawl trap (kalender, folder berulang, ID sesi, banyak parameter, URL yang dalam dan panjang), dan menawarkan untuk meng-exclude atau melewatinya saat itu juga.
Untuk setiap grup URL yang ditemukan, menawarkan Terus crawl, Lewati, atau Exclude, masing-masing dengan apa yang tetap ada di audit dan apa yang keluar darinya, dengan pilihan yang disarankan ditandai.
Memasukkan setiap URL yang ditemukan crawl ke tepat satu kelompok (URL halaman bersih, Varian parameter, URL salah format, Crawl trap, Gambar, CSS, JavaScript dan font, Dokumen, Video dan audio, Sumber daya lain) sehingga jumlahnya selalu bisa dijelaskan.
Mengambil gambar dari 1, 3, 5, 10, 25, 50, atau 100 halaman pertama setiap grup halaman, dengan jumlah gambar dan waktu untuk setiap ukuran, atau melewati sisanya, atau menyimpan semua gambar.
Setelah semua halaman diambil, melewati gambar dan file yang tersisa agar crawl berakhir sebagai selesai dan pemeriksaan dijalankan.
Menampilkan halaman terdalam sejauh ini selama crawl, berwarna kuning mulai 4 klik, dengan baris peringatan mulai 10 klik.
Menggambar 300 URL terbaru menurut kedalaman klik, diwarnai menurut kode status, dengan URL yang hanya ada di sitemap pada lingkarannya sendiri.
Menampilkan median waktu respons URL terbaru pada grafik dengan garis 800 ms dan 1,800 ms.
Mencantumkan URL selagi diambil, 10, 25, 50, atau 100 per halaman, dengan filter untuk 2xx, 3xx, 4xx, 5xx dan Tidak ada respons, yang berubah dan yang baru.
Membandingkan setiap URL selagi diambil dengan crawl sebelumnya yang terbaru dari properti ini yang membaca halaman, utamakan Crawl situs penuh, jika tidak ada crawl Sampel atau Folder tertentu, lalu menampilkan nilai lama yang dicoret di samping nilai baru.
Menampilkan pemeriksaan yang berjalan per kategori, masing-masing dengan berapa URL-nya yang sudah dibaca, dan jumlah tanda setelah ditulis.
Mencantumkan halaman milik Google yang sesuai dengan apa yang ditunjukkan crawl, serta berita Google Search 45 hari terakhir: update ranking, blog Search Central, dan update dokumentasi.
Menyarankan bacaan yang sesuai dengan crawl: Google Search Status Dashboard serta studi kasus dan update algoritma dari SEO ProCheck.
Membekukan crawl dan melanjutkannya tepat di tempat terakhir.
Hentikan menawarkan: Lanjut ke sitemap XML, Hentikan dan jalankan pemeriksaan, Hentikan dan hapus crawl ini, atau Lanjutkan crawl; Lewati render selagi merender.
Melanjutkan crawl yang dihentikan atau terputus dengan pengaturannya sendiri dipulihkan, tidak pernah dari nol.
Menjalankan ulang setiap pemeriksaan pada apa yang diambil sebuah crawl, tanpa mengambil apa pun lagi, juga pada crawl yang sudah selesai sampai akhir, agar pemeriksaan yang diperbaiki di versi baru juga sampai ke crawl tersimpan; berjalan berdampingan dengan crawl situs lain.
Meng-crawl ulang properti dengan pengaturan crawl terbarunya, tanpa mengubah data yang terhubung, pesaing, dan rencananya.
Saat situs menolak crawl, memberi tahu alasannya (dibatasi rate limit, diblokir firewall atau di negara atau wilayah ini, terlarang) dan apa yang harus dilakukan selanjutnya.
Alamat yang tidak mungkin berupa URL, seperti kalimat di dalam href, tidak diikuti dan dilaporkan sebagai tanda.
Membaca setiap stylesheet yang diambil untuk mencari font, gambar latar, dan stylesheet yang diimpor.
Mencantumkan file dan gambar yang dimuat halaman dari host lain, tanpa meng-crawl-nya.
Menghitung URL media CMS tanpa ekstensi gambar, seperti handler /-/media/ milik Sitecore, sebagai gambar.
Mengelompokkan halaman menurut template dari HTML-nya (kata template milik tema itu sendiri, jika tidak ada, kerangka halamannya), dan menurut pola alamat di situs yang sangat besar.
Mengikuti link rel=next dan rel=prev di head, selain anchor biasa.
Mengantrekan crawl dan memulai masing-masing begitu ada slot crawl kosong, tidak pernah dua crawl untuk satu situs sekaligus, dengan Mulai antrean, Kosongkan antrean, dan Setelah pemeriksaan selesai.
Menyimpan crawl di disk, bukan di memori (60 MB memori untuk 60,000 URL), jadi ukurannya dibatasi oleh disk, bukan memori.
Crawl hingga 4 situs berjalan bersamaan, masing-masing dengan kecepatan dan batas URL sendiri, dengan penjaga memori yang menahan crawl saat memori komputer menipis; crawl tersimpan atau properti mana pun tetap bisa dibuka selagi crawl berjalan.
Crawl baru mengisi formulirnya dari pengaturan tersimpan properti (kecepatan, cakupan, batas URL, render, user agent, sitemap XML, dan lainnya), juga saat alamat situs diketik di URL awal; jawaban terakhir Anda sendiri di jendela ini tetap didahulukan, dan apa pun yang sudah Anda ubah tidak ditimpa.
Saat komputer ini kehilangan koneksi internet, crawl memberitahukannya, menunggu, lalu lanjut sendiri setelah koneksi kembali, alih-alih berhenti seolah-olah situsnya down; setelah 30 menit offline, crawl berhenti dan menjelaskan alasannya.
Mencantumkan setiap halaman HTML dengan title, meta description, dan H1 beserta panjangnya, serta pemeriksaan konten dengan tandanya.
Set kolom Semua URL untuk title, meta description, dan H1, masing-masing dengan filter untuk yang hilang, kosong, duplikat, terlalu panjang, dan terlalu pendek.
Menandai title, description, H1, dan H2 yang duplikat, serta teks duplikat atau hampir duplikat di antara halaman HTML.
Menandai teks utama di rentang Sulit dan Sangat Sulit pada skor Flesch, serta thin page di bawah 200 kata.
Menandai kemungkinan kesalahan ejaan dan tata bahasa di teks utama.
Menandai title dan H1 yang menyebut tahun lalu, serta teks yang menyebut promo, tenggat, atau tanggal acara yang sudah lewat.
Memeriksa tag yang menentukan judul, deskripsi, dan gambar yang tampil saat sebuah halaman dibagikan.
Menampilkan bagaimana title dan description sebuah halaman terbaca di hasil penelusuran.
Model di komputer Anda membaca halaman HTML untuk 20 pemeriksaan konten yang butuh penilaian, seperti contoh yang tidak ada, klaim tanpa dasar, atau tanpa byline penulis; tandanya dipisahkan dari Harus diperbaiki dan Perlu dicek.
Menampilkan title, meta description, dan H1 mana yang berubah sejak crawl sebelumnya, sebelum dan sesudahnya.
Bilah panjang title, meta description, dan H1, grup halaman, serta halaman HTML dengan link terbanyak.
Mengekspor konten utama setiap halaman HTML sebagai satu file Markdown per halaman, dengan indeks.
Menandai H1 dan H2 yang hilang, kosong, panjang, dan duplikat, H1 pertama yang bukan judul utama, serta halaman panjang tanpa H2.
Menandai charset, doctype, atau tag body yang hilang, favicon rusak, elemen usang, dan frame yang menampung konten.
Menandai Lorem Ipsum, kode template, nilai skrip kosong, serta error server atau output debug yang tampil sebagai teks halaman.
Menandai rasio teks terhadap HTML yang rendah, teks utama di bawah 200 kata, dan di atas 5,000 kata.
Menandai konten sindikasi tanpa noindex atau canonical ke aslinya.
Menandai halaman Tentang yang tidak ada atau tidak ditautkan di seluruh situs.
Membaca entitas halaman HTML utama dengan kunci Google Natural Language Anda, untuk pemeriksaan konten.
Kode status setiap URL, dengan warna yang sama di mana-mana: 2xx hijau, 3xx oranye, 4xx dan 5xx merah, dengan Tidak ada respons disebut terpisah.
Ke mana redirect mengarah, berapa hop yang dilalui, loop, redirect sementara, meta refresh dan redirect JavaScript, serta link yang mengarah ke sana.
Menandai URL internal dengan 2 hop redirect atau lebih, loop redirect, redirect ke dirinya sendiri, serta header Location yang hilang atau salah format.
Menandai redirect internal 302, 303, dan 307, kecuali tujuan login dan masuk akun.
Menandai redirect internal yang berakhir di 4xx atau 5xx, URL noindex, URL yang di-canonical-kan atau yang di-disallow, atau di website lain.
Menandai URL yang me-redirect hanya untuk menambahkan garis miring atau mengubah huruf besar-kecil, serta halaman yang hanya berbeda dengan cara itu tanpa canonical di antaranya.
Menandai gambar, skrip, dan stylesheet yang di-redirect, serta link eksternal yang di-redirect atau berakhir di error.
Set kolom untuk canonical dan direktif meta robots, dengan filter Noindex dan Nofollow.
Menampilkan header respons URL mana pun.
Menampilkan HTML yang dikirim sebuah URL, dan HTML yang dirender jika crawl merendernya.
Memberi tahu per halaman HTML apakah halaman itu Dirender di server, Hydrated, atau Memerlukan JavaScript.
Menandai title, canonical, link, dan teks utama yang baru muncul atau berubah setelah JavaScript berjalan.
Dua puluh pemeriksaan pada URL AMP dan canonical-nya, termasuk validator AMP.
Menandai URL yang panjang, garis bawah, garis miring ganda, segmen berulang, tanda baca nyasar, dan parameter yang terlalu banyak.
Menampilkan halaman HTML per folder dan per kedalaman crawl.
Menggambar crawl sebagai pohon dari URL awal, setiap titik diwarnai menurut kode status, dengan keterangan yang bisa memfilternya.
Grup URL buatan Anda sendiri dengan regex, per situs, masing-masing dengan jumlah kode statusnya, dan kolom Segmen di Semua URL.
Mencari teks atau regex di HTML setiap halaman, atau mengekstrak nilai dengan XPath, selektor CSS, atau regex, dan menyimpan ekstraksi sebagai kolom yang dijalankan lagi di setiap crawl.
Mencantumkan tipe konten, ukuran, dan waktu respons setiap URL, dengan waktu respons diwarnai mulai 800 ms dan 1,800 ms.
Mengambil ulang hanya URL yang ditandai sebuah pemeriksaan, menjalankan lagi setiap pemeriksaan, dan memberi tahu berapa yang sudah diperbaiki.
Menonaktifkan sebuah pemeriksaan atau mengubah levelnya menjadi Harus diperbaiki atau Perlu dicek untuk satu properti, berlaku untuk setiap crawl berikutnya.
Mengeluarkan seluruh kategori pemeriksaan dari sebuah crawl.
Satu layar untuk render: berapa halaman HTML yang kontennya ada di HTML, sebagian di HTML, atau memerlukan JavaScript, apa yang hanya ditampilkan JavaScript, apa yang disajikan ke setiap crawler AI, per grup halaman, serta halaman yang kontennya tidak semuanya ada di HTML.
Tab SEO Teknis dan Pencarian AI di Dasbor menampilkan persentase halaman yang ada di HTML, halaman yang memerlukan JavaScript, halaman yang konten utamanya hanya muncul dengan JavaScript, dan crawler AI yang mendapat halaman lengkap.
Apakah setiap halaman HTML bisa diindeks: kode status, noindex, canonical, robots.txt, dan HTML yang merusak head sebelum tag SEO.
Menandai setiap URL Dapat diindeks atau tidak beserta alasannya: status 200, tanpa noindex, canonical ke dirinya sendiri atau tanpa canonical.
Menjelaskan setiap baris file live atau draf dengan bahasa sederhana, seperti yang didokumentasikan Google dan didefinisikan RFC 9309, beserta URL hasil crawl yang cocok dengan setiap aturan.
Menampilkan apa yang boleh diambil Googlebot, Bingbot, dan crawler AI menurut robots.txt, beserta URL yang diblokir untuk masing-masing.
Menguji draf terhadap setiap URL hasil crawl sebelum dipasang, dengan daftar URL yang baru diblokir dan yang baru diizinkan.
Memberi tahu saat grup milik sebuah crawler di robots.txt menggugurkan aturan grup *.
Isi sitemap XML dibandingkan dengan temuan crawl: halaman yang dapat diindeks tetapi tidak tercantum, serta URL redirect, noindex, error, dan orphan yang tercantum.
Mengambil halaman yang hanya tercantum di sitemap XML, sebagai langkah 2, dan menghitungnya terpisah.
Memberi robots.txt dan sitemap waktu tersendiri di situs yang lambat, dan memberi tahu jika salah satunya tidak menjawab.
Menulis sitemap XML berisi halaman yang dapat diindeks, di kedalaman berapa pun atau hingga kedalaman 3 atau 5.
Menandai halaman arsip berpaginasi yang mengembalikan 200 tanpa item, rantai rel=next yang putus, dan paginasi yang canonical-nya mengarah ke halaman 1.
Menyimpan setiap versi robots.txt dan sitemap XML yang dibaca crawl, dan menandai perubahan aturan robots.txt sejak crawl sebelumnya.
Menandai HTML yang mengakhiri head sebelum tag SEO (noscript berisi teks, elemen tidak valid, tag head yang dihilangkan atau berulang), sehingga title dan canonical terbaca di body.
Menandai canonical yang membentuk loop atau rantai, mengarah ke redirect, noindex, 4xx, 5xx, HTTP, atau URL eksternal, atau hanya diatur lewat JavaScript.
Menandai noindex, nofollow, dan canonical yang berbeda antara HTML dan header HTTP, dideklarasikan dua kali, atau salah ketik.
Menandai halaman yang memakai gambar, skrip, atau stylesheet yang di-disallow robots.txt.
Menandai varian huruf besar-kecil, garis miring akhir, dan urutan parameter yang mengembalikan HTML yang sama.
Menandai halaman HTML yang menjawab 200 dengan frasa seperti not found atau no results found di title atau H1-nya.
Menandai HTML di atas 2 MB yang punya link atau konten melewati batas yang dibaca Google, serta file JavaScript atau CSS di atas 2 MB.
Menandai perubahan tajam jumlah URL yang bisa di-crawl dan aturan robots.txt yang berubah sejak crawl sebelumnya.
Menandai sitemap XML di atas 50 MB atau 50,000 entri, sitemap kosong, baris sitemap relatif di robots.txt, serta URL di host atau protokol lain.
Memeriksa apakah situs meng-host file kunci IndexNow Anda, dengan Buat kunci untuk membuatnya.
Membaca hasil URL Inspection Google untuk hingga 200 URL per crawl, dan menandai halaman yang dapat diindeks tetapi tidak diindeks Google, atau yang canonical-nya dipilih lain oleh Google.
Setelah Crawl situs penuh yang selesai dengan sendirinya, mengirim halaman yang berubah atau baru sejak crawl penuh sebelumnya ke IndexNow (Bing, Yandex, Seznam, Naver, dan Yep), hanya jika situs meng-host kunci Anda; jendela aplikasi memberi tahu apa yang terkirim atau ditolak.
Mencantumkan halaman yang berlabel eksplisit (meta rating adult, label RTA, atau header Rating) dan halaman yang menjawab crawler dengan verifikasi usia, untuk Anda tinjau.
Link rusak, link ke redirect, anchor, dan halaman yang hanya dijangkau sedikit link.
Mencantumkan setiap link ke dan dari sebuah URL beserta anchor text-nya.
Mencatat apakah setiap link berada di isi halaman, menu, footer, atau filter, dengan kolom Link masuk di isi halaman serta Link masuk di menu dan footer.
Memberi skor 0 sampai 100 pada setiap URL menurut bobot internal link yang diterimanya, semacam PageRank internal atas link yang diikuti dalam crawl.
Jumlah klik dari URL awal untuk setiap URL, dengan tanda mulai kedalaman 4.
Menandai halaman yang dapat diindeks tetapi tidak dijangkau internal link mana pun, yang ditemukan lewat sitemap XML, log server, atau Google Search Console.
Setiap URL di situs lain yang ditautkan situs ini, masing-masing diminta sekali, dengan 4xx, 5xx, dan tanpa respons dilaporkan.
Mengaktifkan atau menonaktifkan permintaan ke setiap URL eksternal untuk sebuah crawl; aktif secara default.
Menyarankan internal link dari teks halaman HTML: halaman yang menyebut topik halaman lain tanpa menautkannya.
Menampilkan URL Rating, Trust Flow, Page Authority, atau Authority Score, referring domain, dan backlink per URL dari kunci Ahrefs, Majestic, Moz, atau Semrush milik Anda sendiri.
Menandai internal link tanpa anchor text atau dengan anchor yang tidak deskriptif, serta gambar bertaut tanpa alt.
Menandai halaman yang hanya dijangkau lewat link nofollow, link keluar internal yang di-nofollow, dan link afiliasi tanpa sponsored atau nofollow.
Menandai href yang kosong, salah format, dan berisi spasi, link yang hanya memakai onclick, parameter pelacakan, path file lokal, localhost, dan fragmen tanpa ID yang cocok.
Menandai URL yang hanya bisa dijangkau lewat canonical, redirect, atau halaman noindex, serta halaman yang link masuknya hanya dari satu URL.
Menghitung alamat yang ditulis salah oleh link (spasi di akhir, garis miring ganda, karakter yang di-encode dua kali) sebagai kelompok tersendiri.
Menandai halaman HTML yang menautkan ke host staging, development, atau lokal.
Mencantumkan setiap gambar yang diambil crawl atau dipakai sebuah halaman, dengan ukurannya, alt text-nya, dan berapa halaman HTML yang memakainya.
Menandai alt text yang hilang, terlalu panjang, berupa placeholder, dan berulang, serta membedakan alt yang hilang dari alt dekoratif.
Menandai gambar di atas 100 KB, GIF di atas 100 KB, dan gambar tanpa width dan height.
Saat render aktif, menandai gambar yang ditampilkan dengan rasio aspek yang salah atau resolusi yang terlalu rendah untuk ukurannya.
Menandai gambar yang tidak dikompresi, tidak dalam format modern, lebih besar dari ukuran tampilnya, serta gambar LCP yang di-lazy-load.
Menandai video tanpa track teks (captions).
Memungkinkan pustaka gambar yang besar diambil sampelnya per grup halaman alih-alih diambil seluruhnya, dengan jumlah dan waktu setiap pilihan.
Meninggalkan gambar yang masih mengantre, sementara setiap halaman tetap di-crawl dan alt text tetap dibaca dari HTML.
Di situs yang melisensikan gambar, menandai markup ImageObject tanpa detail lisensi dan membaca sampel gambar yang disajikan untuk hak IPTC dan XMP-nya, yang dibutuhkan Google untuk lencana Licensable.
Versi bahasa dan wilayah dari setiap halaman dan apakah semuanya saling menunjuk: return link, self-reference, x-default, kode tidak valid, serta target yang di-canonical-kan dan noindex.
Bahasa hreflang dan Target hreflang untuk setiap halaman HTML, dengan daftar lengkapnya saat kursor diarahkan.
Menandai html lang yang hilang, kosong, atau tidak valid, serta nilai lang yang tidak sesuai dengan hreflang atau teks halaman itu sendiri.
Menandai return link yang hilang, self-reference yang hilang, dan return link yang mengarah ke URL yang di-canonical-kan.
Menandai x-default yang hilang di set halaman beranda serta target x-default yang rusak, noindex, atau di-canonical-kan.
Menandai target hreflang yang bukan 200, noindex, di-canonical-kan, di-disallow, atau tidak punya link masuk.
Memvalidasi setiap kode bahasa dan negara hreflang, dan menandai kode regional tanpa fallback khusus bahasa.
Menandai padanan lokal tanpa hreflang dan pasar sasaran yang tidak punya hreflang di halaman mana pun.
Membaca hreflang dari head HTML dan header HTTP Link, dan menandai set yang dideklarasikan dengan lebih dari satu metode.
Menandai respons yang berubah menurut Accept-Language dengan cara yang tidak dilihat Googlebot.
Kecepatan halaman: waktu respons, bobot halaman, Core Web Vitals, dan apa yang memperlambat first paint.
Menjalankan pemeriksaan lab Lighthouse pada satu halaman HTML per grup halaman selama crawl.
LCP, INP, dan CLS dari pengguna Chrome sungguhan di ponsel, persentil ke-75, dari kunci Chrome UX Report Anda.
Menggambar data lapangan sekitar 40 minggu dari Chrome UX Report History sejak hari pertama, satu titik per minggu, dengan garis batas baik dan buruk dari Google.
LCP, INP, dan CLS dari halaman HTML dengan link terbanyak di setiap grup halaman, sehingga template yang lambat langsung terlihat.
Membaca Chrome UX Report untuk origin, URL dengan link terbanyak di setiap grup halaman, dan 10 URL dengan link terbanyak, tanpa crawl.
Mengambil snapshot dengan sendirinya, harian secara default, atau mingguan atau bulanan, meski jendela aplikasi ditutup.
Memunculkan peringatan saat sebuah metrik turun nilainya atau kembali ke Baik, menurut batas Google.
Menampilkan pembacaan terbaru berdampingan, diwarnai Baik, Perlu peningkatan, atau Buruk, beserta tanggalnya.
Menetapkan 0 sampai 3 halaman HTML per grup halaman untuk setiap snapshot dan memberi tahu berapa permintaan Chrome UX Report yang dipakai.
Tingkat Audit situs membaca Core Web Vitals dari Chrome UX Report setelah crawl.
Menyimpan setiap snapshot di komputer Anda, melewati 28 hari yang ditampilkan Chrome UX Report.
Menandai kompresi teks yang nonaktif, CSS dan JavaScript yang tidak diminifikasi, masa cache yang singkat, dan halaman tanpa ETag atau Last-Modified.
Menandai permintaan yang memblokir render, pekerjaan main thread yang panjang, CSS dan JavaScript yang tidak terpakai, JavaScript lama, sumber daya HTTP/1.1, pihak ketiga yang lambat, dan skor Lighthouse di bawah 50.
Menandai respons server yang lambat, CLS di atas 0.1, dan Core Web Vitals di luar rentang baik, di data lab maupun lapangan.
Menandai halaman yang render JavaScript-nya memakan lebih dari 4 detik.
Menandai viewport yang hilang atau tetap, kunci zoom, dan teks di bawah 12 px CSS di ponsel.
Median, 9 dari 10, dan waktu respons paling lambat selama crawl berjalan, dengan 10 halaman paling lambat.
Apa yang menghalangi pengguna teknologi bantu memakai setiap halaman: nama, label, ARIA, landmark, heading, tabel, dan formulir.
Saat render aktif, menjalankan aturan axe-core dan uji perilaku pengunjung: kontras, fokus keyboard, focus trap, zoom 200%, reflow 320 px, dan target sentuh 24 px.
Menandai tombol, link, kolom formulir, gambar, dialog, dan frame tanpa nama yang dapat diakses, serta kolom yang namanya hanya dari atribut title.
Menandai role dan atribut yang tidak valid, atribut wajib yang hilang, role induk atau anak yang salah, dan role yang sudah usang.
Menandai halaman tanpa landmark main, landmark yang duplikat atau bersarang, level heading yang dilompati, dan tidak adanya cara melewati blok yang berulang.
Menandai tabel tanpa sel header, scope dan headers yang tidak valid, serta daftar atau daftar definisi yang strukturnya salah.
Menandai indikator fokus yang hilang, focus trap, tabindex positif, dialog yang tidak menahan fokus, dan area yang bisa di-scroll tanpa akses keyboard.
Menandai teks dengan kontras yang kurang, teks di bawah kontras yang ditingkatkan, dan link yang hanya dibedakan dengan warna.
Menandai zoom yang dinonaktifkan, teks terpotong pada zoom 200%, konten terpotong pada lebar 320 px, kunci orientasi, dan target sentuh di bawah 24 px.
Menandai video tanpa teks atau deskripsi audio, video tanpa suara tanpa alternatif, dan audio tanpa transkrip.
Menandai kolom tanpa label atau dengan beberapa label, nilai autocomplete yang tidak valid, kolom yang memblokir tempel, dan error tanpa teks.
Model lokal membaca halaman untuk 7 pemeriksaan yang butuh penilaian, seperti grafik tanpa padanan teks.
Apa yang boleh diambil crawler AI, apa yang mereka terima, dan bagaimana jawaban AI mengutip situs.
Meminta halaman sampel sebagai 10 agen AI (ChatGPT, Claude, Perplexity, crawler mereka, Meta AI, Google-Extended, Common Crawl) dan menampilkan siapa yang mendapat akses penuh dan apa yang diizinkan robots.txt.
Menilai llms.txt yang dipublikasikan, versi Markdown lewat header Accept, manifest penemuan agen, dan tool WebMCP; situs tanpa semua itu tidak ditandai.
Menandai halaman penting yang memblokir crawler pencarian AI atau membatasi snippet, serta aturan AI yang berbeda dari kebijakan tertulis Anda.
Menandai versi Markdown yang kosong atau berisi kurang dari separuh teks utama.
Menandai konten utama yang baru dimulai setelah 5,000 karakter pertama teks body.
Menandai overlay tak terlihat di atas tombol dan kolom, kontrol tugas yang sulit dilihat, dan keputusan checkout agen tanpa tanggal untuk Google UCP atau OpenAI ACP.
Menandai halaman penting yang men-disallow Applebot dan fetcher AI yang dipicu pengguna yang diblokir.
Menandai kutipan Bing AI yang menurun dan URL penting yang tidak pernah dikutip Bing AI, dari Bing Webmaster Tools.
Melaporkan sesi yang dirujuk AI beserta engagement-nya dibandingkan organik, dari Google Analytics 4.
Mengajukan hingga 20 prompt Anda ke ChatGPT dan Perplexity lewat akun DataForSEO Anda, lalu melaporkan penyebutan brand, URL yang dikutip, dan situs pihak ketiga yang dikutip sebagai gantinya.
Memberi tahu untuk setiap pencarian yang dilacak apakah Google menampilkan AI Overview dan apakah Anda dikutip, dari audit ke audit.
Crawl dengan GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot, dan user agent AI lainnya.
Menampilkan kunjungan crawler AI yang terverifikasi dan penolakan per URL dari log server.
Menjalankan prompt Anda sendiri di setiap halaman HTML (draf meta description, ide FAQ, search intent, entitas utama) dengan Ollama di komputer Anda atau dengan kunci Anthropic, OpenAI, atau Google Gemini Anda, dengan jawaban sebagai kolom.
Menjalankan 44 pemeriksaan yang butuh penilaian di seluruh kategori dengan model lokal lewat Ollama; tidak ada yang keluar dari komputer dan tandanya tidak dihitung.
Asisten AI yang dilayani, AI Overviews, apa yang disajikan ke setiap asisten AI, dan permintaan dari bot terverifikasi.
Untuk setiap pencarian yang dilacak, memuat AI Overview Google 3 kali lewat DataForSEO dan melaporkan berapa sumbernya yang ranking di halaman satu, apakah halaman Anda ranking di sana, dan apakah Overview itu mengutipnya, sebagai tanda Perlu dicek.
Schema markup di setiap halaman: valid, dengan peringatan, atau dengan error, serta kolom Tipe schema.
Memberi penilaian untuk setiap tipe schema pada sebuah URL.
Menandai halaman yang tidak memiliki tipe structured data atau rich result yang dimiliki grup halamannya.
Menandai harga produk yang tidak tampil di halaman, penawaran kedaluwarsa, tanggal yang tidak cocok, dan properti wajib yang hilang.
Menandai structured data dengan error sintaksis, properti wajib atau yang disarankan yang hilang, atau teks yang berbeda dari halaman.
Menandai markup Organization atau Person yang tidak punya properti identitas.
Memeriksa selektor Speakable, halaman berbayar tanpa isAccessibleForFree false, serta markup HowTo, QAPage, dan FAQ dibandingkan dengan halamannya.
Menandai rich result yang tidak valid serta error AMP atau rich result yang dilaporkan Google.
Membandingkan markup Organization dengan Google Business Profile, lewat DataForSEO.
HTTPS, mixed content, dan header keamanan yang dikirim setiap halaman.
Mencantumkan header keamanan yang dikirim setiap URL.
Menandai halaman HTTP, redirect HTTPS ke HTTP, sertifikat yang tidak valid atau hampir kedaluwarsa, serta TLS 1.0 atau 1.1.
Menandai skrip dan style eksternal tanpa hash integrity, serta formulir atau kolom kata sandi lewat HTTP.
Menandai Content-Security-Policy, Strict-Transport-Security, nosniff, proteksi clickjacking, atau Cross-Origin-Opener-Policy yang hilang, serta Referrer-Policy yang tidak aman.
Menandai halaman HTTPS yang memuat sumber daya HTTP atau protocol-relative, atau menautkan ke halaman HTTP.
Menandai header respons yang membuka server atau framework, dan Content-Type yang tidak sesuai dengan file-nya.
Menandai sertifikat yang tidak mencakup hostname yang dikirim lewat SNI.
Saat rendering aktif, menandai cookie pihak ketiga dan permintaan izin yang muncul saat halaman dimuat.
Login lewat halaman Google sendiri di browser Anda, hanya baca, lalu menggabungkan klik, impresi dan CTR ke setiap URL di setiap crawl.
Menggabungkan kunjungan dan engagement ke halaman crawl untuk pemeriksaan analytics, terhubung dengan login Google yang sama.
Menyimpan satu login per akun Google dan memakai akun milik properti untuk setiap situs.
Menanyakan properti Google Search Console dan Google Analytics 4 mana yang milik setiap situs, dengan properti situs itu sudah terpilih.
29 pemeriksaan yang menggabungkan data Google dengan crawl, misalnya URL noindex, di-redirect atau 4xx yang masih mendapat klik.
Menandai landing page organik dengan engagement 10 detik atau kurang, bounce 80% atau lebih, formulir tanpa key event, dan sesi organik di bawah 70% dari angka normal belakangan ini.
Menandai pencarian yang impresinya terbagi ke beberapa URL, atau yang paling sering menampilkan halaman beranda atau URL yang tidak dapat diindeks.
Melaporkan impresi dan klik per tampilan di penelusuran (search appearance).
Menandai ID GA atau GTM yang dimuat dua kali dan URL yang dapat diindeks tanpa ID GA atau GTM.
Mengurutkan pemeriksaan menurut klik dari URL yang ditandainya, jadi tanda yang menggerus traffic muncul paling atas.
Menyimpan setiap bulan data Google Search Console di komputer Anda setelah Google menghapusnya di usia 16 bulan, dengan Arsipkan sekarang dan jadwal bulanan.
Klik dan impresi per hari selama 28 hari terakhir dibandingkan 28 hari sebelumnya, dalam satu grafik.
Pencarian yang mendatangkan klik, dengan impresi dan posisinya.
Melacak hingga 25 pencarian per properti setiap hari dari Google Search Console: posisi selama 7 hari dan 90 hari, perubahan, klik dan impresi, dengan saran pencarian di posisi 4 sampai 20.
Memeriksa hingga 200 URL per crawl, mulai dari yang paling banyak diklik lalu yang paling banyak ditautkan.
Klik dan impresi dari Google Discover, disimpan bersama setiap bulan yang diarsipkan.
Menampilkan update ranking dan insiden Google selama dua tahun terakhir di atas grafik klik harian Anda, dengan klik sebelum dan sesudah setiap update.
Klik, kueri, error crawl dan URL terindeks dari Bing, dengan API key Anda dan tombol Uji yang menampilkan daftar situs Anda.
Ranking, jawaban AI, pesaing dan backlink lewat akun DataForSEO Anda sendiri, dibayar per permintaan.
Posisi mobile yang sebenarnya untuk setiap pencarian yang dilacak di 20 besar, dengan pesaing terbaik di sebelahnya.
Pencarian yang membuat pesaing masuk 20 besar sementara Anda tidak, lengkap dengan volumenya.
Membaca layanan yang Anda hubungkan setelah crawl dan menjalankan ulang pemeriksaannya pada crawl itu, tanpa crawl ulang.
Menampilkan berapa layanan yang terhubung di bilah status, di bawah properti di bilah samping dan sebagai blok Dasbor; masing-masing membuka Koneksi.
Menunjukkan permintaan yang dibuat setiap koneksi untuk sebuah properti dibandingkan kuota Google, semuanya dengan key dan akun Anda sendiri.
Setiap crawl menyertakan link ke laporan Masalah keamanan dan Tindakan manual di Search Console untuk properti itu, karena API Google tidak bisa membacanya, jadi Anda bisa membuka keduanya secara manual.
Menempatkan properti di samping para pesaingnya pada crawl terakhir mereka yang bisa dipakai, setiap metrik diberi warna menurut siapa yang unggul dan tertinggal, dengan selisih terhadap pesaing terbaik.
Mendaftar metrik yang diungguli pesaing, mulai dari selisih terbesar, dengan pemeriksaan di balik setiap angka.
Menerima seluruh daftar yang ditempel apa adanya, pesaing langsung sebagai primer (maksimal 5) dan tidak langsung sebagai sekunder, lalu mengantrekan crawl mereka sekaligus.
Membaca sitemap XML setiap pesaing lebih dulu, meng-crawl 750 URL secara default dan menawarkan 1,000, 2,500 atau 5,000 jika sitemap-nya berisi lebih banyak.
Menemukan situs yang mendapat ranking untuk pencarian yang sama lewat DataForSEO, dipilah menjadi primer dan sekunder.
Tidak pernah mengusulkan toko, aplikasi pesan-antar atau marketplace sebagai pesaing; Anda tetap bisa menambahkannya secara manual.
Meng-crawl pesaing di lokasi baru halaman berandanya ketika pesaing itu pindah ke domain lain.
Mengusulkan sub-portofolio "<properti> | Pesaing" untuk pesaing sebuah properti dan menjaganya tetap terikat ke properti itu.
Hanya menghitung pemeriksaan yang bisa dinilai oleh setiap crawl yang dibandingkan, dan tidak memeringkat apa pun terhadap crawl yang terhenti di tengah jalan.
Pencarian berperingkat, 10 besar, estimasi kunjungan dan referring domain untuk properti dan setiap pesaing, dari audit ke audit.
Referring domain dan backlink milik properti dan para pesaingnya, dari DataForSEO Backlinks.
Menampilkan setiap pesaing di bawah propertinya dengan bar untuk URL, tanda, dan tanda per URL sebagai perbandingan.
Kalender bulanan berisi setiap crawl dan proses terjadwal, yang sudah lewat maupun yang akan datang, dengan filter properti.
Crawl situs penuh yang berjalan sendiri harian, mingguan, setiap N minggu atau bulanan dengan pengaturan properti, walau jendela aplikasi tertutup.
Arsip Google Search Console sesuai jadwal, bulanan secara default.
Menunjukkan biaya crawl terjadwal sebelum ditambahkan: URL per proses dan jumlah proses per bulan.
Memberi notifikasi 15 menit sebelum crawl terjadwal dimulai, dan memberi tahu bahwa crawl berjalan walau jendela tertutup.
Memindahkan satu proses 1, 3, 6 atau 9 jam atau ke tanggal dan jam tertentu, atau melewatinya, sementara jadwalnya tetap pada iramanya.
Menghentikan crawl terjadwal dengan aman saat sedang berjalan dan memberinya waktu baru.
Mengulang Audit lengkap setiap bulan dari penjadwal; Neova menyelesaikan analisis dan PDF-nya saat aplikasi dibuka berikutnya.
Memunculkan peringatan saat nilai Core Web Vitals berubah, klik 7 hari terakhir turun 20% atau lebih, pencarian yang dilacak keluar atau masuk 10 besar atau turun 3 posisi, atau crawl baru punya tanda baru.
Menyimpan 300 peringatan terbaru, dengan Periksa sekarang dan Hapus peringatan.
Neova tetap berjalan saat jendelanya ditutup, di bilah menu dengan progres crawl di samping jam.
Mempertahankan ikon Dock atau hanya menyisakan ikon di bilah menu.
Menjalankan Neova saat login dengan jendela tertutup.
Halaman ponsel yang ditambahkan ke Layar Utama lewat kode QR: crawl terakhir setiap properti, Core Web Vitals, klik Google Search Console, pencarian yang dilacak, proses berikutnya dan crawl yang sedang berjalan, dikunci di Mac sebelum dikirim.
Mac mengirim ringkasan setiap 2 menit saat crawl berjalan dan setiap 15 menit di luar itu; ponsel mengecek setiap 2 menit dan menunjukkan seberapa baru datanya.
Membuat link untuk satu crawl yang sedang berjalan agar siapa pun bisa mengikutinya dan tahu kapan selesai, dengan key-nya sendiri, tanpa membuka apa pun selain itu.
Salinan layar langsung yang bisa dibuka siapa saja: progres, Rincian URL, URL Terbaru, Peta crawl langsung, Waktu respons, Redirect dan error, Pemeriksaan serta Link & Berita.
Halaman yang dibagikan bisa memberi notifikasi kepada pembacanya saat crawl selesai.
Setiap grup 3xx, 4xx, 5xx dan Tidak Ada Respons dari seluruh crawl, hingga 100 URL per grup, mulai dari yang paling banyak ditautkan.
Mengirim peringatan dan hasil akhir setiap crawl ke satu atau beberapa channel Slack lewat incoming webhook, dibuktikan dengan pesan uji.
Mengirim peringatan dan hasil akhir setiap crawl ke channel Teams lewat webhook Workflows.
Mengirim pesan setiap portofolio atau properti ke channel-nya sendiri.
Notifikasi sistem saat crawl selesai ketika Neova tidak sedang di depan, dengan suara yang bisa dipilih.
Mendaftar semua yang sedang dikerjakan Neova: crawl, audit, Jalankan pemeriksaan, crawl terjadwal dan antrean, masing-masing dengan tombol untuk membukanya.
Setiap angka yang punya nilai sebelumnya menunjukkan perubahannya sejak crawl sebanding sebelumnya.
Hanya mengambil daftar halaman, tanpa penemuan halaman baru, dan memunculkan peringatan halaman untuk perubahan status, tujuan redirect, title, canonical, noindex, H1 dan ukuran.
Kondisi crawl dalam sekejap: Ringkasan crawl, Pemeriksaan teratas, Tindakan berikutnya, Kode status dan Perubahan vs. crawl sebelumnya; setiap angka membuka daftarnya.
Setiap pemeriksaan yang punya tanda: tingkat keparahan, URL yang ditandai dari yang diperiksa, berapa yang dapat diindeks, perubahan sejak crawl sebelumnya, kategori dan klik.
Setiap pemeriksaan menjelaskan Ditandai saat, Biasanya artinya dan Yang bisa Anda lakukan, dengan ID, sumber dan Tentang pemeriksaan ini, yang membuka halamannya di pustaka pemeriksaan.
Setiap URL dengan set kolom, filter di kolom mana pun, tampilan tersimpan, pemilih kolom, kolom URL yang dibekukan dan 10, 25, 50 atau 100 baris per halaman.
Setiap tabel dan grid mengekspor isi yang ditampilkannya sebagai CSV.
Setiap kolom, angka dan kartu punya ⓘ yang menjelaskan apa yang dihitungnya.
Delapan grup dan 13 tab yang dibangun dari 39 blok: ringkasan, performa, teknis, Core Web Vitals, konten, kata kunci, pencarian AI, sosial, pesaing, update algoritma, alur kerja, program dan laporan.
Hingga 10 dasbor milik Anda sendiri, dibuat baru atau diduplikasi dari sebuah tab; blok bisa ditambah, dipindah, diubah ukurannya dan dihapus.
Rencana tindakan sebagai program menurut status dan pemilik, setiap item dengan pemeriksaannya dan tandanya di crawl terakhir; merah jika item yang ditandai Selesai masih ditandai.
Satu tiket per pemeriksaan dan grup halaman, Harus diperbaiki lebih dulu, dengan aturan, bukti, URL yang terdampak, kapan dianggap selesai, cara mengecek dan tempat memperbaikinya (template-nya jika 90% sebuah grup ditandai).
Crawl berikutnya menutup, mempertahankan atau membuka kembali setiap tiket berdasarkan key-nya, tidak pernah menghapusnya.
Mengawali setiap tiket dengan kode properti, misalnya [DRH], dan membawanya sebagai label ke Jira dan Linear.
Membuat satu tiket Jira per tiket Neova di proyek Jira Cloud Anda dengan prioritas, label dan daftar URL terlampir, tidak pernah dua kali.
Setelah setiap crawl penuh dari jendela aplikasi, memindahkan tiket yang sudah hilang ke Done, membuka kembali tiket yang muncul lagi dan memperbarui sisanya.
File yang dibentuk untuk impor CSV bawaan setiap alat: Jira, Linear, Asana, ClickUp, monday.com, Azure DevOps Boards, Notion, Airtable, Smartsheet, dan file to-do Markdown untuk Basecamp, masing-masing dengan halaman impornya.
Laporan klien dengan nama, logo dan warna Anda: crawl dalam angka, tanda per kategori, apa yang diperbaiki dulu dengan contoh URL, rendering dan visibilitas AI, perubahan sejak crawl sebelumnya dan cara crawl dilakukan, dalam ukuran Letter atau A4; pemeriksaan dari satu keluarga dihitung sekali, yang kedua dicantumkan sebagai Juga ditandai.
Memberi setiap klien nama, logo dan warnanya sendiri di laporan, dengan Disiapkan untuk, Disiapkan oleh dan catatan.
Satu workbook: Ringkasan, Tiket menurut urutan perbaikan, Per grup halaman, satu sheet per pemeriksaan dengan 1,000 URL yang paling banyak diklik lalu paling banyak ditautkan, dan Semua tanda.
Setiap halaman HTML yang menjawab 200, hingga 200,000, dengan title, description, H1, canonical, status dapat diindeks, kedalaman, link masuk, sitemap, ukuran, waktu respons, klik dan tanda.
Mengirim workbook ke Google Drive Anda, dikonversi menjadi Google Sheets.
Satu ZIP berisi apa yang Anda pilih: PDF, workbook versi detail atau ringkas, tiket dengan daftar URL-nya, file Jira dan Linear, dan setiap URL yang ditandai sebagai satu CSV per pemeriksaan, dengan README.
URL, tanda dan tiket sebagai file CSV, untuk CSV, Excel (UTF-8 dengan BOM), Google Sheets dan Looker Studio.
Setiap ekspor menyertakan catatan jika crawl berjalan tanpa rendering atau hanya mencakup sebagian situs.
Menyimpan ekspor di Unduhan secara default, dalam folder ekspor Neova.
Menyimpan ekspor ke folder yang Anda pilih di komputer.
Mengunggah ke akun Google yang login di Neova lewat antarmuka Google Drive sendiri, ke folder ekspor Neova milik akun itu, menggantikan file bernama sama agar link berbaginya tetap berfungsi; Neova hanya melihat file miliknya sendiri.
Menyimpan ke folder yang disinkronkan aplikasi Google Drive, OneDrive, Dropbox, iCloud Drive, Proton Drive dan kDrive di Mac (OneDrive, Dropbox dan Google Drive di Windows); setiap akun nonaktif sampai Anda mengaktifkannya.
Mengunggah ekspor ke server Anda sendiri lewat SFTP dengan password atau file key, FTPS, atau FTP biasa; koneksi diuji sebelum disimpan dan key server diingat.
Menyimpan ekspor setiap portofolio atau properti di folder atau drive-nya sendiri.
Di Neova Online, menulis ekspor langsung ke folder di komputer Anda di Chrome, Edge, Vivaldi, Brave dan Arc; browser lain mengunduhnya.
Di Neova Online, ekspor berupa folder seperti tabel CSV atau halaman Markdown diunduh sebagai satu ZIP.
Satu link hanya baca untuk sebuah portofolio atau properti, berisi crawl, Rencana tindakan, analisis, pesaing dan file yang Anda centang, dienkripsi di komputer Anda dengan key yang hanya ada di dalam link; Perbarui mempertahankan alamatnya dan Nonaktifkan menghapusnya.
Apa yang dikerjakan dan urutannya: disusun dari crawl (Harus diperbaiki dulu, lalu klik, lalu jangkauan), diurutkan ulang dan disunting oleh Anda, dengan item Anda sendiri, status, pemilik dan catatan, tersimpan dari crawl ke crawl.
Menyalin rencana sebagai Markdown atau mengekspornya sebagai CSV.
Menulis audit lengkap di komputer Anda: kondisi saat ini, tanda yang diprioritaskan, visibilitas pencarian, pencarian yang dilacak, keyword gap dan tindakan prioritas sudah terisi, dengan bagian yang hanya bisa ditulis manusia diberi tanda Untuk ditulis.
Menyimpan laporan yang Anda tambahkan (Markdown, teks, PDF atau Word) bersama properti, dengan Tandai sudah ditinjau.
Membuka email ke Neova Labs yang sudah berisi angka-angka crawl, untuk bagian yang tidak ditulis oleh pemeriksaan mana pun.
Satu kali jalan untuk setiap langkah: crawl dengan semua pemeriksaan aktif, Google, Bing dan Analytics, Core Web Vitals, pesaing dan crawl mereka, data pencarian DataForSEO, Rencana tindakan, analisis dan PDF bermerek.
Jalankan audit lengkap menanyakan apakah membaca crawl terakhir atau crawl ulang, dengan jumlah URL-nya dan waktu yang dibutuhkan.
Crawl A dibandingkan Crawl B: URL baru, dihapus dan berubah, tanda baru dan teratasi, Crawl B diberi warna lebih baik atau lebih buruk.
Semua yang disimpan untuk sebuah properti melewati masa simpan sumbernya sendiri: setiap crawl, setiap bulan Google Search Console, setiap snapshot Core Web Vitals, versi robots.txt, sitemap XML dan perubahan URL.
Setiap saran, tiket dan laporan menyertakan catatan bahwa isinya perlu ditinjau sebelum diterapkan, karena Neova melihat halamannya, bukan bisnis di baliknya.
Crawl terjadwal mengirim hasil akhirnya ke Slack dan Teams, dan Audit lengkap bulanan membuat PDF-nya saat Neova dibuka berikutnya; belum ada file ekspor yang ditulis sesuai jadwal.
Laporan PDF dan workbook menjelaskan cara halaman di-render (secara keseluruhan, per grup halaman dan per halaman), apa yang boleh diambil setiap crawler AI menurut robots.txt dan apa yang diberikan server kepadanya, serta pemeriksaan Pencarian AI mana yang lolos atau ditandai.
Google Sheet yang dibangun khusus untuk Sheets dari crawl: Ringkasan dengan grafik, Rencana tindakan dengan drop-down Pemilik, Status dan Tenggat, Masalah, URL, Tanda, Grup halaman, Redirect & Error, Rendering & AI dan Tentang, disimpan ke akun Google Anda sebagai file baru setiap kali.
Setiap file yang dibuat Neova dari sebuah crawl (Paket klien, PDF, workbook, Google Sheet, ekspor, file Neova) tercantum dengan lokasi tujuannya, crawl, tanggal dan ukurannya, dengan Buka, Buka folder, Salin jalur dan Buka di Google Drive.
Jendela Neova yang sama di browser di app.neova.app, dengan mesinnya di server Neova, yang melakukan crawl dan pemeriksaan di sana.
Akun dibuka dari link undangan, atas nama tertentu atau terbuka; satu link untuk satu akun.
Password disimpan dalam bentuk hash, login berlaku 30 hari sejak kunjungan terakhir Anda, jeda setelah 10 kali password salah, permintaan dari situs lain ditolak, dan pemberitahuan jika halaman dibuka di browser bawaan aplikasi lain.
Crawl, data dan unduhan setiap orang ada di folder miliknya sendiri, tidak pernah bisa dibaca orang lain.
Satu pekerjaan per orang dalam satu waktu, 10,000 URL per crawl, 10 URL per detik dan 10 GB crawl per akun selama Neova Online masih diuji.
Menghubungkan Google Search Console, Google Analytics 4 dan Google Drive dari browser, dengan login yang disimpan di ruang Anda sendiri.
Key dan webhook disimpan di akun Neova Online Anda dan tidak pernah ditampilkan lagi.
Setiap akun baru dimulai dengan Demo: toko uji coba dan tiga pesaing yang sudah di-crawl, dengan pengaturan portofolio, kode dan Rencana tindakan, yang bisa dihapus dalam satu langkah.
Sebuah undangan bisa membawa portofolio yang disalin dari akun lain beserta crawl terakhir, pengaturan dan rencananya, dengan banner selama semuanya disiapkan.
Jendela menyesuaikan diri di ponsel dan tablet: bilah samping menjadi laci, sheet memenuhi layar dalam satu kolom, tabel digulir ke samping.
Aplikasi desktop login sekali ke Neova Online; aplikasi menyimpan key untuk komputer itu, tidak pernah password-nya.
Menjaga portofolio, pesaing, urutan Anda, pilihan Google Search Console dan Google Analytics 4, warna dan kode tetap selaras dengan sendirinya.
Jika satu sisi sudah berisi konten sisi lainnya, login langsung menggabungkannya tanpa bertanya; jika keduanya memang berbeda, Neova menanyakan dari mana memulai: Pertahankan milik Neova Online, Pertahankan milik Mac ini atau Gabungkan Keduanya (disarankan, tidak ada yang hilang), dengan jumlah data di setiap sisi dan cadangan yang disisihkan lebih dulu.
Mengunggah atau mengunduh crawl utuh dalam bagian-bagian yang bisa dilanjutkan dan dicek di akhir, berdampingan dengan crawl yang sedang berjalan.
Mengirim setiap crawl yang selesai di komputer ini ke Neova Online; nonaktif secara default.
Neova Online menampilkan versi baru saat halaman dimuat berikutnya, tidak pernah jendela lama dari cache.
Menyediakan installer dan video tutorial untuk tester, dengan noindex.
Membawa key koneksi yang disimpan akun Neova Online Anda ke komputer ini, atau mengirim key komputer ini ke akun itu, setelah Anda memasukkan password; hanya 4 karakter terakhir setiap key yang ditampilkan, dan key tidak pernah diganti kecuali Anda mencentang Ganti.
Setiap akun Neova Online boleh menyimpan 10 GB crawl; Pengaturan menunjukkan berapa banyak isi akun dan berapa crawl-nya, memberi peringatan mulai 85%, dan unggahan atau crawl yang melebihi ruang ditolak dengan penjelasan apa yang harus dilakukan.
Neova SEO Platform untuk Mac, dengan mesinnya terpasang sebagai kode native, melakukan crawl di komputer Anda.
Installer Windows x64 untuk akun Anda sendiri, tanpa perlu password administrator; build tester, belum ditandatangani.
Di Windows, aplikasi menyebut PC ini dan memakai Ctrl untuk setiap pintasan ⌘.
Aplikasi desktop di Linux: .deb untuk Ubuntu, Linux Mint dan Debian, serta AppImage yang tidak perlu diinstal.
Jendela aplikasi dan pustaka pemeriksaan dalam bahasa Inggris, Prancis, Jerman, Spanyol, Portugis (Brasil), Italia, Jepang, Belanda, Polandia, Turki, Korea, Tionghoa (sederhana), Rusia, Indonesia dan Vietnam.
Neova Marmer (default), Neova, macOS, Liquid Glass, Windows 11, Linux, Terminal dan Kontras tinggi; tampilan mengubah warna, tidak pernah letak elemen.
Terang, gelap atau mengikuti pilihan sistem, dengan warna aksen.
Baris Ringkas atau Nyaman dan teks yang bisa diperbesar-perkecil dengan ⌘+ dan ⌘−.
Menampilkan URL sebagai path atau dengan protokol dan host, di setiap tabel.
Menulis tanggal dan waktu sesuai cara Anda atau cara bahasa yang dipilih.
Menampilkan atau menyembunyikan baris Beranda; nama Neova di kiri atas tetap membuka Beranda.
⌘N Crawl baru, ⌘K Cari properti, ⌘, Pengaturan, ⌘[ Kembali, ⇧⌘P Mode presentasi, ⌘/ Tanya atau cari.
Satu kolom untuk menemukan tampilan, pemeriksaan menurut judul atau ID, halaman dari crawl, properti atau pengaturan, dengan pilihan terakhir tetap tersimpan.
Pertanyaan yang lebih panjang dikirim ke model di komputer Anda, yang memilih jawaban dari apa yang sudah ditampilkan jendela, jadi tidak pernah mengarang angka.
Mengaburkan semua portofolio kecuali yang sedang dibuka, untuk berbagi layar dengan klien.
Kembali ke layar sebelumnya, yang namanya tertulis di tombol.
Satu focus ring, setiap baris bisa dijangkau dengan Tab, tombol panah di dalam tabel, sheet sebagai dialog, dan pengaturan kurangi gerakan dihormati.
Seret bilah samping, daftar pemeriksaan dan panel detail ke lebar yang Anda inginkan.
Keluar bertanya sekali saat crawl sedang berjalan, lalu menyimpannya dengan langkah dan progres yang ditampilkan, dan Lanjutkan meneruskannya nanti.
Menyebutkan crawl terjadwal yang berjalan di latar belakang dan menawarkan untuk menghentikan dan menyimpannya sebelum keluar.
Crawl yang sedang berjalan saat Neova diperbarui menyimpan dirinya sendiri dan diteruskan dengan Lanjutkan.
Saat dihentikan, hanya HTML baru yang ditambahkan, dan setiap langkah penyimpanan ditampilkan dengan bar dan Tutup sekarang.
Memantau ruang disk kosong selama crawl, memberi peringatan saat hampir penuh dan berhenti dengan aman di bawah 3 GB, sehingga Lanjutkan bisa meneruskan crawl setelah ruang dikosongkan.
Crawl yang terputus karena crash atau pipe yang tertutup tercantum sebagai terinterupsi, tidak pernah dibuang, dan penyimpanannya dikembalikan dengan aman.
Antrean dan audit tetap berjalan saat jendela disembunyikan.
Mengecek app.neova.app untuk build yang lebih baru saat aplikasi dibuka, setiap 30 menit dan saat jendela kembali ke depan, hanya dengan mengirim nomor versi.
Menyalin pengaturan jendela ke sebuah file setelah setiap perubahan, satu cadangan per versi, dan dipulihkan jika penyimpanan jendela di-reset.
Memindahkan lokasi tempat Neova menyimpan crawl-nya.
Ikon menampilkan Neova SEO di bawah laba-laba mulai ukuran 64 px.
Build yang lebih baru menampilkan Versi Baru Tersedia di kiri atas, di bilah alat, paling atas di Bantuan dan di Pengaturan › Umum, dengan Unduh; aplikasi mengecek setiap 30 menit dan saat jendela kembali ke depan.
Setiap tabel menyesuaikan lebar kolom dengan isinya, memberikan sisa lebar ke URL dan ke kolom yang terpotong lebih dulu; setiap kepala kolom punya pegangan untuk diseret, klik dua kali untuk memaskan, dan lebar yang Anda atur tetap tersimpan.
Maskot animasi opsional, 8 pilihan (Webster, The Head, Sir Canonical, Polly Glot, Hopper, Shelly, Bo, Zap), lucu atau pixel art, yang mengawasi crawl Anda; bawaannya Tidak ada, dan dengan Tidak ada, tidak ada yang dimuat.
Gelembung percakapan saat sebuah crawl membutuhkan Anda: crawl selesai dengan pemeriksaan Harus diperbaiki dan berapa yang baru, crawl berhenti atau gagal, situs memblokir crawler, disk hampir penuh, crawl terjadwal dimulai; satu klik membuka layar yang disebutkannya.
Klik maskot untuk tahu apa yang sedang dilakukan Neova dan, saat sebuah crawl terbuka, ajukan pertanyaan tentangnya; jawabannya lewat jalur yang sama dengan bilah Tanya (Ollama di komputer Anda atau kunci AI Anda sendiri).
Di desktop, maskot punya jendela sendiri di atas semua jendela dan di setiap Space, di luar Dock; Neova tetap mengawasi saat diperkecil dan satu klik membawanya kembali ke layar yang tepat.
Tujuh ukuran dari Mungil (56 px) sampai Kolosal (320 px), bawaannya Besar, dan bilah alat di bawah maskot: Buka Neova, Crawl baru, Sedang berjalan, dan Lainnya (sembunyikan, pengaturan, bisukan), saat diarahkan atau selalu.
Crawl disimpan di Application Support/Neova di Mac dan %APPDATA%/Neova di Windows; tidak ada yang dikirim ke Neova kecuali Anda melakukan sinkronisasi atau berbagi.
Setiap key, token dan login masuk ke keychain sistem lewat standard input mesin, tidak pernah lewat file, command line atau layar.
Aplikasi tidak membawa key milik Neova: Google, Chrome UX Report, DataForSEO dan layanan lain memakai key dan akun Anda sendiri.
Mesin dikirim sebagai kode native tanpa source yang bisa dibaca.
Google dihubungkan dengan scope hanya baca ditambah email Anda; Putuskan mencabut token di Google.
DataForSEO nonaktif kecuali Crawl baru mengaktifkannya untuk crawl itu.
Sebelum Mulai, memperkirakan biaya dari tarif DataForSEO untuk 20 panggilan terakhir setiap jenis dari komputer ini, atau dari daftar harganya, dibulatkan ke atas ke $0.50 atau dolar berikutnya.
Berhenti meminta data ke DataForSEO begitu batas yang Anda atur tercapai, $0.50 sampai $10 per crawl, $1 secara default.
Data pencarian Audit lengkap berhenti di batasnya sendiri dalam dolar AS dan menunjukkan berapa yang sudah dibelanjakan.
Log server dibaca di komputer Anda; tidak ada alamat IP yang ditulis di mana pun.
Tinjauan AI dan Tanya memakai model di komputer Anda lewat Ollama, jadi tidak ada yang keluar dari komputer; Prompt AI memberi tahu saat teks halaman dikirim ke penyedia yang Anda pilih.
Link berbagi, Neova Go dan Bagikan progres dienkripsi di komputer Anda dengan key yang hanya ada di link atau kode QR, jadi server menyimpan apa yang tidak bisa dibacanya.
Berbagi halaman glosarium mana yang Anda buka nonaktif secara default, dan hanya mengirim ID acak, pemeriksaan dan bahasanya.
Crawl yang dihapus masuk ke Tempat Sampah dan bisa dikembalikan, dengan pemilihan massal untuk crawl lama yang sudah dihentikan.
NeovaBot menyebutkan identitasnya, mematuhi robots.txt dan 3 URL per detik secara default, dan tidak pernah memecahkan CAPTCHA.
Menyimpan sebuah crawl, sebuah properti dengan semua crawl dan datanya, atau sebuah portofolio sebagai satu file .neova, dengan atau tanpa HTML yang tersimpan, ke Unduhan, Google Drive, drive atau folder mana pun; jadwal, koneksi, key dan password tidak pernah ikut di dalamnya.
Memasang file .neova yang dibuat di komputer Mac, Windows atau Linux mana pun, memberi tahu apa yang baru, apa yang sudah ada atau masuk dengan nama lain sebelum apa pun ditulis, dan tidak pernah menggantikan isi komputer ini.
Perintah neova melakukan crawl, impor, publikasi dan membaca situs, halaman, tanda, tiket dan peringatan dari Terminal atau skrip, sebagai tabel, CSV atau JSON.
neova check membandingkan crawl dengan baseline dan keluar dengan kode 3 jika ada tanda baru, atau tanda yang bertambah melewati porsi URL tertentu.
Memberi asisten AI akses baca ke crawl, tanda, tiket dan pengaturan Anda lewat 16 tool, dengan data tetap di komputer Anda.
Menambahkan Neova ke Claude Desktop dengan sekali klik, dengan setup yang bisa disalin untuk Claude Code, Codex, Cursor, VS Code, Gemini CLI, LM Studio, Windsurf dan ChatGPT.
Memulai, menghentikan dan menghapus crawl dari asisten, dengan persetujuan Anda diminta lebih dulu untuk setiap mulai dan hapus.
Membaca log sebuah crawl dan menyebutkan apa yang salah (rentetan 429 atau 503, 403, blokir robots.txt, halaman yang hanya JavaScript, halaman terlalu sedikit) beserta pengaturan yang perlu diubah.
Satu file JSON biasa berisi daftar pengecualian, default, serta pengaturan dan sakelar pemeriksaan setiap properti.
Membuka ekspor Internal Screaming Frog (dengan All Inlinks), ekspor URL Sitebulb, JSON SiteOne Crawler atau CSV apa pun yang punya kolom URL, lalu menjalankan pemeriksaan Neova di atasnya.
Menilai hasil impor dengan mengambil ulang sampel 50 URL pada 2 URL/detik dan membandingkannya dengan sitemap live, jadi impor tidak pernah berpura-pura menjadi crawl.
HTTP API Neova Online di app.neova.app/api/v1: membaca portofolio, properti, crawl, tanda dan tiket, memulai crawl, dan mengelola tiket, setiap skrip dengan key Hanya baca atau Baca-tulis sendiri, 60 permintaan per menit per key dan 20 key per akun.
Permintaan dari mesin pencari dan crawler AI per URL crawl, dari log akses situs itu sendiri.
Menghitung permintaan sebagai Googlebot, Bingbot atau crawler AI hanya jika alamatnya ada di daftar yang diterbitkan perusahaannya; nama yang dipakai pihak lain dihitung terpisah.
Mendaftar halaman HTML yang tidak pernah dikunjungi Googlebot dalam rentang log dan URL yang diminta bot tetapi tidak dikenal crawl.
Menghitung jawaban 429 dan 403 yang diterima setiap bot.
Membaca log combined Apache atau Nginx, biasa atau di-gzip.
Untuk situs di belakang Cloudflare, mengumpulkan permintaan mesin pencari dan crawler AI di akun Cloudflare Anda sendiri dan membacanya sebelum setiap crawl, tanpa perlu akses server.
Menulis permintaan untuk dikirim ke tim IT: hanya baris crawler, tidak ada yang perlu diinstal, dan apa yang perlu diketahui tim keamanan.
Blok Dasbor berisi permintaan dari bot.
Mencocokkan setiap URL dari crawl situs lama ke crawl situs baru dengan tingkat keyakinan, untuk migrasi di domain yang sama maupun domain lain.
Mengecek redirect live setiap URL lama terhadap peta dan menandai yang salah atau tidak ada.
Membandingkan crawl staging dengan produksi: kode status, noindex, canonical, title, meta description, H1 dan URL yang hanya ada di satu crawl.
Menukar crawl mana yang lama dan baru, atau staging dan produksi.
Mengabaikan robots.txt dan berjalan lebih cepat di situs yang Anda konfirmasi sebagai milik Anda, dengan autentikasi HTTP dan header kustom.
Meng-crawl daftar URL lama untuk mengecek ke mana setiap URL berakhir.
Jika halaman awal subdomain staging sebagian besar menautkan ke situs live, Crawl baru menampilkan jumlahnya dan menambahkan aturan Penulisan ulang URL serta sitemap XML situs live dengan sekali klik; sitemap XML yang ditambahkan tanpa aturan yang memindahkannya ke situs ditandai sebelum crawl dimulai.
Setiap properti Anda sebagai blok dengan warna, logo dan angka utamanya, dengan pesaingnya sebagai baris di bawahnya.
Seret properti ke urutan Anda sendiri, tersimpan di Mac, online dan di ponsel.
Menciutkan satu keluarga menjadi satu baris, Ciutkan semua dan Bentangkan semua, dan kolom pencarian tersemat yang dibuka dengan /.
Tabel semua properti dengan setiap pesaing bersarang di bawah propertinya.
Satu pusat per situs: crawl, Untuk klien, Core Web Vitals, Google Search Console, pesaing, Rencana tindakan, analisis dan jadwalnya.
Laporan bermerek (PDF), Workbook semua tanda (Excel) dan tiket, satu tombol untuk masing-masing, dibuat dari crawl yang sedang dibuka.
Setiap tombol di kepala halaman Properti menjelaskan fungsinya dan bedanya dengan tombol lain.
Mengelompokkan properti menurut klien atau perusahaan, dengan warna, dan sub-portofolio satu tingkat.
Memberi setiap properti sebuah warna dan kode 2 hingga 6 huruf yang disarankan dari domainnya.
Menemukan properti dengan ⌘K, yang disematkan dan sedang berjalan lebih dulu, setiap portofolio dengan properti dan pesaingnya di bawahnya.
Lima crawl terbaru properti beserta hasil akhir masing-masing, sekali klik untuk membukanya.
Memilih crawl lewat kotak centang atau Pilih crawl lama yang dihentikan dan terhenti, lalu Hapus yang dipilih.
Setiap baris daftar punya satu tombol utama, lalu ⋯ dan klik kanan dengan semua tindakan, Hapus paling akhir dengan warna merah.
Pustaka pemeriksaan di app.neova.app/checks, Bantuan Neova SEO Platform, Yang Baru, Laporkan masalah, pintasan keyboard dan Periksa pembaruan.
Unduh, instal, crawl pertama Anda, Neova Online dan aplikasi desktop, koneksi opsional dan changelog, di app.neova.app/help.
Semua 694 pemeriksaan per grup di app.neova.app/checks, masing-masing dengan halaman dan sumbernya sendiri, dibuka dari Tentang pemeriksaan ini di mana pun sebuah pemeriksaan disebut.
Menyampaikan sekali bahwa hasil Neova adalah analisis otomatis untuk informasi, dan Anda yang memutuskan apa yang diubah.
Panel setiap pemeriksaan punya Tentang pemeriksaan ini, yang membuka halaman pemeriksaan itu sendiri di pustaka pemeriksaan, dengan apa yang ditandainya dan sumbernya.
Setiap versi sejak build pertama, yang terbaru lebih dulu, setiap perubahan berlabel Baru, Lebih Baik atau Diperbaiki dengan waktu rilisnya di zona waktu Anda, terbuka sendiri sekali setelah update; Segera hadir di bagian atas mendaftar apa yang direncanakan.
Membuat satu ZIP untuk tim dukungan berisi versi aplikasi serta log dan file kecil dari crawl yang dipilih, dengan rahasia disamarkan, dan sebelum ZIP dibuat memberi tahu apa isinya dan apa yang tidak pernah dimasukkan.
Tidak ada fitur yang cocok dengan pencarian itu.
Paket Free, atau 14 hari Desktop gratis, tanpa kartu. Mac, Windows dan Linux. Crawl Anda tetap di komputer Anda.
Unduh NeovaNeova Online, Neova yang sama di browser, termasuk dalam Desktop + Online dan Agency: lihat paketnya.