Сканируйте несколько сайтов сразу и следите за этим вживую
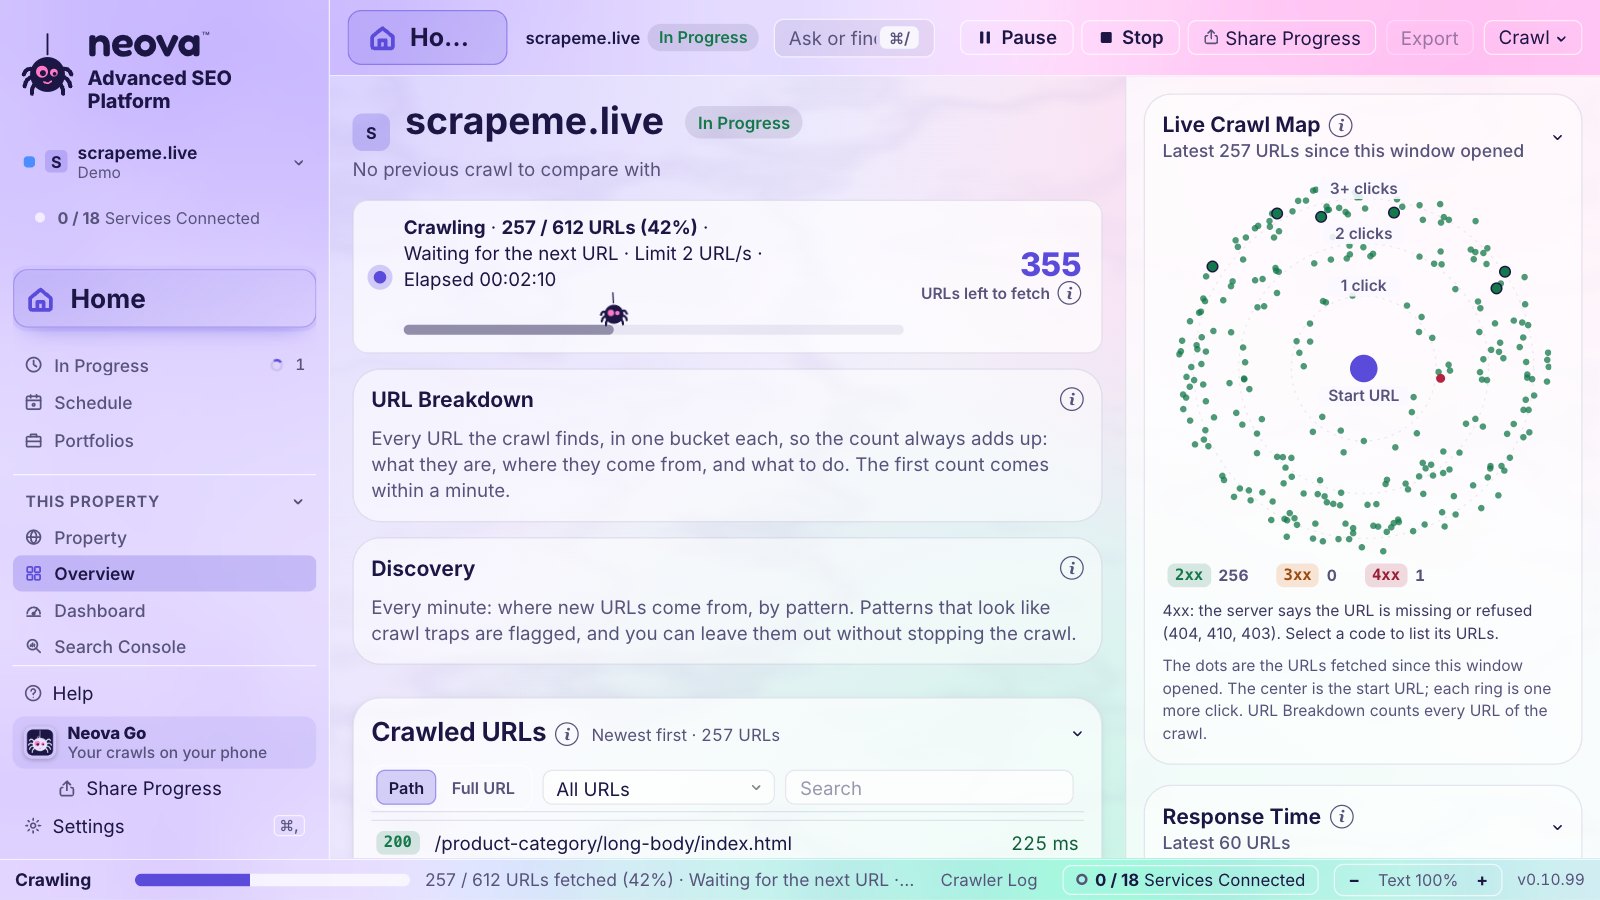
Несколько сайтов сразу, каждый в своём темпе, на живой карте каждого URL по мере поступления.

Создан SEO-специалистами для SEO-специалистов. Neova сканирует с вашего компьютера, а затем говорит, какие отметки важны и что исправить первым, пишет задачи, готовит отчёт для клиента и присматривает за сайтом. Две минуты видео, а дальше - всё подробно.
Сканирование - это только начало. Вот что Neova делает с его результатами.
Несколько сайтов сразу, каждый в своём темпе, на живой карте каждого URL по мере поступления.

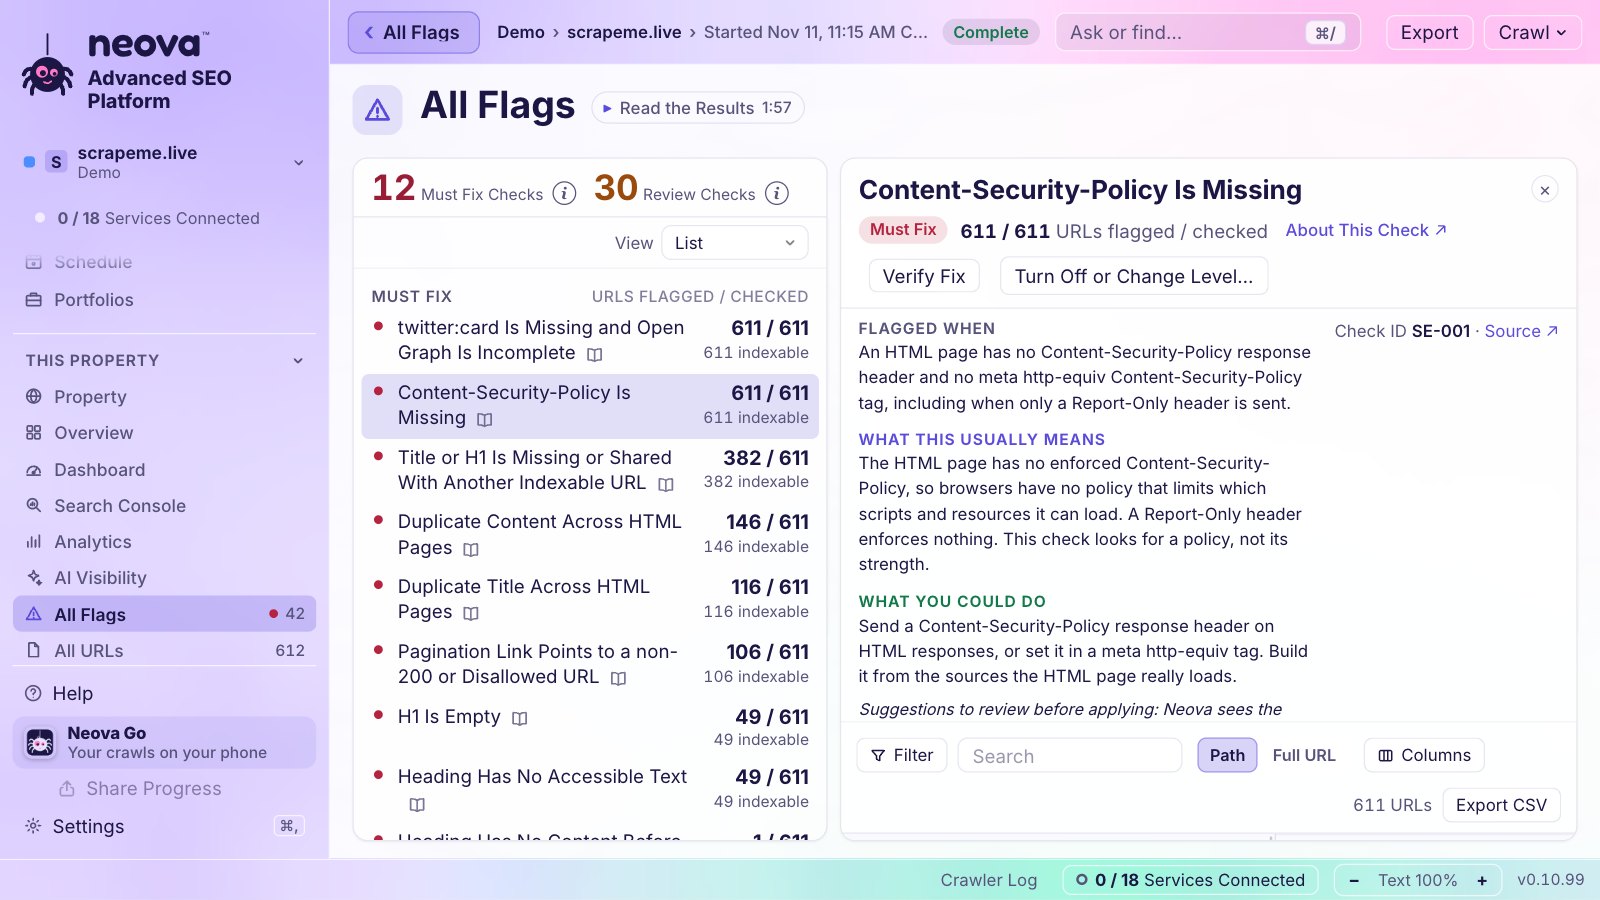
Каждая отметка объясняет, почему сработала, что обычно значит и откуда взято правило.

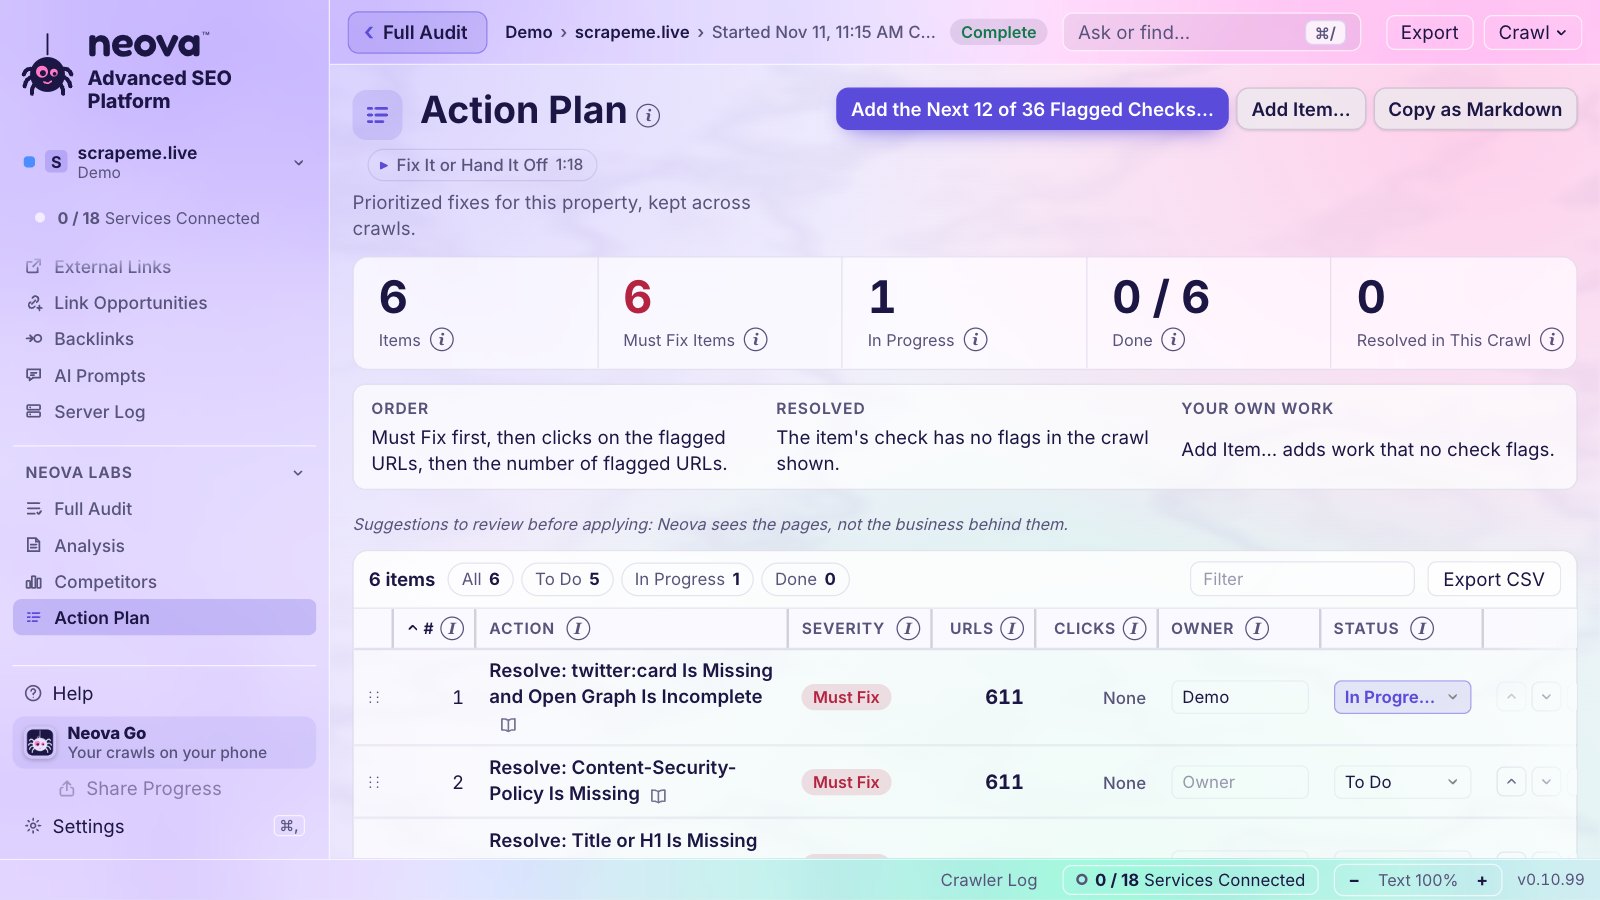
Отметки становятся работой: ответственные, статус, сначала «Нужно исправить», и всё сохраняется от сканирования к сканированию.

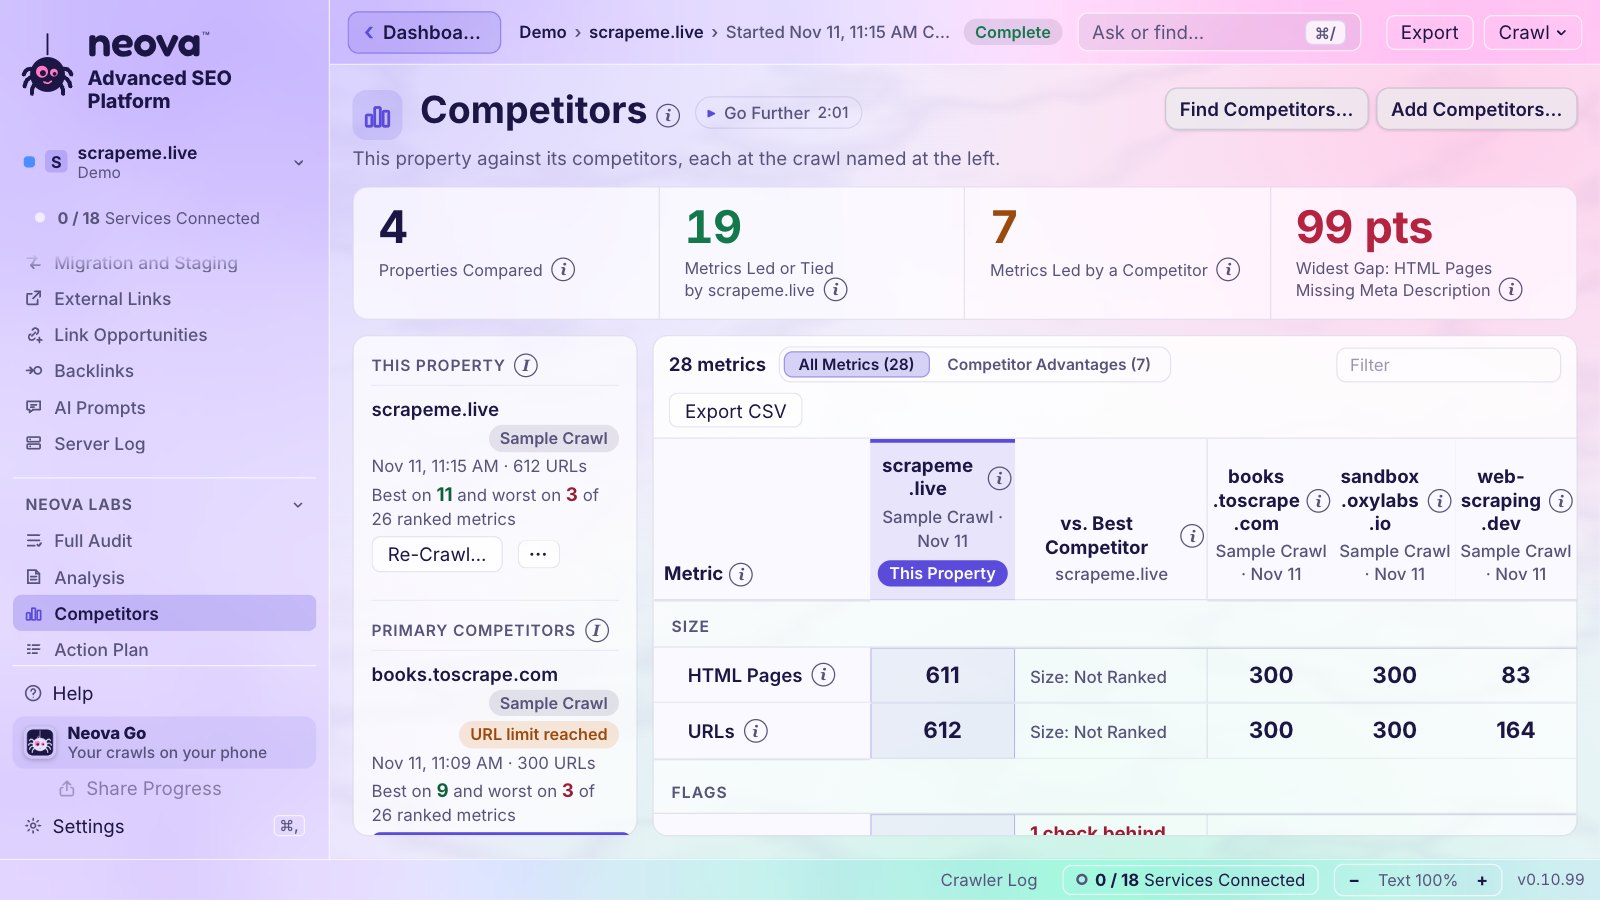
Вставьте список. Neova рассчитывает каждое сканирование по их картам сайта и показывает, кто впереди, по каждой метрике.

Что получают реальные посетители на телефонах, по группам страниц, с оповещением при смене оценки.

Откройте их экспорты и запустите проверки Neova по их находкам. Оставьте инструменты, которые вам нравятся.
Закройте окно. Сканирование продолжается в строке меню, а телефон показывает все ресурсы.

Всё, что получает клиент, из одного места, с шифрованием на вашем компьютере до того, как вы поделитесь ссылкой.
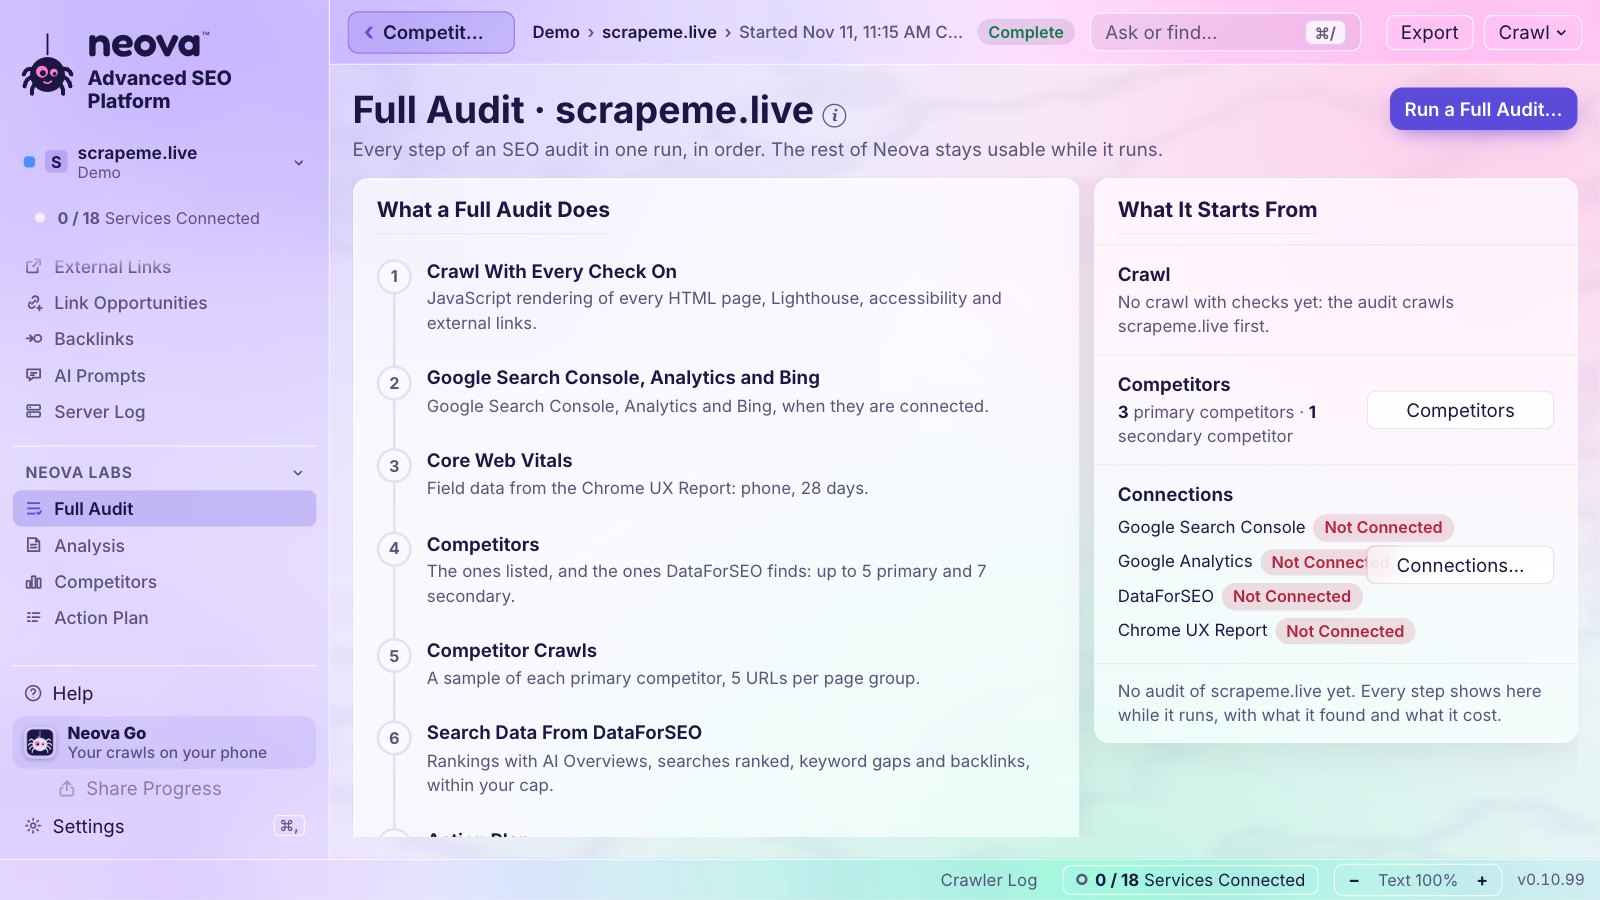
Сканирование, Google, Bing и Analytics, Core Web Vitals, конкуренты, план и PDF за один запуск.

Анимированный талисман, который сидит на рабочем столе и присматривает за вашими сканированиями. Он сообщает, когда сканированию нужно ваше внимание, отвечает на вопросы о сканировании и одним щелчком открывает нужный экран. Необязателен и выключен, пока вы его не выберете.
31 сервис, и все необязательны: Neova делает свою работу без любого из них, а с ними делает больше.
Откройте область, чтобы увидеть все её функции, или ищите по всем.
Лог сканирования в реальном времени: каждый загруженный URL с цветным кодом ответа и временем ответа, каждый шаг жирным, сбои красным, предупреждения жёлтым; Copy Log сохраняет все строки для поддержки.
Идёт по внутренним ссылкам от стартового URL и по XML-картам сайта, если они включены, так же, как поисковик находит сайт.
Сканирует только URL, которые вы вставили или загрузили из файла, и ничего больше.
Читает сайт до начала сканирования и выбирает версию (http или https, с www или без), которая отвечает 200, и сообщает, что делают остальные версии.
Спрашивает, сканировать ли найденные Neova поддомены и какие именно.
Сканирует весь сайт без ограничения по числу URL, если вы его не задали.
Сканирует только указанные вами папки и оценивает полноту по URL из XML-карты сайта внутри них.
Сканирует заданное число страниц из каждой группы страниц, так что большой сайт проходит аудит за минуты, и каждый шаблон охвачен.
Три уровня в одном выборе: Только сканирование, Аудит сайта (добавляет Core Web Vitals и черновик Плана действий) и Полный аудит (добавляет конкурентов, поисковые данные и анализ).
Добавляет стартовые URL из файла TXT или CSV или вставленные вручную, чтобы дойти до страниц, на которые не ведёт ни одна ссылка.
Сканирует URL из XML-карт сайта, указанных в robots.txt, после страниц, до которых дошли ссылки.
Читает дополнительные XML-карты сайта, которые вы укажете, помимо объявленных в robots.txt, при каждом сканировании ресурса.
Выбирает, что сканировать помимо HTML-страниц: изображения, CSS, JavaScript и PDF.
«Сначала страницы» загружает все HTML-страницы раньше изображений и файлов, чтобы основа аудита была готова первой; «По глубине» начинает с ближайших к стартовому URL.
Записывает ссылки из меню, футера и фильтров, не переходя по ним; по ссылкам из основного контента переходит всегда.
Сканирует или пропускает URL по шаблонам regex, по одному в строке, с полем, чтобы проверить на них любой URL.
Один список исключений для всех сканирований, кто бы их ни запустил: окно, расписание или ИИ-ассистент.
Переписывает URL по правилам regex до сканирования: например, убирает параметры отслеживания или переносит ссылки тестового сайта на рабочий, а XML-карты рабочего сайта - на тестовый хост.
Сохраняет или отбрасывает строки запроса при сканировании.
Сканирует внутренние ссылки с rel=nofollow, если вам это нужно.
Считает /Page и /page одним URL.
Позволяет сканированию, начатому в папке, выйти за её пределы.
Лимит URL, лимит глубины сканирования, макс. URL на папку, макс. длина URL и макс. параметров запроса - чтобы держать фасетную навигацию под контролем.
По умолчанию сканирует 3 URL в секунду и сам вдвое снижает скорость, когда сервер замедляется или отвечает 429 или 503, соблюдая Retry-After.
Распределяет все запросы с заданной скоростью, включая robots.txt и XML-карты сайта, так что сайт никогда не получает всплеск нагрузки.
Когда вы подтвердите, что сайт ваш, скорость растёт до 50 URL в секунду, а robots.txt можно игнорировать - для своего сайта или тестового сервера.
По умолчанию сканирует как NeovaBot, а также как Googlebot, Bingbot, Applebot, ИИ-краулеры вроде GPTBot и ClaudeBot, SEO-инструменты, браузеры или с вашей строкой.
Соблюдает рабочий robots.txt, игнорирует его на вашем собственном сайте или соблюдает черновик из тестера robots.txt, чтобы увидеть, к чему приведёт изменение.
После сканирования отрисовывает HTML-страницы в Chrome, все или по несколько на группу страниц, и сравнивает отрисованную страницу с исходным HTML; по умолчанию выключено.
Ждёт, пока затихнет сеть и страница перестанет меняться, но не дольше заданного предела, и сообщает, если страница ещё менялась.
Сообщает над результатами, что сканирование прошло без отрисовки и сколько проверок из-за этого не выполнено, и предлагает «Просканировать снова с отрисовкой».
Загружает каждый URL через Chrome, как посетитель, - для сайтов с защитой от ботов; CAPTCHA вы решаете сами, а Neova ждёт вас.
Отправляет HTTP-аутентификацию, cookie и свои заголовки только сканируемому сайту - для тестовых сайтов и закрытых разделов.
Создаёт секретный заголовок для вашего сайта, который отправляется только на этот сайт, и правило для его ИТ-команды, чтобы файрвол пропускал Neova.
Сохраняет конфигурацию под именем, чтобы использовать её на любом сайте; что она задаёт, видно сразу.
Даёт ресурсу собственные настройки сканирования, от которых отталкиваются «Новое сканирование», «Повторно просканировать» и его расписания, с кнопкой «Вернуть значения по умолчанию».
Показывает настройки, которые меняют чаще всего, или все настройки с пояснением, как работает каждая.
Перед запуском сканирования перечисляет все настройки, отличные от значений по умолчанию, у каждой - ссылка «Изменить».
Сначала читает несколько страниц и сообщает, сколько URL в XML-картах сайта, сколько ждать изображений и файлов и сколько нужно места на диске при текущем свободном.
По выборке страниц сообщает, сколько изображений на странице, какие параметры несут ссылки и какие адреса записаны с ошибками.
Проверяет подключение ресурса к Google перед запуском сканирования или аудита и, если вход слетел, останавливает запуск с вариантами «Войти снова», «Сканировать без этих данных» или «Отменить».
Показывает сканирование по ходу: пронумерованные этапы, что идёт сейчас, сколько URL осталось и все блоки ниже, каждый можно свернуть.
Показывает этапы по названиям (Сканирование сайта, Сканирование XML-карт сайта, Сканирование ресурсов, Отрисовка страниц, Выполнение 694 проверок) и что загружено на каждом.
Одной строкой говорит, что сканирование делает прямо сейчас, и показывает последний загруженный адрес.
Три полосы под прогрессом: HTML-страницы, изображения и CSS, скрипты и другие файлы - у каждой загружено из найденного.
Показывает URL, которые ещё нужно загрузить, а затем URL, которые ещё нужно проверить, крупным шрифтом и с полосой.
Каждую минуту сообщает, откуда по шаблонам берутся новые URL, отмечает признаки ловушек для краулера (календари, повторяющиеся папки, ID сессий, много параметров, глубокие и длинные URL) и предлагает сразу исключить или пропустить их.
Для каждой найденной группы URL предлагает «Продолжить сканировать», «Пропустить» или «Исключить» и показывает, что остаётся в аудите и что из него уходит; рекомендуемый вариант отмечен.
Относит каждый найденный URL ровно к одной группе (Чистые URL страниц, Варианты с параметрами, Некорректные URL, Ловушки для краулера, Изображения, CSS, JavaScript и шрифты, Документы, Видео и аудио, Другие ресурсы), так что у числа всегда есть объяснение.
Загружает изображения первых 1, 3, 5, 10, 25, 50 или 100 страниц каждой группы страниц и показывает, сколько изображений и времени это займёт, либо пропускает остальные, либо оставляет все.
Когда все страницы загружены, пропускает оставшиеся изображения и файлы, чтобы сканирование завершилось и проверки запустились.
Во время сканирования показывает самую глубокую страницу на данный момент: янтарным с 4 кликов, со строкой предупреждения с 10 кликов.
Рисует последние 300 URL по глубине кликов с цветом по коду ответа; URL только из карты сайта - на отдельном кольце.
Показывает медианное время ответа последних URL на графике с линиями 800 мс и 1,800 мс.
Показывает URL по мере загрузки, по 10, 25, 50 или 100 на страницу, с фильтрами 2xx, 3xx, 4xx, 5xx и «Нет ответа», изменённые и новые.
Сравнивает каждый загруженный URL с последним прошлым сканированием ресурса, которое читало страницы (в первую очередь «Сканирование всего сайта», иначе «Выборка» или «Определённые папки»), и показывает старое значение зачёркнутым рядом с новым.
Показывает выполнение проверок по категориям: сколько URL каждой прочитано и число отметок, когда они записаны.
Подбирает страницы самого Google, подходящие к тому, что показывает сканирование, и новости Google Поиска за последние 45 дней: апдейты ранжирования, блог Search Central и обновления документации.
Предлагает материалы по теме сканирования: Google Search Status Dashboard, кейсы SEO ProCheck и разборы апдейтов алгоритмов.
Замораживает сканирование и продолжает его ровно с того же места.
«Стоп» спрашивает: «Перейти к XML-картам сайта», «Остановить и выполнить проверки», «Остановить и удалить это сканирование» или «Продолжить сканирование»; во время отрисовки - «Пропустить отрисовку».
Продолжает остановленное или прерванное сканирование с восстановленными настройками, никогда не с нуля.
Заново выполняет все проверки на том, что загрузило сканирование, ничего не загружая повторно, в том числе на завершённом сканировании, - так улучшенная в новой версии проверка доходит до сохранённых сканирований; работает параллельно со сканированиями других сайтов.
Сканирует ресурс заново с настройками последнего сканирования, не трогая подключённые данные, конкурентов и план.
Когда сайт отказывает в сканировании, объясняет причину (ограничение частоты запросов, блокировка файрволом или в этой стране или регионе, доступ запрещён) и что делать дальше.
Адрес, который не может быть URL, например предложение в href, не используется для перехода, а попадает в отметки.
Читает каждую загруженную таблицу стилей в поисках шрифтов, фоновых изображений и импортированных таблиц стилей.
Перечисляет файлы и изображения, которые страницы загружают с других хостов, не сканируя их.
Считает изображениями URL медиафайлов CMS без расширения изображения, например обработчики /-/media/ в Sitecore.
Группирует страницы по шаблону на основе их HTML (по словам шаблона самой темы, иначе по каркасу страницы), а на очень больших сайтах - по шаблону адреса.
Переходит по ссылкам rel=next и rel=prev в head, а не только по обычным ссылкам.
Ставит сканирования в очередь и запускает каждое, как только освобождается слот, никогда не сканируя один сайт дважды одновременно; кнопки «Запустить очередь», «Очистить очередь» и «Когда проверки закончатся».
Хранит сканирование на диске, а не в памяти (60 МБ памяти на 60,000 URL), так что размер ограничен диском, а не памятью.
Одновременно идут сканирования до 4 сайтов, у каждого свой темп и лимит URL; защита памяти придерживает сканирование, когда компьютеру не хватает памяти; любое сохранённое сканирование или ресурс открываются, пока они идут.
«Новое сканирование» заполняет форму из сохранённых настроек ресурса (скорость, область, лимит URL, отрисовка, User-Agent, XML-карты сайта и остальное), в том числе когда адрес сайта вводится в поле «Стартовый URL»; ваши последние ответы в этом окне по-прежнему важнее, и ничего из уже изменённого вами не перезаписывается.
Когда компьютер теряет интернет, сканирование сообщает об этом, ждёт и само продолжает, когда связь вернётся, а не останавливается, будто сайт лежит; после 30 минут без сети останавливается и объясняет почему.
Перечисляет все HTML-страницы с тегом title, meta description и H1 и их длиной, а также проверки контента с их отметками.
Наборы столбцов «Все URL» для title, meta description и H1, у каждого фильтры: отсутствует, пустой, дубль, слишком длинный и слишком короткий.
Отмечает дубли title, description, H1 и H2, а также одинаковый или почти одинаковый текст на HTML-страницах.
Отмечает основной текст в диапазонах «Сложно» и «Очень сложно» по шкале Флеша и тонкие страницы короче 200 слов.
Отмечает возможные орфографические и грамматические ошибки в основном тексте.
Отмечает title и H1 с прошедшим годом и текст, где упоминается предложение, срок или дата события, которые уже прошли.
Проверяет теги, которые задают заголовок, описание и изображение страницы, когда ею делятся.
Показывает, как title и description страницы выглядят в результатах поиска.
Модель на вашем компьютере читает HTML-страницы для 20 проверок контента, где нужно суждение: например, нет примеров, утверждения без подтверждения или не указан автор; её отметки идут отдельно от «Нужно исправить» и «Стоит проверить».
Показывает, какие title, meta description и H1 изменились с прошлого сканирования: было и стало.
Полосы длины title, meta description и H1, группы страниц и HTML-страницы с наибольшим числом ссылок.
Экспортирует основной контент каждой HTML-страницы в отдельный файл Markdown, с оглавлением.
Отмечает отсутствующие, пустые, длинные и дублирующиеся H1 и H2, первый H1, который не является главным заголовком, и длинные страницы без H2.
Отмечает отсутствие charset, doctype или тега body, битый favicon, устаревшие элементы и фреймы, в которых лежит контент.
Отмечает Lorem Ipsum, код шаблона, пустые значения скриптов и вывод ошибок сервера или отладки, показанный как текст страницы.
Отмечает низкое соотношение текста и HTML, основной текст короче 200 слов и длиннее 5,000 слов.
Отмечает синдицированный текст без noindex или canonical на оригинал.
Отмечает, если страницы «О нас» нет или на неё нет ссылок по всему сайту.
Определяет сущности ключевых HTML-страниц с вашим ключом Google Natural Language для проверок контента.
Код ответа каждого URL, везде одного цвета: 2xx зелёный, 3xx оранжевый, 4xx и 5xx красный, а «Нет ответа» выделено отдельно.
Куда ведут редиректы, сколько у них шагов, циклы, временные редиректы, meta refresh и редиректы на JavaScript, а также ссылки, которые на них указывают.
Отмечает внутренние URL с 2 и более шагами редиректа, циклы редиректов, редиректы на самих себя и отсутствующие или некорректные заголовки Location.
Отмечает внутренние редиректы 302, 303 и 307, не трогая страницы входа и авторизации.
Отмечает внутренние редиректы, которые заканчиваются на 4xx или 5xx, на noindex, неканонической или запрещённой странице или на другом сайте.
Отмечает URL, которые редиректят только ради слеша или смены регистра, и страницы, которые отличаются только этим, без canonical между ними.
Отмечает изображения, скрипты и таблицы стилей с редиректом, а также внешние ссылки, которые редиректят или заканчиваются ошибкой.
Наборы столбцов для canonical и директив meta robots, с фильтрами Noindex и Nofollow.
Показывает заголовки ответа любого URL.
Показывает HTML, который отдал URL, и отрисованный HTML, если сканирование его отрисовало.
Для каждой HTML-страницы указывает: «Отрисовано на сервере», «Гидратация» или «Нужен JavaScript».
Отмечает title, canonical, ссылки и основной текст, которые появляются или меняются только после выполнения JavaScript.
Двадцать проверок AMP-страниц и их canonical, включая валидатор AMP.
Отмечает длинные URL, подчёркивания, двойные слеши, повторяющиеся сегменты, лишнюю пунктуацию и слишком много параметров.
Показывает HTML-страницы по папкам и по глубине сканирования.
Рисует сканирование деревом от стартового URL, каждая точка окрашена по коду ответа, а легенда работает как фильтр.
Ваши собственные группы URL по regex для каждого сайта, у каждой подсчитаны коды ответа, и столбец «Сегмент» во «Все URL».
Ищет текст или regex в HTML каждой страницы или извлекает значения по XPath, CSS-селектору или regex и сохраняет извлечение как столбец, который заново заполняется при каждом сканировании.
Показывает тип контента, размер и время ответа каждого URL; время ответа окрашено начиная с 800 мс и 1,800 мс.
Заново загружает только URL, отмеченные проверкой, снова выполняет все проверки и сообщает, сколько исправлено.
Выключает проверку или меняет её уровень на «Нужно исправить» или «Стоит проверить» для одного ресурса - и так для всех следующих сканирований.
Исключает из сканирования целые категории проверок.
Один экран для отрисовки: сколько HTML-страниц целиком в HTML, частично в HTML или требуют JavaScript, что показывает только JavaScript, что получает каждый ИИ-краулер, по группам страниц, и страницы, которые не целиком в HTML.
На вкладках дашборда «Техническое SEO» и «ИИ-поиск» видны доля страниц, целиком доступных в HTML, страницы, которым нужен JavaScript, страницы, чей основной контент появляется только с JavaScript, и ИИ-краулеры, которые получают страницу целиком.
Может ли каждая HTML-страница попасть в индекс: код ответа, noindex, canonical, robots.txt и HTML, который ломает head раньше SEO-тегов.
Помечает каждый URL как индексируемый или нет и объясняет почему: код 200, нет noindex, canonical на себя или его нет.
Простыми словами объясняет каждую строку рабочего файла или черновика так, как это описывает Google и определяет RFC 9309, и показывает просканированные URL, под которые попадает каждое правило.
Показывает, что Googlebot, Bingbot и ИИ-краулерам разрешено загружать по robots.txt, и URL, закрытые для каждого из них.
Проверяет черновик на всех URL сканирования до выкладки и перечисляет URL, которые станут закрыты, и URL, которые станут открыты.
Предупреждает, когда собственная группа краулера в robots.txt отменяет для него правила группы *.
Что указано в XML-картах сайта в сравнении с тем, что нашло сканирование: пропущенные индексируемые страницы, а также редиректы, noindex, ошибки и страницы-сироты в картах.
Загружает страницы, которые есть только в XML-картах сайта, отдельным этапом 2 и считает их отдельно.
Даёт robots.txt и картам сайта отдельное время на медленных сайтах и сообщает, если какой-то файл не ответил.
Создаёт XML-карту сайта из индексируемых страниц на любой глубине или до глубины 3 или 5.
Отмечает страницы архива с пагинацией, которые отдают 200 без элементов, разорванные цепочки rel=next и пагинацию с canonical на первую страницу.
Хранит все версии robots.txt и XML-карт сайта, прочитанные при сканированиях, и отмечает изменения правил robots.txt с прошлого сканирования.
Отмечает HTML, где head заканчивается раньше SEO-тегов (noscript с текстом, недопустимый элемент, пропущенные или повторённые теги head), из-за чего title и canonical читаются уже в body.
Отмечает canonical, которые зацикливаются, образуют цепочки, указывают на редиректы, noindex, 4xx, 5xx, HTTP или внешние URL либо задаются только через JavaScript.
Отмечает noindex, nofollow и canonical, которые различаются в HTML и HTTP-заголовке, указаны дважды или написаны с ошибкой.
Отмечает страницы, которые используют изображения, скрипты или таблицы стилей, запрещённые в robots.txt.
Отмечает варианты с другим регистром, слешем в конце и порядком параметров, которые отдают один и тот же HTML.
Отмечает HTML-страницы, которые отвечают 200, но содержат в title или H1 фразу вроде «не найдено» или «ничего не найдено».
Отмечает HTML больше 2 МБ, где ссылки или контент лежат за пределом, который читает Google, а также файлы JavaScript или CSS больше 2 МБ.
Отмечает резкое изменение числа доступных для сканирования URL и правила robots.txt, изменившиеся с прошлого сканирования.
Отмечает XML-карты сайта больше 50 МБ или 50,000 записей, пустые карты, относительные строки Sitemap в robots.txt и URL на другом хосте или протоколе.
Проверяет, что на сайте размещён ваш файл ключа IndexNow; создать ключ можно кнопкой «Создать ключ».
Читает вердикт инструмента проверки URL Google для 200 URL за сканирование и отмечает индексируемые страницы, которые Google не индексирует или для которых выбрал другой канонический URL.
После «Сканирования всего сайта», завершившегося само, отправляет страницы, изменённые или новые с прошлого полного сканирования, в IndexNow (Bing, Яндекс, Seznam, Naver и Yep), только если на сайте размещён ваш ключ; окно показывает, что отправлено или отклонено.
Перечисляет страницы с меткой откровенного контента (meta rating adult, метка RTA или заголовок Rating) и страницы, которые отвечают краулеру проверкой возраста, чтобы вы их просмотрели.
Битые ссылки, ссылки на редиректы, анкоры и страницы, на которые ведёт мало ссылок.
Показывает все ссылки на URL и с него вместе с анкорами.
Записывает, где стоит каждая ссылка: в основном контенте, меню, футере или фильтрах, со столбцами «Входящие ссылки из основного контента» и «Входящие ссылки из меню и футера».
Оценивает каждый URL от 0 до 100 по внутреннему ссылочному весу, который он получает: внутренний PageRank по ссылкам сканирования без nofollow.
Число кликов от стартового URL для каждого URL, с отметкой начиная с глубины 4.
Отмечает индексируемые страницы, на которые не ведёт ни одна внутренняя ссылка, найденные через XML-карты сайта, лог сервера или Google Search Console.
Все URL на других сайтах, на которые ссылается сайт, каждый запрашивается один раз, с отчётом о 4xx, 5xx и отсутствии ответа.
Включает или выключает запрос каждого внешнего URL для сканирования; по умолчанию включено.
Предлагает внутренние ссылки по тексту HTML-страниц: страницы, которые упоминают тему другой страницы, но не ссылаются на неё.
Показывает URL Rating, Trust Flow, Page Authority или Authority Score, ссылающиеся домены и обратные ссылки для каждого URL по вашему ключу Ahrefs, Majestic, Moz или Semrush.
Отмечает внутренние ссылки без анкора или с неинформативным анкором и изображения-ссылки без alt.
Отмечает страницы, на которые ведут только ссылки nofollow, внутренние исходящие ссылки с nofollow и партнёрские ссылки без sponsored или nofollow.
Отмечает пустые, некорректные и состоящие из пробелов href, ссылки только на onclick, параметры отслеживания, локальные пути к файлам, localhost и фрагменты без соответствующего ID.
Отмечает URL, до которых можно дойти только через canonical, редирект или страницы с noindex, и страницы с входящими ссылками только с одного URL.
Выделяет в отдельную группу адреса, которые ссылки записали с ошибкой (пробел в конце, двойной слеш, дважды закодированный символ).
Отмечает HTML-страницы со ссылками на тестовый, dev- или локальный хост.
Перечисляет все изображения, которые загрузило сканирование или использует страница, с размером, атрибутом alt и числом HTML-страниц, где оно используется.
Отмечает отсутствующий, слишком длинный, шаблонный и повторяющийся alt и отличает отсутствующий alt от декоративного.
Отмечает изображения больше 100 КБ, GIF больше 100 КБ и изображения без width и height.
При включённой отрисовке отмечает изображения с неверными пропорциями или слишком низким разрешением для их размера.
Отмечает несжатые изображения, изображения не в современном формате, крупнее отображаемого размера и LCP-изображение с отложенной загрузкой.
Отмечает видео без дорожки субтитров.
Позволяет брать выборку из большой библиотеки изображений по группам страниц вместо загрузки целиком, с числом изображений и временем для каждого варианта.
Отказывается от изображений, оставшихся в очереди, при этом все страницы по-прежнему сканируются, а атрибут alt по-прежнему читается из HTML.
На сайтах, которые лицензируют изображения, отмечает разметку ImageObject без данных о лицензии и читает выборку отдаваемых изображений на права IPTC и XMP, которые нужны Google для значка Licensable.
Языковые и региональные версии каждой страницы и ссылаются ли они друг на друга: обратные ссылки, ссылка на себя, x-default, неверные коды, неканонические цели и цели с noindex.
«Языки hreflang» и «Цели hreflang» для каждой HTML-страницы, полный список при наведении.
Отмечает отсутствующий, пустой или неверный html lang и значения lang, которые расходятся с hreflang или с языком текста страницы.
Отмечает отсутствующие обратные ссылки, отсутствующие ссылки на себя и обратные ссылки на неканонические URL.
Отмечает отсутствие x-default в наборе главной страницы и битую, закрытую noindex или неканоническую цель x-default.
Отмечает цели hreflang, которые не отвечают 200, закрыты noindex, неканонические, запрещены или не имеют входящих ссылок.
Проверяет каждый код языка и страны в hreflang и отмечает региональные коды без запасного варианта только с языком.
Отмечает языковые версии без hreflang и целевой рынок, для которого hreflang нет ни на одной странице.
Читает hreflang из head в HTML и из HTTP-заголовка Link и отмечает набор, объявленный больше чем одним способом.
Отмечает ответ, который меняется в зависимости от Accept-Language так, что Googlebot этого не видит.
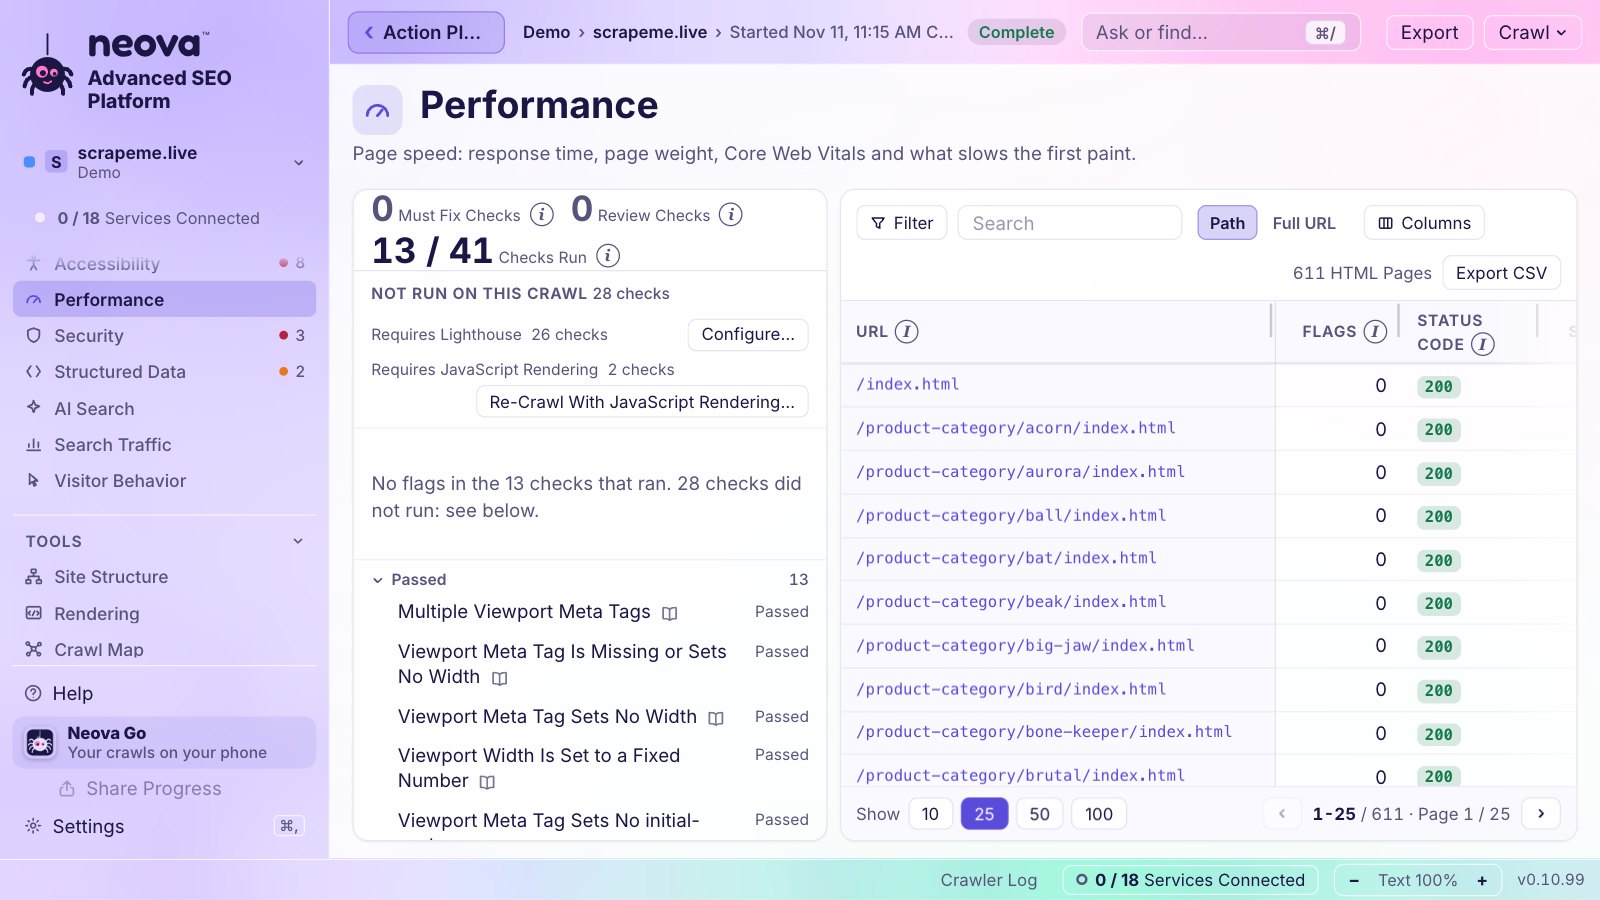
Скорость страниц: время ответа, вес страницы, Core Web Vitals и то, что замедляет первую отрисовку.
Во время сканирования запускает лабораторные проверки Lighthouse на одной HTML-странице из каждой группы страниц.
LCP, INP и CLS реальных пользователей Chrome на телефонах, 75-й процентиль, по вашему ключу Chrome UX Report.
В первый же день строит около 40 недель полевых данных из Chrome UX Report History, по точке в неделю, с линиями «хорошо» и «плохо» по Google.
LCP, INP и CLS HTML-страниц с наибольшим числом ссылок в каждой группе страниц, чтобы медленный шаблон сразу был виден.
Читает Chrome UX Report для домена, URL с наибольшим числом ссылок в каждой группе страниц и 10 самых популярных по ссылкам URL, без сканирования.
Делает снимок сам, по умолчанию ежедневно, либо еженедельно или ежемесячно, даже при закрытом окне.
Отправляет оповещение, когда метрика ухудшает оценку или возвращается к «хорошо», по порогам Google.
Показывает последние замеры рядом, окрашенные как «Хорошо», «Требуется улучшение» или «Плохо», с датами.
Задаёт от 0 до 3 HTML-страниц на группу страниц для каждого снимка и показывает, сколько запросов к Chrome UX Report это займёт.
Уровень «Аудит сайта» после сканирования читает Core Web Vitals из Chrome UX Report.
Хранит все снимки на вашем компьютере, дольше 28 дней, которые показывает Chrome UX Report.
Отмечает выключенное сжатие текста, неминифицированные CSS и JavaScript, короткий срок кэширования и страницы без ETag или Last-Modified.
Отмечает блокирующие отрисовку запросы, долгую работу основного потока, неиспользуемые CSS и JavaScript, устаревший JavaScript, ресурсы по HTTP/1.1, медленные сторонние скрипты и оценку Lighthouse ниже 50.
Отмечает медленный ответ сервера, CLS выше 0.1 и Core Web Vitals за пределами хорошего диапазона, в лабораторных или полевых данных.
Отмечает страницы, у которых отрисовка JavaScript занимает больше 4 секунд.
Отмечает отсутствующий или фиксированный viewport, запрет масштабирования и текст меньше 12 CSS px на телефонах.
Медианное время ответа, 9 из 10 и самое медленное во время сканирования, плюс 10 самых медленных страниц.
Что мешает людям, использующим вспомогательные технологии, пользоваться каждой страницей: имена, подписи, ARIA, ориентиры, заголовки, таблицы и формы.
При включённой отрисовке выполняет правила axe-core и пробы от лица посетителя: контраст, фокус клавиатуры, ловушки фокуса, масштаб 200%, перекомпоновка при 320 px и области касания 24 px.
Отмечает кнопки, ссылки, поля форм, изображения, диалоги и фреймы без доступного имени, а также поля, названные только через title.
Отмечает недопустимые роли и атрибуты, отсутствующие обязательные атрибуты, неверные родительские или дочерние роли и устаревшие роли.
Отмечает страницы без ориентира main, дублирующиеся или вложенные ориентиры, пропущенные уровни заголовков и отсутствие способа обойти повторяющиеся блоки.
Отмечает таблицы без ячеек заголовков, неверные scope и headers, а также неправильно построенные списки и списки определений.
Отмечает отсутствие индикатора фокуса, ловушки фокуса, положительный tabindex, диалоги, которые не удерживают фокус, и прокручиваемые области без доступа с клавиатуры.
Отмечает текст с недостаточным контрастом, текст ниже усиленного контраста и ссылки, которые отличаются только цветом.
Отмечает запрет масштабирования, текст, обрезанный при масштабе 200%, контент, обрезанный при ширине 320 px, блокировку ориентации и области касания меньше 24 px.
Отмечает видео без субтитров или аудиоописания, видео без звука без альтернативы и аудио без расшифровки.
Отмечает поля без подписи или с несколькими подписями, недопустимые значения autocomplete, поля, где запрещена вставка, и ошибки без текста.
Локальная модель читает страницы для 7 проверок, где нужно суждение, например графики без текстового эквивалента.
Что могут получать ИИ-краулеры, что им отдаётся и как ИИ-ответы цитируют сайт.
Запрашивает выборку страниц от имени 10 ИИ-агентов (ChatGPT, Claude, Perplexity, их краулеры, Meta AI, Google-Extended, Common Crawl) и показывает, кто получает полный доступ и что разрешает robots.txt.
Оценивает опубликованный llms.txt, версию в Markdown через заголовок Accept, манифесты обнаружения агентов и инструменты WebMCP; сайт без них не отмечается.
Отмечает ключевые страницы, которые закрыты для ИИ-краулеров поиска или ограничивают сниппеты, и правила для ИИ, которые расходятся с вашей письменной политикой.
Отмечает версию в Markdown, которая пуста или содержит меньше половины основного текста.
Отмечает основной контент, который начинается после первых 5,000 символов текста body.
Отмечает невидимые слои поверх кнопок и полей, плохо заметные элементы управления задачами и решения агентного оформления заказа без даты для Google UCP или OpenAI ACP.
Отмечает ключевые страницы, закрытые для Applebot, и заблокированные ИИ-загрузчики, которые запускает пользователь.
Отмечает падение цитирований в Bing AI и ключевые URL, которые Bing AI никогда не цитирует, по данным Bing Webmaster Tools.
Показывает сессии с переходом из ИИ и их вовлечённость в сравнении с органикой, по данным Google Analytics 4.
Задаёт до 20 ваших промптов ChatGPT и Perplexity через ваш аккаунт DataForSEO и показывает упоминания бренда, процитированные URL и сторонние сайты, которые цитируются вместо вас.
Для каждого отслеживаемого запроса показывает, есть ли у Google AI Overview и цитирует ли он вас, аудит за аудитом.
Сканирует с User-Agent GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot и других ИИ-агентов.
Показывает подтверждённые визиты ИИ-краулеров и отказы по каждому URL из лога сервера.
Выполняет ваши промпты на каждой HTML-странице (черновики meta description, идеи для FAQ, поисковый интент, главные сущности) через Ollama на вашем компьютере или по вашему ключу Anthropic, OpenAI или Google Gemini, ответы - в столбцах.
Выполняет 44 проверки, где нужно суждение, по всем категориям с локальной моделью через Ollama; ничего не покидает компьютер, а её отметки не входят в подсчёты.
Что получают ИИ-ассистенты, AI Overviews, что получает каждый ИИ-ассистент и запросы подтверждённых ботов.
Для каждого отслеживаемого запроса 3 раза загружает AI Overview Google через DataForSEO и показывает, сколько его источников ранжируется на первой странице, есть ли там ваша страница и цитирует ли её Overview, - как отметку «Стоит проверить».
Микроразметка каждой страницы: валидна, с предупреждениями или с ошибками, и столбец «Типы Schema».
Выносит вердикт по каждому типу Schema на URL.
Отмечает страницы, где нет типа структурированных данных или расширенного результата, который есть в их группе страниц.
Отмечает цены товаров, которых нет на странице, истёкшие предложения, несовпадающие даты и отсутствующие обязательные свойства.
Отмечает структурированные данные с синтаксическими ошибками, без обязательных или рекомендуемых свойств или с текстом, который расходится со страницей.
Отмечает разметку Organization или Person без идентифицирующих свойств.
Проверяет селекторы Speakable, платные страницы без isAccessibleForFree false и разметку HowTo, QAPage и FAQ на соответствие странице.
Отмечает невалидные расширенные результаты и ошибки AMP или расширенных результатов, о которых сообщает Google.
Сравнивает разметку Organization с Google Business Profile через DataForSEO.
HTTPS, смешанный контент и заголовки безопасности, которые отправляет каждая страница.
Показывает заголовки безопасности, которые отправляет каждый URL.
Отмечает страницы на HTTP, редиректы с HTTPS на HTTP, недействительные или скоро истекающие сертификаты и TLS 1.0 или 1.1.
Отмечает внешние скрипты и стили без хеша integrity, а также формы и поля пароля по HTTP.
Отмечает отсутствие Content-Security-Policy, Strict-Transport-Security, nosniff, защиты от кликджекинга или Cross-Origin-Opener-Policy и небезопасный Referrer-Policy.
Отмечает HTTPS-страницы, которые загружают ресурсы по HTTP или по относительному протоколу либо ссылаются на HTTP-страницы.
Отмечает заголовки ответа, которые выдают сервер или фреймворк, и Content-Type, не совпадающий с файлом.
Отмечает сертификат, который не покрывает имя хоста, переданное через SNI.
При включённой отрисовке отмечает сторонние cookie и запросы разрешений при загрузке.
Вход через собственную страницу Google в вашем браузере, только на чтение; клики, показы и CTR привязываются к каждому URL каждого сканирования.
Привязывает визиты и вовлечённость к страницам сканирования для проверок аналитики; подключается тем же входом через Google.
Хранит по одному входу на каждый аккаунт Google и для каждого сайта берёт аккаунт, которому принадлежит ресурс.
Спрашивает, какой ресурс Google Search Console и Google Analytics 4 относится к каждому сайту, и заранее выбирает собственный ресурс сайта.
29 проверок, которые сводят данные Google со сканированием: например, URL с noindex, редиректом или кодом 4xx, которые всё ещё получают клики.
Отмечает органические посадочные страницы с вовлечённостью 10 секунд или меньше, отказами от 80%, формы без ключевых событий и органические сеансы ниже 70% от недавней нормы.
Отмечает запросы, по которым показы делят несколько URL или чаще всего показывается главная страница или неиндексируемый URL.
Показывает показы и клики по видам в результатах поиска.
Отмечает идентификаторы GA или GTM, загруженные дважды, и индексируемые URL без идентификатора GA или GTM.
Сортирует проверки по кликам отмеченных ими URL, чтобы первыми шли отметки, которые стоят трафика.
Хранит на вашем компьютере каждый месяц данных Google Search Console после того, как Google удаляет их через 16 месяцев: «Архивировать сейчас» и ежемесячное расписание.
Клики и показы по дням за последние 28 дней в сравнении с 28 днями до них, на графике.
Запросы, которые приносят клики, с показами и позицией.
Каждый день отслеживает до 25 запросов на ресурс по данным Google Search Console: позиция за 7 и 90 дней, изменение, клики и показы; запросы на позициях с 4 по 20 предлагаются сами.
Проверяет до 200 URL за сканирование: сначала самые кликабельные, затем те, на которые больше всего ссылок.
Клики и показы из Google Discover, сохранённые с каждым архивным месяцем.
Наносит апдейты ранжирования и инциденты Google за последние два года на график ваших кликов по дням, с кликами до и после каждого.
Клики, запросы, ошибки сканирования и проиндексированные URL из Bing, с вашим API-ключом и кнопкой «Тест», которая выводит список ваших сайтов.
Позиции, ИИ-ответы, конкуренты и обратные ссылки через ваш собственный аккаунт DataForSEO, с оплатой за запрос.
Реальная мобильная позиция каждого отслеживаемого запроса в топ-20 и лучший конкурент рядом.
Запросы, по которым конкурент в топ-20, а вы нет, с их частотностью.
Читает сервис, подключённый после сканирования, и заново выполняет его проверки на этом сканировании, без повторного сканирования.
Показывает, сколько сервисов подключено, в строке состояния, под ресурсом на боковой панели и блоком на дашборде; каждое открывает «Подключения».
Показывает запросы, которые каждое подключение делает для ресурса, в сравнении с квотами Google; всё на вашем собственном ключе и аккаунте.
Каждое сканирование хранит ссылки на отчёты Search Console «Проблемы безопасности» и «Меры, принятые вручную» для ресурса: API Google их не читает, так что оба можно открыть вручную.
Ставит ресурс рядом с конкурентами по их последнему пригодному сканированию; каждая метрика окрашена по тому, кто впереди и кто отстаёт, с разрывом до лучшего конкурента.
Перечисляет метрики, в которых конкурент впереди, начиная с самого большого разрыва, и проверки за каждым числом.
Принимает целый список, вставленный как есть: прямых конкурентов как основных (не больше 5), косвенных как второстепенных, и ставит их сканирования в очередь за один шаг.
Сначала читает XML-карты сайта каждого конкурента, по умолчанию сканирует 750 URL и предлагает 1,000, 2,500 или 5,000, если в картах сайта их больше.
Находит через DataForSEO сайты, которые ранжируются по тем же запросам, и делит их на основных и второстепенных.
Никогда не предлагает магазины, сервисы доставки и маркетплейсы как конкурентов; добавить их вручную всё равно можно.
Если конкурент переехал на другой домен, сканирует его там, где теперь его главная страница.
Предлагает для конкурентов ресурса вложенный портфель «<ресурс> | Конкуренты» и держит его привязанным к ресурсу.
Считает только проверки, которые смогло оценить каждое сравниваемое сканирование, и ничего не ранжирует против прерванного сканирования.
Запросы в выдаче, топ-10, оценка визитов и ссылающиеся домены для ресурса и каждого конкурента, от аудита к аудиту.
Ссылающиеся домены и обратные ссылки ресурса и его конкурентов из DataForSEO Backlinks.
Показывает каждого конкурента под его ресурсом со шкалами URL, отметок и отметок на URL в сравнении.
Календарь на месяц со всеми сканированиями и запусками по расписанию, прошедшими и будущими, с фильтром по ресурсу.
Сканирования всего сайта, которые запускаются сами - ежедневно, еженедельно, каждые N недель или ежемесячно - с настройками ресурса, при закрытом окне.
Архивы Google Search Console по расписанию, по умолчанию раз в месяц.
Показывает, во что обойдётся сканирование по расписанию, до его добавления: URL за запуск и запусков в месяц.
Уведомляет за 15 минут до начала сканирования по расписанию и сообщает, что оно идёт при закрытом окне.
Сдвигает один запуск на 1, 3, 6 или 9 часов или на нужные дату и время либо пропускает его, а расписание сохраняет свой ритм.
Безопасно останавливает идущее сканирование по расписанию и назначает ему новое время.
Повторяет полный аудит каждый месяц по расписанию; анализ и PDF Neova доделывает при следующем запуске.
Создаёт оповещения, когда Core Web Vitals меняют оценку, клики за последние 7 дней падают на 20% или больше, отслеживаемый запрос выходит из топ-10 или входит в него либо теряет 3 позиции, или в новом сканировании появляются новые отметки.
Хранит последние 300 оповещений, с кнопками «Проверить сейчас» и «Очистить оповещения».
Neova продолжает работать после закрытия окна: в строке меню, с прогрессом сканирования рядом с часами.
Оставляет значок в Dock или только значок в строке меню.
Запускает Neova при входе в систему с закрытым окном.
Страница для телефона, которая добавляется на экран «Домой» по QR-коду: последнее сканирование каждого ресурса, Core Web Vitals, клики Google Search Console, отслеживаемые запросы, следующий запуск и идущие сканирования; данные шифруются на Mac до отправки.
Mac отправляет сводку каждые 2 минуты, пока идёт сканирование, и каждые 15 минут в остальное время; телефон проверяет каждые 2 минуты и показывает, насколько данные свежие.
Создаёт ссылку на одно идущее сканирование, чтобы кто угодно мог следить за ним и узнать, когда оно закончится; у ссылки свой ключ, и больше она ничего не открывает.
Копия живого экрана, которую может открыть кто угодно: прогресс, «Разбивка URL», «Последние URL», «Живая карта сканирования», «Время ответа», «Редиректы и ошибки», «Проверки» и «Ссылки и новости».
Страница для доступа может уведомить читателя, когда сканирование закончится.
Все группы 3xx, 4xx, 5xx и «Нет ответа» за всё сканирование, до 100 URL в каждой, начиная с тех, на которые больше всего ссылок.
Отправляет оповещения и итог каждого сканирования в один или несколько каналов Slack через входящий вебхук; работа подтверждается тестовым сообщением.
Отправляет оповещения и итог каждого сканирования в каналы Teams через вебхук Workflows.
Отправляет сообщения каждого портфеля или ресурса в его собственные каналы.
Системное уведомление, когда сканирование заканчивается, а Neova не на переднем плане; звук можно выбрать.
Показывает всё, что Neova делает сейчас: сканирование, аудит, «Запустить проверки», сканирование по расписанию и очередь, у каждого - кнопка, которая его открывает.
У каждого числа с предыдущим значением есть изменение с прошлого сопоставимого сканирования.
Загружает только список страниц, без поиска новых, и создаёт оповещения по страницам при изменениях кода ответа, цели редиректа, title, canonical, noindex, H1 и размера.
Состояние сканирования с первого взгляда: «Сводка сканирования», «Главные проверки», «Следующие действия», «Коды ответа» и «Изменения по сравнению с предыдущим сканированием»; каждое число открывает свой список.
Каждая проверка с отметками: уровень, сколько URL отмечено из проверенных, сколько из них индексируемых, изменение с прошлого сканирования, категория и клики.
У каждой проверки есть «Отмечается, когда», «Что это обычно значит» и «Что можно сделать», её ID, источник и «Об этой проверке», которая открывает её страницу в библиотеке проверок.
Каждый URL: наборы столбцов, фильтры по любому столбцу, сохранённые виды, выбор столбцов, закреплённый столбец URL и 10, 25, 50 или 100 строк на странице.
Каждая таблица и сетка экспортирует то, что показывает, в CSV.
У каждого столбца, счётчика и карточки есть ⓘ, который объясняет, что именно считается.
Восемь групп и 13 вкладок из 39 блоков: сводка, производительность, техническое SEO, Core Web Vitals, контент, ключевые слова, ИИ-поиск, соцсети, конкуренты, апдейты алгоритмов, рабочий процесс, программа и отчёты.
До 10 собственных дашбордов: с нуля или копией вкладки; блоки можно добавлять, перемещать, менять их размер и удалять.
План действий как программа по статусу и владельцу: у каждого пункта - его проверка с отметками в последнем сканировании; пункт, помеченный «Готово», но всё ещё отмеченный, горит красным.
Одна задача на проверку и группу страниц, сначала «Нужно исправить»: правило, доказательства, затронутые URL, когда считать готовым, как проверить и где исправлять (в шаблоне, если отмечено 90% группы).
Следующее сканирование закрывает, оставляет или переоткрывает каждую задачу по её ключу и никогда не удаляет.
Начинает каждую задачу с кода ресурса, например [DRH], и передаёт его меткой в Jira и Linear.
Создаёт по одной задаче Jira на каждую задачу Neova в вашем проекте Jira Cloud, с приоритетом, метками и приложенным списком URL, без дублей.
После каждого полного сканирования из окна переводит исчезнувшую задачу в Done, переоткрывает вернувшуюся и обновляет остальные.
Файлы в формате CSV-импорта каждого инструмента: Jira, Linear, Asana, ClickUp, monday.com, Azure DevOps Boards, Notion, Airtable, Smartsheet и Markdown-файл задач для Basecamp, у каждого - ссылка на страницу импорта.
Отчёт для клиента с вашим именем, логотипом и цветом: сканирование в цифрах, отметки по категориям, что исправить в первую очередь с примерами URL, отрисовка и видимость в ИИ, изменения с прошлого сканирования и как проводилось сканирование, в формате Letter или A4; проверки одного семейства считаются один раз, вторая идёт как «Также отмечено».
Даёт каждому клиенту в отчёте своё имя, логотип и цвет, с полями «Подготовлено для», «Подготовил» и примечаниями.
Одна книга: «Сводка», задачи в порядке исправления, «По группам страниц», лист на каждую проверку с её 1,000 самыми кликабельными, а затем самыми ссылаемыми URL, и «Все отметки».
Каждая HTML-страница с ответом 200, до 200,000, с title, description, H1, canonical, индексируемостью, глубиной, входящими ссылками, картой сайта, размером, временем ответа, кликами и отметками.
Отправляет книгу в ваш Google Drive, преобразовав её в Google Таблицы.
Один ZIP из того, что вы выберете: PDF, книга подробная или краткая, задачи со списками URL, файлы для Jira и Linear и все отмеченные URL по одному CSV на проверку, плюс README.
URL, отметки и задачи в виде CSV-файлов: для CSV, Excel (UTF-8 с BOM), Google Таблиц и Looker Studio.
К каждому экспорту прилагается примечание, если сканирование шло без отрисовки или охватило только часть сайта.
По умолчанию сохраняет экспорты в «Загрузки», в папку экспортов Neova.
Сохраняет экспорты в папку на компьютере, которую вы выберете.
Загружает через собственный интерфейс Google Drive в аккаунты Google, подключённые к Neova, в их папку экспортов Neova; файл с тем же именем заменяется, так что его общая ссылка продолжает работать. Neova видит только свои файлы.
Сохраняет в папки, которые синхронизируют на Mac приложения Google Drive, OneDrive, Dropbox, iCloud Drive, Proton Drive и kDrive (на Windows - OneDrive, Dropbox и Google Drive); каждый аккаунт выключен, пока вы его не включите.
Загружает экспорты на ваш собственный сервер по SFTP с паролем или файлом ключа, по FTPS или обычному FTP; подключение проверяется перед сохранением, ключ сервера запоминается.
Сохраняет экспорты каждого портфеля или ресурса в его собственную папку или диск.
В Neova Online записывает экспорт прямо в папку на вашем компьютере в Chrome, Edge, Vivaldi, Brave и Arc; другие браузеры его скачивают.
В Neova Online экспорт папкой, например таблицы CSV или страницы в Markdown, скачивается одним ZIP.
Одна ссылка только на чтение на портфель или ресурс со сканированиями, планом действий, анализами, конкурентами и файлами, которые вы отметите; всё шифруется на вашем компьютере ключом, который передаётся только в самой ссылке. «Обновить» сохраняет адрес, «Выключить» удаляет его.
Что делать и в каком порядке: черновик из сканирования (сначала «Нужно исправить», затем клики, затем охват), который вы переставляете и формулируете сами, добавляете свои пункты, со статусом, владельцем и примечанием; сохраняется между сканированиями.
Копирует план в Markdown или экспортирует его в CSV.
Пишет полный аудит на вашем компьютере: текущее состояние, отметки по приоритету, видимость в поиске, отслеживаемые запросы, пробелы в семантике и приоритетные действия уже заполнены, а разделы, которые может написать только человек, помечены «Написать».
Хранит добавленные вами отчёты (Markdown, текст, PDF или Word) вместе с ресурсом, с кнопкой «Пометить как просмотренное».
Открывает письмо в Neova Labs, где уже есть числа сканирования, для разделов, которые не пишет ни одна проверка.
Один запуск всех шагов: сканирование со всеми проверками, Google, Bing и аналитика, Core Web Vitals, конкуренты и их сканирования, поисковые данные DataForSEO, план действий, анализ и брендированный PDF.
«Запустить полный аудит» спрашивает, читать последнее сканирование или просканировать заново, и показывает его URL и сколько оно заняло.
Сканирование A против сканирования B: новые, удалённые и изменённые URL, новые и исправленные отметки; сканирование B окрашено в лучшую или худшую сторону.
Всё, что хранится для ресурса дольше, чем у самих источников: каждое сканирование, каждый месяц Google Search Console, каждый снимок Core Web Vitals, версии robots.txt, XML-карты сайта и изменения URL.
В каждой рекомендации, задаче и отчёте есть строка о том, что их нужно проверить перед применением: Neova видит страницы, а не бизнес за ними.
Сканирование по расписанию отправляет свой итог в Slack и Teams, а ежемесячный полный аудит делает PDF при следующем запуске Neova; файлы экспорта по расписанию пока не создаются.
PDF-отчёт и книга показывают, как отрисовываются страницы (в целом, по группам страниц и постранично), что robots.txt разрешает брать каждому ИИ-краулеру и что ему отдаёт сервер, а также какие проверки ИИ-поиска пройдены, а какие дали отметки.
Google Sheet, собранная из сканирования специально для Google Таблиц: обзор с графиками, план действий с выпадающими списками «Владелец», «Статус» и «Срок», проблемы, URL, отметки, группы страниц, редиректы и ошибки, отрисовка и ИИ, «О файле»; каждый раз сохраняется в ваш аккаунт Google новым файлом.
Каждый файл, который Neova делает из сканирования (пакет для клиента, PDF, книга, Google Sheet, экспорты, файлы Neova), есть в списке: куда он ушёл, сканирование, дата и размер, с кнопками «Открыть», «Открыть папку», «Копировать путь» и «Открыть в Google Drive».
То же окно Neova в браузере на app.neova.app: его движок работает на сервере Neova и сканирует и проверяет там.
Аккаунты открываются по ссылке-приглашению, именной или открытой: одна ссылка - один аккаунт.
Пароль хранится в виде хеша, вход действует 30 дней с последнего визита, после 10 неверных паролей нужно подождать, запросы с других сайтов отклоняются, а если страница открыта во встроенном браузере другого приложения, появляется предупреждение.
Сканирования, данные и загрузки каждого человека лежат в его собственных папках, и другой человек никогда не может их прочитать.
Одна задача на человека за раз, 10,000 URL на сканирование, 10 URL в секунду и 10 ГБ сканирований на аккаунт, пока Neova Online в тестировании.
Подключает Google Search Console, Google Analytics 4 и Google Drive из браузера; вход хранится в вашем собственном пространстве.
Ключи и вебхуки хранятся в вашем аккаунте Neova Online и больше никогда не показываются.
Каждый новый аккаунт начинается с демо: тестовый магазин и три конкурента, уже просканированные, с настройками портфеля, кодами и планом действий; удаляется в один шаг.
Приглашение может принести портфели, скопированные из другого аккаунта, с их последними сканированиями, настройками и планами; пока они готовятся, виден баннер.
Окно подстраивается под телефоны и планшеты: боковая панель становится выдвижной, листы занимают весь экран в одну колонку, таблицы прокручиваются вбок.
Настольное приложение один раз входит в Neova Online; приложение хранит ключ для этого компьютера, но никогда не пароль.
Сама синхронизирует портфели, конкурентов, ваш порядок, выбор Google Search Console и Google Analytics 4, цвета и коды.
Если на одной стороне уже есть содержимое другой, вход объединяет их сразу, без вопросов; если стороны действительно различаются, Neova спрашивает, с чего начать: «Оставить данные Neova Online», «Оставить данные этого Mac» или «Объединить обе» (рекомендуется, ничего не теряется), показывает счётчики каждой стороны и сначала откладывает резервную копию.
Отправляет или скачивает сканирования целиком, частями с возможностью докачки и проверкой в конце, параллельно с любым идущим сканированием.
Отправляет в Neova Online каждое сканирование, завершённое на этом компьютере; по умолчанию выключено.
Neova Online показывает новую версию при следующей загрузке страницы, а не старое окно из кеша.
Отдаёт установщики и обучающее видео для тестировщиков, с noindex.
Переносит ключи подключений из вашего аккаунта Neova Online на этот компьютер или отправляет туда ключи этого компьютера; после ввода пароля, показывая только последние 4 символа каждого ключа и никогда не заменяя ключ, если вы не отметили «Заменить».
Каждый аккаунт Neova Online может хранить 10 ГБ сканирований; в настройках видно, сколько занято и сколько сканирований, с 85% появляется предупреждение, а отправка или сканирование сверх места отклоняется с объяснением, что делать.
Neova SEO Platform для Mac: движок встроен как нативный код, сканирование идёт на вашем компьютере.
Установщик для Windows x64 в ваш собственный аккаунт, без пароля администратора; тестовая сборка, пока не подписана.
В Windows приложение говорит «этот ПК» и использует Ctrl вместо ⌘ во всех сочетаниях клавиш.
Настольное приложение для Linux: .deb для Ubuntu, Linux Mint и Debian и AppImage, который не нужно устанавливать.
Окно и библиотека проверок на английском, французском, немецком, испанском, португальском (Бразилия), итальянском, японском, нидерландском, польском, турецком, корейском, китайском (упрощённом), русском, индонезийском и вьетнамском.
Neova Мрамор (по умолчанию), Neova, macOS, Liquid Glass, Windows 11, Linux, Terminal и Высокая контрастность; оформление меняет цвета, но никогда не расположение элементов.
Светлое, тёмное или как в системе, с цветом акцента.
Компактные или просторные строки и текст, который масштабируется через ⌘+ и ⌘−.
Показывает URL в виде пути или с протоколом и хостом во всех таблицах.
Пишет даты и время так, как удобно вам, или как принято в языке.
Показывает или скрывает строку «Главная»; название Neova слева вверху открывает главную в любом случае.
⌘N - новое сканирование, ⌘K - поиск ресурсов, ⌘, - настройки, ⌘[ - назад, ⇧⌘P - режим презентации, ⌘/ - «Спросите или найдите».
Одно поле находит вид, проверку по названию или ID, страницу сканирования, ресурс или настройку и запоминает недавний выбор.
Длинный вопрос уходит модели на вашем компьютере, которая выбирает ответ из того, что окно уже показывает, поэтому никогда не выдумывает числа.
Размывает все портфели, кроме открытого, для демонстрации экрана клиенту.
Возвращает на предыдущий экран, название которого написано на кнопке.
Единая рамка фокуса, каждая строка доступна по Tab, стрелки внутри таблиц, листы как диалоги и учёт настройки уменьшения движения.
Перетащите боковую панель, список проверок и панель деталей до нужной ширины.
Пока идёт сканирование, выход один раз спрашивает подтверждение, затем сохраняет сканирование, показывая шаги и прогресс, а «Продолжить» позже возобновляет его.
Называет каждое сканирование по расписанию, идущее в фоне, и предлагает остановить и сохранить его перед выходом.
Сканирование, идущее во время обновления Neova, сохраняется само и продолжается через «Продолжить».
Остановка дописывает только новый HTML и показывает каждый шаг сохранения со шкалой и кнопкой «Закрыть сейчас».
Следит за свободным местом на диске во время сканирования, предупреждает, когда его становится мало, и безопасно останавливается ниже 3 ГБ, чтобы «Продолжить» возобновило работу, когда место освободится.
Сканирование, прерванное сбоем или закрытым каналом, попадает в список как прерванное и никогда не теряется, а его хранилище безопасно откатывается.
Очередь и аудиты продолжают работать, пока окно скрыто.
Проверяет на app.neova.app, нет ли новой сборки, при открытии приложения, каждые 30 минут и когда окно снова выходит на передний план; отправляется только номер версии.
После каждого изменения копирует настройки окна в файл, по одной копии на версию, и восстанавливает их, если хранилище окна сбросится.
Меняет место, где Neova хранит сканирования.
Начиная с 64 px, на значке под пауком написано Neova SEO.
Когда есть новая сборка, надпись «Доступна новая версия» с кнопкой «Скачать» появляется слева вверху, на панели инструментов, первой строкой в «Справке» и в «Настройки › Общие»; приложение проверяет каждые 30 минут и когда окно снова выходит на передний план.
Каждая таблица подгоняет ширину столбцов под содержимое, оставляя свободное место URL и столбцам, которые обрезаются первыми; у заголовка каждого столбца есть ручка для перетаскивания, двойной щелчок подгоняет ширину, а заданная вами ширина сохраняется.
Необязательный анимированный талисман, на выбор 8 (Webster, The Head, Sir Canonical, Polly Glot, Hopper, Shelly, Bo, Zap), милый или в пиксель-арте, который следит за вашими сканированиями; по умолчанию «Нет», и с «Нет» ничего не загружается.
Облачко с текстом, когда сканированию нужно ваше внимание: конец сканирования с его проверками «Нужно исправить» и числом новых, остановленное или неудачное сканирование, сайт, блокирующий краулер, заполняющийся диск, старт сканирования по расписанию; щелчок открывает названный экран.
Щелчок по питомцу показывает, что делает Neova, а при открытом сканировании питомец принимает вопрос о нём и отвечает тем же путём, что и строка «Спросить» (Ollama на вашем компьютере или ваш собственный ключ ИИ).
В режиме «На рабочем столе» у питомца своё окно поверх всех окон и на каждом рабочем столе (Space), без значка в Dock; Neova продолжает следить, даже когда свёрнута, а щелчок возвращает её на нужный экран.
Семь размеров, от «Крошечного» (56 px) до «Колоссального» (320 px), по умолчанию «Большой», и панель инструментов под питомцем: «Открыть Neova», «Новое сканирование», «Выполняется» и «Ещё» (скрыть, настройки, без звука), при наведении или всегда.
Сканирования хранятся в Application Support/Neova на Mac и в %APPDATA%/Neova на Windows; в Neova ничего не отправляется, если вы не синхронизируете данные и не делитесь ими.
Каждый ключ, токен и вход попадает в системную связку ключей через стандартный ввод движка, а не через файл, командную строку или экран.
В приложении нет ни одного ключа Neova: Google, Chrome UX Report, DataForSEO и остальные работают на вашем собственном ключе и аккаунте.
Движок поставляется нативным кодом, без читаемого исходного кода.
Google подключается с правами только на чтение плюс ваш email; «Отключить» отзывает токен в Google.
DataForSEO выключен, пока «Новое сканирование» не включит его для конкретного сканирования.
До нажатия «Начать» оценивает стоимость по тому, сколько DataForSEO списал с этого компьютера за последние 20 вызовов каждого вида, иначе по прайс-листу, с округлением вверх до следующих $0.50 или доллара.
Перестаёт обращаться к DataForSEO, когда достигнут заданный вами лимит: от $0.50 до $10 на сканирование, по умолчанию $1.
Поисковые данные полного аудита останавливаются на своём лимите в долларах США, и аудит сообщает, сколько потратил.
Логи сервера читаются на вашем компьютере; IP-адреса нигде не записываются.
«ИИ-проверка» и «Спросить» используют модель на вашем компьютере через Ollama, поэтому ничего не покидает его; «ИИ-промпты» предупреждают, когда текст страницы уходит выбранному вами провайдеру.
Ссылки для доступа, Neova Go и «Поделиться прогрессом» шифруются на вашем компьютере, а ключ есть только в ссылке или QR-коде, поэтому сервер хранит то, что не может прочитать.
Передача сведений о том, какие страницы глоссария вы открываете, по умолчанию выключена и отправляет только случайный ID, проверку и язык.
Удалённое сканирование попадает в корзину, откуда его можно вернуть; старые остановленные сканирования можно выбрать разом.
NeovaBot представляется, соблюдает robots.txt и по умолчанию 3 URL в секунду и никогда не решает CAPTCHA.
Сохраняет сканирование, ресурс со всеми его сканированиями и данными или портфель одним файлом .neova, с сохранённым HTML или без него, в «Загрузки», Google Drive, на любой диск или в папку; расписаний, подключений, ключей и паролей в нём никогда нет.
Устанавливает файл .neova, созданный на любом компьютере с Mac, Windows или Linux; ещё до записи показывает, что новое, что уже есть и что придёт под другим именем, и никогда не заменяет то, что хранится на этом компьютере.
Команда neova сканирует, импортирует, публикует и читает сайты, страницы, отметки, задачи и оповещения из Терминала или скриптов в виде таблиц, CSV или JSON.
neova check сравнивает сканирование с эталоном и завершается с кодом 3 при новых отметках или при отметке, которая выросла сверх заданной доли URL.
Даёт ИИ-ассистентам доступ на чтение к вашим сканированиям, отметкам, задачам и настройкам через 16 инструментов; данные остаются на вашем компьютере.
Добавляет Neova в Claude Desktop в один клик и даёт готовые настройки для копирования в Claude Code, Codex, Cursor, VS Code, Gemini CLI, LM Studio, Windsurf и ChatGPT.
Запускает, останавливает и удаляет сканирования из ассистента; каждый запуск и каждое удаление сначала требуют вашего «да».
Читает лог сканирования и называет, что пошло не так (серии 429 или 503, ответы 403, блокировки в robots.txt, страницы только на JavaScript, слишком мало страниц), и какую настройку поменять.
Один простой JSON-файл хранит список исключений, значения по умолчанию, настройки каждого ресурса и переключатели проверок.
Открывает экспорт Internal из Screaming Frog (с All Inlinks), экспорт URL из Sitebulb, JSON из SiteOne Crawler или любой CSV со столбцом URL и выполняет на нём проверки Neova.
Оценивает импорт, заново загружая выборку из 50 URL со скоростью 2 URL/с и сверяясь с живыми картами сайта, чтобы импорт никогда не выдавал себя за сканирование.
HTTP API Neova Online на app.neova.app/api/v1: чтение портфелей, ресурсов, сканирований, отметок и задач, запуск сканирования и управление задачами; у каждого скрипта свой ключ «Только чтение» или «Чтение и запись», 60 запросов в минуту на ключ и 20 ключей на аккаунт.
Запросы поисковых систем и ИИ-краулеров по каждому URL сканирования из собственного лога доступа сайта.
Засчитывает запрос Googlebot, Bingbot или ИИ-краулеру, только если его адрес есть в списке, который публикует компания-владелец; чужое использование имени считается отдельно.
Перечисляет HTML-страницы, которые Googlebot не посетил за период лога, и URL, которые запрашивали боты, но которых нет в сканировании.
Считает ответы 429 и 403, которые получил каждый бот.
Читает combined-лог Apache или Nginx, обычный или в gzip.
Для сайта за Cloudflare собирает запросы поисковых систем и ИИ-краулеров в вашем собственном аккаунте Cloudflare и читает их перед каждым сканированием; доступ к серверу не нужен.
Пишет запрос для IT-отдела: только строки краулеров, ничего не нужно устанавливать, что нужно знать службе безопасности.
Блок дашборда с запросами ботов.
Сопоставляет каждый URL сканирования старого сайта с URL сканирования нового сайта с оценкой уверенности, для миграции на том же домене или на другом.
Сверяет живой редирект каждого старого URL с картой и отмечает неверные или отсутствующие.
Сравнивает сканирование staging с production: код ответа, noindex, canonical, title, meta description, H1 и URL, которые есть только в одном сканировании.
Меняет местами, какое сканирование старое, а какое новое, или staging и production.
Игнорирует robots.txt и работает быстрее на сайте, который вы подтвердили как свой, с HTTP-аутентификацией и собственными заголовками.
Сканирует список старых URL, чтобы проверить, куда ведёт каждый.
Если стартовая страница staging-поддомена ссылается в основном на рабочий сайт, «Новое сканирование» показывает счётчики и в один клик добавляет правило «Перезапись URL» и XML-карты рабочего сайта; добавленная XML-карта сайта, которую ни одно правило не переносит на сайт, отмечается ещё до начала сканирования.
Каждый ваш ресурс - блок в своём цвете, с логотипом и ключевыми числами, а его конкуренты - строки под ним.
Перетаскивайте ресурсы в свой порядок, который сохраняется на Mac, онлайн и на телефоне.
Сворачивает семейство в одну строку, «Свернуть все» и «Развернуть все», и закреплённый поиск по клавише /.
Таблица всех ресурсов, где каждый конкурент вложен под свой ресурс.
Один центр на сайт: его сканирования, «Для клиента», Core Web Vitals, Google Search Console, конкуренты, план действий, анализ и расписания.
Брендированный отчёт (PDF), книга со всеми отметками (Excel) и задачи, по одной кнопке на каждое, из открытого сканирования.
Каждая кнопка в шапке ресурса объясняет, что она делает и чем отличается от другой.
Группирует ресурсы по клиенту или компании, с цветом, и вложенные портфели на один уровень.
Даёт каждому ресурсу цвет и код из 2-6 букв, предложенный по его домену.
Находит ресурс по ⌘K: сначала закреплённые и те, что сканируются сейчас, а под каждым портфелем - его ресурсы и конкуренты.
Пять последних сканирований ресурса и чем закончилось каждое; любое открывается в один клик.
Выбирает сканирования флажками или кнопкой «Выбрать старые остановленные и прерванные», затем «Удалить выбранные».
В каждой строке списка одна главная кнопка, а в ⋯ и по правому клику - все действия, «Удалить» последним и красным.
Библиотека проверок на app.neova.app/checks, «Справка Neova SEO Platform», «Что нового», «Сообщить о проблеме», сочетания клавиш и «Проверить обновления».
Загрузка, установка, первое сканирование, Neova Online и десктопное приложение, необязательные подключения и список изменений - на app.neova.app/help.
Все 694 проверок по группам на app.neova.app/checks, у каждой своя страница и источник; открывается через «Об этой проверке» везде, где названа проверка.
Один раз сообщает, что результаты Neova - это автоматический анализ для информации, а что менять, решаете вы.
На панели каждой проверки есть «Об этой проверке»: эта ссылка открывает страницу проверки в библиотеке проверок, где сказано, что она отмечает, и указан её источник.
Все версии с первой сборки, новые сверху; каждое изменение помечено «Новое», «Улучшено» или «Исправлено», со временем выпуска в вашем часовом поясе. Окно открывается само один раз после обновления, а вверху, в «Скоро появится», - то, что запланировано.
Собирает для поддержки один ZIP с версиями приложения, логом выбранного сканирования и его небольшими файлами, секреты скрыты; ещё до создания показывает, что в нём будет и чего в нём не будет никогда.
По этому запросу функций не найдено.
Тариф Free или 14 дней Desktop бесплатно, без карты. Mac, Windows и Linux. Ваши сканирования остаются на вашем компьютере.
Скачать NeovaNeova Online, та же Neova в браузере, входит в Desktop + Online и Agency: посмотреть тарифы.