NeovaPlataforma avançada de SEO
694 verificações471 recursosMac, Windows, Linux e a web14 dias de Desktop grátis

O crawler de SEO que faz o trabalho depois do crawl

Feito por SEOs, para SEOs. A Neova rastreia a partir do seu próprio computador e depois diz quais sinalizações importam e o que corrigir primeiro, escreve os tickets, monta o relatório do cliente e fica de olho no site. Dois minutos de vídeo e, depois, tudo o resto.

694verificações, cada uma com a sua fonte
490não precisam de nenhuma conexão
471recursos, todos listados abaixo
15idiomas
3 + webMac, Windows, Linux e Neova Online

Feita para o trabalho depois do crawl

O crawl é só o começo. Veja o que a Neova faz com ele.

Crawl

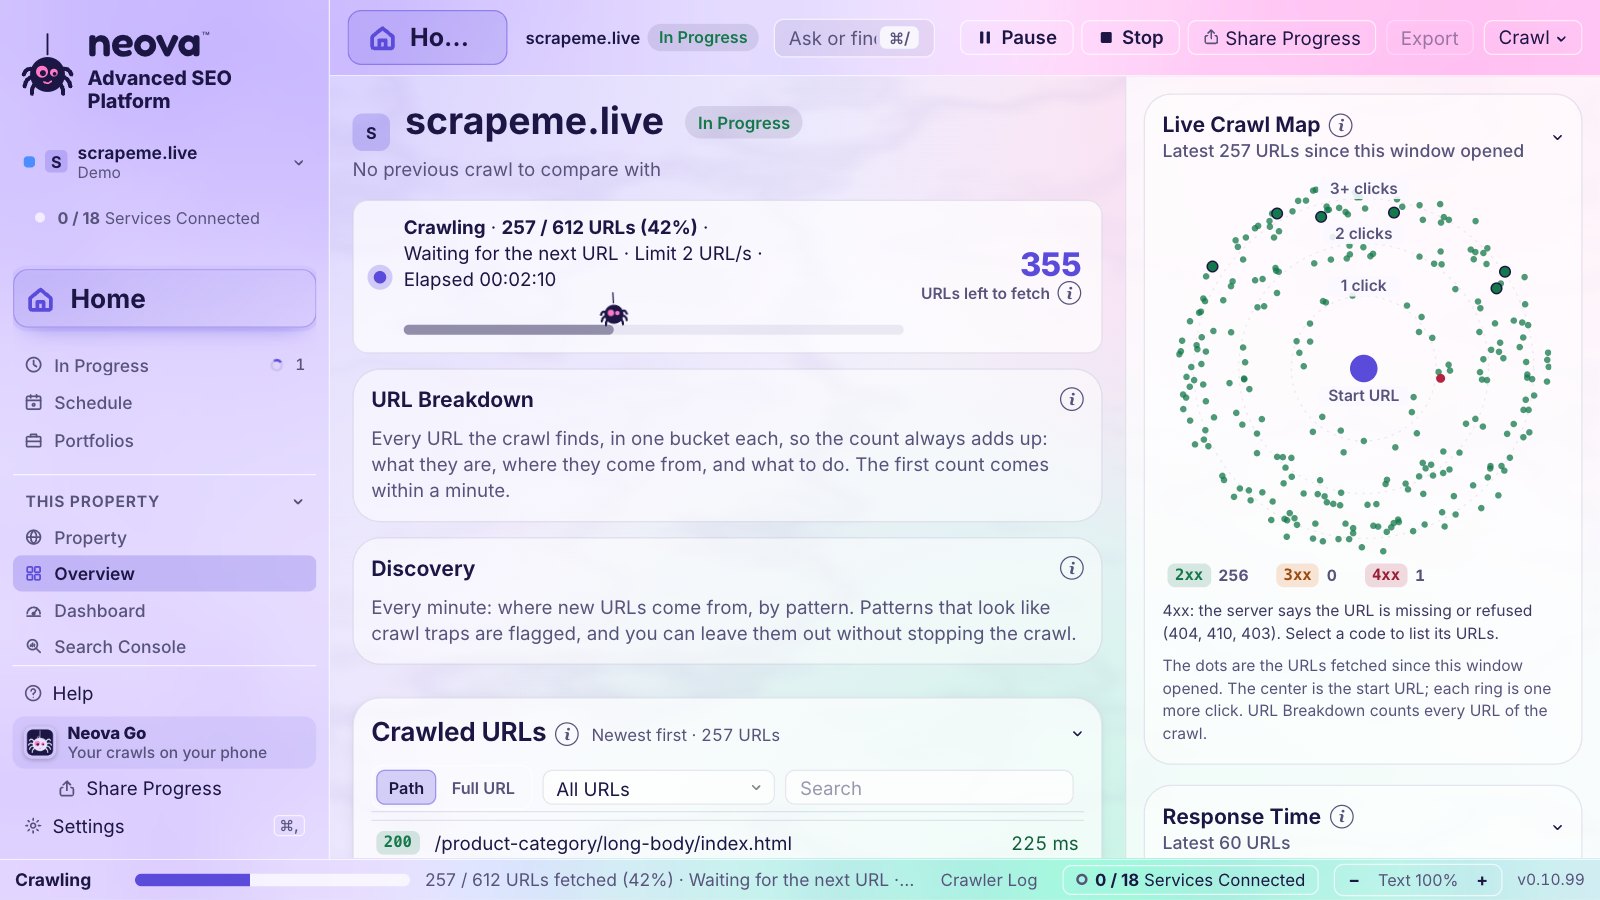
Rastreie vários sites ao mesmo tempo e acompanhe ao vivo

Vários sites ao mesmo tempo, cada um no seu ritmo, num mapa ao vivo de cada URL que chega.

4sites ao mesmo tempo
3modos de crawl
1janela
Spider, Lista ou AmostraMapa do crawl ao vivoRetome de onde parouRenderização de JavaScript no Chrome
▶ Assista: Seu primeiro crawl 1:58
Resultados

694 verificações, e cada sinalização diz o porquê

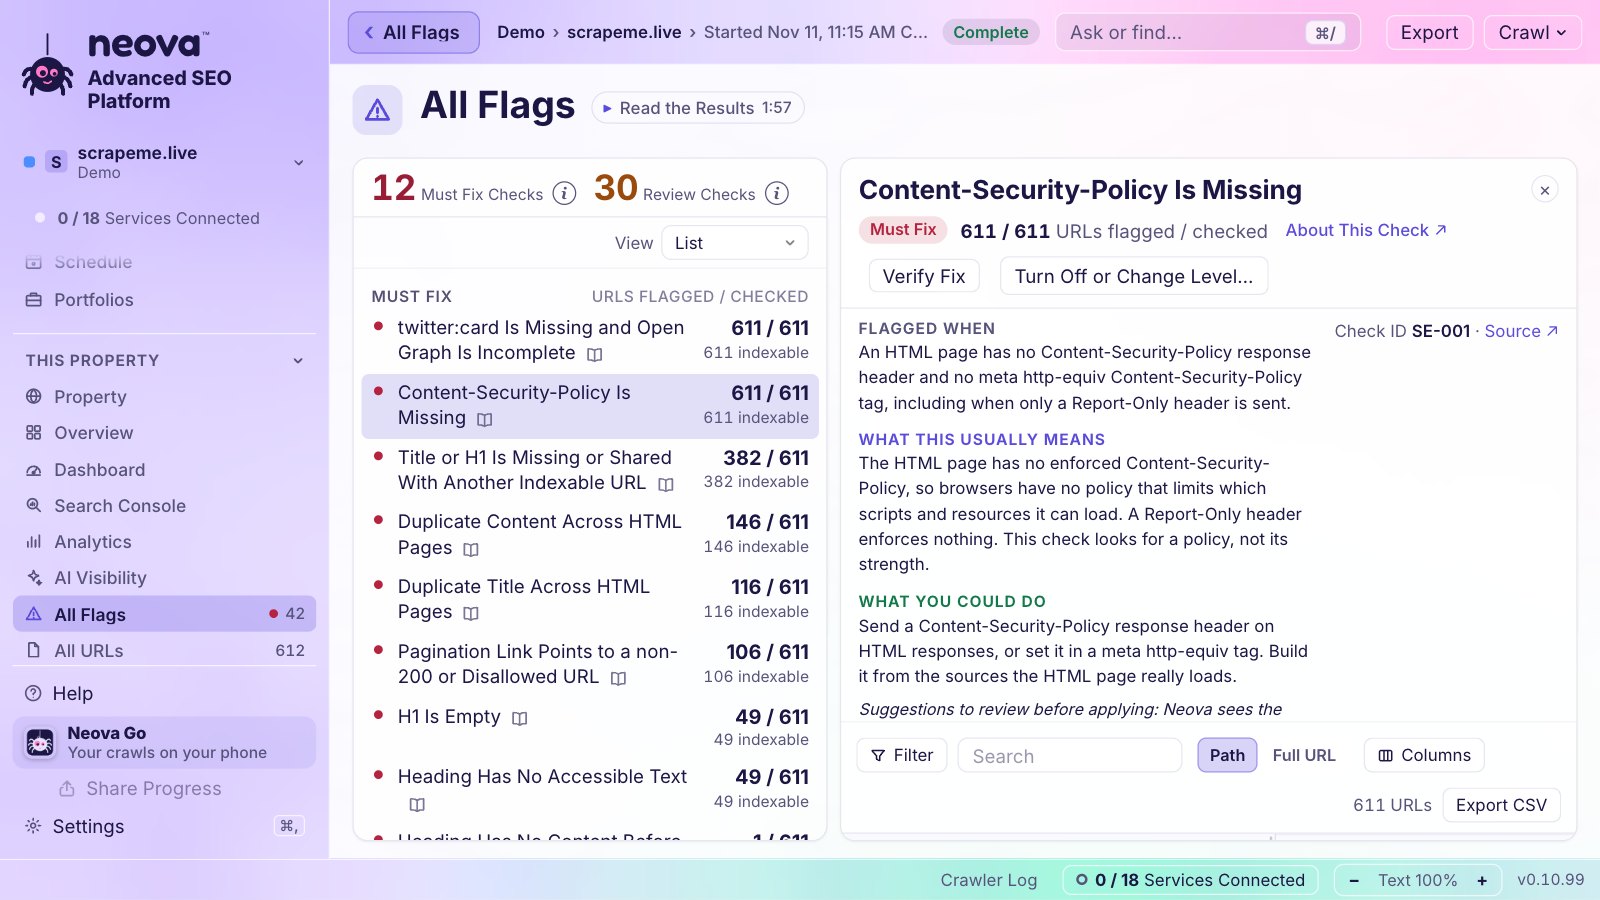
Cada sinalização diz por que dispara, o que costuma significar e de onde vem a regra.

694verificações
490não precisam de nada conectado
2níveis
Caixa PerguntarComparar crawls
▶ Assista: Leia os resultados 1:57
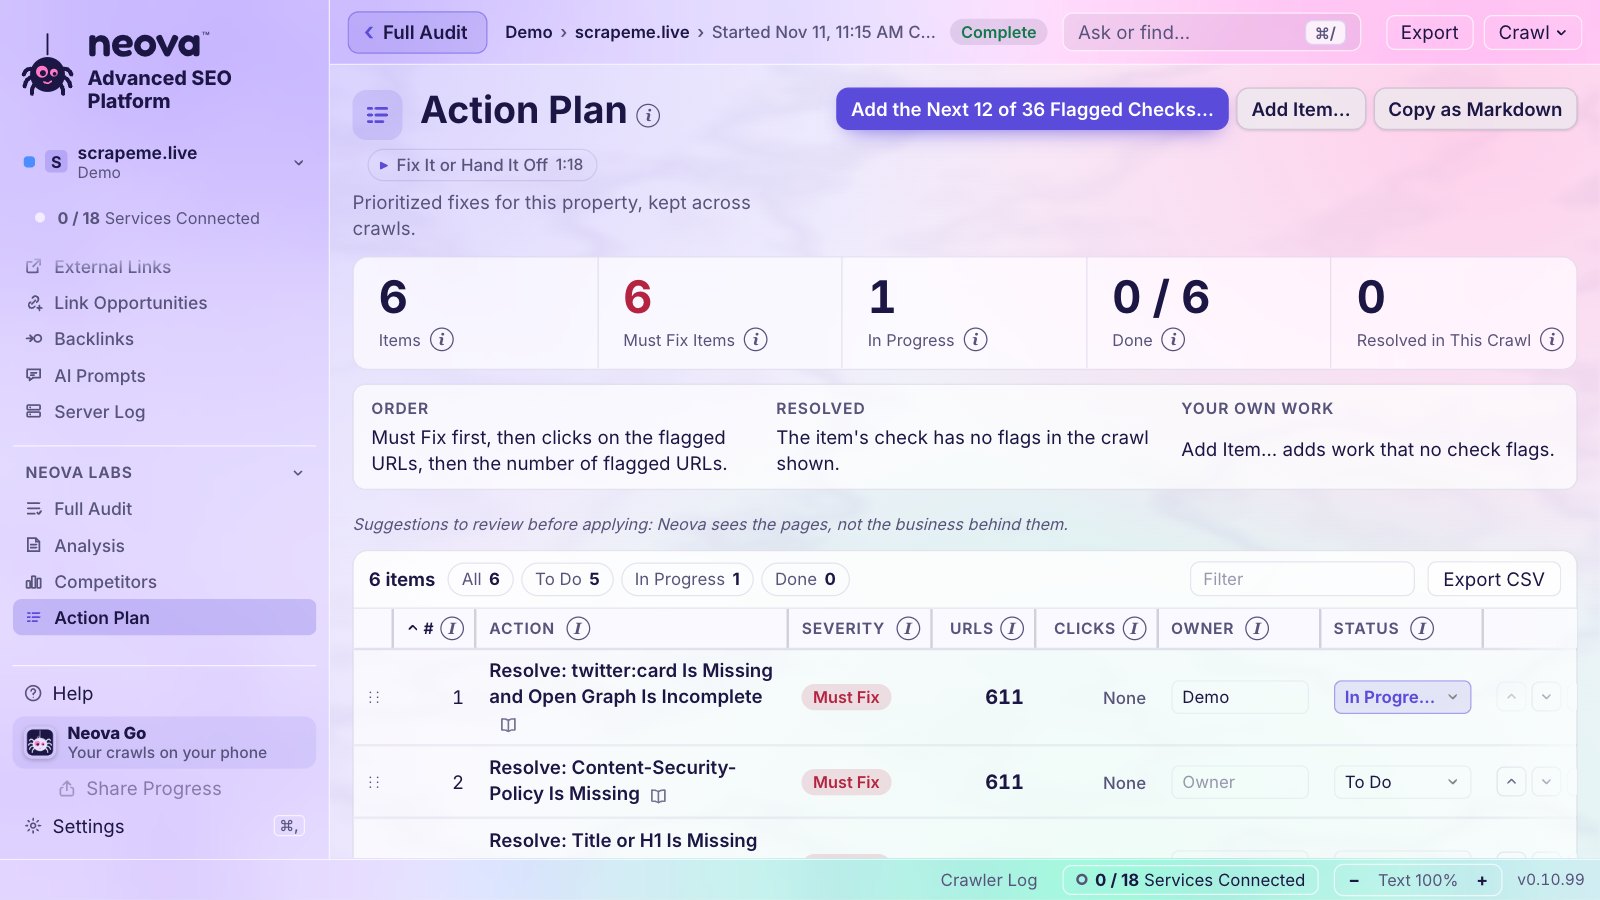
Plano de ação e tickets

Das sinalizações ao trabalho, Corrigir primeiro

As sinalizações viram trabalho: responsáveis, status, Corrigir primeiro, mantidas de um crawl para o outro.

1ticket por verificação
10gerenciadores de tarefas por arquivo de importação
Responsáveis e statusCSV e MarkdownBuscar de novo as URLs com erro
▶ Assista: Corrija ou repasse 1:18
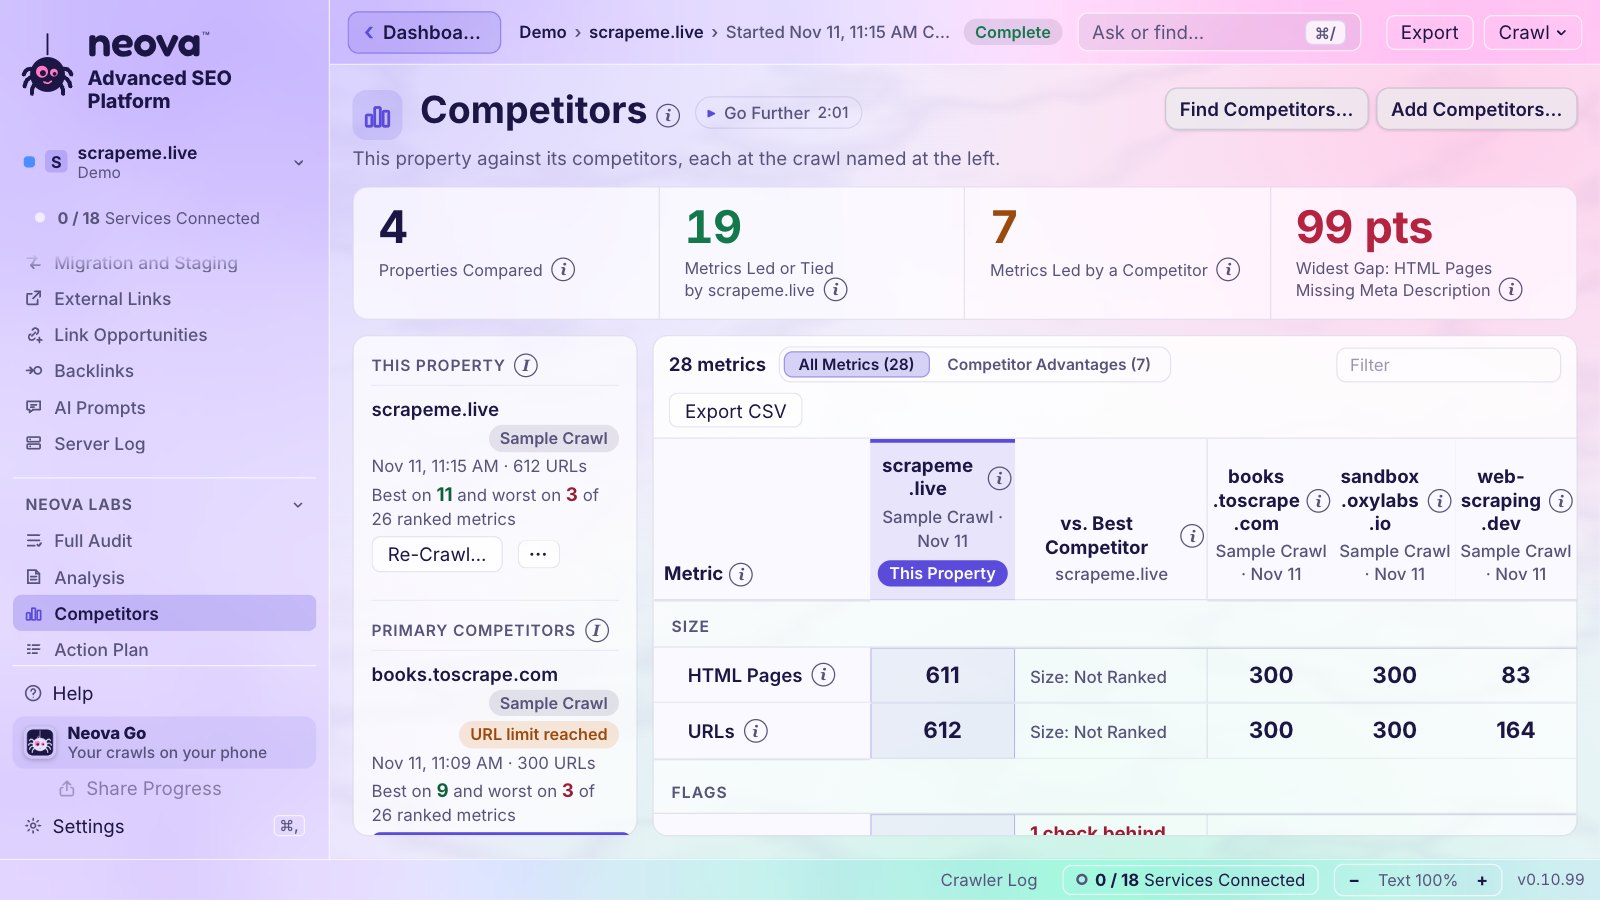
Concorrentes

Seus concorrentes, rastreados do mesmo jeito

Cole uma lista. A Neova dimensiona cada crawl pelos sitemaps deles e mostra quem lidera, métrica por métrica.

Só comparações justasVisibilidade e backlinks com a DataForSEODescoberta de concorrentes
▶ Assista: Vá além 2:01
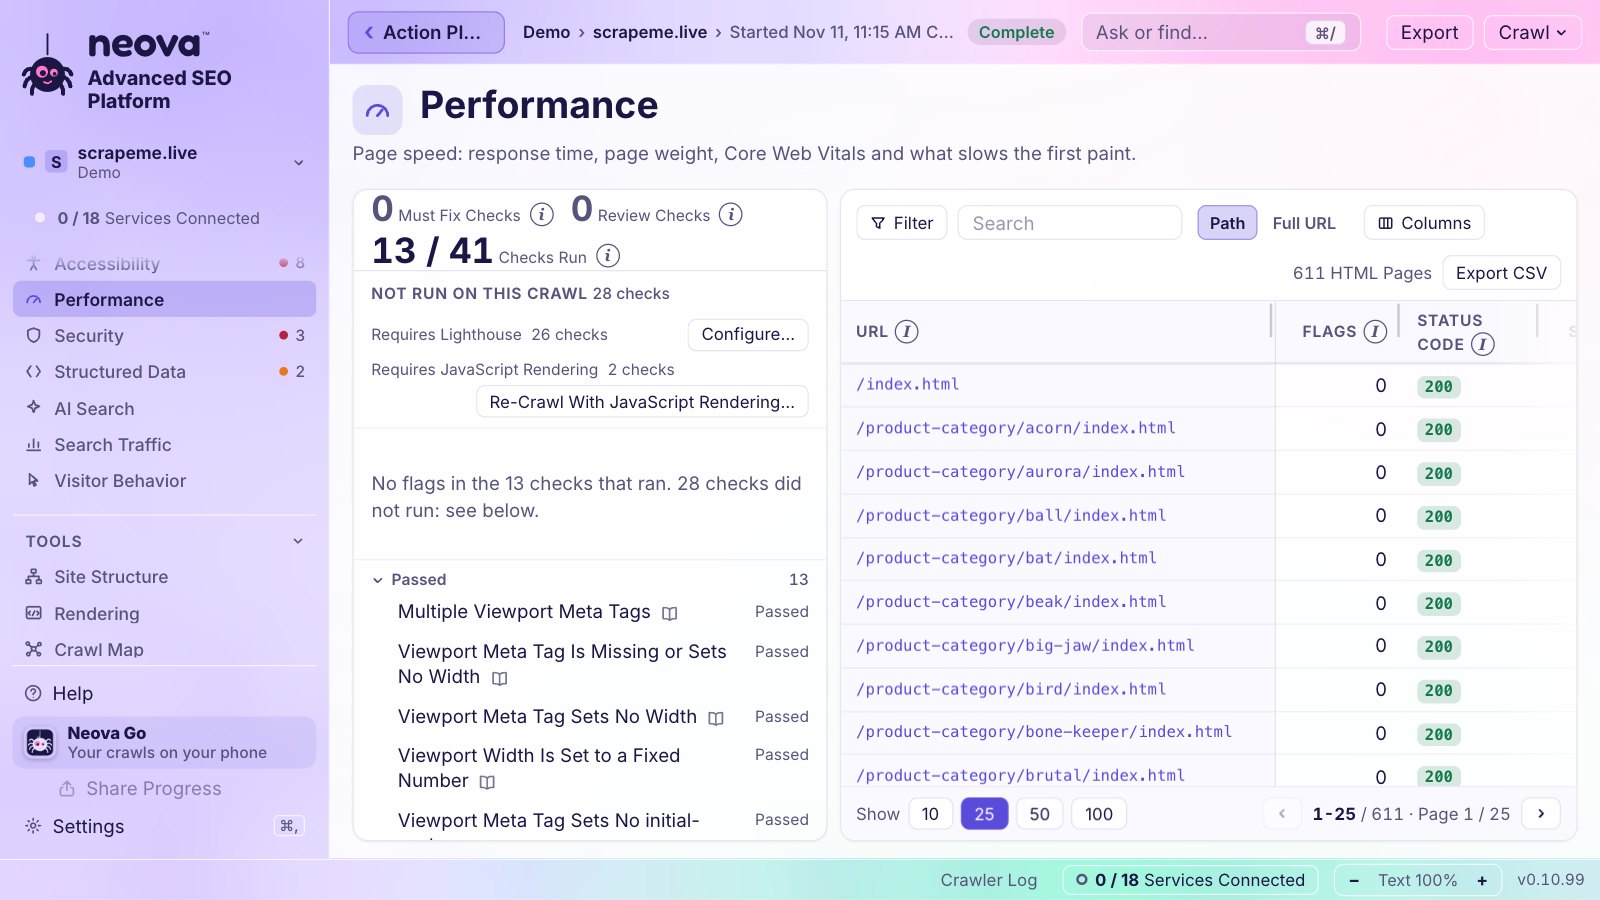
Desempenho

Core Web Vitals de usuários reais do Chrome

O que visitantes reais no celular recebem, por grupo de páginas, com um alerta quando uma nota muda.

3métricas de usuários reais
40semanas de tendência
3agendamentos: diário, semanal, mensal
Chrome UX ReportAlertas quando uma nota muda
▶ Assista: Agendamento e monitoramento 1:09
Já rastreou em outra ferramenta?

Traga seus outros crawls com você

Abra as exportações deles e rode as verificações da Neova no que eles encontraram. Fique com as ferramentas de que você gosta.

694verificações no seu crawl antigo
0novos crawls
Sem rastrear de novoAs verificações da Neova nos seus dados
Exportação do Screaming FrogExportação do SitebulbJSONSiteOne CrawlerCSVQualquer lista de URLs
Neova694 verificações, nos seus dados
Neova GoAO VIVO

Pode sair. A Neova continua rastreando.

Feche a janela. O crawl continua na barra de menus, e o seu celular mostra cada propriedade.

1QR code
4lugares para alertas
Barra de menusSeu celular, por QR codeCompartilhar progressoSlack e Teams
▶ Assista: Neova Go 1:27
Para o cliente

Tudo o que o seu cliente recebe, num só lugar

Tudo o que o seu cliente recebe, de um só lugar, criptografado no seu computador antes de qualquer link ser compartilhado.

6formas de entregar
Relatório PDFGoogle SheetPacote para o clienteCompartilhar um link
▶ Assista: Compartilhe com um cliente 1:23
PDFRelatório com sua marcaXLSXPasta de trabalhoSHEETPlanilha GoogleZIPPacote para o cliente.neovaArquivo NeovaLINKCompartilhar um link
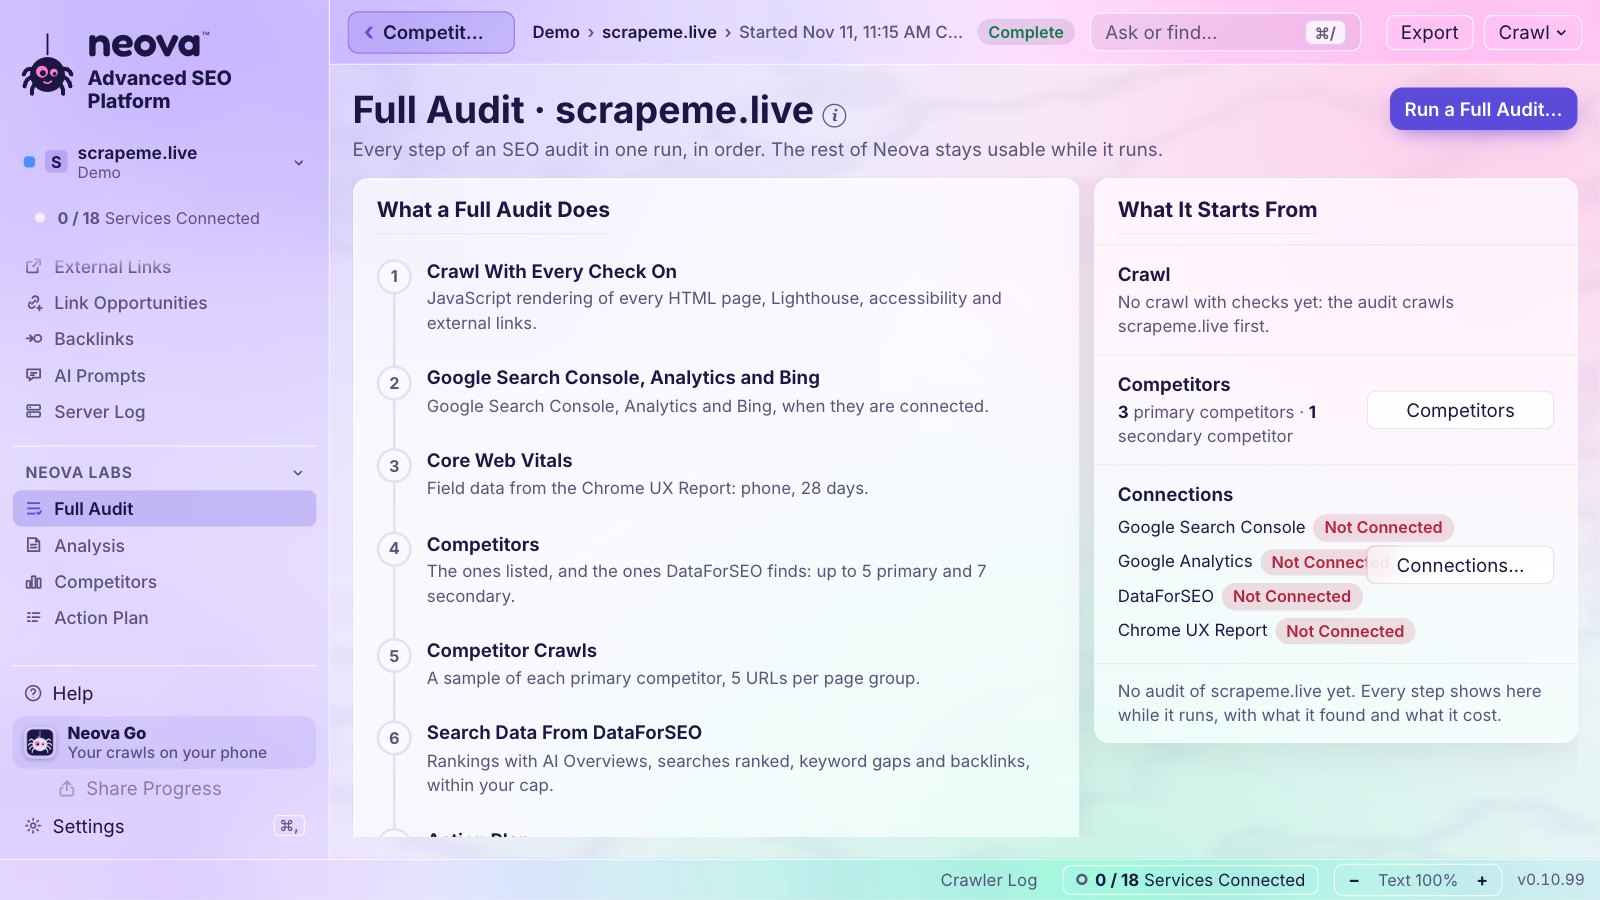
Auditoria completa

Todas as etapas, numa só execução

O crawl, Google, Bing e Analytics, Core Web Vitals, concorrentes, o plano e o PDF, em uma só execução.

1botão
8etapas
12auditorias por ano, sozinhas
Um botãoTodo mês, sozinhaPDF com a sua marca
▶ Assista: Vá além 2:01

Conheça os mascotes

Um mascote animado que fica na sua área de trabalho e fica de olho nos seus crawls. Ele avisa quando um crawl precisa de você, responde às suas perguntas sobre o crawl e leva você à tela certa com um clique. É opcional e fica desligado até você escolher um.

8mascotes, cada um com sua função
2estilos: fofo ou pixel art
7tamanhos, de 56 a 320 px

Como os mascotes funcionam →

WebsterA aranha da Neova. Rastreia tudo, não deixa nada passar.
The HeadO bot do SEO ProCheck: um rosto de JSON-LD e um @ como monóculo.
Sir CanonicalAponta a única URL verdadeira, com toda a educação.
Polly GlotFala 15 idiomas e confere o seu hreflang.
HopperSempre em outro lugar: 301, 302 e cadeias.
ShellyUm caracol de sitemap: lento, constante e em todas as listas.
robots.txtBoO segurança do robots.txt: decide quem entra.
ZapUm vaga-lume que ilumina as páginas lentas.

Funciona com o que você já usa

31 serviços, todos opcionais: a Neova faz o trabalho dela sem nenhum deles, e faz mais com eles.

Google Search ConsoleGoogle AnalyticsChrome UX ReportGoogle CloudGeminiBing Webmaster ToolsOneDriveMicrosoft TeamsDataForSEOSemrushAhrefsMajesticMozSEO GetsAnthropicOpenAIOllamaJiraLinearAsanaClickUpmonday.comSlackCloudflareGoogle DriveDropboxiCloud DriveProton DrivekDriveScreaming FrogSitebulbGoogle Search ConsoleGoogle AnalyticsChrome UX ReportGoogle CloudGeminiBing Webmaster ToolsOneDriveMicrosoft TeamsDataForSEOSemrushAhrefsMajesticMozSEO GetsAnthropicOpenAIOllamaJiraLinearAsanaClickUpmonday.comSlackCloudflareGoogle DriveDropboxiCloud DriveProton DrivekDriveScreaming FrogSitebulb

Todos os 471 recursos, em 24 áreas

Abra uma área para ver todos os recursos dela, ou busque em todos.

Crawl76 recursosLog do crawler, Crawl em modo spider, Crawl em modo lista e mais 73
  • Log do crawler

    Um log ao vivo do crawl: cada URL buscada com o código de status colorido e o tempo de resposta, cada etapa em negrito, falhas em vermelho e avisos em âmbar; Copiar log guarda todas as linhas para o suporte.

  • Crawl em modo spider

    Segue os links internos a partir de uma URL inicial, e os sitemaps XML quando estão ligados, do jeito que um mecanismo de busca descobre um site.

  • Crawl de lista

    Rastreia só as URLs que você cola ou envia em um arquivo, nada mais.

  • Verificação da URL inicial

    Lê o site antes de o crawl começar e escolhe a versão (http ou https, com ou sem www) que responde 200, dizendo o que as outras versões fazem.

  • Rastrear os subdomínios também

    Pergunta se deve rastrear os subdomínios que a Neova encontrou, e quais.

  • Crawl do site inteiro

    Rastreia o site inteiro sem limite de URLs, a menos que você defina um.

  • Pastas específicas

    Rastreia só as pastas que você digita, e avalia a completude pelas URLs do sitemap XML dentro delas.

  • Amostra por grupo de páginas

    Rastreia um número definido de páginas de cada grupo de páginas, para que um site grande seja auditado em minutos com todos os templates cobertos.

  • Níveis de crawl

    Três níveis em uma só escolha: Só crawl, Auditoria do site (adiciona Core Web Vitals e um rascunho do Plano de ação) e Auditoria completa (adiciona concorrentes, dados de busca e a análise).

  • URLs semente

    Adiciona URLs iniciais extras de um arquivo TXT ou CSV, ou coladas, para chegar a páginas que nenhum link alcança.

  • Sitemaps XML no crawl

    Rastreia as URLs listadas nos sitemaps XML que o robots.txt declara, depois das páginas que os links alcançam.

  • Adicionar sitemaps XML

    Lê sitemaps XML extras que você indicar, além dos que o robots.txt declara, em todo crawl da propriedade.

  • Recursos

    Escolhe quais recursos são rastreados além das páginas HTML: imagens, CSS, JavaScript e PDFs.

  • Ordem do crawl

    Páginas primeiro busca todas as páginas HTML antes das imagens e arquivos, para que o núcleo da auditoria fique pronto antes; Por profundidade busca primeiro o que está mais perto da URL inicial.

  • Seguir links em

    Registra os links de menu, rodapé e filtros sem segui-los; os links do corpo são sempre seguidos.

  • Incluir e excluir

    Rastreia ou pula URLs por padrão regex, um por linha, com um campo para testar uma URL contra eles.

  • Lista de exclusão para todo crawl

    Uma única lista de exclusão que todo crawl usa, não importa quem o inicie: a janela, um agendamento ou um assistente de IA.

  • Reescrita de URL

    Reescreve URLs com regras regex antes de rastreá-las, por exemplo para remover parâmetros de rastreamento, ou para trazer para o host de staging os links de um site de staging que apontam para o site no ar, e os sitemaps XML do site no ar.

  • Parâmetros de URL

    Mantém ou remove as query strings ao rastrear.

  • Seguir nofollow interno

    Rastreia links internos marcados com rel=nofollow quando você quiser.

  • URLs em minúsculas

    Trata /Page e /page como uma URL só.

  • Rastrear fora da pasta inicial

    Deixa um crawl que começa em uma pasta ir além dela.

  • Limites

    Limite de URLs, Limite de profundidade do crawl, Máximo de URLs por pasta, Comprimento máximo da URL e Máximo de parâmetros de consulta, para manter a navegação facetada sob controle.

  • Velocidade respeitosa com ajuste automático

    Rastreia a 3 URLs por segundo por padrão e reduz a velocidade pela metade sozinha quando o servidor fica lento ou responde 429 ou 503, respeitando o Retry-After.

  • Um só relógio para todas as requisições

    Espaça cada requisição na velocidade pedida, incluindo robots.txt e sitemaps XML, para que o site nunca receba uma rajada.

  • Mais rápido no seu próprio site

    Depois que você confirma que o site é seu, vai até 50 URLs por segundo e pode ignorar o robots.txt, no seu próprio site ou em um servidor de staging.

  • User agent

    Rastreia como NeovaBot por padrão, ou como Googlebot, Bingbot, Applebot, crawlers de IA como GPTBot e ClaudeBot, ferramentas de SEO, navegadores ou uma string personalizada.

  • robots.txt: respeitar, ignorar ou usar rascunho

    Respeita o robots.txt no ar, ignora-o em um site seu, ou respeita um rascunho salvo no Testador de robots.txt para ver o que uma mudança faria.

  • Renderização de JavaScript

    Renderiza as páginas HTML no Chrome depois do crawl, todas ou algumas por grupo de páginas, e compara a página renderizada com o HTML bruto; desligado por padrão.

  • Espera da renderização

    Espera a rede ficar quieta e a página parar de mudar, até um limite de estabilização, e avisa quando uma página ainda estava mudando.

  • Selo de crawl sem renderização

    Avisa acima dos resultados quando um crawl rodou sem renderização, quantas verificações não puderam rodar por causa disso, e oferece Rastrear de novo com renderização.

  • Rastrear com o Chrome

    Busca cada URL com o Chrome, como um visitante, em sites com proteção contra bots; você mesmo resolve qualquer CAPTCHA e a Neova espera por você.

  • Autenticação e cabeçalhos

    Envia autenticação HTTP, cookies e cabeçalhos personalizados só para o site rastreado, para sites de staging e áreas logadas.

  • Cabeçalho de lista de permissões

    Cria um cabeçalho secreto para um site que você controla, enviado só a esse site, com a regra para entregar à equipe de TI, para que o firewall deixe a Neova passar.

  • Perfis de crawl

    Salva uma configuração com um nome para reutilizar em qualquer site, mostrando de relance o que ela define.

  • Ajustes por propriedade

    Dá a uma propriedade seus próprios ajustes de crawl, de onde partem Novo crawl, Rastrear de novo e os agendamentos dela, com Restaurar padrões.

  • Ajustes Simples ou Especialista

    Mostra os ajustes que a maioria das pessoas muda, ou todos os ajustes com uma nota sobre como cada um funciona.

  • Resumo antes de começar

    Lista cada ajuste diferente do padrão antes de o crawl começar, cada um com um link Editar.

  • Estimativa Antes de começar

    Lê algumas páginas primeiro e diz quantas URLs os sitemaps XML listam, as imagens e arquivos a esperar, e o espaço em disco necessário comparado ao espaço livre.

  • O que esperar

    Diz, a partir das páginas da amostra, quantas imagens há por página, quais parâmetros os links levam e quais endereços estão escritos errado.

  • Conexão conferida antes de começar

    Confere a conexão com o Google da propriedade antes de um crawl ou auditoria começar e o segura com Entrar de novo, Fazer o crawl sem esses dados ou Cancelar quando o login está quebrado.

  • Tela do crawl ao vivo

    Mostra o crawl enquanto ele roda: etapas numeradas, o que ele faz agora, as URLs restantes e cada quadro abaixo, todos recolhíveis.

  • Etapas do rastreamento

    Mostra as etapas pelo nome (Rastreando o site, Rastreando os XML Sitemaps, Rastreando os recursos, Renderizando as páginas, Executando as 694 verificações) com o que cada uma buscou.

  • Linha Agora

    Diz em uma linha o que o crawl faz neste momento e o último endereço buscado.

  • Buscado por tipo de conteúdo

    Três barras sob o progresso: Páginas HTML, Imagens, e CSS, scripts e outros arquivos, cada uma com os buscados sobre os encontrados.

  • O que falta, em destaque

    Mostra as URLs que ainda faltam buscar, depois as que ainda faltam verificar, em letras grandes com uma barra.

  • Descoberta

    A cada minuto, diz de onde vêm as novas URLs por padrão, sinaliza formatos de armadilha de rastreamento (calendários, pastas repetidas, IDs de sessão, muitos parâmetros, URLs profundas e longas) e oferece excluí-las ou pulá-las na hora.

  • Escolha o que acontece

    Para cada grupo de URLs encontrado, oferece Continuar rastreando, Pular ou Excluir, cada um com o que fica na auditoria e o que sai dela, e o recomendado marcado.

  • Detalhamento das URLs

    Coloca cada URL que o crawl encontra em exatamente um grupo (URLs de página limpas, Variantes com parâmetros, URLs malformadas, Armadilhas de rastreamento, Imagens, CSS, JavaScript e fontes, Documentos, Vídeo e áudio, Outros recursos), então a contagem sempre tem explicação.

  • Amostra de imagens

    Busca as imagens das primeiras 1, 3, 5, 10, 25, 50 ou 100 páginas de cada grupo de páginas, com as imagens e o tempo que cada tamanho representa, ou pula o resto, ou mantém todas as imagens.

  • Pular os recursos restantes

    Quando todas as páginas já foram buscadas, pula as imagens e arquivos restantes para que o crawl termine como concluído e as verificações rodem.

  • Aviso de profundidade de clique

    Mostra a página mais profunda até agora durante o crawl, em âmbar a partir de 4 cliques, com uma linha de aviso a partir de 10 cliques.

  • Mapa do crawl ao vivo

    Desenha as últimas 300 URLs por profundidade de clique, coloridas pelo código de status, com as URLs que só estão no sitemap em um anel próprio.

  • Tempo de resposta

    Mostra o tempo de resposta mediano das últimas URLs em um gráfico com as linhas de 800 ms e 1,800 ms.

  • URLs rastreadas

    Lista as URLs à medida que são buscadas, 10, 25, 50 ou 100 por página, com filtros para 2xx, 3xx, 4xx, 5xx e Sem resposta, alteradas e novas.

  • Mudanças em destaque durante o crawl

    Compara cada URL, à medida que é buscada, com o crawl anterior mais recente da propriedade que leu páginas, de preferência um Crawl do site inteiro, senão um crawl de Amostra ou de Pastas específicas, e mostra o valor antigo riscado ao lado do novo.

  • A auditoria, por categoria

    Mostra as verificações rodando por categoria, cada uma com quantas de suas URLs já foram lidas, e a contagem de sinalizações depois de gravada.

  • Links e Notícias

    Lista as páginas do próprio Google que combinam com o que o crawl mostra e as notícias da Pesquisa Google dos últimos 45 dias: atualizações de ranking, o blog do Search Central e atualizações da documentação.

  • Enquanto você espera

    Sugere leituras que combinam com o crawl: o Google Search Status Dashboard e os estudos de caso e atualizações de algoritmo da SEO ProCheck.

  • Pausar e retomar

    Congela o crawl e o continua exatamente de onde parou.

  • Opções de parada

    Parar pergunta: Passar para os sitemaps XML, Parar e executar as verificações, Parar e excluir este crawl, ou Continuar rastreando; durante a renderização, Pular a renderização.

  • Retomar um crawl parado

    Continua um crawl parado ou interrompido com os próprios ajustes restaurados, nunca do zero.

  • Executar as verificações

    Roda todas as verificações de novo sobre o que um crawl buscou, sem buscar nada de novo, inclusive em um crawl que foi até o fim, para que uma verificação melhorada em uma nova versão chegue aos crawls guardados; roda ao lado dos crawls de outros sites.

  • Rastrear de novo

    Rastreia a propriedade de novo com os ajustes do último crawl, sem mexer nos dados conectados, nos concorrentes nem no plano dela.

  • Crawl bloqueado, explicado

    Quando o site recusa o crawl, diz por quê (limite de requisições, bloqueio por firewall ou por país ou região, acesso proibido) e o que fazer em seguida.

  • Links quebrados nunca param um crawl

    Um endereço que não pode ser uma URL, como uma frase dentro de um href, não é seguido e vira uma sinalização.

  • Fontes e imagens no CSS

    Procura fontes, imagens de fundo e folhas de estilo importadas em cada folha de estilo que busca.

  • Arquivos em outros hosts

    Lista os arquivos e imagens que as páginas carregam de outros hosts, sem rastreá-los.

  • Mídia de CMS reconhecida como imagem

    Conta como imagens as URLs de mídia de CMS sem extensão de imagem, como os handlers /-/media/ do Sitecore.

  • Grupos de páginas a partir do HTML

    Agrupa páginas por template a partir do HTML (as palavras de template do próprio tema, senão o esqueleto da página), e por padrão de endereço em sites muito grandes.

  • Links de paginação seguidos

    Segue links rel=next e rel=prev no head, além das âncoras.

  • Fila de crawls

    Põe crawls na fila e inicia cada um assim que uma vaga de crawl fica livre, nunca dois crawls do mesmo site ao mesmo tempo, com Iniciar a fila, Limpar fila e Quando as verificações terminarem.

  • Crawls grandes em disco

    Mantém o crawl em disco em vez da memória (60 MB de memória com 60,000 URLs), então o tamanho é limitado pelo disco, não pela memória.

  • Vários sites ao mesmo tempo

    Crawls de até 4 sites rodam ao mesmo tempo, cada um no seu ritmo e com seu limite de URLs, com uma proteção de memória que segura um crawl quando o computador fica com pouca memória; qualquer crawl guardado ou propriedade abre enquanto eles rodam.

  • Novo crawl usa os ajustes da propriedade

    O Novo crawl preenche o formulário com os ajustes salvos da propriedade (velocidade, escopo, limite de URLs, renderização, user agent, sitemaps XML e o resto), também quando o endereço do site é digitado em URL inicial; suas últimas respostas nesta janela continuam valendo primeiro, e nada que você já mudou é sobrescrito.

  • Espera quando a conexão cai

    Quando este computador perde a conexão com a internet, o crawl avisa, espera e continua sozinho quando ela volta, em vez de parar como se o site estivesse fora do ar; depois de 30 minutos offline, ele para e diz por quê.
Conteúdo19 recursos · 82 verificaçõesCategoria Conteúdo, Title tags, Tabelas de meta description e H1, Conteúdo duplicado e quase duplicado e mais 16
  • Categoria Conteúdo

    Lista cada página HTML com title, meta description e H1 e seus comprimentos, e as verificações de conteúdo com suas sinalizações.

  • Tabelas de títulos de página, meta description e H1

    Conjuntos de colunas de Todas as URLs para titles, meta descriptions e H1s, cada um com filtros para ausente, vazio, duplicado, longo demais e curto demais.

  • Conteúdo duplicado e quase duplicado

    Sinaliza titles, descriptions, H1s e H2s duplicados, e texto duplicado ou quase duplicado entre páginas HTML.

  • Legibilidade

    Sinaliza texto principal nas faixas Difícil e Muito difícil do índice Flesch, e páginas rasas com menos de 200 palavras.

  • Ortografia e gramática

    Sinaliza possíveis erros de ortografia e gramática no texto principal.

  • Conteúdo datado

    Sinaliza titles e H1s que citam um ano passado e texto que menciona uma oferta, prazo ou data de evento que já passou.

  • Open Graph e X Cards

    Verifica as tags que definem o título, a descrição e a imagem que uma página mostra quando é compartilhada.

  • Snippet na SERP

    Mostra como o title e a description de uma página aparecem nos resultados de busca.

  • Revisão de conteúdo por IA

    Um modelo no seu computador lê as páginas HTML para 20 verificações de conteúdo que exigem julgamento, como falta de exemplos, afirmações sem respaldo ou falta de autoria; as sinalizações dele ficam separadas de Corrigir e Revisar.

  • Mudanças de conteúdo entre crawls

    Mostra quais titles, meta descriptions e H1s mudaram desde o crawl anterior, com o antes e o depois.

  • Aba Conteúdo do dashboard

    Barras de comprimento de title, meta description e H1, grupos de páginas e as páginas HTML mais linkadas.

  • Páginas HTML em Markdown

    Exporta o conteúdo principal de cada página HTML como um arquivo Markdown por página, com um índice.

  • Headings

    Sinaliza H1s e H2s ausentes, vazios, longos e duplicados, um primeiro H1 que não é o título principal, e páginas longas sem H2.

  • O básico da página

    Sinaliza charset, doctype ou tag body ausentes, favicon quebrado, elementos obsoletos e frames que guardam o conteúdo.

  • Vazamentos na página

    Sinaliza Lorem Ipsum, código de template, valores de script vazios e saída de erro ou de debug do servidor exibida como texto da página.

  • Páginas rasas e pesadas

    Sinaliza proporção baixa entre texto e HTML, e texto principal com menos de 200 ou mais de 5,000 palavras.

  • Conteúdo sindicado

    Sinaliza conteúdo sindicado sem noindex nem canonical para o original.

  • Página Sobre

    Sinaliza a falta de uma página Sobre, ou uma que não é linkada pelo site.

  • Entidades com o Google Natural Language

    Lê as entidades das páginas HTML principais com a sua chave do Google Natural Language, para as verificações de conteúdo.

SEO técnico24 recursos · 22 verificaçõesCódigos de status, Categoria Redirecionamentos, Cadeias e loops de redirecionamento e mais 21
  • Códigos de status

    O código de status de cada URL, com a mesma cor em todo lugar: 2xx verde, 3xx laranja, 4xx e 5xx vermelho, e Sem resposta à parte.

  • Categoria Redirecionamentos

    Para onde vão os redirecionamentos, quantos saltos fazem, loops, redirecionamentos temporários, meta refresh e redirecionamentos por JavaScript, e os links que apontam para eles.

  • Cadeias e loops de redirecionamento

    Sinaliza URLs internas com 2 ou mais saltos de redirecionamento, loops de redirecionamento, redirecionamentos para si mesmas e cabeçalhos Location ausentes ou malformados.

  • Redirecionamentos temporários

    Sinaliza redirecionamentos internos 302, 303 e 307, deixando de lado os destinos de login.

  • Onde os redirecionamentos terminam

    Sinaliza redirecionamentos internos que terminam em um 4xx ou 5xx, em uma URL com noindex, canonicalizada ou bloqueada, ou em outro site.

  • Barra final e maiúsculas

    Sinaliza URLs que redirecionam só para acrescentar uma barra ou trocar maiúsculas e minúsculas, e páginas que só diferem assim sem canonical entre elas.

  • Redirecionamentos de recursos e links externos

    Sinaliza imagens, scripts e folhas de estilo que redirecionam, e links externos que redirecionam ou terminam em erro.

  • Tabelas de canonicals e diretivas

    Conjuntos de colunas para canonicals e para diretivas meta robots, com filtros Noindex e Nofollow.

  • Cabeçalhos HTTP

    Mostra os cabeçalhos de resposta de qualquer URL.

  • Código-fonte, bruto e renderizado

    Mostra o HTML que uma URL enviou, e o HTML renderizado quando o crawl a renderizou.

  • Coluna Renderização

    Diz, para cada página HTML, se ela é Renderizada no servidor, Hidratada ou Precisa de JavaScript.

  • Verificações de SEO para JavaScript

    Sinaliza titles, canonicals, links e texto principal que só aparecem ou mudam depois que o JavaScript roda.

  • Verificações de AMP

    Vinte verificações em URLs AMP e nas canonicals delas, incluindo o validador AMP.

  • Estrutura de URL

    Sinaliza URLs longas, underscores, barras duplas, segmentos repetidos, pontuação solta e parâmetros demais.

  • Estrutura do site

    Mostra as páginas HTML por pasta e por profundidade de crawl.

  • Mapa do crawl

    Desenha o crawl como uma árvore a partir da URL inicial, cada ponto colorido pelo código de status, com uma legenda que serve de filtro.

  • Segmentos

    Seus próprios grupos de URLs por regex, por site, cada um com a contagem de seus códigos de status, e uma coluna Segmento em Todas as URLs.

  • Busca e extração personalizadas

    Procura no HTML de cada página um texto ou uma regex, ou extrai valores por XPath, seletor CSS ou regex, e salva uma extração como coluna que roda de novo em todo crawl.

  • Tipos de conteúdo e tamanhos

    Lista o tipo de conteúdo, o tamanho e o tempo de resposta de cada URL, com os tempos de resposta coloridos a partir de 800 ms e de 1,800 ms.

  • Verificar correção

    Busca de novo só as URLs que uma verificação sinaliza, roda todas as verificações de novo e diz quantas foram corrigidas.

  • Ajustes de verificação por propriedade

    Desliga uma verificação ou muda o nível dela para Corrigir ou Revisar em uma propriedade, e isso vale para todos os crawls seguintes.

  • Desligar categorias em um crawl

    Deixa categorias inteiras de verificações de fora de um crawl.

  • Tela de renderização

    Uma tela só para a renderização: quantas páginas HTML estão no HTML, parcialmente no HTML ou precisam de JavaScript, o que só o JavaScript mostra, o que cada crawler de IA recebe, por grupo de páginas, e as páginas que não estão inteiras no HTML.

  • Bloco Renderização do dashboard

    As abas SEO técnico e Busca com IA do dashboard mostram a parcela de páginas no HTML, as páginas que precisam de JavaScript, aquelas cujo conteúdo principal só aparece com JavaScript e os crawlers de IA que recebem a página inteira.

Indexabilidade e sitemaps25 recursos · 162 verificaçõesCategoria Indexabilidade, Coluna Indexável, Testador de robots.txt e mais 22
  • Categoria Indexabilidade

    Se cada página HTML pode ser indexada: código de status, noindex, canonical, robots.txt, e HTML que quebra o head antes das tags de SEO.

  • Coluna Indexável

    Marca cada URL como Indexável ou não, e por quê: status 200, sem noindex, canonical para si mesma ou nenhuma.

  • Testador de robots.txt

    Explica cada linha do arquivo no ar ou de um rascunho em palavras simples, como o Google documenta e a RFC 9309 define, com as URLs rastreadas que cada regra alcança.

  • O que cada crawler pode buscar

    Mostra o que o Googlebot, o Bingbot e os crawlers de IA podem buscar segundo o robots.txt, com as URLs bloqueadas para cada um.

  • Teste de rascunho do robots.txt

    Testa um rascunho contra todas as URLs do crawl antes de publicá-lo, listando as URLs que passam a ser bloqueadas e as que passam a ser permitidas.

  • Grupos nomeados explicados

    Avisa quando o grupo próprio de um crawler no robots.txt descarta as regras do grupo *.

  • Categoria Sitemaps XML

    O que os sitemaps XML listam comparado ao que o crawl encontrou: páginas indexáveis ausentes, e URLs com redirecionamento, com noindex, com erro e órfãs listadas.

  • Páginas só do sitemap rastreadas

    Busca as páginas que só os sitemaps XML listam, como etapa 2, e as conta à parte.

  • Sitemap lido antes do crawl

    Dá ao robots.txt e aos sitemaps um tempo próprio em sites lentos e avisa quando um deles não respondeu.

  • Sitemap XML a partir do crawl

    Gera um sitemap XML das páginas indexáveis, em qualquer profundidade ou até a profundidade 3 ou 5.

  • Verificações de paginação

    Sinaliza páginas de arquivo paginadas que retornam 200 sem itens, cadeias rel=next quebradas e paginação canonicalizada para a página 1.

  • robots.txt e sitemaps ao longo do tempo

    Guarda cada versão do robots.txt e cada sitemap XML que os crawls leram, e sinaliza mudanças nas regras do robots.txt desde o crawl anterior.

  • Detecção de head quebrado

    Sinaliza HTML que fecha o head antes das tags de SEO (um noscript com texto, um elemento inválido, tags head omitidas ou repetidas), o que faz titles e canonicals serem lidos no body.

  • Verificações de canonical

    Sinaliza canonicals em loop, em cadeia, que apontam para redirecionamentos, noindex, 4xx, 5xx, HTTP ou URLs externas, ou que só são definidas por JavaScript.

  • Conflitos de diretivas

    Sinaliza noindex, nofollow e canonicals que diferem entre o HTML e o cabeçalho HTTP, que são declarados duas vezes ou estão escritos errado.

  • Recursos bloqueados pelo robots.txt

    Sinaliza páginas que usam imagens, scripts ou folhas de estilo que o robots.txt bloqueia.

  • Variantes de URL duplicadas

    Sinaliza variantes de maiúsculas e minúsculas, barra final e ordem de parâmetros que retornam o mesmo HTML.

  • Frases de soft 404

    Sinaliza páginas HTML que respondem 200 com uma frase como “não encontrado” ou “nenhum resultado encontrado” no title ou no H1.

  • O limite de 2 MB do Google

    Sinaliza HTML com mais de 2 MB com links ou conteúdo além do limite que o Google lê, e arquivos JavaScript ou CSS com mais de 2 MB.

  • Mudanças desde o crawl anterior

    Sinaliza uma mudança brusca nas URLs rastreáveis e as regras do robots.txt que mudaram desde o crawl anterior.

  • Limites de sitemap

    Sinaliza sitemaps XML com mais de 50 MB ou 50,000 entradas, sitemaps vazios, linhas sitemap relativas no robots.txt e URLs em outro host ou protocolo.

  • Verificação do arquivo de chave do IndexNow

    Verifica se o site hospeda o seu arquivo de chave do IndexNow, com Criar uma chave para gerar um.

  • O veredito de indexação do Google

    Lê o veredito da Inspeção de URL do Google para até 200 URLs por crawl e sinaliza páginas indexáveis que o Google não indexa ou para as quais o Google escolheu outra canonical.

  • Envio ao IndexNow

    Depois de um Crawl do site inteiro que termina sozinho, envia ao IndexNow (Bing, Yandex, Seznam, Naver e Yep) as páginas que mudaram ou são novas desde o crawl completo anterior, só quando o site hospeda a sua chave; a janela diz o que foi enviado ou recusado.

  • Rótulos de conteúdo explícito e verificação de idade

    Lista as páginas rotuladas como explícitas (a meta rating adult, o rótulo RTA ou um cabeçalho Rating) e as páginas que respondem ao crawler com uma verificação de idade, para você revisar.

Links16 recursos · 51 verificaçõesCategoria Links internos e externos, Inlinks e outlinks, Posição do link e mais 13
  • Categoria Links internos e externos

    Links quebrados, links para redirecionamentos, âncoras e páginas que poucos links alcançam.

  • Links de entrada e de saída

    Lista cada link que chega a uma URL e que sai dela, com o texto âncora.

  • Posição do link

    Registra se cada link está no corpo, no menu, no rodapé ou nos filtros, com as colunas Links de entrada no corpo e Links de entrada no menu e no rodapé.

  • Link Score

    Dá a cada URL uma nota de 0 a 100 pelo peso de links internos que ela recebe, um PageRank interno calculado sobre os links seguidos do crawl.

  • Profundidade do crawl

    Cliques a partir da URL inicial para cada URL, com uma sinalização a partir da profundidade 4.

  • Páginas órfãs

    Sinaliza páginas indexáveis que nenhum link interno alcança, encontradas pelos sitemaps XML, pelo log do servidor ou pelo Google Search Console.

  • Links externos

    Cada URL de outro site para a qual o site linka, cada uma requisitada uma vez, com 4xx, 5xx e sem resposta informados.

  • Verificar links externos

    Liga ou desliga a requisição de cada URL externa em um crawl; ligado por padrão.

  • Oportunidades de links

    Sugere links internos a partir do texto das páginas HTML: páginas que mencionam o tema de outra página sem linkar para ela.

  • Backlinks por URL

    Mostra URL Rating, Trust Flow, Page Authority ou Authority Score, domínios de referência e backlinks por URL, a partir da sua própria chave do Ahrefs, Majestic, Moz ou Semrush.

  • Texto âncora

    Sinaliza links internos sem texto âncora ou com âncoras não descritivas, e imagens linkadas sem alt.

  • Verificações de nofollow

    Sinaliza páginas alcançadas só por links nofollow, links de saída internos com nofollow e links de afiliado sem sponsored ou nofollow.

  • Higiene de links

    Sinaliza hrefs vazios, malformados e só com espaços, links só com onclick, parâmetros de rastreamento, caminhos de arquivo locais, localhost e fragmentos sem ID correspondente.

  • Alcançabilidade

    Sinaliza URLs alcançáveis só por uma canonical, um redirecionamento ou páginas com noindex, e páginas com links de entrada vindos de uma única URL.

  • URLs malformadas

    Conta como um grupo próprio os endereços que os links escreveram errado (um espaço no fim, uma barra dupla, um caractere codificado duas vezes).

  • Links para staging

    Sinaliza páginas HTML que linkam para um host de staging, de desenvolvimento ou local.

Imagens e mídia9 recursos · 20 verificaçõesCategoria Imagens, Verificações de texto alternativo, Tamanho e dimensões das imagens e mais 6
  • Categoria Imagens

    Lista cada imagem que o crawl buscou ou que uma página usa, com o tamanho, o texto alternativo e quantas páginas HTML a usam.

  • Verificações de texto alternativo

    Sinaliza texto alternativo ausente, longo demais, genérico e repetido, e distingue um alt ausente de um decorativo.

  • Tamanho e dimensões das imagens

    Sinaliza imagens com mais de 100 KB, GIFs com mais de 100 KB e imagens sem width e height.

  • Verificações de exibição de imagens

    Com a renderização ligada, sinaliza imagens exibidas na proporção errada ou com resolução baixa demais para o tamanho delas.

  • Verificações de imagens do Lighthouse

    Sinaliza imagens não comprimidas, fora de um formato moderno, maiores do que o exibido, e uma imagem LCP com lazy loading.

  • Legendas de vídeo

    Sinaliza vídeos sem faixa de legendas.

  • Amostra de imagens por grupo de páginas

    Permite amostrar uma grande biblioteca de imagens por grupo de páginas em vez de buscá-la inteira, com as contagens e o tempo de cada opção.

  • Pular imagens

    Deixa de lado as imagens ainda na fila, enquanto todas as páginas continuam sendo rastreadas e o texto alternativo continua sendo lido do HTML.

  • Metadados de licença de imagem

    Em sites que licenciam imagens, sinaliza marcação ImageObject sem detalhes de licença e lê uma amostra das imagens servidas em busca dos direitos IPTC e XMP, de que o Google precisa para o selo Licenciável.

Internacional (hreflang)10 recursos · 37 verificaçõesCategoria Hreflang, Colunas de hreflang, Verificações do atributo lang do HTML e mais 7
  • Categoria Hreflang

    Versões de idioma e região de cada página e se elas apontam umas para as outras: links de retorno, autorreferência, x-default, códigos inválidos, destinos canonicalizados e com noindex.

  • Colunas de hreflang

    Idiomas do hreflang e Destinos do hreflang para cada página HTML, com a lista completa ao passar o mouse.

  • Verificações de html lang

    Sinaliza um html lang ausente, vazio ou inválido, e valores de lang que discordam do hreflang ou do próprio texto da página.

  • Links de retorno e autorreferência

    Sinaliza links de retorno ausentes, autorreferências ausentes e links de retorno que apontam para URLs canonicalizadas.

  • x-default

    Sinaliza a falta de x-default no conjunto da página inicial e um destino x-default quebrado, com noindex ou canonicalizado.

  • Saúde dos destinos de hreflang

    Sinaliza destinos de hreflang que não são 200, têm noindex, são canonicalizados, estão bloqueados ou não têm links de entrada.

  • Códigos de idioma e país

    Valida cada código de idioma e de país do hreflang e sinaliza códigos regionais sem um fallback só de idioma.

  • Hreflang ausente

    Sinaliza equivalentes em outros idiomas sem hreflang e um mercado-alvo sem hreflang em nenhuma página.

  • Hreflang por todos os métodos

    Lê o hreflang do head do HTML e do cabeçalho HTTP Link, e sinaliza um conjunto declarado por mais de um método.

  • Respostas que variam por idioma

    Sinaliza uma resposta que varia por Accept-Language de um jeito que o Googlebot não vê.

Velocidade e Core Web Vitals18 recursos · 44 verificaçõesCategoria Desempenho, Lighthouse por grupo de páginas, Core Web Vitals de visitantes reais e mais 15
  • Categoria Desempenho

    Velocidade da página: tempo de resposta, peso da página, Core Web Vitals e o que atrasa a primeira renderização.

  • Lighthouse por grupo de páginas

    Roda as verificações de laboratório do Lighthouse em uma página HTML por grupo de páginas durante o crawl.

  • Core Web Vitals de visitantes reais

    LCP, INP e CLS de usuários reais do Chrome em celulares, no percentil 75, a partir da sua chave do Chrome UX Report.

  • Tendência de 40 semanas

    Desenha cerca de 40 semanas de dados de campo do Chrome UX Report History já no primeiro dia, um ponto por semana, com as linhas de bom e ruim do Google.

  • Core Web Vitals por grupo de páginas

    LCP, INP e CLS das páginas HTML mais linkadas de cada grupo de páginas, para que um template lento se revele.

  • Tirar instantâneo

    Lê o Chrome UX Report da origem, das URLs mais linkadas de cada grupo de páginas e das 10 URLs mais linkadas, sem precisar de crawl.

  • Agendamento do instantâneo de Core Web Vitals

    Tira o instantâneo sozinho, todo dia por padrão, ou toda semana ou todo mês, mesmo com a janela fechada.

  • Alertas de Core Web Vitals

    Gera um alerta quando uma métrica piora de nota ou volta para Bom, pelos limites do Google.

  • Tendência na tela da propriedade

    Mostra as leituras mais recentes lado a lado, coloridas como Bom, Precisa melhorar ou Ruim, com as datas.

  • Ajuste de páginas por grupo de páginas

    Define de 0 a 3 páginas HTML por grupo de páginas para cada instantâneo e diz quantas requisições ao Chrome UX Report isso usa.

  • Core Web Vitals na Auditoria do site

    O nível Auditoria do site lê os Core Web Vitals do Chrome UX Report depois do crawl.

  • Todos os instantâneos guardados

    Guarda cada instantâneo no seu computador, além dos 28 dias que o Chrome UX Report mostra.

  • Compressão, minificação e cache

    Sinaliza compressão de texto desligada, CSS e JavaScript não minificados, tempos de cache curtos e páginas sem ETag nem Last-Modified.

  • Verificações de laboratório do Lighthouse

    Sinaliza requisições que bloqueiam a renderização, trabalho longo na thread principal, CSS e JavaScript não usados, JavaScript legado, recursos em HTTP/1.1, terceiros lentos e uma nota do Lighthouse abaixo de 50.

  • Vitals de campo e de laboratório

    Sinaliza resposta lenta do servidor, CLS acima de 0.1 e Core Web Vitals fora da faixa boa, em dados de laboratório ou de campo.

  • Tempo de renderização

    Sinaliza páginas cuja renderização de JavaScript leva mais de 4 segundos.

  • Verificações de viewport e mobile

    Sinaliza viewports ausentes ou fixas, bloqueios de zoom e texto abaixo de 12 px CSS em celulares.

  • Tempo de resposta ao vivo

    Mediana, 9 em 10 e os tempos de resposta mais lentos enquanto o crawl roda, com as 10 páginas mais lentas.

Acessibilidade12 recursos · 114 verificaçõesCategoria Acessibilidade, Verificações de acessibilidade renderizada, Nomes e rótulos e mais 9
  • Categoria Acessibilidade

    O que impede quem usa tecnologia assistiva de usar cada página: nomes, rótulos, ARIA, landmarks, headings, tabelas e formulários.

  • Verificações de acessibilidade com renderização

    Com a renderização ligada, roda regras do axe-core e testes de visitante: contraste, foco do teclado, armadilhas de foco, zoom de 200%, reflow em 320 px e áreas de toque de 24 px.

  • Nomes e rótulos

    Sinaliza botões, links, campos de formulário, imagens, diálogos e frames sem nome acessível, e campos nomeados só por um title.

  • Validade do ARIA

    Sinaliza roles e atributos inválidos, atributos obrigatórios ausentes, roles pai ou filho errados e roles obsoletos.

  • Landmarks e headings

    Sinaliza páginas sem landmark main, landmarks duplicados ou aninhados, níveis de heading pulados e nenhum jeito de pular blocos repetidos.

  • Tabelas e listas

    Sinaliza tabelas sem células de cabeçalho, scope e headers inválidos, e listas ou listas de definição mal construídas.

  • Teclado e foco

    Sinaliza indicador de foco ausente, armadilhas de foco, tabindex positivo, diálogos que não retêm o foco e regiões roláveis sem acesso pelo teclado.

  • Contraste de cores

    Sinaliza texto com contraste insuficiente, texto abaixo do contraste aprimorado e links que só se distinguem pela cor.

  • Zoom, reflow e áreas de toque

    Sinaliza zoom desativado, texto cortado com zoom de 200%, conteúdo cortado em 320 px de largura, bloqueios de orientação e áreas de toque menores que 24 px.

  • Alternativas de mídia

    Sinaliza vídeo sem legendas ou audiodescrição, vídeo sem som sem alternativa e áudio sem transcrição.

  • Formulários

    Sinaliza campos sem rótulo ou com vários rótulos, valores de autocomplete inválidos, campos que bloqueiam colar e erros sem texto.

  • Revisão de acessibilidade por IA

    Um modelo local lê as páginas para 7 verificações de julgamento, como gráficos sem equivalente em texto.

Busca com IA18 recursos · 47 verificaçõesCategoria Busca com IA, O que cada assistente de IA recebe, llms.txt e arquivos para agentes e mais 15
  • Categoria Busca com IA

    O que os crawlers de IA podem buscar, o que recebem e como as respostas de IA citam o site.

  • O que cada assistente de IA recebe

    Requisita páginas da amostra como 10 agentes de IA (ChatGPT, Claude, Perplexity, os crawlers deles, Meta AI, Google-Extended, Common Crawl) e mostra quem recebe acesso total e o que o robots.txt permite.

  • llms.txt e arquivos para agentes

    Avalia um llms.txt publicado, uma versão em Markdown pelo cabeçalho Accept, manifests de descoberta de agentes e ferramentas WebMCP; um site sem eles não é sinalizado.

  • Regras para crawlers de IA

    Sinaliza páginas-chave que bloqueiam crawlers de busca com IA ou restringem snippets, e regras de IA que diferem da sua política escrita.

  • Versão em Markdown

    Sinaliza uma versão em Markdown vazia ou com menos da metade do texto principal.

  • Posição do conteúdo principal

    Sinaliza conteúdo principal que começa depois dos primeiros 5,000 caracteres do texto do body.

  • Páginas prontas para agentes

    Sinaliza sobreposições invisíveis sobre botões e campos, controles de tarefa difíceis de ver e decisões de checkout por agentes sem data para o Google UCP ou o OpenAI ACP.

  • Applebot e fetchers de IA

    Sinaliza páginas-chave que bloqueiam o Applebot e fetchers de IA acionados pelo usuário que estão bloqueados.

  • Citações no Bing AI

    Sinaliza queda nas citações do Bing AI e URLs-chave que o Bing AI nunca cita, a partir do Bing Webmaster Tools.

  • Visitas vindas de IA

    Informa as sessões vindas de IA e o engajamento delas comparado ao orgânico, a partir do Google Analytics 4.

  • Assistentes de IA que mencionam você

    Faz até 20 dos seus prompts ao ChatGPT e ao Perplexity pela sua conta DataForSEO e informa menções à marca, URLs citadas e sites de terceiros citados no seu lugar.

  • AI Overviews no Google

    Diz, para cada busca acompanhada, se o Google mostra um AI Overview e se ele cita você, auditoria após auditoria.

  • Rastrear como um crawler de IA

    Rastreia com GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot e outros user agents de IA.

  • Visitas de crawlers de IA a partir do log

    Mostra as visitas verificadas de crawlers de IA e as recusas por URL, a partir do log do servidor.

  • Prompts de IA

    Roda seus próprios prompts em cada página HTML (rascunhos de meta description, ideias de FAQ, intenção de busca, entidades principais) com o Ollama no seu computador ou com a sua chave da Anthropic, da OpenAI ou do Google Gemini, com as respostas em colunas.

  • Revisão por IA

    Roda 44 verificações de julgamento em todas as categorias com um modelo local pelo Ollama; nada sai do computador e as sinalizações dela ficam fora das contagens.

  • Aba Busca com IA do dashboard

    Assistentes de IA atendidos, AI Overviews, o que cada assistente de IA recebe e requisições de bots verificados.

  • Fontes do AI Overview comparadas à primeira página

    Para cada busca acompanhada, carrega o AI Overview do Google 3 vezes pelo DataForSEO e informa quantas das fontes dele ranqueiam na primeira página, se a sua página ranqueia lá e se o Overview a cita, como uma revisão.

Dados estruturados9 recursos · 15 verificaçõesCategoria Dados estruturados, Veredito por tipo, Consistência por grupo de páginas e mais 6
  • Categoria Dados estruturados

    Marcação Schema em cada página: válida, com avisos ou com erros, e a coluna Tipos de Schema.

  • Veredito por tipo

    Dá um veredito para cada tipo de Schema em uma URL.

  • Consistência do grupo de páginas

    Sinaliza páginas que não têm um tipo de dados estruturados ou de resultado rico que o grupo de páginas delas tem.

  • Marcação comparada à página

    Sinaliza preços de produto que não aparecem na página, ofertas expiradas, datas que não batem e propriedades obrigatórias ausentes.

  • Sintaxe e propriedades obrigatórias

    Sinaliza dados estruturados com erros de sintaxe, propriedades obrigatórias ou recomendadas ausentes, ou texto diferente do da página.

  • Identidade de Organization e Person

    Sinaliza marcação Organization ou Person sem propriedades de identificação.

  • Marcação especial

    Verifica seletores Speakable, páginas com paywall sem isAccessibleForFree false, e marcação HowTo, QAPage e FAQ comparada à página.

  • Resultados ricos no Google

    Sinaliza resultados ricos inválidos e erros de AMP ou de resultados ricos que o Google informa.

  • Organization comparado ao Perfil da Empresa no Google

    Compara a marcação Organization com o Perfil da Empresa no Google, pelo DataForSEO.

Segurança9 recursos · 29 verificaçõesCategoria Segurança, Coluna Cabeçalhos de segurança, HTTPS e certificados e mais 6
  • Categoria Segurança

    HTTPS, conteúdo misto e os cabeçalhos de segurança que cada página envia.

  • Coluna Cabeçalhos de segurança

    Lista os cabeçalhos de segurança que cada URL envia.

  • HTTPS e certificados

    Sinaliza páginas HTTP, redirecionamentos de HTTPS para HTTP, certificados inválidos ou perto de expirar, e TLS 1.0 ou 1.1.

  • Subresource Integrity e formulários

    Sinaliza scripts e estilos externos sem hash de integridade, e formulários ou campos de senha em HTTP.

  • Cabeçalhos de segurança

    Sinaliza a falta de Content-Security-Policy, Strict-Transport-Security, nosniff, proteção contra clickjacking ou Cross-Origin-Opener-Policy, e uma Referrer-Policy insegura.

  • Conteúdo misto

    Sinaliza páginas HTTPS que carregam recursos HTTP ou com protocolo relativo, ou que linkam para páginas HTTP.

  • Detalhes do servidor expostos

    Sinaliza cabeçalhos de resposta que revelam o servidor ou o framework, e um Content-Type que não corresponde ao arquivo.

  • Hostname do certificado

    Sinaliza um certificado que não cobre o hostname enviado via SNI.

  • Verificações no navegador

    Com a renderização ligada, sinaliza cookies de terceiros e pedidos de permissão no carregamento.

Dados de busca25 recursos · 29 verificaçõesGoogle Search Console, Google Analytics 4, Várias contas Google e mais 22
  • Google Search Console

    Faz login pela própria página do Google no seu navegador, em somente leitura, e junta cliques, impressões e CTR a cada URL de cada crawl.

  • Google Analytics 4

    Junta visitas e engajamento às páginas do crawl para as verificações de analytics, conectado com o mesmo login do Google.

  • Várias contas do Google

    Mantém um login por conta do Google e usa a conta da própria propriedade para cada site.

  • Uma propriedade por site

    Pergunta qual propriedade do Google Search Console e do Google Analytics 4 pertence a cada site, já com a do próprio site pré-selecionada.

  • Categoria Google Search Console

    29 verificações que juntam os dados do Google ao crawl, como URLs com noindex, redirecionadas ou com 4xx que ainda recebem cliques.

  • Páginas de entrada orgânicas

    Sinaliza páginas de entrada orgânicas com 10 segundos ou menos de engajamento, rejeição de 80% ou mais, formulários sem eventos-chave e sessões orgânicas abaixo de 70% do normal recente.

  • Várias URLs para uma só busca

    Sinaliza buscas em que várias URLs dividem as impressões, ou em que a página inicial ou uma URL não indexável aparece mais.

  • Aparência na pesquisa

    Mostra impressões e cliques por aparência na pesquisa.

  • Tags de analytics

    Sinaliza IDs de GA ou GTM carregados duas vezes e URLs indexáveis sem nenhum ID de GA ou GTM.

  • Cliques em URLs sinalizadas

    Ordena as verificações pelos cliques das URLs que elas sinalizam, para que as sinalizações que custam tráfego venham primeiro.

  • Arquivo além dos 16 meses

    Guarda cada mês de dados do Google Search Console no seu computador depois que o Google os apaga aos 16 meses, com Arquivar agora e um agendamento mensal.

  • Cliques por dia

    Cliques e impressões por dia dos últimos 28 dias contra os 28 anteriores, em um gráfico.

  • Principais buscas

    As buscas que trazem cliques, com impressões e posição.

  • Buscas acompanhadas

    Acompanha até 25 buscas por propriedade todos os dias pelo Google Search Console: posição em 7 e em 90 dias, variação, cliques e impressões, com sugestões de buscas nas posições 4 a 20.

  • Inspeção de URL

    Inspeciona até 200 URLs por crawl, primeiro as mais clicadas, depois as mais linkadas.

  • Google Discover

    Cliques e impressões do Google Discover, guardados com cada mês arquivado.

  • Atualizações do Google e seus cliques

    Mostra as atualizações de ranking e os incidentes do Google dos últimos dois anos sobre os seus cliques por dia, com os cliques antes e depois de cada um.

  • Bing Webmaster Tools

    Cliques, consultas, erros de crawl e URLs indexadas do Bing, com a sua chave de API e um botão Testar que lista os seus sites.

  • DataForSEO

    Rankings, respostas de IA, concorrentes e backlinks pela sua própria conta do DataForSEO, paga por requisição.

  • Posições no Google

    A posição real no mobile de cada busca acompanhada no top 20, com o melhor concorrente ao lado.

  • Lacunas de palavras-chave

    Buscas em que um concorrente aparece no top 20 e você não, com o volume de cada uma.

  • Executar estas verificações

    Lê um serviço que você conectou depois de um crawl e executa as verificações dele de novo nesse crawl, sem rastrear de novo.

  • Status das conexões em todo lugar

    Mostra quantos serviços estão conectados na barra de status, abaixo da propriedade na barra lateral e num bloco do Dashboard; cada um abre Conexões.

  • O que esta propriedade usa

    Mostra as requisições que cada conexão faz para uma propriedade em relação às cotas do Google, tudo na sua própria chave e conta.

  • Links para Problemas de segurança e Ações manuais

    Todo crawl traz os links para os relatórios Problemas de segurança e Ações manuais do Search Console da propriedade, já que a API do Google não consegue lê-los, para você abrir os dois manualmente.

Concorrentes12 recursosTela Concorrentes, Vantagens dos concorrentes, Adicionar concorrentes e mais 9
  • Tela Concorrentes

    Coloca a propriedade ao lado dos concorrentes, no último crawl utilizável de cada um, com cada métrica colorida por quem lidera e quem fica atrás, e a diferença para o melhor concorrente.

  • Vantagens dos concorrentes

    Lista as métricas em que um concorrente lidera, a maior diferença primeiro, com as verificações por trás de cada número.

  • Adicionar concorrentes

    Aceita uma lista inteira colada do jeito que veio, com os diretos como principais (no máximo 5) e os indiretos como secundários, e coloca os crawls deles na fila de uma vez.

  • Crawls de concorrentes sob medida

    Lê primeiro os sitemaps XML de cada concorrente, rastreia 750 URLs por padrão e oferece 1,000, 2,500 ou 5,000 quando os sitemaps listam mais.

  • Descoberta de concorrentes

    Encontra pelo DataForSEO os sites que ranqueiam para as mesmas buscas, separados em principais e secundários.

  • Lojas não entram como concorrentes

    Nunca propõe lojas, apps de entrega ou marketplaces como concorrentes; você ainda pode adicioná-los manualmente.

  • Concorrentes que mudaram de domínio

    Quando um concorrente muda para outro domínio, rastreia o endereço onde a página inicial dele está agora.

  • Concorrentes agrupados

    Propõe um subportfólio "<propriedade> | Concorrentes" para os concorrentes de uma propriedade e o mantém ligado à propriedade.

  • Comparação justa

    Conta só as verificações que todos os crawls comparados conseguiram avaliar, e não ranqueia nada contra um crawl interrompido antes do fim.

  • Visibilidade orgânica

    Buscas ranqueadas, top 10, visitas estimadas e domínios de referência da propriedade e de cada concorrente, auditoria após auditoria.

  • Backlinks dos concorrentes

    Domínios de referência e backlinks da propriedade e dos concorrentes, pelo DataForSEO Backlinks.

  • Concorrentes no Início

    Mostra cada concorrente abaixo da sua propriedade, com barras de URLs, de sinalizações e de sinalizações por URL comparadas.

Monitoramento, agendamentos e alertas26 recursosAgenda, Crawls agendados, Arquivamentos agendados e mais 23
  • Agenda

    Um calendário mensal de cada crawl e cada execução agendada, passados e futuros, com filtro por propriedade.

  • Crawls agendados

    Crawls do site inteiro que rodam sozinhos (diários, semanais, a cada N semanas ou mensais) com os ajustes da propriedade, mesmo com a janela fechada.

  • Arquivamentos agendados

    Arquivamentos do Google Search Console agendados, mensais por padrão.

  • Custo de um agendamento

    Mostra quanto um crawl agendado custa antes de você adicioná-lo: URLs por execução e execuções por mês.

  • Aviso antes de um crawl agendado

    Avisa 15 minutos antes de um crawl agendado começar e diz que ele roda com a janela fechada.

  • Adiar e pular

    Adia uma execução em 1, 3, 6 ou 9 horas ou para uma data e hora, ou a pula, e o agendamento mantém o seu ritmo.

  • Parar e adiar

    Para com segurança um crawl agendado que está rodando e dá a ele um novo horário.

  • Auditoria completa mensal

    Repete a auditoria completa todo mês pelo agendador; a Neova termina a análise e o PDF na próxima vez que abrir.

  • Regras de alerta

    Gera alertas quando os Core Web Vitals mudam de nota, os cliques dos últimos 7 dias caem 20% ou mais, uma busca acompanhada sai ou entra no top 10 ou perde 3 posições, ou um novo crawl tem sinalizações novas.

  • Lista de alertas

    Guarda os 300 alertas mais recentes, com Verificar agora e Limpar alertas.

  • Neova Go na barra de menus

    Mantém a Neova rodando na barra de menus quando a janela fecha, com o progresso do crawl ao lado do relógio.

  • Manter o ícone no Dock

    Mantém o ícone no Dock ou deixa só o ícone na barra de menus.

  • Abrir ao iniciar sessão

    Inicia a Neova junto com a sessão, com a janela fechada.

  • Neova Go no celular

    Uma página para celular adicionada à Tela de Início por um QR code: o último crawl de cada propriedade, Core Web Vitals, cliques do Google Search Console, buscas acompanhadas, a próxima execução e os crawls em andamento, criptografada no Mac antes de sair dele.

  • Atualização do Neova Go

    O Mac envia o resumo a cada 2 minutos enquanto um crawl roda e a cada 15 no resto do tempo; o celular confere a cada 2 minutos e diz de quando é o resumo.

  • Compartilhar progresso

    Cria um link para um crawl em andamento, com uma chave própria, para que qualquer pessoa possa acompanhá-lo e saber quando ele termina, sem revelar mais nada.

  • Página do crawl compartilhado

    Uma cópia da tela ao vivo que qualquer pessoa pode abrir: progresso, Detalhamento das URLs, URLs Recentes, Mapa do crawl ao vivo, Tempo de resposta, Redirecionamentos e erros, Verificações e Links e Notícias.

  • Avisar-me quando terminar

    A página compartilhada pode avisar quem a lê quando o crawl terminar.

  • Redirecionamentos e erros na página compartilhada

    Cada grupo 3xx, 4xx, 5xx e Sem resposta do crawl inteiro, até 100 URLs cada, as mais linkadas primeiro.

  • Slack

    Publica os alertas e o resultado de cada crawl em um ou vários canais do Slack por um incoming webhook, confirmado com uma mensagem de teste.

  • Microsoft Teams

    Publica os alertas e o resultado de cada crawl em canais do Teams por um webhook do Workflows.

  • Mensagens por portfólio e propriedade

    Envia as mensagens de cada portfólio ou propriedade para os próprios canais.

  • Notificação de fim de crawl

    Uma notificação do sistema quando um crawl termina e a Neova não está em primeiro plano, com um som à sua escolha.

  • Em andamento

    Lista tudo o que a Neova está fazendo agora (o crawl, uma auditoria, Executar as verificações, um crawl agendado e a fila), cada um com o botão que o abre.

  • Selos de variação

    Cada contagem com um valor anterior mostra a variação desde o crawl comparável anterior.

  • Crawl de vigilância

    Busca só uma lista de páginas, sem descoberta, e gera alertas de página para mudanças de status, destino de redirecionamento, title, canonical, noindex, H1 e tamanho.

Relatórios, dashboards e tickets46 recursosVisão geral, Todas as sinalizações, Painel da verificação e mais 43
  • Visão geral

    O estado do crawl num relance: Resumo do crawl, Principais verificações, Próximas ações, Códigos de status e Mudanças vs. crawl anterior, com cada número abrindo a sua lista.

  • Todas as sinalizações

    Cada verificação com sinalizações: gravidade, URLs sinalizadas do total verificado, quantas são indexáveis, variação desde o crawl anterior, categoria e cliques.

  • Painel da verificação

    Cada verificação mostra Sinalizado quando, O que isso costuma significar e O que você poderia fazer, com o ID, a fonte e Sobre esta verificação, que abre a página dela na biblioteca de verificações.

  • Todas as URLs

    Cada URL, com conjuntos de colunas, filtros em qualquer coluna, visualizações salvas, seletor de colunas, coluna de URL fixa e 10, 25, 50 ou 100 linhas por página.

  • Exportar CSV de qualquer tabela

    Cada tabela e grade exporta o que mostra como CSV.

  • Explicação em cada número

    Cada coluna, contagem e cartão tem um ⓘ que diz o que ele conta.

  • Dashboard

    Oito grupos e 13 abas montados com 39 blocos: resumo, desempenho, técnico, Core Web Vitals, conteúdo, palavras-chave, busca com IA, social, concorrentes, atualizações de algoritmo, fluxo de trabalho, programa e relatórios.

  • Meus dashboards

    Até 10 dashboards seus, criados do zero ou duplicados de uma aba, com blocos que você adiciona, move, redimensiona e remove.

  • Aba Programa

    O Plano de ação como programa, por status e responsável, cada item com a sua verificação e as sinalizações dela no último crawl, em vermelho quando um item marcado como Concluído ainda está sinalizado.

  • Tickets

    Um ticket por verificação e grupo de páginas, Corrigir primeiro, com a regra, a evidência, as URLs afetadas, quando está concluído, como verificar e onde corrigir (o template, quando 90% de um grupo está sinalizado).

  • Ciclo de vida do ticket

    Um crawl posterior fecha, mantém ou reabre cada ticket pela sua chave, e nunca apaga nenhum.

  • Código da propriedade nos tickets

    Começa cada ticket com o código da propriedade, como [DRH], e o leva como label para o Jira e o Linear.

  • Enviar para o Jira

    Cria um item no Jira para cada ticket da Neova, no seu projeto do Jira Cloud, com prioridade, labels e a lista de URLs anexada, nunca duas vezes.

  • Jira sempre em dia

    Depois de cada crawl completo feito pela janela, move para Concluído um ticket que sumiu, reabre um que voltou e atualiza o resto.

  • Arquivos de importação de tickets

    Arquivos no formato da importação CSV de cada ferramenta: Jira, Linear, Asana, ClickUp, monday.com, Azure DevOps Boards, Notion, Airtable, Smartsheet, e o arquivo de tarefas em Markdown do Basecamp, cada um com a sua página de importação.

  • Relatório com sua marca (PDF)

    Um relatório para o cliente com o seu nome, logo e cor: o crawl em números, sinalizações por categoria, o que corrigir primeiro com URLs de exemplo, renderização e visibilidade em IA, mudanças desde o crawl anterior e como o crawl foi feito, em Letter ou A4; verificações da mesma família contam uma vez só, e a segunda aparece como Também sinalizada.

  • Marca por propriedade

    Dá a cada cliente o próprio nome, logo e cor no relatório, com Preparado para, Preparado por e notas.

  • Pasta de trabalho com todas as sinalizações (Excel)

    Uma só pasta de trabalho: Resumo, Tickets na ordem de correção, Por grupo de páginas, uma planilha por verificação com as 1,000 URLs mais clicadas e depois mais linkadas, e Todas as sinalizações.

  • Planilha Páginas HTML

    Cada página HTML que respondeu 200, até 200,000, com title, description, H1, canonical, indexável, profundidade, links de entrada, sitemap, tamanho, tempo de resposta, cliques e sinalizações.

  • Pasta de trabalho no Google Sheets

    Envia a pasta de trabalho para o seu Google Drive, convertida para Google Sheets.

  • Pacote para o cliente (ZIP)

    Um ZIP com o que você escolher: o PDF, a pasta de trabalho detalhada ou resumida, os tickets com as listas de URLs, os arquivos do Jira e do Linear e cada URL sinalizada, em um CSV por verificação, com um README.

  • Tabelas do crawl (CSV)

    As URLs, sinalizações e tickets como arquivos CSV, para CSV, Excel (UTF-8 com BOM), Google Sheets e Looker Studio.

  • Leia-me em cada exportação

    Cada exportação traz uma nota quando o crawl rodou sem renderização ou cobriu só parte do site.

  • Salvar em Downloads

    Salva as exportações em Downloads por padrão, numa pasta Neova exports.

  • Salvar em qualquer pasta

    Salva as exportações numa pasta do computador que você escolher.

  • Salvar no Google Drive

    Envia, pela própria interface do Google Drive, para a pasta Neova exports das contas do Google conectadas à Neova, substituindo um arquivo de mesmo nome para que o link compartilhado continue funcionando; a Neova só vê os próprios arquivos.

  • Salvar em drives sincronizados

    Salva nas pastas que os apps Google Drive, OneDrive, Dropbox, iCloud Drive, Proton Drive e kDrive sincronizam no Mac (OneDrive, Dropbox e Google Drive no Windows), com cada conta desligada até você ligá-la.

  • Servidor de exportação (SFTP, FTPS, FTP)

    Envia as exportações para o seu próprio servidor por SFTP com senha ou arquivo de chave, FTPS ou FTP simples, com um teste antes de salvar e a chave do servidor memorizada.

  • Pasta de exportação por portfólio e propriedade

    Salva as exportações de cada portfólio ou propriedade na própria pasta ou drive.

  • Salvar numa pasta pelo navegador

    Na Neova Online, grava uma exportação direto numa pasta do seu computador no Chrome, Edge, Vivaldi, Brave e Arc; nos outros navegadores, ela é baixada.

  • Exportações de pasta em um só ZIP online

    Na Neova Online, uma exportação de pasta, como as tabelas CSV ou as páginas em Markdown, é baixada como um só ZIP.

  • Compartilhar um link

    Um link somente leitura de um portfólio ou de uma propriedade com os crawls, o Plano de ação, as análises, os concorrentes e os arquivos que você marcar, criptografado no seu computador com uma chave que só viaja no link; Atualizar mantém o endereço e Desligar o apaga.

  • Plano de ação

    O que fazer, em ordem: redigido a partir do crawl (Corrigir primeiro, depois cliques, depois alcance), reordenado e reescrito por você, com itens seus, status, responsável e nota, mantido de um crawl para outro.

  • Exportar o Plano de ação

    Copia o plano como Markdown ou o exporta como CSV.

  • Análise

    Escreve a auditoria completa no seu computador, com estado atual, sinalizações priorizadas, visibilidade orgânica, buscas acompanhadas, lacunas de palavras-chave e ações priorizadas já preenchidos, e as seções que só uma pessoa pode escrever marcadas como A escrever.

  • Relatórios na propriedade

    Guarda com a propriedade os relatórios que você adiciona (Markdown, texto, PDF ou Word), com Marcar como revisado.

  • Perguntar a um analista

    Abre um e-mail para a Neova Labs já com os números do crawl, para as seções que nenhuma verificação escreve.

  • Auditoria completa

    Uma execução de cada etapa: o crawl com todas as verificações ligadas, Google, Bing e Analytics, Core Web Vitals, concorrentes e os crawls deles, dados de busca do DataForSEO, o Plano de ação, a análise e o PDF com sua marca.

  • Qual crawl a auditoria lê

    Executar uma auditoria completa pergunta se deve ler o último crawl ou rastrear de novo, mostrando as URLs dele e o tempo que levou.

  • Comparar crawls

    Crawl A contra Crawl B: URLs novas, removidas e alteradas, sinalizações novas e resolvidas, com o Crawl B colorido como melhor ou pior.

  • Dados históricos

    Tudo o que fica guardado de uma propriedade além da retenção das próprias fontes: cada crawl, cada mês do Google Search Console, cada snapshot dos Core Web Vitals, versões do robots.txt, sitemaps XML e mudanças de URL.

  • Sugestões para revisar

    Cada sugestão, ticket e relatório traz o aviso de que deve ser revisado antes de ser aplicado, já que a Neova vê as páginas, não o negócio por trás delas.

  • Saídas agendadas

    Um crawl agendado publica como terminou no Slack e no Teams, e a auditoria completa mensal gera o PDF na próxima vez que a Neova abrir; nenhum arquivo de exportação é gravado por agendamento ainda.

  • Renderização e visibilidade em IA nos relatórios

    O relatório em PDF e a pasta de trabalho mostram como as páginas são renderizadas (no geral, por grupo de páginas e página a página), o que o robots.txt deixa cada crawler de IA pegar e o que o servidor entrega a ele, e quais verificações de busca com IA passaram ou sinalizaram.

  • Google Sheet

    Um Google Sheet feito para o Sheets a partir do crawl: Visão geral com gráficos, um Plano de ação com menus suspensos de Responsável, Status e Prazo, Problemas, URLs, Sinalizações, Grupos de páginas, Redirecionamentos e erros, Renderização e IA e Sobre, salvo na sua conta do Google como um arquivo novo a cada vez.

  • Arquivos

    Cada arquivo que a Neova gera a partir de um crawl (Pacote para o cliente, PDF, pasta de trabalho, Google Sheet, exportações, arquivos Neova) aparece com o destino, o crawl, a data e o tamanho, com Abrir, Abrir a pasta, Copiar o caminho e Abrir no Google Drive.

Neova Online e sincronização19 recursosNeova Online, Por convite, Login seguro e mais 16
  • Neova Online

    A mesma janela da Neova num navegador, em app.neova.app, com o motor no servidor da Neova, rastreando e verificando lá.

  • Por convite

    As contas são abertas a partir de um link de convite, nominal ou aberto, um link para uma conta.

  • Login seguro

    Senha guardada com hash, um login que dura 30 dias a partir da sua última visita, uma espera depois de 10 senhas erradas, requisições de outros sites recusadas e um aviso quando a página é aberta no navegador embutido de outro app.

  • O seu próprio espaço

    Os crawls, dados e downloads de cada pessoa ficam nas próprias pastas, que nenhuma outra pessoa consegue ler.

  • Limites online

    Uma tarefa por pessoa de cada vez, 10,000 URLs por crawl, 10 URLs por segundo e 10 GB de crawls por conta enquanto a Neova Online está em teste.

  • Login com o Google online

    Conecta o Google Search Console, o Google Analytics 4 e o Google Drive pelo navegador, com o login guardado no seu próprio espaço.

  • Chaves na sua conta

    Chaves e webhooks ficam guardados na sua conta da Neova Online e nunca são mostrados de novo.

  • Portfólio Demo

    Toda conta nova começa com uma Demo: uma loja de teste e três concorrentes já rastreados, com ajustes do portfólio, códigos e um Plano de ação, removível num passo só.

  • Os seus crawls preparados

    Um convite pode trazer portfólios copiados de outra conta com os últimos crawls, ajustes e planos, com um banner enquanto eles são preparados.

  • Layout para celular e tablet

    A janela se ajusta a celulares e tablets: a barra lateral vira uma gaveta, as folhas ocupam a tela toda numa coluna só e as tabelas rolam para o lado.

  • Uma conta para o Mac e o online

    Conecta o app desktop à Neova Online uma única vez; o app guarda uma chave para aquele computador, nunca a senha.

  • Sincronização nos dois sentidos

    Mantém sincronizados sozinhos os portfólios, os concorrentes, a sua ordem, as escolhas de Google Search Console e Google Analytics 4, as cores e os códigos.

  • Escolha da primeira sincronização

    Quando um lado já tem o conteúdo do outro, o login mescla tudo na hora, sem perguntar; quando os dois realmente diferem, ele pergunta de onde começar, Manter o do Neova Online, Manter o deste Mac ou Mesclar os dois (recomendado, não perde nada), com as contagens de cada lado e um backup separado antes.

  • Crawls para cima e para baixo

    Envia ou baixa crawls inteiros em partes que podem ser retomadas, conferidas no final, ao lado de qualquer crawl em andamento.

  • Enviar novos crawls

    Envia para a Neova Online cada crawl que termina neste computador; desligado por padrão.

  • Sempre a janela mais recente

    A Neova Online mostra uma nova versão publicada no próximo carregamento da página, nunca uma janela antiga em cache.

  • Página de downloads

    Disponibiliza os instaladores e o vídeo tutorial para os testadores, com noindex.

  • Trazer minhas conexões

    Traz para este computador as chaves de conexão que a sua conta da Neova Online guarda, ou envia as deste computador para ela, depois da sua senha, mostrando só os 4 últimos caracteres de cada chave e nunca substituindo uma chave a menos que você marque Substituir.

  • Armazenamento por conta

    Cada conta da Neova Online pode guardar 10 GB de crawls; Ajustes mostra quanto a conta ocupa e quantos crawls tem, avisa a partir de 85%, e um envio ou crawl que passe do espaço é recusado, com o que fazer.

App desktop36 recursosApp para Mac, App para Windows, Termos do Windows e mais 33
  • App para Mac

    A Neova SEO Platform para Mac, com o motor embutido como código nativo, rastreia no seu computador.

  • App para Windows

    Um instalador para Windows x64 na sua própria conta de usuário, sem precisar de senha de administrador; versão de teste, ainda sem assinatura.

  • Termos do Windows

    No Windows, o app diz "este PC" e usa Ctrl em todo atalho com ⌘.

  • App para Linux

    O app desktop no Linux: um .deb para Ubuntu, Linux Mint e Debian, e um AppImage que não precisa de instalação.

  • 15 idiomas

    A janela e a biblioteca de verificações em inglês, francês, alemão, espanhol, português (Brasil), italiano, japonês, holandês, polonês, turco, coreano, chinês (simplificado), russo, indonésio e vietnamita.

  • Visuais

    Neova Mármore (o padrão), Neova, macOS, Liquid Glass, Windows 11, Linux, Terminal e Alto contraste; um visual muda as cores, nunca o lugar das coisas.

  • Claro, escuro ou sistema

    Claro, escuro ou o que o sistema escolher, com uma cor de destaque.

  • Densidade e tamanho do texto

    Linhas Compacta ou Confortável e texto que aumenta e diminui com ⌘+ e ⌘−.

  • URLs como caminho ou completas

    Mostra as URLs como caminho ou com protocolo e host, em todas as tabelas.

  • Formato de data e relógio

    Escreve datas e horas do seu jeito ou do jeito do idioma.

  • Início na barra lateral

    Mostra ou esconde a linha Início; o nome Neova no canto superior esquerdo abre o Início de qualquer forma.

  • Atalhos de teclado

    ⌘N Novo crawl, ⌘K Buscar propriedades, ⌘, Ajustes, ⌘[ Voltar, ⇧⌘P Modo de apresentação, ⌘/ Pergunte ou encontre.

  • Pergunte ou encontre

    Um só campo encontra uma visualização, uma verificação pelo título ou ID, uma página do crawl, uma propriedade ou um ajuste, e guarda as escolhas recentes.

  • Pergunte ao crawl em linguagem simples

    Uma pergunta mais longa vai para um modelo no seu computador, que escolhe uma resposta a partir do que a janela já mostra, então ele nunca inventa um número.

  • Modo de apresentação

    Desfoca todos os portfólios menos o que está aberto, para compartilhar a tela com um cliente.

  • Voltar

    Volta para a tela anterior, cujo nome aparece no botão.

  • Base para teclado e leitor de tela

    Um único anel de foco, cada linha alcançável com Tab, setas dentro das tabelas, folhas como diálogos e respeito ao movimento reduzido.

  • Painéis redimensionáveis

    Arraste a barra lateral, a lista de verificações e o painel de detalhes até a largura que você quiser.

  • Sair salva antes

    Sair pergunta uma vez enquanto um crawl roda, depois o salva mostrando as etapas e o progresso, e Retomar o continua mais tarde.

  • Parar tudo e sair

    Mostra o nome de qualquer crawl agendado rodando em segundo plano e oferece pará-lo e salvá-lo antes de sair.

  • Atualizações seguras

    Um crawl que está rodando quando a Neova é atualizada se salva sozinho e continua com Retomar.

  • Salvamento rápido

    Uma parada acrescenta só o HTML novo e mostra cada etapa do salvamento com uma barra e Fechar agora.

  • Proteção do disco

    Vigia o espaço livre em disco durante um crawl, avisa quando ele fica perto do limite e para com segurança abaixo de 3 GB, para que Retomar continue quando houver espaço de novo.

  • Recuperação

    Um crawl cortado por uma falha ou por um pipe fechado aparece como interrompido, nunca é descartado, e o armazenamento dele é revertido com segurança.

  • Nunca desacelerado em segundo plano

    A fila e as auditorias continuam rodando enquanto a janela está oculta.

  • Busca de atualizações

    Consulta app.neova.app em busca de uma versão mais nova quando o app abre, a cada 30 minutos e quando a janela volta para a frente, enviando só o número da versão.

  • Backup dos ajustes

    Copia os ajustes da janela para um arquivo depois de cada mudança, um backup por versão, restaurado se o armazenamento da janela for apagado.

  • Local dos dados de crawl

    Muda o lugar onde a Neova guarda os crawls.

  • Ícone do app com o nome

    O ícone traz Neova SEO abaixo da aranha a partir de 64 px.

  • Nova versão disponível

    Uma versão mais nova mostra Nova versão disponível no canto superior esquerdo, na barra de ferramentas, em primeiro lugar na Ajuda e em Ajustes › Geral, com Baixar; o app confere a cada 30 minutos e quando a janela volta para a frente.

  • Colunas que se ajustam ao conteúdo

    Cada tabela dimensiona as colunas pelo que elas contêm, dá a largura que sobra à URL e às colunas cortadas primeiro; cada cabeçalho de coluna tem uma alça para arrastar, o duplo clique ajusta, e a largura que você definir é mantida.

  • Mascotes da Neova

    Um mascote animado opcional, 8 para escolher (Webster, The Head, Sir Canonical, Polly Glot, Hopper, Shelly, Bo, Zap), fofo ou em pixel art, que acompanha seus crawls; Nenhuma por padrão, e com Nenhuma nada é carregado.

  • O mascote avisa

    Um balão quando um crawl precisa de você: o fim de um crawl com suas verificações Corrigir e quantas são novas, um crawl parado ou com falha, um site bloqueando o crawler, o disco ficando cheio, um crawl agendado começando; um clique abre a tela que ele indica.

  • Pergunte ao mascote

    Um clique no mascote diz o que a Neova está fazendo e, com um crawl aberto, aceita uma pergunta sobre ele, respondida pelo mesmo caminho da barra Perguntar (Ollama no seu computador ou sua própria chave de IA).

  • Mascote na área de trabalho

    Na área de trabalho, o mascote tem sua própria janela acima de todas as janelas e em todos os Spaces, fora do Dock; a Neova continua de olho mesmo minimizada e um clique a traz de volta na tela certa.

  • Tamanho e barra do mascote

    Sete tamanhos, de Minúsculo (56 px) a Colossal (320 px), Grande por padrão, e uma barra de ferramentas sob o mascote: Abrir a Neova, Novo crawl, Em andamento e Mais (ocultar, ajustes, silenciar), ao passar o cursor ou sempre.

Dados, privacidade e custos17 recursosOs crawls ficam no seu computador, Chaves no chaveiro do sistema, Nenhuma chave da Neova embutida e mais 14
  • Os crawls ficam no seu computador

    Os crawls ficam em Application Support/Neova no Mac e em %APPDATA%/Neova no Windows; nada é enviado para a Neova, a não ser que você sincronize ou compartilhe.

  • Chaves no chaveiro do sistema

    Cada chave, token e login vai para o chaveiro do sistema pela entrada padrão do motor, nunca por um arquivo, uma linha de comando ou a tela.

  • Nenhuma chave da Neova embutida

    O app não traz nenhuma chave da Neova: Google, Chrome UX Report, DataForSEO e os outros usam a sua própria chave e conta.

  • Motor compilado

    O motor é distribuído como código nativo, sem código-fonte legível.

  • Acesso somente leitura ao Google

    O Google é conectado com escopos somente leitura mais o seu e-mail; Desconectar revoga o token no Google.

  • DataForSEO desligado por padrão

    O DataForSEO fica desligado, a não ser que o Novo crawl o ligue para aquele crawl.

  • Estimativa do DataForSEO

    Antes de Iniciar, estima o custo a partir do que o DataForSEO cobrou deste computador nas últimas 20 chamadas de cada tipo, ou senão pela tabela de preços, arredondado para cima até os próximos $0.50 ou o próximo dólar.

  • Limite de gastos do DataForSEO

    Para de consultar o DataForSEO assim que o limite que você definiu é atingido, de $0.50 a $10 por crawl, $1 por padrão.

  • Limite da auditoria

    Os dados de busca da auditoria completa param no próprio limite, em dólares americanos, e dizem quanto gastaram.

  • Logs lidos localmente

    Os logs do servidor são lidos no seu computador; nenhum endereço IP é gravado em lugar nenhum.

  • IA local

    Revisão por IA e Perguntar usam um modelo no seu computador pelo Ollama, então nada sai dele; Prompts de IA avisa quando o texto da página vai para um provedor que você escolheu.

  • Cópias trancadas

    Links de compartilhamento, Neova Go e Compartilhar progresso são criptografados no seu computador com a chave só no link ou no QR code, então o servidor guarda o que não consegue ler.

  • Dados de uso opcionais

    Compartilhar quais páginas do glossário você abre fica desligado por padrão e envia só um ID aleatório, a verificação e o idioma.

  • O que é apagado vai para a Lixeira

    Um crawl apagado vai para a Lixeira, de onde pode ser restaurado, com seleção em massa dos crawls antigos parados.

  • Nada escondido sobre o crawler

    O NeovaBot diz quem é, respeita o robots.txt e 3 URLs por segundo por padrão, e nunca resolve um CAPTCHA.

  • Arquivo Neova

    Salva um crawl, uma propriedade com todos os crawls e dados, ou um portfólio como um único arquivo .neova, com ou sem o HTML guardado, em Downloads, no Google Drive, em qualquer drive ou pasta; agendamentos, conexões, chaves e senhas nunca vão nele.

  • Instalar um arquivo Neova

    Instala um arquivo .neova feito em qualquer computador Mac, Windows ou Linux, dizendo o que é novo, o que já está aqui ou o que entra com outro nome antes de gravar qualquer coisa, e nunca substitui o que este computador já tem.

Desenvolvedores e automação10 recursosNeova CLI, SEO Gate para CI, Servidor MCP e mais 7
  • Neova CLI

    O comando neova rastreia, importa, publica e lê sites, páginas, sinalizações, tickets e alertas pelo Terminal ou por scripts, como tabelas, CSV ou JSON.

  • Barreira de SEO para CI

    neova check compara um crawl com uma linha de base e sai com o código 3 quando há sinalizações novas, ou quando uma sinalização cresce além de uma parcela das URLs.

  • Servidor MCP

    Dá aos assistentes de IA acesso de leitura aos seus crawls, sinalizações, tickets e ajustes por meio de 16 ferramentas, com os dados ficando no seu computador.

  • Claude Desktop em um clique

    Adiciona a Neova ao Claude Desktop em um clique, com configurações prontas para copiar para Claude Code, Codex, Cursor, VS Code, Gemini CLI, LM Studio, Windsurf e ChatGPT.

  • Crawls a partir de um assistente de IA

    Inicia, para e apaga crawls a partir de um assistente, e cada início e exclusão pede o seu sim antes.

  • Diagnosticar um crawl

    Lê o log de um crawl e diz o que deu errado (sequências de 429 ou 503, 403s, bloqueios do robots.txt, páginas só em JavaScript, páginas de menos) com o ajuste a mudar.

  • Arquivo de ajustes

    Um arquivo JSON simples guarda a lista de exclusões, os padrões e os ajustes e as chaves de verificação de cada propriedade.

  • Importar um crawl

    Abre uma exportação Internal do Screaming Frog (com All Inlinks), uma exportação de URLs do Sitebulb, o JSON do SiteOne Crawler ou qualquer CSV com uma coluna de URL, e roda as verificações da Neova nela.

  • Importação avaliada contra o site ao vivo

    Avalia uma importação buscando de novo uma amostra de 50 URLs a 2 URLs/s e comparando com os sitemaps ao vivo, para que uma importação nunca se passe por um crawl.

  • API REST

    A API HTTP da Neova Online em app.neova.app/api/v1: lê portfólios, propriedades, crawls, sinalizações e tickets, inicia um crawl e gerencia tickets, com cada script usando a própria chave Somente leitura ou Leitura e gravação, 60 requisições por minuto por chave e 20 chaves por conta.

Logs do servidor8 recursos · 5 verificaçõesLog do servidor, Só bots verificados, Nunca visitadas e órfãs e mais 5
  • Log do servidor

    Requisições de buscadores e crawlers de IA por URL do crawl, a partir do próprio log de acesso do site.

  • Só bots verificados

    Conta uma requisição como do Googlebot, do Bingbot ou de um crawler de IA só quando o endereço dela está na lista que a empresa publica; um nome usado em outro lugar é contado à parte.

  • Nunca visitadas e órfãs

    Lista as páginas HTML que o Googlebot nunca visitou no período do log e as URLs que os bots pediram e que o crawl não conhece.

  • Recusas

    Conta as respostas 429 e 403 que cada bot recebeu.

  • Escolher um arquivo de log

    Lê um log combined do Apache ou do Nginx, simples ou compactado com gzip.

  • Logs do Cloudflare

    Para um site atrás do Cloudflare, coleta as requisições de buscadores e crawlers de IA na sua própria conta do Cloudflare e as lê antes de cada crawl, sem precisar de acesso ao servidor.

  • Pedir o log

    Escreve o pedido para enviar à TI: só as linhas de crawlers, nada para instalar, o que a segurança precisa saber.

  • Requisições de bots verificados

    Um bloco do Dashboard com as requisições dos bots.

Migração e staging7 recursosMapa de redirecionamentos, Verificação de redirecionamentos ao vivo, Staging vs. produção e mais 4
  • Mapa de redirecionamentos

    Associa cada URL do crawl do site antigo ao crawl do site novo com um grau de confiança, para uma migração no mesmo domínio ou em outro.

  • Verificação de redirecionamentos ao vivo

    Confere o redirecionamento ao vivo de cada URL antiga com o mapa e sinaliza os errados ou ausentes.

  • Staging vs. produção

    Compara um crawl de staging com a produção: código de status, noindex, canonical, title, meta description, H1 e URLs que só estão em um dos crawls.

  • Inverter crawls

    Inverte qual crawl é o antigo e qual é o novo, ou qual é o de staging e qual é o de produção.

  • Rastrear um site de staging

    Ignora o robots.txt e vai mais rápido num site que você confirma ser seu, com autenticação HTTP e cabeçalhos personalizados.

  • URLs antigas em lista

    Rastreia uma lista de URLs antigas para verificar onde cada uma vai parar.

  • Links para o site em produção

    Quando a página inicial de um subdomínio de staging linka principalmente para o site em produção, o Novo crawl mostra as contagens e adiciona a regra de Reescrita de URL e os sitemaps XML do site em produção em um clique; um sitemap XML adicionado que nenhuma regra traz para o site é sinalizado antes de o crawl começar.

Propriedades, portfólios e Início13 recursosInício, Minha ordem, Recolher e buscar e mais 10
  • Início

    Cada propriedade sua como um bloco na cor dela, com o logo e os números principais, e os concorrentes como linhas abaixo.

  • Minha ordem

    Arraste as propriedades na ordem que você quiser, mantida no Mac, online e no celular.

  • Recolher e buscar

    Recolhe uma família numa linha só, Recolher tudo e Expandir tudo, e uma busca fixa acessível com /.

  • Lista do Início

    Uma tabela de todas as propriedades com cada concorrente abaixo da sua propriedade.

  • Tela da propriedade

    Um hub por site: os crawls, Para o cliente, Core Web Vitals, Google Search Console, concorrentes, Plano de ação, análise e agendamentos.

  • Para o cliente

    Relatório com sua marca (PDF), Pasta de trabalho com todas as sinalizações (Excel) e os tickets, um botão para cada, feitos a partir do crawl aberto.

  • Rastrear de novo ou auditoria completa, explicados

    Cada botão no topo da Propriedade diz o que faz e como se diferencia do outro.

  • Portfólios

    Agrupa propriedades por cliente ou empresa, com uma cor, e subportfólios de um nível.

  • Cor e código da propriedade

    Dá a cada propriedade uma cor e um código de 2 a 6 letras sugerido a partir do domínio.

  • Seletor de propriedades

    Encontra uma propriedade com ⌘K, primeiro as fixadas e as que estão rodando, cada portfólio com suas propriedades e concorrentes logo abaixo.

  • Histórico de crawls na barra lateral

    Os cinco crawls mais recentes da propriedade, com o que aconteceu com cada um, a um clique de distância.

  • Excluir crawls em lote

    Seleciona crawls pela caixa de seleção ou com Selecionar os antigos parados e interrompidos, depois Excluir selecionados.

  • Menus de linha

    Toda linha de lista tem um botão principal, depois ⋯ e o clique direito com todas as ações, com Excluir por último, em vermelho.

Ajuda e suporte7 recursosMenu Ajuda, Seção de ajuda, Biblioteca de verificações online e mais 4
  • Menu Ajuda

    A biblioteca de verificações em app.neova.app/checks, Ajuda do Neova SEO Platform, Novidades, Relatar um problema, atalhos de teclado e Buscar atualizações.

  • Seção de ajuda

    Download, instalação, seu primeiro crawl, a Neova Online e o app desktop, conexões opcionais e o histórico de mudanças, em app.neova.app/help.

  • Biblioteca de verificações online

    Todas as 694 verificações por grupo em app.neova.app/checks, cada uma com sua própria página e fonte, abertas por Sobre esta verificação em qualquer lugar onde uma verificação aparece.

  • Aviso no Início

    Diz uma vez que os resultados da Neova são análise automatizada, para fins informativos, e que você decide o que mudar.

  • Links Sobre esta verificação

    Todo painel de verificação tem Sobre esta verificação, que abre a página da própria verificação na biblioteca de verificações, com o que ela sinaliza e a sua fonte.

  • Novidades

    Todas as versões desde o primeiro build, da mais nova para a mais antiga, cada mudança marcada como Novo, Melhorado ou Corrigido, com o horário de lançamento no seu fuso horário; abre sozinha uma vez depois de cada atualização. No topo, Chegando em breve lista o que está planejado.

  • Relatar um problema

    Gera um ZIP para o suporte com as versões do app e o log e os arquivos pequenos do crawl escolhido, com os segredos mascarados, e mostra o que ele contém e o que nunca contém antes de gerá-lo.

Nenhum recurso corresponde a essa busca.

Pronto para o seu próximo crawler de SEO?

Plano Free, ou 14 dias de Desktop grátis, sem cartão. Mac, Windows e Linux. Seus crawls ficam no seu computador.

Baixar a Neova

A Neova Online, a mesma Neova no navegador, vem com Desktop + Online e Agency: veja os planos.