Crawluj kilka witryn naraz i oglądaj to na żywo
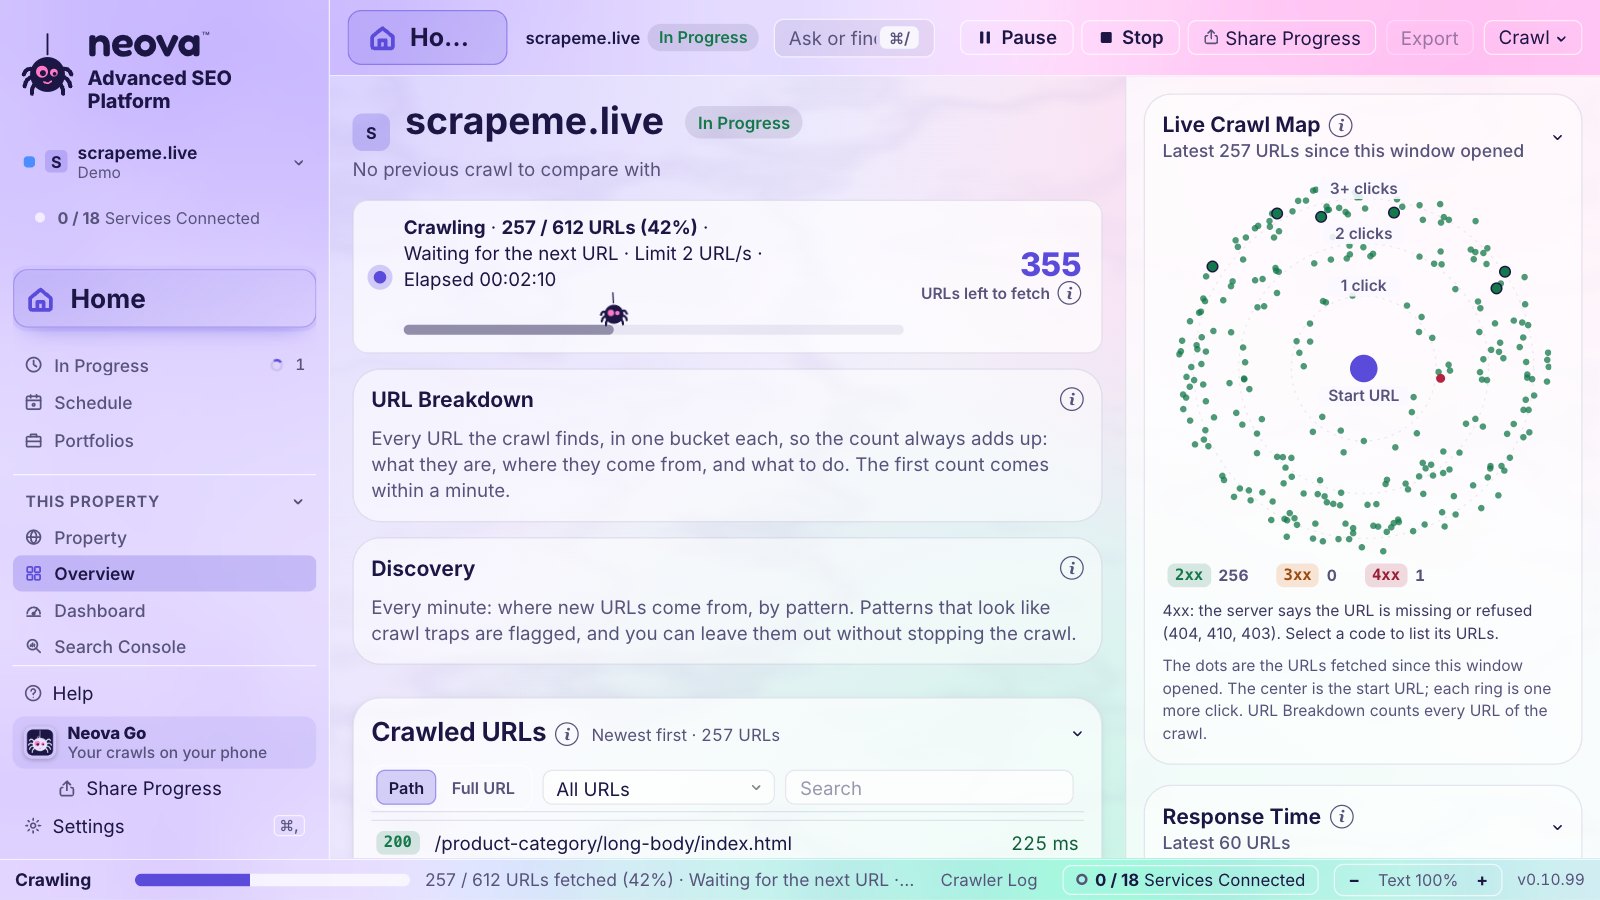
Kilka witryn naraz, każda we własnym tempie, na mapie na żywo z każdym URL-em, gdy tylko się pojawi.

Stworzony przez SEO-wców dla SEO-wców. Neova crawluje z twojego komputera, a potem mówi, które uwagi mają znaczenie, co naprawić najpierw, pisze tickety, przygotowuje raport dla klienta i pilnuje witryny. Dwie minuty filmu, a potem wszystko po kolei.
Crawl to dopiero początek. Oto co Neova z nim robi.
Kilka witryn naraz, każda we własnym tempie, na mapie na żywo z każdym URL-em, gdy tylko się pojawi.

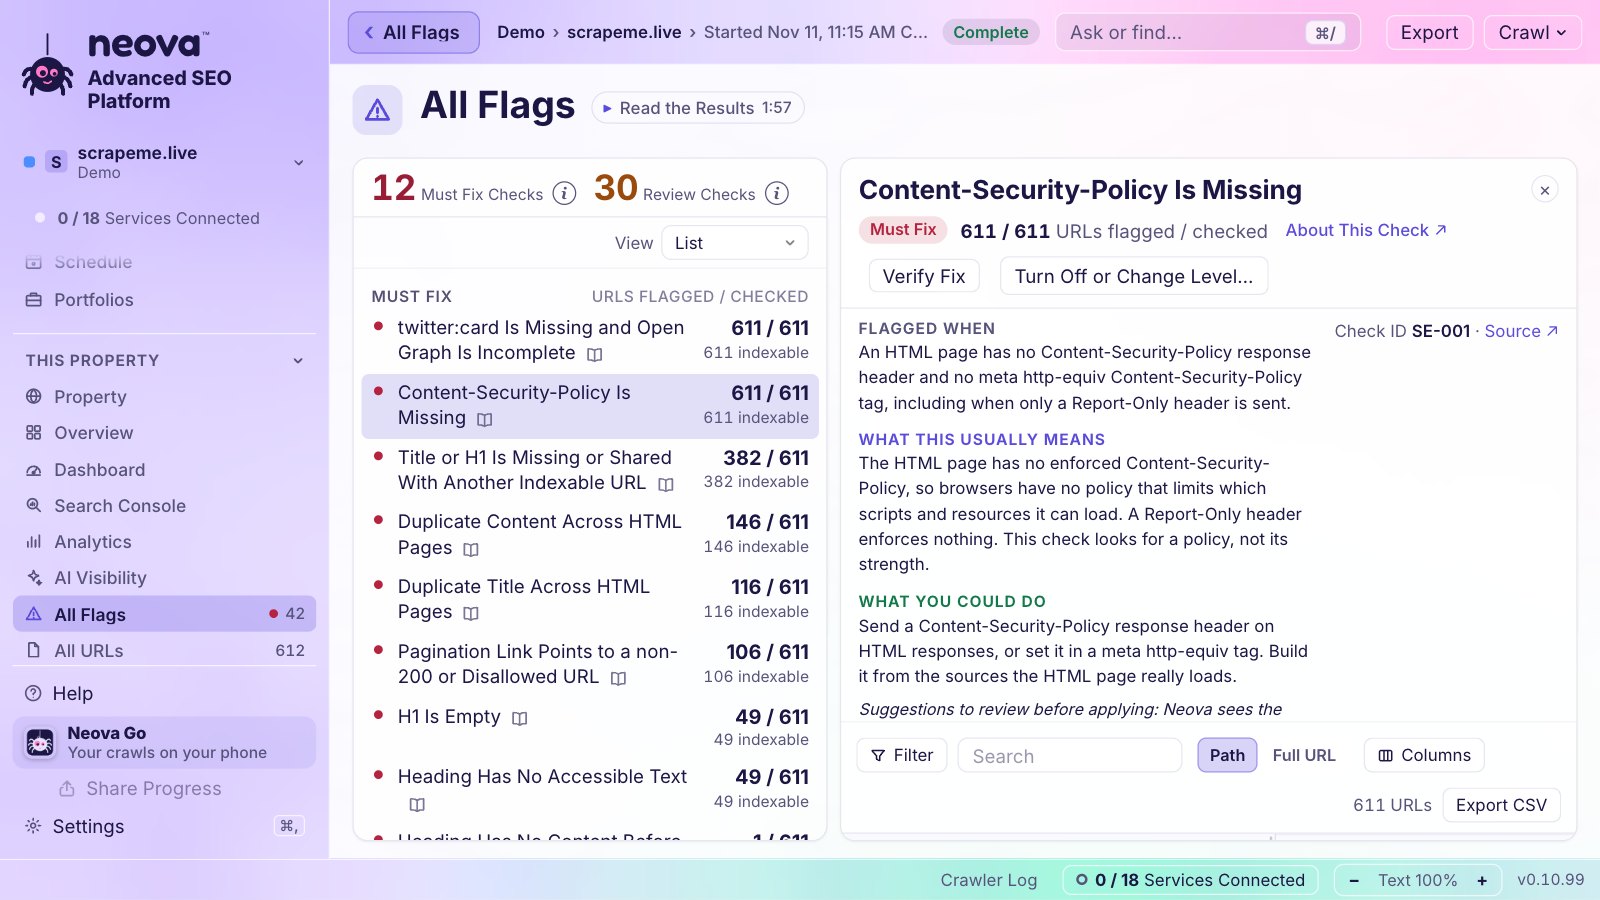
Każda uwaga mówi, dlaczego się pojawia, co zwykle oznacza i skąd pochodzi reguła.

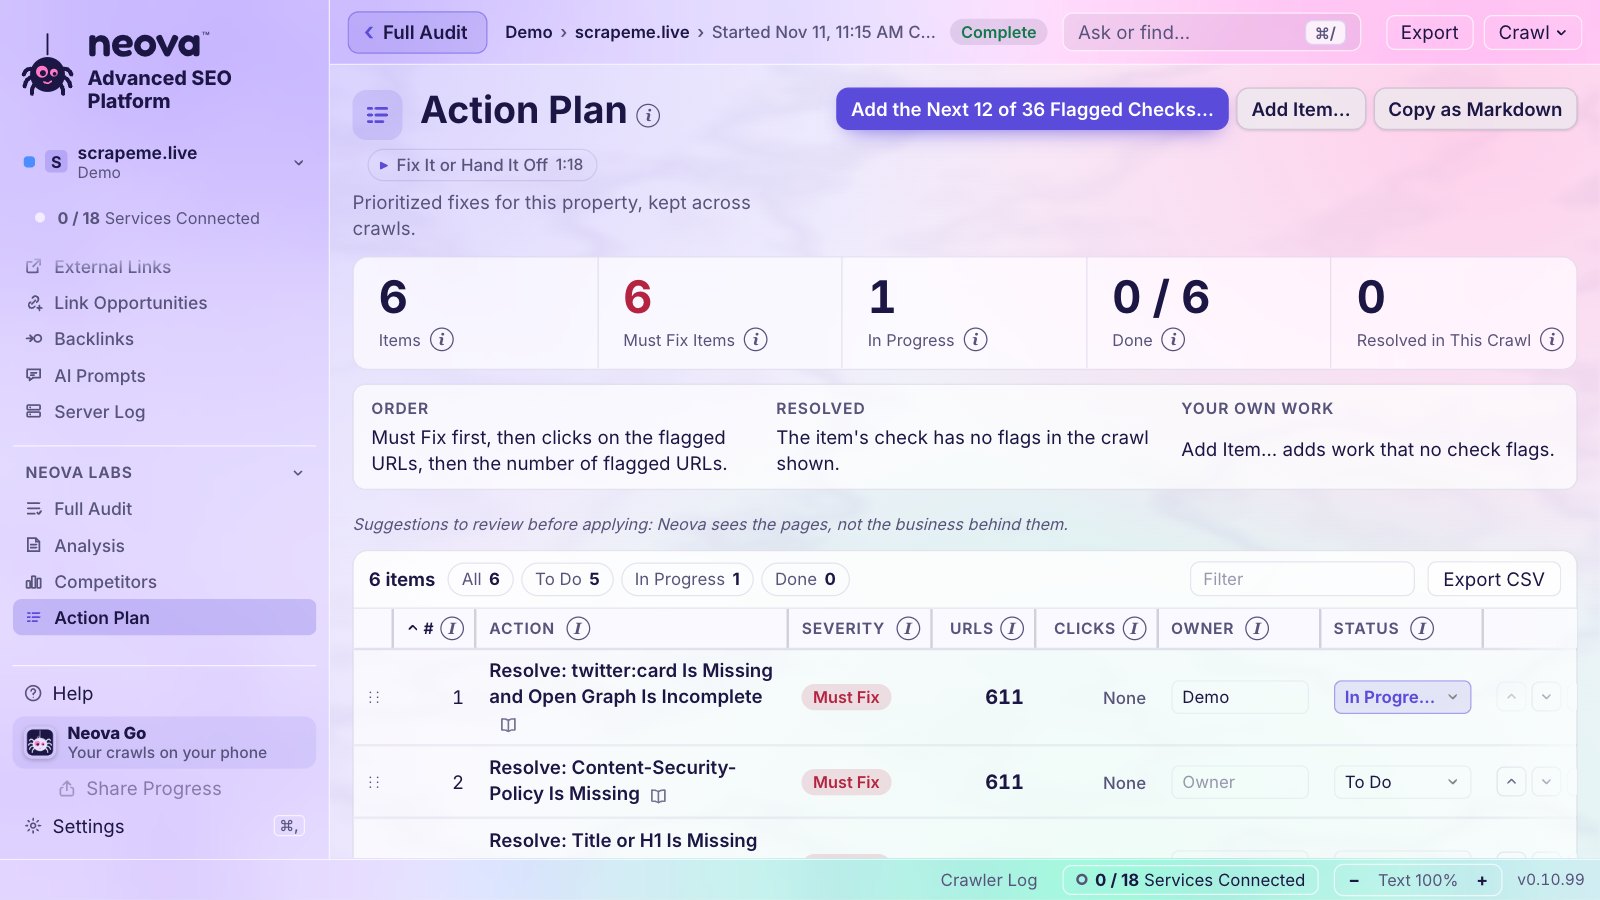
Uwagi stają się pracą: osoby odpowiedzialne, status, najpierw Do naprawy, zachowane od crawla do crawla.

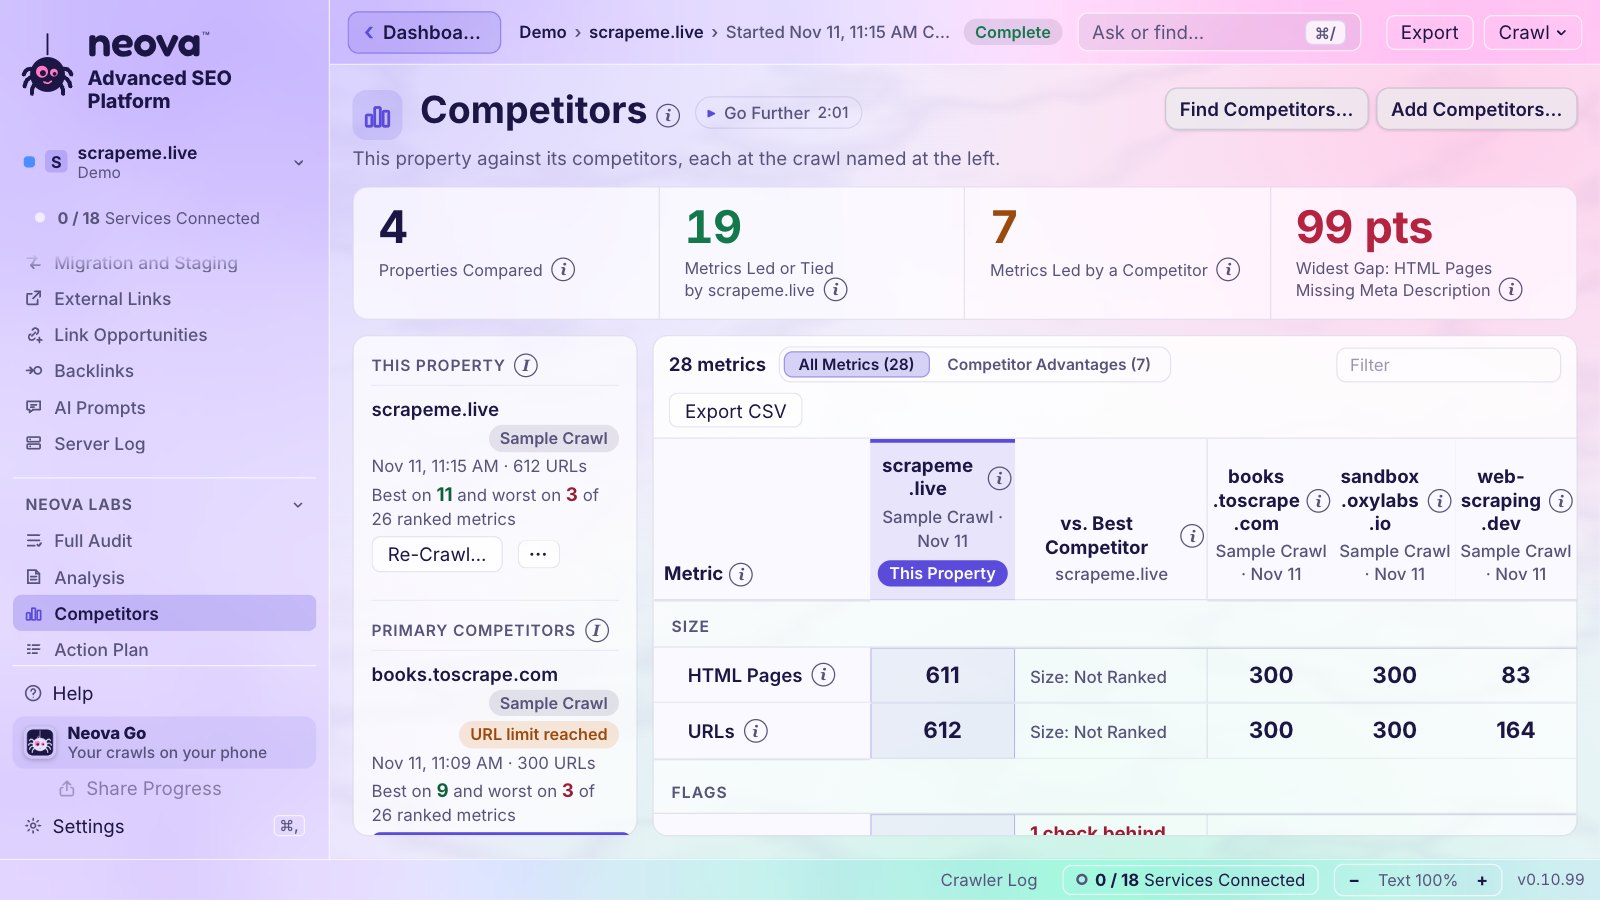
Wklej listę. Neova dobiera każdy crawl do ich map witryn, a potem pokazuje, kto prowadzi, metryka po metryce.

Co dostają prawdziwi użytkownicy na telefonach, według grup stron, z alertem, gdy zmieni się ocena.

Otwórz ich eksporty i uruchom testy Neova na tym, co znalazły. Zostań przy narzędziach, które lubisz.
Zamknij okno. Crawl trwa dalej na pasku menu, a telefon pokazuje każdą usługę.

Wszystko, co dostaje klient, z jednego miejsca, zaszyfrowane na twoim komputerze, zanim udostępnisz jakikolwiek link.
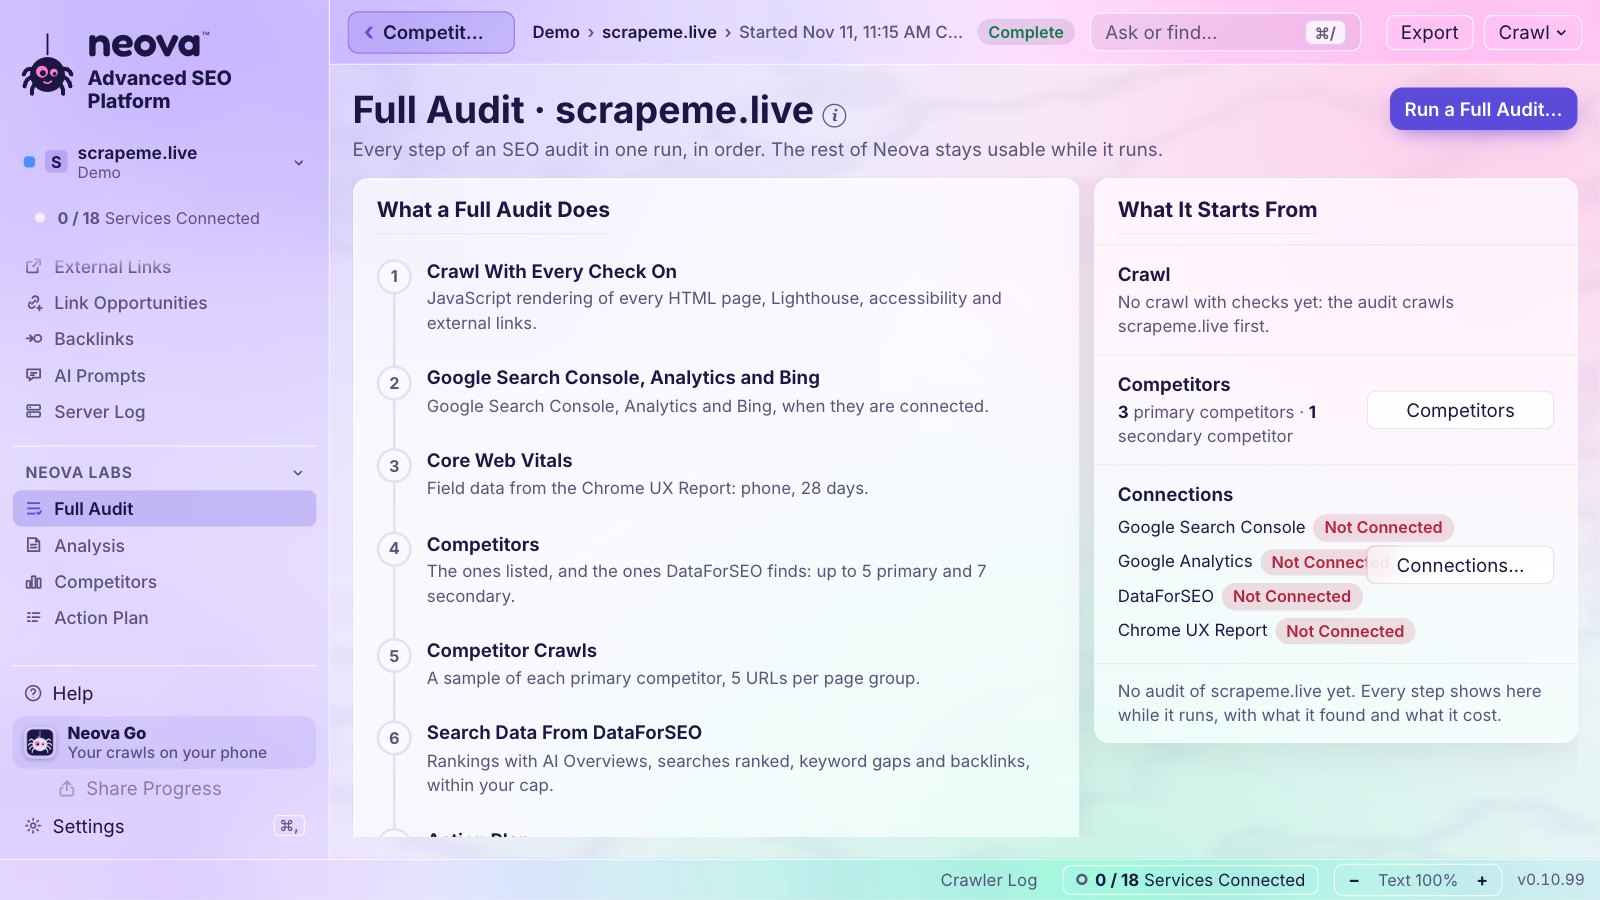
Crawl, Google, Bing i Analytics, Core Web Vitals, konkurenci, plan i PDF w jednym uruchomieniu.

Animowana maskotka, która siedzi na twoim pulpicie i pilnuje twoich crawli. Odzywa się, gdy crawl cię potrzebuje, odpowiada na pytania o crawl i jednym kliknięciem przenosi cię na właściwy ekran. Opcjonalna i wyłączona, dopóki jakiejś nie wybierzesz.
31 usług, każda opcjonalna: Neova robi swoje bez żadnej z nich, a z nimi robi więcej.
Otwórz obszar, by zobaczyć wszystkie jego funkcje, albo przeszukaj je wszystkie.
Log crawla na żywo: każdy pobrany URL z kolorowym kodem odpowiedzi i czasem odpowiedzi, każdy krok pogrubiony, błędy na czerwono, ostrzeżenia na bursztynowo; Kopiuj log zachowuje każdy wiersz dla supportu.
Podąża za linkami wewnętrznymi od URL startowego, a także za mapami stron XML, gdy są włączone, tak jak wyszukiwarka odkrywa witrynę.
Crawluje tylko URL, które wklejasz lub wgrywasz z pliku, nic więcej.
Odczytuje witrynę przed startem crawla i wybiera wersję (http lub https, z www lub bez), która odpowiada kodem 200, z informacją, co robią pozostałe wersje.
Pyta, czy crawlować subdomeny znalezione przez Neova, i które.
Crawluje całą witrynę bez limitu URL, chyba że go ustawisz.
Crawluje tylko foldery, które wpiszesz, i ocenia kompletność względem URL z mapy strony XML w tych folderach.
Crawluje określoną liczbę stron z każdej grupy stron, więc duża witryna jest audytowana w kilka minut, a każdy szablon jest uwzględniony.
Trzy poziomy w jednym wyborze: Tylko crawl, Audyt witryny (dodaje Core Web Vitals i szkic Planu działań) i Pełny audyt (dodaje konkurencję, dane wyszukiwania i analizę).
Dodaje dodatkowe startowe URL z pliku TXT lub CSV albo wklejone ręcznie, żeby dotrzeć do stron, do których nie prowadzi żaden link.
Crawluje URL z map stron XML zadeklarowanych w robots.txt, po stronach, do których prowadzą linki.
Czyta dodatkowe mapy stron XML, które wskażesz, obok tych zadeklarowanych w robots.txt, przy każdym crawlu usługi.
Wybiera, jakie zasoby oprócz stron HTML są crawlowane: obrazy, CSS, JavaScript i pliki PDF.
„Najpierw strony” pobiera wszystkie strony HTML przed obrazami i plikami, więc rdzeń audytu jest gotowy najpierw; „Według głębokości” pobiera najpierw to, co najbliżej startowego URL.
Zapisuje linki z menu, stopki i filtrów bez podążania za nimi, a za linkami w treści podąża zawsze.
Crawluje lub pomija URL według wzorców regex, po jednym w wierszu, z polem do przetestowania URL.
Jedna lista wykluczeń dla każdego crawla, niezależnie od tego, kto go uruchamia: okno, harmonogram czy asystent AI.
Przepisuje URL regułami regex przed crawlem, na przykład żeby usunąć parametry śledzące albo przenieść linki z wersji stagingowej na wersję produkcyjną, a linki z wersji produkcyjnej i jej mapy stron XML na host stagingowy.
Zachowuje lub usuwa parametry zapytania podczas crawlowania.
Crawluje linki wewnętrzne oznaczone rel=nofollow, kiedy tego chcesz.
Traktuje /Page i /page jako jeden URL.
Pozwala crawlowi, który zaczyna się w folderze, wyjść poza niego.
Limit URL, limit głębokości crawla, maks. URL na folder, maks. długość URL i maks. parametrów zapytania, żeby nawigacja fasetowa nie wymknęła się spod kontroli.
Domyślnie crawluje 3 URL na sekundę i sam zwalnia o połowę, gdy serwer zwalnia albo odpowiada kodem 429 lub 503, z poszanowaniem Retry-After.
Rozkłada każde żądanie zgodnie z zadaną szybkością, łącznie z robots.txt i mapami stron XML, więc witryna nigdy nie dostaje nagłego zrywu żądań.
Gdy potwierdzisz, że witryna jest twoja, przyspiesza do 50 URL na sekundę i może ignorować robots.txt, na twojej witrynie lub serwerze stagingowym.
Domyślnie crawluje jako NeovaBot albo jako Googlebot, Bingbot, Applebot, crawlery AI takie jak GPTBot i ClaudeBot, narzędzia SEO, przeglądarki lub własny ciąg znaków.
Przestrzega aktualnego robots.txt, ignoruje go na twojej własnej witrynie albo przestrzega szkicu zapisanego w testerze robots.txt, żeby zobaczyć, co zmieniłaby zmiana.
Po crawlu renderuje strony HTML w Chrome, wszystkie albo kilka na grupę stron, i porównuje wyrenderowaną stronę z surowym HTML; domyślnie wyłączone.
Czeka, aż sieć ucichnie, a strona przestanie się zmieniać, do limitu ustalenia, i mówi, kiedy strona wciąż się zmieniała.
Mówi nad wynikami, że crawl przebiegł bez renderowania i ile testów przez to nie zostało uruchomionych, i proponuje „Crawluj ponownie z renderowaniem”.
Pobiera każdy URL przez Chrome jak odwiedzający, na witrynach z ochroną przed botami; CAPTCHA rozwiązujesz sam, a Neova na ciebie czeka.
Wysyła uwierzytelnianie HTTP, ciasteczka i własne nagłówki tylko do crawlowanej witryny, dla wersji stagingowych i stref po zalogowaniu.
Tworzy tajny nagłówek dla witryny, którą zarządzasz, wysyłany tylko do niej, z regułą do przekazania jej działowi IT, żeby firewall przepuścił Neova.
Zapisuje konfigurację pod nazwą, żeby użyć jej na dowolnej witrynie, z podglądem tego, co ustawia.
Daje usłudze własne ustawienia crawla, od których startują Nowy crawl, Crawluj ponownie i jej harmonogramy, z opcją „Przywróć domyślne”.
Pokazuje ustawienia, które większość osób zmienia, albo wszystkie ustawienia z opisem działania każdego z nich.
Przed startem crawla wymienia każde ustawienie, które różni się od domyślnego, każde z linkiem „Edytuj”.
Najpierw czyta kilka stron i mówi, ile URL wymieniają mapy stron XML, ilu obrazów i plików się spodziewać oraz ile miejsca na dysku potrzeba w porównaniu z wolnym miejscem.
Na podstawie próbki stron mówi, ile obrazów przypada na stronę, jakie parametry niosą linki i które adresy są zapisane błędnie.
Sprawdza połączenie usługi z Google przed startem crawla lub audytu i wstrzymuje go z opcjami „Zaloguj się ponownie”, „Crawluj bez tych danych” lub „Anuluj”, gdy logowanie nie działa.
Pokazuje crawl w trakcie: ponumerowane etapy, co robi w tej chwili, pozostałe URL i wszystkie poniższe sekcje, każdą do zwinięcia.
Pokazuje etapy z nazwy (Crawlowanie witryny, Crawlowanie map stron XML, Crawlowanie zasobów, Renderowanie stron, Uruchamianie 694 testów) i co każdy pobrał.
Mówi w jednym wierszu, co crawl robi w tej chwili i jaki adres pobrał ostatnio.
Trzy paski pod postępem: Strony HTML, Obrazy oraz CSS, skrypty i inne pliki, każdy z liczbą pobranych spośród znalezionych.
Pokazuje URL jeszcze do pobrania, a potem URL jeszcze do sprawdzenia, dużą czcionką z paskiem.
Co minutę mówi, skąd według wzorca pochodzą nowe URL, oznacza kształty pułapek na crawlera (kalendarze, powtarzające się foldery, identyfikatory sesji, wiele parametrów, głębokie i długie URL) i proponuje od razu je wykluczyć lub pominąć.
Dla każdej znalezionej grupy URL proponuje „Crawluj je dalej”, „Pomiń” lub „Exclude”, przy każdej opcji mówiąc, co zostaje w audycie, a co z niego wypada, z zaznaczoną zalecaną.
Każdy URL znaleziony przez crawl trafia do dokładnie jednego koszyka (Czyste URL stron, Warianty z parametrami, Nieprawidłowe URL, Pułapki na crawlera, Obrazy, CSS, JavaScript i czcionki, Dokumenty, Wideo i audio, Inne zasoby), więc liczba jest zawsze wyjaśniona.
Pobiera obrazy z pierwszych 1, 3, 5, 10, 25, 50 lub 100 stron każdej grupy stron, z liczbą obrazów i czasem dla każdej opcji, albo pomija resztę, albo zachowuje wszystkie obrazy.
Gdy wszystkie strony są pobrane, pomija pozostałe obrazy i pliki, więc crawl kończy się jako ukończony, a testy się uruchamiają.
Podczas crawlowania pokazuje najgłębszą dotąd stronę, na pomarańczowo od 4 kliknięć, z wierszem ostrzeżenia od 10 kliknięć.
Rysuje ostatnie 300 URL według głębokości kliknięć, w kolorach kodów odpowiedzi, z URL tylko z mapy strony na osobnym pierścieniu.
Pokazuje medianę czasu odpowiedzi ostatnich URL na wykresie z liniami 800 ms i 1,800 ms.
Wymienia URL w miarę pobierania, po 10, 25, 50 lub 100 na stronę, z filtrami 2xx, 3xx, 4xx, 5xx i Brak odpowiedzi, zmienione i nowe.
Porównuje każdy pobrany URL z najnowszym wcześniejszym crawlem usługi, który czytał strony, najpierw z crawlem całej witryny, w przeciwnym razie z crawlem próbki lub wybranych folderów, i pokazuje starą wartość przekreśloną obok nowej.
Pokazuje uruchomione testy według kategorii, każdą z liczbą przeczytanych URL, a po zapisaniu także z liczbą uwag.
Wymienia strony samego Google pasujące do tego, co pokazuje crawl, oraz wiadomości z wyszukiwarki Google z ostatnich 45 dni: aktualizacje rankingowe, blog Search Central i aktualizacje dokumentacji.
Podsuwa lektury pasujące do crawla: Google Search Status Dashboard oraz case studies i aktualizacje algorytmów od SEO ProCheck.
Zamraża crawl i wznawia go dokładnie w tym samym miejscu.
„Zatrzymaj” pyta: „Przejdź do map stron XML”, „Zatrzymaj i uruchom testy”, „Zatrzymaj i usuń ten crawl” lub „Kontynuuj crawl”; podczas renderowania także „Pomiń renderowanie”.
Kontynuuje zatrzymany lub przerwany crawl z przywróconymi jego ustawieniami, nigdy od zera.
Uruchamia ponownie wszystkie testy na tym, co crawl pobrał, bez ponownego pobierania, także na crawlu, który doszedł do końca, więc test ulepszony w nowej wersji obejmuje też zapisane crawle; działa równolegle z crawlami innych witryn.
Crawluje usługę ponownie z ustawieniami jej ostatniego crawla, nie ruszając podłączonych danych, konkurentów ani planu.
Gdy witryna odrzuca crawl, mówi dlaczego (limit żądań, blokada przez firewall lub w tym kraju albo regionie, brak dostępu) i co zrobić dalej.
Adres, który nie może być URL, na przykład zdanie w href, nie jest odwiedzany, tylko zgłaszany jako uwaga.
Przeszukuje każdy pobrany arkusz stylów pod kątem czcionek, obrazów tła i importowanych arkuszy stylów.
Wymienia pliki i obrazy, które strony ładują z innych hostów, bez crawlowania ich.
Liczy jako obrazy URL mediów z CMS bez rozszerzenia obrazu, na przykład handlery /-/media/ w Sitecore.
Grupuje strony według szablonu na podstawie ich HTML (słów szablonu z samego motywu, a w ich braku szkieletu strony), a na bardzo dużych witrynach według wzorca adresu.
Podąża za linkami rel=next i rel=prev w sekcji head, tak samo jak za zwykłymi linkami.
Ustawia crawle w kolejce i startuje każdy, gdy tylko zwolni się miejsce na crawl, nigdy dwa crawle jednej witryny naraz, z opcjami „Uruchom kolejkę”, „Wyczyść kolejkę” i „Po zakończeniu testów”.
Trzyma crawl na dysku, a nie w pamięci (60 MB pamięci przy 60,000 URL), więc rozmiar ogranicza dysk, a nie pamięć.
Crawle do 4 witryn działają jednocześnie, każdy we własnym tempie i z własnym limitem URL, z ochroną pamięci, która wstrzymuje crawl, gdy komputerowi zaczyna jej brakować; każdy zapisany crawl lub usługa otwiera się w trakcie.
Nowy crawl wypełnia formularz zapisanymi ustawieniami usługi (szybkość, zakres, limit URL, renderowanie, user agent, mapy stron XML i reszta), także gdy wpiszesz adres witryny w polu URL startowy; twoje ostatnie odpowiedzi w tym oknie mają pierwszeństwo, a nic, co już zmieniłeś, nie zostaje nadpisane.
Gdy ten komputer traci połączenie z internetem, crawl to mówi, czeka i sam rusza dalej, gdy połączenie wróci, zamiast zatrzymać się, jakby witryna nie działała; po 30 minutach offline zatrzymuje się i mówi dlaczego.
Wymienia każdą stronę HTML z jej tagiem title, meta description i H1 oraz ich długością, a także testy treści z ich uwagami.
Zestawy kolumn w Wszystkie URL dla tytułów, meta description i H1, każdy z filtrami: brak, pusty, duplikat, za długi i za krótki.
Oznacza zduplikowane tytuły, opisy, H1 i H2 oraz zduplikowaną lub prawie zduplikowaną treść na stronach HTML.
Oznacza główną treść w przedziałach „trudny” i „bardzo trudny” wskaźnika Flescha oraz ubogie strony poniżej 200 słów.
Oznacza możliwe błędy ortograficzne i gramatyczne w głównej treści.
Oznacza tytuły i H1 z minionym rokiem oraz tekst, który wspomina ofertę, termin lub datę wydarzenia, które już minęły.
Sprawdza tagi, które ustalają tytuł, opis i obraz, jakie strona pokazuje po udostępnieniu.
Pokazuje, jak tytuł i opis strony wyglądają w wynikach wyszukiwania.
Model na twoim komputerze czyta strony HTML w ramach 20 testów treści, które wymagają oceny, na przykład brak przykładów, twierdzenia bez poparcia czy brak autora; jego uwagi są trzymane osobno od „Do naprawy” i „Do sprawdzenia”.
Pokazuje, które tytuły, meta description i H1 zmieniły się od poprzedniego crawla, przed i po.
Paski długości tytułu, meta description i H1, grupy stron i najczęściej linkowane strony HTML.
Eksportuje główną treść każdej strony HTML jako osobny plik Markdown, z indeksem.
Oznacza brakujące, puste, długie i zduplikowane H1 i H2, pierwszy H1, który nie jest głównym tytułem, oraz długie strony bez H2.
Oznacza brak deklaracji charset, doctype lub tagu body, zepsuty favicon, przestarzałe elementy i ramki, w których jest treść.
Oznacza Lorem Ipsum, kod szablonu, puste wartości skryptów oraz błędy serwera lub komunikaty debugowania widoczne jako tekst strony.
Oznacza niski stosunek tekstu do HTML, główną treść poniżej 200 słów i powyżej 5,000 słów.
Oznacza treść syndykowaną bez noindex lub canonicala do oryginału.
Oznacza brak strony „O nas” albo taką, do której nie prowadzą linki w całej witrynie.
Czyta encje kluczowych stron HTML twoim kluczem Google Natural Language, na potrzeby testów treści.
Kod odpowiedzi każdego URL, wszędzie w tych samych kolorach: 2xx na zielono, 3xx na pomarańczowo, 4xx i 5xx na czerwono, a Brak odpowiedzi osobno.
Dokąd prowadzą przekierowania, ile mają skoków, pętle, przekierowania tymczasowe, meta refresh i przekierowania JavaScript oraz linki, które na nie wskazują.
Oznacza wewnętrzne URL z 2 lub więcej skokami przekierowań, pętle przekierowań, przekierowania na samych siebie oraz brakujące lub błędne nagłówki Location.
Oznacza wewnętrzne przekierowania 302, 303 i 307, pomijając cele logowania.
Oznacza wewnętrzne przekierowania, które kończą się na 4xx lub 5xx, na URL z noindex, skanonikalizowanym lub zablokowanym albo na innej witrynie.
Oznacza URL, które przekierowują tylko po to, żeby dodać ukośnik lub zmienić wielkość liter, oraz strony, które różnią się tylko tym, bez canonicala między nimi.
Oznacza przekierowujące obrazy, skrypty i arkusze stylów oraz linki zewnętrzne, które przekierowują lub kończą się błędem.
Zestawy kolumn dla canonicali i dyrektyw meta robots, z filtrami Noindex i Nofollow.
Pokazuje nagłówki odpowiedzi dowolnego URL.
Pokazuje HTML, który wysłał URL, oraz wyrenderowany HTML, gdy crawl go renderował.
Mówi dla każdej strony HTML, czy jest renderowana po stronie serwera, po hydracji, czy wymaga JavaScript.
Oznacza tytuły, canonicale, linki i główną treść, które pojawiają się lub zmieniają dopiero po uruchomieniu JavaScript.
Dwadzieścia testów URL AMP i ich canonicali, w tym walidator AMP.
Oznacza długie URL, podkreślenia, podwójne ukośniki, powtórzone segmenty, przypadkowe znaki interpunkcyjne i zbyt wiele parametrów.
Pokazuje strony HTML według folderu i głębokości crawla.
Rysuje crawl jako drzewo od startowego URL, każdy punkt w kolorze kodu odpowiedzi, z legendą, która go filtruje.
Twoje własne grupy URL według regex, dla każdej witryny, każda z policzonymi kodami odpowiedzi, oraz kolumna Segment w Wszystkie URL.
Przeszukuje HTML każdej strony pod kątem tekstu lub regex albo wyciąga wartości przez XPath, selektor CSS lub regex i zapisuje ekstrakcję jako kolumnę, która uruchamia się ponownie przy każdym crawlu.
Wymienia typ treści, rozmiar i czas odpowiedzi każdego URL, z czasami odpowiedzi kolorowanymi od 800 ms i 1,800 ms.
Pobiera ponownie tylko URL oznaczone przez test, uruchamia wszystkie testy jeszcze raz i mówi, ile zostało naprawionych.
Wyłącza test albo zmienia jego poziom na „Do naprawy” lub „Do sprawdzenia” dla jednej usługi, z zachowaniem dla każdego kolejnego crawla.
Pomija w crawlu całe kategorie testów.
Jeden ekran do renderowania: ile stron HTML ma treść w HTML, częściowo w HTML lub wymaga JavaScript, co pokazuje tylko JavaScript, co dostaje każdy crawler AI, według grup stron, oraz strony, których treść nie jest w całości w HTML.
Zakładki SEO techniczne i Wyszukiwanie AI w dashboardzie pokazują odsetek stron z treścią w HTML, strony wymagające JavaScript, strony, których główna treść pojawia się tylko z JavaScript, oraz crawlery AI, które dostają pełną stronę.
Czy każda strona HTML może zostać zaindeksowana: kod odpowiedzi, noindex, canonical, robots.txt i HTML, który psuje sekcję head przed tagami SEO.
Oznacza każdy URL jako indeksowalny lub nie i podaje powód: kod 200, brak noindex, canonical wskazujący na siebie albo brak canonicala.
Wyjaśnia prostymi słowami każdy wiersz aktualnego pliku lub szkicu, tak jak opisuje go Google i definiuje RFC 9309, z crawlowanymi URL, do których pasuje każda reguła.
Pokazuje, co Googlebot, Bingbot i crawlery AI mogą pobierać według robots.txt, z URL, które są dla każdego z nich zablokowane.
Sprawdza szkic na każdym URL z crawla, zanim trafi na serwer, i wymienia URL nowo zablokowane i nowo dozwolone.
Mówi, kiedy własna grupa crawlera w robots.txt wyłącza reguły grupy *.
Co wymieniają mapy stron XML w porównaniu z tym, co znalazł crawl: brakujące strony indeksowalne oraz wymienione URL przekierowujące, z noindex, z błędem i osierocone.
Pobiera strony, które wymieniają tylko mapy stron XML, jako etap 2, i liczy je osobno.
Daje robots.txt i mapom stron więcej czasu na wolnych witrynach i mówi, kiedy któraś nie odpowiedziała.
Tworzy mapę strony XML ze stron indeksowalnych, na dowolnej głębokości albo do głębokości 3 lub 5.
Oznacza strony archiwum z paginacją, które zwracają 200 bez żadnych pozycji, zepsute łańcuchy rel=next i paginację z canonicalem na stronę 1.
Zachowuje każdą wersję robots.txt i każdą mapę strony XML przeczytaną przez crawle oraz oznacza zmiany reguł robots.txt od poprzedniego crawla.
Oznacza HTML, który zamyka sekcję head przed tagami SEO (noscript z tekstem, nieprawidłowy element, pominięte lub powtórzone tagi head), przez co tytuły i canonicale są czytane w body.
Oznacza canonicale, które się zapętlają, tworzą łańcuch, wskazują na przekierowania, noindex, 4xx, 5xx, HTTP lub zewnętrzne URL albo są ustawiane tylko przez JavaScript.
Oznacza noindex, nofollow i canonicale, które różnią się między HTML a nagłówkiem HTTP, są zadeklarowane dwa razy lub zawierają literówkę.
Oznacza strony, które używają obrazów, skryptów lub arkuszy stylów zablokowanych w robots.txt.
Oznacza warianty różniące się wielkością liter, ukośnikiem na końcu i kolejnością parametrów, które zwracają ten sam HTML.
Oznacza strony HTML, które odpowiadają kodem 200 z frazą typu „nie znaleziono” lub „brak wyników” w tytule lub H1.
Oznacza HTML powyżej 2 MB z linkami lub treścią poza limitem, który czyta Google, oraz pliki JavaScript lub CSS powyżej 2 MB.
Oznacza gwałtowną zmianę liczby crawlowalnych URL i reguły robots.txt zmienione od poprzedniego crawla.
Oznacza mapy stron XML powyżej 50 MB lub 50,000 wpisów, puste mapy, względne wiersze Sitemap w robots.txt oraz URL na innym hoście lub protokole.
Sprawdza, czy witryna hostuje twój plik klucza IndexNow, z opcją „Utwórz klucz”, żeby go utworzyć.
Czyta werdykt Sprawdzania adresu URL od Google dla maksymalnie 200 URL na crawl i oznacza strony indeksowalne, których Google nie indeksuje albo dla których Google wybrało inny adres kanoniczny.
Po crawlu całej witryny, który zakończy się sam, wysyła do IndexNow (Bing, Yandex, Seznam, Naver i Yep) strony zmienione lub nowe od poprzedniego pełnego crawla, tylko jeśli witryna hostuje twój klucz; okno mówi, co zostało wysłane lub odrzucone.
Wymienia strony oznaczone jako treść dla dorosłych (meta rating adult, etykieta RTA lub nagłówek Rating) oraz strony, które odpowiadają crawlerowi bramką wiekową, do twojego sprawdzenia.
Zepsute linki, linki do przekierowań, anchory i strony, do których prowadzi mało linków.
Wymienia każdy link do URL i z URL wraz z tekstem anchora.
Zapisuje, czy każdy link jest w treści, menu, stopce czy filtrach, z kolumnami Linki wchodzące z treści oraz Linki wchodzące z menu i stopki.
Ocenia każdy URL w skali od 0 do 100 według wagi linków wewnętrznych, które do niego prowadzą: to wewnętrzny PageRank liczony po linkach dofollow z crawla.
Liczba kliknięć od startowego URL dla każdego URL, z uwagą od głębokości 4.
Oznacza strony indeksowalne, do których nie prowadzi żaden link wewnętrzny, znalezione w mapach stron XML, logu serwera lub Google Search Console.
Każdy URL na innych witrynach, do którego linkuje witryna, każdy sprawdzany raz, ze zgłoszeniem 4xx, 5xx i braku odpowiedzi.
Włącza lub wyłącza dla crawla sprawdzanie każdego zewnętrznego URL; domyślnie włączone.
Podsuwa linki wewnętrzne na podstawie tekstu stron HTML: strony, które wspominają temat innej strony, ale do niej nie linkują.
Pokazuje URL Rating, Trust Flow, Page Authority lub Authority Score, domeny odsyłające i linki zwrotne dla każdego URL z twojego własnego klucza Ahrefs, Majestic, Moz lub Semrush.
Oznacza linki wewnętrzne bez anchora lub z anchorem, który nic nie mówi, oraz linkowane obrazy bez alt.
Oznacza strony osiągalne tylko przez linki nofollow, wewnętrzne linki wychodzące z nofollow oraz linki afiliacyjne bez sponsored lub nofollow.
Oznacza puste, błędne i złożone z białych znaków href, linki działające tylko przez onclick, parametry śledzące, lokalne ścieżki plików, localhost i fragmenty bez pasującego ID.
Oznacza URL osiągalne tylko przez canonical, przekierowanie lub strony z noindex oraz strony z linkami wchodzącymi tylko z jednego URL.
Liczy adresy zapisane w linkach błędnie (spacja na końcu, podwójny ukośnik, znak zakodowany dwa razy) jako osobny koszyk.
Oznacza strony HTML, które linkują do hosta stagingowego, deweloperskiego lub lokalnego.
Wymienia każdy obraz pobrany przez crawl lub używany przez stronę, z jego rozmiarem, tekstem alternatywnym i liczbą stron HTML, które go używają.
Oznacza brakujący, za długi, zastępczy i powtarzany tekst alternatywny oraz odróżnia brak alt od pustego alt obrazu dekoracyjnego.
Oznacza obrazy powyżej 100 KB, pliki GIF powyżej 100 KB i obrazy bez szerokości i wysokości.
Przy włączonym renderowaniu oznacza obrazy wyświetlane w złych proporcjach lub w zbyt niskiej rozdzielczości jak na swój rozmiar.
Oznacza obrazy nieskompresowane, nie w nowoczesnym formacie, większe niż wyświetlane oraz obraz LCP ładowany leniwie.
Oznacza wideo bez ścieżki napisów.
Pozwala pobrać z dużej biblioteki obrazów próbkę na grupę stron zamiast całości, z liczbami i czasem dla każdej opcji.
Pomija obrazy, które wciąż czekają w kolejce, a wszystkie strony nadal są crawlowane, a tekst alternatywny nadal czytany z HTML.
Na witrynach, które licencjonują obrazy, oznacza znaczniki ImageObject bez danych licencji i czyta próbkę serwowanych obrazów pod kątem praw IPTC i XMP, których Google potrzebuje do plakietki „Licencjonowany”.
Wersje językowe i regionalne każdej strony oraz to, czy wskazują na siebie nawzajem: linki zwrotne, autoreferencja, x-default, nieprawidłowe kody, cele skanonikalizowane i z noindex.
Języki hreflang i Cele hreflang dla każdej strony HTML, z pełną listą po najechaniu kursorem.
Oznacza brakujący, pusty lub nieprawidłowy html lang oraz wartości lang niezgodne z hreflang lub z tekstem samej strony.
Oznacza brakujące linki zwrotne, brakujące autoreferencje i linki zwrotne wskazujące na skanonikalizowane URL.
Oznacza brak x-default w zestawie strony głównej oraz zepsuty, z noindex lub skanonikalizowany cel x-default.
Oznacza cele hreflang, które nie zwracają 200, mają noindex, są skanonikalizowane, zablokowane albo nie mają linków wchodzących.
Waliduje każdy kod języka i kraju w hreflang i oznacza kody regionalne bez wersji zapasowej z samym językiem.
Oznacza odpowiedniki w innych wersjach językowych bez hreflang oraz rynek docelowy bez hreflang na żadnej stronie.
Czyta hreflang z sekcji head w HTML i z nagłówka HTTP Link oraz oznacza zestaw zadeklarowany więcej niż jedną metodą.
Oznacza odpowiedź, która zmienia się zależnie od Accept-Language w sposób niewidoczny dla Googlebota.
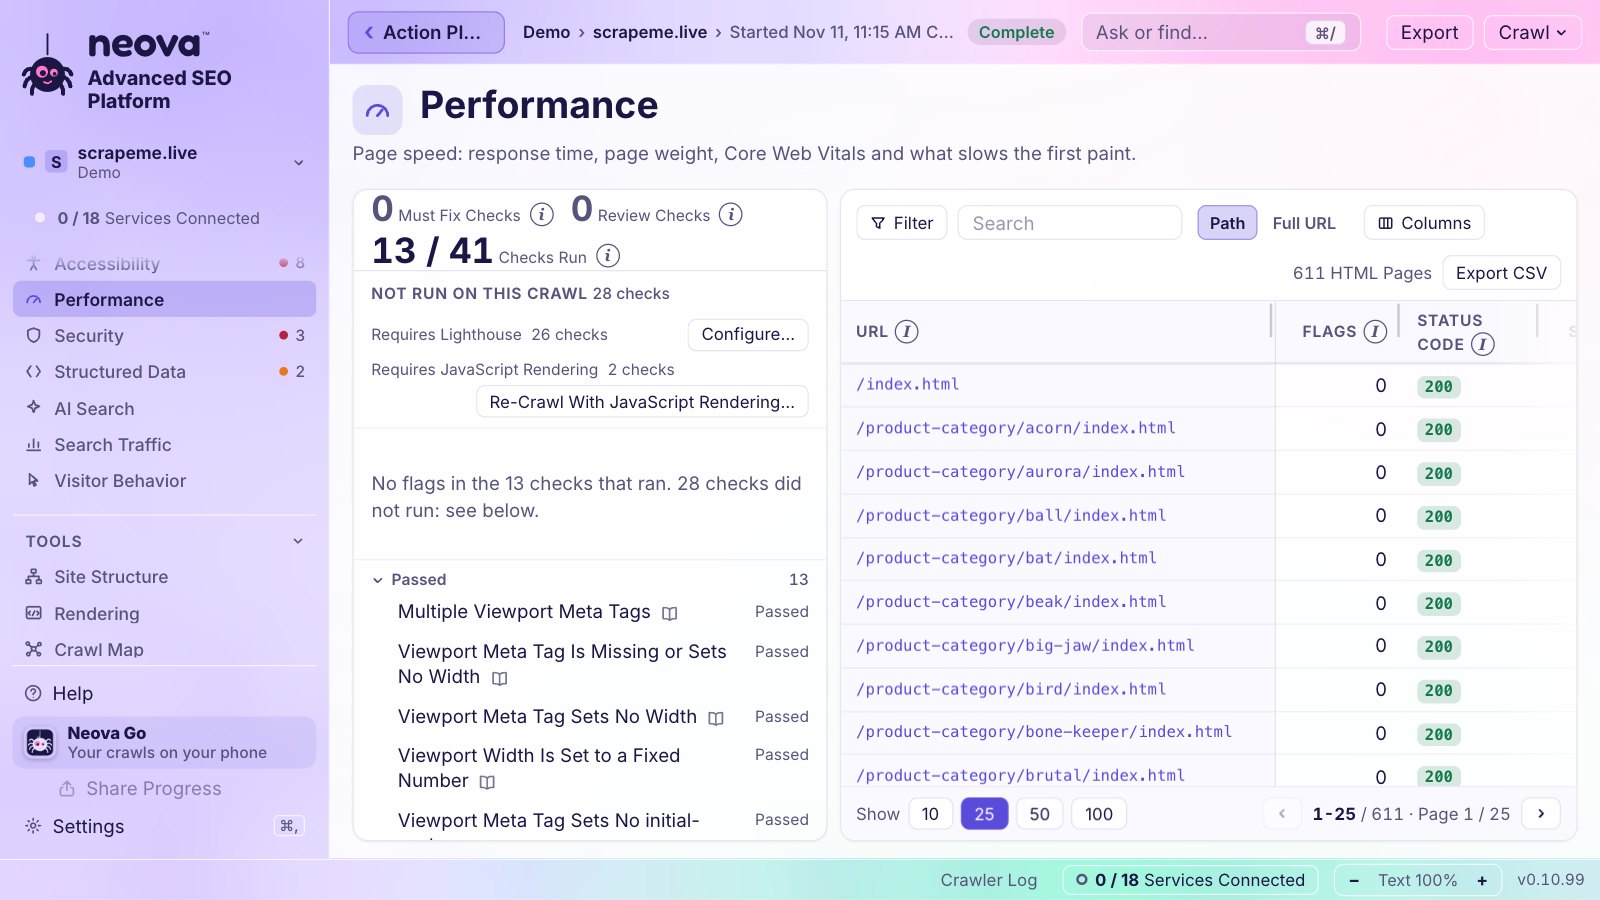
Szybkość strony: czas odpowiedzi, waga strony, Core Web Vitals i to, co spowalnia pierwsze wyrenderowanie.
Podczas crawla uruchamia testy laboratoryjne Lighthouse na jednej stronie HTML z każdej grupy stron.
LCP, INP i CLS prawdziwych użytkowników Chrome na telefonach, 75. percentyl, z twojego klucza Chrome UX Report.
Już pierwszego dnia rysuje około 40 tygodni danych terenowych z Chrome UX Report History, jeden punkt na tydzień, z progami Google dla wyników dobrych i słabych.
LCP, INP i CLS najczęściej linkowanych stron HTML z każdej grupy stron, więc wolny szablon od razu widać.
Czyta Chrome UX Report dla domeny, najczęściej linkowanych URL z każdej grupy stron i 10 najczęściej linkowanych URL, bez crawla.
Wykonuje migawkę sam, domyślnie codziennie albo co tydzień lub co miesiąc, nawet przy zamkniętym oknie.
Wysyła alert, gdy wskaźnik dostaje gorszą ocenę albo wraca do „Dobrze”, według progów Google.
Pokazuje obok siebie najnowsze odczyty w kolorach „Dobrze”, „Wymaga poprawy” lub „Słabo”, z datami.
Ustawia od 0 do 3 stron HTML na grupę stron dla każdej migawki i mówi, ile żądań do Chrome UX Report to zużywa.
Poziom Audyt witryny czyta Core Web Vitals z Chrome UX Report po crawlu.
Zachowuje każdą migawkę na twoim komputerze, dłużej niż 28 dni, które pokazuje Chrome UX Report.
Oznacza wyłączoną kompresję tekstu, niezminifikowane CSS i JavaScript, krótkie czasy cache oraz strony bez ETag lub Last-Modified.
Oznacza żądania blokujące renderowanie, długą pracę wątku głównego, nieużywane CSS i JavaScript, przestarzały JavaScript, zasoby po HTTP/1.1, wolne skrypty zewnętrzne i wynik Lighthouse poniżej 50.
Oznacza wolną odpowiedź serwera, CLS powyżej 0.1 i Core Web Vitals poza dobrym zakresem, w danych laboratoryjnych lub terenowych.
Oznacza strony, których renderowanie JavaScript trwa ponad 4 sekundy.
Oznacza brakujące lub sztywne viewporty, blokadę powiększania i tekst poniżej 12 px CSS na telefonach.
Mediana, 9 na 10 i najwolniejsze czasy odpowiedzi w trakcie crawla, z 10 najwolniejszymi stronami.
Co utrudnia osobom korzystającym z technologii wspomagających używanie każdej strony: nazwy, etykiety, ARIA, punkty orientacyjne, nagłówki, tabele i formularze.
Przy włączonym renderowaniu uruchamia reguły axe-core i próby jak odwiedzający: kontrast, fokus klawiatury, pułapki fokusu, powiększenie 200%, reflow przy 320 px i cele dotykowe 24 px.
Oznacza przyciski, linki, pola formularzy, obrazy, okna dialogowe i ramki bez dostępnej nazwy oraz pola nazwane tylko atrybutem title.
Oznacza nieprawidłowe role i atrybuty, brak wymaganych atrybutów, złe role nadrzędne lub podrzędne i przestarzałe role.
Oznacza strony bez punktu orientacyjnego main, ze zduplikowanymi lub zagnieżdżonymi punktami orientacyjnymi, pominiętymi poziomami nagłówków i bez sposobu na pominięcie powtarzających się bloków.
Oznacza tabele bez komórek nagłówka, nieprawidłowe scope i headers oraz źle zbudowane listy i listy definicji.
Oznacza brak wskaźnika fokusu, pułapki fokusu, dodatni tabindex, okna dialogowe, które nie utrzymują fokusu, i przewijane obszary bez dostępu z klawiatury.
Oznacza tekst o niewystarczającym kontraście, tekst poniżej kontrastu podwyższonego i linki odróżnione tylko kolorem.
Oznacza wyłączone powiększanie, tekst ucięty przy powiększeniu 200%, treść uciętą przy szerokości 320 px, blokadę orientacji i cele dotykowe poniżej 24 px.
Oznacza wideo bez napisów lub audiodeskrypcji, nieme wideo bez alternatywy i audio bez transkrypcji.
Oznacza pola bez etykiety lub z kilkoma etykietami, nieprawidłowe wartości autocomplete, pola blokujące wklejanie i błędy bez tekstu.
Lokalny model czyta strony w ramach 7 testów wymagających oceny, na przykład wykresów bez tekstowego odpowiednika.
Co mogą pobierać crawlery AI, co dostają i jak odpowiedzi AI cytują witrynę.
Odpytuje próbkę stron jako 10 agentów AI (ChatGPT, Claude, Perplexity, ich crawlery, Meta AI, Google-Extended, Common Crawl) i pokazuje, kto ma pełny dostęp i na co pozwala robots.txt.
Ocenia opublikowany llms.txt, wersję Markdown przez nagłówek Accept, manifesty wykrywania agentów i narzędzia WebMCP; witryna bez nich nie dostaje uwagi.
Oznacza kluczowe strony, które blokują crawlery wyszukiwania AI lub ograniczają snippety, oraz reguły dla AI niezgodne z twoją spisaną polityką.
Oznacza wersję Markdown, która jest pusta lub zawiera mniej niż połowę głównej treści.
Oznacza główną treść, która zaczyna się dopiero po pierwszych 5,000 znakach tekstu w body.
Oznacza niewidoczne nakładki na przyciskach i polach, słabo widoczne kontrolki zadań oraz niedatowane decyzje o zakupach przez agentów dla Google UCP lub OpenAI ACP.
Oznacza kluczowe strony, które blokują Applebota, oraz zablokowane fetchery AI uruchamiane przez użytkownika.
Oznacza spadające cytowania w Bing AI i kluczowe URL, których Bing AI nigdy nie cytuje, z Bing Webmaster Tools.
Raportuje sesje z odesłań przez AI i ich zaangażowanie na tle ruchu organicznego, z Google Analytics 4.
Zadaje do 20 twoich promptów ChatGPT i Perplexity przez twoje konto DataForSEO i raportuje wzmianki o marce, cytowane URL i witryny zewnętrzne cytowane zamiast twojej.
Mówi dla każdego śledzonego wyszukiwania, czy Google pokazuje AI Overview i czy cytuje ciebie, audyt po audycie.
Crawluje jako GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot i inne user agenty AI.
Pokazuje zweryfikowane wizyty crawlerów AI i odmowy dla każdego URL z logu serwera.
Uruchamia twoje własne prompty na każdej stronie HTML (szkice meta description, pomysły na FAQ, intencja wyszukiwania, główne encje) przez Ollama na twoim komputerze lub twoim kluczem Anthropic, OpenAI albo Google Gemini, z odpowiedziami w kolumnach.
Uruchamia 44 testy wymagające oceny we wszystkich kategoriach z lokalnym modelem przez Ollama; nic nie opuszcza komputera, a jego uwagi nie wchodzą do liczników.
Obsłużeni asystenci AI, AI Overviews, co dostaje każdy asystent AI i żądania od zweryfikowanych botów.
Dla każdego śledzonego wyszukiwania 3 razy wczytuje AI Overview Google przez DataForSEO i raportuje, ile jego źródeł jest na pierwszej stronie wyników, czy twoja strona tam jest i czy AI Overview ją cytuje, jako uwagę do sprawdzenia.
Znaczniki Schema na każdej stronie: poprawne, z ostrzeżeniami lub z błędami, oraz kolumna Typy Schema.
Wydaje werdykt dla każdego typu Schema na URL.
Oznacza strony, którym brakuje typu danych strukturalnych lub wyniku z elementami rozszerzonymi, który ma ich grupa stron.
Oznacza ceny produktów niewidoczne na stronie, wygasłe oferty, niezgodne daty i brakujące wymagane właściwości.
Oznacza dane strukturalne z błędami składni, brakiem wymaganych lub zalecanych właściwości albo tekstem innym niż na stronie.
Oznacza znaczniki Organization lub Person bez właściwości identyfikujących.
Sprawdza selektory Speakable, strony za paywallem bez isAccessibleForFree false oraz znaczniki HowTo, QAPage i FAQ na tle strony.
Oznacza nieprawidłowe wyniki z elementami rozszerzonymi oraz błędy AMP i wyników z elementami rozszerzonymi zgłaszane przez Google.
Porównuje znaczniki Organization z Profilem Firmy w Google, przez DataForSEO.
HTTPS, treści mieszane i nagłówki bezpieczeństwa wysyłane przez każdą stronę.
Wymienia nagłówki bezpieczeństwa wysyłane przez każdy URL.
Oznacza strony HTTP, przekierowania z HTTPS na HTTP, certyfikaty nieprawidłowe lub bliskie wygaśnięcia oraz TLS 1.0 lub 1.1.
Oznacza zewnętrzne skrypty i style bez hasha integrity oraz formularze lub pola hasła przesyłane przez HTTP.
Oznacza brak Content-Security-Policy, Strict-Transport-Security, nosniff, ochrony przed clickjackingiem lub Cross-Origin-Opener-Policy oraz niebezpieczną Referrer-Policy.
Oznacza strony HTTPS, które ładują zasoby po HTTP lub z adresami względnymi wobec protokołu albo linkują do stron HTTP.
Oznacza nagłówki odpowiedzi, które zdradzają serwer lub framework, oraz Content-Type niezgodny z plikiem.
Oznacza certyfikat, który nie obejmuje nazwy hosta wysłanej przez SNI.
Przy włączonym renderowaniu oznacza ciasteczka stron trzecich i prośby o uprawnienia przy ładowaniu.
Loguje się przez własną stronę Google w twojej przeglądarce, tylko do odczytu, i dołącza kliknięcia, wyświetlenia i CTR do każdego URL w każdym crawlu.
Dołącza wizyty i zaangażowanie do stron crawla na potrzeby testów analityki, przez to samo logowanie Google.
Przechowuje jedno logowanie na każde konto Google i dla każdej witryny używa konta, do którego należy usługa.
Pyta, która usługa Google Search Console i Google Analytics 4 należy do każdej witryny, i od razu zaznacza tę właściwą.
29 testów łączących dane Google z crawlem, np. URL z noindex, przekierowane lub z kodem 4xx, które nadal dostają kliknięcia.
Oznacza organiczne strony docelowe z zaangażowaniem 10 sekund lub krótszym, współczynnikiem odrzuceń 80% lub wyższym, formularze bez kluczowych zdarzeń oraz sesje organiczne poniżej 70% niedawnej normy.
Oznacza wyszukiwania, w których kilka URL dzieli się wyświetleniami albo najczęściej pokazuje się strona główna lub URL nieindeksowalny.
Podaje wyświetlenia i kliknięcia według wyglądu w wyszukiwarce.
Oznacza identyfikatory GA lub GTM ładowane dwa razy oraz indeksowalne URL bez identyfikatora GA ani GTM.
Szereguje testy według kliknięć oznaczonych przez nie URL, więc uwagi, które kosztują ruch, są na górze.
Zachowuje na twoim komputerze każdy miesiąc danych Google Search Console, także po tym, jak Google usuwa je po 16 miesiącach, z przyciskiem Archiwizuj teraz i comiesięcznym harmonogramem.
Kliknięcia i wyświetlenia dziennie z ostatnich 28 dni na tle 28 poprzednich, na wykresie.
Wyszukiwania, które przynoszą kliknięcia, z wyświetleniami i pozycją.
Codziennie śledzi do 25 wyszukiwań na usługę z Google Search Console: pozycję z 7 i 90 dni, zmianę, kliknięcia i wyświetlenia, z podpowiedziami wyszukiwań na pozycjach od 4 do 20.
Sprawdza do 200 URL na crawl: najpierw najczęściej klikane, potem najczęściej linkowane.
Kliknięcia i wyświetlenia z Google Discover, zachowywane z każdym zarchiwizowanym miesiącem.
Nanosi aktualizacje rankingowe i incydenty Google z ostatnich dwóch lat na twoje dzienne kliknięcia, z kliknięciami przed i po każdej z nich.
Kliknięcia, zapytania, błędy crawlowania i zaindeksowane URL z Bing, przez twój klucz API, z przyciskiem Przetestuj, który wymienia twoje witryny.
Pozycje, odpowiedzi AI, konkurenci i linki zwrotne przez twoje własne konto DataForSEO, płatne za każde zapytanie.
Rzeczywista pozycja mobilna każdego śledzonego wyszukiwania w top 20, obok najlepszy konkurent.
Wyszukiwania, na które konkurent jest w top 20, a ty nie, z ich wolumenem.
Odczytuje usługę, którą połączyłeś po crawlu, i uruchamia jej testy ponownie na tym crawlu, bez ponownego crawlowania.
Pokazuje, ile usług jest połączonych: na pasku stanu, pod usługą na pasku bocznym i jako blok Dashboardu; każde z tych miejsc otwiera Połączenia.
Podaje, ile żądań wysyła każde połączenie dla usługi w odniesieniu do limitów Google, wszystko na twoim własnym kluczu i koncie.
Każdy crawl zawiera linki do raportów Search Console „Problemy dotyczące bezpieczeństwa” i „Ręczne działania” dla danej usługi, bo API Google nie potrafi ich odczytać, więc oba otworzysz ręcznie.
Stawia usługę obok konkurentów, każdego z jego ostatnim użytecznym crawlem; każda metryka jest pokolorowana według tego, kto prowadzi, a kto zostaje w tyle, z różnicą do najlepszego konkurenta.
Wymienia metryki, w których prowadzi konkurent, od największej różnicy, z testami stojącymi za każdą liczbą.
Przyjmuje całą listę wklejoną tak, jak przyszła: bezpośrednich konkurentów jako głównych (najwyżej 5), pośrednich jako dodatkowych, i ustawia ich crawle w kolejce jednym krokiem.
Najpierw czyta mapy stron XML każdego konkurenta, domyślnie crawluje 750 URL i proponuje 1,000, 2,500 lub 5,000, gdy mapy stron wymieniają więcej.
Znajduje przez DataForSEO witryny, które mają pozycje na te same wyszukiwania, i dzieli je na głównych i dodatkowych konkurentów.
Nigdy nie proponuje jako konkurentów sklepów, aplikacji dostawczych ani marketplace’ów; nadal możesz dodać je ręcznie.
Gdy konkurent przeniósł się na inną domenę, crawluje go tam, gdzie teraz jest jego strona główna.
Proponuje podportfolio „<usługa> | Konkurenci” dla konkurentów usługi i trzyma je powiązane z tą usługą.
Liczy tylko testy, które mógł ocenić każdy porównywany crawl, i nie szereguje niczego względem crawla przerwanego przed końcem.
Wyszukiwania z pozycją, top 10, szacowane wizyty i domeny linkujące dla usługi i każdego konkurenta, audyt po audycie.
Domeny linkujące i linki zwrotne usługi i jej konkurentów, z DataForSEO Backlinks.
Pokazuje każdego konkurenta pod jego usługą, z paskami dla URL, uwag i uwag na porównany URL.
Kalendarz miesięczny wszystkich crawli i zaplanowanych uruchomień, minionych i nadchodzących, z filtrem usług.
Crawle całej witryny, które uruchamiają się same codziennie, co tydzień, co N tygodni lub co miesiąc, z ustawieniami usługi, przy zamkniętym oknie.
Archiwizacja Google Search Console według harmonogramu, domyślnie co miesiąc.
Mówi, ile kosztuje zaplanowany crawl, zanim zostanie dodany: URL na uruchomienie i uruchomienia na miesiąc.
Powiadamia 15 minut przed startem zaplanowanego crawla i mówi, że ruszy przy zamkniętym oknie.
Przesuwa jedno uruchomienie o 1, 3, 6 lub 9 godzin albo na wybraną datę i godzinę, lub je pomija, a harmonogram zachowuje swój rytm.
Bezpiecznie zatrzymuje trwający zaplanowany crawl i wyznacza mu nowy termin.
Powtarza pełny audyt co miesiąc z harmonogramu; Neova kończy analizę i PDF przy następnym otwarciu.
Wysyła alert, gdy Core Web Vitals zmieniają ocenę, kliknięcia z ostatnich 7 dni spadają o 20% lub więcej, śledzone wyszukiwanie wypada z top 10 lub do niego wchodzi albo traci 3 pozycje, lub gdy nowy crawl ma nowe uwagi.
Przechowuje 300 najnowszych alertów, z przyciskami Sprawdź teraz i Wyczyść alerty.
Neova działa dalej po zamknięciu okna, na pasku menu, z postępem crawla obok zegara.
Zachowuje ikonę w Docku albo zostawia tylko ikonę na pasku menu.
Uruchamia Neova przy logowaniu, z zamkniętym oknem.
Strona na telefon dodawana do ekranu początkowego kodem QR: ostatni crawl każdej usługi, Core Web Vitals, kliknięcia z Google Search Console, śledzone wyszukiwania, następne uruchomienie i trwające crawle, zaszyfrowane na Macu, zanim go opuszczą.
Mac wysyła podsumowanie co 2 minuty, gdy trwa crawl, a w pozostałym czasie co 15; telefon sprawdza co 2 minuty i mówi, jak stare są dane.
Tworzy link do jednego trwającego crawla, żeby każdy mógł go śledzić i wiedzieć, kiedy się skończy, z osobnym kluczem, bez ujawniania czegokolwiek innego.
Kopia ekranu na żywo, którą każdy może otworzyć: postęp, Podział URL, Najnowsze URL-e, Mapa crawla na żywo, Czas odpowiedzi, Przekierowania i błędy, Testy oraz Linki i Aktualności.
Udostępniona strona może powiadomić czytelnika, gdy crawl się skończy.
Każda grupa 3xx, 4xx, 5xx i Brak odpowiedzi z całego crawla, do 100 URL w każdej, najczęściej linkowane na początku.
Publikuje alerty i informację, jak zakończył się każdy crawl, na jednym lub kilku kanałach Slacka przez incoming webhook, sprawdzony wiadomością testową.
Publikuje alerty i informację, jak zakończył się każdy crawl, na kanałach Teams przez webhook z Workflows.
Wysyła wiadomości każdego portfolio lub usługi na ich własne kanały.
Powiadomienie systemowe, gdy crawl się kończy, a Neova nie jest na pierwszym planie, z dźwiękiem do wyboru.
Wymienia wszystko, co Neova teraz robi: crawl, audyt, Uruchom testy, zaplanowany crawl i kolejkę, każde z przyciskiem, który to otwiera.
Każda liczba, która ma poprzednią wartość, pokazuje zmianę od poprzedniego porównywalnego crawla.
Pobiera tylko listę stron, bez odkrywania, i wysyła alerty o zmianach statusu, celu przekierowania, title, canonicala, noindex, H1 i rozmiaru.
Stan crawla w skrócie: Podsumowanie crawla, Najważniejsze testy, Następne działania, Kody odpowiedzi i Zmiany wobec poprzedniego crawla; każda liczba otwiera swoją listę.
Każdy test z uwagami: waga, oznaczone URL spośród sprawdzonych, ile z nich jest indeksowalnych, zmiana od poprzedniego crawla, kategoria i kliknięcia.
Każdy test podaje: Oznaczane, gdy, Co to zwykle oznacza i Co możesz zrobić, ze swoim ID, źródłem i linkiem O tym teście, który otwiera jego stronę w bibliotece testów.
Każdy URL z zestawami kolumn, filtrami na dowolnej kolumnie, zapisanymi widokami, wyborem kolumn, przypiętą kolumną URL i 10, 25, 50 lub 100 wierszami na stronę.
Każda tabela i siatka eksportuje do CSV to, co pokazuje.
Każda kolumna, licznik i karta ma ⓘ, które mówi, co liczy.
Osiem grup i 13 kart zbudowanych z 39 bloków: podsumowanie, wydajność, technika, Core Web Vitals, treść, słowa kluczowe, wyszukiwanie AI, social, konkurenci, aktualizacje algorytmu, przepływ pracy, program i raporty.
Do 10 własnych dashboardów, tworzonych od zera lub jako duplikat karty, z blokami, które dodajesz, przesuwasz, zmieniasz ich rozmiar i usuwasz.
Plan działań jako program według statusu i właściciela, przy każdej pozycji jej test z uwagami z ostatniego crawla; na czerwono, gdy pozycja oznaczona jako Gotowe nadal ma uwagi.
Jeden ticket na test i grupę stron, najpierw Do naprawy, z regułą, dowodami, URL, których dotyczy, warunkiem ukończenia, sposobem sprawdzenia i miejscem poprawki (szablon, gdy oznaczone jest 90% grupy).
Kolejny crawl zamyka, zostawia lub ponownie otwiera każdy ticket według jego klucza, nigdy żadnego nie usuwa.
Zaczyna każdy ticket od kodu usługi, np. [DRH], i przenosi go jako etykietę do Jiry i Lineara.
Tworzy jedno zgłoszenie w Jirze na każdy ticket Neova w twoim projekcie Jira Cloud, z priorytetem, etykietami i załączoną listą URL, nigdy dwa razy.
Po każdym pełnym crawlu z okna przenosi zniknięte zgłoszenie do Done, ponownie otwiera to, które wróciło, i aktualizuje resztę.
Pliki przygotowane pod import CSV każdego narzędzia: Jira, Linear, Asana, ClickUp, monday.com, Azure DevOps Boards, Notion, Airtable, Smartsheet oraz plik to-do w Markdown dla Basecampa, każdy ze swoją stroną importu.
Raport dla klienta z twoją nazwą, logo i kolorem: crawl w liczbach, uwagi według kategorii, co naprawić najpierw z przykładowymi URL, renderowanie i widoczność w AI, zmiany od poprzedniego crawla i sposób wykonania crawla, w formacie Letter lub A4; testy z jednej rodziny liczą się raz, a drugi jest wymieniony jako Również oznaczone.
Daje każdemu klientowi własną nazwę, logo i kolor w raporcie, z polami Przygotowane dla, Przygotował i notatkami.
Jeden skoroszyt: Podsumowanie, Tickety w kolejności naprawy, Według grupy stron, arkusz na każdy test z 1,000 najczęściej klikanych, a potem najczęściej linkowanych URL, oraz Wszystkie uwagi.
Każda strona HTML, która odpowiedziała kodem 200, do 200,000, z title, description, H1, canonicalem, indeksowalnością, głębokością, linkami przychodzącymi, mapą strony, rozmiarem, czasem odpowiedzi, kliknięciami i uwagami.
Wysyła skoroszyt na twój Google Drive, przekonwertowany do Arkuszy Google.
Jeden ZIP z tym, co wybierzesz: PDF, skoroszyt szczegółowy lub skrócony, tickety z listami URL, pliki dla Jiry i Lineara oraz każdy oznaczony URL jako jeden CSV na test, z plikiem README.
URL, uwagi i tickety jako pliki CSV, dla CSV, Excela (UTF-8 z BOM), Arkuszy Google i Looker Studio.
Każdy eksport zawiera notatkę, gdy crawl działał bez renderowania lub objął tylko część witryny.
Domyślnie zapisuje eksporty w folderze Pobrane, w folderze Neova exports.
Zapisuje eksporty w wybranym folderze na komputerze.
Wysyła pliki na konta Google zalogowane w Neova, przez własny interfejs Google Drive, do ich folderu Neova exports, zastępując plik o tej samej nazwie, żeby jego link do udostępnienia dalej działał; Neova widzi tylko własne pliki.
Zapisuje w folderach synchronizowanych na Macu przez aplikacje Google Drive, OneDrive, Dropbox, iCloud Drive, Proton Drive i kDrive (na Windows OneDrive, Dropbox i Google Drive); każde konto jest wyłączone, dopóki go nie włączysz.
Wysyła eksporty na twój własny serwer przez SFTP z hasłem lub plikiem klucza, FTPS albo zwykły FTP; połączenie jest testowane przed zapisaniem, a klucz serwera zapamiętany.
Zapisuje eksporty każdego portfolio lub usługi w ich własnym folderze lub na dysku.
W Neova Online zapisuje eksport prosto do folderu na twoim komputerze w Chrome, Edge, Vivaldi, Brave i Arc; inne przeglądarki go pobierają.
W Neova Online eksport folderu, np. tabele CSV lub strony w Markdown, pobiera się jako jeden ZIP.
Jeden link tylko do odczytu do portfolio lub usługi, z zaznaczonymi przez ciebie crawlami, Planem działań, analizami, konkurentami i plikami, zaszyfrowany na twoim komputerze kluczem, który podróżuje tylko w linku; Aktualizuj zachowuje adres, a Wyłącz go usuwa.
Co zrobić i w jakiej kolejności: szkic z crawla (najpierw Do naprawy, potem kliknięcia, potem zasięg), który przestawiasz i opisujesz po swojemu, z własnymi pozycjami, statusem, właścicielem i notatką, zachowany między crawlami.
Kopiuje plan jako Markdown lub eksportuje go do CSV.
Pisze pełny audyt na twoim komputerze: obecny stan, uwagi według priorytetu, widoczność w wyszukiwarce, śledzone wyszukiwania, luki słów kluczowych i działania według priorytetu, a sekcje, które może napisać tylko człowiek, oznacza jako Do napisania.
Przechowuje dodane przez ciebie raporty (Markdown, tekst, PDF lub Word) przy usłudze, z opcją Oznacz jako sprawdzone.
Otwiera e-mail do Neova Labs z liczbami z crawla już w treści, dla sekcji, których nie pisze żaden test.
Jedno uruchomienie wszystkich etapów: crawl ze wszystkimi testami, Google, Bing i Analytics, Core Web Vitals, konkurenci i ich crawle, dane wyszukiwania z DataForSEO, Plan działań, analiza i PDF z brandingiem.
Uruchom pełny audyt pyta, czy czytać ostatni crawl, czy crawlować ponownie, i podaje jego URL i czas trwania.
Crawl A wobec crawla B: nowe, usunięte i zmienione URL, nowe i rozwiązane uwagi, crawl B pokolorowany jako lepszy lub gorszy.
Wszystko, co zachowano dla usługi ponad okres przechowywania samych źródeł: każdy crawl, każdy miesiąc Google Search Console, każdy pomiar Core Web Vitals, wersje robots.txt, mapy stron XML i zmiany URL.
Każda sugestia, ticket i raport ma dopisek, że trzeba go sprawdzić przed wdrożeniem, bo Neova widzi strony, a nie biznes, który za nimi stoi.
Zaplanowany crawl publikuje na Slacku i w Teams, jak się zakończył, a comiesięczny pełny audyt tworzy swój PDF przy następnym otwarciu Neova; żaden plik eksportu nie jest jeszcze zapisywany według harmonogramu.
Raport PDF i skoroszyt mówią, jak renderowane są strony (ogólnie, według grupy stron i strona po stronie), co robots.txt pozwala pobrać każdemu crawlerowi AI i co serwer mu podaje, oraz które testy wyszukiwania AI przeszły, a które coś oznaczyły.
Arkusz Google zbudowany z crawla specjalnie dla Arkuszy: Przegląd z wykresami, Plan działań z listami rozwijanymi Właściciel, Status i Termin, Uwagi, URL, Oznaczenia, Grupy stron, Przekierowania i błędy, Renderowanie i AI oraz Informacje, zapisywany na twoim koncie Google za każdym razem jako nowy plik.
Każdy plik, który Neova tworzy z crawla (Pakiet dla klienta, PDF, skoroszyt, Google Sheet, eksporty, pliki Neova), jest na liście z miejscem docelowym, crawlem, datą i rozmiarem, z przyciskami Otwórz, Otwórz folder, Kopiuj ścieżkę i Otwórz w Google Drive.
To samo okno Neova w przeglądarce pod adresem app.neova.app, z silnikiem na serwerze Neova, który tam crawluje i testuje.
Konta zakłada się z linku z zaproszeniem, imiennego lub otwartego; jeden link, jedno konto.
Hasło przechowywane jako hash, logowanie ważne 30 dni od ostatniej wizyty, przerwa po 10 błędnych hasłach, odrzucanie żądań z innych witryn i komunikat, gdy strona jest otwarta we wbudowanej przeglądarce innej aplikacji.
Crawle, dane i pobrane pliki każdej osoby w jej własnych folderach, nigdy niedostępne dla nikogo innego.
Jedno zadanie na osobę naraz, 10,000 URL na crawl, 10 URL na sekundę i 10 GB crawli na konto, dopóki Neova Online jest w testach.
Łączy Google Search Console, Google Analytics 4 i Google Drive z poziomu przeglądarki, a logowanie zostaje w twojej własnej przestrzeni.
Klucze i webhooki są przechowywane na twoim koncie Neova Online i nigdy nie są pokazywane ponownie.
Każde nowe konto zaczyna z Demo: testowym sklepem i trzema konkurentami już przecrawlowanymi, z ustawieniami portfolio, kodami i Planem działań, do usunięcia jednym krokiem.
Zaproszenie może zawierać portfolio skopiowane z innego konta z ich ostatnimi crawlami, ustawieniami i planami, z banerem, dopóki trwa przygotowanie.
Okno dopasowuje się do telefonów i tabletów: pasek boczny staje się wysuwaną szufladą, arkusze zajmują cały ekran w jednej kolumnie, a tabele przewijają się na boki.
Loguje aplikację desktopową do Neova Online raz; aplikacja przechowuje klucz dla tego komputera, nigdy hasło.
Sama utrzymuje zgodność portfolio, konkurentów, twojej kolejności, wyborów Google Search Console i Google Analytics 4, kolorów i kodów.
Gdy jedna strona ma już zawartość drugiej, logowanie od razu je scala, bez pytania; gdy obie naprawdę się różnią, pyta, od czego zacząć: Zachowaj z Neova Online, Zachowaj z tego Maca lub Scal obie (zalecane, nic nie traci), z liczbami po każdej stronie i kopią zapasową odłożoną najpierw.
Wysyła lub pobiera całe crawle w częściach, które można wznowić, sprawdzanych na końcu, obok dowolnego trwającego crawla.
Wysyła do Neova Online każdy crawl zakończony na tym komputerze; domyślnie wyłączone.
Neova Online pokazuje nowe wdrożenie przy następnym załadowaniu strony, nigdy starego okna z pamięci podręcznej.
Udostępnia instalatory i film instruktażowy dla testerów, z noindex.
Po podaniu hasła przenosi na ten komputer klucze połączeń, które ma twoje konto Neova Online, albo wysyła tam klucze tego komputera; pokazuje tylko 4 ostatnie znaki każdego klucza i nigdy nie zastępuje klucza, chyba że zaznaczysz Zastąp.
Każde konto Neova Online może przechowywać 10 GB crawli; Ustawienia pokazują, ile zajmuje konto i ile ma crawli, ostrzegają od 85%, a wysyłka lub crawl ponad dostępne miejsce jest odrzucany z informacją, co zrobić.
Neova SEO Platform na Maca, z silnikiem na pokładzie jako kod natywny, crawluje na twoim komputerze.
Instalator Windows x64 dla twojego konta, bez hasła administratora; wersja dla testerów, jeszcze niepodpisana.
W Windows aplikacja mówi „ten komputer” i używa Ctrl zamiast ⌘ we wszystkich skrótach.
Aplikacja desktopowa na Linuksie: pakiet .deb dla Ubuntu, Linux Mint i Debiana oraz AppImage, który nie wymaga instalacji.
Okno i biblioteka testów po angielsku, francusku, niemiecku, hiszpańsku, portugalsku (Brazylia), włosku, japońsku, niderlandzku, polsku, turecku, koreańsku, chińsku (uproszczonym), rosyjsku, indonezyjsku i wietnamsku.
Neova Marmur (domyślny), Neova, macOS, Liquid Glass, Windows 11, Linux, Terminal i Wysoki kontrast; wygląd zmienia kolory, nigdy położenie elementów.
Tryb jasny, ciemny lub zgodny z systemem, z kolorem akcentu.
Wiersze Kompaktowy lub Komfortowy i tekst, który skalujesz skrótami ⌘+ i ⌘−.
Pokazuje URL jako ścieżkę albo z protokołem i hostem, w każdej tabeli.
Zapisuje daty i godziny po twojemu albo zgodnie z językiem.
Pokazuje lub ukrywa wiersz Ekran główny; nazwa Neova w lewym górnym rogu i tak otwiera Ekran główny.
⌘N Nowy crawl, ⌘K Szukaj usług, ⌘, Ustawienia, ⌘[ Wstecz, ⇧⌘P Tryb prezentacji, ⌘/ Zapytaj lub znajdź.
Jedno pole znajduje widok, test po tytule lub ID, stronę z crawla, usługę albo ustawienie, i pamięta ostatnie wybory.
Dłuższe pytanie trafia do modelu na twoim komputerze, który wybiera odpowiedź spośród tego, co okno już pokazuje, więc nigdy nie zmyśla liczb.
Rozmywa wszystkie portfolio poza otwartym, na czas udostępniania ekranu klientowi.
Wraca do poprzedniego ekranu, którego nazwa jest na przycisku.
Jedna obwódka fokusu, każdy wiersz dostępny klawiszem Tab, klawisze strzałek w tabelach, arkusze jako okna dialogowe i respektowanie ograniczonego ruchu.
Przeciągnij pasek boczny, listę testów i panel szczegółów do szerokości, jakiej chcesz.
Zamknięcie pyta raz, gdy trwa crawl, potem go zapisuje, pokazując etapy i postęp, a Wznów kontynuuje go później.
Wymienia każdy zaplanowany crawl działający w tle i proponuje zatrzymanie i zapisanie go przed zamknięciem.
Crawl trwający podczas aktualizacji Neova sam się zapisuje, a Wznów go kontynuuje.
Zatrzymanie dopisuje tylko nowy HTML i pokazuje każdy etap zapisu z paskiem i przyciskiem Zamknij teraz.
Pilnuje wolnego miejsca na dysku podczas crawla, ostrzega, gdy robi się ciasno, i bezpiecznie zatrzymuje crawl poniżej 3 GB, żeby Wznów mógł go kontynuować po zwolnieniu miejsca.
Crawl przerwany przez awarię lub zamknięty potok jest na liście jako przerwany, nigdy nie znika, a jego magazyn danych jest bezpiecznie przywracany.
Kolejka i audyty działają dalej, gdy okno jest ukryte.
Sprawdza na app.neova.app, czy jest nowsza wersja: przy otwarciu aplikacji, co 30 minut i gdy okno wraca na pierwszy plan, wysyłając tylko numer wersji.
Po każdej zmianie kopiuje ustawienia okna do pliku, jedna kopia na wersję, przywracana, gdy pamięć okna zostanie wyczyszczona.
Zmienia miejsce, w którym Neova przechowuje crawle.
Od 64 px ikona ma napis Neova SEO pod pająkiem.
Gdy jest nowsza wersja, Nowa wersja dostępna pojawia się w lewym górnym rogu, na pasku narzędzi, na początku menu Pomoc i w Ustawienia › Ogólne, z przyciskiem Pobierz; aplikacja sprawdza co 30 minut i gdy okno wraca na pierwszy plan.
Każda tabela dobiera szerokość kolumn do tego, co zawierają, oddając pozostałe miejsce kolumnie URL i kolumnom przycinanym jako pierwsze; każdy nagłówek kolumny ma uchwyt do przeciągania, dwuklik dopasowuje, a ustawiona przez ciebie szerokość zostaje zapamiętana.
Opcjonalna animowana maskotka do wyboru spośród 8 (Webster, The Head, Sir Canonical, Polly Glot, Hopper, Shelly, Bo, Zap), w stylu uroczym lub pixel art, która pilnuje twoich crawli; domyślnie Brak, a przy Brak nic się nie ładuje.
Dymek, gdy crawl cię potrzebuje: koniec crawla z jego testami Do naprawy i liczbą nowych, zatrzymany lub nieudany crawl, witryna blokująca crawlera, zapełniający się dysk, start zaplanowanego crawla; kliknięcie otwiera ekran, o którym mowa.
Kliknięcie maskotki mówi, co robi Neova, a przy otwartym crawlu przyjmuje pytanie o niego, na które odpowiada tą samą drogą co pasek pytań (Ollama na twoim komputerze lub twój własny klucz AI).
W trybie Na pulpicie maskotka ma własne okno ponad wszystkimi oknami i na każdym Space, poza Dockiem; Neova czuwa także po zminimalizowaniu, a kliknięcie przywraca ją na właściwym ekranie.
Siedem rozmiarów od Malutki (56 px) do Kolosalny (320 px), domyślnie Duży, oraz pasek narzędzi pod maskotką: Otwórz Neova, Nowy crawl, W toku i Więcej (ukryj, ustawienia, wycisz), po najechaniu lub zawsze.
Crawle są przechowywane w Application Support/Neova na Macu i w %APPDATA%/Neova na Windows; nic nie trafia do Neova, chyba że synchronizujesz lub udostępniasz.
Każdy klucz, token i logowanie trafia do systemowego pęku kluczy przez standardowe wejście silnika, nigdy przez plik, wiersz poleceń ani ekran.
Aplikacja nie zawiera żadnego klucza Neova: Google, Chrome UX Report, DataForSEO i pozostałe usługi korzystają z twojego własnego klucza i konta.
Silnik jest dostarczany jako kod natywny, bez czytelnego kodu źródłowego.
Google jest połączone z uprawnieniami tylko do odczytu i twoim adresem e-mail; Rozłącz unieważnia token w Google.
DataForSEO jest wyłączone, chyba że Nowy crawl włączy je dla danego crawla.
Przed Start szacuje koszt na podstawie tego, ile DataForSEO policzyło temu komputerowi za ostatnie 20 wywołań każdego rodzaju, a w braku danych według cennika, zaokrąglając w górę do najbliższych $0.50 lub pełnego dolara.
Przestaje odpytywać DataForSEO po osiągnięciu ustawionego limitu, od $0.50 do $10 na crawl, domyślnie $1.
Dane wyszukiwania pełnego audytu zatrzymują się na jego własnym limicie w dolarach amerykańskich, a audyt mówi, ile wydał.
Logi serwera są czytane na twoim komputerze; żaden adres IP nie jest nigdzie zapisywany.
Ocena AI i Zapytaj używają modelu na twoim komputerze przez Ollama, więc nic go nie opuszcza; Prompty AI mówią, kiedy tekst strony trafia do wybranego przez ciebie dostawcy.
Linki do udostępnienia, Neova Go i Udostępnij postęp są szyfrowane na twoim komputerze kluczem, który jest tylko w linku lub kodzie QR, więc serwer przechowuje to, czego nie potrafi odczytać.
Udostępnianie informacji, które strony słownika otwierasz, jest domyślnie wyłączone i wysyła tylko losowy identyfikator, test i język.
Usunięty crawl trafia do Kosza, skąd można go przywrócić, z zaznaczaniem wielu starych, zatrzymanych crawli naraz.
NeovaBot mówi, kim jest, przestrzega robots.txt i domyślnie 3 URL na sekundę, i nigdy nie rozwiązuje CAPTCHA.
Zapisuje crawl, usługę ze wszystkimi crawlami i danymi albo portfolio jako jeden plik .neova, z zapisanym HTML lub bez, w folderze Pobrane, na Google Drive, na dowolnym dysku lub w folderze; harmonogramów, połączeń, kluczy i haseł nigdy w nim nie ma.
Instaluje plik .neova utworzony na dowolnym komputerze z Mac, Windows lub Linux; zanim cokolwiek zapisze, mówi, co jest nowe, co już tu jest, a co przychodzi pod inną nazwą, i nigdy nie zastępuje tego, co ma ten komputer.
Polecenie neova crawluje, importuje, publikuje i odczytuje witryny, strony, uwagi, tickety i alerty z Terminala lub skryptów, jako tabele, CSV lub JSON.
neova check porównuje crawl z punktem odniesienia i kończy się kodem 3 przy nowych uwagach albo przy uwadze, która przekroczy określony odsetek URL.
Daje asystentom AI dostęp do odczytu twoich crawli, uwag, ticketów i ustawień przez 16 narzędzi, a dane zostają na twoim komputerze.
Dodaje Neova do Claude Desktop jednym kliknięciem, z gotowymi do skopiowania konfiguracjami dla Claude Code, Codex, Cursor, VS Code, Gemini CLI, LM Studio, Windsurf i ChatGPT.
Uruchamia, zatrzymuje i usuwa crawle z poziomu asystenta; każde uruchomienie i usunięcie najpierw pyta cię o zgodę.
Czyta log crawla i nazywa, co poszło nie tak (serie 429 lub 503, kody 403, blokady w robots.txt, strony tylko w JavaScripcie, za mało stron), z ustawieniem do zmiany.
Jeden zwykły plik JSON zawiera listę wykluczeń, ustawienia domyślne oraz ustawienia i przełączniki testów każdej usługi.
Otwiera eksport Internal ze Screaming Frog (z All Inlinks), eksport URL z Sitebulb, JSON z SiteOne Crawler albo dowolny CSV z kolumną URL i uruchamia na nim testy Neova.
Ocenia import, pobierając ponownie próbkę 50 URL z prędkością 2 URL/s i porównując z mapami stron na żywo, żeby import nigdy nie udawał crawla.
HTTP API Neova Online pod adresem app.neova.app/api/v1: odczyt portfolio, usług, crawli, uwag i ticketów, uruchamianie crawla i zarządzanie ticketami, każdy skrypt z własnym kluczem Tylko odczyt lub Odczyt i zapis, 60 żądań na minutę na klucz i 20 kluczy na konto.
Żądania wyszukiwarek i crawlerów AI na każdy URL z crawla, z własnego logu dostępu witryny.
Liczy żądanie jako Googlebota, Bingbota lub crawlera AI tylko wtedy, gdy jego adres jest na liście publikowanej przez daną firmę; nazwa użyta gdzie indziej jest liczona osobno.
Wymienia strony HTML, których Googlebot nie odwiedził w okresie logu, oraz URL, o które pytały boty, a których crawl nie zna.
Liczy odpowiedzi 429 i 403, które dostał każdy bot.
Czyta log Apache lub Nginx w formacie combined, zwykły lub spakowany gzipem.
Dla witryny za Cloudflare zbiera żądania wyszukiwarek i crawlerów AI na twoim własnym koncie Cloudflare i czyta je przed każdym crawlem, bez potrzeby dostępu do serwera.
Pisze prośbę do wysłania działowi IT: tylko linie crawlerów, nic do instalowania, to, co musi wiedzieć dział bezpieczeństwa.
Blok Dashboardu z żądaniami botów.
Dopasowuje każdy URL z crawla starej witryny do crawla nowej, z poziomem pewności, przy migracji w tej samej domenie lub na inną.
Sprawdza przekierowanie na żywo każdego starego URL względem mapy i oznacza błędne lub brakujące.
Porównuje crawl stagingu z produkcją: kod odpowiedzi, noindex, canonical, title, meta description, H1 i URL obecne tylko w jednym crawlu.
Zamienia, który crawl jest stary, a który nowy, albo który jest stagingiem, a który produkcją.
Ignoruje robots.txt i działa szybciej na witrynie, którą potwierdzasz jako swoją, z uwierzytelnianiem HTTP i własnymi nagłówkami.
Crawluje listę starych URL, żeby sprawdzić, gdzie każdy z nich prowadzi.
Gdy strona startowa subdomeny stagingowej linkuje głównie do witryny produkcyjnej, Nowy crawl pokazuje liczby i jednym kliknięciem dodaje regułę Przepisywanie URL oraz mapy stron XML witryny produkcyjnej; dodana mapa strony XML, której żadna reguła nie przenosi na crawlowaną witrynę, jest oznaczana przed startem crawla.
Każda twoja usługa jako blok w swoim kolorze, z logo i kluczowymi liczbami, a jej konkurenci jako wiersze pod nią.
Przeciągaj usługi we własnej kolejności, zachowanej na Macu, online i na telefonie.
Zwija usługę z jej konkurentami do jednej linii, ma Zwiń wszystko i Rozwiń wszystko oraz przypiętą wyszukiwarkę pod klawiszem /.
Tabela wszystkich usług, a pod każdą usługą jej konkurenci.
Jedno centrum dla każdej witryny: jej crawle, Dla klienta, Core Web Vitals, Google Search Console, konkurenci, Plan działań, analiza i harmonogramy.
Raport z brandingiem (PDF), Skoroszyt wszystkich uwag (Excel) i tickety, każde pod jednym przyciskiem, tworzone z otwartego crawla.
Każdy przycisk w nagłówku Usługi mówi, co robi i czym różni się od drugiego.
Grupuje usługi według klienta lub firmy, z kolorem, i podportfolio na jednym poziomie zagłębienia.
Daje każdej usłudze kolor i kod z 2 do 6 liter zaproponowany na podstawie jej domeny.
Znajduje usługę skrótem ⌘K: najpierw przypięte i te, które się crawlują, a pod każdym portfolio jego usługi i konkurenci.
Pięć ostatnich crawli usługi i to, co się z każdym stało; otwierasz jednym kliknięciem.
Zaznaczasz crawle polami wyboru albo przyciskiem Zaznacz starsze zatrzymane i przerwane, a potem Usuń zaznaczone.
Każdy wiersz listy ma jeden główny przycisk, a pod ⋯ i prawym przyciskiem myszy wszystkie akcje, z Usuń na końcu, na czerwono.
Biblioteka testów na app.neova.app/checks, Pomoc Neova SEO Platform, Co nowego, Zgłoś problem, skróty klawiszowe i Sprawdź aktualizacje.
Pobieranie, instalacja, pierwszy crawl, Neova Online i aplikacja desktopowa, opcjonalne połączenia i lista zmian, na app.neova.app/help.
Wszystkie 694 testów według grup na app.neova.app/checks, każdy z własną stroną i źródłem, otwierane przez O tym teście wszędzie, gdzie pada nazwa testu.
Mówi jeden raz, że wyniki Neova to automatyczna analiza o charakterze informacyjnym, a o tym, co zmienić, decydujesz ty.
Panel każdego testu ma O tym teście: otwiera stronę testu w bibliotece testów, z tym, co oznacza, i z jego źródłem.
Każda wersja od pierwszej, od najnowszej, a każda zmiana oznaczona jako Nowe, Ulepszone albo Naprawione, z godziną wydania w twojej strefie czasowej; otwiera się sama raz po aktualizacji. Na górze Już wkrótce: to, co planujemy.
Tworzy jeden plik ZIP dla wsparcia z wersjami aplikacji oraz logiem i małymi plikami wybranego crawla, z zamaskowanymi sekretami, a zanim go utworzy, mówi, co w nim będzie, a czego nigdy nie będzie.
Żadna funkcja nie pasuje do tego wyszukiwania.
Plan Free albo 14 dni Desktop za darmo, bez karty. Mac, Windows i Linux. Twoje crawle zostają na twoim komputerze.
Pobierz NeovaNeova Online, ta sama Neova w przeglądarce, jest w planach Desktop + Online i Agency: zobacz plany.