Crawlez plusieurs sites à la fois, et suivez-les en direct
Plusieurs sites à la fois, chacun à son rythme, sur une carte en direct de chaque URL dès son arrivée.

Conçu par des SEO, pour des SEO. Neova crawle depuis votre propre ordinateur, puis vous dit quels flags comptent et quoi corriger en premier, rédige les tickets, produit le rapport client et garde un œil sur le site. Deux minutes de vidéo, puis tout le reste.
Le crawl n'est que le début. Voici ce que Neova en fait.
Plusieurs sites à la fois, chacun à son rythme, sur une carte en direct de chaque URL dès son arrivée.

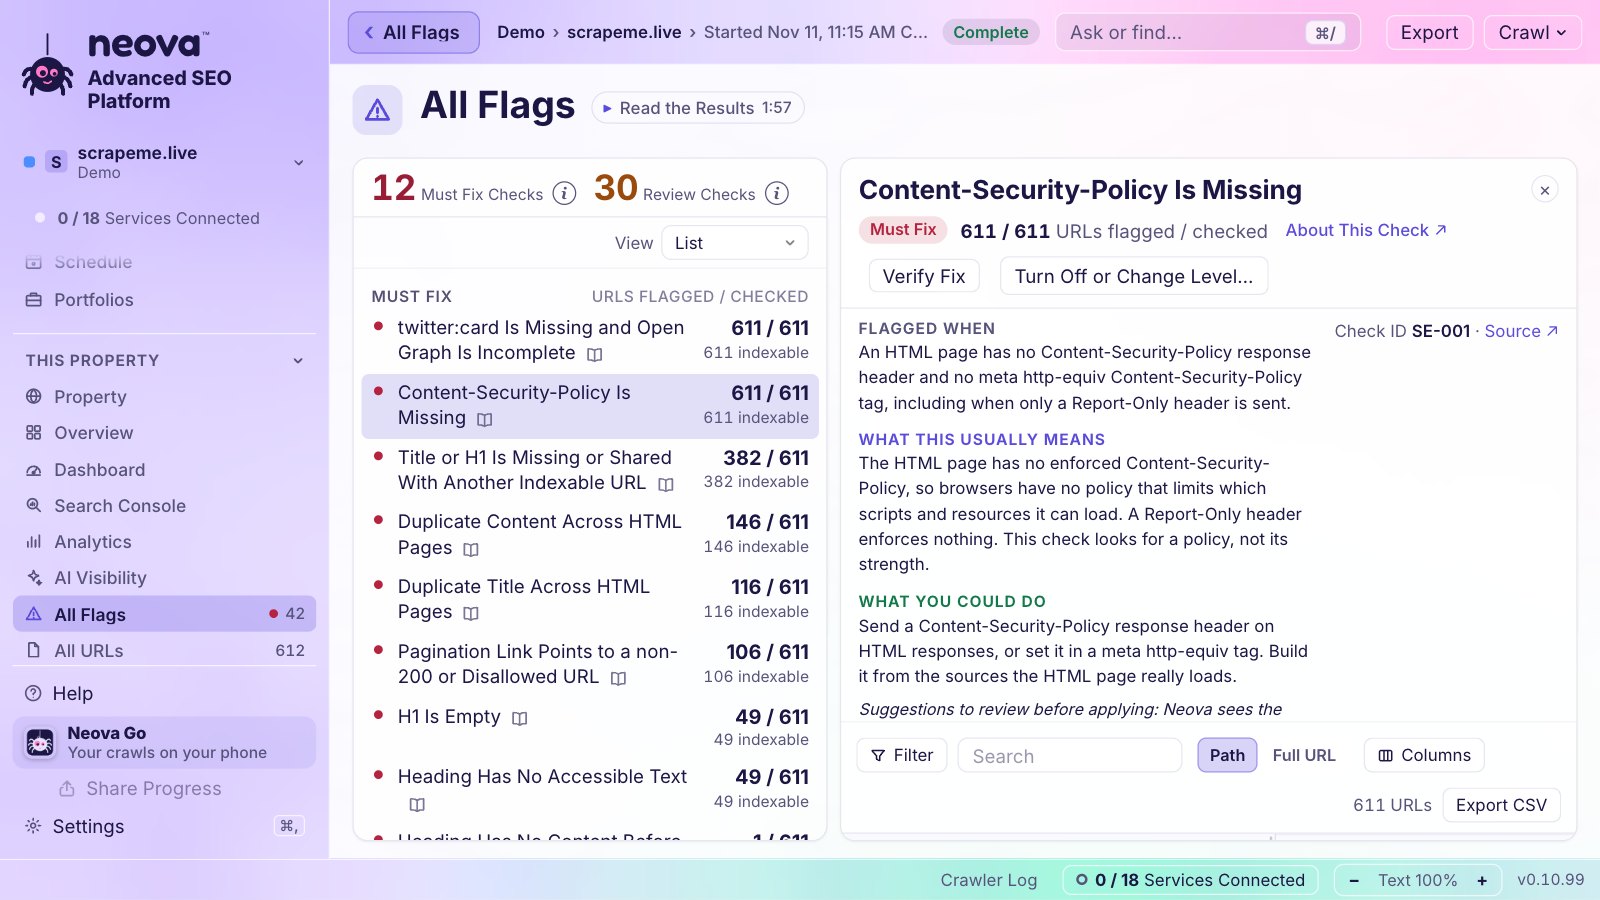
Chaque flag dit pourquoi il se déclenche, ce qu'il signifie le plus souvent et d'où vient la règle.

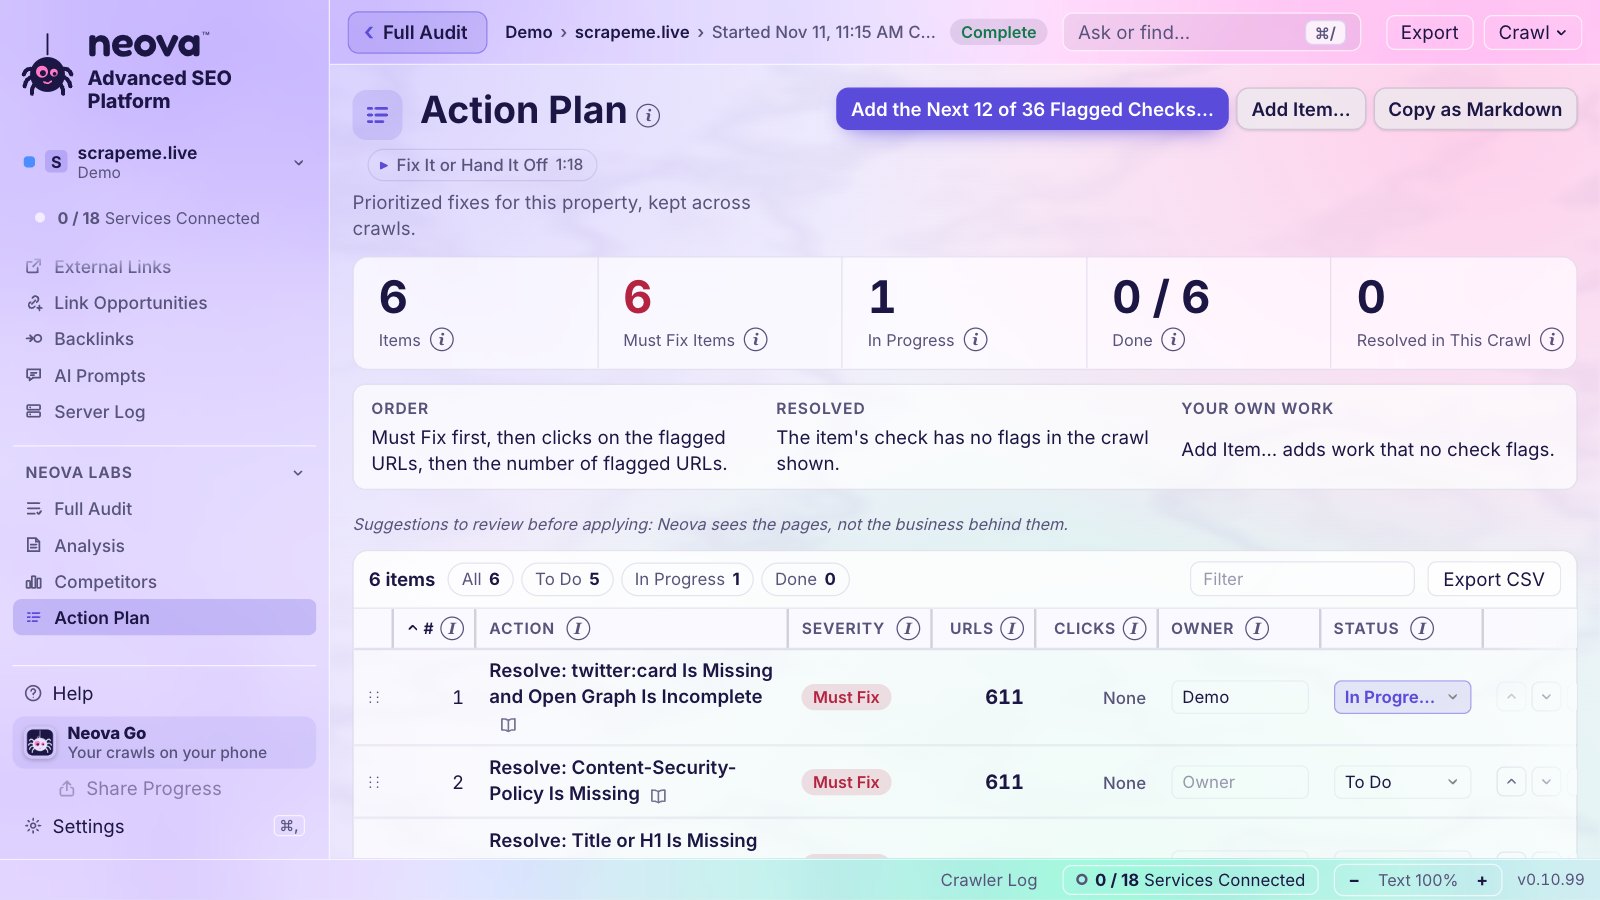
Les flags deviennent le travail : responsables, statut, À corriger en premier, conservés d'un crawl à l'autre.

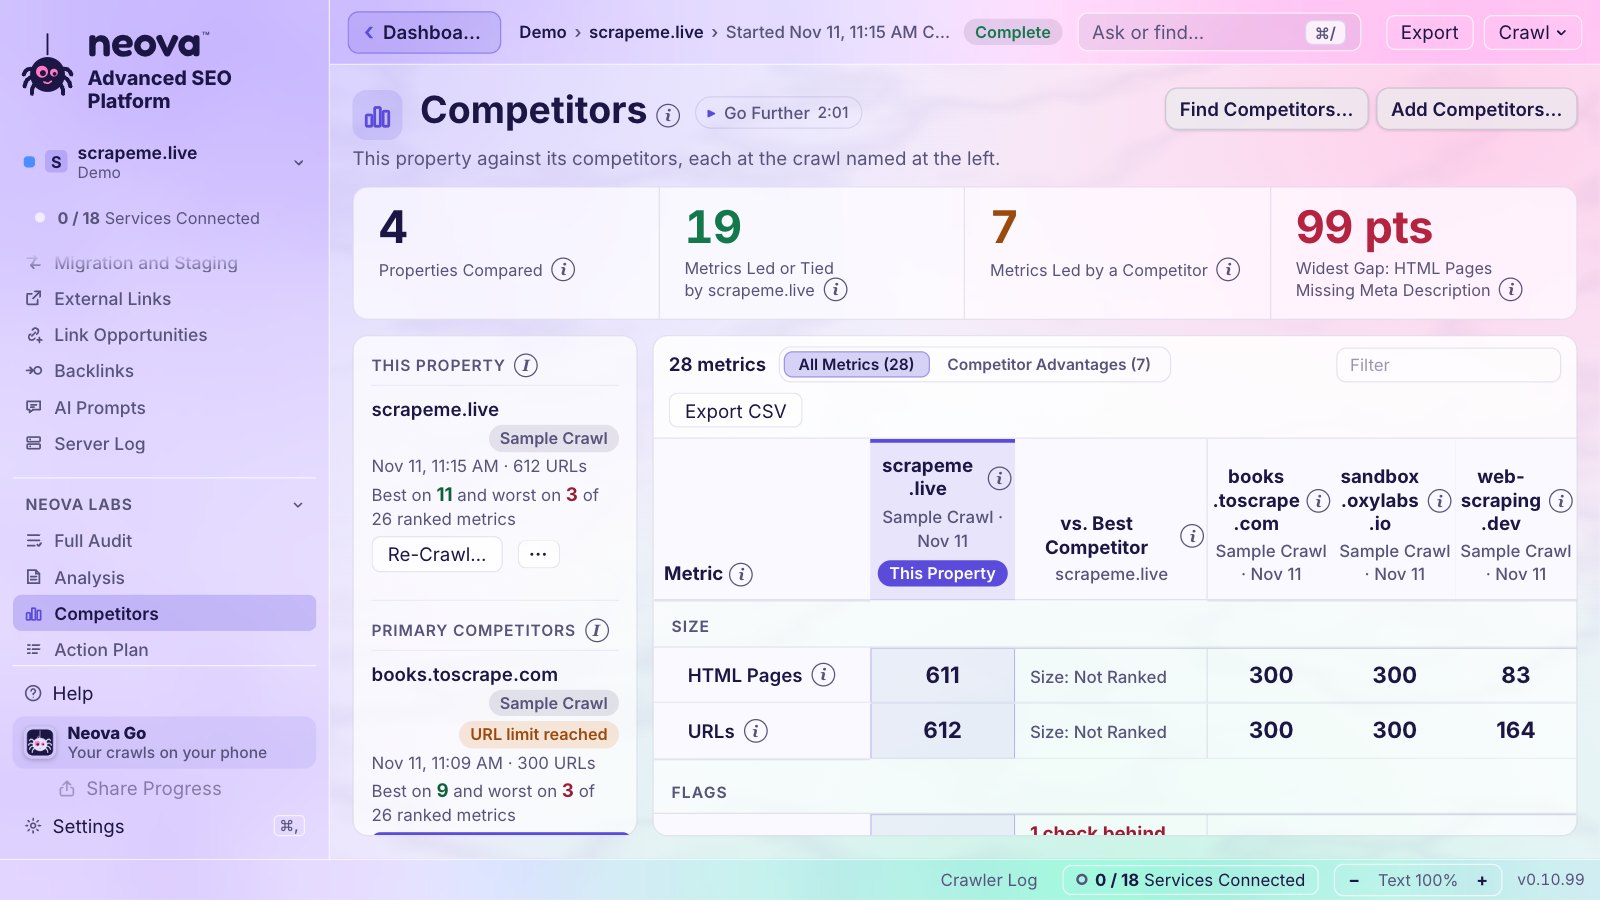
Collez une liste. Neova dimensionne chaque crawl d'après leurs sitemaps, puis montre qui mène, métrique par métrique.

Ce que vivent les vrais visiteurs sur mobile, par groupe de pages, avec une alerte quand une note change.

Ouvrez leurs exports et lancez les checks de Neova sur ce qu'ils ont trouvé. Gardez les outils que vous aimez.
Fermez la fenêtre. Le crawl continue dans la barre des menus, et votre téléphone affiche chaque propriété.

Tout ce que reçoit votre client, depuis un seul endroit, chiffré sur votre ordinateur avant tout partage de lien.
Le crawl, Google, Bing et Analytics, les Core Web Vitals, les concurrents, le plan et le PDF, en une seule exécution.

Une mascotte animée qui s'installe sur votre bureau et garde un œil sur vos crawls. Elle prend la parole quand un crawl a besoin de vous, répond à vos questions sur le crawl et vous emmène au bon écran en un clic. Facultative, et désactivée tant que vous n'en choisissez pas une.
31 services, tous facultatifs : Neova fait son travail sans aucun d'eux, et en fait plus avec eux.
Ouvrez un domaine pour voir toutes ses fonctionnalités, ou cherchez parmi toutes.
Un log en direct du crawl : chaque URL récupérée avec son code HTTP en couleur et son temps de réponse, chaque étape en gras, les échecs en rouge et les avertissements en orange ; Copier le log garde chaque ligne pour le support.
Suit les liens internes depuis une URL de départ, et les sitemaps XML quand ils sont activés, comme un moteur de recherche découvre un site.
Ne crawle que les URL que vous collez ou importez depuis un fichier, rien d'autre.
Lit le site avant le début du crawl et choisit la version (http ou https, avec ou sans www) qui répond 200, en indiquant ce que font les autres versions.
Demande s'il faut crawler les sous-domaines que Neova a trouvés, et lesquels.
Crawle le site entier sans limite d'URL, sauf si vous en fixez une.
Ne crawle que les dossiers que vous saisissez, et juge l'exhaustivité d'après les URL du sitemap XML situées sous eux.
Crawle un nombre fixé de pages dans chaque groupe de pages : un grand site est audité en quelques minutes, avec chaque template couvert.
Trois niveaux en un seul choix : Crawl seulement, Audit du site (ajoute les Core Web Vitals et un brouillon de plan d'action) et Audit complet (ajoute les concurrents, les données de recherche et l'analyse).
Ajoute des URL de départ supplémentaires, depuis un fichier TXT ou CSV ou collées, pour atteindre les pages vers lesquelles aucun lien ne mène.
Crawle les URL listées dans les sitemaps XML que déclare le robots.txt, après les pages atteintes par les liens.
Lit les sitemaps XML supplémentaires que vous indiquez, en plus de ceux que déclare le robots.txt, à chaque crawl de la propriété.
Choisit les ressources crawlées en plus des pages HTML : images, CSS, JavaScript et PDF.
Pages d'abord récupère toutes les pages HTML avant les images et les fichiers, pour que le cœur de l'audit soit fait en premier ; Par profondeur récupère d'abord les pages les plus proches de l'URL de départ.
Enregistre les liens du menu, du pied de page et des filtres sans les suivre ; les liens du contenu sont toujours suivis.
Crawle ou ignore des URL selon des motifs regex, un par ligne, avec un champ pour tester une URL contre eux.
Une seule liste d'exclusion pour tous les crawls, quel que soit celui qui les lance : la fenêtre, un planning ou un assistant IA.
Réécrit les URL avec des règles regex avant de les crawler, par exemple pour retirer les paramètres de tracking, ou pour ramener sur l'hôte de staging les liens d'un site de staging qui pointent vers le site en ligne, ainsi que les sitemaps XML du site en ligne.
Garde ou retire les query strings pendant le crawl.
Crawle les liens internes marqués rel=nofollow, quand vous le souhaitez.
Traite /Page et /page comme une seule URL.
Permet à un crawl qui démarre dans un dossier d'aller au-delà.
Limite d'URL, limite de profondeur de crawl, URL max par dossier, longueur d'URL max et paramètres de requête max, pour garder la navigation à facettes sous contrôle.
Crawle à 3 URL par seconde par défaut et divise de lui-même sa vitesse par deux quand le serveur ralentit ou répond 429 ou 503, en respectant Retry-After.
Espace chaque requête à la vitesse demandée, robots.txt et sitemaps XML compris, pour que le site ne reçoive jamais de rafale.
Une fois que vous avez confirmé que le site est à vous, monte jusqu'à 50 URL par seconde et peut ignorer le robots.txt, pour votre propre site ou un serveur de staging.
Crawle en tant que NeovaBot par défaut, ou en tant que Googlebot, Bingbot, Applebot, crawlers IA comme GPTBot et ClaudeBot, outils SEO, navigateurs ou chaîne personnalisée.
Respecte le robots.txt en ligne, l'ignore pour un site qui vous appartient, ou respecte un brouillon enregistré dans le testeur robots.txt pour voir l'effet d'une modification.
Effectue le rendu des pages HTML dans Chrome après le crawl, toutes ou quelques-unes par groupe de pages, et compare la page rendue au HTML brut ; désactivé par défaut.
Attend que le réseau se calme et que la page cesse de changer, jusqu'à une limite de stabilisation, et indique quand une page changeait encore.
Indique au-dessus des résultats qu'un crawl s'est fait sans rendu, combien de checks n'ont pas pu s'exécuter à cause de cela, et propose Recrawler avec rendu.
Récupère chaque URL avec Chrome comme un visiteur, pour les sites protégés contre les bots ; vous résolvez vous-même les CAPTCHA et Neova vous attend.
Envoie l'authentification HTTP, les cookies et des en-têtes personnalisés au seul site crawlé, pour les sites de staging et les espaces connectés.
Crée un en-tête secret pour un site que vous contrôlez, envoyé uniquement à ce site, avec la règle à transmettre à son équipe IT pour que le pare-feu laisse passer Neova.
Enregistre une configuration sous un nom pour la réutiliser sur n'importe quel site, avec ses réglages visibles d'un coup d'œil.
Donne à une propriété ses propres réglages de crawl, dont partent Nouveau crawl, Recrawler et ses plannings, avec Rétablir les valeurs par défaut.
Affiche les réglages que la plupart des gens modifient, ou tous les réglages avec une note sur le fonctionnement de chacun.
Liste chaque réglage qui diffère de la valeur par défaut avant le démarrage du crawl, chacun avec un lien Modifier.
Lit d'abord quelques pages et indique combien d'URL listent les sitemaps XML, les images et fichiers à prévoir, et l'espace disque nécessaire face à l'espace libre.
Indique, d'après les pages échantillonnées, combien d'images compte chaque page, quels paramètres portent les liens et quelles adresses sont mal écrites.
Vérifie la connexion Google de la propriété avant le démarrage d'un crawl ou d'un audit, et le met en attente avec Se reconnecter, Crawler sans ces données ou Annuler quand la connexion est rompue.
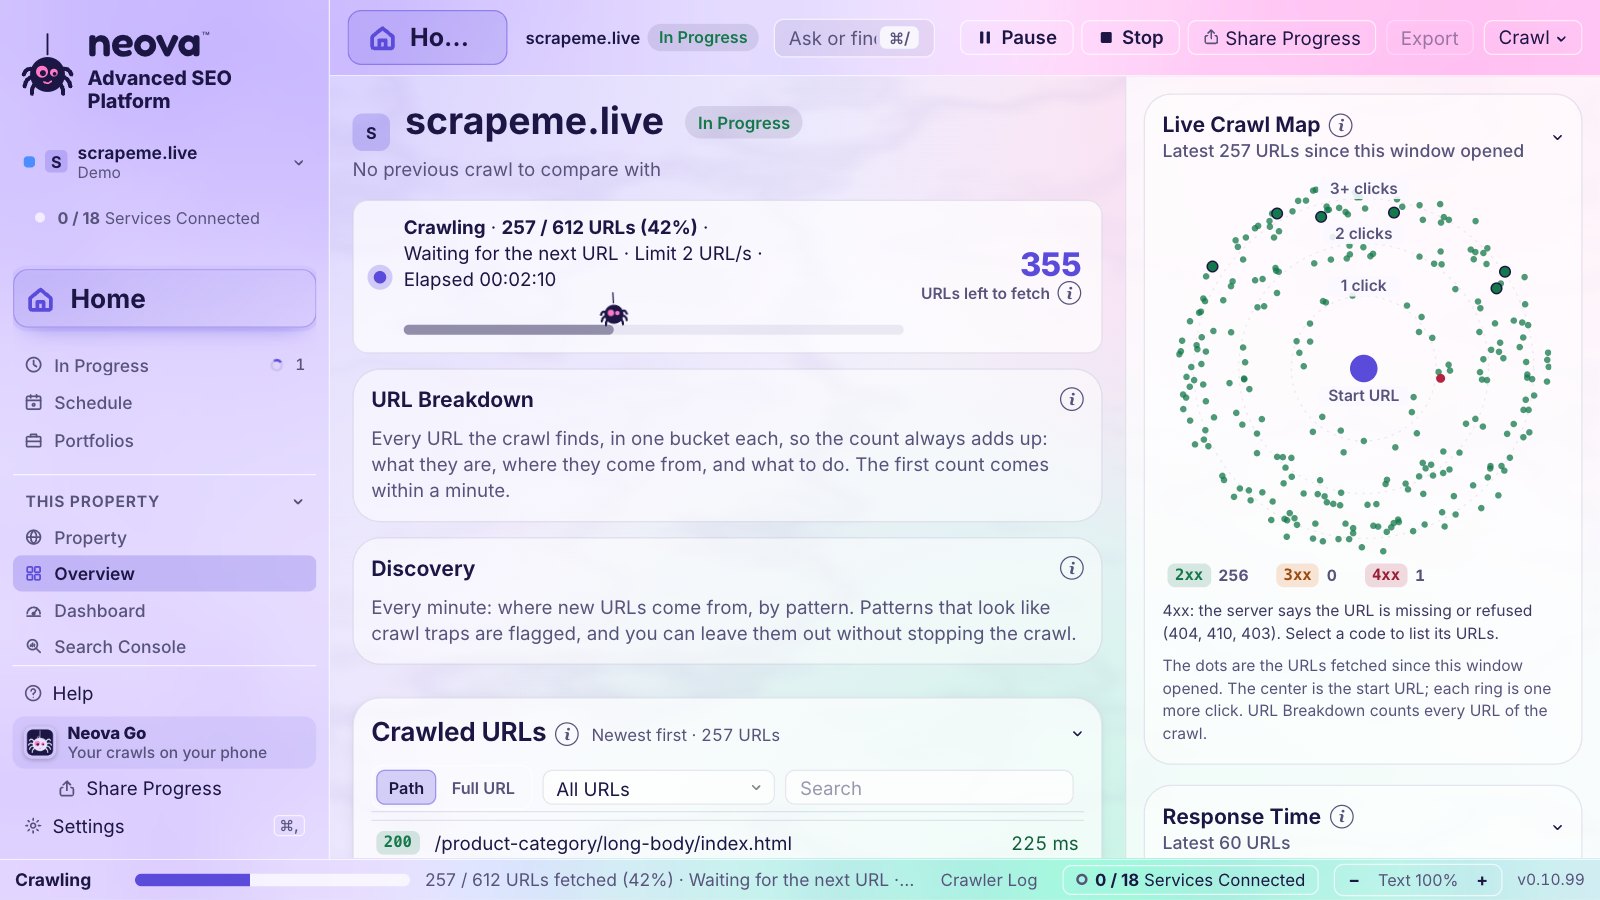
Montre le crawl pendant qu'il tourne : étapes numérotées, ce qu'il fait maintenant, les URL restantes, et chaque bloc en dessous, repliable.
Affiche les étapes par leur nom (Crawl du site web, Crawl des XML Sitemaps, Crawl des ressources, Rendu des pages, Exécution des 694 checks) avec ce que chacune a récupéré.
Indique en une ligne ce que fait le crawl à cet instant et la dernière adresse récupérée.
Trois barres sous la progression : Pages HTML, Images, et CSS, scripts et autres fichiers, chacune en récupérés sur trouvés.
Affiche les URL encore à récupérer, puis les URL encore à vérifier, en gros caractères avec une barre.
Chaque minute, indique d'où viennent les nouvelles URL par motif, signale les formes de pièges à crawl (calendriers, dossiers répétés, ID de session, nombreux paramètres, URL profondes et longues) et propose de les exclure ou de les passer sur-le-champ.
Pour chaque groupe d'URL trouvé, propose Continuer à les crawler, Passer ou Exclure, chacun avec ce qui reste dans l'audit et ce qui en sort, l'option recommandée étant marquée.
Range chaque URL trouvée par le crawl dans un seul compartiment (URL de pages propres, Variantes avec paramètres, URL mal formées, Pièges à crawl, Images, CSS, JavaScript et polices, Documents, Vidéo et audio, Autres ressources), pour que le total soit toujours expliqué.
Récupère les images des 1, 3, 5, 10, 25, 50 ou 100 premières pages de chaque groupe de pages, avec le nombre d'images et le temps que représente chaque taille, ou passe le reste, ou garde toutes les images.
Une fois toutes les pages récupérées, passe les images et fichiers restants pour que le crawl se termine comme achevé et que les checks s'exécutent.
Indique la page la plus profonde atteinte pendant le crawl, en orange dès 4 clics, avec une ligne d'alerte dès 10 clics.
Dessine les 300 dernières URL par profondeur de clic, colorées par code HTTP, avec les URL présentes seulement dans le sitemap sur leur propre anneau.
Affiche le temps de réponse médian des dernières URL sur un graphique avec les lignes à 800 ms et 1,800 ms.
Liste les URL au fur et à mesure de leur récupération, 10, 25, 50 ou 100 par page, avec des filtres 2xx, 3xx, 4xx, 5xx et Sans réponse, modifiées et nouvelles.
Compare chaque URL, dès sa récupération, au crawl antérieur le plus récent de la propriété qui a lu des pages, un Crawl du site entier en priorité, sinon un crawl Échantillon ou Dossiers spécifiques, et affiche l'ancienne valeur barrée à côté de la nouvelle.
Montre les checks en cours par catégorie, chacun avec le nombre de ses URL lues, et le nombre de flags une fois écrits.
Liste les pages de Google qui correspondent à ce que montre le crawl et les actualités de Google Search des 45 derniers jours : mises à jour du classement, blog Search Central et mises à jour de la documentation.
Propose des lectures adaptées au crawl : le Google Search Status Dashboard, ainsi que les études de cas et les mises à jour d'algorithme de SEO ProCheck.
Fige le crawl et le reprend exactement là où il en était.
Arrêter propose : Passer aux sitemaps XML, Arrêter et lancer les checks, Arrêter et supprimer ce crawl, ou Continuer le crawl ; Passer le rendu pendant le rendu.
Reprend un crawl arrêté ou interrompu avec ses propres réglages restaurés, jamais à partir de zéro.
Relance tous les checks sur ce qu'un crawl a récupéré, sans rien récupérer à nouveau, y compris sur un crawl allé jusqu'au bout, pour qu'un check amélioré dans une nouvelle version atteigne les crawls stockés ; cela tourne à côté des crawls d'autres sites.
Recrawle la propriété avec les réglages de son dernier crawl, sans toucher à ses données connectées, ses concurrents ni son plan.
Quand le site refuse le crawl, indique pourquoi (limite de débit, blocage par un pare-feu ou dans ce pays ou cette région, accès interdit) et que faire ensuite.
Une adresse qui ne peut pas être une URL, comme une phrase dans un href, n'est pas suivie et remonte en flag à la place.
Lit chaque feuille de style récupérée pour y trouver les polices, les images d'arrière-plan et les feuilles de style importées.
Liste les fichiers et images que les pages chargent depuis d'autres hôtes, sans les crawler.
Compte comme images les URL de médias de CMS sans extension d'image, comme les handlers /-/media/ de Sitecore.
Regroupe les pages par template d'après leur HTML (les mots de template du thème lui-même, sinon le squelette de la page), et par motif d'adresse sur les très grands sites.
Suit les liens rel=next et rel=prev du head en plus des liens classiques.
Met les crawls en file et démarre chacun dès qu'un emplacement de crawl se libère, jamais deux crawls d'un même site à la fois, avec Lancer la file d'attente, Vider la file d'attente et À la fin des checks.
Garde le crawl sur le disque plutôt qu'en mémoire (60 Mo de mémoire à 60,000 URL) : la taille est limitée par le disque, pas par la mémoire.
Les crawls de 4 sites au plus tournent en même temps, chacun à son rythme et avec sa limite d'URL, avec une protection mémoire qui retient un crawl quand l'ordinateur manque de mémoire ; tout crawl stocké ou toute propriété s'ouvre pendant ce temps.
Nouveau crawl remplit son formulaire avec les réglages enregistrés de la propriété (vitesse, périmètre, limite d'URL, rendu, user agent, sitemaps XML et le reste), y compris quand l'adresse du site est saisie dans URL de départ ; vos propres dernières réponses dans cette fenêtre passent toujours en premier, et rien de ce que vous avez déjà modifié n'est écrasé.
Quand cet ordinateur perd sa connexion internet, le crawl l'indique, attend et repart de lui-même une fois la connexion revenue, au lieu de s'arrêter comme si le site était en panne ; après 30 minutes hors ligne, il s'arrête et dit pourquoi.
Liste chaque page HTML avec sa balise title, sa meta description et son H1 et leurs longueurs, ainsi que les checks de contenu avec leurs flags.
Jeux de colonnes de Toutes les URL pour les titres, les meta descriptions et les H1, chacun avec des filtres manquant, vide, dupliqué, trop long et trop court.
Signale les titres, descriptions, H1 et H2 dupliqués, ainsi que le texte dupliqué ou quasi dupliqué entre pages HTML.
Signale le texte principal dans les tranches Difficile et Très difficile du score de Flesch, et les pages pauvres de moins de 200 mots.
Signale les fautes d'orthographe et de grammaire possibles dans le texte principal.
Signale les titres et H1 qui citent une année passée, et le texte qui mentionne une offre, une échéance ou une date d'événement dépassée.
Vérifie les balises qui définissent le titre, la description et l'image qu'affiche une page quand elle est partagée.
Montre comment le titre et la description d'une page apparaissent dans les résultats de recherche.
Un modèle sur votre ordinateur lit les pages HTML pour 20 checks de contenu qui demandent du jugement, comme des exemples manquants, des affirmations sans appui ou l'absence de signature d'auteur ; ses flags restent à part des niveaux À corriger et À vérifier.
Montre quels titres, meta descriptions et H1 ont changé depuis le crawl précédent, avant et après.
Barres de longueur des titres, meta descriptions et H1, groupes de pages et pages HTML les plus liées.
Exporte le contenu principal de chaque page HTML dans un fichier Markdown par page, avec un index.
Signale les H1 et H2 manquants, vides, longs et dupliqués, un premier H1 qui n'est pas le titre principal, et les pages longues sans H2.
Signale un charset, un doctype ou une balise body manquant, un favicon cassé, des éléments obsolètes et des frames qui contiennent le contenu.
Signale le Lorem Ipsum, le code de template, les valeurs de script vides et les erreurs serveur ou sorties de débogage affichées comme texte de la page.
Signale un faible ratio texte/HTML, un texte principal de moins de 200 mots et de plus de 5,000 mots.
Signale le contenu syndiqué sans noindex ni canonique vers l'original.
Signale une page À propos manquante ou non liée depuis l'ensemble du site.
Lit les entités des pages HTML clés avec votre clé Google Natural Language, pour les checks de contenu.
Le code HTTP de chaque URL, avec les mêmes couleurs partout : 2xx en vert, 3xx en orange, 4xx et 5xx en rouge, et Sans réponse nommé à part.
Où vont les redirections, combien de sauts elles font, les boucles, les redirections temporaires, les meta refresh et les redirections JavaScript, et les liens qui pointent vers elles.
Signale les URL internes avec 2 sauts de redirection ou plus, les boucles de redirection, les redirections vers elles-mêmes et les en-têtes Location manquants ou mal formés.
Signale les redirections internes 302, 303 et 307, en laissant de côté les cibles de connexion et d'identification.
Signale les redirections internes qui aboutissent sur une 4xx ou une 5xx, une URL en noindex, canonicalisée ou bloquée, ou sur un autre site web.
Signale les URL qui redirigent seulement pour ajouter un slash ou changer la casse, et les pages qui ne diffèrent que de cette façon sans canonique entre elles.
Signale les images, scripts et feuilles de style qui redirigent, et les liens externes qui redirigent ou aboutissent sur une erreur.
Jeux de colonnes pour les canoniques et pour les directives meta robots, avec des filtres Noindex et Nofollow.
Affiche les en-têtes de réponse de n'importe quelle URL.
Affiche le HTML envoyé par une URL, et le HTML rendu quand le crawl en a fait le rendu.
Indique pour chaque page HTML si elle est Rendu côté serveur, Hydraté ou Nécessite JavaScript.
Signale les titres, canoniques, liens et textes principaux qui n'apparaissent ou ne changent qu'après l'exécution du JavaScript.
Vingt checks sur les URL AMP et leurs canoniques, dont le validateur AMP.
Signale les URL longues, les underscores, les doubles slashs, les segments répétés, la ponctuation parasite et les paramètres trop nombreux.
Affiche les pages HTML par dossier et par profondeur de crawl.
Dessine le crawl sous forme d'arbre depuis l'URL de départ, chaque point coloré par code HTTP, avec une légende qui sert de filtre.
Vos propres groupes d'URL par regex, par site, chacun avec ses codes HTTP comptés, et une colonne Segment dans Toutes les URL.
Cherche un texte ou une regex dans le HTML de chaque page, ou extrait des valeurs par XPath, sélecteur CSS ou regex, et enregistre une extraction comme colonne qui se relance à chaque crawl.
Liste le type de contenu, la taille et le temps de réponse de chaque URL, avec les temps de réponse colorés à partir de 800 ms et 1,800 ms.
Récupère à nouveau seulement les URL qu'un check signale, relance tous les checks et indique combien sont corrigées.
Désactive un check ou change son niveau en À corriger ou À vérifier pour une propriété, conservé pour tous les crawls suivants.
Exclut d'un crawl des catégories entières de checks.
Un seul écran pour le rendu : combien de pages HTML sont dans le HTML, en partie dans le HTML ou nécessitent JavaScript, ce que seul JavaScript affiche, ce qui est servi à chaque crawler IA, par groupe de pages, et les pages qui ne sont pas entièrement dans le HTML.
Les onglets SEO technique et Recherche IA du tableau de bord montrent la part des pages présentes dans le HTML, les pages qui nécessitent JavaScript, celles dont le contenu principal n'apparaît qu'avec JavaScript et les crawlers IA qui reçoivent la page complète.
Si chaque page HTML peut être indexée : code HTTP, noindex, canonique, robots.txt, et HTML qui casse le head avant les balises SEO.
Indique pour chaque URL si elle est indexable ou non, et pourquoi : code 200, pas de noindex, canonique vers elle-même ou absente.
Explique en termes simples chaque ligne du fichier en ligne ou d'un brouillon, telle que Google la documente et que la RFC 9309 la définit, avec les URL crawlées que chaque règle concerne.
Montre ce que Googlebot, Bingbot et les crawlers IA peuvent récupérer selon le robots.txt, avec les URL qui sont bloquées pour chacun.
Teste un brouillon sur toutes les URL du crawl avant sa mise en ligne, en listant les URL nouvellement bloquées et nouvellement autorisées.
Indique quand le groupe propre à un crawler dans le robots.txt écarte les règles du groupe *.
Ce que listent les sitemaps XML face à ce que le crawl a trouvé : pages indexables absentes, et URL en redirection, en noindex, en erreur ou orphelines listées.
Récupère, à l'étape 2, les pages que seuls les sitemaps XML listent, et les compte à part.
Accorde au robots.txt et aux sitemaps leur propre délai sur les sites lents, et indique quand l'un d'eux n'a pas répondu.
Écrit un sitemap XML des pages indexables, à toute profondeur ou jusqu'à la profondeur 3 ou 5.
Signale les pages d'archive paginées qui renvoient 200 sans aucun élément, les chaînes rel=next cassées et la pagination canonicalisée vers la page 1.
Conserve chaque version du robots.txt et chaque sitemap XML lus par les crawls, et signale les changements de règles du robots.txt depuis le crawl précédent.
Signale le HTML qui termine le head avant les balises SEO (un noscript contenant du texte, un élément invalide, des balises head omises ou répétées), si bien que titres et canoniques sont lus dans le body.
Signale les canoniques qui bouclent, s'enchaînent, pointent vers des redirections, des URL en noindex, 4xx, 5xx, HTTP ou externes, ou qui ne sont définies que par JavaScript.
Signale les noindex, nofollow et canoniques qui diffèrent entre le HTML et l'en-tête HTTP, sont déclarés deux fois ou sont mal orthographiés.
Signale les pages qui utilisent des images, scripts ou feuilles de style interdits par le robots.txt.
Signale les variantes de casse, de slash final et d'ordre des paramètres qui renvoient le même HTML.
Signale les pages HTML qui répondent 200 avec une formule comme « introuvable » ou « aucun résultat » dans leur titre ou leur H1.
Signale le HTML de plus de 2 Mo avec des liens ou du contenu au-delà de la limite que lit Google, et les fichiers JavaScript ou CSS de plus de 2 Mo.
Signale une forte variation du nombre d'URL crawlables et les règles du robots.txt modifiées depuis le crawl précédent.
Signale les sitemaps XML de plus de 50 Mo ou de plus de 50,000 entrées, les sitemaps vides, les lignes sitemap relatives dans le robots.txt et les URL sur un autre hôte ou protocole.
Vérifie que le site héberge votre fichier de clé IndexNow, avec Créer une clé pour en générer une.
Lit le verdict de l'outil d'inspection d'URL de Google pour 200 URL au plus par crawl, et signale les pages indexables que Google n'indexe pas ou pour lesquelles Google a choisi une autre canonique.
Après un Crawl du site entier qui se termine de lui-même, envoie à IndexNow (Bing, Yandex, Seznam, Naver et Yep) les pages modifiées ou nouvelles depuis le crawl complet précédent, uniquement si le site héberge votre clé ; la fenêtre indique ce qui a été envoyé ou refusé.
Liste les pages étiquetées comme explicites (la meta rating adult, le label RTA ou un en-tête Rating) et les pages qui répondent au crawler par un contrôle d'âge, pour que vous les examiniez.
Liens cassés, liens vers des redirections, ancres, et pages que peu de liens atteignent.
Liste chaque lien vers une URL et depuis une URL, avec son ancre.
Enregistre si chaque lien se trouve dans le contenu, le menu, le pied de page ou les filtres, avec les colonnes Liens entrants du contenu et Liens entrants du menu et du pied de page.
Note chaque URL de 0 à 100 selon le poids des liens internes qu'elle reçoit, un PageRank interne calculé sur les liens suivis du crawl.
Le nombre de clics depuis l'URL de départ pour chaque URL, avec un flag dès la profondeur 4.
Signale les pages indexables qu'aucun lien interne n'atteint, trouvées par les sitemaps XML, le log serveur ou Google Search Console.
Chaque URL d'autres sites vers laquelle le site fait un lien, demandée une seule fois, avec les 4xx, 5xx et absences de réponse signalées.
Active ou désactive la requête de chaque URL externe pour un crawl ; activé par défaut.
Suggère des liens internes à partir du texte des pages HTML : les pages qui évoquent le sujet d'une autre page sans faire de lien vers elle.
Affiche URL Rating, Trust Flow, Page Authority ou Authority Score, les domaines référents et les backlinks par URL, avec votre propre clé Ahrefs, Majestic, Moz ou Semrush.
Signale les liens internes sans ancre ou avec des ancres non descriptives, et les images cliquables sans attribut alt.
Signale les pages atteintes uniquement par des liens nofollow, les liens internes sortants en nofollow et les liens d'affiliation sans sponsored ni nofollow.
Signale les href vides, mal formés ou faits d'espaces, les liens uniquement en onclick, les paramètres de tracking, les chemins de fichiers locaux, localhost et les fragments sans ID correspondant.
Signale les URL accessibles uniquement par une canonique, une redirection ou des pages en noindex, et les pages dont les liens entrants viennent d'une seule URL.
Compte dans leur propre compartiment les adresses que les liens ont mal écrites (un espace à la fin, un double slash, un caractère encodé deux fois).
Signale les pages HTML qui font un lien vers un hôte de staging, de développement ou local.
Liste chaque image que le crawl a récupérée ou qu'une page utilise, avec sa taille, son attribut alt et le nombre de pages HTML qui l'utilisent.
Signale les attributs alt manquants, trop longs, génériques et répétés, et distingue un alt manquant d'un alt décoratif.
Signale les images de plus de 100 Ko, les GIF de plus de 100 Ko et les images sans width ni height.
Avec le rendu activé, signale les images affichées avec le mauvais ratio ou une résolution trop faible pour leur taille d'affichage.
Signale les images non compressées, pas dans un format moderne, plus grandes que leur affichage, et une image LCP en lazy loading.
Signale les vidéos sans piste de sous-titres.
Permet d'échantillonner une grande médiathèque par groupe de pages au lieu de tout récupérer, avec le nombre d'images et le temps de chaque choix.
Laisse de côté les images encore en file d'attente, tandis que toutes les pages sont toujours crawlées et que les attributs alt sont toujours lus dans le HTML.
Sur les sites qui accordent des licences d'images, signale le balisage ImageObject sans informations de licence et lit un échantillon des images servies pour leurs droits IPTC et XMP, dont Google a besoin pour le badge Licensable.
Les versions de chaque page par langue et par région, et si elles pointent les unes vers les autres : liens de retour, auto-référence, x-default, codes invalides, cibles canonicalisées et en noindex.
Langues hreflang et Cibles hreflang pour chaque page HTML, avec la liste complète au survol.
Signale un html lang manquant, vide ou invalide, et les valeurs lang qui ne concordent pas avec le hreflang ou avec le texte de la page.
Signale les liens de retour manquants, les auto-références manquantes et les liens de retour qui pointent vers des URL canonicalisées.
Signale un x-default manquant dans le jeu hreflang de la page d'accueil, et une cible x-default cassée, en noindex ou canonicalisée.
Signale les cibles hreflang qui ne sont pas en 200, sont en noindex, canonicalisées, bloquées ou sans liens entrants.
Valide chaque code de langue et de pays hreflang, et signale les codes régionaux sans version de repli en langue seule.
Signale les équivalents locaux sans hreflang, et un marché cible sans hreflang sur aucune page.
Lit le hreflang dans le head HTML et dans l'en-tête HTTP Link, et signale un jeu déclaré par plus d'une méthode.
Signale une réponse qui varie selon Accept-Language d'une manière que Googlebot ne voit pas.
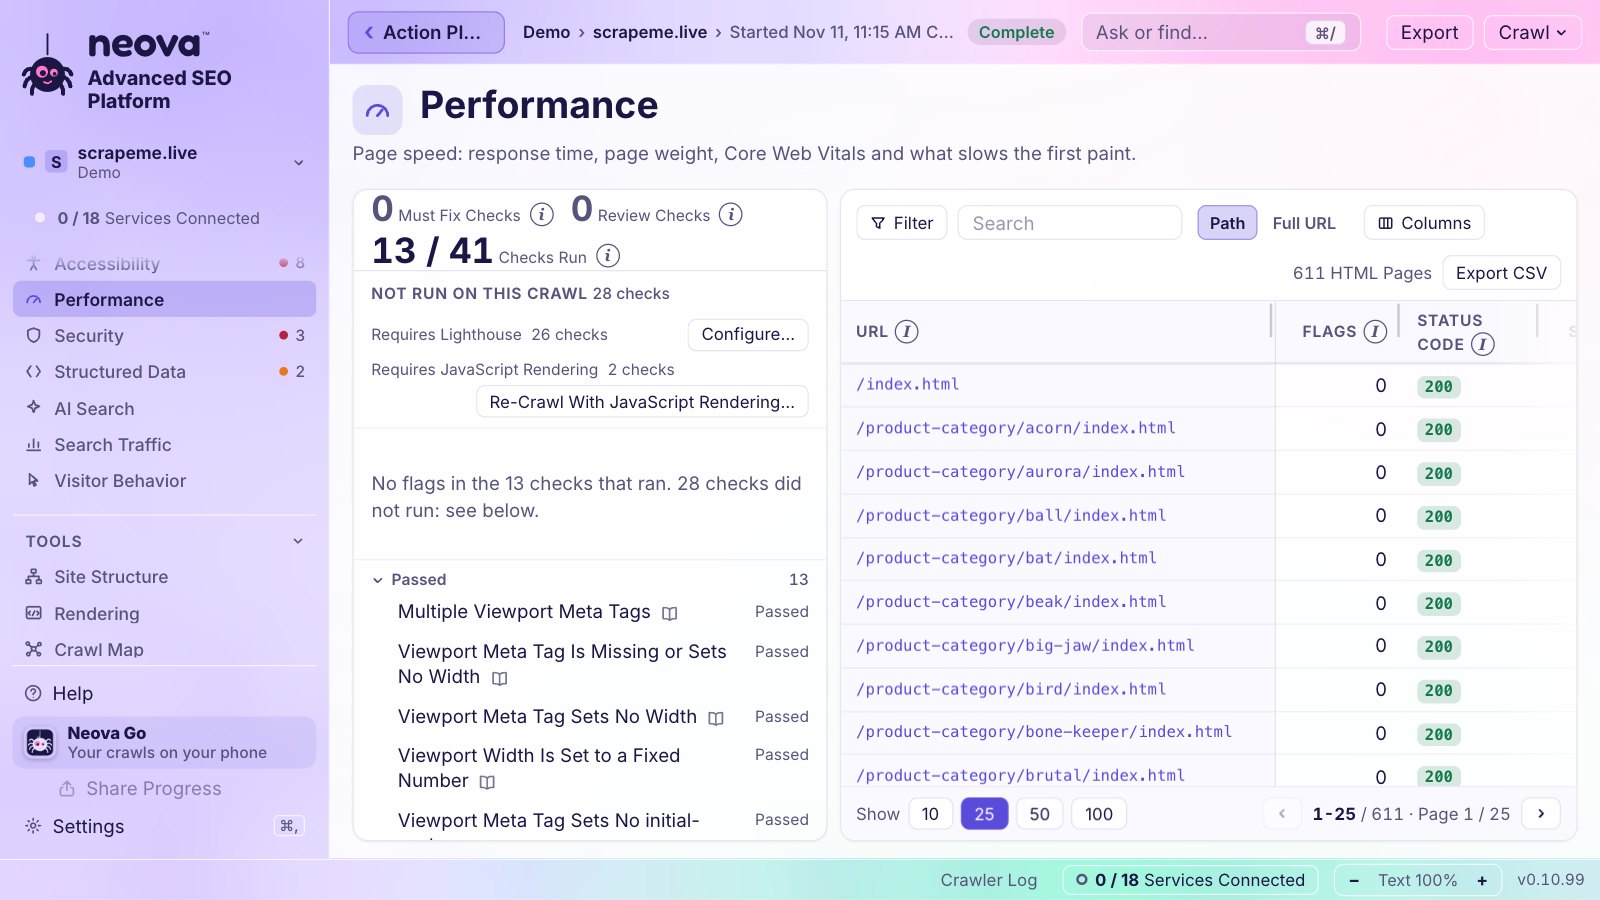
Vitesse des pages : temps de réponse, poids de page, Core Web Vitals et ce qui ralentit le premier affichage.
Lance les checks de laboratoire Lighthouse sur une page HTML par groupe de pages pendant le crawl.
LCP, INP et CLS des vrais utilisateurs de Chrome sur mobile, au 75e percentile, avec votre clé Chrome UX Report.
Trace dès le premier jour environ 40 semaines de données terrain issues de l'historique du Chrome UX Report, un point par semaine, avec les seuils Bon et Médiocre de Google.
LCP, INP et CLS des pages HTML les plus liées de chaque groupe de pages, pour qu'un template lent se repère tout seul.
Lit le Chrome UX Report pour l'origine, les URL les plus liées de chaque groupe de pages et les 10 URL les plus liées, sans crawl.
Prend l'instantané tout seul, chaque jour par défaut, ou chaque semaine ou chaque mois, même fenêtre fermée.
Déclenche une alerte quand une métrique passe à une note moins bonne ou revient à Bon, selon les seuils de Google.
Affiche côte à côte les dernières mesures, colorées en Bon, À améliorer ou Médiocre, avec leurs dates.
Définit de 0 à 3 pages HTML par groupe de pages pour chaque instantané, et indique le nombre de requêtes Chrome UX Report utilisées.
Le niveau Audit du site lit les Core Web Vitals dans le Chrome UX Report après le crawl.
Conserve chaque instantané sur votre ordinateur, au-delà des 28 jours qu'affiche le Chrome UX Report.
Signale la compression de texte désactivée, le CSS et le JavaScript non minifiés, les durées de cache courtes et les pages sans ETag ni Last-Modified.
Signale les requêtes bloquant le rendu, les longues tâches sur le thread principal, le CSS et le JavaScript inutilisés, le JavaScript obsolète, les ressources en HTTP/1.1, les tiers lents et un score Lighthouse inférieur à 50.
Signale une réponse serveur lente, un CLS supérieur à 0.1 et des Core Web Vitals hors de la plage Bon, en données de laboratoire ou de terrain.
Signale les pages dont le rendu JavaScript prend plus de 4 secondes.
Signale les viewports manquants ou fixes, le zoom bloqué et le texte de moins de 12 px CSS sur mobile.
Temps de réponse médian, à 9 sur 10 et le plus lent pendant le crawl, avec les 10 pages les plus lentes.
Ce qui empêche les personnes qui utilisent des technologies d'assistance d'utiliser chaque page : noms, libellés, ARIA, landmarks, titres, tableaux et formulaires.
Avec le rendu activé, exécute les règles axe-core et des tests en conditions de visite : contraste, focus clavier, pièges à focus, zoom à 200 %, reflow à 320 px et cibles tactiles de 24 px.
Signale les boutons, liens, champs de formulaire, images, boîtes de dialogue et frames sans nom accessible, et les champs nommés uniquement par un title.
Signale les rôles et attributs invalides, les attributs requis manquants, les rôles parents ou enfants incorrects et les rôles obsolètes.
Signale les pages sans landmark main, les landmarks dupliqués ou imbriqués, les niveaux de titre sautés et l'absence de moyen d'éviter les blocs répétés.
Signale les tableaux sans cellules d'en-tête, avec scope et headers invalides, et les listes ou listes de définitions mal construites.
Signale un indicateur de focus absent, les pièges à focus, les tabindex positifs, les boîtes de dialogue qui ne retiennent pas le focus et les zones défilantes inaccessibles au clavier.
Signale le texte au contraste insuffisant, le texte sous le contraste renforcé et les liens distingués uniquement par la couleur.
Signale le zoom désactivé, le texte coupé à 200 % de zoom, le contenu coupé à 320 px de large, l'orientation bloquée et les cibles tactiles de moins de 24 px.
Signale les vidéos sans sous-titres ni audiodescription, les vidéos muettes sans alternative et l'audio sans transcription.
Signale les champs sans libellé ou avec plusieurs libellés, les valeurs autocomplete invalides, les champs qui bloquent le collage et les erreurs sans texte.
Un modèle local lit les pages pour 7 checks qui demandent du jugement, comme des graphiques sans équivalent textuel.
Ce que les crawlers IA peuvent récupérer, ce qui leur est servi, et comment les réponses IA citent le site.
Interroge des pages échantillonnées en tant que 10 agents IA (ChatGPT, Claude, Perplexity, leurs crawlers, Meta AI, Google-Extended, Common Crawl) et montre qui obtient l'accès complet et ce qu'autorise le robots.txt.
Évalue un llms.txt publié, une version Markdown via l'en-tête Accept, les manifestes de découverte pour agents et les outils WebMCP ; un site qui n'en a pas n'est pas signalé.
Signale les pages clés qui bloquent les crawlers de recherche IA ou restreignent les extraits, et les règles IA qui diffèrent de votre politique écrite.
Signale une version Markdown vide ou qui contient moins de la moitié du texte principal.
Signale le contenu principal qui commence après les 5,000 premiers caractères du texte du body.
Signale les calques invisibles par-dessus les boutons et les champs, les commandes de tâche difficiles à voir, et les décisions non datées sur le checkout par agent pour Google UCP ou OpenAI ACP.
Signale les pages clés qui interdisent Applebot, et les fetchers IA déclenchés par l'utilisateur qui sont bloqués.
Signale la baisse des citations Bing AI et les URL clés que Bing AI ne cite jamais, d'après Bing Webmaster Tools.
Rapporte les sessions venues des IA et leur engagement face au trafic organique, d'après Google Analytics 4.
Pose jusqu'à 20 de vos prompts à ChatGPT et Perplexity via votre compte DataForSEO, et rapporte les mentions de la marque, les URL citées et les sites tiers cités à votre place.
Indique pour chaque recherche suivie si Google affiche un AI Overview et s'il vous cite, audit après audit.
Crawle avec GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot et d'autres user agents IA.
Affiche les visites et les refus vérifiés des crawlers IA par URL, d'après le log serveur.
Exécute vos propres prompts sur chaque page HTML (brouillons de meta description, idées de FAQ, intention de recherche, entités principales) avec Ollama sur votre ordinateur ou avec votre clé Anthropic, OpenAI ou Google Gemini, les réponses arrivant en colonnes.
Exécute 44 checks qui demandent du jugement, dans toutes les catégories, avec un modèle local via Ollama ; rien ne quitte l'ordinateur et ses flags restent hors des totaux.
Assistants IA servis, AI Overviews, ce qui est servi à chaque assistant IA et requêtes des bots vérifiés.
Pour chaque recherche suivie, charge 3 fois l'AI Overview de Google via DataForSEO et indique combien de ses sources se classent en première page, si votre page s'y classe et si l'Overview la cite, sous forme de flag à vérifier.
Le balisage Schema de chaque page : valide, avec avertissements ou avec erreurs, et la colonne Types Schema.
Donne un verdict pour chaque type Schema d'une URL.
Signale les pages auxquelles manque un type de données structurées ou de résultat enrichi que porte leur groupe de pages.
Signale les prix de produits absents de la page, les offres expirées, les dates qui ne concordent pas et les propriétés requises manquantes.
Signale les données structurées avec des erreurs de syntaxe, des propriétés requises ou recommandées manquantes, ou un texte qui diffère de la page.
Signale le balisage Organization ou Person sans propriétés d'identification.
Vérifie les sélecteurs Speakable, les pages payantes sans isAccessibleForFree à false, et les balisages HowTo, QAPage et FAQ par rapport à la page.
Signale les résultats enrichis invalides et les erreurs AMP ou de résultats enrichis que remonte Google.
Compare le balisage Organization avec la fiche Google Business Profile, via DataForSEO.
HTTPS, contenu mixte et en-têtes de sécurité envoyés par chaque page.
Liste les en-têtes de sécurité envoyés par chaque URL.
Signale les pages en HTTP, les redirections de HTTPS vers HTTP, les certificats invalides ou proches de l'expiration, et TLS 1.0 ou 1.1.
Signale les scripts et styles externes sans hash d'intégrité, et les formulaires ou champs de mot de passe en HTTP.
Signale l'absence de Content-Security-Policy, de Strict-Transport-Security, de nosniff, de protection contre le clickjacking ou de Cross-Origin-Opener-Policy, et une Referrer-Policy non sûre.
Signale les pages HTTPS qui chargent des ressources en HTTP ou en URL relatives au protocole, ou qui font des liens vers des pages HTTP.
Signale les en-têtes de réponse qui révèlent le serveur ou le framework, et un Content-Type qui ne correspond pas au fichier.
Signale un certificat qui ne couvre pas le nom d'hôte envoyé par SNI.
Avec le rendu activé, signale les cookies tiers et les demandes d'autorisation au chargement.
Se connecte via la page de Google elle-même dans votre navigateur, en lecture seule, et associe clics, impressions et CTR à chaque URL de chaque crawl.
Associe les visites et l'engagement aux pages du crawl pour les checks d'analytics, avec la même connexion Google.
Garde une connexion par compte Google et utilise pour chaque site le compte qui détient sa propriété.
Demande quelle propriété Google Search Console et Google Analytics 4 correspond à chaque site, en présélectionnant celle du site.
29 checks qui associent les données Google au crawl, comme les URL en noindex, redirigées ou en 4xx qui reçoivent encore des clics.
Signale les pages d'atterrissage organiques avec 10 secondes d'engagement ou moins, un taux de rebond de 80 % ou plus, des formulaires sans événement clé, et des sessions organiques sous 70 % de la normale récente.
Signale les recherches où plusieurs URL se partagent les impressions, ou celles où la page d'accueil ou une URL non indexable apparaît le plus.
Ventile les impressions et les clics par apparence dans les résultats de recherche.
Signale les ID GA ou GTM chargés deux fois et les URL indexables sans ID GA ni GTM.
Classe les checks selon les clics des URL qu'ils signalent, pour que les flags qui coûtent du trafic arrivent en premier.
Garde chaque mois de données Google Search Console sur votre ordinateur une fois que Google les supprime, au bout de 16 mois, avec Archiver maintenant et un planning mensuel.
Les clics et les impressions par jour des 28 derniers jours face aux 28 précédents, sur un graphique.
Les recherches qui apportent des clics, avec les impressions et la position.
Suit chaque jour jusqu'à 25 recherches par propriété depuis Google Search Console : position sur 7 jours et sur 90 jours, évolution, clics et impressions, avec des recherches en positions 4 à 20 suggérées.
Inspecte jusqu'à 200 URL par crawl, les plus cliquées puis les plus liées.
Les clics et les impressions de Google Discover, conservés avec chaque mois archivé.
Place les mises à jour du classement et les incidents de Google des deux dernières années sur vos clics par jour, avec les clics avant et après chacun.
Clics, requêtes, erreurs de crawl et URL indexées depuis Bing, avec votre clé API et un bouton Tester qui liste vos sites.
Classements, réponses IA, concurrents et backlinks via votre propre compte DataForSEO, payé à la requête.
La position mobile réelle de chaque recherche suivie dans le top 20, avec le meilleur concurrent à côté.
Les recherches où un concurrent se classe dans le top 20 et pas vous, avec leur volume.
Lit un service connecté après un crawl et réexécute ses checks sur ce crawl, sans recrawler.
Indique combien de services sont connectés dans la barre d'état, sous la propriété dans la barre latérale et dans un bloc du tableau de bord, chacun ouvrant Connexions.
Indique les requêtes que chaque connexion fait pour une propriété face aux quotas de Google, toutes sur votre propre clé et votre propre compte.
Chaque crawl contient les liens vers les rapports Problèmes de sécurité et Actions manuelles de Search Console pour la propriété, puisque l'API de Google ne permet pas de les lire : vous ouvrez les deux à la main.
Place la propriété à côté de ses concurrents, chacun à son dernier crawl exploitable, chaque métrique colorée selon qui mène et qui suit, avec l'écart au meilleur concurrent.
Liste les métriques où un concurrent mène, l'écart le plus large d'abord, avec les checks derrière chaque chiffre.
Accepte une liste entière collée telle quelle, les concurrents directs en principaux (5 au plus) et les indirects en secondaires, et met leurs crawls en file d'attente en une seule étape.
Lit d'abord les sitemaps XML de chaque concurrent, crawle 750 URL par défaut et propose 1,000, 2,500 ou 5,000 quand les sitemaps en listent davantage.
Trouve via DataForSEO les sites qui se classent sur les mêmes recherches, répartis en principaux et secondaires.
Ne propose jamais de boutiques, d'applis de livraison ou de marketplaces comme concurrents ; vous pouvez toujours les ajouter à la main.
Crawle un concurrent là où se trouve désormais sa page d'accueil quand il est passé sur un autre domaine.
Propose un sous-portfolio « <propriété> | Concurrents » pour les concurrents d'une propriété et le garde lié à la propriété.
Ne compte que les checks que chaque crawl comparé a pu juger, et ne classe rien face à un crawl interrompu avant la fin.
Recherches classées, top 10, visites estimées et domaines référents pour la propriété et chaque concurrent, audit après audit.
Domaines référents et backlinks de la propriété et de ses concurrents, depuis DataForSEO Backlinks.
Affiche chaque concurrent sous sa propriété, avec des barres pour les URL, les flags et les flags par URL, comparés.
Un calendrier mensuel de chaque crawl et de chaque exécution planifiée, passés et à venir, avec un filtre par propriété.
Des crawls du site entier qui se lancent seuls, chaque jour, chaque semaine, toutes les N semaines ou chaque mois, avec les réglages de la propriété et la fenêtre fermée.
Des archivages Google Search Console planifiés, mensuels par défaut.
Indique ce que coûte un crawl planifié avant de l'ajouter : URL par exécution et exécutions par mois.
Prévient 15 minutes avant le début d'un crawl planifié, et indique qu'il tourne fenêtre fermée.
Décale une exécution de 1, 3, 6 ou 9 heures ou à une date et une heure précises, ou la passe, sans que le planning perde son rythme.
Arrête proprement un crawl planifié en cours et lui donne un nouvel horaire.
Répète l'audit complet chaque mois depuis le planificateur ; Neova termine l'analyse et le PDF à sa prochaine ouverture.
Déclenche une alerte quand les Core Web Vitals changent de note, quand les clics des 7 derniers jours baissent de 20 % ou plus, quand une recherche suivie sort du top 10, y entre ou perd 3 positions, ou quand un nouveau crawl a de nouveaux flags.
Garde les 300 dernières alertes, avec Vérifier maintenant et Effacer les alertes.
Garde Neova actif quand sa fenêtre se ferme, dans la barre des menus, avec la progression du crawl à côté de l'horloge.
Garde l'icône dans le Dock ou ne laisse que l'icône de la barre des menus.
Lance Neova à l'ouverture de session, fenêtre fermée.
Une page pour téléphone, ajoutée à l'écran d'accueil par un QR code : le dernier crawl de chaque propriété, les Core Web Vitals, les clics Google Search Console, les recherches suivies, la prochaine exécution et les crawls en cours, chiffrés sur le Mac avant d'en sortir.
Le Mac envoie le résumé toutes les 2 minutes pendant un crawl et toutes les 15 sinon ; le téléphone vérifie toutes les 2 minutes et indique de quand il date.
Crée un lien pour un crawl en cours, pour que n'importe qui puisse le suivre et savoir quand il se termine, avec sa propre clé, sans rien dévoiler d'autre.
Une copie de l'écran en direct que tout le monde peut ouvrir : progression, Répartition des URL, Dernières URL, Carte du crawl en direct, Temps de réponse, Redirections et erreurs, Checks et Liens & Actualités.
La page partagée peut prévenir son lecteur quand le crawl se termine.
Chaque groupe 3xx, 4xx, 5xx et Sans réponse de tout le crawl, jusqu'à 100 URL chacun, les plus liées d'abord.
Publie les alertes et l'issue de chaque crawl dans un ou plusieurs canaux Slack via un webhook entrant, validé par un message de test.
Publie les alertes et l'issue de chaque crawl dans des canaux Teams via un webhook Workflows.
Envoie les messages de chaque portfolio ou propriété vers ses propres canaux.
Une notification système quand un crawl se termine alors que Neova n'est pas au premier plan, avec un son au choix.
Liste tout ce que Neova fait en ce moment (le crawl, un audit, Lancer les checks, un crawl planifié et la file d'attente), chacun avec le bouton qui l'ouvre.
Chaque compteur qui a une valeur précédente affiche son évolution depuis le dernier crawl comparable.
Ne récupère qu'une liste de pages, sans découverte, et déclenche des alertes de page quand le code HTTP, la cible de redirection, le title, la canonique, le noindex, le H1 ou la taille changent.
L'état du crawl d'un coup d'œil : Résumé du crawl, Principaux checks, Prochaines actions, Codes HTTP et Changements par rapport au crawl précédent, chaque chiffre ouvrant sa liste.
Chaque check avec des flags : gravité, URL signalées sur URL vérifiées, combien sont indexables, évolution depuis le crawl précédent, catégorie et clics.
Chaque check donne Signalé quand, Ce que cela signifie en général et Ce que vous pourriez faire, avec son ID, sa source et À propos de ce check, qui ouvre sa page dans la bibliothèque des checks.
Chaque URL, avec des jeux de colonnes, des filtres sur n'importe quelle colonne, des vues enregistrées, un sélecteur de colonnes, la colonne URL figée et 10, 25, 50 ou 100 lignes par page.
Chaque tableau et chaque grille exporte en CSV ce qu'il affiche.
Chaque colonne, compteur et carte a un ⓘ qui dit ce qu'il compte.
Huit groupes et 13 onglets construits à partir de 39 blocs : résumé, performance, technique, Core Web Vitals, contenu, mots-clés, recherche IA, social, concurrents, mises à jour d'algorithme, flux de travail, programme et rapports.
Jusqu'à 10 tableaux de bord à vous, créés de zéro ou dupliqués depuis un onglet, avec des blocs ajoutés, déplacés, redimensionnés et retirés.
Le plan d'action en programme, par statut et par propriétaire, le check de chaque élément avec ses flags sur le dernier crawl, en rouge quand un élément marqué Terminé est encore signalé.
Un ticket par check et par groupe de pages, À corriger d'abord, avec la règle, les preuves, les URL concernées, le critère de fin, comment vérifier et où corriger (le template quand 90 % d'un groupe est signalé).
Un crawl suivant ferme, garde ou rouvre chaque ticket selon sa clé, sans jamais en supprimer.
Commence chaque ticket par le code de la propriété, par exemple [DRH], et le transmet comme label à Jira et à Linear.
Crée un ticket Jira par ticket Neova dans votre projet Jira Cloud, avec la priorité, les labels et la liste d'URL en pièce jointe, jamais en double.
Après chaque crawl complet lancé depuis la fenêtre, passe en Terminé un ticket disparu, rouvre celui qui est revenu et met à jour les autres.
Des fichiers taillés pour l'import CSV de chaque outil : Jira, Linear, Asana, ClickUp, monday.com, Azure DevOps Boards, Notion, Airtable, Smartsheet, et le fichier de tâches Markdown de Basecamp, chacun avec sa page d'import.
Un rapport client à votre nom, avec votre logo et votre couleur : le crawl en chiffres, les flags par catégorie, quoi corriger en premier avec des exemples d'URL, le rendu et la visibilité IA, les changements depuis le crawl précédent et la façon dont le crawl a été fait, en Letter ou en A4 ; les checks d'une même famille comptent une fois, le second étant listé en Également signalé.
Donne à chaque client son nom, son logo et sa couleur sur le rapport, avec Préparé pour, Préparé par et des notes.
Un seul classeur : Résumé, Tickets par ordre de correction, Par groupe de pages, une feuille par check avec ses 1,000 URL les plus cliquées puis les plus liées, et Tous les flags.
Chaque page HTML qui a répondu 200, jusqu'à 200,000, avec title, description, H1, canonique, indexable, profondeur, liens entrants, sitemap, taille, temps de réponse, clics et flags.
Envoie le classeur dans votre Google Drive, converti en Google Sheets.
Un seul ZIP avec ce que vous choisissez : le PDF, le classeur détaillé ou abrégé, les tickets avec leurs listes d'URL, les fichiers Jira et Linear et chaque URL signalée, en un CSV par check, avec un README.
Les URL, les flags et les tickets en fichiers CSV, pour CSV, Excel (UTF-8 avec BOM), Google Sheets et Looker Studio.
Chaque export contient une note quand le crawl a tourné sans rendu ou n'a couvert qu'une partie du site.
Enregistre par défaut les exports dans Téléchargements, dans un dossier Neova exports.
Enregistre les exports dans un dossier de l'ordinateur que vous choisissez.
Envoie les fichiers, via l'interface de Google Drive elle-même, sur les comptes Google connectés à Neova, dans leur dossier Neova exports, en remplaçant un fichier du même nom pour que son lien partagé continue de fonctionner ; Neova ne voit que ses propres fichiers.
Enregistre dans les dossiers que les applis Google Drive, OneDrive, Dropbox, iCloud Drive, Proton Drive et kDrive synchronisent sur un Mac (OneDrive, Dropbox et Google Drive sous Windows), chaque compte restant désactivé tant que vous ne l'activez pas.
Envoie les exports sur votre propre serveur en SFTP avec un mot de passe ou un fichier de clé, en FTPS ou en FTP simple, testé avant d'être enregistré, la clé du serveur étant mémorisée.
Enregistre les exports de chaque portfolio ou propriété dans son propre dossier ou disque.
Dans Neova Online, écrit un export directement dans un dossier de votre ordinateur sous Chrome, Edge, Vivaldi, Brave et Arc ; les autres navigateurs le téléchargent.
Dans Neova Online, un export de dossier, comme les tableaux CSV ou les pages Markdown, se télécharge en un seul ZIP.
Un lien en lecture seule vers un portfolio ou une propriété, avec les crawls, le plan d'action, les analyses, les concurrents et les fichiers que vous cochez, chiffré sur votre ordinateur avec une clé qui ne voyage que dans le lien ; Mettre à jour garde l'adresse et Désactiver le supprime.
Quoi faire, dans l'ordre : un plan rédigé à partir du crawl (À corriger d'abord, puis les clics, puis la portée), réordonné et reformulé par vous, enrichi de vos propres éléments, avec statut, propriétaire et note, et conservé d'un crawl à l'autre.
Copie le plan en Markdown ou l'exporte en CSV.
Rédige l'audit complet sur votre ordinateur : état actuel, flags priorisés, visibilité organique, recherches suivies, keyword gaps et actions priorisées remplis, avec les sections que seule une personne peut écrire marquées À rédiger.
Conserve avec la propriété les rapports que vous ajoutez (Markdown, texte, PDF ou Word), avec Marquer comme examiné.
Ouvre un e-mail à Neova Labs avec les chiffres du crawl déjà dedans, pour les sections qu'aucun check n'écrit.
Une seule exécution de chaque étape : le crawl avec tous les checks activés, Google, Bing et Analytics, les Core Web Vitals, les concurrents et leurs crawls, les données de recherche DataForSEO, le plan d'action, l'analyse et le PDF à votre marque.
Lancer un audit complet demande s'il faut lire le dernier crawl ou recrawler, avec ses URL et le temps qu'il a pris.
Le crawl A face au crawl B : URL nouvelles, supprimées et modifiées, flags nouveaux et résolus, le crawl B coloré en mieux ou en moins bien.
Tout ce qui est conservé pour une propriété au-delà de la durée de conservation des sources : chaque crawl, chaque mois Google Search Console, chaque instantané Core Web Vitals, les versions du robots.txt, les sitemaps XML et les changements d'URL.
Chaque suggestion, ticket et rapport porte la mention qu'il est à vérifier avant d'être appliqué, puisque Neova voit les pages, pas l'activité qui se trouve derrière.
Un crawl planifié publie son issue dans Slack et Teams, et l'audit complet mensuel produit son PDF à la prochaine ouverture de Neova ; aucun fichier d'export n'est encore écrit selon un planning.
Le rapport PDF et le classeur indiquent comment les pages sont rendues (globalement, par groupe de pages et page par page), ce que le robots.txt laisse prendre à chaque crawler IA et ce que le serveur lui renvoie, et quels checks de recherche IA sont réussis ou ont signalé quelque chose.
Un Google Sheet conçu pour Sheets à partir du crawl : Vue d'ensemble avec graphiques, un plan d'action avec des listes déroulantes Propriétaire, Statut et Échéance, Problèmes, URL, Flags, Groupes de pages, Redirections & erreurs, Rendu & IA et À propos, enregistré dans votre compte Google comme nouveau fichier à chaque fois.
Chaque fichier que Neova produit à partir d'un crawl (Pack client, PDF, classeur, Google Sheet, exports, fichiers Neova) est listé avec sa destination, le crawl, la date et sa taille, avec Ouvrir, Ouvrir le dossier, Copier le chemin et Ouvrir dans Google Drive.
La même fenêtre Neova dans un navigateur sur app.neova.app, son moteur sur le serveur de Neova, qui crawle et vérifie là-bas.
Les comptes s'ouvrent depuis un lien d'invitation, nominatif ou ouvert, un lien pour un compte.
Un mot de passe stocké haché, une connexion qui dure 30 jours après votre dernière visite, une attente après 10 mots de passe erronés, les requêtes venant d'autres sites refusées, et un avertissement quand la page est ouverte dans le navigateur intégré d'une autre appli.
Les crawls, les données et les téléchargements de chaque personne dans ses propres dossiers, jamais lisibles par quelqu'un d'autre.
Une tâche à la fois par personne, 10,000 URL par crawl, 10 URL par seconde et 10 GB de crawls par compte, le temps des tests de Neova Online.
Connecte Google Search Console, Google Analytics 4 et Google Drive depuis le navigateur, la connexion étant conservée dans votre propre espace.
Les clés et les webhooks sont conservés dans votre compte Neova Online, et jamais réaffichés.
Chaque nouveau compte démarre avec une Démo : une boutique de test et trois concurrents déjà crawlés, avec les réglages du portfolio, des codes et un plan d'action, supprimable en une seule étape.
Une invitation peut apporter des portfolios copiés depuis un autre compte, avec leurs derniers crawls, leurs réglages et leurs plans, et un bandeau s'affiche pendant leur préparation.
La fenêtre s'adapte aux téléphones et aux tablettes : la barre latérale devient un tiroir, les feuilles occupent tout l'écran sur une colonne, les tableaux défilent latéralement.
Connecte une seule fois l'appli de bureau à Neova Online ; l'appli garde une clé pour cet ordinateur, jamais le mot de passe.
Garde à jour d'elle-même les portfolios, les concurrents, votre ordre, les choix Google Search Console et Google Analytics 4, les couleurs et les codes.
Quand un côté contient déjà le contenu de l'autre, la connexion fusionne tout de suite sans rien demander ; quand les deux diffèrent vraiment, elle demande d'où partir, Garder celui de Neova Online, Garder celui de ce Mac ou Tout fusionner (recommandé, rien n'est perdu), avec les comptes de chaque côté et une sauvegarde mise de côté au préalable.
Envoie ou télécharge des crawls entiers en parties reprenables, vérifiées à la fin, à côté de n'importe quel crawl en cours.
Envoie à Neova Online chaque crawl qui se termine sur cet ordinateur ; désactivé par défaut.
Neova Online affiche un déploiement dès le chargement de page suivant, jamais une ancienne fenêtre en cache.
Propose les installeurs et la vidéo tutoriel aux testeurs, en noindex.
Rapatrie sur cet ordinateur les clés de connexion que contient votre compte Neova Online, ou y envoie celles de cet ordinateur, après votre mot de passe, en n'affichant que les 4 derniers caractères de chaque clé et sans jamais remplacer une clé à moins que vous ne cochiez Remplacer.
Chaque compte Neova Online peut garder 10 GB de crawls ; Réglages indique combien le compte en contient et combien de crawls, avertit à partir de 85 %, et un envoi ou un crawl qui dépasse la place disponible est refusé, avec la marche à suivre.
Neova SEO Platform pour Mac, son moteur intégré en code natif, crawle sur votre ordinateur.
Un installeur Windows x64 pour votre propre compte, sans mot de passe administrateur ; version de test, pas encore signée.
Sous Windows, l'appli dit « ce PC » et utilise Ctrl pour chaque raccourci ⌘.
L'appli de bureau sous Linux : un .deb pour Ubuntu, Linux Mint et Debian, et une AppImage qui ne demande aucune installation.
La fenêtre et la bibliothèque des checks en anglais, français, allemand, espagnol, portugais (Brésil), italien, japonais, néerlandais, polonais, turc, coréen, chinois (simplifié), russe, indonésien et vietnamien.
Neova Marbre (par défaut), Neova, macOS, Liquid Glass, Windows 11, Linux, Terminal et Contraste élevé ; un style change les couleurs, jamais l'emplacement des éléments.
Clair, sombre ou le choix du système, avec une couleur d'accent.
Des lignes Compact ou Confortable et un texte qui s'agrandit avec ⌘+ et ⌘−.
Affiche les URL sous forme de chemin ou avec le protocole et l'hôte, dans tous les tableaux.
Écrit les dates et les heures à votre façon ou à celle de la langue.
Affiche ou masque la ligne Accueil ; le nom Neova en haut à gauche ouvre l'Accueil dans tous les cas.
⌘N Nouveau crawl, ⌘K Rechercher des propriétés, ⌘, Réglages, ⌘[ Retour, ⇧⌘P Mode présentation, ⌘/ Demander ou trouver.
Un seul champ trouve une vue, un check par son titre ou son ID, une page du crawl, une propriété ou un réglage, en gardant les choix récents.
Une question plus longue part vers un modèle sur votre ordinateur, qui choisit une réponse parmi ce que la fenêtre affiche déjà : il n'invente donc jamais un chiffre.
Floute tous les portfolios sauf celui qui est ouvert, pour partager votre écran avec un client.
Revient à l'écran précédent, dont le nom figure sur le bouton.
Un seul anneau de focus, chaque ligne accessible par Tab, les flèches dans les tableaux, les feuilles en boîtes de dialogue, et la réduction des animations respectée.
Faites glisser la barre latérale, la liste des checks et le panneau de détail à la largeur voulue.
Quitter demande une fois confirmation pendant un crawl, puis l'enregistre en affichant ses étapes et sa progression, et Reprendre le poursuit plus tard.
Nomme tout crawl planifié qui tourne en arrière-plan et propose de l'arrêter et de l'enregistrer avant de quitter.
Un crawl en cours pendant la mise à jour de Neova s'enregistre et se poursuit avec Reprendre.
Un arrêt n'ajoute que le nouveau HTML et indique chaque étape de l'enregistrement avec une barre et Fermer maintenant.
Surveille l'espace disque libre pendant un crawl, avertit quand il devient juste et s'arrête proprement sous 3 GB, pour que Reprendre poursuive une fois l'espace libéré.
Un crawl coupé par un plantage ou un pipe fermé est listé comme interrompu, jamais abandonné, et sa base est restaurée proprement.
La file d'attente et les audits continuent de tourner quand la fenêtre est masquée.
Vérifie sur app.neova.app s'il existe une version plus récente à l'ouverture de l'appli, toutes les 30 minutes et quand la fenêtre revient au premier plan, en n'envoyant que le numéro de version.
Copie les réglages de la fenêtre dans un fichier après chaque changement, une sauvegarde par version, restaurée si le stockage de la fenêtre est réinitialisé.
Change l'endroit où Neova garde ses crawls.
L'icône porte Neova SEO sous l'araignée à partir de 64 px.
Une version plus récente affiche Nouvelle version disponible en haut à gauche, dans la barre d'outils, en tête du menu Aide et dans Réglages › Général, avec Télécharger ; l'appli vérifie toutes les 30 minutes et quand la fenêtre revient au premier plan.
Chaque tableau dimensionne ses colonnes selon leur contenu, en laissant la largeur restante à l'URL et aux colonnes tronquées en premier ; chaque en-tête de colonne a une poignée à faire glisser, un double-clic ajuste, et une largeur que vous réglez est conservée.
Une mascotte animée facultative, 8 au choix (Webster, The Head, Sir Canonical, Polly Glot, Hopper, Shelly, Bo, Zap), en style mignon ou pixel art, qui surveille vos crawls ; Aucune par défaut, et avec Aucune rien n'est chargé.
Une bulle quand un crawl a besoin de vous : la fin d'un crawl avec ses checks À corriger et le nombre de nouveaux, un crawl arrêté ou en échec, un site qui bloque le crawler, un disque presque plein, un crawl planifié qui démarre ; un clic ouvre l'écran indiqué.
Un clic sur le compagnon indique ce que fait Neova et, avec un crawl ouvert, accepte une question à son sujet, traitée comme dans la barre Demander (Ollama sur votre ordinateur ou votre propre clé d'IA).
Sur le bureau, le compagnon a sa propre fenêtre au-dessus de toutes les autres et sur chaque Space, hors du Dock ; Neova continue de surveiller une fois réduit, et un clic le ramène sur le bon écran.
Sept tailles, de Minuscule (56 px) à Colossal (320 px), Grand par défaut, et une barre d'outils sous le compagnon : Ouvrir Neova, Nouveau crawl, En cours et Plus (masquer, réglages, couper la parole), au survol ou toujours.
Les crawls sont conservés dans Application Support/Neova sur Mac et dans %APPDATA%/Neova sous Windows ; rien n'est envoyé à Neova sauf si vous synchronisez ou partagez.
Chaque clé, token et connexion va dans le trousseau du système par l'entrée standard du moteur, jamais dans un fichier, une ligne de commande ou à l'écran.
L'appli ne contient aucune clé appartenant à Neova : Google, Chrome UX Report, DataForSEO et les autres utilisent votre propre clé et votre propre compte.
Le moteur est livré en code natif, sans source lisible.
Google est connecté avec des autorisations en lecture seule plus votre e-mail ; Déconnecter révoque le token chez Google.
DataForSEO reste désactivé, sauf si Nouveau crawl l'active pour ce crawl.
Avant Démarrer, estime le coût à partir de ce que DataForSEO a facturé à cet ordinateur pour ses 20 derniers appels de chaque type, ou à défaut à partir de sa grille tarifaire, arrondi aux $0.50 ou au dollar supérieurs.
Cesse d'interroger DataForSEO une fois atteint le plafond que vous fixez, de $0.50 à $10 par crawl, $1 par défaut.
Les données de recherche de l'audit complet s'arrêtent à leur propre plafond en dollars US, et l'audit indique ce qu'il a dépensé.
Les logs serveur sont lus sur votre ordinateur ; aucune adresse IP n'est écrite nulle part.
Revue IA et Demander utilisent un modèle sur votre ordinateur via Ollama, donc rien n'en sort ; Prompts IA indique quand le texte d'une page part chez un fournisseur que vous avez choisi.
Les liens de partage, Neova Go et Partager la progression sont chiffrés sur votre ordinateur, avec la clé uniquement dans le lien ou le QR code : le serveur stocke ce qu'il ne peut pas lire.
Le partage des pages du glossaire que vous ouvrez est désactivé par défaut et n'envoie qu'un ID aléatoire, le check et la langue.
Un crawl supprimé va dans la Corbeille, où il peut être remis à sa place, avec une sélection groupée des anciens crawls arrêtés.
NeovaBot dit qui il est, respecte le robots.txt et 3 URL par seconde par défaut, et ne résout jamais de CAPTCHA.
Enregistre un crawl, une propriété avec tous ses crawls et ses données, ou un portfolio dans un seul fichier .neova, avec ou sans le HTML stocké, dans Téléchargements, Google Drive, n'importe quel disque ou dossier ; les plannings, les connexions, les clés et les mots de passe n'y figurent jamais.
Installe un fichier .neova créé sur n'importe quel ordinateur Mac, Windows ou Linux, en indiquant ce qui est nouveau, déjà présent ou arrive sous un autre nom avant d'écrire quoi que ce soit, et sans jamais remplacer ce que contient cet ordinateur.
La commande neova crawle, importe, publie et lit les sites, les pages, les flags, les tickets et les alertes depuis le Terminal ou des scripts, en tableaux, en CSV ou en JSON.
neova check compare un crawl à une référence et sort avec le code 3 en cas de nouveaux flags, ou d'un flag qui dépasse une part donnée des URL.
Donne aux assistants IA un accès en lecture à vos crawls, flags, tickets et réglages via 16 outils, les données restant sur votre ordinateur.
Ajoute Neova à Claude Desktop en un clic, avec des configurations à copier pour Claude Code, Codex, Cursor, VS Code, Gemini CLI, LM Studio, Windsurf et ChatGPT.
Lance, arrête et supprime des crawls depuis un assistant, chaque lancement et chaque suppression demandant d'abord votre accord.
Lit le log d'un crawl et nomme ce qui a mal tourné (séries de 429 ou de 503, 403, blocages robots.txt, pages uniquement en JavaScript, trop peu de pages), avec le réglage à changer.
Un simple fichier JSON contient la liste d'exclusion, les valeurs par défaut, et les réglages et les interrupteurs de checks de chaque propriété.
Ouvre un export Internal de Screaming Frog (avec All Inlinks), un export d'URL de Sitebulb, le JSON de SiteOne Crawler ou n'importe quel CSV avec une colonne URL, et y exécute les checks Neova.
Note un import en récupérant à nouveau un échantillon de 50 URL à 2 URL/s et en le comparant aux sitemaps en ligne, pour qu'un import ne se fasse jamais passer pour un crawl.
L'API HTTP de Neova Online sur app.neova.app/api/v1 : lire les portfolios, les propriétés, les crawls, les flags et les tickets, lancer un crawl et gérer les tickets, chaque script avec sa propre clé Lecture seule ou Lecture et écriture, 60 requêtes par minute et par clé et 20 clés par compte.
Les requêtes des moteurs de recherche et des crawlers IA par URL du crawl, tirées du log d'accès du site lui-même.
Compte une requête pour Googlebot, Bingbot ou un crawler IA seulement quand son adresse figure sur la liste publiée par son entreprise ; un nom utilisé ailleurs est compté à part.
Liste les pages HTML que Googlebot n'a jamais visitées sur la période du log et les URL demandées par les bots que le crawl ne connaît pas.
Compte les réponses 429 et 403 reçues par chaque bot.
Lit un log combiné Apache ou Nginx, brut ou compressé en gzip.
Pour un site derrière Cloudflare, collecte les requêtes des moteurs de recherche et des crawlers IA dans votre propre compte Cloudflare et les lit avant chaque crawl, sans accès au serveur.
Rédige la demande à envoyer à l'IT : uniquement les lignes des crawlers, rien à installer, ce que l'équipe sécurité doit savoir.
Un bloc du tableau de bord pour les requêtes des bots.
Associe chaque URL du crawl de l'ancien site au crawl du nouveau site, avec un indice de confiance, pour une migration sur le même domaine ou vers un autre.
Vérifie la redirection en ligne de chaque ancienne URL par rapport au plan et signale celles qui sont fausses ou manquantes.
Compare un crawl de préproduction avec la production : code HTTP, noindex, canonique, title, meta description, H1 et URL présentes dans un seul crawl.
Inverse quel crawl est l'ancien et lequel est le nouveau, ou la préproduction et la production.
Ignore le robots.txt et va plus vite sur un site dont vous confirmez qu'il est à vous, avec l'authentification HTTP et des en-têtes personnalisés.
Crawle une liste d'anciennes URL pour vérifier où chacune aboutit.
Quand la page de départ d'un sous-domaine de préproduction pointe surtout vers le site en production, Nouveau crawl affiche les chiffres et ajoute en un clic la règle de Réécriture d'URL et les sitemaps XML du site en production ; un sitemap XML ajouté qu'aucune règle ne ramène sur le site est signalé avant le début du crawl.
Chacune de vos propriétés en bloc, dans sa couleur, avec son logo et ses chiffres clés, et ses concurrents en lignes en dessous.
Faites glisser les propriétés dans votre propre ordre, conservé sur le Mac, en ligne et sur le téléphone.
Replie une famille sur une ligne, Tout replier et Tout déplier, et une recherche épinglée accessible avec /.
Un tableau de toutes les propriétés, chaque concurrent imbriqué sous sa propriété.
Un hub par site : ses crawls, Pour le client, Core Web Vitals, Google Search Console, les concurrents, le plan d'action, l'analyse et les plannings.
Rapport à votre marque (PDF), Classeur de tous les flags (Excel) et les tickets, un bouton chacun, produits à partir du crawl ouvert.
Chaque bouton de l'en-tête de la propriété dit ce qu'il fait et en quoi il diffère de l'autre.
Regroupe les propriétés par client ou par entreprise, avec une couleur, et des sous-portfolios sur un seul niveau.
Attribue à chaque propriété une couleur et un code de 2 à 6 lettres suggéré d'après son domaine.
Trouve une propriété avec ⌘K, les épinglées et celles en cours de crawl d'abord, chaque portfolio avec ses propriétés et leurs concurrents en dessous.
Les cinq derniers crawls de la propriété, avec ce qu'il est advenu de chacun, à ouvrir en un clic.
Sélectionne des crawls par case à cocher ou avec Sélectionner les anciens crawls arrêtés ou interrompus, puis Supprimer la sélection.
Chaque ligne de liste a un bouton principal, puis ⋯ et le clic droit avec toutes les actions, Supprimer en dernier, en rouge.
La bibliothèque des checks sur app.neova.app/checks, Aide de Neova SEO Platform, Nouveautés, Signaler un problème, les raccourcis clavier et Rechercher les mises à jour.
Téléchargement, installation, votre premier crawl, Neova Online et l'app de bureau, les connexions facultatives et l'historique des versions, sur app.neova.app/help.
Les 694 checks par groupe sur app.neova.app/checks, chacun avec sa page et sa source, ouverts depuis À propos de ce check partout où un check est nommé.
Rappelle une fois que les résultats de Neova sont une analyse automatisée, fournie à titre d'information, et que c'est vous qui décidez quoi changer.
Le panneau de chaque check comporte À propos de ce check, qui ouvre la page du check dans la bibliothèque des checks, avec ce qu'il signale et sa source.
Chaque version depuis le premier build, la plus récente en premier, chaque changement marqué Nouveau, Amélioré ou Corrigé avec son heure de publication dans votre fuseau horaire ; s'ouvre d'elle-même une fois après une mise à jour. Bientôt disponible, tout en haut, liste ce qui est prévu.
Crée un seul ZIP pour le support avec les versions de l'app, le log du crawl choisi et ses petits fichiers, secrets masqués, et indique ce qu'il contient et ne contient jamais avant de le créer.
Aucune fonctionnalité ne correspond à cette recherche.
Offre Free, ou 14 jours de Desktop gratuits, sans carte. Mac, Windows et Linux. Vos crawls restent sur votre ordinateur.
Télécharger NeovaNeova Online, le même Neova dans le navigateur, est inclus dans Desktop + Online et Agency : voir les offres.