Scansiona più siti insieme e seguili dal vivo
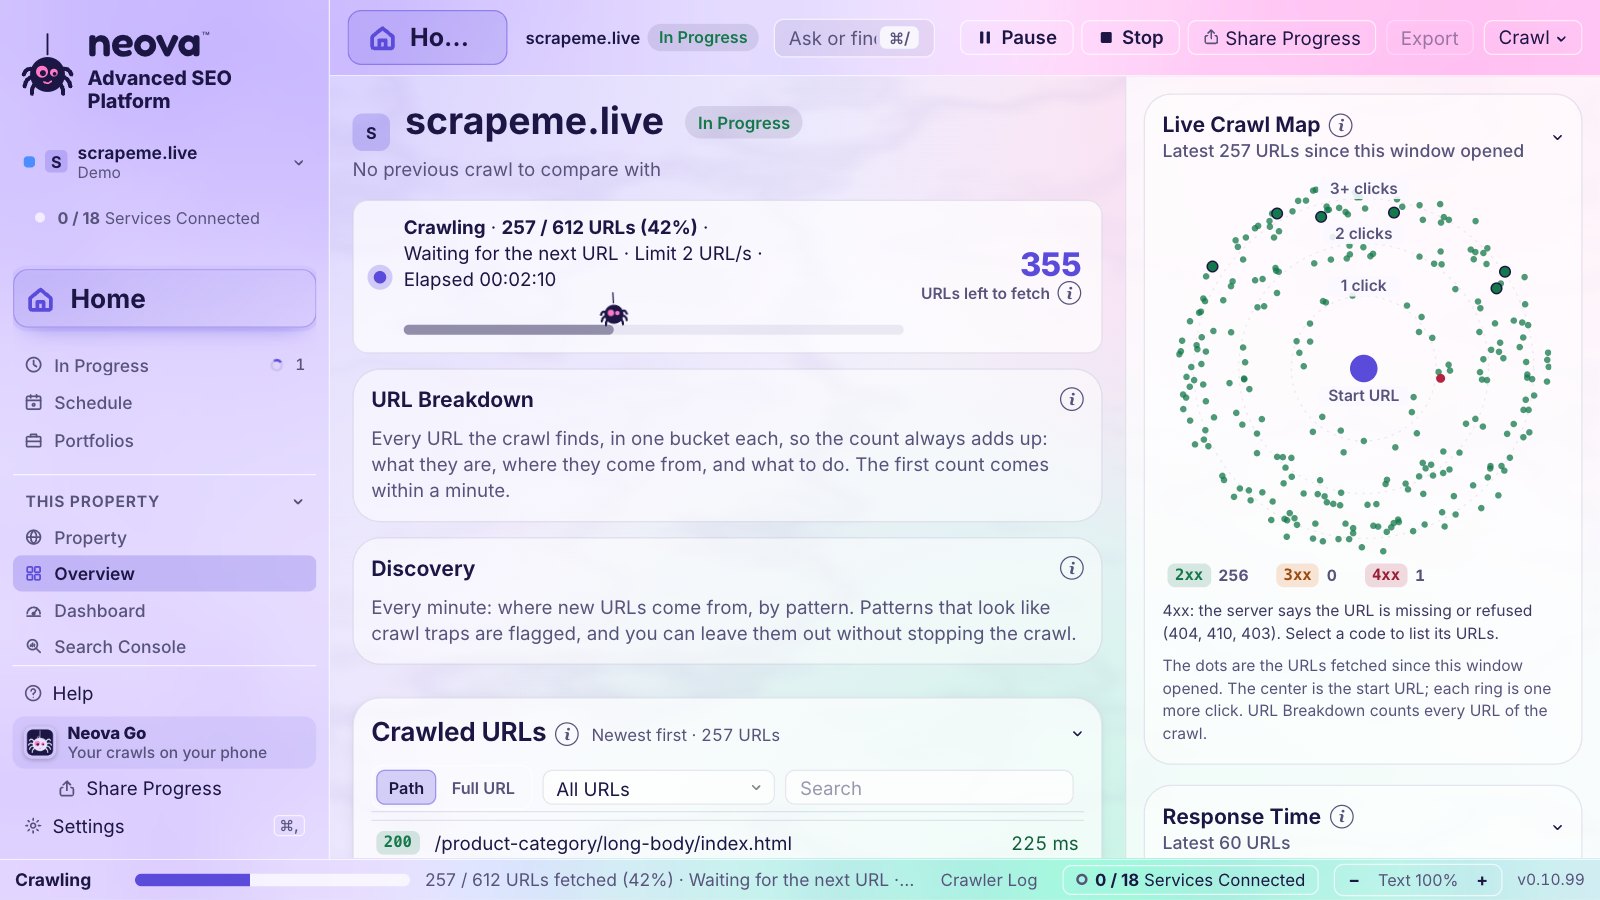
Più siti insieme, ognuno al suo ritmo, su una mappa dal vivo di ogni URL appena arriva.

Creato da SEO, per SEO. Neova scansiona dal tuo computer, poi ti dice quali segnalazioni contano, cosa correggere per prima cosa, scrive i ticket, prepara il report per il cliente e tiene d'occhio il sito. Due minuti di video, poi tutto il resto.
Il crawl è solo l'inizio. Ecco cosa ne fa Neova.
Più siti insieme, ognuno al suo ritmo, su una mappa dal vivo di ogni URL appena arriva.

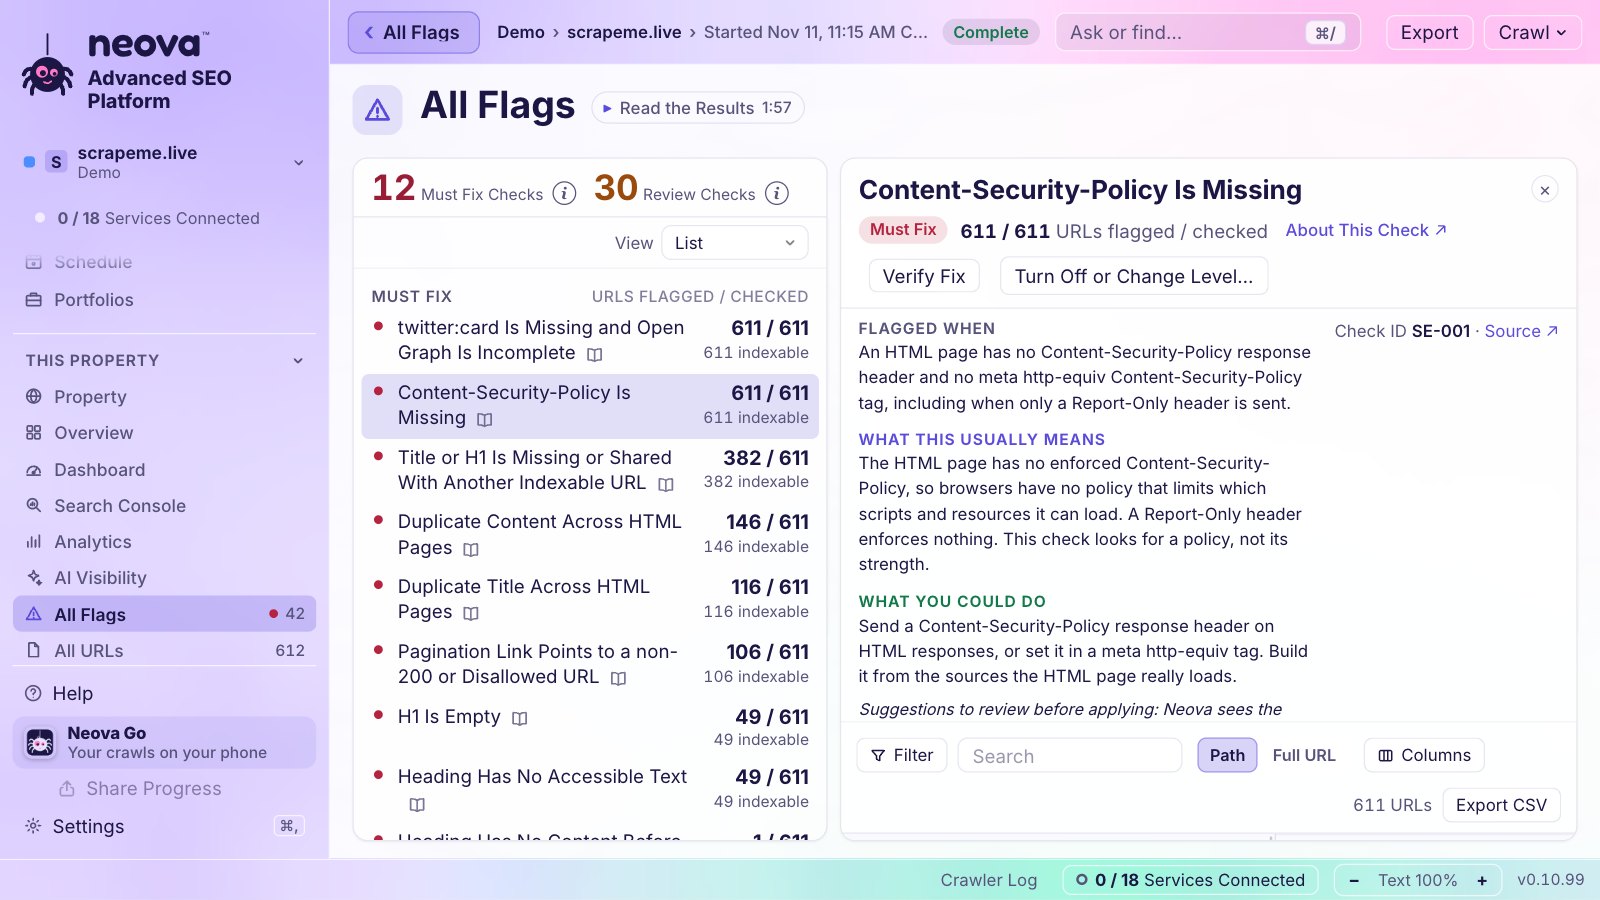
Ogni segnalazione dice perché scatta, cosa significa di solito e da dove viene la regola.

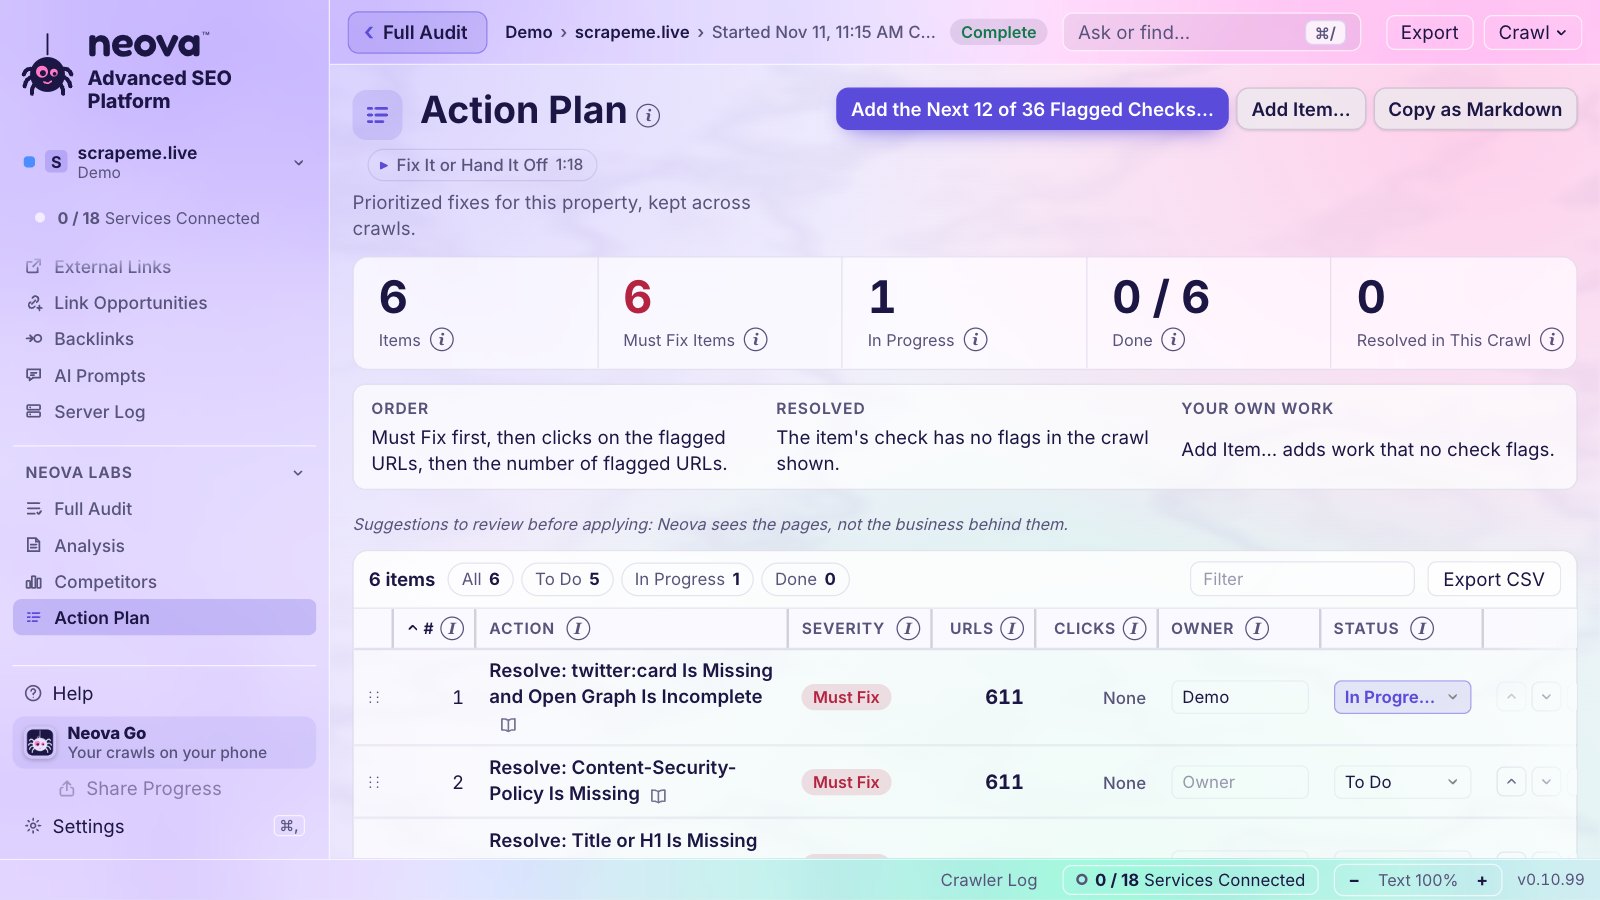
Le segnalazioni diventano lavoro: responsabili, stato, prima i Da correggere, conservate da un crawl all'altro.

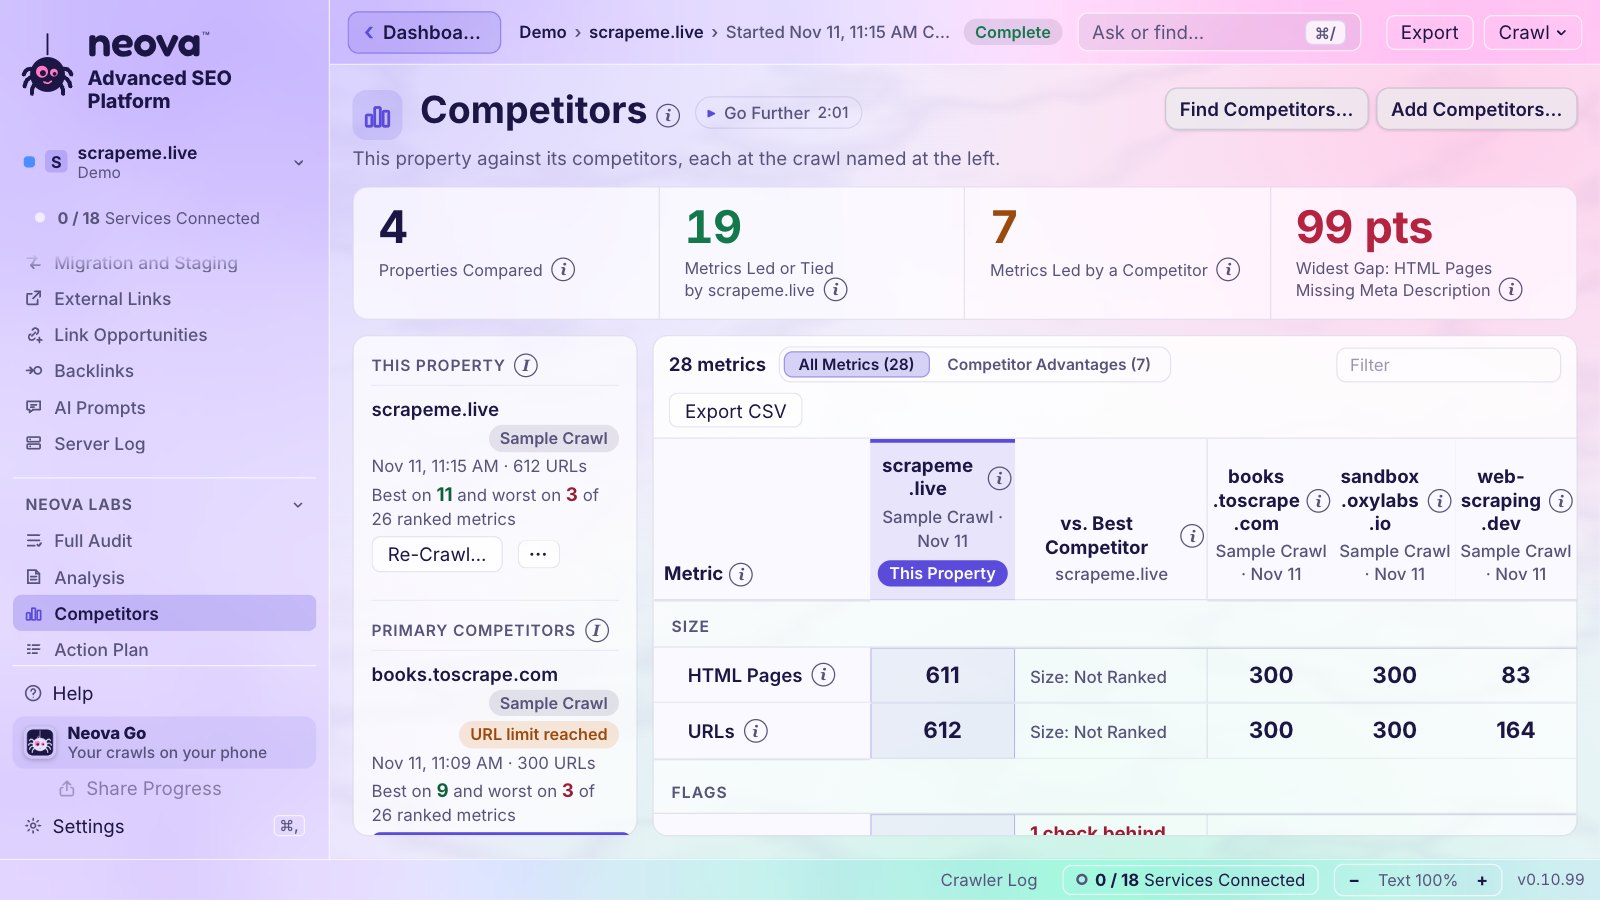
Incolla un elenco. Neova dimensiona ogni crawl dalle loro sitemap, poi mostra chi è in testa, metrica per metrica.

Cosa ricevono i visitatori reali da telefono, per gruppo di pagine, con un avviso quando un voto cambia.

Apri i loro export e lancia i controlli di Neova su ciò che hanno trovato. Tieni gli strumenti che ti piacciono.
Chiudi la finestra. Il crawl continua nella barra dei menu e il telefono mostra ogni proprietà.

Tutto ciò che riceve il tuo cliente, da un unico posto, cifrato sul tuo computer prima di condividere qualsiasi link.
Il crawl, Google, Bing e Analytics, Core Web Vitals, concorrenti, il piano e il PDF, in un'unica esecuzione.

Una mascotte animata che sta sulla tua scrivania e tiene d'occhio i tuoi crawl. Ti avvisa quando un crawl ha bisogno di te, risponde alle tue domande sul crawl e ti porta alla schermata giusta con un clic. Facoltativa, e spenta finché non ne scegli una.
31 servizi, tutti facoltativi: Neova fa il suo lavoro senza nessuno di loro, e ne fa di più con loro.
Apri un'area per vedere tutte le sue funzionalità, o cercale tutte.
Un log dal vivo del crawl: ogni URL scaricato con il suo codice di stato colorato e il tempo di risposta, ogni passo in grassetto, gli errori in rosso e gli avvisi in ambra; Copia log conserva ogni riga per l'assistenza.
Segue i link interni da un URL iniziale, e le sitemap XML quando sono attive, come un motore di ricerca scopre un sito.
Scansiona solo gli URL che incolli o carichi da un file, nient'altro.
Legge il sito prima che parta il crawl e sceglie la versione (http o https, con o senza www) che risponde 200, dicendoti cosa fanno le altre versioni.
Ti chiede se scansionare i sottodomini trovati da Neova, e quali.
Scansiona tutto il sito senza limite di URL, a meno che tu non ne imposti uno.
Scansiona solo le cartelle che scrivi, e valuta la completezza rispetto agli URL della sitemap XML al loro interno.
Scansiona un numero fisso di pagine da ogni gruppo di pagine, così un sito grande viene analizzato in pochi minuti con ogni template coperto.
Tre livelli in una sola scelta: Solo crawl, Audit del sito (aggiunge Core Web Vitals e una bozza del Piano d'azione) e Audit completo (aggiunge concorrenti, dati di ricerca e l'analisi).
Aggiunge altri URL iniziali da un file TXT o CSV, o incollati, per raggiungere le pagine a cui nessun link porta.
Scansiona gli URL elencati nelle sitemap XML dichiarate nel robots.txt, dopo le pagine raggiunte dai link.
Legge altre sitemap XML indicate da te, oltre a quelle dichiarate nel robots.txt, per ogni crawl della proprietà.
Sceglie quali risorse scansionare oltre alle pagine HTML: immagini, CSS, JavaScript e PDF.
Prima le pagine recupera tutte le pagine HTML prima di immagini e file, così il cuore dell'audit è pronto per primo; Per profondità recupera prima ciò che è più vicino all'URL iniziale.
Registra i link di menu, footer e filtri senza seguirli, mentre i link nel corpo vengono sempre seguiti.
Scansiona o salta gli URL con pattern regex, uno per riga, con un campo per testare un URL.
Una sola lista di esclusione usata da ogni crawl, chiunque lo avvii: la finestra, una pianificazione o un assistente AI.
Riscrive gli URL con regole regex prima di scansionarli, per esempio per togliere i parametri di tracciamento, o per portare sull'host di staging i link di un sito di staging verso il sito live e le sitemap XML del sito live.
Mantiene o rimuove le query string durante il crawl.
Scansiona i link interni marcati rel=nofollow, quando lo vuoi tu.
Tratta /Page e /page come un solo URL.
Permette a un crawl che parte da una cartella di andare oltre.
Limite di URL, Limite di profondità di crawl, Max URL per cartella, Lunghezza massima URL e Max parametri di query, per tenere a bada la navigazione a faccette.
Scansiona a 3 URL al secondo per impostazione predefinita e dimezza da solo la velocità quando il server rallenta o risponde 429 o 503, rispettando Retry-After.
Distanzia ogni richiesta alla velocità impostata, robots.txt e sitemap XML compresi, così il sito non riceve mai una raffica.
Dopo che confermi che il sito è tuo, arriva fino a 50 URL al secondo e può ignorare il robots.txt, per il tuo sito o un server di staging.
Scansiona come NeovaBot per impostazione predefinita, oppure come Googlebot, Bingbot, Applebot, crawler AI come GPTBot e ClaudeBot, strumenti SEO, browser o una stringa personalizzata.
Rispetta il robots.txt live, lo ignora per un sito tuo, oppure rispetta una bozza salvata nel tester robots.txt per vedere cosa farebbe una modifica.
Esegue il rendering delle pagine HTML in Chrome dopo il crawl, tutte o alcune per gruppo di pagine, e confronta la pagina renderizzata con l'HTML grezzo; disattivato per impostazione predefinita.
Aspetta che la rete si calmi e che la pagina smetta di cambiare, fino a un limite di assestamento, e dice quando una pagina stava ancora cambiando.
Indica sopra i risultati quando un crawl è stato eseguito senza rendering e quanti controlli non sono stati eseguiti per questo, e propone Scansiona di nuovo con il rendering.
Recupera ogni URL con Chrome come un visitatore, per i siti con protezione anti-bot; risolvi tu eventuali CAPTCHA e Neova ti aspetta.
Invia autenticazione HTTP, cookie e header personalizzati solo al sito scansionato, per siti di staging e aree riservate.
Crea un header segreto per un sito che controlli, inviato solo a quel sito, con la regola da passare al suo team IT perché il firewall lasci passare Neova.
Salva una configurazione con un nome per riusarla su qualsiasi sito, con le impostazioni che applica visibili a colpo d'occhio.
Dà a una proprietà le sue impostazioni di crawl, da cui partono Nuovo crawl, Riscansiona e le sue pianificazioni, con Ripristina i predefiniti.
Mostra le impostazioni che quasi tutti cambiano, oppure tutte le impostazioni con una nota su come funziona ognuna.
Elenca ogni impostazione diversa da quella predefinita prima che il crawl parta, ognuna con un link Modifica.
Legge prima alcune pagine e dice quanti URL elencano le sitemap XML, quante immagini e quanti file aspettarsi e lo spazio su disco necessario rispetto a quello libero.
Dice, dalle pagine campione, quante immagini ci sono per pagina, quali parametri portano i link e quali indirizzi sono scritti male.
Verifica la connessione Google della proprietà prima che parta un crawl o un audit e lo mette in attesa con Accedi di nuovo, Esegui il crawl senza questi dati o Annulla quando l'accesso non funziona.
Mostra il crawl mentre è in corso: le fasi numerate, cosa sta facendo, gli URL rimasti e tutti i riquadri sotto, ognuno richiudibile.
Mostra le fasi per nome (Crawl del sito web in corso, Crawl delle sitemap XML in corso, Crawl delle risorse in corso, Rendering delle pagine in corso, Esecuzione dei 694 controlli) con ciò che ognuna ha recuperato.
Dice in una riga cosa sta facendo il crawl in questo momento e l'ultimo indirizzo recuperato.
Tre barre sotto l'avanzamento: Pagine HTML, Immagini e CSS, script e altri file, ognuna con i recuperati sui trovati.
Mostra gli URL ancora da recuperare, poi gli URL ancora da controllare, in caratteri grandi con una barra.
Ogni minuto dice da dove arrivano i nuovi URL, per pattern, segnala le forme tipiche delle trappole per crawler (calendari, cartelle ripetute, ID di sessione, molti parametri, URL profondi e lunghi) e propone di escluderli o saltarli all'istante.
Per ogni gruppo di URL trovato propone Continua a scansionarli, Salta o Escludi, ognuno con cosa resta nell'audit e cosa ne esce, con l'opzione consigliata evidenziata.
Mette ogni URL trovato dal crawl in un solo contenitore (URL di pagina puliti, Varianti con parametri, URL malformati, Trappole per crawler, Immagini, CSS, JavaScript e font, Documenti, Video e audio, Altre risorse), così il conteggio è sempre spiegato.
Recupera le immagini delle prime 1, 3, 5, 10, 25, 50 o 100 pagine di ogni gruppo di pagine, con le immagini e il tempo che ogni dimensione comporta, oppure salta le altre, oppure tiene tutte le immagini.
Quando tutte le pagine sono state recuperate, salta le immagini e i file rimasti, così il crawl si chiude come completato e i controlli partono.
Durante il crawl indica la pagina più profonda trovata finora, in ambra da 4 clic, con una riga di avviso da 10 clic.
Disegna gli ultimi 300 URL per profondità di clic, colorati per codice di stato, con gli URL presenti solo nella sitemap su un anello a parte.
Mostra il tempo di risposta mediano degli ultimi URL su un grafico con le linee a 800 ms e 1,800 ms.
Elenca gli URL man mano che vengono recuperati, 10, 25, 50 o 100 per pagina, con filtri per 2xx, 3xx, 4xx, 5xx e Nessuna risposta, modificati e nuovi.
Confronta ogni URL appena recuperato con il crawl precedente più recente della proprietà che ha letto delle pagine, prima un Crawl del sito intero, altrimenti un crawl Campione o Cartelle specifiche, e mostra il valore vecchio barrato accanto a quello nuovo.
Mostra i controlli in esecuzione per categoria, ognuna con quanti dei suoi URL sono stati letti, e il numero di segnalazioni una volta scritte.
Elenca le pagine di Google che riguardano ciò che il crawl mostra e le novità della Ricerca Google degli ultimi 45 giorni: aggiornamenti del ranking, il blog di Search Central e gli aggiornamenti della documentazione.
Suggerisce letture adatte al crawl: la Google Search Status Dashboard e i casi studio e gli aggiornamenti degli algoritmi di SEO ProCheck.
Congela il crawl e lo riprende esattamente da dove era rimasto.
Ferma chiede: Passa alle sitemap XML, Ferma ed esegui i controlli, Ferma ed elimina questo crawl o Continua il crawl; Salta il rendering durante il rendering.
Riprende un crawl fermato o interrotto con le sue impostazioni ripristinate, mai da zero.
Esegue di nuovo tutti i controlli su ciò che un crawl ha recuperato, senza recuperare nulla di nuovo, anche su un crawl arrivato alla fine, così un controllo migliorato in una nuova versione arriva anche ai crawl salvati; gira in parallelo ai crawl di altri siti.
Scansiona di nuovo la proprietà con le impostazioni del suo ultimo crawl, senza toccare i dati collegati, i concorrenti e il piano.
Quando il sito rifiuta il crawl, dice perché (limite di richieste, bloccato da un firewall o in questo paese o regione, accesso vietato) e cosa fare dopo.
Un indirizzo che non può essere un URL, come una frase in un href, non viene seguito ed è riportato invece come segnalazione.
Legge ogni foglio di stile recuperato alla ricerca di font, immagini di sfondo e fogli di stile importati.
Elenca i file e le immagini che le pagine caricano da altri host, senza scansionarli.
Conta come immagini gli URL dei media del CMS senza estensione di immagine, come gli handler /-/media/ di Sitecore.
Raggruppa le pagine per template in base al loro HTML (le parole di template del tema, altrimenti lo scheletro della pagina) e, sui siti molto grandi, per pattern dell'indirizzo.
Segue i link rel=next e rel=prev nell'head oltre agli anchor.
Mette i crawl in coda e avvia ognuno appena si libera uno slot, mai due crawl dello stesso sito insieme, con Avvia la coda, Svuota la coda e Quando i controlli finiscono.
Tiene il crawl su disco invece che in memoria (60 MB di memoria a 60,000 URL), così la dimensione è limitata dal disco, non dalla memoria.
I crawl di fino a 4 siti girano contemporaneamente, ognuno al suo ritmo e con il suo limite di URL, con una protezione della memoria che trattiene un crawl quando il computer è a corto; intanto puoi aprire qualsiasi crawl salvato o proprietà.
Nuovo crawl compila il modulo con le impostazioni salvate della proprietà (velocità, ambito, limite di URL, rendering, user agent, sitemap XML e il resto), anche quando l'indirizzo del sito viene digitato in URL iniziale; le tue ultime risposte in questa finestra hanno comunque la precedenza, e nulla di ciò che hai già cambiato viene sovrascritto.
Quando questo computer perde la connessione a internet, il crawl lo dice, aspetta e riparte da solo quando torna, invece di fermarsi come se il sito fosse irraggiungibile; dopo 30 minuti offline si ferma e dice perché.
Elenca ogni pagina HTML con tag title, meta description e H1 e le loro lunghezze, e i controlli sui contenuti con le loro segnalazioni.
Set di colonne di Tutti gli URL per titoli, meta description e H1, ognuno con filtri per mancante, vuoto, duplicato, troppo lungo e troppo corto.
Segnala titoli, description, H1 e H2 duplicati, e testo duplicato o quasi duplicato tra le pagine HTML.
Segnala il testo principale nelle fasce Difficile e Molto difficile dell'indice Flesch, e le pagine povere sotto le 200 parole.
Segnala possibili errori di ortografia e grammatica nel testo principale.
Segnala tag title e H1 che citano un anno passato e testi che parlano di un'offerta, una scadenza o un evento la cui data è passata.
Controlla i tag che impostano titolo, descrizione e immagine che una pagina mostra quando viene condivisa.
Mostra come appaiono il titolo e la descrizione di una pagina nei risultati di ricerca.
Un modello sul tuo computer legge le pagine HTML per 20 controlli sui contenuti che richiedono giudizio, come esempi mancanti, affermazioni senza fonte o nessuna firma dell'autore; le sue segnalazioni restano separate da Da correggere e Da controllare.
Mostra quali tag title, meta description e H1 sono cambiati dal crawl precedente, prima e dopo.
Barre delle lunghezze di tag title, meta description e H1, gruppi di pagine e le pagine HTML più linkate.
Esporta il contenuto principale di ogni pagina HTML in un file Markdown ciascuna, con un indice.
Segnala H1 e H2 mancanti, vuoti, lunghi e duplicati, un primo H1 che non è il titolo principale e le pagine lunghe senza H2.
Segnala charset, doctype o tag body mancanti, una favicon rotta, elementi obsoleti e frame che contengono il contenuto.
Segnala Lorem Ipsum, codice di template, valori di script vuoti e output di errore del server o di debug mostrati come testo della pagina.
Segnala un rapporto testo/HTML basso, testo principale sotto le 200 parole e oltre le 5,000 parole.
Segnala i testi in syndication senza noindex né canonical verso l'originale.
Segnala una pagina Chi siamo mancante o non linkata in tutto il sito.
Legge le entità delle pagine HTML principali con la tua chiave Google Natural Language, per i controlli sui contenuti.
Il codice di stato di ogni URL, con gli stessi colori ovunque: 2xx verde, 3xx arancione, 4xx e 5xx rosso, con Nessuna risposta indicato a parte.
Dove portano i redirect, quanti passaggi fanno, loop, redirect temporanei, meta refresh e redirect JavaScript, e i link che puntano a loro.
Segnala URL interni con 2 o più passaggi di redirect, loop di redirect, redirect verso sé stessi e header Location mancanti o malformati.
Segnala i redirect interni 302, 303 e 307, lasciando stare le destinazioni di login e accesso.
Segnala i redirect interni che finiscono su un 4xx o 5xx, su un URL noindex, canonicalizzato o bloccato, o su un altro sito.
Segnala gli URL che fanno redirect solo per aggiungere uno slash o cambiare maiuscole e minuscole, e le pagine che differiscono solo così senza un canonical tra loro.
Segnala immagini, script e fogli di stile con redirect, e i link esterni che fanno redirect o finiscono su un errore.
Set di colonne per i canonical e per le direttive meta robots, con i filtri Noindex e Nofollow.
Mostra gli header di risposta di qualsiasi URL.
Mostra l'HTML inviato da un URL, e l'HTML renderizzato quando il crawl ne ha fatto il rendering.
Indica per ogni pagina HTML se è Renderizzato lato server, Idratato o Richiede JavaScript.
Segnala titoli, canonical, link e testo principale che compaiono o cambiano solo dopo l'esecuzione del JavaScript.
Venti controlli sugli URL AMP e sui loro canonical, compreso il validatore AMP.
Segnala URL lunghi, underscore, doppi slash, segmenti ripetuti, punteggiatura fuori posto e troppi parametri.
Mostra le pagine HTML per cartella e per profondità di crawl.
Disegna il crawl come un albero a partire dall'URL iniziale, ogni punto colorato per codice di stato, con una legenda che fa da filtro.
I tuoi gruppi di URL per regex, per sito, ognuno con i suoi codici di stato contati, e una colonna Segmento in Tutti gli URL.
Cerca un testo o una regex nell'HTML di ogni pagina, oppure estrae valori con XPath, selettore CSS o regex, e salva un'estrazione come colonna che si ripete a ogni crawl.
Elenca tipo di contenuto, dimensione e tempo di risposta di ogni URL, con i tempi di risposta colorati da 800 ms e 1,800 ms.
Recupera di nuovo solo gli URL segnalati da un controllo, esegue di nuovo tutti i controlli e dice quanti sono stati corretti.
Disattiva un controllo o ne cambia il livello in Da correggere o Da controllare per una proprietà, e lo mantiene in tutti i crawl successivi.
Esclude da un crawl intere categorie di controlli.
Una sola schermata per il rendering: quante pagine HTML sono nell'HTML, in parte nell'HTML o richiedono JavaScript, cosa mostra solo il JavaScript, cosa riceve ogni crawler AI, per gruppo di pagine, e le pagine non del tutto nell'HTML.
Le schede SEO tecnico e Ricerca AI della dashboard mostrano la quota di pagine nell'HTML, le pagine che richiedono JavaScript, quelle il cui contenuto principale compare solo con JavaScript e i crawler AI che ricevono la pagina completa.
Se ogni pagina HTML può essere indicizzata: codice di stato, noindex, canonical, robots.txt e HTML che rompe l'head prima dei tag SEO.
Indica per ogni URL se è Indicizzabile o no e perché: stato 200, nessun noindex, canonical verso sé stesso o assente.
Spiega in parole semplici ogni riga del file live o di una bozza, come la documenta Google e come la definisce la RFC 9309, con gli URL scansionati a cui si applica ogni regola.
Mostra cosa possono recuperare Googlebot, Bingbot e i crawler AI secondo il robots.txt, con gli URL bloccati per ognuno.
Verifica una bozza su tutti gli URL del crawl prima della pubblicazione, elencando gli URL che diventano bloccati e quelli che diventano consentiti.
Indica quando il gruppo dedicato a un crawler nel robots.txt annulla le regole del gruppo *.
Cosa elencano le sitemap XML rispetto a cosa ha trovato il crawl: pagine indicizzabili mancanti e URL elencati che fanno redirect, sono noindex, in errore o orfani.
Recupera le pagine elencate solo nelle sitemap XML, come fase 2, e le conta a parte.
Dà al robots.txt e alle sitemap un tempo tutto loro sui siti lenti e dice quando uno dei due non ha risposto.
Scrive una sitemap XML delle pagine indicizzabili, a qualsiasi profondità o fino alla profondità 3 o 5.
Segnala le pagine d'archivio paginate che rispondono 200 senza elementi, le catene rel=next interrotte e la paginazione con canonical verso la pagina 1.
Conserva ogni versione del robots.txt e ogni sitemap XML letta dai crawl, e segnala le modifiche alle regole del robots.txt dal crawl precedente.
Segnala l'HTML che chiude l'head prima dei tag SEO (un noscript con testo, un elemento non valido, tag head omessi o ripetuti), così tag title e canonical vengono letti nel body.
Segnala i canonical in loop, a catena, che puntano a redirect, pagine noindex, 4xx, 5xx, HTTP o URL esterni, o che sono impostati solo dal JavaScript.
Segnala noindex, nofollow e canonical diversi tra l'HTML e l'header HTTP, dichiarati due volte o scritti male.
Segnala le pagine che usano immagini, script o fogli di stile vietati dal robots.txt.
Segnala le varianti di maiuscole, slash finale e ordine dei parametri che restituiscono lo stesso HTML.
Segnala le pagine HTML che rispondono 200 con una frase come not found o no results found nel tag title o nell'H1.
Segnala l'HTML oltre i 2 MB con link o contenuti dopo il limite che Google legge, e i file JavaScript o CSS oltre i 2 MB.
Segnala un cambiamento netto negli URL scansionabili e le regole del robots.txt cambiate dal crawl precedente.
Segnala sitemap XML oltre i 50 MB o le 50,000 voci, sitemap vuote, righe sitemap relative nel robots.txt e URL su un altro host o protocollo.
Verifica che il sito ospiti il file della tua chiave IndexNow, con Crea una chiave per generarne una.
Legge il verdetto del Controllo URL di Google per un massimo di 200 URL a crawl e segnala le pagine indicizzabili che Google non indicizza o per cui Google ha scelto un altro canonical.
Dopo un Crawl del sito intero che si conclude da solo, invia a IndexNow (Bing, Yandex, Seznam, Naver e Yep) le pagine cambiate o nuove dal crawl completo precedente, solo se il sito ospita la tua chiave; la finestra dice cosa è stato inviato o rifiutato.
Elenca le pagine etichettate come esplicite (il meta rating adult, l'etichetta RTA o un header Rating) e le pagine che rispondono al crawler con una verifica dell'età, perché tu le controlli.
Link rotti, link verso redirect, anchor e pagine raggiunte da pochi link.
Elenca ogni link verso e da un URL con il suo anchor text.
Registra se ogni link si trova nel corpo, nel menu, nel footer o nei filtri, con le colonne Link in entrata nel corpo e Link in entrata da menu e footer.
Dà a ogni URL un punteggio da 0 a 100 in base al peso dei link interni che riceve, un PageRank interno calcolato sui link seguiti del crawl.
I clic dall'URL iniziale per ogni URL, con una segnalazione dalla profondità 4.
Segnala le pagine indicizzabili che nessun link interno raggiunge, trovate tramite le sitemap XML, il log del server o Google Search Console.
Ogni URL di altri siti linkato dal sito, ognuno richiesto una sola volta, con 4xx, 5xx e nessuna risposta riportati.
Attiva o disattiva per un crawl la richiesta di ogni URL esterno; attivo per impostazione predefinita.
Suggerisce link interni dal testo delle pagine HTML: pagine che parlano dell'argomento di un'altra pagina senza linkarla.
Mostra URL Rating, Trust Flow, Page Authority o Authority Score, domini di riferimento e backlink per URL con la tua chiave Ahrefs, Majestic, Moz o Semrush.
Segnala i link interni senza anchor text o con anchor poco descrittivi, e le immagini linkate senza alt.
Segnala le pagine raggiunte solo tramite link nofollow, i link interni in uscita con nofollow e i link di affiliazione senza sponsored o nofollow.
Segnala href vuoti, malformati o fatti di spazi, link solo onclick, parametri di tracciamento, percorsi di file locali, localhost e frammenti senza un ID corrispondente.
Segnala gli URL raggiungibili solo tramite un canonical, un redirect o pagine noindex, e le pagine con link in entrata da un solo URL.
Conta a parte, in un loro contenitore, gli indirizzi scritti male nei link (uno spazio alla fine, un doppio slash, un carattere codificato due volte).
Segnala le pagine HTML che linkano a un host di staging, di sviluppo o locale.
Elenca ogni immagine recuperata dal crawl o usata da una pagina, con dimensione, testo alt e numero di pagine HTML che la usano.
Segnala testo alt mancante, troppo lungo, segnaposto o ripetuto, e distingue un alt mancante da uno decorativo.
Segnala immagini oltre i 100 KB, GIF oltre i 100 KB e immagini senza width e height.
Con il rendering attivo, segnala le immagini mostrate con le proporzioni sbagliate o con una risoluzione troppo bassa per le loro dimensioni.
Segnala immagini non compresse, non in un formato moderno, più grandi di come vengono mostrate, e un'immagine LCP caricata in lazy loading.
Segnala i video senza traccia di sottotitoli.
Permette di campionare una grande libreria di immagini per gruppo di pagine invece di recuperarla tutta, con i conteggi e il tempo di ogni scelta.
Lascia perdere le immagini ancora in coda, mentre tutte le pagine vengono comunque scansionate e il testo alt viene comunque letto dall'HTML.
Sui siti che concedono immagini in licenza, segnala il markup ImageObject senza dettagli di licenza e legge un campione delle immagini servite per i loro diritti IPTC e XMP, che Google richiede per il badge Concedibile in licenza.
Le versioni per lingua e regione di ogni pagina e se puntano l'una all'altra: link di ritorno, autoreferenza, x-default, codici non validi, destinazioni canonicalizzate e noindex.
Lingue hreflang e Destinazioni hreflang per ogni pagina HTML, con l'elenco completo al passaggio del mouse.
Segnala un html lang mancante, vuoto o non valido, e valori lang in disaccordo con hreflang o con il testo stesso della pagina.
Segnala link di ritorno mancanti, autoreferenze mancanti e link di ritorno che puntano a URL canonicalizzati.
Segnala un x-default mancante nel set della home page e una destinazione x-default rotta, noindex o canonicalizzata.
Segnala le destinazioni hreflang che non rispondono 200, sono noindex, canonicalizzate, bloccate o senza link in entrata.
Convalida ogni codice di lingua e di paese hreflang e segnala i codici regionali senza un fallback solo lingua.
Segnala gli equivalenti locali senza hreflang e un mercato di destinazione senza hreflang su nessuna pagina.
Legge gli hreflang dall'head HTML e dall'header HTTP Link, e segnala un set dichiarato con più di un metodo.
Segnala una risposta che varia in base ad Accept-Language in un modo che Googlebot non vede.
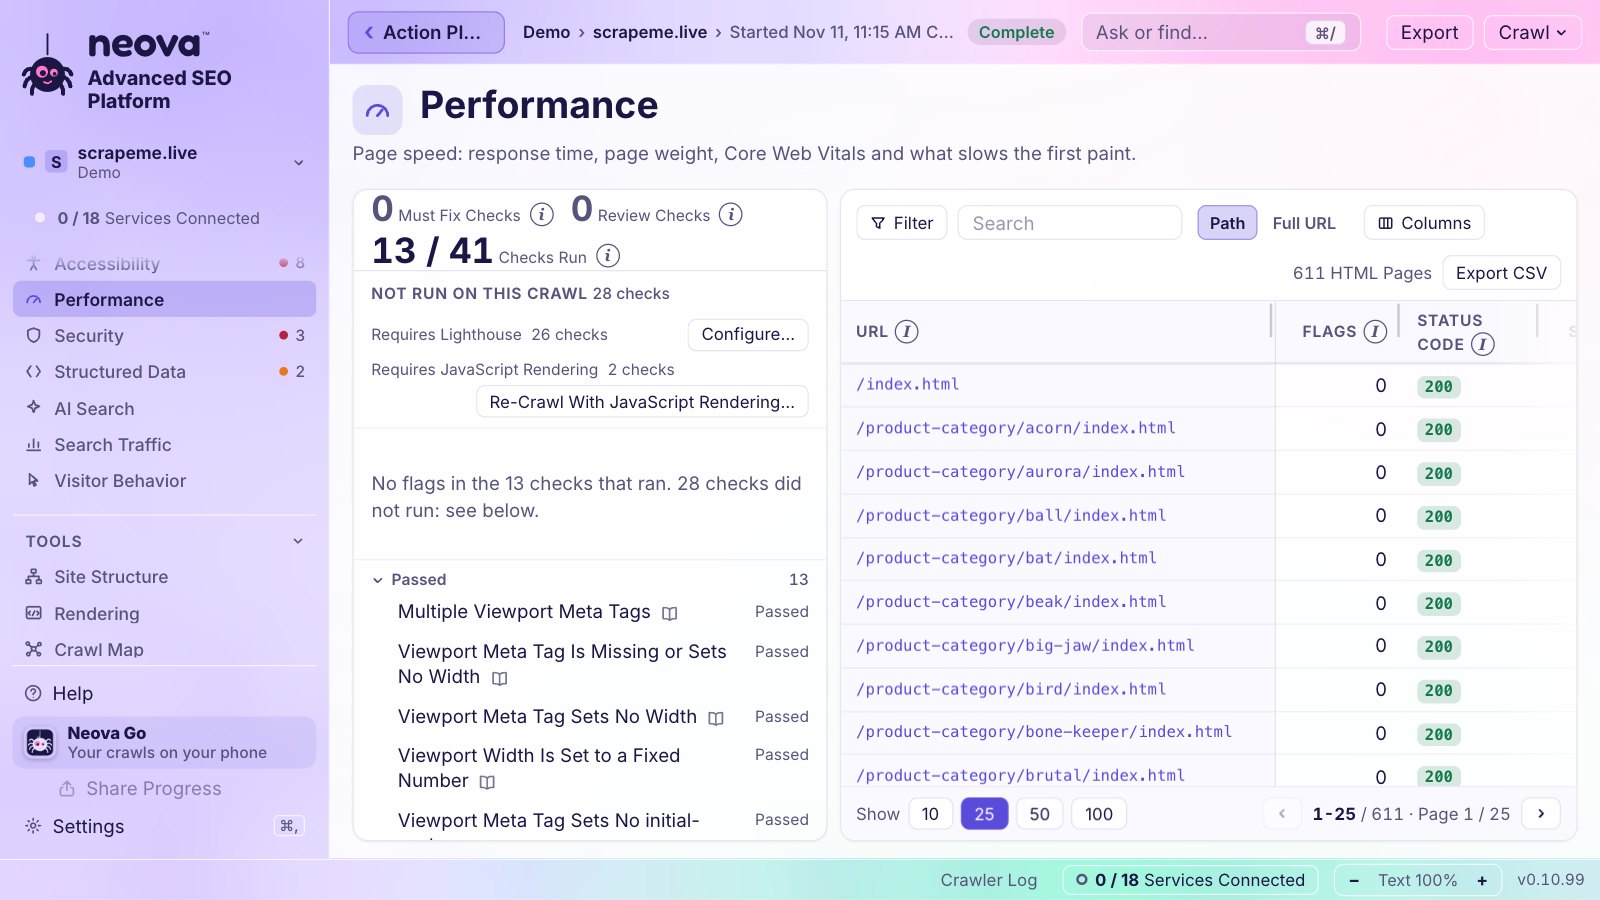
Velocità delle pagine: tempo di risposta, peso della pagina, Core Web Vitals e cosa rallenta la prima visualizzazione.
Esegue i controlli di laboratorio Lighthouse su una pagina HTML per gruppo di pagine durante il crawl.
LCP, INP e CLS degli utenti reali di Chrome da smartphone, al 75° percentile, con la tua chiave Chrome UX Report.
Disegna fin dal primo giorno circa 40 settimane di dati sul campo dalla cronologia del Chrome UX Report, un punto a settimana, con le soglie buono e scarso di Google.
LCP, INP e CLS delle pagine HTML più linkate di ogni gruppo di pagine, così un template lento si fa notare.
Legge il Chrome UX Report per l'origine, gli URL più linkati di ogni gruppo di pagine e i 10 URL più linkati, senza un crawl.
Scatta l'istantanea da solo, ogni giorno per impostazione predefinita, oppure ogni settimana o ogni mese, anche con la finestra chiusa.
Genera un avviso quando una metrica peggiora di livello o torna a Buono, secondo le soglie di Google.
Mostra le ultime rilevazioni affiancate, colorate Buono, Da migliorare o Scarso, con le loro date.
Imposta da 0 a 3 pagine HTML per gruppo di pagine per ogni istantanea e indica le richieste al Chrome UX Report che consuma.
Il livello Audit del sito legge i Core Web Vitals dal Chrome UX Report dopo il crawl.
Conserva ogni istantanea sul tuo computer, oltre i 28 giorni che mostra il Chrome UX Report.
Segnala compressione del testo disattivata, CSS e JavaScript non minificati, durate della cache brevi e pagine senza ETag o Last-Modified.
Segnala richieste che bloccano il rendering, lavoro lungo sul thread principale, CSS e JavaScript inutilizzati, JavaScript legacy, risorse HTTP/1.1, terze parti lente e un punteggio Lighthouse sotto 50.
Segnala una risposta lenta del server, un CLS oltre 0.1 e Core Web Vitals fuori dalla fascia buona, nei dati di laboratorio o sul campo.
Segnala le pagine il cui rendering JavaScript richiede più di 4 secondi.
Segnala viewport mancanti o fissi, blocchi dello zoom e testo sotto i 12 px CSS sugli smartphone.
Tempi di risposta mediano, al 90° percentile e più lento mentre il crawl è in corso, con le 10 pagine più lente.
Ciò che impedisce a chi usa tecnologie assistive di usare ogni pagina: nomi, etichette, ARIA, landmark, heading, tabelle e moduli.
Con il rendering attivo, esegue le regole axe-core e prove da visitatore: contrasto, focus da tastiera, trappole del focus, zoom al 200%, reflow a 320 px e target touch da 24 px.
Segnala pulsanti, link, campi dei moduli, immagini, finestre di dialogo e frame senza nome accessibile, e i campi indicati solo da un title.
Segnala ruoli e attributi non validi, attributi obbligatori mancanti, ruoli padre o figlio sbagliati e ruoli deprecati.
Segnala pagine senza landmark main, landmark duplicati o annidati, livelli di heading saltati e nessun modo per saltare i blocchi ripetuti.
Segnala tabelle senza celle di intestazione, scope e headers non validi, ed elenchi o elenchi di definizioni costruiti male.
Segnala un indicatore di focus mancante, trappole del focus, tabindex positivi, finestre di dialogo che non trattengono il focus e aree scorrevoli senza accesso da tastiera.
Segnala testo con contrasto insufficiente, testo sotto il contrasto avanzato e link distinguibili solo dal colore.
Segnala zoom disattivato, testo tagliato con lo zoom al 200%, contenuto tagliato a 320 px di larghezza, blocchi dell'orientamento e target touch sotto i 24 px.
Segnala video senza sottotitoli o audiodescrizione, video muti senza alternativa e audio senza trascrizione.
Segnala campi senza etichetta o con più etichette, valori di autocomplete non validi, campi che bloccano l'incolla ed errori senza testo.
Un modello locale legge le pagine per 7 controlli che richiedono giudizio, come grafici senza un equivalente testuale.
Cosa possono recuperare i crawler AI, cosa ricevono e come le risposte AI citano il sito.
Richiede pagine campione come 10 agenti AI (ChatGPT, Claude, Perplexity, i loro crawler, Meta AI, Google-Extended, Common Crawl) e mostra chi ottiene l'accesso completo e cosa consente il robots.txt.
Valuta un llms.txt pubblicato, una versione Markdown tramite l'header Accept, i manifest di scoperta per agenti e gli strumenti WebMCP; un sito che non li ha non viene segnalato.
Segnala le pagine chiave che bloccano i crawler della ricerca AI o limitano gli snippet, e le regole AI diverse dalla tua policy scritta.
Segnala una versione Markdown vuota o con meno di metà del testo principale.
Segnala il contenuto principale che inizia dopo i primi 5,000 caratteri del testo del body.
Segnala overlay invisibili sopra pulsanti e campi, controlli delle attività difficili da vedere e decisioni di checkout per agenti senza data per Google UCP o OpenAI ACP.
Segnala le pagine chiave che vietano Applebot e i fetcher AI avviati dagli utenti bloccati.
Segnala il calo delle citazioni in Bing AI e gli URL chiave che Bing AI non cita mai, da Bing Webmaster Tools.
Riporta le sessioni provenienti da AI e il loro engagement rispetto all'organico, da Google Analytics 4.
Pone fino a 20 dei tuoi prompt a ChatGPT e Perplexity tramite il tuo account DataForSEO e riporta le menzioni del brand, gli URL citati e i siti di terzi citati al posto tuo.
Indica per ogni ricerca monitorata se Google mostra un'AI Overview e se ti cita, audit dopo audit.
Scansiona con GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot e altri user agent AI.
Mostra per URL le visite verificate dei crawler AI e i rifiuti, dal log del server.
Esegue i tuoi prompt su ogni pagina HTML (bozze di meta description, idee per le FAQ, intento di ricerca, entità principali) con Ollama sul tuo computer o con la tua chiave Anthropic, OpenAI o Google Gemini, con le risposte come colonne.
Esegue 44 controlli che richiedono giudizio in tutte le categorie con un modello locale tramite Ollama; nulla lascia il computer e le sue segnalazioni restano fuori dai conteggi.
Assistenti AI serviti, AI Overviews, cosa riceve ogni assistente AI e richieste dei bot verificati.
Per ogni ricerca monitorata, carica l'AI Overview di Google 3 volte tramite DataForSEO e riporta quante delle sue fonti si posizionano in prima pagina, se la tua pagina è lì e se l'Overview la cita, come segnalazione Da controllare.
Il markup Schema di ogni pagina: valido, con avvisi o con errori, e la colonna Tipi Schema.
Dà un verdetto per ogni tipo Schema su un URL.
Segnala le pagine a cui manca un tipo di dati strutturati o di risultato multimediale presente nel loro gruppo di pagine.
Segnala prezzi dei prodotti non mostrati nella pagina, offerte scadute, date che non coincidono e proprietà obbligatorie mancanti.
Segnala dati strutturati con errori di sintassi, proprietà obbligatorie o consigliate mancanti, o testo diverso da quello della pagina.
Segnala il markup Organization o Person privo di proprietà identificative.
Controlla i selettori Speakable, le pagine a pagamento senza isAccessibleForFree false, e il markup HowTo, QAPage e FAQ rispetto alla pagina.
Segnala risultati multimediali non validi ed errori AMP o dei risultati multimediali riportati da Google.
Confronta il markup Organization con il Profilo dell'attività su Google, tramite DataForSEO.
HTTPS, mixed content e gli header di sicurezza che ogni pagina invia.
Elenca gli header di sicurezza inviati da ogni URL.
Segnala pagine HTTP, redirect da HTTPS a HTTP, certificati non validi o vicini alla scadenza, e TLS 1.0 o 1.1.
Segnala script e stili esterni senza hash di integrità, e moduli o campi password su HTTP.
Segnala l'assenza di Content-Security-Policy, Strict-Transport-Security, nosniff, protezione dal clickjacking o Cross-Origin-Opener-Policy, e una Referrer-Policy non sicura.
Segnala le pagine HTTPS che caricano risorse HTTP o protocol-relative o che linkano a pagine HTTP.
Segnala gli header di risposta che rivelano il server o il framework, e un Content-Type che non corrisponde al file.
Segnala un certificato che non copre l'hostname inviato tramite SNI.
Con il rendering attivo, segnala i cookie di terze parti e le richieste di autorizzazione al caricamento.
Accede dalla pagina di Google nel tuo browser, in sola lettura, e associa clic, impressioni e CTR a ogni URL di ogni crawl.
Associa visite e coinvolgimento alle pagine del crawl per i controlli di analytics, collegato con lo stesso accesso Google.
Conserva un accesso per ogni account Google e usa per ogni sito l'account della sua proprietà.
Chiede quale proprietà di Google Search Console e di Google Analytics 4 appartiene a ogni sito, preselezionando quella del sito.
29 controlli che associano i dati di Google al crawl, per esempio URL noindex, in redirect o 4xx che ricevono ancora clic.
Segnala le landing page organiche con 10 secondi di coinvolgimento o meno, una frequenza di rimbalzo dell'80% o più, moduli senza eventi chiave e sessioni organiche sotto il 70% della norma recente.
Segnala le ricerche in cui più URL si dividono le impressioni, o in cui compare soprattutto la home page o un URL non indicizzabile.
Riporta impressioni e clic per aspetto nella ricerca.
Segnala gli ID GA o GTM caricati due volte e gli URL indicizzabili senza un ID GA o GTM.
Ordina i controlli per i clic degli URL che segnalano, così le segnalazioni che costano traffico vengono per prime.
Conserva sul tuo computer ogni mese di dati di Google Search Console anche dopo che Google li cancella a 16 mesi, con Archivia ora e una pianificazione mensile.
Clic e impressioni al giorno degli ultimi 28 giorni rispetto ai 28 precedenti, su un grafico.
Le ricerche che portano clic, con impressioni e posizione.
Monitora ogni giorno fino a 25 ricerche per proprietà da Google Search Console: posizione su 7 e su 90 giorni, variazione, clic e impressioni, con suggerite le ricerche dalla posizione 4 alla 20.
Controlla fino a 200 URL per crawl, prima i più cliccati, poi i più linkati.
Clic e impressioni da Google Discover, conservati con ogni mese archiviato.
Riporta sui tuoi clic giornalieri gli aggiornamenti del ranking e gli incidenti di Google degli ultimi due anni, con i clic prima e dopo ciascuno.
Clic, query, errori di scansione e URL indicizzati da Bing, con la tua chiave API e un pulsante Prova che elenca i tuoi siti.
Ranking, risposte AI, concorrenti e backlink tramite il tuo account DataForSEO, a pagamento per richiesta.
La posizione reale da mobile di ogni ricerca monitorata nella top 20, con accanto il miglior concorrente.
Le ricerche per cui un concorrente è nella top 20 e tu no, con il loro volume.
Legge un servizio che hai connesso dopo un crawl e riesegue i suoi controlli su quel crawl, senza scansionare di nuovo.
Mostra quanti servizi sono connessi nella barra di stato, sotto la proprietà nella barra laterale e come blocco della Dashboard, e ognuno apre Connessioni.
Indica le richieste che ogni connessione fa per una proprietà rispetto alle quote di Google, tutte sulla tua chiave e sul tuo account.
Ogni crawl riporta i link ai report Problemi di sicurezza e Azioni manuali di Search Console per la proprietà, perché l'API di Google non li legge: così puoi aprirli entrambi a mano.
Mette la proprietà accanto ai suoi concorrenti, ciascuno al suo ultimo crawl utilizzabile, con ogni metrica colorata secondo chi è in testa e chi è indietro, e il distacco dal miglior concorrente.
Elenca le metriche in cui un concorrente è in testa, a partire dal distacco più ampio, con i controlli dietro ogni numero.
Accetta un intero elenco incollato così com'è, i concorrenti diretti come primari (al massimo 5) e quelli indiretti come secondari, e mette in coda i loro crawl in un solo passaggio.
Legge prima le sitemap XML di ogni concorrente, scansiona 750 URL di default e propone 1,000, 2,500 o 5,000 quando le sitemap ne elencano di più.
Trova tramite DataForSEO i siti posizionati per le stesse ricerche, divisi tra primari e secondari.
Non propone mai come concorrenti negozi, app di consegna o marketplace; puoi comunque aggiungerli a mano.
Se un concorrente si è trasferito su un altro dominio, lo scansiona dove si trova ora la sua home page.
Propone un sotto-portfolio "<proprietà> | Concorrenti" per i concorrenti di una proprietà e lo tiene legato alla proprietà.
Conta solo i controlli che ogni crawl confrontato ha potuto valutare, e non mette niente in classifica contro un crawl interrotto.
Ricerche posizionate, top 10, visite stimate e domini di riferimento per la proprietà e per ogni concorrente, audit dopo audit.
Domini di riferimento e backlink della proprietà e dei suoi concorrenti, da DataForSEO Backlinks.
Mostra ogni concorrente sotto la sua proprietà, con barre a confronto per URL, segnalazioni e segnalazioni per URL.
Un calendario mensile di ogni crawl ed esecuzione pianificata, passati e futuri, con un filtro per proprietà.
Crawl del sito intero che partono da soli ogni giorno, ogni settimana, ogni N settimane o ogni mese con le impostazioni della proprietà, anche a finestra chiusa.
Archivi di Google Search Console secondo una pianificazione, mensile di default.
Indica quanto costa un crawl pianificato prima di aggiungerlo: URL per esecuzione ed esecuzioni al mese.
Ti avvisa 15 minuti prima che parta un crawl pianificato, e ti dice che verrà eseguito a finestra chiusa.
Sposta un'esecuzione di 1, 3, 6 o 9 ore o a una data e un'ora, oppure la salta, mentre la pianificazione mantiene il suo ritmo.
Ferma in sicurezza un crawl pianificato mentre è in corso e gli dà un nuovo orario.
Ripete l'audit completo ogni mese dalla pianificazione; Neova completa l'analisi e il PDF alla prossima apertura.
Genera un avviso quando i Core Web Vitals cambiano valutazione, i clic degli ultimi 7 giorni calano del 20% o più, una ricerca monitorata esce dalla top 10 o ci entra o perde 3 posizioni, o un nuovo crawl ha nuove segnalazioni.
Conserva gli ultimi 300 avvisi, con Controlla ora e Cancella gli avvisi.
Tiene Neova in esecuzione quando chiudi la finestra, nella barra dei menu, con l'avanzamento del crawl accanto all'orologio.
Mantiene l'icona nel Dock o lascia solo l'icona nella barra dei menu.
Avvia Neova al login con la finestra chiusa.
Una pagina per il telefono, aggiunta alla schermata Home con un codice QR: l'ultimo crawl di ogni proprietà, i Core Web Vitals, i clic di Google Search Console, le ricerche monitorate, la prossima esecuzione e i crawl in corso, cifrati sul Mac prima di uscirne.
Il Mac invia il riepilogo ogni 2 minuti mentre un crawl è in corso e ogni 15 negli altri casi; il telefono controlla ogni 2 minuti e indica quanto è vecchio.
Crea un link per un crawl in corso, così chiunque può seguirlo e sapere quando finisce, con una chiave tutta sua e senza rivelare nient'altro.
Una copia della schermata live che chiunque può aprire: avanzamento, Ripartizione degli URL, Ultimi URL, Mappa del crawl live, Tempo di risposta, Redirect ed errori, Controlli e Link e Novità.
La pagina condivisa può avvisare chi la legge quando il crawl termina.
Ogni gruppo 3xx, 4xx, 5xx e Nessuna risposta dell'intero crawl, fino a 100 URL ciascuno, prima i più linkati.
Pubblica gli avvisi e l'esito di ogni crawl in uno o più canali Slack tramite un incoming webhook, verificato con un messaggio di prova.
Pubblica gli avvisi e l'esito di ogni crawl nei canali di Teams tramite un webhook di Workflows.
Invia i messaggi di ogni portfolio o proprietà ai suoi canali.
Una notifica di sistema quando un crawl termina mentre Neova non è in primo piano, con un suono a scelta.
Elenca tutto quello che Neova sta facendo ora, il crawl, un audit, Esegui i controlli, un crawl pianificato e la coda, ognuno con il pulsante che lo apre.
Ogni conteggio che ha un valore precedente riporta la sua variazione dal precedente crawl confrontabile.
Scarica solo un elenco di pagine, senza esplorare il sito, e genera avvisi di pagina quando cambiano stato, destinazione del redirect, title, canonical, noindex, H1 e dimensione.
Lo stato del crawl a colpo d'occhio: Riepilogo del crawl, Controlli principali, Prossime azioni, Codici di stato e Modifiche rispetto al crawl precedente, e ogni numero apre il suo elenco.
Ogni controllo con segnalazioni: gravità, URL segnalati su quelli controllati, quanti sono indicizzabili, variazione dal crawl precedente, categoria e clic.
Ogni controllo riporta Segnalato quando, Cosa significa di solito e Cosa potresti fare, con il suo ID, la sua fonte e Informazioni su questo controllo, che apre la sua pagina nella libreria dei controlli.
Ogni URL, con set di colonne, filtri su qualsiasi colonna, viste salvate, un selettore di colonne, la colonna URL bloccata e 10, 25, 50 o 100 righe per pagina.
Ogni tabella e griglia esporta in CSV quello che mostra.
Ogni colonna, conteggio e scheda ha una ⓘ che spiega cosa conta.
Otto gruppi e 13 schede costruiti con 39 blocchi: riepilogo, prestazioni, tecnico, Core Web Vitals, contenuti, parole chiave, ricerca AI, social, concorrenti, aggiornamenti dell'algoritmo, flusso di lavoro, programma e report.
Fino a 10 dashboard tutte tue, create da zero o duplicate da una scheda, con blocchi da aggiungere, spostare, ridimensionare e rimuovere.
Il Piano d'azione come programma per stato e proprietario, con il controllo di ogni voce e le sue segnalazioni sull'ultimo crawl, in rosso quando una voce segnata come Fatto è ancora segnalata.
Un ticket per controllo e gruppo di pagine, prima i Da correggere, con la regola, le prove, gli URL interessati, quando è fatto, come verificarlo e dove correggerlo (il template, quando è segnalato il 90% di un gruppo).
Un crawl successivo chiude, mantiene o riapre ogni ticket in base alla sua chiave, e non ne elimina mai uno.
Apre ogni ticket con il codice della proprietà, per esempio [DRH], e lo porta come etichetta in Jira e Linear.
Crea un ticket Jira per ogni ticket Neova nel tuo progetto Jira Cloud, con priorità, etichette e l'elenco degli URL allegato, mai due volte.
Dopo ogni crawl completo avviato dalla finestra, sposta in Done un ticket sparito, riapre quello che è tornato e aggiorna gli altri.
File pronti per l'importazione CSV di ogni strumento: Jira, Linear, Asana, ClickUp, monday.com, Azure DevOps Boards, Notion, Airtable, Smartsheet, e il file di to-do in Markdown di Basecamp, ognuno con la sua pagina di importazione.
Un report per il cliente con il tuo nome, logo e colore: il crawl in numeri, le segnalazioni per categoria, cosa correggere prima con URL di esempio, rendering e visibilità AI, le modifiche dal crawl precedente e come è stato fatto il crawl, in formato Letter o A4; i controlli della stessa famiglia contano una volta sola, e il secondo è elencato come Segnalato anche.
Dà a ogni cliente il suo nome, logo e colore nel report, con Preparato per, Preparato da e note.
Una sola cartella di lavoro: Riepilogo, Ticket in ordine di correzione, Per gruppo di pagine, un foglio per controllo con i suoi 1,000 URL più cliccati e poi più linkati, e Tutte le segnalazioni.
Ogni pagina HTML che ha risposto 200, fino a 200,000, con title, description, H1, canonical, indicizzabile, profondità, link in entrata, sitemap, dimensione, tempo di risposta, clic e segnalazioni.
Invia la cartella di lavoro al tuo Google Drive, convertita in Google Sheets.
Un unico ZIP con quello che scegli: il PDF, la cartella di lavoro dettagliata o sintetica, i ticket con i loro elenchi di URL, i file per Jira e Linear e ogni URL segnalato in un CSV per controllo, con un README.
Gli URL, le segnalazioni e i ticket come file CSV, per CSV, Excel (UTF-8 con BOM), Google Sheets e Looker Studio.
Ogni esportazione riporta una nota quando il crawl è stato eseguito senza rendering o ha coperto solo una parte del sito.
Salva le esportazioni in Download di default, in una cartella Neova exports.
Salva le esportazioni in una cartella del computer che scegli tu.
Carica negli account Google connessi a Neova, tramite l'interfaccia di Google Drive, nella loro cartella Neova exports, sostituendo un file con lo stesso nome così il suo link condiviso continua a funzionare; Neova vede solo i propri file.
Salva nelle cartelle che le app Google Drive, OneDrive, Dropbox, iCloud Drive, Proton Drive e kDrive sincronizzano su un Mac (OneDrive, Dropbox e Google Drive su Windows), con ogni account disattivato finché non lo attivi.
Carica le esportazioni sul tuo server tramite SFTP con password o file di chiave, FTPS o FTP semplice, con una prova prima di salvarlo e la chiave del server memorizzata.
Salva le esportazioni di ogni portfolio o proprietà nella sua cartella o unità.
In Neova Online, scrive un'esportazione direttamente in una cartella del tuo computer in Chrome, Edge, Vivaldi, Brave e Arc; gli altri browser la scaricano.
In Neova Online, un'esportazione di cartella, come le tabelle CSV o le pagine in Markdown, si scarica come un unico ZIP.
Un link in sola lettura di un portfolio o di una proprietà con i crawl, il Piano d'azione, le analisi, i concorrenti e i file che spunti, cifrato sul tuo computer con una chiave che viaggia solo nel link; Aggiorna mantiene l'indirizzo e Disattiva lo elimina.
Cosa fare, in ordine: una bozza ricavata dal crawl (prima i Da correggere, poi i clic, poi la portata), riordinata e formulata da te, con le tue voci in più, con stato, proprietario e nota, conservata da un crawl all'altro.
Copia il piano come Markdown o lo esporta in CSV.
Scrive l'audit completo sul tuo computer: stato attuale, segnalazioni in ordine di priorità, visibilità organica, ricerche monitorate, keyword gap e azioni prioritarie già compilati, con le sezioni che solo una persona può scrivere segnate come Da scrivere.
Conserva con la proprietà i report che aggiungi (Markdown, testo, PDF o Word), con Segna come controllato.
Apre un'email a Neova Labs con i numeri del crawl già dentro, per le sezioni che nessun controllo scrive.
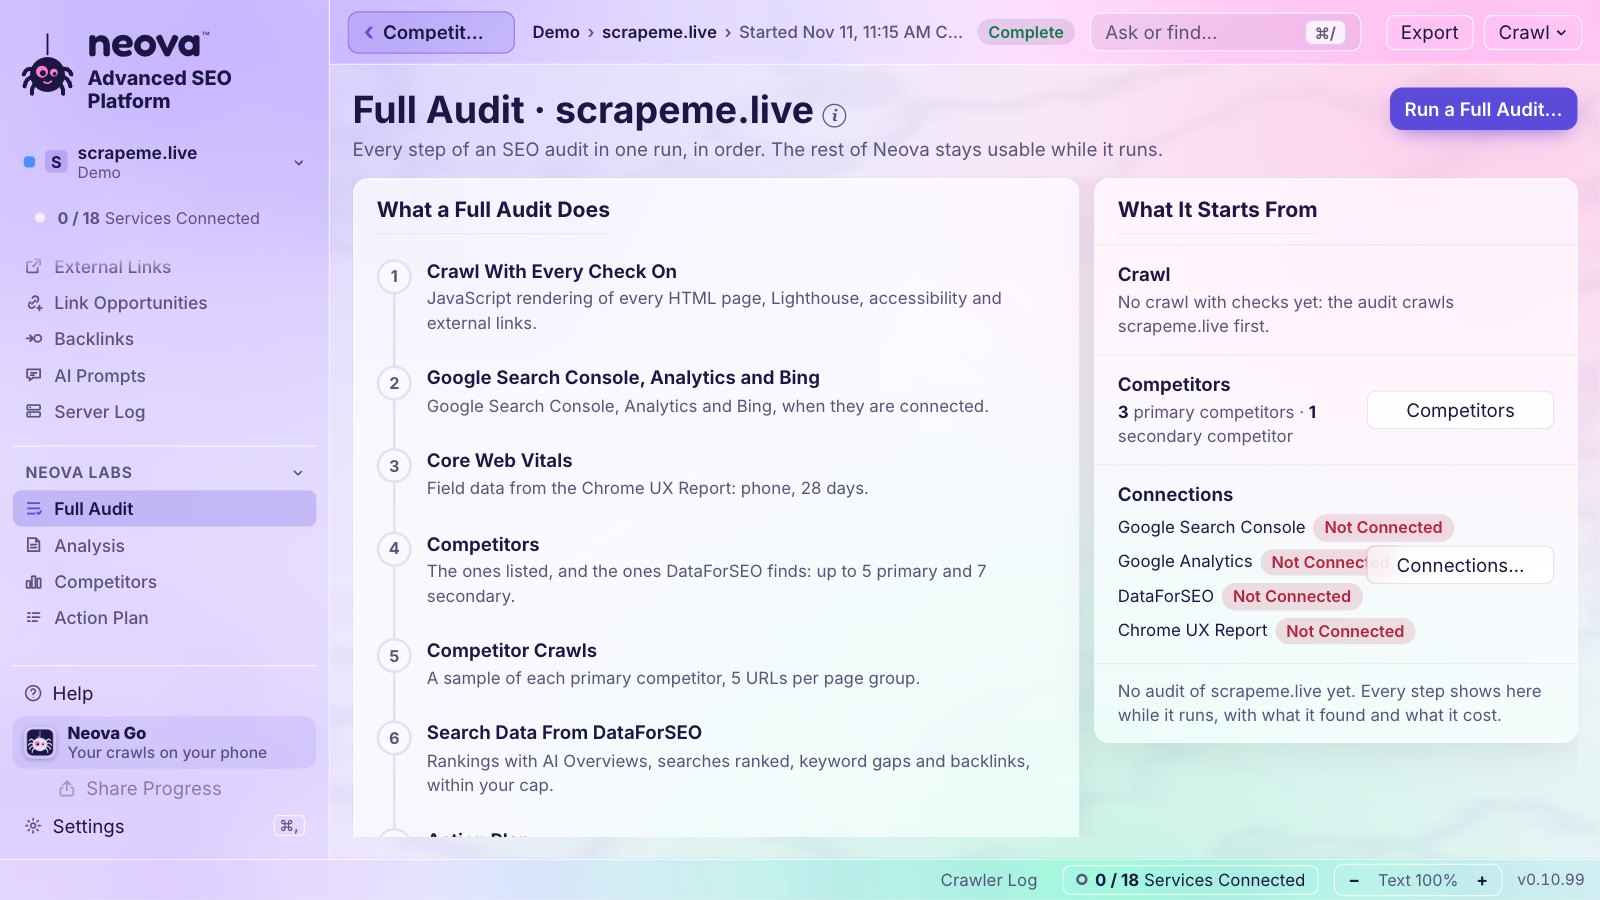
Un'unica esecuzione di ogni passaggio: il crawl con tutti i controlli attivi, Google, Bing e Analytics, Core Web Vitals, i concorrenti e i loro crawl, i dati di ricerca di DataForSEO, il Piano d'azione, l'analisi e il PDF con il tuo brand.
Esegui un audit completo chiede se leggere l'ultimo crawl o scansionare di nuovo, con i suoi URL e il tempo che ha richiesto.
Crawl A contro crawl B: URL nuovi, rimossi e modificati, segnalazioni nuove e risolte, con il crawl B colorato in meglio o in peggio.
Tutto ciò che si conserva per una proprietà oltre la conservazione delle fonti: ogni crawl, ogni mese di Google Search Console, ogni istantanea dei Core Web Vitals, le versioni del robots.txt, le sitemap XML e le modifiche agli URL.
Ogni suggerimento, ticket e report riporta la riga che va controllato prima di applicarlo, perché Neova vede le pagine, non l'attività che c'è dietro.
Un crawl pianificato pubblica il suo esito su Slack e Teams e l'audit completo mensile crea il suo PDF alla prossima apertura di Neova; per ora nessun file di esportazione viene scritto su pianificazione.
Il report PDF e la cartella di lavoro indicano come vengono renderizzate le pagine (nel complesso, per gruppo di pagine e pagina per pagina), cosa il robots.txt lascia prendere a ogni crawler AI e cosa gli consegna il server, e quali controlli di ricerca AI sono superati o segnalati.
Un Google Sheet costruito per Sheets a partire dal crawl: Panoramica con grafici, un Piano d'azione con menu a tendina per Proprietario, Stato e Scadenza, Problemi, URL, Segnalazioni, Gruppi di pagine, Redirect ed errori, Rendering e AI e Informazioni, salvato nel tuo account Google come nuovo file ogni volta.
Ogni file che Neova crea da un crawl (Pacchetto cliente, PDF, cartella di lavoro, Google Sheet, esportazioni, file Neova) è elencato con dove è finito, il crawl, la data e la dimensione, con Apri, Apri la cartella, Copia il percorso e Apri in Google Drive.
La stessa finestra di Neova in un browser su app.neova.app, con il motore sul server di Neova, che scansiona e controlla lì.
Gli account si aprono da un link di invito, nominativo o aperto: un link, un account.
Una password salvata come hash, un accesso che dura 30 giorni dalla tua ultima visita, un'attesa dopo 10 password sbagliate, le richieste da altri siti rifiutate e un avviso quando la pagina è aperta nel browser integrato di un'altra app.
I crawl, i dati e i download di ogni persona nelle sue cartelle, mai leggibili da un'altra persona.
Un'attività per persona alla volta, 10,000 URL per crawl, 10 URL al secondo e 10 GB di crawl per account mentre Neova Online è in test.
Connette Google Search Console, Google Analytics 4 e Google Drive dal browser, con l'accesso conservato nel tuo spazio.
Chiavi e webhook vengono conservati nel tuo account Neova Online e non vengono mai più mostrati.
Ogni nuovo account parte con una Demo: un negozio di prova e tre concorrenti già scansionati, con impostazioni del portfolio, codici e un Piano d'azione, da rimuovere in un solo passaggio.
Un invito può portare con sé portfolio copiati da un altro account, con i loro ultimi crawl, impostazioni e piani, e un banner mentre vengono preparati.
La finestra si adatta a telefoni e tablet: la barra laterale diventa un cassetto, i pannelli occupano tutto lo schermo in una colonna, le tabelle scorrono di lato.
Collega una volta sola l'app desktop a Neova Online; l'app conserva una chiave per quel computer, mai la password.
Tiene allineati da soli portfolio, concorrenti, il tuo ordine, le scelte di Google Search Console e Google Analytics 4, colori e codici.
Quando un lato contiene già i contenuti dell'altro, l'accesso li unisce subito senza chiedere; quando sono davvero diversi, chiede da dove partire, Tieni quelli di Neova Online, Tieni quelli di questo Mac o Unisci entrambi (consigliato, non perde nulla), con i conteggi di ogni lato e prima un backup messo da parte.
Carica o scarica crawl interi in parti riprendibili, verificate alla fine, accanto a qualsiasi crawl in corso.
Invia a Neova Online ogni crawl che termina su questo computer; disattivato di default.
Neova Online mostra un aggiornamento al caricamento successivo della pagina, mai una vecchia finestra dalla cache.
Offre gli installer e il video tutorial per i tester, in noindex.
Porta su questo computer le chiavi di connessione che il tuo account Neova Online conserva, o gli invia quelle di questo computer, dopo la tua password, mostrando solo gli ultimi 4 caratteri di ogni chiave e senza mai sostituire una chiave a meno che tu non spunti Sostituisci.
Ogni account Neova Online può conservare 10 GB di crawl; Impostazioni indica quanto occupa l'account e quanti crawl contiene, avvisa dall'85%, e un caricamento o un crawl oltre lo spazio disponibile viene rifiutato con l'indicazione di cosa fare.
Neova SEO Platform per Mac, con il motore integrato come codice nativo, scansiona sul tuo computer.
Un installer per Windows x64 per il tuo account, senza bisogno della password di amministratore; build per tester, non ancora firmata.
Su Windows l'app dice «questo PC» e usa Ctrl per ogni scorciatoia con ⌘.
L'app desktop su Linux: un .deb per Ubuntu, Linux Mint e Debian, e un AppImage che non richiede installazione.
La finestra e la libreria dei controlli in inglese, francese, tedesco, spagnolo, portoghese (Brasile), italiano, giapponese, olandese, polacco, turco, coreano, cinese (semplificato), russo, indonesiano e vietnamita.
Neova Marmo (quello predefinito), Neova, macOS, Liquid Glass, Windows 11, Linux, Terminal e Contrasto elevato; un aspetto cambia i colori, mai la posizione delle cose.
Chiaro, scuro o la scelta del sistema, con un colore di evidenziazione.
Righe Compatta o Comoda e testo che si ridimensiona con ⌘+ e ⌘−.
Mostra gli URL come percorso o con protocollo e host, in ogni tabella.
Scrive date e orari a modo tuo o secondo la lingua.
Mostra o nasconde la riga Home; il nome Neova in alto a sinistra apre comunque la Home.
⌘N Nuovo crawl, ⌘K Cerca proprietà, ⌘, Impostazioni, ⌘[ Indietro, ⇧⌘P Modalità presentazione, ⌘/ Chiedi o cerca.
Un solo campo trova una vista, un controllo per titolo o ID, una pagina del crawl, una proprietà o un'impostazione, e ricorda le scelte recenti.
Una domanda più lunga va a un modello sul tuo computer, che sceglie una risposta tra ciò che la finestra mostra già, così non inventa mai un numero.
Sfoca tutti i portfolio tranne quello aperto, per condividere lo schermo con un cliente.
Torna alla schermata precedente, il cui nome compare sul pulsante.
Un solo anello di focus, ogni riga raggiungibile con Tab, tasti freccia nelle tabelle, pannelli come finestre di dialogo e riduzione del movimento rispettata.
Trascina la barra laterale, l'elenco dei controlli e il pannello dei dettagli alla larghezza che vuoi.
Esci chiede una volta sola mentre un crawl è in corso, poi lo salva mostrando passaggi e avanzamento, e Riprendi lo continua più tardi.
Indica ogni crawl pianificato in esecuzione in background e propone di fermarlo e salvarlo prima di uscire.
Un crawl in corso quando Neova viene aggiornato si salva da solo e si continua con Riprendi.
Uno stop aggiunge solo il nuovo HTML e mostra ogni passaggio del salvataggio con una barra e Chiudi ora.
Tiene d'occhio lo spazio libero su disco durante un crawl, avvisa quando si avvicina al limite e si ferma in sicurezza sotto i 3 GB, così Riprendi continua appena si libera spazio.
Un crawl interrotto da un crash o da una pipe chiusa viene elencato come interrotto, mai scartato, e il suo archivio viene riportato indietro in sicurezza.
La coda e gli audit continuano mentre la finestra è nascosta.
Controlla su app.neova.app se c'è una build più recente quando l'app si apre, ogni 30 minuti e quando la finestra torna in primo piano, inviando solo il numero di versione.
Copia le impostazioni della finestra in un file dopo ogni modifica, un backup per versione, ripristinato se lo spazio di archiviazione della finestra viene azzerato.
Sposta il punto in cui Neova conserva i suoi crawl.
L'icona porta la scritta Neova SEO sotto il ragno da 64 px in su.
Una build più recente mostra Nuova versione disponibile in alto a sinistra, nella barra degli strumenti, per prima in Aiuto e in Impostazioni › Generale, con Scarica; l'app controlla ogni 30 minuti e quando la finestra torna in primo piano.
Ogni tabella dimensiona le colonne in base a ciò che contengono, lasciando la larghezza restante all'URL e alle colonne troncate per prime; ogni intestazione di colonna ha una maniglia da trascinare, il doppio clic adatta la larghezza e quella che imposti viene mantenuta.
Una mascotte animata facoltativa, 8 tra cui scegliere (Webster, The Head, Sir Canonical, Polly Glot, Hopper, Shelly, Bo, Zap), carina o in pixel art, che sorveglia i tuoi crawl; Nessuna per impostazione predefinita, e con Nessuna non viene caricato nulla.
Un fumetto quando un crawl ha bisogno di te: la fine di un crawl con i suoi controlli Da correggere e quanti sono nuovi, un crawl fermato o non riuscito, un sito che blocca il crawler, il disco che si riempie, un crawl pianificato che parte; un clic apre la schermata che nomina.
Un clic sulla mascotte dice cosa sta facendo Neova e, con un crawl aperto, accetta una domanda sul crawl, con la risposta che segue la stessa strada della barra Chiedi (Ollama sul tuo computer o la tua chiave AI).
Sulla scrivania, la mascotte ha una sua finestra sopra ogni altra finestra e su ogni scrivania, fuori dal Dock; Neova continua a sorvegliare anche ridotta a icona e un clic la riporta sulla schermata giusta.
Sette dimensioni da Minuscola (56 px) a Colossale (320 px), Grande per impostazione predefinita, e una barra sotto la mascotte: Apri Neova, Nuovo crawl, In corso e Altro (nascondi, impostazioni, silenzia), al passaggio del mouse o sempre.
I crawl sono conservati in Application Support/Neova su Mac e in %APPDATA%/Neova su Windows; niente viene inviato a Neova a meno che tu non sincronizzi o condivida.
Ogni chiave, token e accesso va nel portachiavi di sistema tramite lo standard input del motore, mai in un file, in una riga di comando o sullo schermo.
L'app non contiene nessuna chiave di Neova: Google, Chrome UX Report, DataForSEO e gli altri usano la tua chiave e il tuo account.
Il motore viene distribuito come codice nativo, senza sorgente leggibile.
Google viene connesso con permessi in sola lettura più la tua email; Disconnetti revoca il token presso Google.
DataForSEO resta disattivato a meno che Nuovo crawl non lo attivi per quel crawl.
Prima di Avvia, stima il costo in base a quanto DataForSEO ha addebitato a questo computer per le sue ultime 20 chiamate di ogni tipo, altrimenti in base al listino, arrotondato per eccesso ai successivi $0.50 o al dollaro.
Smette di interrogare DataForSEO quando raggiunge il tetto che imposti, da $0.50 a $10 per crawl, $1 di default.
I dati di ricerca dell'audit completo si fermano al suo tetto in dollari USA e indicano quanto hanno speso.
I log del server vengono letti sul tuo computer; nessun indirizzo IP viene scritto da nessuna parte.
Revisione AI e Chiedi usano un modello sul tuo computer tramite Ollama, quindi niente ne esce; Prompt AI indica quando il testo delle pagine va a un provider che hai scelto.
I link di condivisione, Neova Go e Condividi avanzamento sono cifrati sul tuo computer, con la chiave solo nel link o nel codice QR, così il server conserva ciò che non può leggere.
La condivisione delle pagine del glossario che apri è disattivata di default e invia solo un ID casuale, il controllo e la lingua.
Un crawl eliminato va nel Cestino, da cui si può ripristinare, con la selezione multipla dei vecchi crawl fermati.
NeovaBot dice chi è, rispetta il robots.txt e 3 URL al secondo di default, e non risolve mai un CAPTCHA.
Salva un crawl, una proprietà con tutti i suoi crawl e dati, o un portfolio come un unico file .neova, con o senza l'HTML salvato, in Download, Google Drive, qualsiasi unità o cartella; pianificazioni, connessioni, chiavi e password non ci finiscono mai.
Installa un file .neova creato su qualsiasi computer Mac, Windows o Linux, indicando cosa è nuovo, cosa c'è già o cosa arriva con un altro nome prima di scrivere qualsiasi cosa, e senza mai sostituire ciò che questo computer contiene.
Il comando neova scansiona, importa, pubblica e legge siti, pagine, segnalazioni, ticket e avvisi dal Terminale o da script, come tabelle, CSV o JSON.
neova check confronta un crawl con una baseline ed esce con 3 in caso di nuove segnalazioni, o di una segnalazione che supera una quota di URL.
Dà agli assistenti AI l'accesso in lettura ai tuoi crawl, segnalazioni, ticket e impostazioni tramite 16 strumenti, con i dati che restano sul tuo computer.
Aggiunge Neova a Claude Desktop in un clic, con configurazioni da copiare per Claude Code, Codex, Cursor, VS Code, Gemini CLI, LM Studio, Windsurf e ChatGPT.
Avvia, ferma ed elimina crawl da un assistente, e ogni avvio ed eliminazione chiede prima il tuo sì.
Legge il log di un crawl e indica cosa è andato storto (serie di 429 o 503, 403, blocchi nel robots.txt, pagine solo JavaScript, troppe poche pagine) con l'impostazione da cambiare.
Un semplice file JSON contiene l'elenco delle esclusioni, i valori predefiniti e le impostazioni e gli interruttori dei controlli di ogni proprietà.
Apre un export Internal di Screaming Frog (con All Inlinks), un export URL di Sitebulb, il JSON di SiteOne Crawler o qualsiasi CSV con una colonna URL, ed esegue su di esso i controlli di Neova.
Valuta un'importazione riscaricando un campione di 50 URL a 2 URL/s e confrontandola con le sitemap live, così un'importazione non si spaccia mai per un crawl.
L'API HTTP di Neova Online su app.neova.app/api/v1: leggi portfolio, proprietà, crawl, segnalazioni e ticket, avvia un crawl e gestisci i ticket, con una chiave Sola lettura o Lettura e scrittura per ogni script, 60 richieste al minuto per chiave e 20 chiavi per account.
Le richieste dei motori di ricerca e dei crawler AI per ogni URL del crawl, dal log di accesso del sito.
Conta una richiesta di Googlebot, Bingbot o di un crawler AI solo quando il suo indirizzo è nell'elenco pubblicato dalla sua azienda; un nome usato altrove viene contato a parte.
Elenca le pagine HTML che Googlebot non ha mai visitato nel periodo del log e gli URL richiesti dai bot che il crawl non conosce.
Conta le risposte 429 e 403 ricevute da ogni bot.
Legge un log combined di Apache o Nginx, semplice o compresso con gzip.
Per un sito dietro Cloudflare, raccoglie le richieste dei motori di ricerca e dei crawler AI nel tuo account Cloudflare e le legge prima di ogni crawl, senza bisogno di accedere al server.
Scrive la richiesta da mandare all'IT: solo le righe dei crawler, niente da installare, ciò che la sicurezza deve sapere.
Un blocco della Dashboard con le richieste dei bot.
Abbina ogni URL del crawl del vecchio sito al crawl del nuovo sito con un grado di affidabilità, per una migrazione sullo stesso dominio o su un altro.
Confronta il redirect live di ogni vecchio URL con la mappa e segnala quelli sbagliati o mancanti.
Confronta un crawl di staging con la produzione: codice di stato, noindex, canonical, title, meta description, H1 e URL presenti in un solo crawl.
Inverte quale crawl è il vecchio e quale il nuovo, o quale è staging e quale produzione.
Ignora il robots.txt e va più veloce su un sito che confermi essere tuo, con autenticazione HTTP e header personalizzati.
Scansiona un elenco di vecchi URL per verificare dove arriva ciascuno.
Quando la pagina iniziale di un sottodominio di staging linka soprattutto al sito in produzione, Nuovo crawl mostra i conteggi e aggiunge in un clic la regola di Riscrittura degli URL e le sitemap XML del sito in produzione; una sitemap XML aggiunta che nessuna regola riporta sul sito viene segnalata prima che parta il crawl.
Ogni tua proprietà come un blocco nel suo colore, con il suo logo e i numeri chiave, e i suoi concorrenti come righe sotto.
Trascina le proprietà nell'ordine che preferisci, conservato sul Mac, online e sul telefono.
Comprime una famiglia in una riga, con Comprimi tutto ed Espandi tutto, e una ricerca fissata raggiungibile con /.
Una tabella di tutte le proprietà, con ogni concorrente annidato sotto la sua proprietà.
Un punto centrale per ogni sito: i suoi crawl, Per il cliente, Core Web Vitals, Google Search Console, concorrenti, Piano d'azione, analisi e pianificazioni.
Report con il tuo brand (PDF), Cartella di lavoro con tutte le segnalazioni (Excel) e i ticket, un pulsante ciascuno, creati dal crawl aperto.
Ogni pulsante nell'intestazione di Proprietà dice cosa fa e in cosa si differenzia dall'altro.
Raggruppa le proprietà per cliente o azienda, con un colore, e sotto-portfolio su un solo livello.
Dà a ogni proprietà un colore e un codice da 2 a 6 lettere suggerito dal suo dominio.
Trova una proprietà con ⌘K: prima quelle fissate e quelle in corso, poi ogni portfolio con le sue proprietà e i suoi concorrenti.
Gli ultimi cinque crawl della proprietà, con l'esito di ciascuno, a un clic di distanza.
Seleziona i crawl con le caselle o con Seleziona i vecchi fermati e interrotti, poi Elimina selezionati.
Ogni riga di un elenco ha un pulsante principale, poi ⋯ e il clic destro con tutte le azioni, Elimina per ultima in rosso.
La libreria dei controlli su app.neova.app/checks, Guida di Neova SEO Platform, Novità, Segnala un problema, le scorciatoie da tastiera e Verifica aggiornamenti.
Download, installazione, il tuo primo crawl, Neova Online e l'app desktop, le connessioni facoltative e il registro delle modifiche, su app.neova.app/help.
Tutti i 694 controlli per gruppo su app.neova.app/checks, ognuno con la sua pagina e la sua fonte, aperti da Informazioni su questo controllo ovunque compaia il nome di un controllo.
Dice una volta sola che i risultati di Neova sono un'analisi automatica a scopo informativo e che sei tu a decidere cosa cambiare.
Il pannello di ogni controllo ha Informazioni su questo controllo, che apre la pagina del controllo nella libreria dei controlli, con cosa segnala e la sua fonte.
Ogni versione dalla prima build, la più recente per prima, ogni modifica etichettata Nuovo, Migliorato o Corretto con l'ora di rilascio nel tuo fuso orario; si apre da sola una volta dopo ogni aggiornamento. In cima, Prossimamente elenca cosa è in programma.
Crea un unico ZIP per il supporto con le versioni dell'app, il log del crawl scelto e i suoi file piccoli, con i dati riservati oscurati, e ti dice cosa contiene e cosa non contiene mai prima di crearlo.
Nessuna funzionalità corrisponde a questa ricerca.
Piano Free, o 14 giorni di Desktop gratis, senza carta. Mac, Windows e Linux. I tuoi crawl restano sul tuo computer.
Scarica NeovaNeova Online, lo stesso Neova nel browser, è compreso in Desktop + Online e Agency: guarda i piani.