抓取
同时抓取多个网站,并实时观看
同时抓取多个网站,各按各的节奏,每个 URL 一到就出现在实时地图上。
4个网站同时抓取
3种抓取模式
1个窗口
蜘蛛模式、列表或抽样实时抓取地图从停下的地方继续在 Chrome 中渲染 JavaScript
▶ 观看:您的第一次抓取 1:58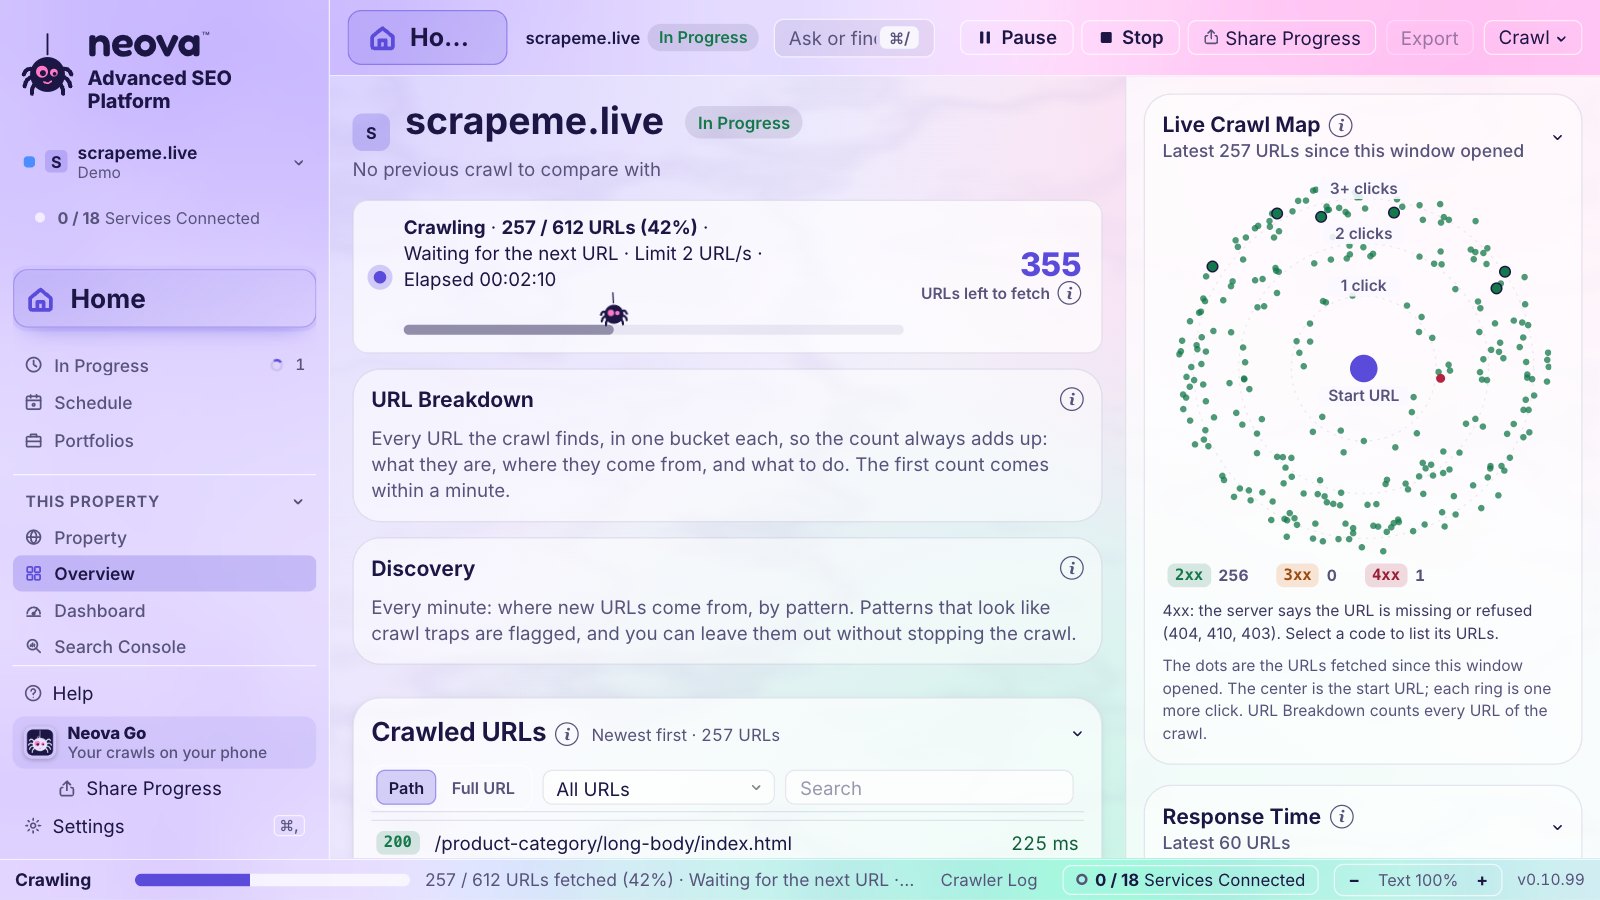
由 SEO 打造,为 SEO 而生。Neova 在您自己的电脑上抓取,然后告诉您哪些标记重要、先修复什么,写好工单,生成给客户的报告,并持续监视网站。先看两分钟视频,再看全部功能。
抓取只是开始。下面是 Neova 接下来做的事。
同时抓取多个网站,各按各的节奏,每个 URL 一到就出现在实时地图上。
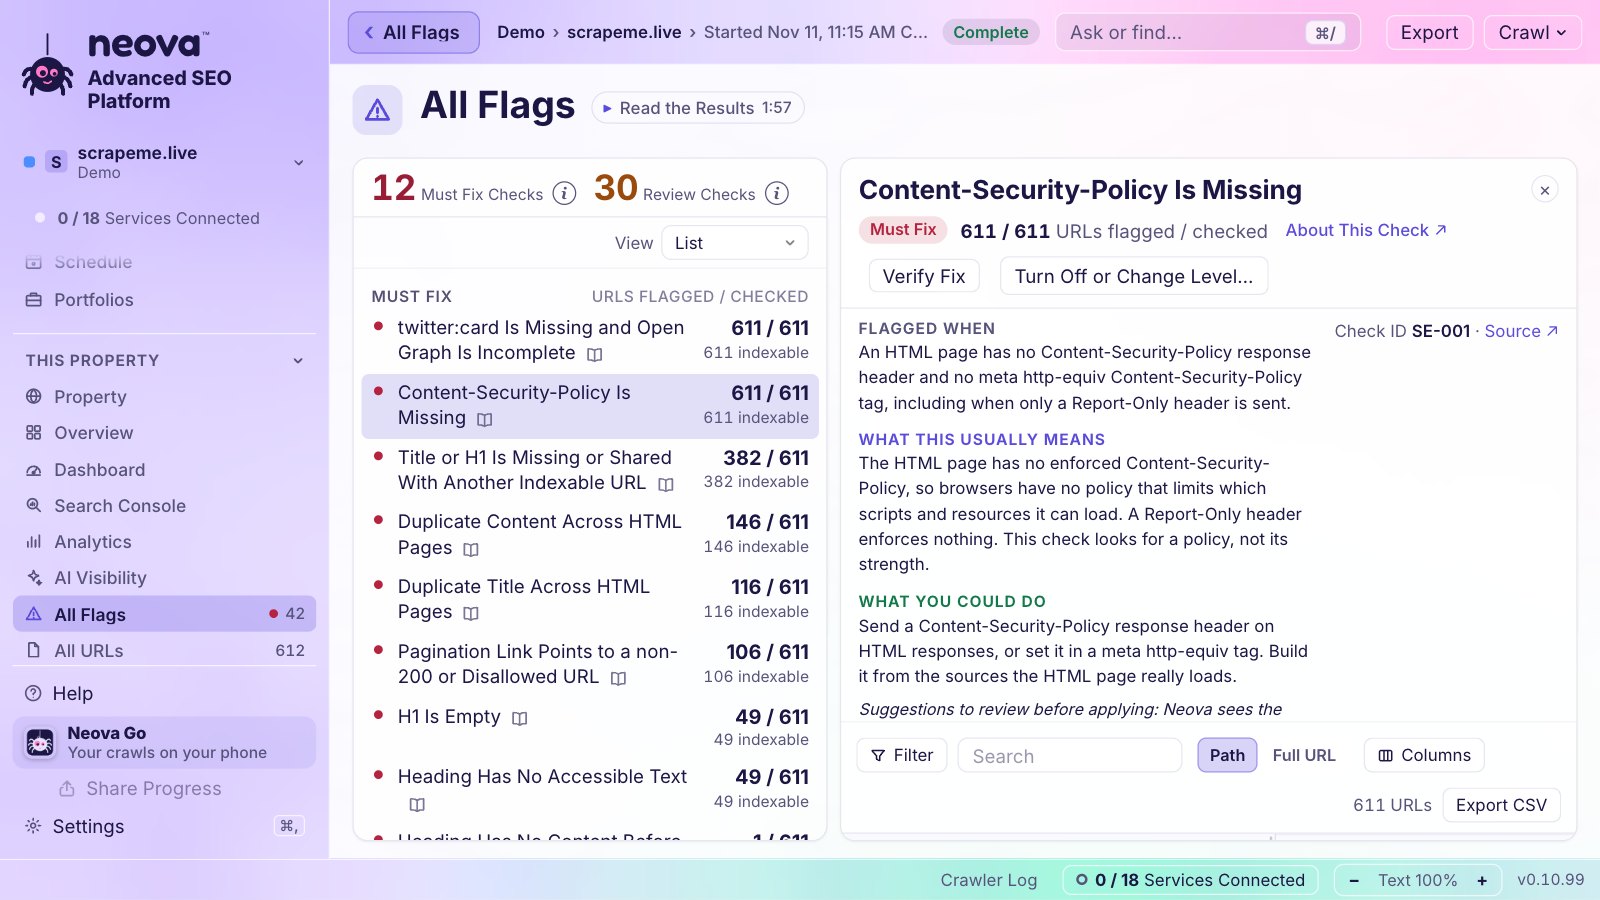
标记直接变成工作:负责人、状态,「必须修复」优先,在多次抓取之间保留。
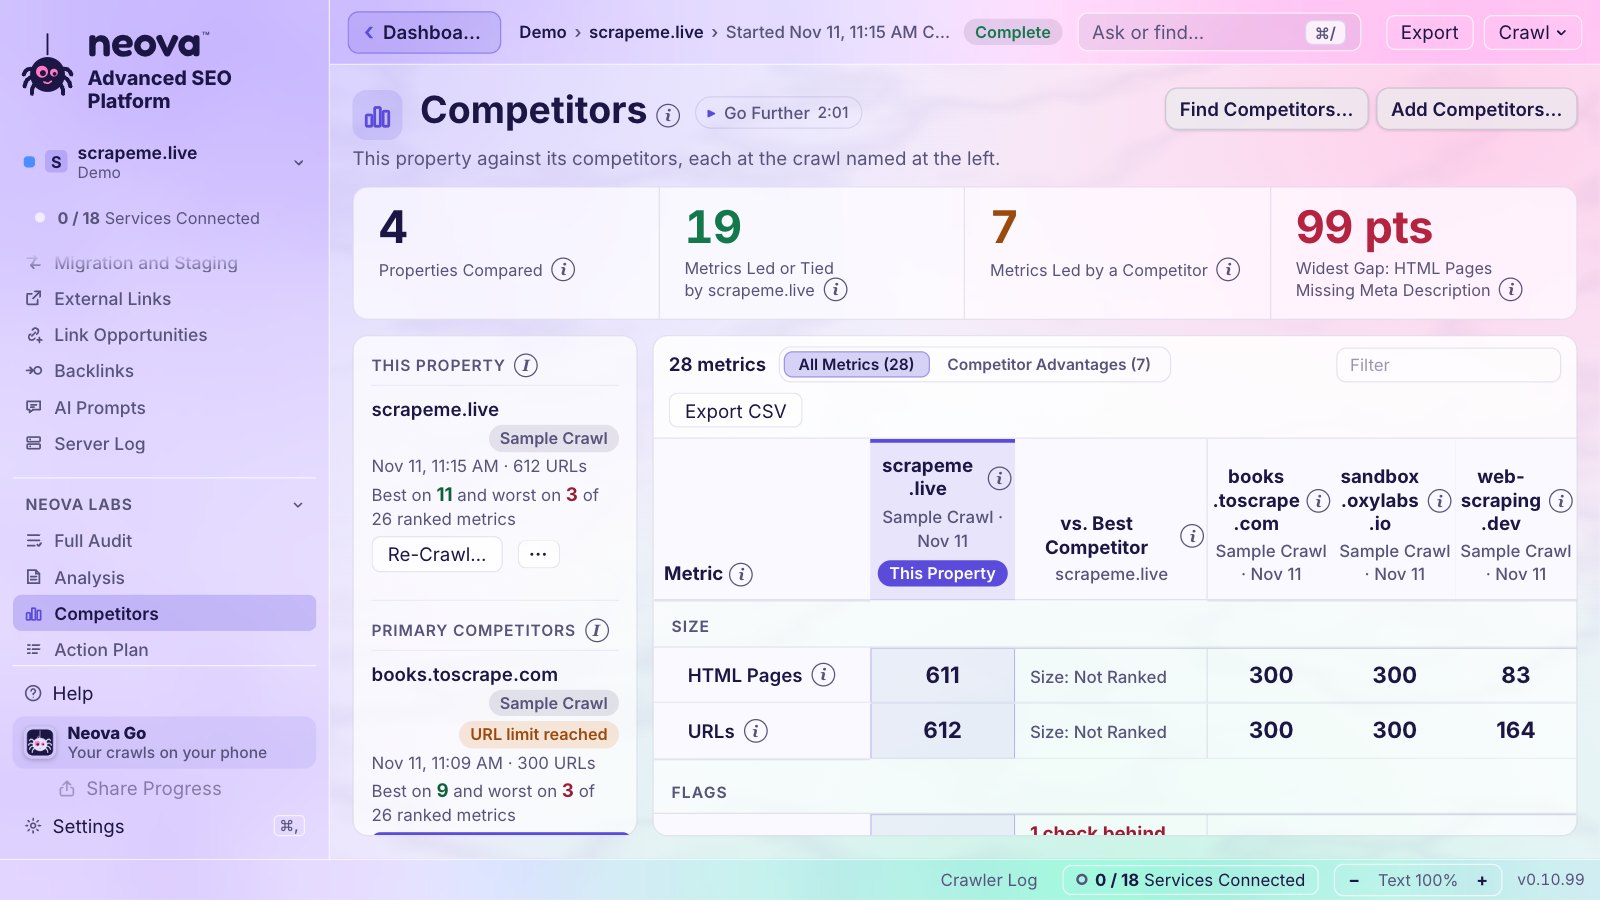
粘贴一份列表。Neova 按对方的站点地图确定每次抓取的规模,再逐项指标显示谁领先。
真实访客在手机上的体验,按页面组呈现,评级一变就发出警报。
打开它们的导出文件,对其发现运行 Neova 的检查。喜欢的工具照用不误。
 Screaming Frog 导出
 Sitebulb 导出JSONSiteOne CrawlerCSV任意 URL 列表
关掉窗口,抓取在菜单栏里继续,手机上能看到每个资源。

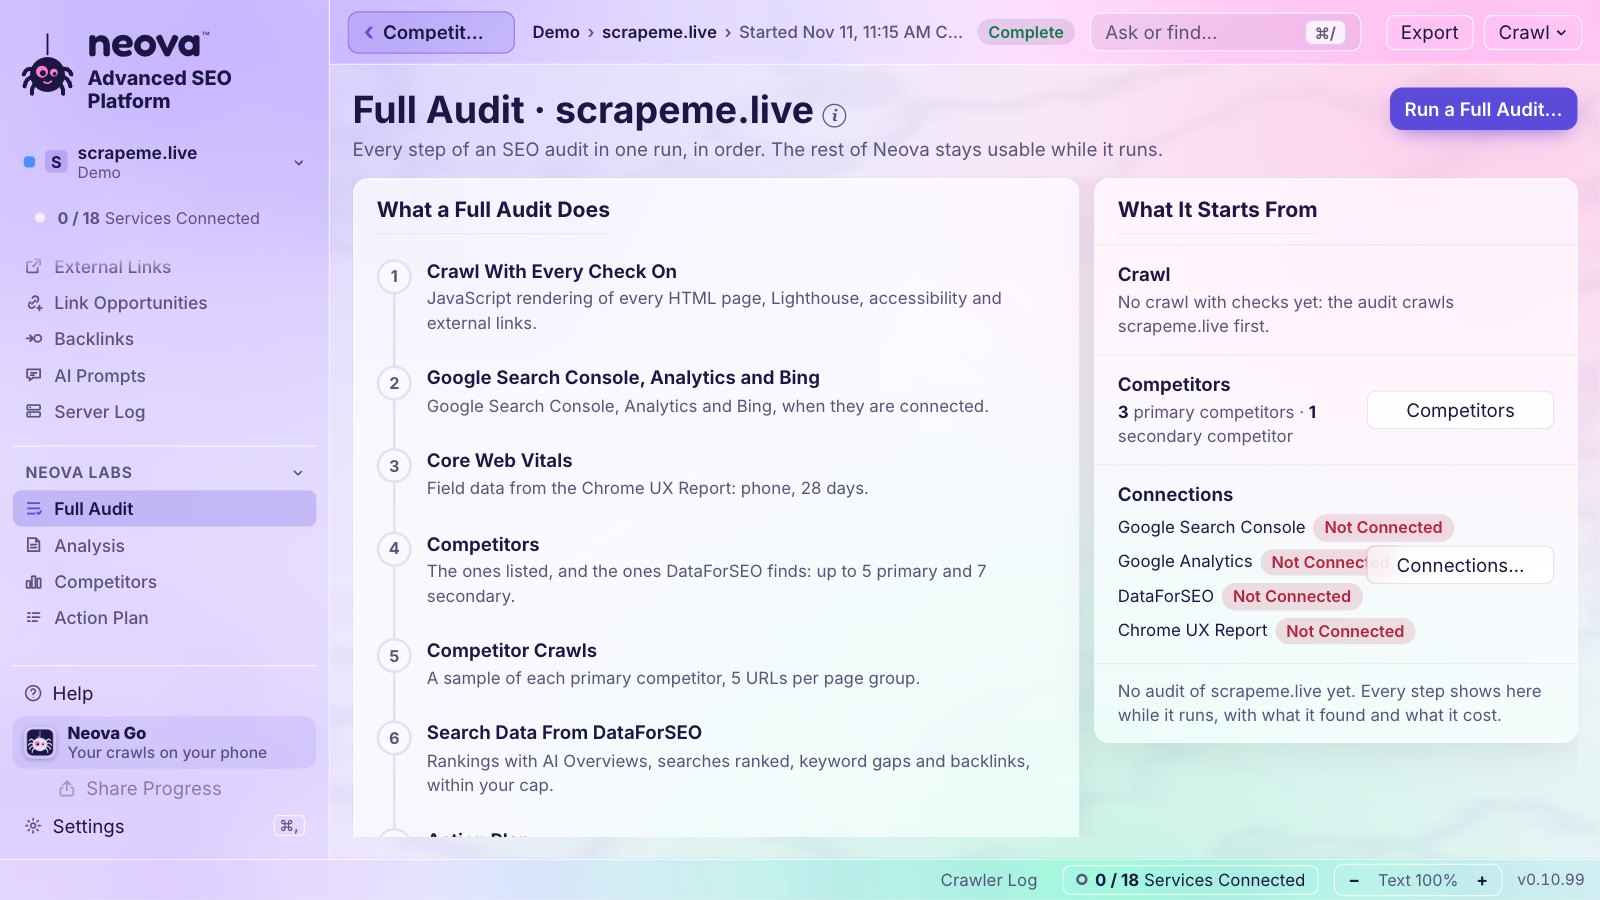
抓取、Google、Bing 和 Analytics、Core Web Vitals、竞争对手、计划和 PDF,一次跑完。
一个待在您桌面上、替您盯着抓取的动画吉祥物。抓取需要您时它会提醒,能回答您关于这次抓取的问题,点一下就带您到正确的界面。可选功能,在您选择之前一直关闭。
31 项服务,全部可选:没有它们,Neova 照样工作;有了它们,能做得更多。
 Google Search Console
 Google Analytics
 Chrome UX Report
 Google Cloud
 Gemini
 Bing Webmaster Tools
 OneDrive
 Microsoft Teams
 DataForSEO
 Semrush
 Ahrefs
 Majestic
 Moz
 SEO Gets
 Anthropic
 OpenAI
 Ollama
 Jira
 Linear
 Asana
 ClickUp
 monday.com
 Slack
 Cloudflare
 Google Drive
 Dropbox
 iCloud Drive
 Proton Drive
 kDriveScreaming FrogSitebulbGoogle Search ConsoleGoogle AnalyticsChrome UX ReportGoogle CloudGeminiBing Webmaster ToolsOneDriveMicrosoft TeamsDataForSEOSemrushAhrefsMajesticMozSEO GetsAnthropicOpenAIOllamaJiraLinearAsanaClickUpmonday.comSlackCloudflareGoogle DriveDropboxiCloud DriveProton DrivekDriveScreaming FrogSitebulb
打开一个领域,查看其中的所有功能,或搜索全部功能。
抓取的实时日志:每个已获取的 URL 及其彩色状态码和响应时间,每个步骤加粗,失败显示为红色、警告显示为琥珀色;「复制日志」会保留每一行,方便提交给支持团队。
从起始 URL 沿内链抓取,开启 XML 站点地图时也会读取站点地图,与搜索引擎发现网站的方式相同。
只抓取您粘贴或从文件上传的 URL,别的都不抓。
抓取开始前先读取网站,选出返回 200 的版本(http 或 https,带或不带 www),并说明其他版本的情况。
询问是否抓取 Neova 发现的子域名,以及抓取哪些。
抓取整个网站,除非您设定上限,否则不限 URL 数量。
只抓取您输入的文件夹,并对照其下的 XML 站点地图 URL 判断完整度。
从每个页面组抓取设定数量的页面,大型网站几分钟就能完成诊断,并覆盖每个模板。
一次选择,三个级别:仅抓取、网站诊断(增加 Core Web Vitals 和行动计划草稿)和完整诊断(增加竞争对手、搜索数据和分析)。
从 TXT 或 CSV 文件导入或直接粘贴额外的起始 URL,抓到没有任何链接指向的页面。
在链接能到达的页面之后,再抓取 robots.txt 声明的 XML 站点地图中列出的 URL。
除了 robots.txt 声明的站点地图,还读取您另外指定的 XML 站点地图,该资源的每次抓取都适用。
选择 HTML 页面之外还抓取哪些资源文件:图片、CSS、JavaScript 和 PDF。
「页面优先」先获取所有 HTML 页面,再获取图片和文件,诊断的核心部分最先完成;「按深度」先获取离起始 URL 最近的页面。
记录菜单、页脚和筛选器中的链接但不跟随,正文链接则始终跟随。
按正则表达式抓取或跳过 URL,每行一条,另有一个输入框可用这些规则测试某个 URL。
一份排除列表,每次抓取都会使用,无论由谁发起:窗口、定时计划还是 AI 助手。
在抓取之前用正则规则重写 URL,例如去掉跟踪参数,或者把预发布网站上指向正式网站的链接,以及正式网站的 XML 站点地图,改到预发布主机上。
抓取时保留或去掉查询字符串。
需要时也抓取标有 rel=nofollow 的内链。
把 /Page 和 /page 视为同一个 URL。
从某个文件夹开始的抓取可以越出这个文件夹。
URL 上限、抓取深度上限、每个文件夹的最大 URL 数、最大 URL 长度和最大查询参数数,让分面导航不失控。
默认每秒抓取 3 个 URL;服务器变慢或返回 429、503 时自动减半速度,并遵守 Retry-After。
每个请求都按设定的速度间隔发出,robots.txt 和 XML 站点地图也不例外,网站绝不会遭遇突发请求。
确认网站归您所有后,速度最高可达每秒 50 个 URL,还可以忽略 robots.txt,适用于您自己的网站或预发布服务器。
默认以 NeovaBot 身份抓取,也可以用 Googlebot、Bingbot、Applebot、GPTBot 和 ClaudeBot 等 AI 爬虫、SEO 工具、浏览器或自定义字符串。
遵守线上的 robots.txt;对自己的网站可以忽略它;也可以遵守在 robots.txt 测试工具中保存的草稿,看看改动会带来什么。
抓取完成后在 Chrome 中渲染 HTML 页面(全部,或每个页面组几个),并把渲染后的页面与原始 HTML 对比;默认关闭。
等待网络安静下来、页面停止变化,最长等到稳定时限,并说明哪些页面那时仍在变化。
抓取未开启渲染时,在结果上方说明这一点,以及因此有多少项检查无法运行,并提供「开启渲染重新抓取」。
像访客一样用 Chrome 获取每个 URL,适用于有爬虫防护的网站;遇到 CAPTCHA 由您自己完成,Neova 会等您。
只向被抓取的网站发送 HTTP 身份验证、Cookie 和自定义请求头,适用于预发布网站和需要登录的区域。
为您管理的网站生成一个密钥请求头,只发送给该网站,并附上一条可交给其 IT 团队的规则,让防火墙放行 Neova。
把一套配置以名称保存,可在任何网站上复用,设置了什么一目了然。
为某个资源设置专属的抓取设置,新建抓取、重新抓取及其定时计划都以此为起点,并可「恢复默认设置」。
只显示大多数人会改的设置,或者显示全部设置,并为每项附上工作原理说明。
抓取开始前列出所有与默认值不同的设置,每项都带「编辑」链接。
先读取几个页面,说明 XML 站点地图列出了多少 URL、预计有多少图片和文件,以及所需磁盘空间与可用空间的对比。
根据抽样页面,说明每个页面有多少图片、链接带有哪些参数,以及哪些地址写错了。
在抓取或诊断开始前检查该资源的 Google 连接;登录失效时先暂停,并提供「重新登录」「不含这些数据继续抓取」或「取消」。
抓取进行时实时显示:带编号的步骤、当前正在做什么、剩余 URL,以及下方的每个面板,每个都可折叠。
按名称显示各个步骤(正在抓取网站、正在抓取 XML 站点地图、正在抓取资源文件、正在渲染页面、正在运行 694 项检查),以及每一步获取了什么。
用一行说明抓取此刻在做什么,以及最后获取的地址。
进度条下方的三条进度:HTML 页面、图片,以及 CSS、脚本和其他文件,每条显示已获取数与已发现数。
用大字和进度条显示还要获取的 URL,然后是还要检查的 URL。
每分钟按模式说明新 URL 来自哪里,标记抓取陷阱的形态(日历、重复文件夹、会话 ID、大量参数、过深过长的 URL),并可当场排除或跳过。
对发现的每个 URL 组,提供「继续抓取」「跳过」或「排除」,并说明各自会让哪些内容留在诊断中、哪些移出,推荐的选项会标出。
把抓取发现的每个 URL 恰好归入一个类别(干净的页面 URL、参数变体、格式错误的 URL、抓取陷阱、图片、CSS、JavaScript 和字体、文档、视频和音频、其他资源文件),数量始终有据可查。
获取每个页面组前 1、3、5、10、25、50 或 100 个页面的图片,并显示每档对应的图片数和耗时;也可以跳过其余图片,或保留所有图片。
所有页面获取完成后,跳过剩下的图片和文件,让抓取以完成状态结束并运行检查项。
抓取时显示目前最深的页面,从 4 次点击起显示为琥珀色,从 10 次点击起出现警告行。
按点击深度绘制最新的 300 个 URL,按状态码着色,仅出现在站点地图中的 URL 单独成一圈。
在图表上显示最新 URL 的响应时间中位数,并标出 800 ms 和 1,800 ms 两条线。
边获取边列出 URL,每页 10、25、50 或 100 条,可按 2xx、3xx、4xx、5xx、无响应、已变化和新增筛选。
每获取一个 URL,就与该资源最近一次读取过页面的抓取对比(优先整站抓取,其次抽样或指定文件夹抓取),把旧值加删除线显示在新值旁边。
按类别显示正在运行的检查项,每个类别显示已读取多少 URL,写入后显示标记数量。
列出与抓取所见相符的 Google 官方页面,以及最近 45 天的 Google 搜索动态:排名更新、Search Central 博客和文档更新。
推荐与本次抓取相关的阅读:Google Search Status Dashboard,以及 SEO ProCheck 的案例研究和算法更新。
冻结抓取,之后从原处继续。
「停止」会询问:转到 XML 站点地图、停止并运行检查项、停止并删除此次抓取,或继续抓取;渲染期间还可以「跳过渲染」。
继续已停止或中断的抓取,恢复其原有设置,绝不从零开始。
对一次抓取已获取的内容重新运行所有检查项,不重新获取任何内容;已完整结束的抓取也可以,这样新版本中改进的检查项也能用于已保存的抓取。它可以与其他网站的抓取同时运行。
用最近一次抓取的设置重新抓取该资源,已连接的数据、竞争对手和计划都不受影响。
网站拒绝抓取时,说明原因(被限速、被防火墙拦截或在此国家/地区被屏蔽、禁止访问),以及下一步怎么做。
不可能是 URL 的地址(比如 href 里的一句话)不会被跟随,而是作为一条标记报告。
读取获取到的每个样式表,找出其中的字体、背景图片和导入的样式表。
列出页面从其他主机加载的文件和图片,但不抓取它们。
把没有图片扩展名的 CMS 媒体 URL(例如 Sitecore 的 /-/media/ 处理程序)计为图片。
根据 HTML 按模板给页面分组(优先用主题自带的模板词,否则用页面骨架),超大网站还会按地址模式分组。
除了锚点链接,也跟随 head 中的 rel=next 和 rel=prev 链接。
把抓取排进队列,一有空闲的抓取名额就开始,同一网站绝不同时进行两次抓取;提供「启动队列」「清空队列」和「检查项结束时」。
抓取数据存在磁盘而非内存中(60,000 个 URL 时占用 60 MB 内存),规模只受磁盘限制,不受内存限制。
最多可同时抓取 4 个网站,每个按自己的速度和 URL 上限运行;内存守护会在电脑内存不足时让某个抓取暂缓。抓取运行期间,任何已保存的抓取或资源都能打开。
新建抓取会用该资源已保存的设置(速度、范围、URL 上限、渲染、User-Agent、XML 站点地图等)填写表单,在「起始 URL」中输入网站地址时也是如此;您在此窗口中最近填写的内容仍然优先,已经改过的内容不会被覆盖。
这台电脑断网时,抓取会说明情况并等待,网络恢复后自动继续,而不是当作网站宕机而停止;离线 30 分钟后才会停止并说明原因。
列出每个 HTML 页面的标题、meta description 和 H1 及其长度,以及内容检查项和它们的标记。
「所有 URL」中用于标题、meta description 和 H1 的列组,每组都可按缺失、为空、重复、过长和过短筛选。
标记重复的标题、描述、H1 和 H2,以及 HTML 页面之间重复或近似重复的文本。
标记 Flesch 分数落在「难」和「很难」区间的正文,以及不足 200 字的单薄页面。
标记正文中可能的拼写和语法错误。
标记写着过去年份的标题和 H1,以及提到已过期的优惠、截止日期或活动日期的文本。
检查决定页面被分享时显示的标题、描述和图片的标签。
显示页面的标题和描述在搜索结果中的样子。
由您电脑上的模型阅读 HTML 页面,完成 20 项需要判断的内容检查,例如缺少示例、论断没有依据或没有作者署名;它的标记与「必须修复」和「值得关注」分开存放。
显示自上一次抓取以来哪些标题、meta description 和 H1 发生了变化,并列出前后对比。
标题、meta description 和 H1 的长度条形图、页面组,以及获得链接最多的 HTML 页面。
把每个 HTML 页面的主要内容各导出为一个 Markdown 文件,并附一个索引。
标记缺失、为空、过长和重复的 H1 与 H2,第一个 H1 不是主标题的情况,以及没有 H2 的长页面。
标记缺少 charset、doctype 或 body 标签、失效的 favicon、过时的元素,以及承载内容的框架。
标记 Lorem Ipsum、模板代码、空的脚本值,以及作为页面文本显示出来的服务器错误或调试输出。
标记文本与 HTML 比例过低、正文不足 200 字以及超过 5,000 字的页面。
标记没有 noindex、也没有 canonical 指向原文的转载内容。
标记缺少「关于」页面,或该页面没有在全站链接。
用您自己的 Google Natural Language 密钥读取关键 HTML 页面的实体,供内容检查项使用。
每个 URL 的状态码,在各处颜色一致:2xx 绿色、3xx 橙色、4xx 和 5xx 红色,「无响应」单独列出。
重定向指向哪里、经过几跳、循环、临时重定向、meta refresh 和 JavaScript 重定向,以及指向它们的链接。
标记经过 2 跳及以上重定向的内部 URL、重定向循环、重定向到自身,以及缺失或格式错误的 Location 响应头。
标记内部的 302、303 和 307 重定向,登录页面的跳转目标除外。
标记最终落在 4XX 或 5XX、noindex、已 canonical 到其他 URL、被禁止抓取的 URL 或其他网站上的内部重定向。
标记仅为加斜杠或改变大小写而重定向的 URL,以及仅在这方面不同、彼此之间又没有 canonical 的页面。
标记会重定向的图片、脚本和样式表,以及会重定向或最终报错的外部链接。
canonical 和 meta robots 指令的列组,可按 noindex 和 nofollow 筛选。
显示任意 URL 的响应头。
显示 URL 返回的 HTML;抓取开启渲染时,还显示渲染后的 HTML。
逐个 HTML 页面说明它属于服务器端渲染、客户端水合还是需要 JavaScript。
标记只有在 JavaScript 运行后才出现或改变的标题、canonical、链接和正文。
针对 AMP URL 及其 canonical 的 20 项检查,包括 AMP 验证器。
标记过长的 URL、下划线、双斜杠、重复的路径段、多余的标点和过多的参数。
按文件夹和抓取深度显示 HTML 页面。
把抓取画成一棵从起始 URL 展开的树,每个点按状态码着色,图例可用于筛选。
您用正则表达式自定义的 URL 组,按网站设置,每组统计各状态码数量,「所有 URL」中还有「细分」列。
在每个页面的 HTML 中搜索文本或正则表达式,或者用 XPath、CSS 选择器或正则表达式提取值,并把提取规则保存为一列,每次抓取都会重新运行。
列出每个 URL 的内容类型、大小和响应时间,响应时间从 800 ms 和 1,800 ms 起分色显示。
只重新获取某项检查标记的 URL,重新运行所有检查项,并说明修复了多少。
针对单个资源关闭某项检查,或把它的级别改为「必须修复」或「值得关注」,此后每次抓取都保留。
在一次抓取中整体排除某些检查项类别。
一个界面看全渲染情况:多少 HTML 页面内容完全在 HTML 中、部分在 HTML 中或需要 JavaScript,哪些内容只有 JavaScript 才显示,每个 AI 爬虫获取到什么(按页面组),以及内容不全在 HTML 中的页面。
仪表盘的「技术」和「AI 搜索」标签页显示内容在 HTML 中的页面占比、需要 JavaScript 的页面、主要内容只有在 JavaScript 运行后才出现的页面,以及获取到完整页面的 AI 爬虫。
每个 HTML 页面能否被索引:状态码、noindex、canonical、robots.txt,以及在 SEO 标签之前就把 head 截断的 HTML。
标出每个 URL 是否可索引及原因:状态码 200、没有 noindex、canonical 指向自身或没有 canonical。
用平实的语言逐行解释线上文件或草稿,依据 Google 的文档说明和 RFC 9309 的定义,并列出每条规则匹配到的已抓取 URL。
显示在 robots.txt 规则下 Googlebot、Bingbot 和各 AI 爬虫可以获取什么,并列出每个爬虫被拦截的 URL。
在草稿上线之前,用本次抓取的每个 URL 检验它,列出新被拦截和新被允许的 URL。
当 robots.txt 中某个爬虫自己的分组让 * 分组的规则失效时,会说明这一点。
XML 站点地图列出的内容与抓取发现的内容对比:缺失的可索引页面,以及被列出的重定向、noindex、错误和孤立 URL。
作为第 2 步,获取只在 XML 站点地图中列出的页面,并单独计数。
在响应慢的网站上,给 robots.txt 和站点地图单独留出时间,并说明哪个没有响应。
为可索引页面生成 XML 站点地图,可包含任意深度,或只到深度 3 或 5。
标记返回 200 却没有任何条目的分页归档页、断开的 rel=next 链,以及 canonical 到第 1 页的分页。
保留抓取读取过的每个 robots.txt 版本和 XML 站点地图,并标记自上一次抓取以来 robots.txt 规则的变化。
标记在 SEO 标签之前就结束 head 的 HTML(带文本的 noscript、无效元素、省略或重复的 head 标签),这会导致标题和 canonical 被当作 body 内容读取。
标记循环、成链、指向重定向、noindex、4XX、5XX、HTTP 或外部 URL,或者只由 JavaScript 设置的 canonical。
标记在 HTML 和 HTTP 响应头中不一致、重复声明或拼写错误的 noindex、nofollow 和 canonical。
标记使用了被 robots.txt 禁止抓取的图片、脚本或样式表的页面。
标记返回相同 HTML 的大小写、末尾斜杠和参数顺序变体。
标记返回 200、但标题或 H1 中含有「未找到」「未找到结果」之类短语的 HTML 页面。
标记超过 2 MB、且有链接或内容超出 Google 读取上限的 HTML,以及超过 2 MB 的 JavaScript 或 CSS 文件。
标记可抓取 URL 数量的剧烈变化,以及自上一次抓取以来变化的 robots.txt 规则。
标记超过 50 MB 或 50,000 个条目的 XML 站点地图、空站点地图、robots.txt 中使用相对路径的 Sitemap 行,以及位于其他主机或协议上的 URL。
检查网站上是否放置了您的 IndexNow 密钥文件,没有的话可用「生成密钥」创建一个。
每次抓取读取最多 200 个 URL 的 Google 网址检查结论,标记 Google 未编入索引或 Google 选择了另一个 canonical 的可索引页面。
整站抓取自行结束后,把自上一次完整抓取以来变化或新增的页面提交给 IndexNow(Bing、Yandex、Seznam、Naver 和 Yep),前提是网站上放置了您的密钥;窗口中会说明提交了什么、哪些被拒绝。
列出标为成人内容的页面(adult meta rating、RTA 标签或 Rating 响应头),以及对爬虫返回年龄验证页的页面,供您查看。
失效链接、指向重定向的链接、锚点,以及很少有链接到达的页面。
列出指向某个 URL 和从它发出的每条链接及其锚文本。
记录每条链接位于正文、菜单、页脚还是筛选器中,并提供「正文入链」和「菜单和页脚入链」列。
按每个 URL 获得的内链权重给出 0 到 100 的分数,即在本次抓取的可跟随链接上计算的内部 PageRank。
每个 URL 距起始 URL 的点击次数,深度达到 4 起会标记。
标记没有任何内链到达的可索引页面,这些页面是通过 XML 站点地图、服务器日志或 Google Search Console 发现的。
网站链接到其他网站的每个 URL,各请求一次,并报告 4XX、5XX 和无响应。
为某次抓取开启或关闭对每个外部 URL 的请求;默认开启。
根据 HTML 页面的文本建议内链:提到了另一个页面的主题却没有链接过去的页面。
用您自己的 Ahrefs、Majestic、Moz 或 Semrush 密钥,显示每个 URL 的 URL Rating、Trust Flow、Page Authority 或 Authority Score,以及引用域名和反向链接。
标记没有锚文本或锚文本没有描述性的内链,以及没有 alt 的带链接图片。
标记只能通过 nofollow 链接到达的页面、被 nofollow 的内部出链,以及没有 sponsored 或 nofollow 的联盟链接。
标记为空、格式错误和含空白的 href,只靠 onclick 的链接、跟踪参数、本地文件路径、localhost,以及没有对应 ID 的片段。
标记只能通过 canonical、重定向或 noindex 页面到达的 URL,以及只有一个 URL 链入的页面。
把链接中写错的地址(末尾有空格、双斜杠、字符被编码两次)单独归为一类计数。
标记链接到预发布、开发或本地主机的 HTML 页面。
列出抓取获取到的或页面用到的每张图片,以及它的大小、alt 文本和使用它的 HTML 页面数。
标记缺失、过长、占位和重复的 alt 文本,并区分缺失的 alt 和装饰性图片的空 alt。
标记超过 100 KB 的图片、超过 100 KB 的 GIF,以及没有设置 width 和 height 的图片。
开启渲染时,标记显示宽高比不对或分辨率相对显示尺寸过低的图片。
标记未压缩、未使用现代格式、比显示尺寸大的图片,以及延迟加载的 LCP 图片。
标记没有字幕轨道的视频。
大型图片库可按页面组抽样,而不必全部获取,并显示每种选择对应的数量和耗时。
跳过仍在队列中的图片,每个页面照常抓取,alt 文本也照样从 HTML 中读取。
在授权图片的网站上,标记缺少许可信息的 ImageObject 标记,并抽样读取所提供图片的 IPTC 和 XMP 版权信息,Google 需要这些信息来显示「可许可」徽章。
每个页面的语言和地区版本,以及它们是否互相指向:返回链接、自我引用、x-default、无效代码、已 canonical 到其他 URL 的目标和 noindex 目标。
每个 HTML 页面的「Hreflang 语言」和「Hreflang 目标」,鼠标悬停可看完整列表。
标记缺失、为空或无效的 html lang,以及与 hreflang 或页面本身文本不一致的 lang 值。
标记缺失的返回链接、缺失的自我引用,以及指向已 canonical 到其他 URL 的返回链接。
标记首页组合缺少 x-default,以及 x-default 目标失效、noindex 或已 canonical 到其他 URL。
标记状态码不是 200、noindex、已 canonical 到其他 URL、被禁止抓取或没有入链的 hreflang 目标。
校验每个 hreflang 语言和国家代码,并标记没有纯语言后备的地区代码。
标记没有 hreflang 的同内容语言版本,以及任何页面都没有 hreflang 的目标市场。
从 HTML head 和 HTTP Link 响应头读取 hreflang,并标记用多种方式声明的组合。
标记按 Accept-Language 变化、而 Googlebot 看不到的响应。
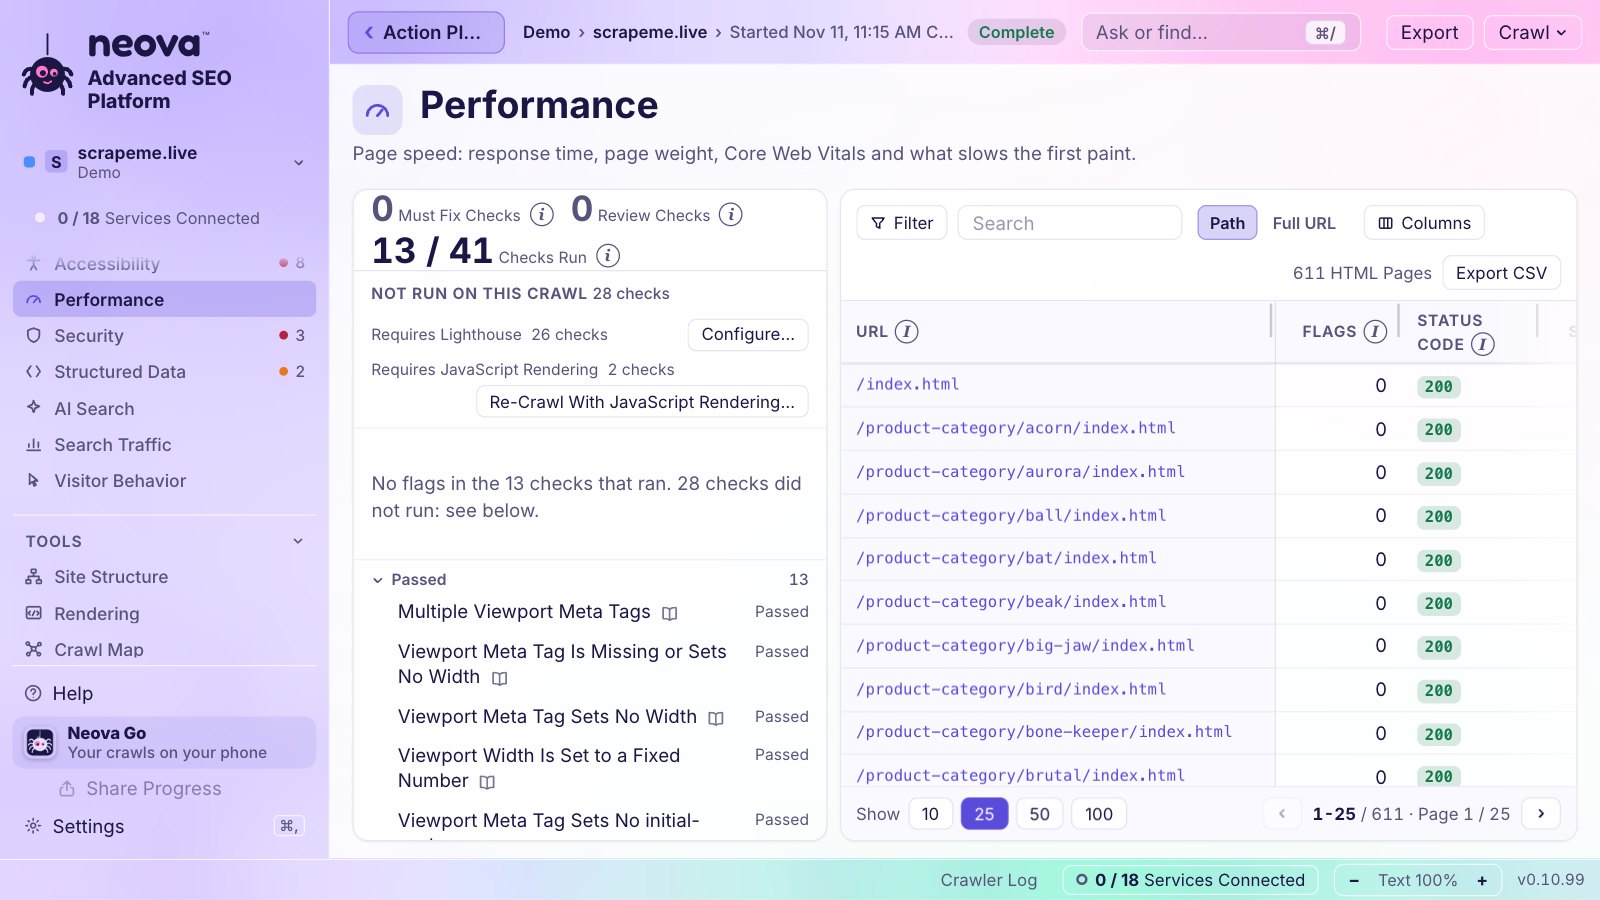
页面速度:响应时间、页面大小、Core Web Vitals 以及拖慢首次绘制的因素。
抓取期间,对每个页面组的一个 HTML 页面运行 Lighthouse 实验室检查。
使用您的 Chrome UX Report 密钥,获取手机端真实 Chrome 用户的 LCP、INP 和 CLS(第 75 百分位)。
第一天就从 Chrome UX Report History 绘出约 40 周的实测数据,每周一个点,并标出 Google 的「良好」和「较差」线。
每个页面组中获得链接最多的 HTML 页面的 LCP、INP 和 CLS,慢的模板一眼就能看出来。
无需抓取,即可读取源站、每个页面组中链接最多的 URL 以及全站链接最多的 10 个 URL 的 Chrome UX Report 数据。
自动拍摄快照,默认每天一次,也可以每周或每月,窗口关着也照常运行。
按 Google 的阈值,当某项指标评级变差或恢复为「良好」时发出警报。
并排显示最新的几次读数及其日期,按「良好」「需要改进」或「较差」着色。
为每次快照设定每个页面组 0 到 3 个 HTML 页面,并说明会用掉多少次 Chrome UX Report 请求。
「网站诊断」级别会在抓取之后从 Chrome UX Report 读取 Core Web Vitals。
每次快照都保存在您的电脑上,超出 Chrome UX Report 显示的 28 天也不会丢失。
标记未开启文本压缩、CSS 和 JavaScript 未精简、缓存有效期过短,以及没有 ETag 或 Last-Modified 的页面。
标记阻塞渲染的请求、过长的主线程任务、未使用的 CSS 和 JavaScript、旧版 JavaScript、HTTP/1.1 资源文件、缓慢的第三方资源,以及低于 50 分的 Lighthouse 得分。
标记服务器响应慢、CLS 超过 0.1,以及实验室或实测数据中超出良好范围的 Core Web Vitals。
标记 JavaScript 渲染耗时超过 4 秒的页面。
标记缺失或固定宽度的视口、禁止缩放,以及在手机上小于 12 CSS px 的文字。
抓取运行时的响应时间中位数、九成请求的响应时间和最慢响应时间,并列出最慢的 10 个页面。
哪些因素让使用辅助技术的人无法使用每个页面:名称、标签、ARIA、地标、标题、表格和表单。
开启渲染时,运行 axe-core 规则和访客模拟测试:对比度、键盘焦点、焦点陷阱、200% 缩放、320 px 重排和 24 px 触控目标。
标记没有无障碍名称的按钮、链接、表单字段、图片、对话框和框架,以及仅靠 title 命名的字段。
标记无效的角色和属性、缺失的必需属性、错误的父级或子级角色,以及已弃用的角色。
标记没有 main 地标、地标重复或嵌套、标题层级跳级,以及无法跳过重复区块的页面。
标记没有表头单元格、scope 和 headers 无效的表格,以及结构错误的列表或定义列表。
标记缺少焦点指示、焦点陷阱、正值 tabindex、不能保持焦点的对话框,以及无法用键盘访问的可滚动区域。
标记对比度不足的文字、未达到增强对比度的文字,以及只靠颜色区分的链接。
标记禁止缩放、200% 缩放时文字被截断、320 px 宽度下内容被截断、屏幕方向锁定,以及小于 24 px 的触控目标。
标记没有字幕或音频描述的视频、没有替代内容的无声视频,以及没有文字稿的音频。
标记没有标签或有多个标签的字段、无效的 autocomplete 值、禁止粘贴的字段,以及没有文字说明的错误提示。
由本地模型阅读页面,完成 7 项需要判断的检查,例如没有文字替代内容的图表。
AI 爬虫可以获取什么、它们获得什么内容,以及 AI 回答如何引用该网站。
以 10 个 AI 代理(ChatGPT、Claude、Perplexity 及其爬虫、Meta AI、Google-Extended、Common Crawl)的身份请求抽样页面,显示谁能完整访问,以及 robots.txt 允许什么。
评估已发布的 llms.txt、通过 Accept 请求头提供的 Markdown 版本、代理发现清单和 WebMCP 工具;没有这些的网站不会被标记。
标记拦截 AI 搜索爬虫或限制摘要的关键页面,以及与您书面政策不一致的 AI 规则。
标记为空或包含不到一半正文的 Markdown 版本。
标记在正文前 5,000 个字符之后才开始的主要内容。
标记覆盖在按钮和字段上的隐形遮罩层、难以看清的任务控件,以及没有标注日期的 Google UCP 或 OpenAI ACP 代理结账决策。
标记禁止 Applebot 的关键页面,以及被拦截的用户触发型 AI 获取工具。
根据 Bing Webmaster Tools,标记下降的 Bing AI 引用,以及 Bing AI 从未引用的关键 URL。
根据 Google Analytics 4,报告 AI 引荐的会话及其互动情况,并与自然流量对比。
通过您的 DataForSEO 账户,向 ChatGPT 和 Perplexity 提问最多 20 条您的提示词,报告品牌提及、被引用的 URL,以及取而代之被引用的第三方网站。
每次诊断都说明每个跟踪的搜索词是否出现 AI 概览,以及它是否引用了您。
以 GPTBot、OAI-SearchBot、ChatGPT-User、ClaudeBot、PerplexityBot 和其他 AI User-Agent 抓取。
根据服务器日志,按 URL 显示经过验证的 AI 爬虫访问和被拒绝的请求。
在每个 HTML 页面上运行您自己的提示词(meta description 草稿、FAQ 创意、搜索意图、主要实体),可用您电脑上的 Ollama,或您的 Anthropic、OpenAI、Google Gemini 密钥,结果以列的形式呈现。
通过 Ollama 用本地模型在各类别中运行 44 项需要判断的检查;数据不离开电脑,它的标记也不计入统计。
AI 助手的获取情况、AI 概览、各 AI 助手获取到的内容,以及经过验证的爬虫的请求。
对每个跟踪的搜索词,通过 DataForSEO 加载 3 次 Google 的 AI 概览,报告其中有多少来源排在第一页、您的页面是否排在第一页,以及 AI 概览是否引用了它,作为一条「值得关注」标记。
每个页面上的 Schema 标记:有效、有警告或有错误,以及「Schema 类型」列。
为 URL 上的每种 Schema 类型给出结论。
标记缺少其所在页面组普遍具有的结构化数据或富媒体搜索结果类型的页面。
标记页面上没有显示的商品价格、已过期的优惠、不一致的日期,以及缺失的必需属性。
标记有语法错误、缺少必需或推荐属性,或文本与页面不一致的结构化数据。
标记缺少识别属性的 Organization 或 Person 标记。
检查 Speakable 选择器、未设置 isAccessibleForFree false 的付费墙页面,并将 HowTo、QAPage 和 FAQ 标记与页面内容对比。
标记无效的富媒体搜索结果,以及 Google 报告的 AMP 或富媒体搜索结果错误。
通过 DataForSEO,将 Organization 标记与 Google 商家资料进行对比。
HTTPS、混合内容以及每个页面发送的安全响应头。
列出每个 URL 发送的安全响应头。
标记 HTTP 页面、从 HTTPS 到 HTTP 的重定向、无效或即将过期的证书,以及 TLS 1.0 或 1.1。
标记没有 integrity 哈希的外部脚本和样式,以及通过 HTTP 提交的表单或密码字段。
标记缺少 Content-Security-Policy、Strict-Transport-Security、nosniff、点击劫持防护或 Cross-Origin-Opener-Policy,以及不安全的 Referrer-Policy。
标记加载 HTTP 或协议相对路径资源、或链接到 HTTP 页面的 HTTPS 页面。
标记暴露服务器或框架的响应头,以及与文件不符的 Content-Type。
标记未覆盖通过 SNI 发送的主机名的证书。
开启渲染时,标记页面加载时出现的第三方 Cookie 和权限请求。
在您的浏览器里通过 Google 自己的页面登录,只读,把点击、展示和 CTR 关联到每次抓取的每个 URL。
用同一个 Google 登录连接,把访问和互动数据关联到抓取的页面,供分析类检查项使用。
每个 Google 账号保留一次登录,每个网站使用该资源所属的账号。
询问每个网站对应哪个 Google Search Console 和 Google Analytics 4 资源,并预先选好网站自己的资源。
29 项检查把 Google 数据与抓取关联起来,例如仍有点击的 noindex、已重定向或 4xx URL。
标记互动时长不超过 10 秒、跳出率 80% 及以上、表单没有关键事件,以及自然搜索会话低于近期常态 70% 的自然搜索着陆页。
标记多个 URL 分摊展示的搜索词,以及首页或不可索引 URL 占大部分展示的搜索词。
按搜索结果呈现方式报告展示和点击。
标记重复加载两次的 GA 或 GTM ID,以及没有 GA 或 GTM ID 的可索引 URL。
按所标记 URL 的点击量给检查项排序,让损失流量的标记排在最前。
Google 在 16 个月后删除 Google Search Console 数据,Neova 把每个月的数据留在您的电脑上,提供「立即归档」和每月计划。
用图表对比最近 28 天与之前 28 天的每日点击和展示。
带来点击的搜索词,附展示和排名。
每个资源每天从 Google Search Console 跟踪最多 25 个搜索词:7 天和 90 天的排名、变化、点击和展示,并推荐排名第 4 到 20 位的搜索词。
每次抓取最多检查 200 个 URL,先点击最多的,再链接最多的。
来自 Google Discover 的点击和展示,随每个归档月份一起保存。
把 Google 近两年的排名更新和事故标在您的每日点击图上,并给出每次前后的点击。
来自 Bing 的点击、查询、抓取错误和已索引 URL,使用您的 API 密钥,并可用「测试」列出您的网站。
通过您自己的 DataForSEO 账号获取排名、AI 回答、竞争对手和反向链接,按请求付费。
每个跟踪的搜索词在前 20 名中的真实移动端排名,旁边是表现最好的竞争对手。
竞争对手排进前 20 而您没有的搜索词,附搜索量。
抓取后才连接的服务,会被读取并在那次抓取上重新运行它的检查项,无需重新抓取。
在状态栏、侧边栏的资源下方和仪表盘的一个区块里显示已连接的服务数量,点击都会打开「连接」。
列出每个连接为一个资源发出的请求数,并与 Google 的配额对照,全部使用您自己的密钥和账号。
Google 的 API 无法读取 Search Console 的「安全问题」和「人工处置」报告,所以每次抓取都附上该资源这两份报告的链接,方便您手动打开。
把资源与竞争对手最近一次可用的抓取并排对比,每项指标按领先和落后着色,并显示与最佳竞争对手的差距。
列出竞争对手领先的指标,差距最大的排在最前,每个数字都附上背后的检查项。
原样粘贴整份名单即可:直接竞争对手作为主要(最多 5 个),间接竞争对手作为次要,一步排好它们的抓取队列。
先读取每个竞争对手的 XML 站点地图,默认抓取 750 个 URL;站点地图列出更多时,可选 1,000、2,500 或 5,000。
通过 DataForSEO 找到在相同搜索词上有排名的网站,并分为主要和次要。
从不把商店、外卖应用或电商平台推荐为竞争对手;您仍可手动添加。
竞争对手迁到另一个域名时,去它首页现在所在的地方抓取。
为资源的竞争对手建议一个「<资源> | Competitors」子资源组合,并让它始终与该资源绑定。
只计算每次参与比较的抓取都能判断的检查项,也不拿中途截断的抓取做排名。
资源和每个竞争对手的排名搜索词数、前 10 名、预估访问量和引用域名,一次次诊断持续记录。
资源及其竞争对手的引用域名和反向链接,来自 DataForSEO Backlinks。
在每个资源下方列出它的竞争对手,用条形图对比 URL 数、标记数和每个 URL 的标记数。
一份月历,显示所有已完成和将要进行的抓取与计划运行,可按资源筛选。
每天、每周、每 N 周或每月自动运行的整站抓取,使用资源的设置,窗口关着也照常运行。
按计划归档 Google Search Console 数据,默认每月一次。
添加计划抓取之前就告诉您它的费用:每次运行的 URL 数和每月的运行次数。
计划抓取开始前 15 分钟发出通知,并说明它会在窗口关闭时运行。
把某一次运行推迟 1、3、6 或 9 小时,或改到某个日期和时间,也可以跳过,计划本身的节奏不变。
在计划抓取运行时安全地停止它,并给它安排新的时间。
由计划程序每月重复一次完整诊断;Neova 下次打开时完成分析和 PDF。
在以下情况发出警报:Core Web Vitals 评级变化、最近 7 天的点击下降 20% 或更多、跟踪的搜索词跌出或进入前 10 名或下降 3 位,或者新的抓取出现新的标记。
保留最近 300 条警报,提供「立即检查」和「清除警报」。
窗口关闭后 Neova 仍在菜单栏中运行,时钟旁显示抓取进度。
保留程序坞图标,或者只留菜单栏图标。
登录时启动 Neova,窗口保持关闭。
扫二维码即可添加到主屏幕的手机页面:每个资源的最近一次抓取、Core Web Vitals、Google Search Console 点击、跟踪的搜索词、下次运行和进行中的抓取,在离开 Mac 之前就已加密。
抓取运行时 Mac 每 2 分钟发送一次摘要,其余时间每 15 分钟一次;手机每 2 分钟检查一次,并显示数据有多旧。
为一次正在运行的抓取生成链接,任何人都能跟踪进度并知道何时结束;链接有自己的密钥,不泄露其他任何内容。
任何人都能打开的实时界面副本:进度、URL 构成、最新 URL、实时抓取地图、响应时间、重定向和错误、检查项以及链接与动态。
共享页面可以在抓取结束时通知读者。
整次抓取中每个 3xx、4xx、5xx 和无响应分组,每组最多 100 个 URL,链接最多的排在最前。
通过 Incoming Webhook 把警报和每次抓取的结束情况发到一个或多个 Slack 频道,并用一条测试消息确认可用。
通过 Workflows Webhook 把警报和每次抓取的结束情况发到 Teams 频道。
每个资源组合或资源的消息发到各自的频道。
Neova 不在前台时抓取结束,会发出系统通知,提示音可选。
列出 Neova 当前在做的一切:抓取、诊断、运行检查项、计划抓取和队列,每项都带有打开它的按钮。
每个有前值的计数都显示自上一次可比抓取以来的变化。
只获取一份页面列表,不做发现,并在状态码、重定向目标、title、canonical、noindex、H1 和大小变化时发出页面警报。
抓取状态一目了然:抓取摘要、首要检查项、后续行动、状态码和与上一次抓取相比的变化,每个数字都能打开对应的列表。
每项有标记的检查:严重程度、已标记 URL 占已检查 URL 的数量、其中可索引的有多少、自上一次抓取以来的变化、类别和点击。
每项检查都写明「标记条件」「通常意味着什么」和「您可以做什么」,附上 ID、来源和「关于此检查项」,后者会打开它在检查项库中的页面。
所有 URL,带列组合、任意列筛选、已保存视图、列选择器、冻结的 URL 列,每页 10、25、50 或 100 行。
每个表格和网格都能把显示的内容导出为 CSV。
每一列、每个计数和每张卡片都有 ⓘ,说明它统计的是什么。
8 个分组、13 个标签页,由 39 个区块组成:摘要、性能、技术、Core Web Vitals、内容、关键词、AI 搜索、社交、竞争对手、算法更新、工作流、程序和报告。
最多 10 个自己的仪表盘,可以新建或从某个标签页复制,区块可添加、移动、调整大小和删除。
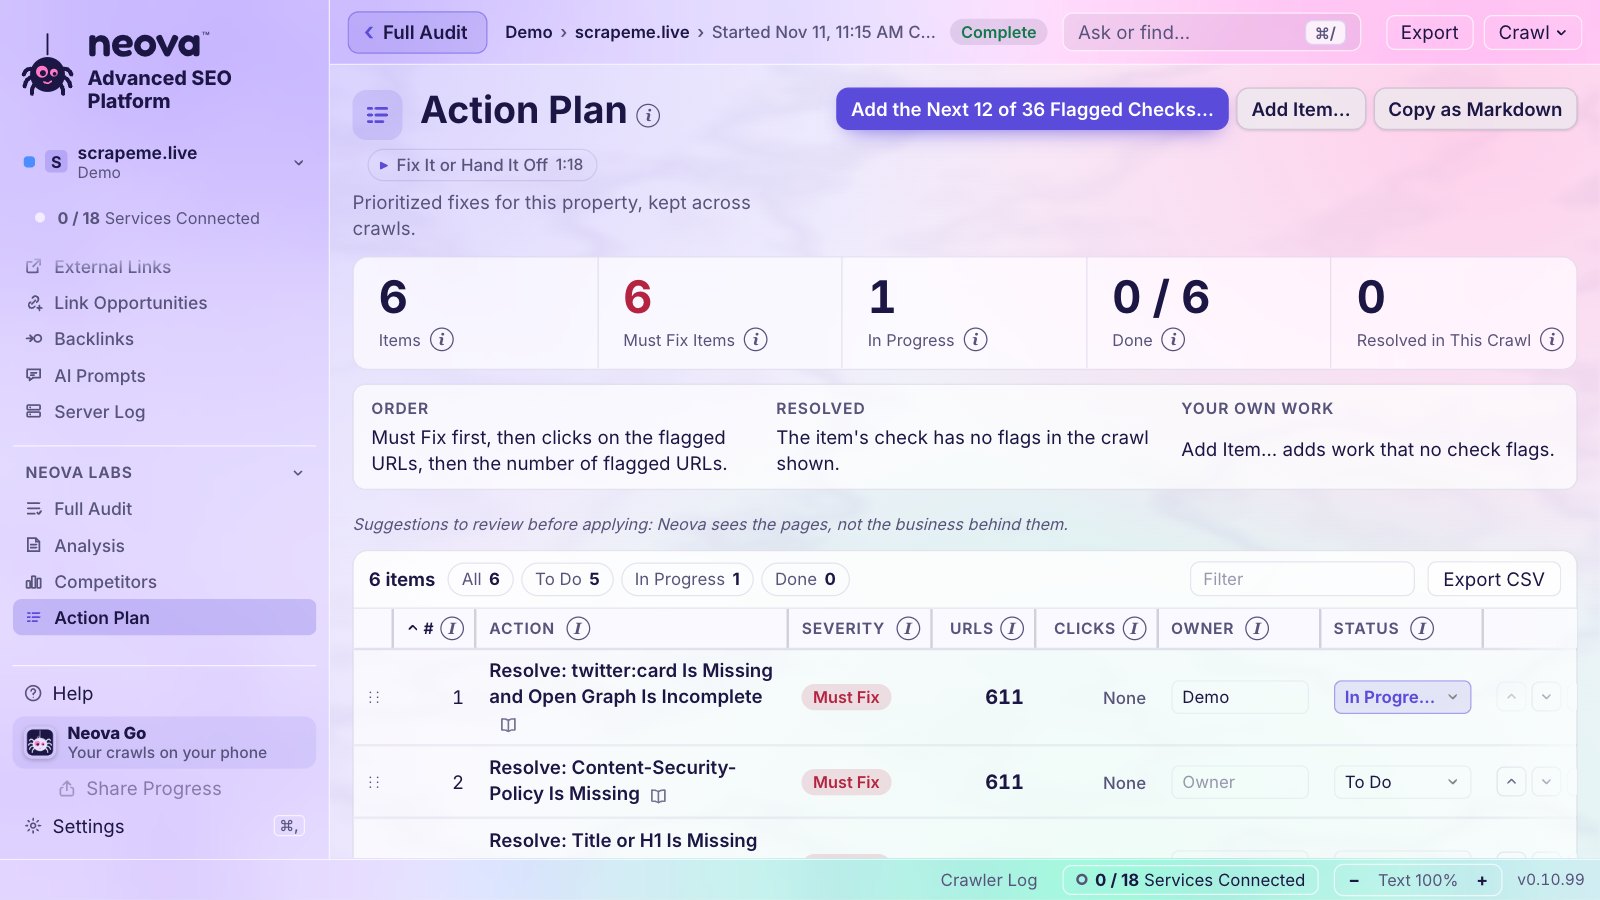
把行动计划按状态和负责人排成一个项目,每一项的检查及其在最近一次抓取中的标记一并列出;标为「完成」但仍被标记的项会显示为红色。
每项检查和页面组各一张工单,「必须修复」排在最前,附规则、证据、受影响的 URL、完成标准、检查方法和修复位置(一个分组 90% 被标记时,指向模板)。
之后的抓取按工单的键关闭、保留或重新打开每张工单,从不删除。
每张工单都以资源代码开头,例如 [DRH],并作为标签带到 Jira 和 Linear。
在您的 Jira Cloud 项目中为每张 Neova 工单创建一个 Jira 事项,带优先级、标签和附加的 URL 列表,从不重复创建。
每次从窗口运行完整抓取后,把已消失的工单移到 Done,重新打开又出现的工单,并更新其余工单。
按各工具自己的 CSV 导入格式生成的文件:Jira、Linear、Asana、ClickUp、monday.com、Azure DevOps Boards、Notion、Airtable、Smartsheet,以及 Basecamp 的 Markdown 待办文件,每个都附上导入页面。
一份带有您的名称、标志和颜色的客户报告:抓取数据概况、按类别列出的标记、优先修复的内容及示例 URL、渲染和 AI 可见性、与上一次抓取相比的变化以及抓取方式,Letter 或 A4 纸张;同一系列的检查项只计一次,第二项列为「另被标记」。
让每个客户在报告上有自己的名称、标志和颜色,附「报告对象」「编制者」和备注。
一个工作簿:摘要、按修复顺序排列的工单、按页面组、每项检查一张工作表(列出点击最多、再按链接最多排序的 1,000 个 URL),以及所有标记。
每个返回 200 的 HTML 页面,最多 200,000 个,附 title、description、H1、canonical、可索引、深度、内链入、站点地图、大小、响应时间、点击和标记。
把工作簿发送到您的 Google Drive,并转换为 Google Sheets。
一个 ZIP 包含您勾选的内容:PDF、详细版或简版工作簿、工单及其 URL 列表、Jira 和 Linear 文件,以及每项检查一个 CSV 的全部已标记 URL,另附 README。
URL、标记和工单的 CSV 文件,适用于 CSV、Excel(带 BOM 的 UTF-8)、Google Sheets 和 Looker Studio。
抓取未开启渲染或只覆盖了网站的一部分时,每份导出都会附上说明。
默认把导出保存到“下载”中的 Neova 导出文件夹。
把导出保存到您在电脑上选择的文件夹。
通过 Google Drive 自己的接口,上传到登录 Neova 的 Google 账号中的 Neova 导出文件夹,覆盖同名文件,让它的分享链接继续有效;Neova 只能看到自己创建的文件。
保存到 Mac 上 Google Drive、OneDrive、Dropbox、iCloud Drive、Proton Drive 和 kDrive 应用同步的文件夹(Windows 上为 OneDrive、Dropbox 和 Google Drive),每个账号在您开启之前都是关闭的。
通过 SFTP(密码或密钥文件)、FTPS 或普通 FTP 把导出上传到您自己的服务器,保存前先试连,并记住服务器的密钥。
每个资源组合或资源的导出保存到各自的文件夹或磁盘。
在 Neova Online 中,Chrome、Edge、Vivaldi、Brave 和 Arc 可以把导出直接写入您电脑上的文件夹;其他浏览器则下载。
在 Neova Online 中,CSV 数据表或 Markdown 页面这类文件夹导出会下载为一个 ZIP。
为一个资源组合或资源生成一个只读链接,包含您勾选的抓取、行动计划、分析、竞争对手和文件,在您的电脑上加密,密钥只随链接传递;「更新」保留原地址,「关闭」将其删除。
按顺序要做的事:根据抓取起草(先「必须修复」,再按点击,再按影响范围),由您重新排序和改写,可添加自己的项,带状态、负责人和备注,跨抓取保留。
把计划复制为 Markdown,或导出为 CSV。
在您的电脑上撰写完整诊断:现状、按优先级排列的标记、搜索可见性、跟踪的搜索词、关键词差距和按优先级排列的行动都已填好,只有人才能写的部分标为「待撰写」。
把您添加的报告(Markdown、文本、PDF 或 Word)与资源一起保存,可「标为已审阅」。
打开一封写给 Neova Labs 的邮件,已填好抓取的数据,用于检查项写不了的部分。
一次跑完所有步骤:开启全部检查项的抓取、Google、Bing 和 Analytics、Core Web Vitals、竞争对手及其抓取、DataForSEO 搜索数据、行动计划、分析和品牌 PDF。
「运行完整诊断」会询问是读取最近一次抓取还是重新抓取,并显示它的 URL 数和所用时间。
抓取 A 对比抓取 B:新增、移除和变化的 URL,新增和已解决的标记,抓取 B 按变好或变差着色。
为资源保留超出各数据源自身保留期限的所有内容:每次抓取、每个月的 Google Search Console 数据、每份 Core Web Vitals 快照、robots.txt 各版本、XML 站点地图和 URL 变化。
每条建议、每张工单和每份报告都注明应用前需先核实,因为 Neova 看到的是页面,而不是页面背后的业务。
计划抓取会把结束情况发到 Slack 和 Teams,每月完整诊断会在 Neova 下次打开时生成 PDF;目前还不会按计划写出导出文件。
PDF 报告和工作簿会说明页面如何渲染(整体、按页面组和逐页)、robots.txt 允许每个 AI 爬虫获取什么、服务器实际返回给它什么,以及哪些 AI 搜索检查项通过或被标记。
根据抓取为 Sheets 专门生成的 Google Sheet:带图表的概览、带「负责人」「状态」「截止日期」下拉菜单的行动计划、问题、URL、标记、页面组、重定向与错误、渲染与 AI 以及关于,每次都作为新文件保存到您的 Google 账号。
Neova 根据抓取生成的每个文件(客户交付包、PDF、工作簿、Google Sheet、导出、Neova 文件)都会列出保存位置、所属抓取、日期和大小,并提供「打开」「打开文件夹」「复制路径」和「在 Google Drive 中打开」。
同样的 Neova 窗口,在浏览器中通过 app.neova.app 打开,引擎运行在 Neova 的服务器上,抓取和检查都在那里完成。
账号通过邀请链接开通,链接可指定姓名或不指定,一个链接对应一个账号。
密码以哈希形式存储,登录自上次访问起保持 30 天,连续输错 10 次密码需等待,拒绝来自其他网站的请求,在其他应用的内置浏览器中打开页面时会给出提示。
每个人的抓取、数据和下载都在各自的文件夹中,其他人永远无法读取。
Neova Online 测试期间:每人同时运行一个任务,每次抓取 10,000 个 URL,每秒 10 个 URL,每个账号 10 GB 抓取数据。
在浏览器中连接 Google Search Console、Google Analytics 4 和 Google Drive,登录信息保存在您自己的空间里。
密钥和 Webhook 保存在您的 Neova Online 账号中,保存后不再显示。
每个新账号都从一个演示开始:一家测试商店和三个已抓取好的竞争对手,带资源组合设置、代码和行动计划,一步即可删除。
邀请可以附带从另一个账号复制来的资源组合,包括其最近的抓取、设置和计划;准备期间会显示一条横幅。
窗口适配手机和平板:侧边栏变成抽屉,面板以单栏占满整个屏幕,表格可横向滚动。
桌面应用只需登录 Neova Online 一次;应用为这台电脑保存一个密钥,从不保存密码。
自动同步资源组合、竞争对手、您的排序、Google Search Console 和 Google Analytics 4 的选择、颜色和代码。
一方已包含另一方的内容时,登录后立即合并,不再询问;两边确实不同时,会询问从哪边开始:「保留 Neova Online 的」「保留这台 Mac 的」或「合并两边」(推荐,不会丢失任何内容),并显示两边各自的数量,且先留一份备份。
以可续传的分段上传或下载整次抓取,结束时校验,可与正在运行的抓取同时进行。
把在这台电脑上结束的每次抓取发送到 Neova Online;默认关闭。
Neova Online 在下次加载页面时就显示新部署的版本,从不显示缓存的旧窗口。
为测试者提供安装程序和教程视频,设为 noindex。
输入密码后,把您的 Neova Online 账号保存的连接密钥带到这台电脑,或把这台电脑的密钥发送到账号;每个密钥只显示最后 4 个字符,除非勾选「替换」,否则从不覆盖已有密钥。
每个 Neova Online 账号可保存 10 GB 抓取数据;「设置」中显示账号已用多少空间和多少次抓取,用到 85% 时开始提醒,超出空间的上传或抓取会被拒绝,并说明该怎么做。
Mac 版 Neova SEO Platform,引擎以原生代码内置,在您的电脑上抓取。
为您自己的账户安装的 Windows x64 安装程序,无需管理员密码;测试版本,尚未签名。
在 Windows 上,应用会说「这台电脑」,所有 ⌘ 快捷键都改用 Ctrl。
Linux 桌面应用:适用于 Ubuntu、Linux Mint 和 Debian 的 .deb,以及无需安装的 AppImage。
界面和检查项库支持英语、法语、德语、西班牙语、葡萄牙语(巴西)、意大利语、日语、荷兰语、波兰语、土耳其语、韩语、简体中文、俄语、印尼语和越南语。
Neova 大理石(默认)、Neova、macOS、Liquid Glass、Windows 11、Linux、Terminal 和 高对比度;外观风格只改变颜色,从不改变各项的位置。
浅色、深色或跟随系统设置,并可选强调色。
紧凑或宽松的行距,文字可用 ⌘+ 和 ⌘− 缩放。
在每个表格中,URL 显示为路径,或带协议和主机名的完整地址。
按您的习惯或所选语言的习惯显示日期和时间。
显示或隐藏「主页」一行;无论哪种,点击左上角的 Neova 名称都会打开主页。
⌘N 新建抓取,⌘K 搜索资源,⌘, 设置,⌘[ 返回,⇧⌘P 演示模式,⌘/ 提问或查找。
一个输入框即可找到视图、按标题或 ID 查找检查项、抓取中的页面、资源或设置,并保留最近的选择。
较长的问题交给您电脑上的模型,它从窗口已显示的内容中挑选答案,因此从不编造数字。
除当前打开的资源组合外,其他全部模糊处理,方便与客户共享屏幕。
回到上一个界面,按钮上会写明它的名称。
统一的焦点框,每一行都能用 Tab 到达,表格内可用方向键,面板作为对话框,并尊重「减少动态效果」设置。
把侧边栏、检查项列表和详情窗格拖到您想要的宽度。
抓取运行时退出会询问一次,然后保存抓取并显示保存步骤和进度,之后用「继续」接着抓取。
列出在后台运行的计划抓取,并在退出前提出停止并保存它。
Neova 更新时正在运行的抓取会自动保存,之后用「继续」接着抓取。
停止时只追加新的 HTML,并用进度条显示每个保存步骤,附「立即关闭」。
抓取期间监控剩余磁盘空间,接近不足时发出提醒,低于 3 GB 时安全停止,腾出空间后可用「继续」接着抓取。
因崩溃或管道关闭而中断的抓取会列为「已中断」,从不丢弃,其存储会被安全回滚。
窗口隐藏时,队列和诊断照常运行。
应用打开时、每 30 分钟以及窗口回到前台时,向 app.neova.app 检查是否有新版本,只发送版本号。
每次更改后把窗口的设置复制到一个文件中,每个版本一份备份,窗口的存储被重置时自动恢复。
更改 Neova 保存抓取数据的位置。
从 64 px 起,图标在蜘蛛下方显示 Neova SEO 字样。
有新版本时,左上角、工具栏、「帮助」菜单首项和「设置 › 常规」中都会显示「有新版本」,并附「下载」;应用每 30 分钟以及窗口回到前台时检查一次。
每个表格都按内容调整列宽,把剩余宽度留给 URL 列以及最先被截断的列;每个列标题都有可拖动的手柄,双击自动适应,您设定的宽度会被保留。
可选的动画吉祥物,共 8 个可选(Webster、The Head、Sir Canonical、Polly Glot、Hopper、Shelly、Bo、Zap),可爱或像素风,替您盯着抓取;默认为“无”,选“无”时不加载任何内容。
抓取需要您时弹出对话气泡:抓取结束时报告必须修复的检查项及新增数量、抓取停止或失败、网站屏蔽了爬虫、磁盘快满了、计划抓取开始;点击即可打开它提到的界面。
点击宠物,它会告诉您 Neova 正在做什么;打开某次抓取时,还能回答关于这次抓取的问题,回答走的是提问栏的同一条路径(您电脑上的 Ollama 或您自己的 AI 密钥)。
选择“在桌面上”时,宠物有自己的窗口,位于所有窗口之上、出现在每个桌面空间,不占程序坞;Neova 最小化时仍在后台监看,点击即可回到正确的界面。
从极小(56 px)到超巨大(320 px)共七档,默认为大;宠物下方有工具栏:打开 Neova、新建抓取、进行中和更多(隐藏、设置、静音),可设为悬停时显示或始终显示。
抓取数据在 Mac 上保存在 Application Support/Neova,在 Windows 上保存在 %APPDATA%/Neova;除非您同步或分享,否则不会发送任何内容给 Neova。
每个密钥、令牌和登录信息都通过引擎的标准输入存入系统钥匙串,从不写入文件、命令行或显示在屏幕上。
应用不带 Neova 的任何密钥:Google、Chrome UX Report、DataForSEO 等都使用您自己的密钥和账号。
引擎以原生代码发布,不含可读的源代码。
Google 以只读权限范围加上您的邮箱地址连接;「断开连接」会在 Google 端撤销令牌。
除非在「新建抓取」中为该次抓取开启,否则 DataForSEO 处于关闭状态。
点击「开始」之前,根据 DataForSEO 对这台电脑最近 20 次同类调用的实际收费估算费用,没有记录时按其价目表,向上取整到下一个 $0.50 或整美元。
达到您设定的上限后就不再向 DataForSEO 发出请求,每次抓取 $0.50 到 $10,默认 $1。
完整诊断的搜索数据按其单独的美元上限停止,并说明花了多少。
服务器日志在您的电脑上读取;任何地方都不会写入 IP 地址。
「AI 审查」和「提问」通过 Ollama 使用您电脑上的模型,因此数据不会离开电脑;「AI 提示词」会说明何时把页面文本发送给您选择的服务商。
分享链接、Neova Go 和分享进度都在您的电脑上加密,密钥只在链接或二维码里,因此服务器存储的是它自己无法读取的内容。
分享您打开了哪些术语表页面的功能默认关闭,开启后只发送一个随机 ID、检查项和语言。
删除的抓取会进入废纸篓,可以恢复;还可以批量选择已停止的旧抓取。
NeovaBot 表明自己的身份,遵守 robots.txt,默认每秒 3 个 URL,从不破解验证码。
把一次抓取、一个资源(含所有抓取和数据)或一个资源组合保存为一个 .neova 文件,可带或不带存储的 HTML,保存到“下载”、Google Drive、任意磁盘或文件夹;计划、连接、密钥和密码从不包含在内。
安装在任何 Mac、Windows 或 Linux 电脑上生成的 .neova 文件,在写入任何内容之前说明哪些是新的、哪些已存在、哪些会以另一个名称导入,从不覆盖这台电脑上已有的内容。
neova 命令可以在终端或脚本中抓取、导入、发布,并读取网站、页面、标记、工单和警报,输出为表格、CSV 或 JSON。
neova check 把一次抓取与基线对比,出现新的标记,或某条标记涉及的 URL 超过设定比例时,以退出码 3 退出。
通过 16 个工具让 AI 助手读取您的抓取、标记、工单和设置,数据始终留在您的电脑上。
一键把 Neova 添加到 Claude Desktop,并为 Claude Code、Codex、Cursor、VS Code、Gemini CLI、LM Studio、Windsurf 和 ChatGPT 提供可复制的配置。
从助手启动、停止和删除抓取,每次启动和删除都要先征得您的同意。
读取抓取日志,指出哪里出了问题(连续的 429 或 503、403、robots.txt 屏蔽、仅靠 JavaScript 的页面、页面过少),并给出要改的设置。
一个普通的 JSON 文件,保存排除列表、默认值,以及每个资源的设置和检查项开关。
打开 Screaming Frog 的 Internal 导出(含 All Inlinks)、Sitebulb 的 URL 导出、SiteOne Crawler 的 JSON 或任何带 URL 列的 CSV,并在上面运行 Neova 检查项。
以每秒 2 个 URL 重新获取 50 个 URL 的样本,并对照线上的站点地图,为导入评分,导入因此从不冒充一次抓取。
Neova Online 的 HTTP API,地址为 app.neova.app/api/v1:读取资源组合、资源、抓取、标记和工单,启动抓取,管理工单;每个脚本使用自己的 Read Only 或 Read-Write 密钥,每个密钥每分钟 60 次请求,每个账号 20 个密钥。
根据网站自己的访问日志,按抓取中的每个 URL 统计搜索引擎和 AI 爬虫的请求。
只有当请求的地址在其所属公司公布的列表上时,才计为 Googlebot、Bingbot 或 AI 爬虫的请求;在别处冒用的名称单独统计。
列出在日志时间范围内 Googlebot 从未访问的 HTML 页面,以及爬虫请求过但抓取中没有的 URL。
统计每个爬虫收到的 429 和 403 响应。
读取 Apache 或 Nginx 的 combined 日志,未压缩或 gzip 压缩均可。
对于使用 Cloudflare 的网站,在您自己的 Cloudflare 账号中收集搜索引擎和 AI 爬虫的请求,并在每次抓取前读取,无需服务器访问权限。
写好发给 IT 的请求:只要爬虫的日志行,无需安装任何东西,以及安全团队需要了解的内容。
仪表盘中显示爬虫请求的一个区块。
把旧网站抓取中的每个 URL 与新网站抓取匹配,并给出置信度,适用于同域名或跨域名迁移。
对照映射表检查每个旧 URL 的线上重定向,并标记错误或缺失的重定向。
把预发布抓取与生产环境对比:状态码、noindex、canonical、title、meta description、H1,以及只出现在其中一次抓取中的 URL。
交换哪次抓取是旧的、哪次是新的,或哪次是预发布、哪次是生产环境。
在您确认属于自己的网站上忽略 robots.txt 并加快速度,支持 HTTP 身份验证和自定义请求头。
抓取一份旧 URL 列表,检查每个 URL 最终跳转到哪里。
预发布子域名的起始页大多链接到正式站点时,「新建抓取」会显示数量,一键添加 URL 重写规则和正式站点的 XML 站点地图;如果添加的 XML 站点地图没有规则把它映射到该网站,会在抓取开始前标记出来。
您的每个资源都是一个区块,带它的颜色、标志和关键数字,竞争对手作为行排在下方。
把资源拖成您自己的顺序,在 Mac、在线版和手机上都保持一致。
把一个组合折叠成一行,提供「全部折叠」和「全部展开」,以及按 / 即可进入的固定搜索框。
列出所有资源的表格,每个竞争对手嵌套在其资源下方。
每个网站一个中心:它的抓取、交付给客户、Core Web Vitals、Google Search Console、竞争对手、行动计划、分析和计划。
品牌报告(PDF)、所有标记工作簿(Excel)和工单,每项一个按钮,基于当前打开的抓取生成。
资源页顶部的每个按钮都说明它的作用,以及与另一个按钮的区别。
按客户或公司对资源分组,可设颜色,子资源组合最多一层。
为每个资源设置一种颜色和一个 2 到 6 个字母的代码,代码根据其域名建议。
用 ⌘K 查找资源:已固定和正在运行的排在最前,每个资源组合下列出其资源和竞争对手。
该资源最近的五次抓取及各自的结果,点一下即可打开。
勾选要删除的抓取,或用「选择较早的已停止和已中断抓取」,然后点击「删除所选」。
每个列表行都有一个主按钮,另有 ⋯ 和右键菜单列出全部操作,「删除」排在最后,显示为红色。
app.neova.app/checks 上的检查项库、Neova SEO Platform 帮助、新功能、报告问题、键盘快捷键和检查更新。
下载、安装、第一次抓取、Neova Online 与桌面应用、可选连接和更新日志,都在 app.neova.app/help。
app.neova.app/checks 按分组列出全部 694 项检查,每项都有自己的页面和来源;凡是提到检查项的地方,都能通过「关于此检查项」打开。
只提示一次:Neova 的结果是供参考的自动化分析,改什么由您决定。
每个检查项窗格都有「关于此检查项」,点击即可打开该检查项在检查项库中的页面,说明它标记什么以及来源。
从第一个版本起的每个版本,最新在前,每项改动标为「新增」「改进」或「已修复」,发布时间按您的时区显示;更新后会自动打开一次;顶部的「即将推出的功能」列出计划中的内容。
为支持团队生成一个 ZIP,包含应用的版本信息、所选抓取的日志和小文件,密钥已遮盖;生成之前会说明其中包含什么、绝不包含什么。
没有与该搜索匹配的功能。