Crawl nhiều website cùng lúc và xem trực tiếp
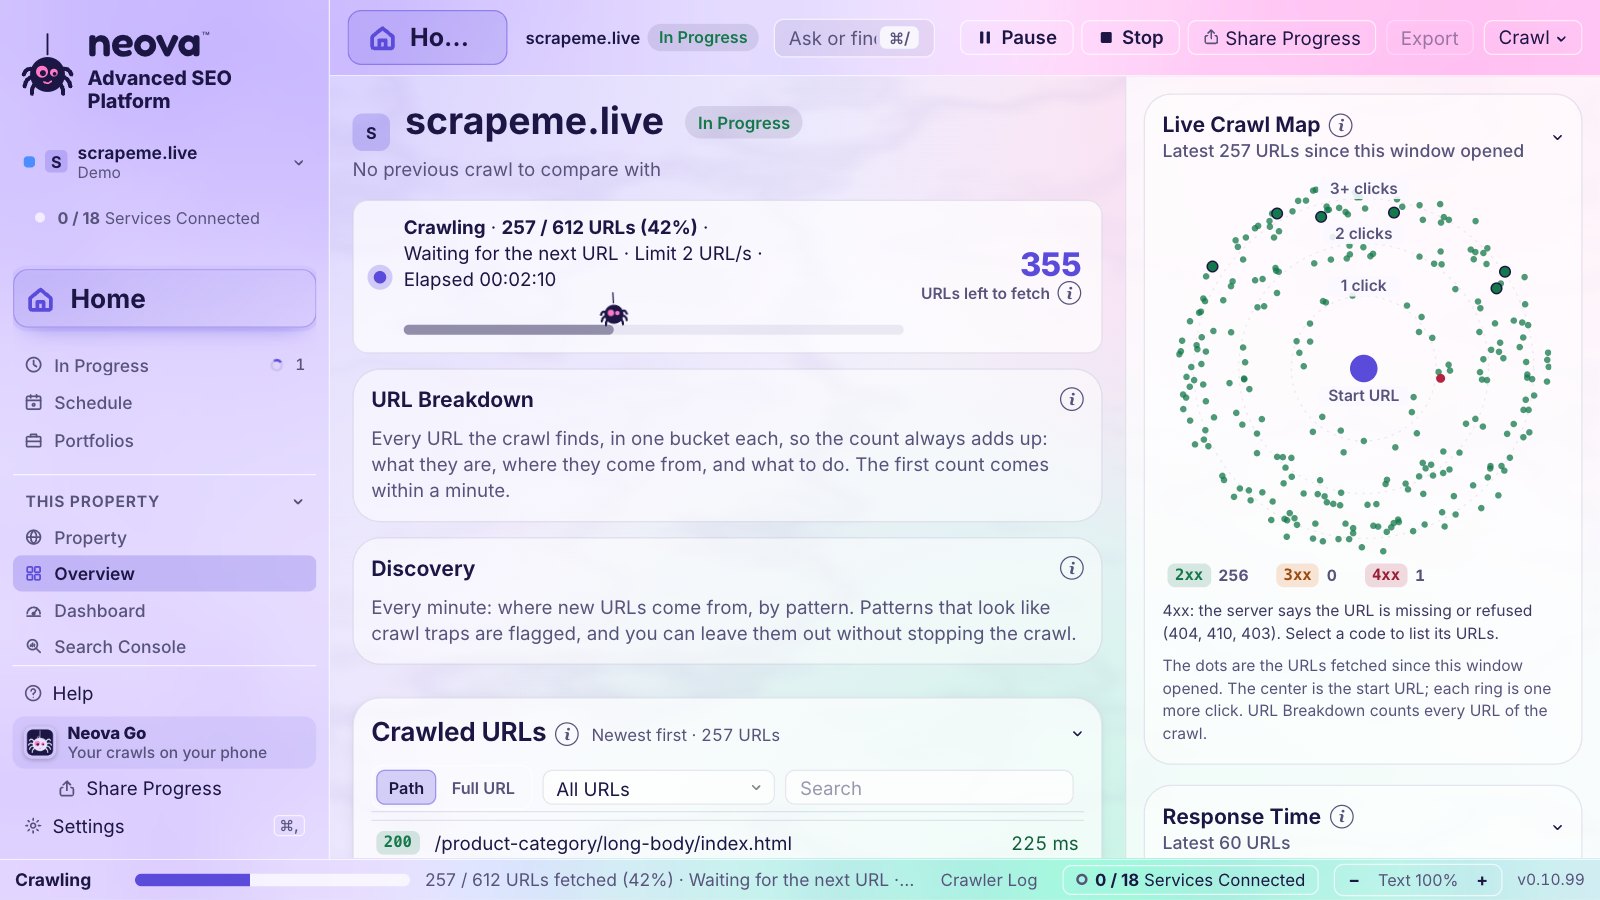
Nhiều website cùng lúc, mỗi website một nhịp riêng, trên bản đồ trực tiếp hiện từng URL ngay khi về.

Do dân SEO làm, cho dân SEO. Neova crawl từ chính máy tính của bạn, rồi cho bạn biết mục đánh dấu nào quan trọng, sửa gì trước, viết ticket, làm báo cáo cho khách hàng và theo dõi website. Hai phút video, rồi đến toàn bộ chi tiết.
Crawl chỉ là điểm bắt đầu. Đây là những gì Neova làm tiếp.
Nhiều website cùng lúc, mỗi website một nhịp riêng, trên bản đồ trực tiếp hiện từng URL ngay khi về.

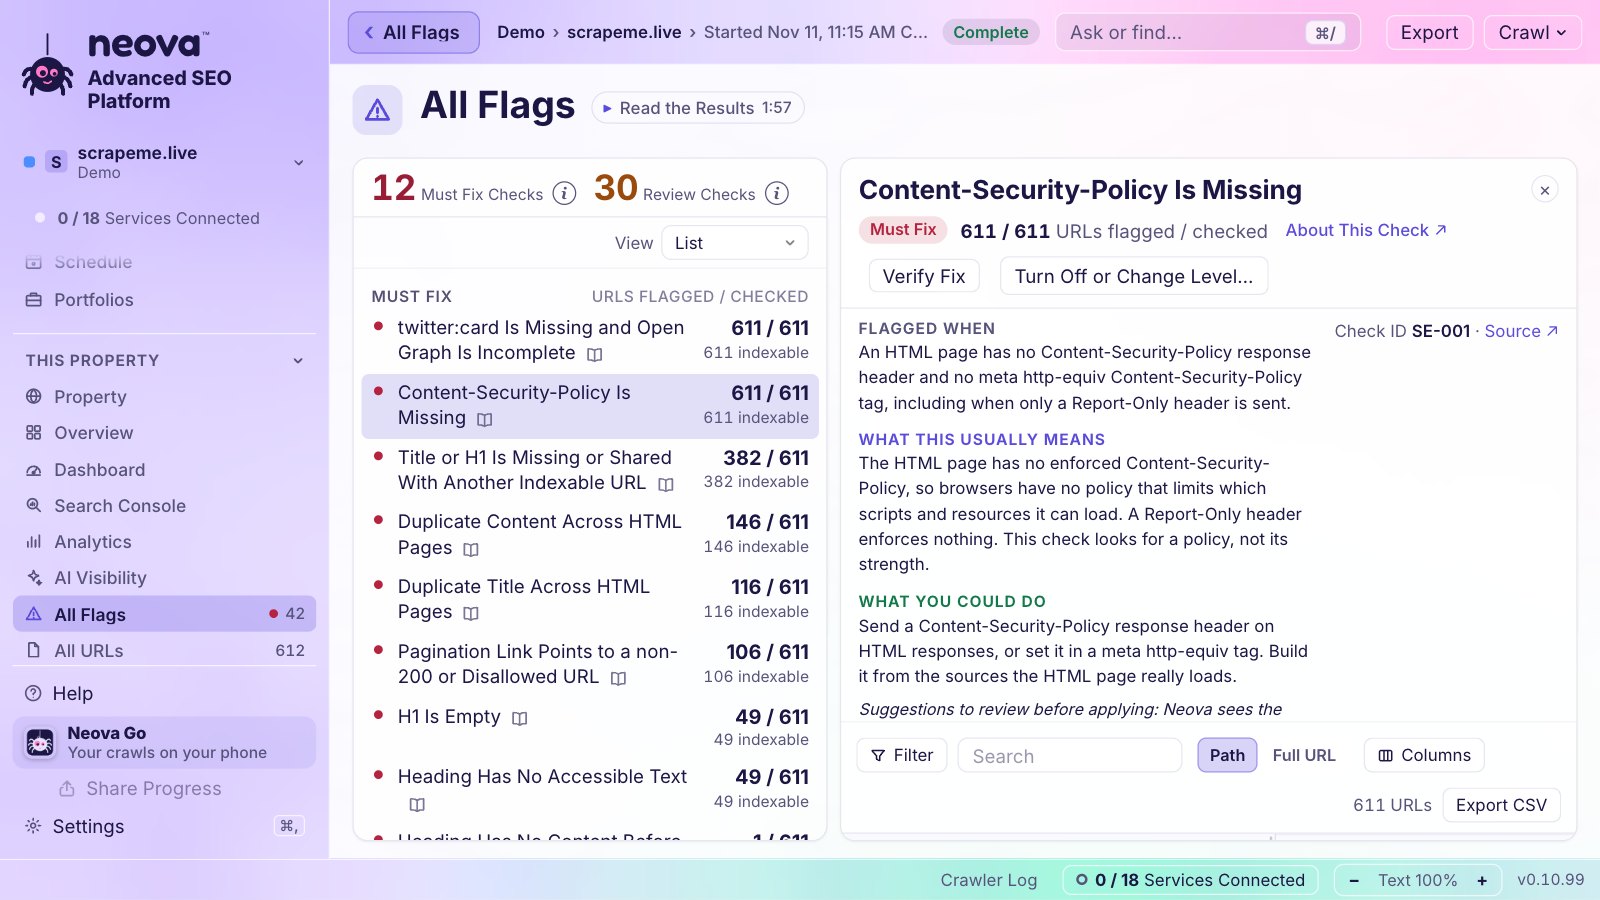
Mỗi mục đánh dấu cho biết vì sao nó xuất hiện, thường có nghĩa gì và quy tắc lấy từ đâu.

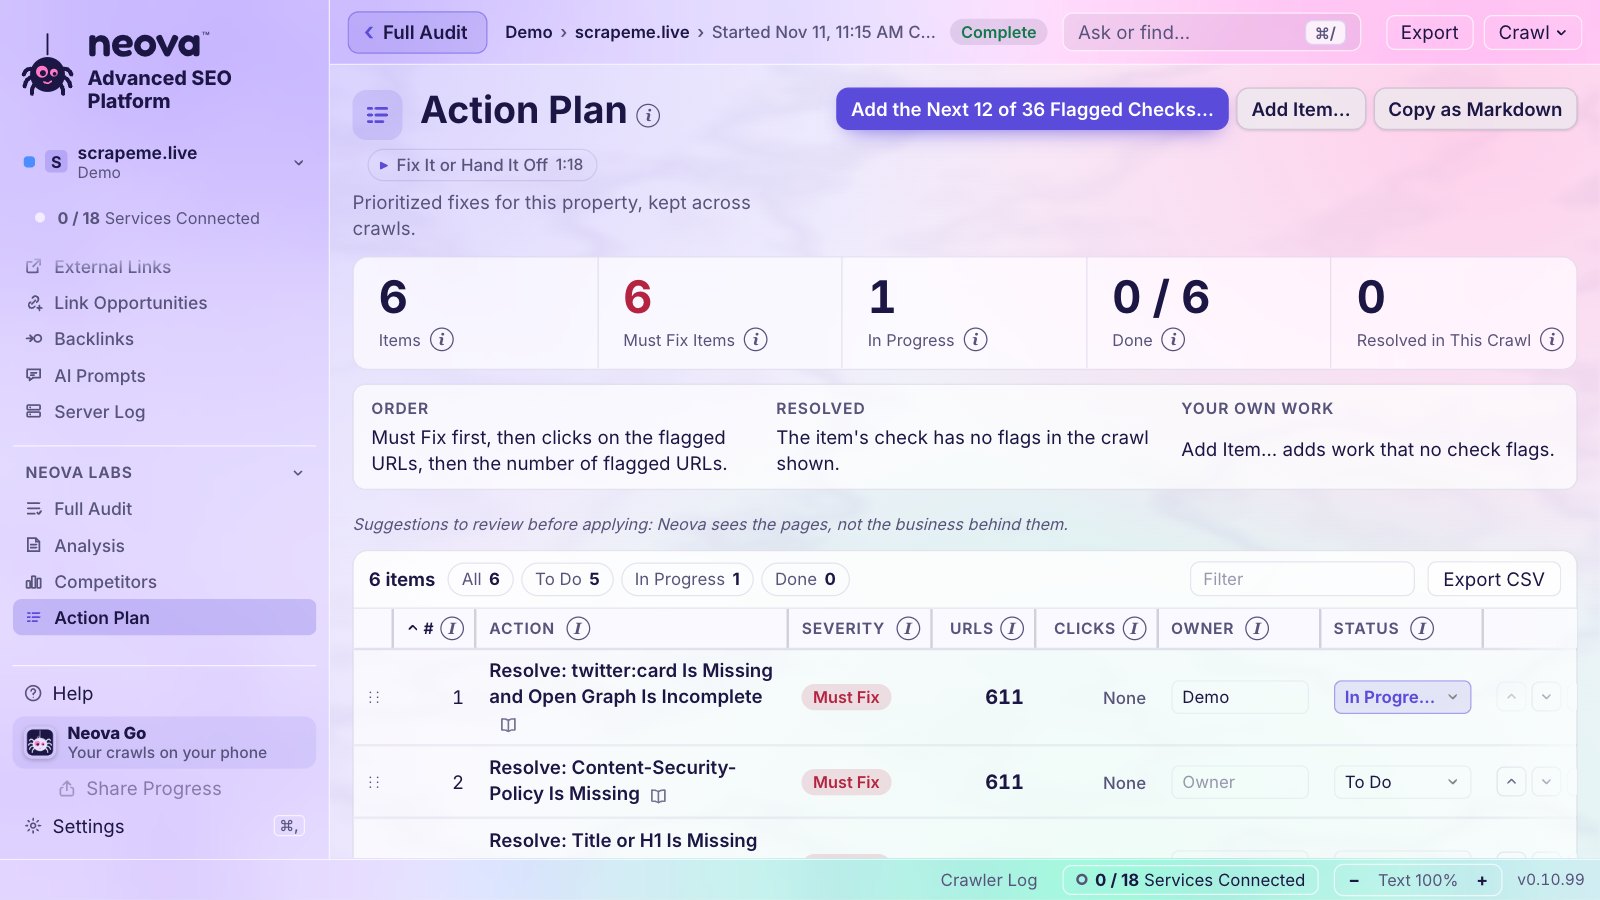
Mục đánh dấu thành việc cần làm: người phụ trách, trạng thái, Cần sửa trước, giữ lại qua các lần crawl.

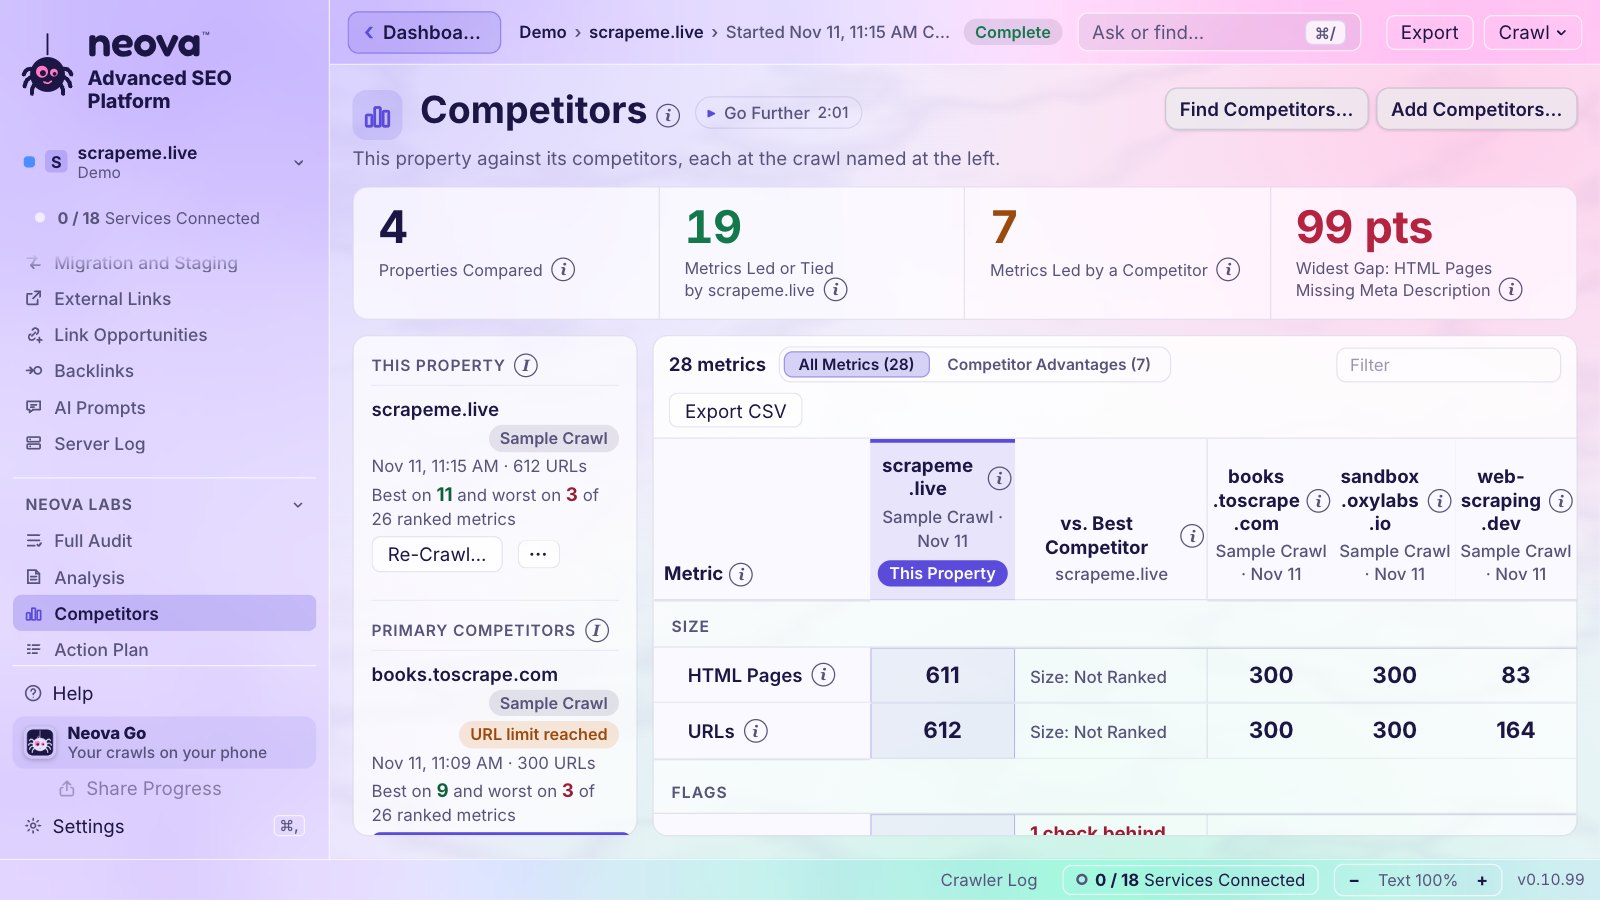
Dán một danh sách. Neova định cỡ từng lần crawl theo sitemap của họ, rồi cho thấy ai dẫn đầu, theo từng chỉ số.

Trải nghiệm của khách thật trên điện thoại, theo nhóm trang, kèm cảnh báo khi điểm thay đổi.

Mở các bản xuất của họ và chạy các mục kiểm tra của Neova trên những gì họ tìm thấy. Giữ lại công cụ bạn thích.
Đóng cửa sổ. Lần crawl vẫn chạy trên thanh menu, và điện thoại hiện mọi tài sản.

Mọi thứ khách hàng nhận được, từ một nơi, mã hóa trên máy bạn trước khi chia sẻ bất kỳ liên kết nào.
Lần crawl, Google, Bing và Analytics, Core Web Vitals, đối thủ, kế hoạch và PDF, trong một lần chạy.

Một linh vật hoạt hình ngồi trên màn hình nền và để mắt đến các lần crawl của bạn. Nó lên tiếng khi một lần crawl cần bạn, trả lời câu hỏi của bạn về lần crawl đó, và đưa bạn tới đúng màn hình chỉ với một cú nhấp. Tùy chọn, và tắt cho đến khi bạn chọn một con.
31 dịch vụ, cái nào cũng tùy chọn: Neova vẫn làm tốt việc của mình khi không có dịch vụ nào, và làm được nhiều hơn khi có chúng.
Mở một lĩnh vực để xem mọi tính năng trong đó, hoặc tìm trong tất cả.
Log trực tiếp của lần crawl: mọi URL đã tải kèm mã trạng thái tô màu và thời gian phản hồi, mỗi bước in đậm, lỗi màu đỏ và cảnh báo màu hổ phách; Copy Log giữ lại mọi dòng để gửi bộ phận hỗ trợ.
Đi theo internal link từ một URL bắt đầu, và theo sitemap XML khi bật, giống cách công cụ tìm kiếm khám phá một website.
Chỉ crawl những URL bạn dán vào hoặc tải lên từ file, không gì khác.
Đọc website trước khi crawl bắt đầu và chọn phiên bản (http hay https, có hay không có www) trả về 200, kèm cho biết các phiên bản kia làm gì.
Hỏi có crawl các tên miền phụ Neova tìm thấy không, và những tên miền nào.
Crawl toàn bộ website, không giới hạn URL trừ khi bạn đặt.
Chỉ crawl các thư mục bạn nhập, và đánh giá độ đầy đủ theo các URL trong sitemap XML nằm dưới các thư mục đó.
Crawl một số trang cố định từ mỗi nhóm trang, nhờ đó website lớn được audit trong vài phút mà template nào cũng được bao quát.
Ba mức trong một lựa chọn: Chỉ crawl, Audit website (thêm Core Web Vitals và bản nháp Kế hoạch hành động) và Audit đầy đủ (thêm đối thủ, dữ liệu tìm kiếm và phần phân tích).
Thêm URL bắt đầu từ một file TXT hoặc CSV, hoặc dán trực tiếp, để tới được những trang không có link nào dẫn đến.
Crawl các URL có trong sitemap XML mà robots.txt khai báo, sau các trang mà link dẫn tới.
Đọc thêm các sitemap XML bạn chỉ định, ngoài những sitemap robots.txt khai báo, cho mọi lần crawl của tài sản.
Chọn những tài nguyên được crawl ngoài các trang HTML: hình ảnh, CSS, JavaScript và PDF.
Trang trước tải mọi trang HTML trước hình ảnh và file, để phần cốt lõi của audit xong trước; Theo độ sâu tải các URL gần URL bắt đầu nhất trước.
Ghi lại link ở menu, footer và bộ lọc mà không đi theo, còn link trong nội dung luôn được đi theo.
Crawl hoặc bỏ qua URL theo mẫu regex, mỗi dòng một mẫu, kèm một ô để thử một URL với các mẫu đó.
Một danh sách loại trừ dùng cho mọi lần crawl, dù ai bắt đầu: cửa sổ app, một lịch trình hay một trợ lý AI.
Viết lại URL bằng quy tắc regex trước khi crawl, ví dụ để bỏ tham số tracking, hoặc để chuyển link của website staging trỏ sang website thật, và sitemap XML của website thật, về host staging.
Giữ hoặc bỏ query string khi crawl.
Crawl các internal link gắn rel=nofollow khi bạn muốn.
Coi /Page và /page là một URL.
Cho một lần crawl bắt đầu trong một thư mục được đi ra ngoài thư mục đó.
Giới hạn URL, Giới hạn độ sâu crawl, Số URL tối đa mỗi thư mục, Độ dài URL tối đa và Số tham số truy vấn tối đa, để kiểm soát faceted navigation.
Mặc định crawl 3 URL mỗi giây và tự giảm một nửa tốc độ khi server chậm lại hoặc trả về 429 hay 503, có tuân theo Retry-After.
Giãn đều mọi request theo đúng tốc độ đã chọn, kể cả robots.txt và sitemap XML, nên website không bao giờ bị dồn request cùng lúc.
Sau khi bạn xác nhận website là của mình, tốc độ lên tới 50 URL mỗi giây và có thể bỏ qua robots.txt, cho website của bạn hoặc một server staging.
Mặc định crawl dưới tên NeovaBot, hoặc dưới tên Googlebot, Bingbot, Applebot, các bot AI như GPTBot và ClaudeBot, công cụ SEO, trình duyệt hoặc một chuỗi tùy chỉnh.
Tuân thủ robots.txt đang chạy, bỏ qua nó với website của bạn, hoặc tuân thủ một bản nháp lưu trong Công cụ kiểm tra robots.txt để xem một thay đổi sẽ ra sao.
Kết xuất các trang HTML trong Chrome sau lần crawl, toàn bộ hoặc vài trang mỗi nhóm trang, rồi so trang đã kết xuất với HTML gốc; mặc định tắt.
Chờ mạng yên và trang ngừng thay đổi, tối đa tới một giới hạn chờ, và báo khi trang vẫn còn đang thay đổi.
Báo phía trên kết quả khi một lần crawl chạy không kết xuất, bao nhiêu mục kiểm tra không chạy được vì thế, và đưa ra nút Crawl lại có kết xuất.
Tải từng URL bằng Chrome như một khách truy cập, cho các website có chống bot; bạn tự giải CAPTCHA và Neova chờ bạn.
Gửi xác thực HTTP, cookie và header tùy chỉnh chỉ tới website đang crawl, cho website staging và khu vực cần đăng nhập.
Tạo một header bí mật cho website bạn quản lý, chỉ gửi tới website đó, kèm quy tắc để đưa đội IT của họ, để firewall cho Neova đi qua.
Lưu một cấu hình dưới một cái tên để dùng lại cho bất kỳ website nào, với những gì nó thiết lập hiện ra ngay.
Cho mỗi tài sản một bộ cài đặt crawl riêng, làm điểm xuất phát cho Lần crawl mới, Crawl lại và các lịch trình của nó, có nút Đặt lại mặc định.
Hiện các cài đặt mà phần lớn mọi người hay đổi, hoặc mọi cài đặt kèm ghi chú về cách từng cái hoạt động.
Liệt kê mọi cài đặt khác mặc định trước khi lần crawl bắt đầu, mỗi cái có link Sửa.
Đọc trước vài trang và cho biết sitemap XML liệt kê bao nhiêu URL, số hình ảnh và file dự kiến, và dung lượng đĩa cần so với dung lượng còn trống.
Dựa trên các trang lấy mẫu, cho biết mỗi trang có bao nhiêu hình ảnh, link mang những tham số nào và địa chỉ nào bị viết sai.
Kiểm tra kết nối Google của tài sản trước khi một lần crawl hoặc audit bắt đầu, và tạm giữ lại với các nút Đăng nhập lại, Crawl không có dữ liệu này hoặc Hủy khi đăng nhập bị hỏng.
Hiện lần crawl khi đang chạy: các bước đánh số, việc nó đang làm, số URL còn lại, và mọi ô bên dưới, ô nào cũng gập lại được.
Hiện các bước theo tên (Đang crawl website, Đang crawl XML Sitemaps, Đang crawl tài nguyên, Đang kết xuất các trang, Đang chạy 694 mục kiểm tra) cùng những gì mỗi bước đã tải.
Cho biết trong một dòng lần crawl đang làm gì lúc này và địa chỉ vừa tải gần nhất.
Ba thanh dưới thanh tiến độ: Trang HTML, Hình ảnh, và CSS, script và tệp khác, mỗi thanh là số đã tải trên số tìm thấy.
Hiện số URL còn phải tải, rồi số URL còn phải kiểm tra, bằng chữ lớn kèm một thanh.
Mỗi phút, cho biết URL mới đến từ đâu theo mẫu, đánh dấu những dạng bẫy crawl (lịch, thư mục lặp lại, ID phiên, nhiều tham số, URL sâu và dài) và cho bạn exclude hoặc bỏ qua chúng ngay tại chỗ.
Với mỗi nhóm URL tìm thấy, đưa ra Tiếp tục crawl, Bỏ qua hoặc Exclude, mỗi lựa chọn kèm những gì còn lại trong audit và những gì bị loại ra, lựa chọn nên dùng được đánh dấu.
Xếp mọi URL lần crawl tìm thấy vào đúng một nhóm (URL trang sạch, Biến thể có tham số, URL sai định dạng, Bẫy crawl, Hình ảnh, CSS, JavaScript và phông chữ, Tài liệu, Video và âm thanh, Tài nguyên khác) để con số luôn có lời giải thích.
Tải hình ảnh của 1, 3, 5, 10, 25, 50 hoặc 100 trang đầu của mỗi nhóm trang, kèm số hình ảnh và thời gian mà mỗi mức đó tốn, hoặc bỏ qua phần còn lại, hoặc giữ mọi hình ảnh.
Khi mọi trang đã được tải, bỏ qua hình ảnh và file còn lại để lần crawl kết thúc ở trạng thái hoàn tất và các mục kiểm tra được chạy.
Trong lúc crawl, cho biết trang sâu nhất tới giờ, chuyển màu hổ phách từ 4 click, và hiện một dòng cảnh báo từ 10 click.
Vẽ 300 URL mới nhất theo độ sâu click, tô màu theo mã trạng thái, các URL chỉ có trong sitemap nằm trên một vòng riêng.
Hiện thời gian phản hồi trung vị của các URL mới nhất trên biểu đồ, với các đường 800 ms và 1,800 ms.
Liệt kê URL ngay khi được tải, 10, 25, 50 hoặc 100 URL mỗi trang, có bộ lọc 2xx, 3xx, 4xx, 5xx và Không phản hồi, đã thay đổi và mới.
So từng URL ngay khi được tải với lần crawl gần nhất trước đó của tài sản có đọc trang, ưu tiên Crawl toàn bộ website, nếu không thì lần crawl Mẫu hoặc Thư mục cụ thể, và hiện giá trị cũ bị gạch ngang cạnh giá trị mới.
Hiện các mục kiểm tra đang chạy theo danh mục, mỗi danh mục kèm số URL đã đọc, và số mục đánh dấu khi đã ghi xong.
Liệt kê các trang của chính Google khớp với những gì lần crawl cho thấy, và tin tức Google Search trong 45 ngày qua: cập nhật xếp hạng, blog Search Central và cập nhật tài liệu.
Gợi ý bài đọc hợp với lần crawl: Google Search Status Dashboard, case study và bài cập nhật thuật toán của SEO ProCheck.
Dừng tạm lần crawl và chạy tiếp đúng từ chỗ đã dừng.
Nút Dừng hỏi: Chuyển sang sitemap XML, Dừng và chạy các mục kiểm tra, Dừng và xóa lần crawl này, hoặc Tiếp tục crawl; khi đang kết xuất thì có thêm Bỏ qua kết xuất.
Chạy tiếp một lần crawl đã dừng hoặc bị gián đoạn với đúng cài đặt của nó, không bao giờ bắt đầu lại từ đầu.
Chạy lại mọi mục kiểm tra trên những gì một lần crawl đã tải, không tải lại gì, kể cả với lần crawl đã chạy xong, để một mục kiểm tra được cải thiện ở phiên bản mới áp dụng cho các lần crawl đã lưu; nó chạy song song với các lần crawl của website khác.
Crawl lại tài sản với cài đặt của lần crawl gần nhất, giữ nguyên dữ liệu đã kết nối, đối thủ và kế hoạch của nó.
Khi website từ chối lần crawl, cho biết lý do (bị giới hạn tốc độ, bị firewall chặn hoặc bị chặn ở quốc gia hay khu vực này, bị cấm truy cập) và nên làm gì tiếp.
Một địa chỉ không thể là URL, chẳng hạn một câu văn nằm trong href, sẽ không được đi theo mà được báo thành một mục đánh dấu.
Đọc mọi stylesheet tải về để tìm phông chữ, hình nền và các stylesheet được import.
Liệt kê các file và hình ảnh mà trang tải từ host khác, không crawl chúng.
Tính các URL media của CMS không có đuôi file ảnh, như handler /-/media/ của Sitecore, là hình ảnh.
Nhóm trang theo template dựa trên HTML (các từ template riêng của theme, nếu không có thì theo khung trang), và theo mẫu địa chỉ với các website rất lớn.
Đi theo link rel=next và rel=prev trong head cũng như các thẻ a.
Xếp các lần crawl vào hàng đợi và bắt đầu từng lần ngay khi có slot crawl trống, không bao giờ crawl một website hai lần cùng lúc, có các nút Chạy hàng đợi, Xóa hàng đợi và Khi các mục kiểm tra kết thúc.
Giữ lần crawl trên đĩa thay vì trong bộ nhớ (60 MB bộ nhớ ở 60,000 URL), nên quy mô bị giới hạn bởi đĩa chứ không phải bộ nhớ.
Tối đa 4 website được crawl cùng lúc, mỗi website theo tốc độ và giới hạn URL riêng, có cơ chế canh bộ nhớ tạm giữ một lần crawl lại khi máy sắp hết bộ nhớ; bạn vẫn mở được mọi lần crawl đã lưu hay tài sản nào trong lúc chúng chạy.
Lần crawl mới điền biểu mẫu từ cài đặt đã lưu của tài sản (tốc độ, phạm vi, giới hạn URL, kết xuất, user agent, sitemap XML và phần còn lại), kể cả khi địa chỉ website được gõ ở URL bắt đầu; các câu trả lời gần nhất của bạn trong cửa sổ này vẫn được ưu tiên, và không gì bạn đã đổi bị ghi đè.
Khi máy này mất kết nối internet, lần crawl báo cho bạn, chờ và tự chạy tiếp khi có mạng lại, thay vì dừng như thể website bị sập; sau 30 phút ngoại tuyến thì nó dừng và cho biết lý do.
Liệt kê mọi trang HTML với thẻ title, meta description, H1 và độ dài của chúng, cùng các mục kiểm tra nội dung và mục đánh dấu của chúng.
Các bộ cột của Tất cả URL cho thẻ title, meta description và H1, mỗi bộ có bộ lọc thiếu, trống, trùng lặp, quá dài và quá ngắn.
Đánh dấu thẻ title, description, H1 và H2 trùng lặp, cùng văn bản trùng lặp hoặc gần trùng lặp giữa các trang HTML.
Đánh dấu nội dung chính nằm trong mức Khó và Rất khó của điểm Flesch, và các trang mỏng dưới 200 từ.
Đánh dấu lỗi chính tả và ngữ pháp có thể có trong nội dung chính.
Đánh dấu thẻ title và H1 nhắc tới một năm đã qua, và văn bản nhắc tới một ưu đãi, hạn chót hay ngày sự kiện đã qua.
Kiểm tra các thẻ quyết định tiêu đề, mô tả và hình ảnh mà một trang hiển thị khi được chia sẻ.
Cho thấy thẻ title và description của một trang trông ra sao trong kết quả tìm kiếm.
Một model chạy trên máy bạn đọc các trang HTML cho 20 mục kiểm tra nội dung cần sự phán đoán, như thiếu ví dụ, khẳng định không có dẫn chứng hay không ghi tên tác giả; mục đánh dấu của nó nằm riêng, tách khỏi Cần sửa và Nên xem.
Cho thấy thẻ title, meta description và H1 nào đã đổi kể từ lần crawl trước, trước và sau.
Thanh độ dài thẻ title, meta description và H1, nhóm trang và các trang HTML được link nhiều nhất.
Xuất nội dung chính của mọi trang HTML, mỗi trang một file Markdown, kèm một file mục lục.
Đánh dấu H1 và H2 bị thiếu, trống, dài và trùng lặp, H1 đầu tiên không phải tiêu đề chính, và trang dài không có H2.
Đánh dấu thiếu charset, doctype hoặc thẻ body, favicon hỏng, phần tử lỗi thời và frame chứa nội dung.
Đánh dấu Lorem Ipsum, code template, giá trị script trống và thông báo lỗi server hay output debug hiện thành chữ trên trang.
Đánh dấu tỷ lệ text trên HTML thấp, nội dung chính dưới 200 từ và trên 5,000 từ.
Đánh dấu nội dung đăng lại (syndicated) không có noindex hoặc canonical về bản gốc.
Đánh dấu khi thiếu trang Giới thiệu hoặc trang đó không được link trên toàn website.
Đọc các thực thể của những trang HTML quan trọng bằng khóa Google Natural Language của bạn, phục vụ các mục kiểm tra nội dung.
Mã trạng thái của mọi URL, cùng một màu ở mọi nơi: 2xx xanh lá, 3xx cam, 4xx và 5xx đỏ, Không phản hồi được gọi tên riêng.
Redirect đi đâu, qua bao nhiêu bước, vòng lặp, redirect tạm thời, meta refresh và redirect bằng JavaScript, cùng các link trỏ vào chúng.
Đánh dấu URL nội bộ có từ 2 bước redirect trở lên, vòng lặp redirect, redirect về chính nó và header Location bị thiếu hoặc sai định dạng.
Đánh dấu redirect 302, 303 và 307 nội bộ, bỏ qua các đích đăng nhập.
Đánh dấu redirect nội bộ kết thúc ở một URL 4xx hoặc 5xx, noindex, đã canonical sang URL khác hoặc bị disallow, hoặc ở một website khác.
Đánh dấu URL redirect chỉ để thêm dấu gạch chéo hoặc đổi chữ hoa, chữ thường, và các trang chỉ khác nhau ở điểm đó mà không có canonical giữa chúng.
Đánh dấu hình ảnh, script và stylesheet bị redirect, và link ngoài bị redirect hoặc kết thúc ở một lỗi.
Các bộ cột cho canonical và cho chỉ thị meta robots, có bộ lọc Noindex và Nofollow.
Hiện header phản hồi của bất kỳ URL nào.
Hiện HTML mà một URL gửi về, và HTML đã kết xuất khi lần crawl có kết xuất nó.
Cho biết với từng trang HTML là Kết xuất phía máy chủ, Đã hydrate hay Cần JavaScript.
Đánh dấu thẻ title, canonical, link và nội dung chính chỉ xuất hiện hoặc thay đổi sau khi JavaScript chạy.
Hai mươi mục kiểm tra trên URL AMP và canonical của chúng, kể cả trình xác thực AMP.
Đánh dấu URL dài, dấu gạch dưới, dấu gạch chéo kép, đoạn lặp lại, dấu câu thừa và quá nhiều tham số.
Hiện các trang HTML theo thư mục và theo độ sâu crawl.
Vẽ lần crawl thành một cây từ URL bắt đầu, mỗi chấm tô màu theo mã trạng thái, có chú thích dùng để lọc.
Nhóm URL do bạn tự đặt bằng regex, theo từng website, mỗi nhóm có đếm mã trạng thái, và một cột Phân đoạn trong Tất cả URL.
Tìm trong HTML của mọi trang một đoạn text hoặc regex, hoặc trích xuất giá trị bằng XPath, CSS selector hay regex, và lưu một phép trích xuất thành cột chạy lại ở mọi lần crawl.
Liệt kê loại nội dung, dung lượng và thời gian phản hồi của mọi URL, thời gian phản hồi được tô màu từ 800 ms và 1,800 ms.
Chỉ tải lại các URL mà một mục kiểm tra đánh dấu, chạy lại mọi mục kiểm tra và cho biết bao nhiêu URL đã được sửa.
Tắt một mục kiểm tra hoặc đổi mức của nó thành Cần sửa hay Nên xem cho một tài sản, giữ nguyên cho mọi lần crawl sau.
Bỏ cả danh mục mục kiểm tra ra khỏi một lần crawl.
Một màn hình cho việc kết xuất: bao nhiêu trang HTML có nội dung nằm trong HTML, nằm một phần trong HTML hay cần JavaScript, những gì chỉ JavaScript hiển thị, mỗi bot AI nhận được gì, theo nhóm trang, và các trang không nằm trọn trong HTML.
Tab Kỹ thuật và Tìm kiếm AI của Dashboard cho thấy tỷ lệ trang nằm trong HTML, các trang cần JavaScript, các trang có nội dung chính chỉ hiện ra nhờ JavaScript và các bot AI nhận được trang đầy đủ.
Mỗi trang HTML có index được hay không: mã trạng thái, noindex, canonical, robots.txt, và HTML làm vỡ phần head trước các thẻ SEO.
Đánh dấu từng URL có index được hay không và lý do: mã trạng thái 200, không có noindex, canonical về chính nó hoặc không có canonical.
Giải thích từng dòng của file đang chạy hoặc một bản nháp bằng lời dễ hiểu, theo tài liệu của Google và định nghĩa của RFC 9309, kèm các URL đã crawl mà mỗi quy tắc khớp.
Cho thấy Googlebot, Bingbot và các bot AI được phép tải những gì theo robots.txt, kèm các URL mỗi bot bị chặn.
Kiểm tra một bản nháp với mọi URL của lần crawl trước khi đưa lên, liệt kê các URL mới bị chặn và mới được cho phép.
Báo khi nhóm riêng của một crawler trong robots.txt làm mất hiệu lực các quy tắc của nhóm *.
Những gì sitemap XML liệt kê so với những gì lần crawl tìm thấy: trang index được bị thiếu, và các URL redirect, noindex, lỗi hay mồ côi có trong sitemap.
Tải các trang chỉ có trong sitemap XML, ở bước 2, và đếm riêng chúng.
Dành thời gian riêng cho robots.txt và sitemap trên các website chậm, và báo khi một file không phản hồi.
Tạo một sitemap XML gồm các trang index được, ở mọi độ sâu hoặc tới độ sâu 3 hay 5.
Đánh dấu trang lưu trữ có phân trang trả về 200 mà không có mục nào, chuỗi rel=next bị đứt và phân trang canonical về trang 1.
Giữ mọi phiên bản robots.txt và sitemap XML mà các lần crawl đã đọc, và đánh dấu các thay đổi quy tắc robots.txt kể từ lần crawl trước.
Đánh dấu HTML kết thúc phần head trước các thẻ SEO (một noscript có chữ, một phần tử không hợp lệ, thẻ head bị bỏ hoặc lặp lại), khiến thẻ title và canonical bị đọc trong body.
Đánh dấu canonical bị vòng lặp, nối chuỗi, trỏ tới redirect, noindex, 4xx, 5xx, HTTP hoặc URL ngoài, hoặc chỉ được đặt bằng JavaScript.
Đánh dấu noindex, nofollow và canonical khác nhau giữa HTML và header HTTP, bị khai báo hai lần hoặc viết sai chính tả.
Đánh dấu trang dùng hình ảnh, script hoặc stylesheet mà robots.txt disallow.
Đánh dấu các biến thể về chữ hoa chữ thường, dấu gạch chéo cuối và thứ tự tham số trả về cùng một HTML.
Đánh dấu trang HTML trả về 200 nhưng có cụm từ như not found hay no results found trong thẻ title hoặc H1.
Đánh dấu HTML trên 2 MB có link hoặc nội dung nằm sau giới hạn Google đọc, và file JavaScript hay CSS trên 2 MB.
Đánh dấu thay đổi đột ngột về số URL crawl được và các quy tắc robots.txt đã đổi kể từ lần crawl trước.
Đánh dấu sitemap XML trên 50 MB hoặc 50,000 mục, sitemap rỗng, dòng sitemap dùng đường dẫn tương đối trong robots.txt, và URL ở host hay giao thức khác.
Kiểm tra website có host file khóa IndexNow của bạn không, có nút Tạo khóa để tạo một khóa.
Đọc kết luận URL Inspection của Google cho tối đa 200 URL mỗi lần crawl, và đánh dấu các trang index được mà Google không index hoặc Google đã chọn canonical khác.
Sau một lần Crawl toàn bộ website tự chạy xong, gửi các trang đã thay đổi hoặc mới kể từ lần crawl toàn bộ trước tới IndexNow (Bing, Yandex, Seznam, Naver và Yep), chỉ khi website có host khóa của bạn; cửa sổ app cho biết những gì đã gửi hoặc bị từ chối.
Liệt kê các trang gắn nhãn nội dung người lớn (meta rating adult, nhãn RTA hoặc header Rating) và các trang trả về cho crawler một cổng xác nhận tuổi, để bạn xem lại.
Link hỏng, link trỏ tới redirect, anchor và các trang có ít link dẫn tới.
Liệt kê mọi link tới và từ một URL kèm anchor text.
Ghi lại mỗi link nằm trong nội dung, menu, footer hay bộ lọc, có các cột Link đến trong nội dung và Link đến từ menu và footer.
Chấm điểm mỗi URL từ 0 tới 100 theo sức mạnh internal link nó nhận được, một dạng PageRank nội bộ trên các link được theo của lần crawl.
Số click từ URL bắt đầu tới mọi URL, đánh dấu từ độ sâu 4.
Đánh dấu các trang index được mà không internal link nào dẫn tới, tìm thấy qua sitemap XML, log server hoặc Google Search Console.
Mọi URL trên website khác mà website link tới, mỗi URL chỉ request một lần, báo các URL 4xx, 5xx và không phản hồi.
Bật hoặc tắt việc request từng URL ngoài cho một lần crawl; mặc định bật.
Gợi ý internal link từ nội dung của các trang HTML: những trang nhắc tới chủ đề của một trang khác mà chưa link tới trang đó.
Hiện URL Rating, Trust Flow, Page Authority hoặc Authority Score, số tên miền giới thiệu và backlink của từng URL, từ khóa Ahrefs, Majestic, Moz hoặc Semrush của chính bạn.
Đánh dấu internal link không có anchor text hoặc anchor không mô tả gì, và hình ảnh gắn link không có alt.
Đánh dấu trang chỉ tới được qua link nofollow, internal link trỏ ra bị nofollow và link affiliate không có sponsored hoặc nofollow.
Đánh dấu href trống, sai định dạng hoặc chỉ có khoảng trắng, link chỉ chạy bằng onclick, tham số tracking, đường dẫn file cục bộ, localhost và fragment không có ID tương ứng.
Đánh dấu URL chỉ tới được qua canonical, redirect hoặc trang noindex, và trang chỉ có link đến từ một URL duy nhất.
Đếm riêng thành một nhóm các địa chỉ mà link viết sai (khoảng trắng ở cuối, dấu gạch chéo kép, ký tự bị mã hóa hai lần).
Đánh dấu trang HTML link tới host staging, development hoặc local.
Liệt kê mọi hình ảnh mà lần crawl đã tải hoặc một trang có dùng, kèm dung lượng, alt text và số trang HTML dùng nó.
Đánh dấu alt text bị thiếu, quá dài, là chữ giữ chỗ hoặc lặp lại, và phân biệt alt bị thiếu với alt để trống cho ảnh trang trí.
Đánh dấu hình ảnh trên 100 KB, GIF trên 100 KB và hình ảnh không có width và height.
Khi bật kết xuất, đánh dấu hình ảnh hiển thị sai tỷ lệ khung hoặc độ phân giải quá thấp so với kích thước hiển thị.
Đánh dấu hình ảnh chưa nén, chưa dùng định dạng hiện đại, lớn hơn kích thước hiển thị, và ảnh LCP bị lazy-load.
Đánh dấu video không có track phụ đề.
Cho phép lấy mẫu một kho ảnh lớn theo nhóm trang thay vì tải toàn bộ, kèm số lượng và thời gian của từng lựa chọn.
Bỏ các hình ảnh còn trong hàng đợi, trong khi mọi trang vẫn được crawl và alt text vẫn được đọc từ HTML.
Trên các website cấp phép hình ảnh, đánh dấu markup ImageObject thiếu thông tin giấy phép và đọc một mẫu ảnh được phục vụ để lấy quyền IPTC và XMP, thứ Google cần cho huy hiệu Licensable.
Các phiên bản ngôn ngữ và khu vực của mỗi trang và việc chúng có trỏ tới nhau không: link trả về, tự tham chiếu, x-default, mã không hợp lệ, đích đã canonical sang URL khác và đích noindex.
Ngôn ngữ hreflang và Đích hreflang cho mỗi trang HTML, rê chuột để xem danh sách đầy đủ.
Đánh dấu html lang bị thiếu, trống hoặc không hợp lệ, và giá trị lang không khớp với hreflang hoặc với chính nội dung trang.
Đánh dấu thiếu link trả về, thiếu tự tham chiếu và link trả về trỏ tới URL đã canonical sang URL khác.
Đánh dấu bộ hreflang của trang chủ thiếu x-default, và đích x-default bị hỏng, noindex hoặc đã canonical sang URL khác.
Đánh dấu đích hreflang không trả về 200, bị noindex, đã canonical sang URL khác, bị disallow hoặc không có link đến.
Xác thực mọi mã ngôn ngữ và quốc gia của hreflang, và đánh dấu mã khu vực không có phương án dự phòng chỉ theo ngôn ngữ.
Đánh dấu các trang tương đương theo ngôn ngữ không có hreflang, và thị trường mục tiêu không có hreflang trên trang nào.
Đọc hreflang từ head HTML và header HTTP Link, và đánh dấu bộ hreflang được khai báo bằng nhiều hơn một cách.
Đánh dấu phản hồi thay đổi theo Accept-Language theo cách mà Googlebot không thấy.
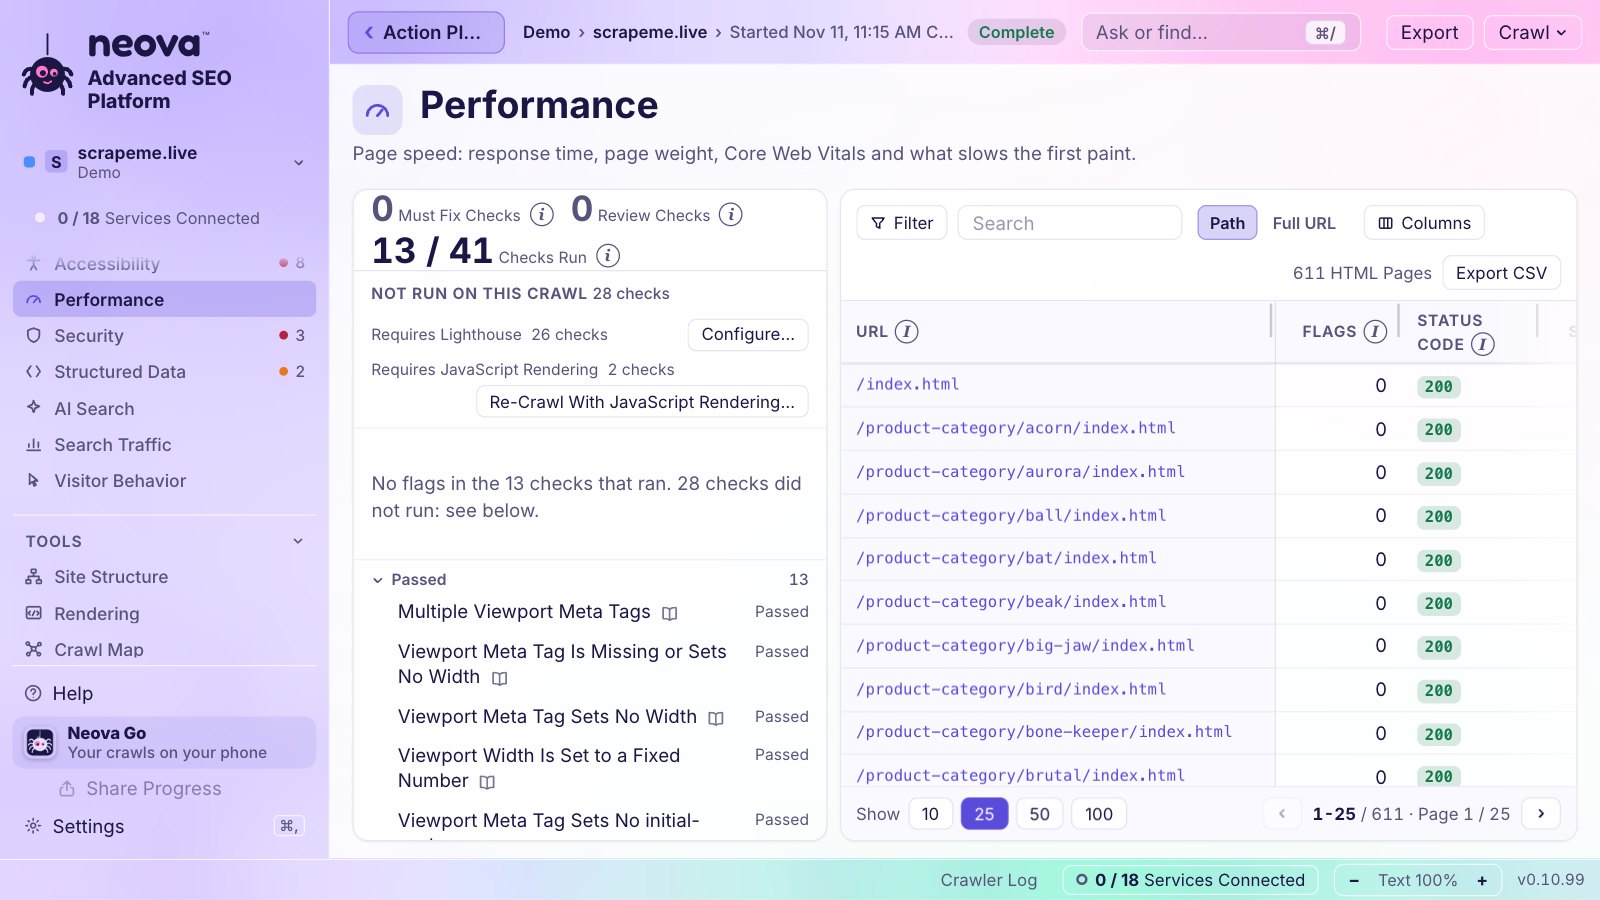
Tốc độ trang: thời gian phản hồi, dung lượng trang, Core Web Vitals và những gì làm chậm lần hiển thị đầu tiên.
Chạy các mục kiểm tra lab của Lighthouse trên một trang HTML mỗi nhóm trang trong lúc crawl.
LCP, INP và CLS của người dùng Chrome thật trên điện thoại, ở phân vị 75, từ khóa Chrome UX Report của bạn.
Ngay ngày đầu, vẽ khoảng 40 tuần dữ liệu thực tế từ Chrome UX Report History, mỗi tuần một điểm, kèm các ngưỡng tốt và kém của Google.
LCP, INP và CLS của các trang HTML được link nhiều nhất trong mỗi nhóm trang, để template chậm tự lộ ra.
Đọc Chrome UX Report cho origin, các URL được link nhiều nhất của mỗi nhóm trang và 10 URL được link nhiều nhất, không cần crawl.
Tự tạo ảnh chụp nhanh, mặc định hằng ngày, hoặc hằng tuần, hằng tháng, kể cả khi cửa sổ app đã đóng.
Gửi cảnh báo khi một chỉ số bị xếp hạng tệ hơn hoặc trở lại mức Tốt, theo ngưỡng của Google.
Hiện các số đo gần nhất cạnh nhau, tô màu Tốt, Cần cải thiện hoặc Kém, kèm ngày đo.
Đặt từ 0 tới 3 trang HTML mỗi nhóm trang cho mỗi ảnh chụp nhanh, và cho biết số request Chrome UX Report sẽ dùng.
Mức Audit website đọc Core Web Vitals từ Chrome UX Report sau lần crawl.
Giữ mọi ảnh chụp nhanh trên máy của bạn, lâu hơn 28 ngày mà Chrome UX Report hiển thị.
Đánh dấu khi tắt nén text, CSS và JavaScript chưa minify, thời gian cache ngắn và trang không có ETag hoặc Last-Modified.
Đánh dấu request chặn hiển thị, tác vụ dài trên main thread, CSS và JavaScript không dùng, JavaScript cũ, tài nguyên HTTP/1.1, bên thứ ba chậm và điểm Lighthouse dưới 50.
Đánh dấu server phản hồi chậm, CLS trên 0.1 và Core Web Vitals ngoài ngưỡng tốt, theo dữ liệu lab hoặc dữ liệu thực tế.
Đánh dấu trang có phần kết xuất JavaScript mất hơn 4 giây.
Đánh dấu viewport bị thiếu hoặc cố định, khóa zoom, và chữ dưới 12 CSS px trên điện thoại.
Thời gian phản hồi trung vị, mức 9/10 và chậm nhất trong lúc crawl chạy, kèm 10 trang chậm nhất.
Những gì cản người dùng công nghệ hỗ trợ sử dụng từng trang: tên, nhãn, ARIA, landmark, heading, bảng và biểu mẫu.
Khi bật kết xuất, chạy các luật axe-core và các phép thử như khách truy cập: độ tương phản, focus bàn phím, bẫy focus, zoom 200%, reflow 320 px và vùng chạm 24 px.
Đánh dấu nút, link, trường biểu mẫu, hình ảnh, hộp thoại và frame không có tên truy cập được, và trường chỉ được đặt tên bằng title.
Đánh dấu role và thuộc tính không hợp lệ, thiếu thuộc tính bắt buộc, sai role cha hoặc con, và role đã lỗi thời.
Đánh dấu trang không có landmark main, landmark bị lặp hoặc lồng nhau, bỏ cấp heading và không có cách bỏ qua các khối lặp lại.
Đánh dấu bảng không có ô tiêu đề, scope và headers không hợp lệ, và danh sách hay danh sách định nghĩa dựng sai.
Đánh dấu thiếu chỉ báo focus, bẫy focus, tabindex dương, hộp thoại không giữ focus và vùng cuộn không truy cập được bằng bàn phím.
Đánh dấu chữ có độ tương phản không đủ, chữ dưới mức tương phản nâng cao và link chỉ phân biệt được bằng màu.
Đánh dấu khi tắt zoom, chữ bị cắt ở zoom 200%, nội dung bị cắt ở chiều rộng 320 px, khóa hướng màn hình và vùng chạm dưới 24 px.
Đánh dấu video không có phụ đề hoặc mô tả âm thanh, video không tiếng không có phương án thay thế và audio không có bản ghi lời.
Đánh dấu trường không có nhãn hoặc có nhiều nhãn, giá trị autocomplete không hợp lệ, trường chặn dán và lỗi không có chữ mô tả.
Một model chạy trên máy đọc các trang cho 7 mục kiểm tra cần phán đoán, như biểu đồ không có phần chữ tương đương.
Những gì crawler AI được phép tải, những gì chúng nhận được, và cách câu trả lời AI trích dẫn website.
Gửi request tới các trang lấy mẫu dưới tên 10 agent AI (ChatGPT, Claude, Perplexity, crawler của chúng, Meta AI, Google-Extended, Common Crawl) và cho thấy ai được truy cập đầy đủ và robots.txt cho phép những gì.
Đánh giá file llms.txt đã đăng, bản Markdown qua header Accept, manifest khám phá cho agent và công cụ WebMCP; website không có chúng thì không bị đánh dấu.
Đánh dấu trang quan trọng chặn bot tìm kiếm AI hoặc giới hạn snippet, và quy tắc AI khác với chính sách bạn đã viết ra.
Đánh dấu bản Markdown trống hoặc chứa chưa tới một nửa nội dung chính.
Đánh dấu nội dung chính bắt đầu sau 5,000 ký tự đầu tiên của văn bản trong body.
Đánh dấu lớp phủ vô hình đè lên nút và trường nhập, nút điều khiển tác vụ khó nhìn thấy, và quyết định checkout cho agent không ghi ngày với Google UCP hoặc OpenAI ACP.
Đánh dấu trang quan trọng disallow Applebot và các trình tải AI do người dùng kích hoạt bị chặn.
Đánh dấu trích dẫn AI của Bing đang giảm và URL quan trọng mà Bing AI chưa bao giờ trích dẫn, từ Bing Webmaster Tools.
Báo cáo số phiên đến từ AI và mức tương tác của chúng so với organic, từ Google Analytics 4.
Hỏi tối đa 20 prompt của bạn với ChatGPT và Perplexity qua tài khoản DataForSEO của bạn, rồi báo cáo số lần nhắc tới thương hiệu, URL được trích dẫn và các website bên thứ ba được trích dẫn thay cho bạn.
Cho biết với mỗi truy vấn đang theo dõi, Google có hiện AI Overview không và có trích dẫn bạn không, qua từng lần audit.
Crawl bằng GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot và các user agent AI khác.
Hiện các lượt ghé đã xác minh và các lần bị từ chối của bot AI theo từng URL, từ log server.
Chạy prompt của chính bạn trên mỗi trang HTML (bản nháp meta description, ý tưởng FAQ, ý định tìm kiếm, thực thể chính) bằng Ollama trên máy bạn hoặc bằng khóa Anthropic, OpenAI hay Google Gemini của bạn, câu trả lời thành các cột.
Chạy 44 mục kiểm tra cần phán đoán trên các danh mục bằng một model chạy trên máy qua Ollama; không gì rời khỏi máy và mục đánh dấu của nó không tính vào các con số.
Trợ lý AI được phục vụ, AI Overviews, những gì mỗi trợ lý AI nhận được và request của các bot đã xác minh.
Với mỗi truy vấn đang theo dõi, tải AI Overview của Google 3 lần qua DataForSEO và báo cáo bao nhiêu nguồn của nó xếp hạng ở trang một, trang của bạn có xếp ở đó không và Overview có trích dẫn trang đó không, ở mức Nên xem.
Schema trên mỗi trang: hợp lệ, có cảnh báo hoặc có lỗi, và cột Loại schema.
Đưa ra kết luận cho từng loại schema trên một URL.
Đánh dấu trang thiếu một loại dữ liệu có cấu trúc hoặc rich result mà nhóm trang của nó có.
Đánh dấu giá sản phẩm không hiện trên trang, ưu đãi đã hết hạn, ngày không khớp và thiếu thuộc tính bắt buộc.
Đánh dấu dữ liệu có cấu trúc có lỗi cú pháp, thiếu thuộc tính bắt buộc hoặc nên có, hoặc có nội dung khác với trang.
Đánh dấu markup Organization hoặc Person thiếu các thuộc tính nhận diện.
Kiểm tra selector Speakable, trang có paywall thiếu isAccessibleForFree false, và markup HowTo, QAPage và FAQ so với trang.
Đánh dấu rich result không hợp lệ và lỗi AMP hoặc rich result mà Google báo.
So markup Organization với Google Business Profile, qua DataForSEO.
HTTPS, mixed content và các header bảo mật mà mỗi trang gửi.
Liệt kê các header bảo mật mà mỗi URL gửi.
Đánh dấu trang HTTP, redirect từ HTTPS về HTTP, chứng chỉ không hợp lệ hoặc sắp hết hạn, và TLS 1.0 hoặc 1.1.
Đánh dấu script và style bên ngoài không có hash integrity, và biểu mẫu hay trường mật khẩu chạy qua HTTP.
Đánh dấu khi thiếu Content-Security-Policy, Strict-Transport-Security, nosniff, chống clickjacking hoặc Cross-Origin-Opener-Policy, và Referrer-Policy không an toàn.
Đánh dấu trang HTTPS tải tài nguyên HTTP hoặc protocol-relative, hoặc link tới trang HTTP.
Đánh dấu header phản hồi để lộ server hoặc framework, và Content-Type không khớp với file.
Đánh dấu chứng chỉ không bao phủ hostname gửi qua SNI.
Khi bật render, đánh dấu cookie bên thứ ba và yêu cầu cấp quyền hiện ra lúc tải trang.
Đăng nhập qua chính trang của Google trong trình duyệt của bạn, chỉ đọc, và ghép lượt click, lượt hiển thị và CTR vào mọi URL của mọi lần crawl.
Ghép lượt truy cập và mức tương tác vào các trang của lần crawl cho các mục kiểm tra analytics, kết nối bằng cùng lần đăng nhập Google.
Giữ một phiên đăng nhập cho mỗi tài khoản Google và dùng đúng tài khoản sở hữu tài sản cho từng website.
Hỏi tài sản Google Search Console và Google Analytics 4 nào thuộc về từng website, chọn sẵn tài sản của chính website đó.
29 mục kiểm tra ghép dữ liệu Google vào lần crawl, chẳng hạn URL noindex, đã redirect hoặc 4xx mà vẫn có lượt click.
Đánh dấu trang đích organic có thời gian tương tác từ 10 giây trở xuống, tỷ lệ thoát từ 80% trở lên, form không có sự kiện chính nào, và phiên organic thấp hơn 70% mức thường gần đây.
Đánh dấu truy vấn mà nhiều URL chia nhau lượt hiển thị, hoặc trang chủ hay một URL không index được lại hiện nhiều nhất.
Báo cáo lượt hiển thị và lượt click theo giao diện tìm kiếm.
Đánh dấu ID GA hoặc GTM bị tải hai lần và URL index được nhưng không có ID GA hay GTM nào.
Xếp hạng mục kiểm tra theo lượt click của các URL chúng đánh dấu, để mục đánh dấu làm mất traffic đứng đầu.
Giữ mọi tháng dữ liệu Google Search Console trên máy tính của bạn sau khi Google xóa chúng ở mốc 16 tháng, với Lưu trữ ngay và lịch hằng tháng.
Lượt click và lượt hiển thị mỗi ngày trong 28 ngày gần nhất so với 28 ngày trước đó, trên một biểu đồ.
Các truy vấn mang lại lượt click, kèm lượt hiển thị và vị trí.
Theo dõi tối đa 25 truy vấn mỗi tài sản mỗi ngày từ Google Search Console: vị trí trong 7 ngày và 90 ngày, mức thay đổi, lượt click và lượt hiển thị, kèm gợi ý các truy vấn đang ở vị trí 4 đến 20.
Kiểm tra tối đa 200 URL mỗi lần crawl, ưu tiên URL nhiều lượt click nhất rồi đến URL được link nhiều nhất.
Lượt click và lượt hiển thị từ Google Discover, lưu kèm từng tháng đã lưu trữ.
Vẽ các cập nhật xếp hạng và sự cố của Google trong hai năm qua lên biểu đồ lượt click mỗi ngày, kèm lượt click trước và sau mỗi sự kiện.
Lượt click, truy vấn, lỗi crawl và URL đã index từ Bing, dùng API key của bạn, kèm nút Kiểm thử liệt kê các website của bạn.
Thứ hạng, câu trả lời AI, đối thủ và backlink qua chính tài khoản DataForSEO của bạn, trả tiền theo từng request.
Vị trí thật trên mobile của mỗi truy vấn được theo dõi trong top 20, kèm đối thủ mạnh nhất bên cạnh.
Các truy vấn đối thủ có thứ hạng trong top 20 còn bạn thì không, kèm lượng tìm kiếm.
Đọc một dịch vụ bạn kết nối sau lần crawl và chạy lại các mục kiểm tra của dịch vụ đó trên lần crawl này, không cần crawl lại.
Hiện số dịch vụ đã kết nối trên thanh trạng thái, dưới tài sản ở thanh bên và thành một khối trên Dashboard, chỗ nào cũng mở Kết nối.
Cho biết số request mỗi kết nối gửi cho một tài sản so với hạn mức của Google, tất cả đều trên key và tài khoản của bạn.
Mọi lần crawl đều kèm link tới báo cáo Vấn đề bảo mật và Thao tác thủ công của Search Console cho tài sản, vì API của Google không đọc được hai báo cáo này, để bạn tự mở cả hai.
Đặt tài sản cạnh các đối thủ ở lần crawl dùng được gần nhất của họ, mỗi chỉ số tô màu theo bên dẫn đầu và bên tụt lại, kèm khoảng cách với đối thủ mạnh nhất.
Liệt kê các chỉ số đối thủ đang dẫn, khoảng cách lớn nhất trước, kèm các mục kiểm tra đứng sau mỗi con số.
Nhận nguyên cả danh sách dán vào như vốn có, đối thủ trực tiếp là chính (tối đa 5), gián tiếp là phụ, rồi xếp hàng crawl cho tất cả trong một bước.
Đọc sitemap XML của từng đối thủ trước, mặc định crawl 750 URL và đề xuất 1,000, 2,500 hoặc 5,000 khi sitemap liệt kê nhiều hơn.
Tìm các website có thứ hạng cho cùng truy vấn qua DataForSEO, chia thành chính và phụ.
Không bao giờ đề xuất cửa hàng, app giao hàng hay sàn thương mại điện tử làm đối thủ; bạn vẫn có thể tự thêm chúng.
Crawl đối thủ tại nơi trang chủ của họ đang nằm khi họ đã chuyển sang tên miền khác.
Đề xuất một portfolio con "<tài sản> | Đối thủ" cho các đối thủ của một tài sản và giữ nó gắn với tài sản đó.
Chỉ tính các mục kiểm tra mà mọi lần crawl được so sánh đều đánh giá được, và không xếp hạng gì so với một lần crawl bị cắt ngang.
Số truy vấn có thứ hạng, số trong top 10, lượt truy cập ước tính và referring domain của tài sản và từng đối thủ, qua mỗi lần audit.
Referring domain và backlink của tài sản và các đối thủ, lấy từ DataForSEO Backlinks.
Vẽ từng đối thủ dưới tài sản của nó, với thanh cho số URL, số mục đánh dấu và số mục đánh dấu trên mỗi URL để so sánh.
Lịch tháng của mọi lần crawl và lượt chạy theo lịch, đã qua và sắp tới, có bộ lọc theo tài sản.
Crawl toàn bộ website tự chạy hằng ngày, hằng tuần, mỗi N tuần hoặc hằng tháng với cài đặt của tài sản, kể cả khi cửa sổ đã đóng.
Lưu trữ dữ liệu Google Search Console theo lịch, mặc định hằng tháng.
Cho biết một lần crawl theo lịch tốn bao nhiêu trước khi bạn thêm: số URL mỗi lượt chạy và số lượt chạy mỗi tháng.
Thông báo 15 phút trước khi lần crawl theo lịch bắt đầu, và cho biết nó chạy cả khi cửa sổ đã đóng.
Dời một lượt chạy 1, 3, 6 hoặc 9 giờ, hoặc sang một ngày giờ khác, hay bỏ qua nó, còn lịch vẫn giữ nhịp.
Dừng an toàn một lần crawl theo lịch đang chạy và đặt cho nó giờ mới.
Lặp lại Audit đầy đủ mỗi tháng từ bộ lập lịch; Neova hoàn tất phần phân tích và file PDF vào lần mở tiếp theo.
Phát cảnh báo khi Core Web Vitals đổi mức, lượt click 7 ngày gần nhất giảm từ 20% trở lên, một truy vấn được theo dõi rời khỏi hoặc vào top 10 hay tụt 3 bậc, hoặc một lần crawl mới có mục đánh dấu mới.
Giữ 300 cảnh báo mới nhất, với Kiểm tra ngay và Xóa cảnh báo.
Giữ Neova chạy khi cửa sổ đóng, trên thanh menu với tiến độ lần crawl cạnh đồng hồ.
Giữ biểu tượng trên Dock hoặc chỉ để biểu tượng trên thanh menu.
Khởi động Neova khi đăng nhập, với cửa sổ đóng sẵn.
Một trang cho điện thoại, thêm vào Màn hình chính bằng mã QR: lần crawl gần nhất của mỗi tài sản, Core Web Vitals, lượt click Google Search Console, từ khóa theo dõi, lượt chạy tiếp theo và các lần crawl đang chạy, được khóa ngay trên Mac trước khi rời máy.
Mac gửi bản tóm tắt 2 phút một lần khi có lần crawl đang chạy và 15 phút một lần những lúc khác; điện thoại kiểm tra 2 phút một lần và cho biết dữ liệu đã cũ bao lâu.
Tạo link cho một lần crawl đang chạy để ai cũng theo dõi được và biết khi nào nó xong, với key riêng, không để lộ gì khác.
Bản sao màn hình trực tiếp mà ai cũng mở được: tiến độ, Phân loại URL, URL Mới Nhất, Bản đồ crawl trực tiếp, Thời gian phản hồi, Redirect và lỗi, Mục kiểm tra và Liên kết & Tin tức.
Trang được chia sẻ có thể báo cho người xem khi lần crawl kết thúc.
Mọi nhóm 3xx, 4xx, 5xx và Không phản hồi của cả lần crawl, tối đa 100 URL mỗi nhóm, URL được link nhiều nhất trước.
Gửi cảnh báo và kết quả của mỗi lần crawl tới một hoặc nhiều kênh Slack qua incoming webhook, được xác nhận bằng một tin nhắn thử.
Gửi cảnh báo và kết quả của mỗi lần crawl tới các kênh Teams qua webhook của Workflows.
Gửi tin nhắn của từng portfolio hoặc tài sản tới kênh riêng của nó.
Thông báo hệ thống khi một lần crawl xong lúc Neova không ở phía trước, kèm âm thanh bạn chọn.
Liệt kê mọi việc Neova đang làm: lần crawl, một lần audit, Chạy các mục kiểm tra, một lần crawl theo lịch và hàng đợi, mỗi việc kèm nút mở nó.
Mọi con số có giá trị trước đó đều kèm mức thay đổi so với lần crawl tương đương gần nhất.
Chỉ tải một danh sách trang, không khám phá thêm, và phát cảnh báo trang khi mã trạng thái, đích redirect, title, canonical, noindex, H1 hoặc kích thước thay đổi.
Tình trạng lần crawl trong nháy mắt: Tóm tắt lần crawl, Mục kiểm tra hàng đầu, Hành động tiếp theo, Mã trạng thái và Thay đổi so với lần crawl trước, con số nào cũng mở danh sách của nó.
Mọi mục kiểm tra có mục đánh dấu: mức độ, số URL bị đánh dấu trên số URL đã kiểm tra, bao nhiêu URL index được, thay đổi so với lần crawl trước, danh mục và lượt click.
Mỗi mục kiểm tra có Đánh dấu khi, Điều này thường có nghĩa là gì và Bạn có thể làm gì, kèm ID, nguồn và Về mục kiểm tra này, nút mở trang của nó trong Thư viện mục kiểm tra.
Mọi URL với các bộ cột, bộ lọc trên bất kỳ cột nào, chế độ xem đã lưu, bộ chọn cột, cột URL cố định và 10, 25, 50 hoặc 100 dòng mỗi trang.
Mọi bảng và lưới đều xuất đúng những gì đang hiển thị ra CSV.
Mọi cột, số đếm và thẻ đều có ⓘ cho biết nó đếm gì.
Tám nhóm và 13 tab dựng từ 39 khối: tóm tắt, hiệu năng, kỹ thuật, Core Web Vitals, nội dung, từ khóa, tìm kiếm AI, mạng xã hội, đối thủ, cập nhật thuật toán, quy trình, chương trình và báo cáo.
Tối đa 10 dashboard của riêng bạn, tạo mới hoặc nhân đôi từ một tab, rồi thêm, di chuyển, đổi kích thước và gỡ khối.
Kế hoạch hành động dưới dạng chương trình theo trạng thái và người phụ trách, mục kiểm tra của từng hạng mục kèm số mục đánh dấu ở lần crawl gần nhất, tô đỏ khi hạng mục đã đặt là Xong mà vẫn bị đánh dấu.
Một ticket cho mỗi mục kiểm tra và nhóm trang, Cần sửa trước, kèm quy tắc, bằng chứng, URL bị ảnh hưởng, khi nào là xong, cách kiểm tra và chỗ cần sửa (là template khi 90% một nhóm bị đánh dấu).
Lần crawl sau đóng, giữ hoặc mở lại từng ticket theo key của nó, không bao giờ xóa ticket nào.
Mở đầu mọi ticket bằng mã của tài sản, chẳng hạn [DRH], và mang mã đó thành label sang Jira và Linear.
Tạo một issue Jira cho mỗi ticket Neova trong project Jira Cloud của bạn, kèm độ ưu tiên, label và danh sách URL đính kèm, không bao giờ tạo trùng.
Sau mỗi lần crawl đầy đủ từ cửa sổ, chuyển issue đã hết lỗi sang Done, mở lại issue bị lặp lại và cập nhật phần còn lại.
File đúng định dạng nhập CSV riêng của từng công cụ: Jira, Linear, Asana, ClickUp, monday.com, Azure DevOps Boards, Notion, Airtable, Smartsheet, và file to-do Markdown của Basecamp, mỗi file kèm trang nhập của công cụ đó.
Báo cáo cho khách hàng mang tên, logo và màu của bạn: lần crawl qua các con số, mục đánh dấu theo danh mục, việc cần sửa trước kèm URL ví dụ, render và mức hiển thị trên AI, thay đổi so với lần crawl trước và cách lần crawl được thực hiện, khổ Letter hoặc A4; các mục kiểm tra cùng loại chỉ tính một lần, mục thứ hai ghi là Cũng bị đánh dấu.
Cho mỗi khách hàng tên, logo và màu riêng trên báo cáo, kèm Chuẩn bị cho, Thực hiện bởi và ghi chú.
Một sổ làm việc: Tóm tắt, Ticket theo thứ tự sửa, Theo nhóm trang, một sheet cho mỗi mục kiểm tra với 1,000 URL nhiều lượt click nhất rồi được link nhiều nhất, và Tất cả mục đánh dấu.
Mọi trang HTML trả về 200, tối đa 200,000 trang, kèm title, description, H1, canonical, index được, độ sâu, inlink, sitemap, kích thước, thời gian phản hồi, lượt click và mục đánh dấu.
Gửi sổ làm việc lên Google Drive của bạn, chuyển sẵn sang Google Sheets.
Một file ZIP gồm những gì bạn chọn: file PDF, sổ làm việc bản chi tiết hoặc rút gọn, các ticket kèm danh sách URL, file cho Jira và Linear, và mọi URL bị đánh dấu thành một CSV cho mỗi mục kiểm tra, kèm README.
URL, mục đánh dấu và ticket dưới dạng file CSV, dùng cho CSV, Excel (UTF-8 có BOM), Google Sheets và Looker Studio.
Mỗi file xuất đều kèm ghi chú khi lần crawl chạy không render hoặc chỉ bao phủ một phần website.
Mặc định lưu file xuất trong Downloads, vào thư mục Neova exports.
Lưu file xuất vào thư mục bạn chọn trên máy tính.
Tải lên các tài khoản Google đã đăng nhập vào Neova qua chính giao diện của Google Drive, vào thư mục Neova exports của từng tài khoản, thay file trùng tên để link chia sẻ của nó vẫn hoạt động; Neova chỉ thấy file do chính nó tạo.
Lưu vào các thư mục mà app Google Drive, OneDrive, Dropbox, iCloud Drive, Proton Drive và kDrive đồng bộ trên Mac (OneDrive, Dropbox và Google Drive trên Windows), mỗi tài khoản đều tắt cho tới khi bạn bật.
Tải file xuất lên server của bạn qua SFTP bằng mật khẩu hoặc file key, FTPS, hoặc FTP thường, được thử kết nối trước khi lưu, key của server được ghi nhớ.
Lưu file xuất của từng portfolio hoặc tài sản trong thư mục hay ổ riêng của nó.
Trong Neova Online, ghi file xuất thẳng vào một thư mục trên máy tính của bạn khi dùng Chrome, Edge, Vivaldi, Brave và Arc; trình duyệt khác thì tải file về.
Trong Neova Online, file xuất dạng thư mục như các bảng CSV hay các trang Markdown được tải về thành một file ZIP.
Một link chỉ đọc của một portfolio hoặc tài sản, gồm các lần crawl, Kế hoạch hành động, phân tích, đối thủ và file bạn tick chọn, được mã hóa trên máy tính của bạn bằng một key chỉ đi kèm trong link; Cập nhật giữ nguyên địa chỉ, còn Tắt sẽ xóa link.
Việc cần làm theo thứ tự: soạn sẵn từ lần crawl (Cần sửa trước, rồi đến lượt click, rồi đến độ phủ), bạn sắp xếp lại và viết lại, thêm hạng mục của riêng bạn, kèm trạng thái, người phụ trách và ghi chú, giữ qua các lần crawl.
Sao chép kế hoạch dạng Markdown hoặc xuất ra CSV.
Viết bản audit đầy đủ ngay trên máy tính của bạn: hiện trạng, mục đánh dấu theo thứ tự ưu tiên, hiển thị trên tìm kiếm, từ khóa theo dõi, keyword gap và hành động ưu tiên được điền sẵn, còn các phần chỉ con người viết được thì ghi Cần viết.
Giữ các báo cáo bạn thêm (Markdown, văn bản, PDF hoặc Word) cùng tài sản, với Xác nhận đã xem xét.
Mở một email gửi Neova Labs có sẵn các con số của lần crawl, cho những phần không mục kiểm tra nào viết được.
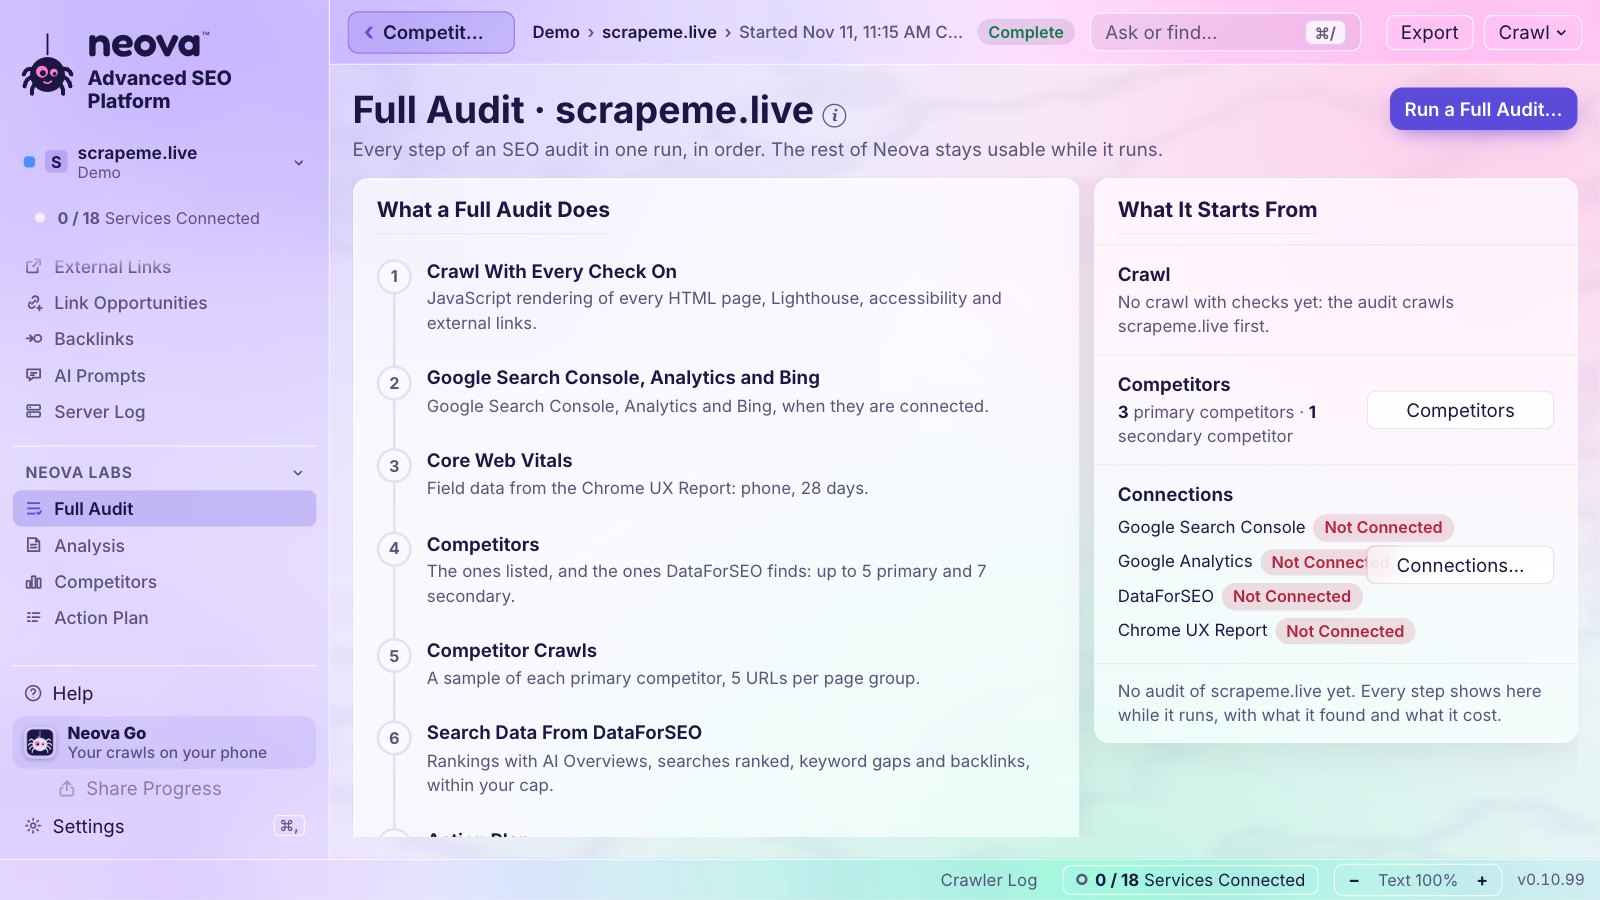
Chạy mọi bước trong một lượt: lần crawl bật mọi mục kiểm tra, Google, Bing và Analytics, Core Web Vitals, đối thủ và lần crawl của họ, dữ liệu tìm kiếm DataForSEO, Kế hoạch hành động, phần phân tích và báo cáo PDF có thương hiệu.
Chạy audit đầy đủ hỏi nên đọc lần crawl gần nhất hay crawl lại, kèm số URL và thời gian lần crawl đó mất.
Lần crawl A so với lần crawl B: URL mới, đã gỡ và đã thay đổi, mục đánh dấu mới và đã xử lý, lần crawl B tô màu tốt hơn hoặc tệ hơn.
Mọi thứ được giữ cho một tài sản, vượt quá thời hạn lưu của chính các nguồn: mọi lần crawl, mọi tháng Google Search Console, mọi ảnh chụp Core Web Vitals, các phiên bản robots.txt, sitemap XML và thay đổi URL.
Mọi gợi ý, ticket và báo cáo đều kèm dòng nhắc cần xem lại trước khi áp dụng, vì Neova thấy các trang chứ không thấy việc kinh doanh đằng sau.
Lần crawl theo lịch gửi kết quả lên Slack và Teams, còn Audit đầy đủ hằng tháng tạo PDF vào lần Neova mở tiếp theo; hiện chưa có file xuất nào được ghi theo lịch.
Báo cáo PDF và sổ làm việc cho biết các trang được render ra sao (tổng thể, theo nhóm trang và từng trang), robots.txt cho mỗi bot AI lấy gì và server trả cho nó gì, và mục kiểm tra Tìm kiếm AI nào đạt hay bị đánh dấu.
Một Google Sheet dựng riêng cho Sheets từ lần crawl: Tổng quan có biểu đồ, Kế hoạch hành động với danh sách thả xuống Người phụ trách, Trạng thái và Hạn, Vấn đề, URL, Mục đánh dấu, Nhóm trang, Redirect & lỗi, Render & AI và Giới thiệu, lưu vào tài khoản Google của bạn thành file mới mỗi lần.
Mọi file Neova tạo từ một lần crawl (Gói cho khách hàng, PDF, sổ làm việc, Google Sheet, file xuất, tệp Neova) đều được liệt kê kèm nơi lưu, lần crawl, ngày và kích thước, với Mở, Mở thư mục, Sao chép đường dẫn và Mở trong Google Drive.
Vẫn cửa sổ Neova đó, nhưng trong trình duyệt tại app.neova.app, engine chạy trên server của Neova, crawl và kiểm tra ngay tại đó.
Tài khoản được mở từ link mời, ghi đích danh hoặc dùng chung, mỗi link một tài khoản.
Mật khẩu lưu dạng hash, phiên đăng nhập kéo dài 30 ngày tính từ lần ghé gần nhất, phải chờ sau 10 lần sai mật khẩu, request từ website khác bị từ chối, và có ghi chú khi trang được mở trong trình duyệt tích hợp của app khác.
Lần crawl, dữ liệu và file tải về của mỗi người nằm trong thư mục riêng, người khác không bao giờ đọc được.
Mỗi người một việc tại một thời điểm, 10,000 URL mỗi lần crawl, 10 URL mỗi giây và 10 GB dữ liệu crawl mỗi tài khoản trong lúc Neova Online đang thử nghiệm.
Kết nối Google Search Console, Google Analytics 4 và Google Drive từ trình duyệt, phiên đăng nhập được giữ trong không gian riêng của bạn.
Key và webhook được giữ trong tài khoản Neova Online của bạn, không bao giờ hiện lại.
Mọi tài khoản mới đều bắt đầu với một Demo: một shop thử nghiệm và 3 đối thủ đã crawl sẵn, kèm cài đặt portfolio, mã và Kế hoạch hành động, gỡ được trong một bước.
Lời mời có thể mang theo các portfolio sao chép từ tài khoản khác, cùng lần crawl gần nhất, cài đặt và kế hoạch, kèm một banner trong lúc chúng được chuẩn bị.
Cửa sổ vừa với điện thoại và tablet: thanh bên thành ngăn kéo, hộp thoại chiếm cả màn hình trong một cột, bảng cuộn ngang.
Đăng nhập app desktop vào Neova Online một lần; app giữ một key cho máy tính đó, không bao giờ giữ mật khẩu.
Tự giữ khớp portfolio, đối thủ, thứ tự của bạn, lựa chọn Google Search Console và Google Analytics 4, màu và mã.
Khi một bên đã có nội dung của bên kia, việc đăng nhập gộp ngay mà không hỏi; khi hai bên thật sự khác nhau, Neova hỏi nên bắt đầu từ đâu: Giữ bản của Neova Online, Giữ bản của máy Mac này hoặc Gộp cả hai (khuyên dùng, không mất gì), kèm số lượng của từng bên và một bản sao lưu được cất riêng trước.
Tải lên hoặc tải xuống nguyên lần crawl theo từng phần có thể tiếp tục, được kiểm tra khi xong, song song với bất kỳ lần crawl nào đang chạy.
Gửi mỗi lần crawl xong trên máy tính này lên Neova Online; mặc định tắt.
Neova Online hiện bản deploy mới ngay ở lần tải trang kế tiếp, không bao giờ hiện cửa sổ cũ trong cache.
Cung cấp bộ cài và video hướng dẫn cho tester, đặt noindex.
Mang các key kết nối mà tài khoản Neova Online của bạn đang giữ về máy tính này, hoặc gửi key của máy này lên đó, sau khi bạn nhập mật khẩu, chỉ hiện 4 ký tự cuối của mỗi key và không bao giờ thay key nào trừ khi bạn tick Thay thế.
Mỗi tài khoản Neova Online được giữ 10 GB dữ liệu crawl; Cài đặt cho biết tài khoản đang dùng bao nhiêu và có bao nhiêu lần crawl, cảnh báo từ 85%, và lượt tải lên hay lần crawl vượt dung lượng còn lại sẽ bị từ chối, kèm hướng dẫn cần làm gì.
Neova SEO Platform cho Mac, engine tích hợp sẵn dưới dạng mã native, crawl ngay trên máy tính của bạn.
Bộ cài Windows x64 cho riêng tài khoản của bạn, không cần mật khẩu quản trị viên; bản build cho tester, chưa được ký số.
Trên Windows, app nói “PC này” và dùng Ctrl cho mọi phím tắt ⌘.
App desktop trên Linux: file .deb cho Ubuntu, Linux Mint và Debian, và một AppImage không cần cài đặt.
Cửa sổ và Thư viện mục kiểm tra bằng tiếng Anh, Pháp, Đức, Tây Ban Nha, Bồ Đào Nha (Brazil), Ý, Nhật, Hà Lan, Ba Lan, Thổ Nhĩ Kỳ, Hàn, Trung (giản thể), Nga, Indonesia và tiếng Việt.
Neova Cẩm thạch (mặc định), Neova, macOS, Liquid Glass, Windows 11, Linux, Terminal và Độ tương phản cao; mỗi kiểu giao diện chỉ đổi màu, không bao giờ đổi vị trí các thành phần.
Sáng, tối hoặc theo lựa chọn của hệ thống, kèm màu nhấn.
Dòng Gọn hoặc Thoáng, và chữ phóng to thu nhỏ bằng ⌘+ và ⌘−.
Hiện URL dạng đường dẫn hoặc kèm giao thức và host, trong mọi bảng.
Viết ngày giờ theo cách của bạn hoặc theo cách của ngôn ngữ đang dùng.
Hiện hoặc ẩn dòng Trang chủ; tên Neova ở góc trên bên trái lúc nào cũng mở Trang chủ.
⌘N Lần crawl mới, ⌘K Tìm tài sản, ⌘, Cài đặt, ⌘[ Quay lại, ⇧⌘P Chế độ trình chiếu, ⌘/ Hỏi hoặc tìm.
Một ô duy nhất tìm được chế độ xem, mục kiểm tra theo tên hoặc ID, một trang của lần crawl, một tài sản hoặc một cài đặt, kèm các lựa chọn gần đây.
Câu hỏi dài hơn được chuyển cho một model trên máy tính của bạn, model này chọn câu trả lời từ những gì cửa sổ đang hiện, nên không bao giờ bịa ra con số.
Làm mờ mọi portfolio trừ portfolio đang mở, để chia sẻ màn hình với khách hàng.
Trở về màn hình trước, tên màn hình đó ghi ngay trên nút.
Một kiểu viền focus duy nhất, dòng nào cũng tới được bằng Tab, phím mũi tên trong bảng, sheet hoạt động như hộp thoại, và tôn trọng thiết lập giảm chuyển động.
Kéo thanh bên, danh sách mục kiểm tra và khung chi tiết tới độ rộng bạn muốn.
Khi có lần crawl đang chạy, lệnh Thoát hỏi một lần, rồi lưu lần crawl và hiện từng bước cùng tiến độ, sau đó Tiếp tục sẽ chạy tiếp.
Nêu tên mọi lần crawl theo lịch đang chạy nền và đề nghị dừng rồi lưu lại trước khi thoát.
Lần crawl đang chạy khi Neova được cập nhật sẽ tự lưu và được chạy tiếp bằng Tiếp tục.
Khi dừng, chỉ ghi thêm phần HTML mới và báo từng bước lưu bằng thanh tiến độ, kèm nút Đóng ngay.
Theo dõi dung lượng trống của ổ đĩa trong lúc crawl, cảnh báo khi sắp đầy và dừng an toàn khi còn dưới 3 GB, để Tiếp tục chạy tiếp khi đã giải phóng dung lượng.
Lần crawl bị ngắt do crash hoặc pipe bị đóng được liệt kê là bị gián đoạn, không bao giờ bị bỏ, và kho dữ liệu của nó được đưa về trạng thái an toàn trước đó.
Hàng đợi và các lần audit vẫn chạy khi cửa sổ bị ẩn.
Kiểm tra app.neova.app xem có bản build mới hơn không khi app mở, 30 phút một lần và khi cửa sổ quay lại phía trước, chỉ gửi số phiên bản.
Sao chép cài đặt của cửa sổ ra một file sau mỗi lần thay đổi, mỗi phiên bản một bản sao lưu, được khôi phục nếu bộ nhớ của cửa sổ bị reset.
Đổi nơi Neova lưu các lần crawl.
Biểu tượng có chữ Neova SEO dưới con nhện, từ cỡ 64 px trở lên.
Khi có bản build mới hơn, dòng Có phiên bản mới hiện ở góc trên bên trái, trên thanh công cụ, đầu menu Trợ giúp và trong Cài đặt › Chung, kèm nút Tải xuống; app kiểm tra 30 phút một lần và khi cửa sổ quay lại phía trước.
Mọi bảng đặt độ rộng cột theo nội dung, nhường phần còn lại cho URL và các cột bị cắt trước; đầu mỗi cột có tay nắm để kéo, nhấp đúp để vừa khung, và độ rộng bạn đặt được giữ lại.
Một linh vật hoạt hình tùy chọn, 8 con để chọn (Webster, The Head, Sir Canonical, Polly Glot, Hopper, Shelly, Bo, Zap), dễ thương hoặc pixel art, theo dõi các lần crawl của bạn; mặc định là Không có, và khi chọn Không có thì không tải gì cả.
Một bong bóng thoại khi lần crawl cần bạn: lần crawl kết thúc kèm các mục kiểm tra Cần sửa và số mục mới, lần crawl dừng hoặc lỗi, website chặn crawler, ổ đĩa sắp đầy, lần crawl đã lên lịch bắt đầu; một cú nhấp mở đúng màn hình được nhắc tới.
Nhấp vào thú cưng để biết Neova đang làm gì và, khi đang mở một lần crawl, đặt câu hỏi về nó; câu trả lời đi qua cùng đường với thanh Hỏi (Ollama trên máy bạn hoặc khóa AI của riêng bạn).
Trên màn hình nền, thú cưng có cửa sổ riêng nằm trên mọi cửa sổ và trên mọi Space, không nằm trong Dock; Neova vẫn theo dõi khi thu nhỏ và một cú nhấp đưa nó trở lại đúng màn hình.
Bảy kích thước từ Tí hon (56 px) đến Siêu khổng lồ (320 px), mặc định là Lớn, và một thanh công cụ dưới thú cưng: Mở Neova, Crawl mới, Đang thực hiện và Thêm (ẩn, cài đặt, tắt tiếng), hiện khi di chuột hoặc luôn luôn.
Lần crawl được lưu trong Application Support/Neova trên Mac và %APPDATA%/Neova trên Windows; không có gì được gửi tới Neova trừ khi bạn đồng bộ hoặc chia sẻ.
Mọi key, token và phiên đăng nhập đều vào keychain của hệ thống qua standard input của engine, không bao giờ qua file, dòng lệnh hay màn hình.
App không mang key nào của Neova: Google, Chrome UX Report, DataForSEO và các dịch vụ khác dùng key và tài khoản của chính bạn.
Engine được phát hành dưới dạng mã native, không có mã nguồn đọc được.
Google được kết nối với scope chỉ đọc cộng email của bạn; Ngắt kết nối sẽ thu hồi token ngay tại Google.
DataForSEO luôn tắt trừ khi Lần crawl mới bật nó cho lần crawl đó.
Trước khi Bắt đầu, ước tính chi phí dựa trên số tiền DataForSEO đã tính cho máy tính này ở 20 lần gọi gần nhất của mỗi loại, nếu chưa có thì theo bảng giá, làm tròn lên mức $0.50 hoặc đô la chẵn kế tiếp.
Ngừng gọi DataForSEO khi chạm mức chi tối đa bạn đặt, từ $0.50 đến $10 mỗi lần crawl, mặc định $1.
Dữ liệu tìm kiếm của Audit đầy đủ dừng ở mức chi tối đa riêng, tính bằng đô la Mỹ, và cho biết đã chi bao nhiêu.
Log server được đọc trên máy tính của bạn; không địa chỉ IP nào được ghi lại ở đâu cả.
Đánh giá AI và Hỏi dùng một model trên máy tính của bạn qua Ollama, nên không có gì rời khỏi máy; Prompt AI cho biết khi nào văn bản của trang được gửi tới nhà cung cấp bạn chọn.
Link chia sẻ, Neova Go và Chia sẻ tiến độ được mã hóa trên máy tính của bạn, key chỉ nằm trong link hoặc mã QR, nên server lưu những gì nó không đọc được.
Việc chia sẻ bạn mở trang nào trong bảng thuật ngữ mặc định tắt, và chỉ gửi một ID ngẫu nhiên, mục kiểm tra và ngôn ngữ.
Lần crawl bị xóa sẽ vào Thùng rác, nơi có thể khôi phục lại, kèm chọn hàng loạt các lần crawl cũ đã dừng.
NeovaBot nói rõ nó là ai, tôn trọng robots.txt, mặc định 3 URL mỗi giây, và không bao giờ giải CAPTCHA.
Lưu một lần crawl, một tài sản cùng mọi lần crawl và dữ liệu của nó, hoặc một portfolio thành một file .neova, có hoặc không kèm HTML đã lưu, vào Downloads, Google Drive, ổ hay thư mục bất kỳ; lịch, kết nối, key và mật khẩu không bao giờ nằm trong đó.
Cài một file .neova tạo trên bất kỳ máy Mac, Windows hay Linux nào, cho biết cái gì mới, cái gì đã có hoặc sẽ mang tên khác trước khi ghi bất cứ thứ gì, và không bao giờ thay thế những gì máy này đang giữ.
Lệnh neova crawl, nhập, xuất bản và đọc website, trang, mục đánh dấu, ticket và cảnh báo từ Terminal hoặc script, dưới dạng bảng, CSV hoặc JSON.
neova check so sánh một lần crawl với baseline và thoát với mã 3 khi có mục đánh dấu mới, hoặc khi một mục đánh dấu tăng vượt một tỷ lệ URL.
Cho trợ lý AI quyền đọc các lần crawl, mục đánh dấu, ticket và cài đặt của bạn qua 16 công cụ, dữ liệu vẫn nằm trên máy tính của bạn.
Thêm Neova vào Claude Desktop chỉ với một cú nhấp, kèm cấu hình sao chép được cho Claude Code, Codex, Cursor, VS Code, Gemini CLI, LM Studio, Windsurf và ChatGPT.
Bắt đầu, dừng và xóa lần crawl từ trợ lý, mỗi lần bắt đầu hay xóa đều hỏi bạn đồng ý trước.
Đọc log của một lần crawl và chỉ ra điều gì đã sai (chuỗi lỗi 429 hoặc 503, lỗi 403, chặn bởi robots.txt, trang chỉ chạy bằng JavaScript, quá ít trang) kèm cài đặt cần đổi.
Một file JSON thuần chứa danh sách loại trừ, các giá trị mặc định, cài đặt và công tắc mục kiểm tra của từng tài sản.
Mở file xuất Internal của Screaming Frog (kèm All Inlinks), file xuất URL của Sitebulb, JSON của SiteOne Crawler hoặc bất kỳ CSV nào có cột URL, rồi chạy các mục kiểm tra của Neova trên đó.
Chấm điểm bản nhập bằng cách tải lại một mẫu 50 URL ở tốc độ 2 URL/s và đối chiếu với sitemap thật, để bản nhập không bao giờ giả làm một lần crawl.
HTTP API của Neova Online tại app.neova.app/api/v1: đọc portfolio, tài sản, lần crawl, mục đánh dấu và ticket, bắt đầu crawl và quản lý ticket, mỗi script có key Chỉ đọc hoặc Đọc và ghi riêng, 60 request mỗi phút cho mỗi key và 20 key mỗi tài khoản.
Request từ công cụ tìm kiếm và bot AI theo từng URL của lần crawl, lấy từ access log của chính website.
Chỉ tính một request là của Googlebot, Bingbot hay một bot AI khi địa chỉ của nó nằm trong danh sách mà công ty đó công bố; tên bị mạo danh ở nơi khác được đếm riêng.
Liệt kê trang HTML mà Googlebot chưa từng ghé trong khoảng thời gian của log, và URL bot đã yêu cầu nhưng lần crawl không biết tới.
Đếm số phản hồi 429 và 403 mà mỗi bot nhận được.
Đọc log combined của Apache hoặc Nginx, dạng thường hoặc nén gzip.
Với website chạy sau Cloudflare, thu thập request của công cụ tìm kiếm và bot AI ngay trong tài khoản Cloudflare của bạn và đọc chúng trước mỗi lần crawl, không cần quyền truy cập server.
Soạn sẵn yêu cầu gửi bộ phận IT: chỉ các dòng của crawler, không cần cài gì, và những gì bộ phận bảo mật cần biết.
Một khối Dashboard hiển thị request của các bot.
Ghép mọi URL trong lần crawl website cũ với lần crawl website mới kèm mức độ tin cậy, cho việc chuyển website trên cùng tên miền hoặc sang tên miền khác.
Kiểm tra redirect thực tế của từng URL cũ so với bản đồ và đánh dấu các redirect sai hoặc thiếu.
So sánh một lần crawl staging với production: mã trạng thái, noindex, canonical, title, meta description, H1 và các URL chỉ có trong một lần crawl.
Đổi lần crawl nào là cũ và mới, hoặc là staging và production.
Bỏ qua robots.txt và chạy nhanh hơn trên website bạn xác nhận là của mình, có HTTP authentication và header tùy chỉnh.
Crawl một danh sách URL cũ để xem mỗi URL dẫn tới đâu.
Khi trang bắt đầu của một tên miền phụ staging chủ yếu link tới website thật, Lần crawl mới hiện số lượng và thêm quy tắc Viết lại URL cùng sitemap XML của website thật chỉ bằng một cú nhấp; sitemap XML đã thêm mà không quy tắc nào chuyển về website đang crawl sẽ bị đánh dấu trước khi crawl bắt đầu.
Mỗi tài sản của bạn là một khối mang màu và logo riêng cùng các con số chính, đối thủ của nó là các dòng bên dưới.
Kéo tài sản theo thứ tự của riêng bạn, được giữ trên Mac, online và trên điện thoại.
Thu gọn một nhóm thành một dòng, Thu gọn tất cả và Mở rộng tất cả, và ô tìm kiếm ghim sẵn, mở bằng phím /.
Bảng mọi tài sản, mỗi đối thủ lồng dưới tài sản của nó.
Một trung tâm cho mỗi website: các lần crawl, Cho khách hàng, Core Web Vitals, Google Search Console, đối thủ, Kế hoạch hành động, phân tích và lịch trình.
Báo cáo có thương hiệu (PDF), Sổ làm việc tất cả mục đánh dấu (Excel) và các ticket, mỗi thứ một nút, tạo từ lần crawl đang mở.
Mỗi nút trên phần đầu màn hình Tài sản cho biết nó làm gì và khác nút kia ra sao.
Gom tài sản theo khách hàng hoặc công ty, có màu riêng, và portfolio con sâu một cấp.
Gán cho mỗi tài sản một màu và một mã 2 đến 6 chữ cái, gợi ý từ tên miền của nó.
Tìm một tài sản bằng ⌘K, các tài sản đã ghim và đang chạy lên đầu, mỗi portfolio kèm các tài sản và đối thủ của nó bên dưới.
5 lần crawl gần nhất của tài sản, kèm kết quả của từng lần, một cú nhấp là mở.
Chọn lần crawl bằng ô đánh dấu hoặc bằng Chọn các lần cũ đã dừng và bị gián đoạn, rồi Xóa mục đã chọn.
Mỗi dòng trong danh sách có một nút chính, rồi ⋯ và chuột phải với mọi thao tác, Xóa nằm cuối cùng, màu đỏ.
Thư viện mục kiểm tra tại app.neova.app/checks, Trợ giúp Neova SEO Platform, Có gì mới, Báo sự cố, phím tắt và Kiểm tra cập nhật.
Tải xuống, cài đặt, lần crawl đầu tiên, Neova Online và app desktop, các kết nối tùy chọn và nhật ký thay đổi, tại app.neova.app/help.
Cả 694 mục kiểm tra theo nhóm tại app.neova.app/checks, mỗi mục có trang riêng và nguồn riêng, mở từ Về mục kiểm tra này ở bất cứ đâu có tên một mục kiểm tra.
Nói một lần rằng kết quả của Neova là phân tích tự động để tham khảo, và bạn quyết định thay đổi gì.
Khung của mỗi mục kiểm tra đều có Về mục kiểm tra này, mở trang riêng của mục đó trong Thư viện mục kiểm tra, cho biết nó đánh dấu gì và nguồn của nó.
Mọi phiên bản từ bản build đầu tiên, mới nhất lên đầu, mỗi thay đổi gắn nhãn Mới, Cải thiện hoặc Đã sửa kèm giờ phát hành theo múi giờ của bạn, tự mở một lần sau mỗi lần cập nhật; phần Sắp ra mắt ở trên cùng liệt kê những gì đã lên kế hoạch.
Tạo một file ZIP cho bộ phận hỗ trợ, gồm các phiên bản của app, log và các file nhỏ của lần crawl được chọn, bí mật được che đi, và cho biết file chứa gì, không bao giờ chứa gì trước khi tạo.
Không có tính năng nào khớp với tìm kiếm này.
Gói Free, hoặc 14 ngày Desktop miễn phí, không cần thẻ. Mac, Windows và Linux. Các lần crawl của bạn vẫn ở trên máy tính của bạn.
Tải NeovaNeova Online, cùng Neova trên trình duyệt, đi kèm Desktop + Online và Agency: xem các gói.