Crawl meerdere sites tegelijk en kijk live mee
Meerdere sites tegelijk, elk in een eigen tempo, op een live kaart van elke URL zodra die binnenkomt.

Gebouwd door SEO's, voor SEO's. Neova crawlt vanaf je eigen computer en vertelt je daarna welke meldingen ertoe doen en wat je eerst oplost, schrijft de tickets, maakt het rapport voor de klant en houdt de site in de gaten. Twee minuten video, daarna alles.
De crawl is het begin. Dit doet Neova ermee.
Meerdere sites tegelijk, elk in een eigen tempo, op een live kaart van elke URL zodra die binnenkomt.

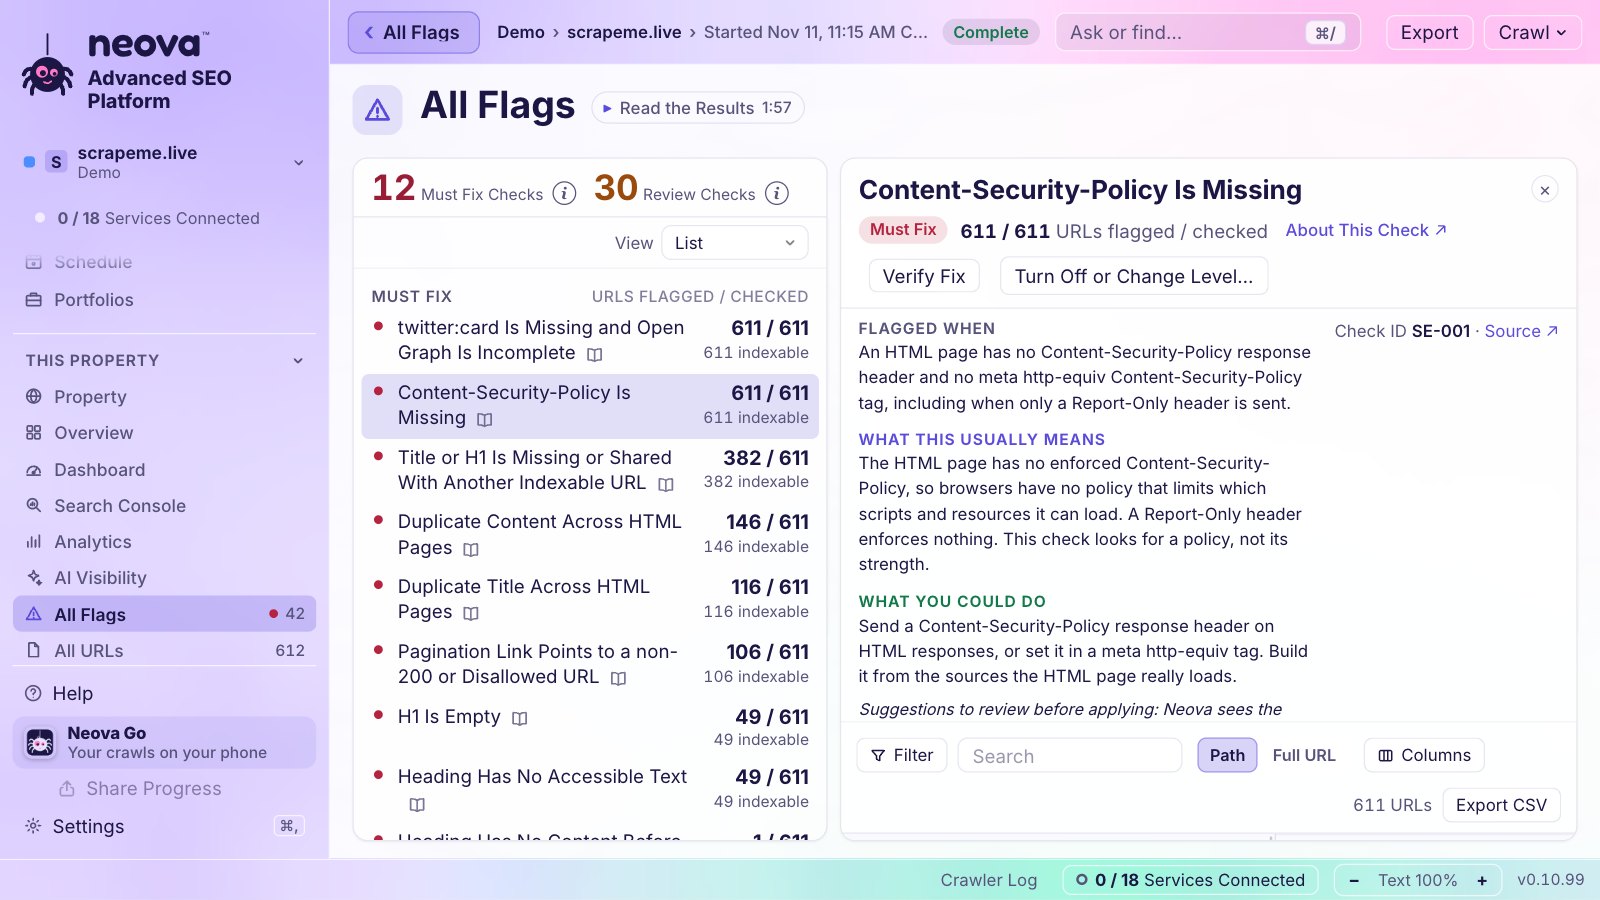
Elke melding zegt waarom die afgaat, wat die meestal betekent en waar de regel vandaan komt.

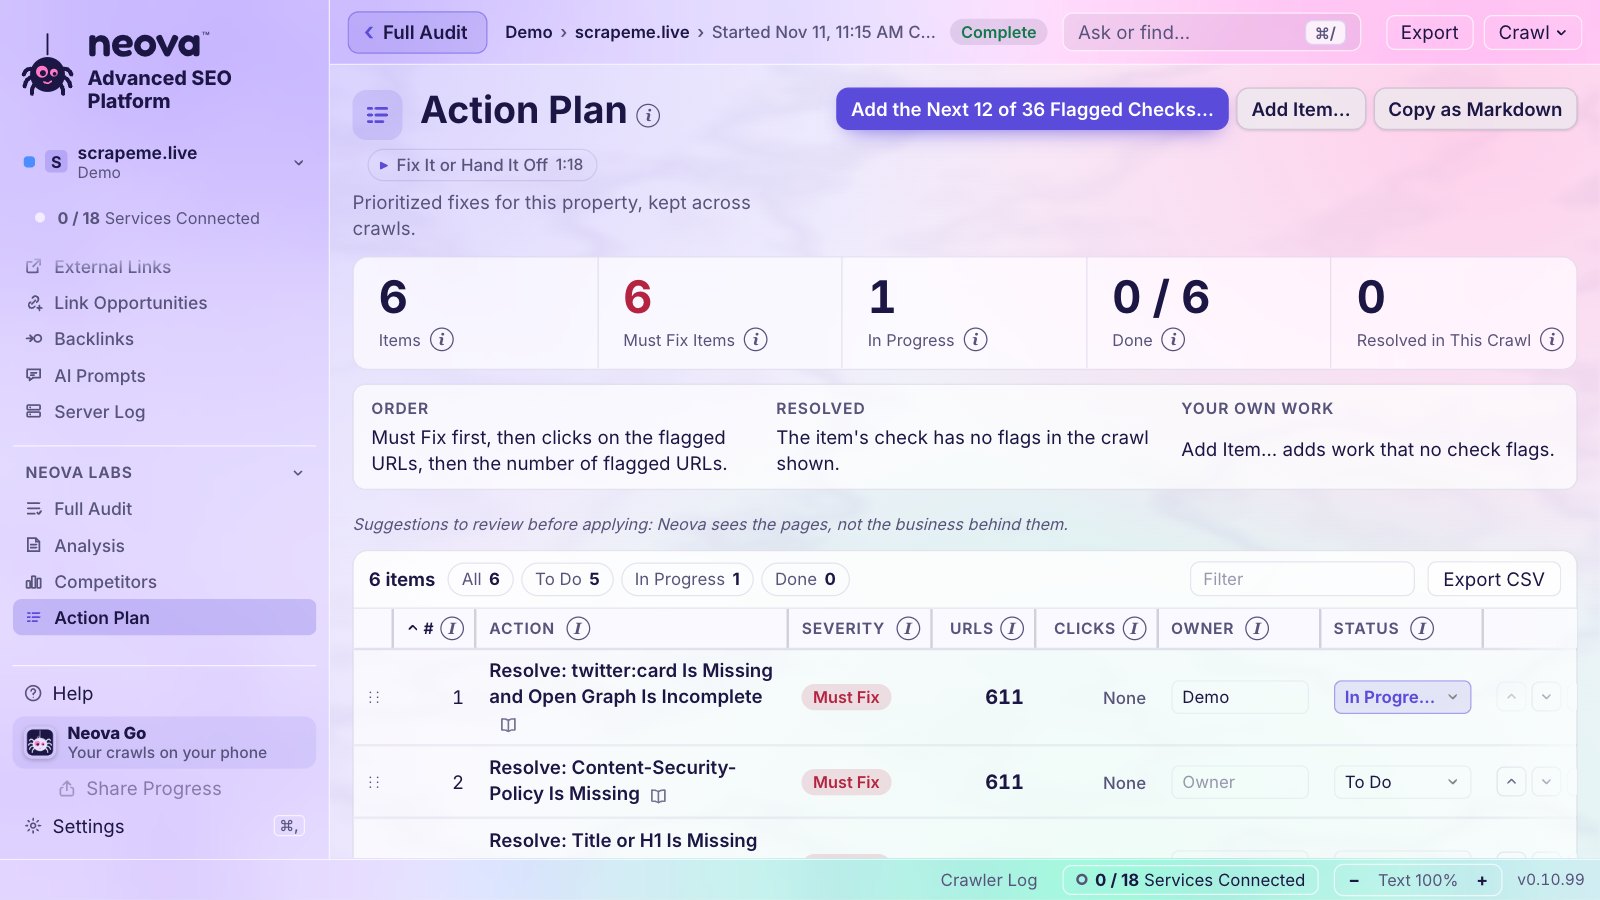
Meldingen worden werk: eigenaars, status, Moet opgelost eerst, bewaard van crawl tot crawl.

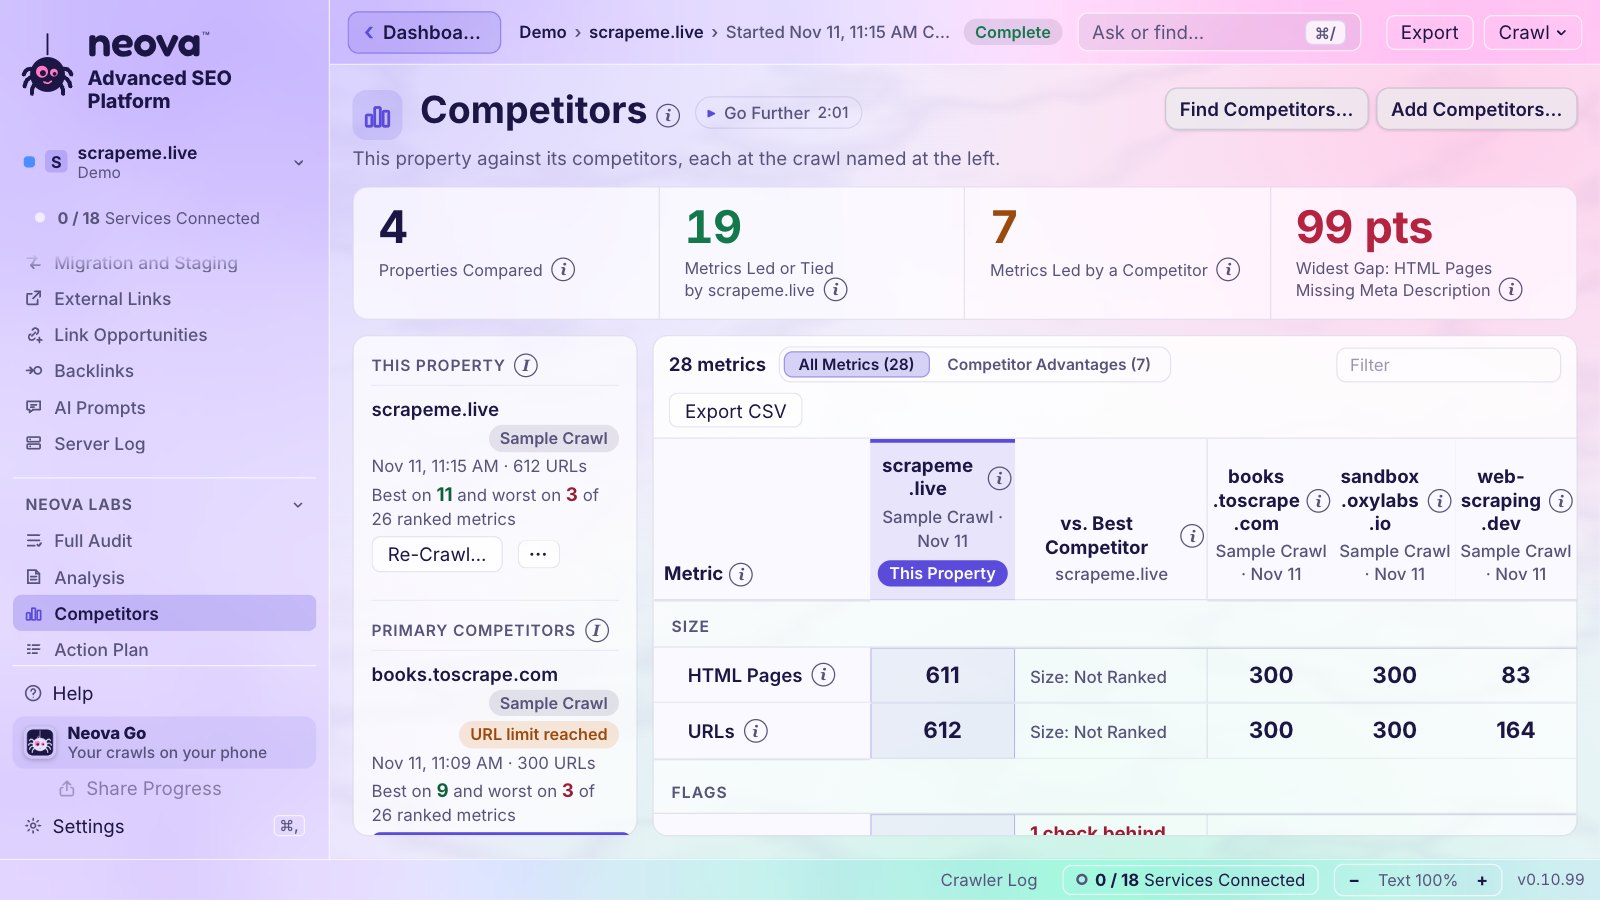
Plak een lijst. Neova stemt elke crawl af op hun sitemaps en laat zien wie voorligt, metric voor metric.

Wat echte bezoekers op hun telefoon krijgen, per paginagroep, met een alert als een score verandert.

Open hun exports en laat de checks van Neova los op wat ze vonden. Houd de tools die je fijn vindt.
Sluit het venster. De crawl loopt door in de menubalk en je telefoon toont elke property.

Alles wat je klant krijgt, vanuit één plek, versleuteld op je computer voordat er een link wordt gedeeld.
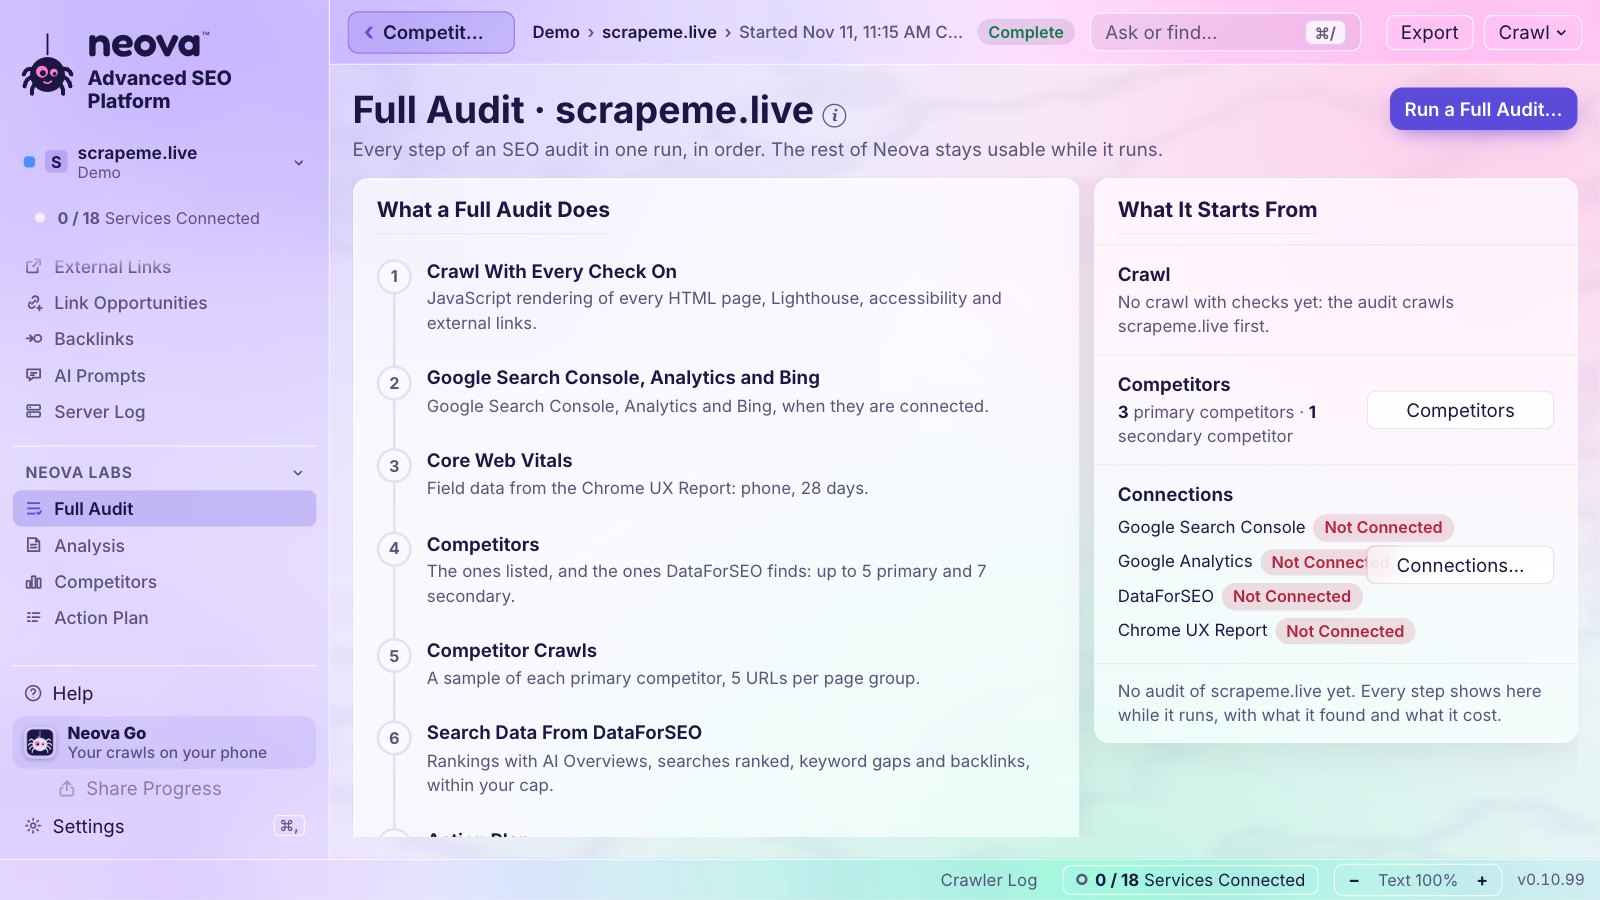
De crawl, Google, Bing en Analytics, Core Web Vitals, concurrenten, het plan en de PDF, in één run.

Een geanimeerde mascotte die op je bureaublad zit en je crawls in de gaten houdt. Hij meldt zich als een crawl je nodig heeft, beantwoordt je vragen over de crawl en brengt je met één klik naar het juiste scherm. Optioneel, en uit tot je er een kiest.
31 diensten, allemaal optioneel: Neova doet zijn werk zonder een van hen, en doet meer met ze.
Open een gebied om elke functie erin te zien, of doorzoek ze allemaal.
Een live log van de crawl: elke opgehaalde URL met een gekleurde statuscode en responstijd, elke stap vetgedrukt, fouten in rood en waarschuwingen in oranje; Log kopiëren bewaart elke regel voor support.
Volgt de interne links vanaf een start-URL, en de XML-sitemaps als die aanstaan, zoals een zoekmachine een site ontdekt.
Crawlt alleen de URL's die je plakt of uit een bestand uploadt, verder niets.
Leest de site voordat de crawl begint en kiest de versie (http of https, met of zonder www) die 200 antwoordt, en zegt wat de andere versies doen.
Vraagt of de subdomeinen die Neova vond gecrawld moeten worden, en welke.
Crawlt de hele site zonder URL-limiet, tenzij je er een instelt.
Crawlt alleen de mappen die je intypt, en beoordeelt de volledigheid aan de hand van de URL's uit de XML-sitemap daaronder.
Crawlt een vast aantal pagina's uit elke paginagroep, zodat een grote site in minuten wordt geaudit met elke template gedekt.
Drie niveaus in één keuze: Alleen crawl, Site-audit (voegt Core Web Vitals en een concept-Actieplan toe) en Volledige audit (voegt concurrenten, zoekdata en de analyse toe).
Voegt extra start-URL's toe uit een TXT- of CSV-bestand of geplakt, om pagina's te bereiken waar geen link naartoe leidt.
Crawlt de URL's uit de XML-sitemaps die robots.txt opgeeft, na de pagina's die de links bereiken.
Leest extra XML-sitemaps die je zelf opgeeft, naast die uit robots.txt, bij elke crawl van de property.
Kiest welke resources naast HTML-pagina's worden gecrawld: afbeeldingen, CSS, JavaScript en PDF's.
Pagina's eerst haalt elke HTML-pagina op vóór afbeeldingen en bestanden, zodat de kern van de audit eerst klaar is; Op diepte haalt eerst op wat het dichtst bij de start-URL ligt.
Legt links in menu, footer en filters vast zonder ze te volgen; links in de content worden altijd gevolgd.
Crawlt of slaat URL's over op regex-patroon, één per regel, met een veld om een URL ertegen te testen.
Eén uitsluitlijst die elke crawl gebruikt, wie hem ook start: het venster, een planning of een AI-assistent.
Herschrijft URL's met regex-regels voordat ze worden gecrawld, bijvoorbeeld om trackingparameters te schrappen, of om de links van een stagingsite naar de live site, en de XML-sitemaps van de live site, naar de staginghost te verplaatsen.
Houdt querystrings vast of laat ze weg tijdens het crawlen.
Crawlt interne links met rel=nofollow als je dat wilt.
Behandelt /Page en /page als één URL.
Laat een crawl die in een map begint verder gaan dan die map.
URL-limiet, Limiet crawldiepte, Max. URL's per map, Max. URL-lengte en Max. queryparameters, om gefacetteerde navigatie in toom te houden.
Crawlt standaard 3 URL's per seconde en halveert zelf de snelheid als de server trager wordt of 429 of 503 antwoordt, met respect voor Retry-After.
Verdeelt elk verzoek over de tijd op het gevraagde tempo, robots.txt en XML-sitemaps inbegrepen, zodat de site nooit een piek krijgt.
Zodra je bevestigt dat de site van jou is, gaat het tot 50 URL's per seconde en kan robots.txt genegeerd worden, voor je eigen site of een stagingserver.
Crawlt standaard als NeovaBot, of als Googlebot, Bingbot, Applebot, AI-crawlers zoals GPTBot en ClaudeBot, SEO-tools, browsers of een eigen string.
Respecteert de live robots.txt, negeert hem voor een site die van jou is, of respecteert een concept dat je in de robots.txt-tester hebt opgeslagen, om te zien wat een wijziging zou doen.
Rendert de HTML-pagina's na de crawl in Chrome, allemaal of een paar per paginagroep, en vergelijkt de gerenderde pagina met de ruwe HTML; staat standaard uit.
Wacht tot het netwerk stil is en de pagina niet meer verandert, tot een vaste limiet, en zegt het als een pagina nog aan het veranderen was.
Zegt boven de resultaten dat een crawl zonder rendering liep, hoeveel checks daardoor niet konden draaien, en biedt Opnieuw crawlen met rendering aan.
Haalt elke URL op met Chrome zoals een bezoeker, voor sites met botbescherming; een CAPTCHA los je zelf op en Neova wacht op je.
Stuurt HTTP-authenticatie, cookies en eigen headers alleen naar de gecrawlde site, voor stagingsites en afgeschermde delen.
Maakt een geheime header voor een site die je beheert, die alleen naar die site gaat, met de regel voor het IT-team zodat de firewall Neova doorlaat.
Slaat een configuratie op onder een naam om op elke site te hergebruiken, met in één oogopslag wat ze instelt.
Geeft een property eigen crawlinstellingen waar Nieuwe crawl, Opnieuw crawlen en haar planningen van uitgaan, met Standaardinstellingen herstellen.
Toont de instellingen die de meeste mensen aanpassen, of elke instelling met een uitleg hoe die werkt.
Zet elke instelling die afwijkt van de standaard op een rij voordat de crawl start, elk met een link Bewerken.
Leest eerst een paar pagina's en zegt hoeveel URL's de XML-sitemaps bevatten, welke afbeeldingen en bestanden je kunt verwachten, en hoeveel schijfruimte nodig is tegenover de vrije ruimte.
Zegt op basis van de voorbeeldpagina's hoeveel afbeeldingen per pagina er zijn, welke parameters de links meedragen en welke adressen verkeerd geschreven zijn.
Controleert de Google-verbinding van de property voordat een crawl of audit start, en houdt die tegen met Opnieuw aanmelden, Crawlen zonder deze gegevens of Annuleer als de aanmelding niet meer werkt.
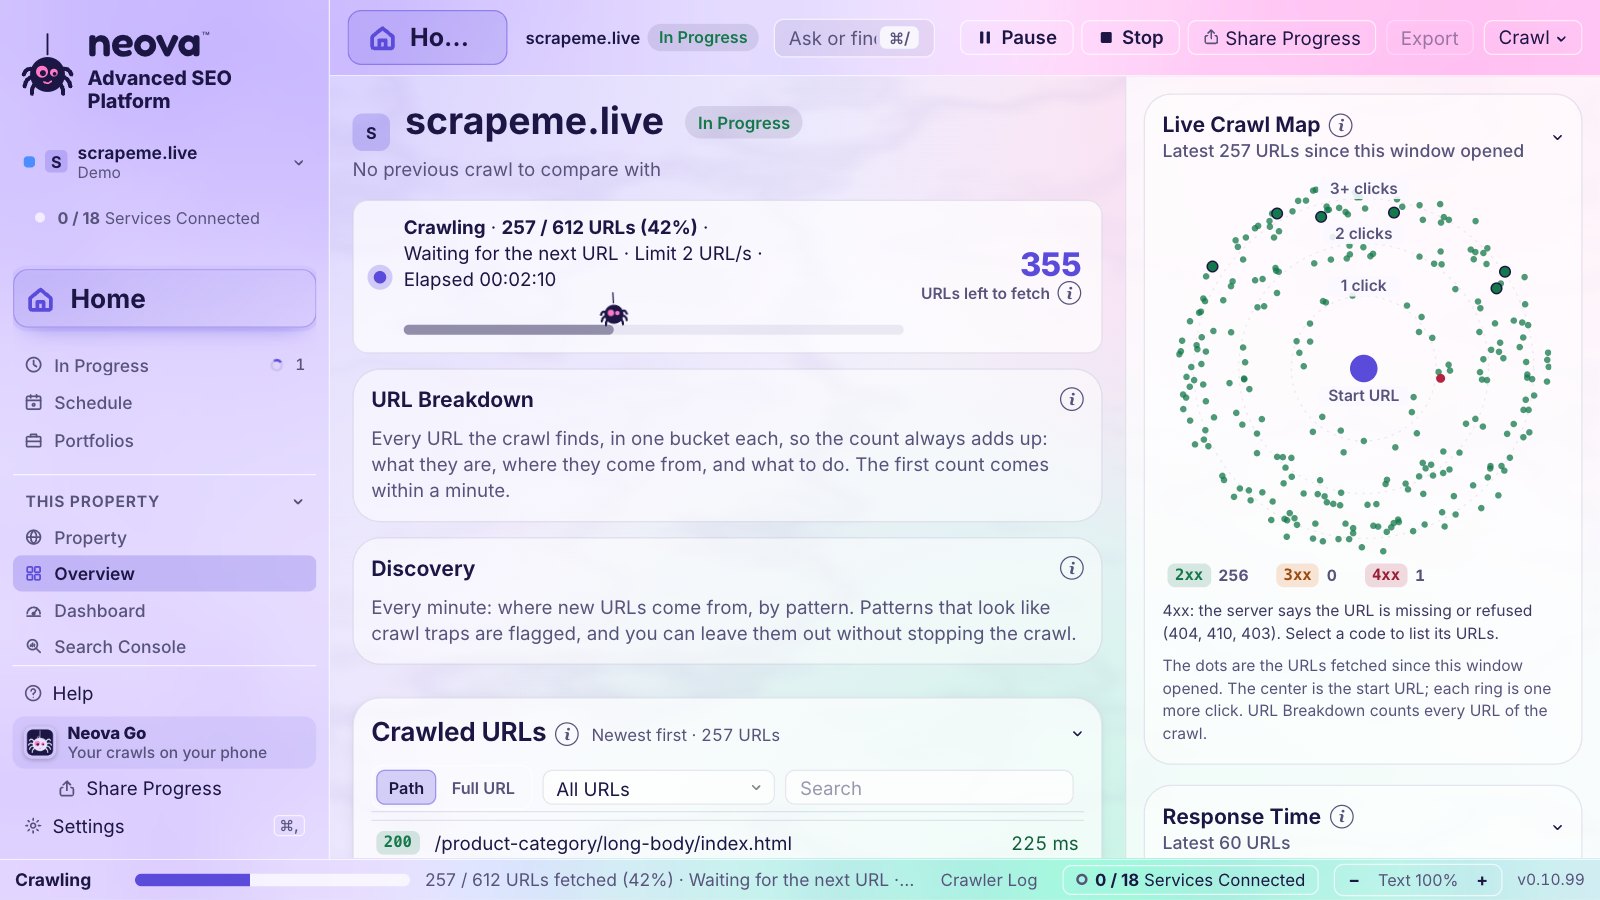
Toont de crawl terwijl hij loopt: genummerde stappen, wat hij nu doet, de URL's die nog over zijn en elk blok daaronder, elk inklapbaar.
Toont de stappen bij naam (Website wordt gecrawld, XML Sitemaps worden gecrawld, Resources worden gecrawld, Pagina's worden gerenderd, De 694 checks worden uitgevoerd) met wat elke stap heeft opgehaald.
Zegt in één regel wat de crawl op dit moment doet en welk adres het laatst is opgehaald.
Drie balken onder de voortgang: HTML-pagina's, Afbeeldingen, en CSS, scripts en andere bestanden, elk opgehaald van gevonden.
Toont de URL's die nog opgehaald moeten worden, daarna de URL's die nog gecontroleerd moeten worden, in grote letters met een balk.
Zegt elke minuut per patroon waar de nieuwe URL's vandaan komen, markeert vormen van crawl traps (kalenders, herhalende mappen, sessie-ID's, veel parameters, diepe en lange URL's) en biedt aan ze meteen uit te sluiten of over te slaan.
Biedt voor elke gevonden URL-groep Blijven crawlen, Overslaan of Exclude, elk met wat in de audit blijft en wat eruit gaat, de aanbevolen keuze gemarkeerd.
Zet elke URL die de crawl vindt in precies één bak (Schone pagina-URL's, Parametervarianten, Misvormde URL's, Crawl traps, Afbeeldingen, CSS, JavaScript en lettertypen, Documenten, Video en audio, Overige resources), zodat het aantal altijd verklaard is.
Haalt de afbeeldingen op van de eerste 1, 3, 5, 10, 25, 50 of 100 pagina's van elke paginagroep, met het aantal afbeeldingen en de tijd die elke grootte betekent, of slaat de rest over, of houdt elke afbeelding.
Slaat, zodra elke pagina is opgehaald, de overgebleven afbeeldingen en bestanden over, zodat de crawl als voltooid eindigt en de checks draaien.
Toont tijdens het crawlen de diepste pagina tot nu toe, amber vanaf 4 klikken, met een waarschuwingsregel vanaf 10 klikken.
Tekent de laatste 300 URL's op klikdiepte, gekleurd op statuscode, met URL's die alleen in de sitemap staan op een eigen ring.
Toont de mediane responstijd van de laatste URL's in een grafiek met lijnen op 800 ms en 1,800 ms.
Toont de URL's terwijl ze worden opgehaald, 10, 25, 50 of 100 per pagina, met filters voor 2xx, 3xx, 4xx, 5xx en Geen antwoord, gewijzigd en nieuw.
Vergelijkt elke URL bij het ophalen met de nieuwste eerdere crawl van de property die pagina's las, eerst een Crawl van de volledige site, anders een Steekproef of een crawl van Specifieke mappen, en toont de oude waarde doorgestreept naast de nieuwe.
Toont de checks die per categorie draaien, elk met hoeveel van zijn URL's gelezen zijn, en het aantal meldingen zodra dat geschreven is.
Toont Googles eigen pagina's die passen bij wat de crawl laat zien, en Google Search-nieuws van de laatste 45 dagen: rankingupdates, de Search Central-blog en updates van de documentatie.
Raadt leesstof aan die bij de crawl past: het Google Search Status Dashboard en de cases en algoritme-updates van SEO ProCheck.
Zet de crawl stil en gaat precies verder waar hij was.
Stoppen vraagt: Door naar de XML-sitemaps, Stoppen en de checks uitvoeren, Deze crawl stoppen en verwijderen, of Doorgaan met crawlen; Rendering overslaan tijdens het renderen.
Zet een gestopte of onderbroken crawl voort met zijn eigen instellingen hersteld, nooit vanaf nul.
Voert elke check opnieuw uit op wat een crawl heeft opgehaald, zonder iets opnieuw op te halen, ook op een crawl die tot het eind liep, zodat een check die in een nieuwe versie beter is geworden ook opgeslagen crawls bereikt; draait naast crawls van andere sites.
Crawlt de property opnieuw met de instellingen van haar laatste crawl, zonder haar gekoppelde data, concurrenten en plan aan te raken.
Als de site de crawl weigert, zegt het waarom (rate limit, geblokkeerd door een firewall of in dit land of deze regio, verboden) en wat je nu kunt doen.
Een adres dat geen URL kan zijn, zoals een zin in een href, wordt niet gevolgd en in plaats daarvan als melding gerapporteerd.
Leest elke opgehaalde stylesheet op lettertypen, achtergrondafbeeldingen en geïmporteerde stylesheets.
Toont de bestanden en afbeeldingen die de pagina's van andere hosts laden, zonder ze te crawlen.
Telt CMS-media-URL's zonder afbeeldingsextensie, zoals de /-/media/-handlers van Sitecore, als afbeeldingen.
Groepeert pagina's per template op basis van hun HTML (de eigen templatewoorden van het thema, anders het paginaskelet), en op adrespatroon bij heel grote sites.
Volgt rel=next- en rel=prev-links in de head, net als gewone links.
Zet crawls in de wachtrij en start elke crawl zodra er een crawlplek vrij is, nooit twee crawls van één site tegelijk, met Wachtrij starten, Wachtrij leegmaken en Als de checks klaar zijn.
Houdt de crawl op schijf in plaats van in het geheugen (60 MB geheugen bij 60,000 URL's), zodat de omvang beperkt wordt door de schijf, niet door het geheugen.
Crawls van tot 4 sites lopen tegelijk, elk in een eigen tempo en met een eigen URL-limiet, met een geheugenbewaking die een crawl tegenhoudt als de computer krap komt te zitten; elke opgeslagen crawl of property gaat open terwijl ze lopen.
Nieuwe crawl vult het formulier met de opgeslagen instellingen van de property (snelheid, bereik, URL-limiet, rendering, user agent, XML-sitemaps en de rest), ook als je het adres van de site bij Start-URL typt; je eigen laatste antwoorden in dit venster gaan nog steeds voor, en niets wat je al hebt aangepast wordt overschreven.
Als deze computer zijn internetverbinding verliest, zegt de crawl dat, wacht hij en gaat hij vanzelf verder zodra die terug is, in plaats van te stoppen alsof de site plat ligt; na 30 minuten offline stopt hij en zegt hij waarom.
Toont elke HTML-pagina met haar title, meta description en H1 en hun lengte, en de contentchecks met hun meldingen.
Kolomsets van Alle URL's voor titles, meta descriptions en H1's, elk met filters voor ontbrekend, leeg, dubbel, te lang en te kort.
Markeert dubbele titles, descriptions, H1's en H2's, en duplicate of bijna-duplicate tekst over HTML-pagina's heen.
Markeert hoofdtekst in de banden Moeilijk en Zeer moeilijk van de Flesch-score, en dunne pagina's onder de 200 woorden.
Markeert mogelijke spel- en grammaticafouten in de hoofdtekst.
Markeert titles en H1's die een voorbij jaar noemen, en tekst over een aanbieding, deadline of evenementdatum die al voorbij is.
Controleert de tags die bepalen welke titel, beschrijving en afbeelding een pagina toont als ze gedeeld wordt.
Toont hoe de title en description van een pagina eruitzien in de zoekresultaten.
Een model op je computer leest de HTML-pagina's voor 20 contentchecks die oordeelsvermogen vragen, zoals ontbrekende voorbeelden, ononderbouwde claims of geen auteursvermelding; die meldingen staan los van Moet opgelost en Bekijken.
Toont welke titles, meta descriptions en H1's sinds de vorige crawl zijn gewijzigd, voor en na.
Lengtebalken voor title, meta description en H1, paginagroepen en de HTML-pagina's met de meeste links.
Exporteert de hoofdcontent van elke HTML-pagina als één Markdown-bestand per pagina, met een index.
Markeert ontbrekende, lege, lange en dubbele H1's en H2's, een eerste H1 die niet de hoofdtitel is, en lange pagina's zonder H2.
Markeert een ontbrekende charset, doctype of body-tag, een kapot favicon, verouderde elementen en frames die de content bevatten.
Markeert Lorem Ipsum, templatecode, lege scriptwaarden en serverfouten of debugoutput die als paginatekst te zien zijn.
Markeert een lage tekst-HTML-verhouding, hoofdtekst onder de 200 woorden en boven de 5,000 woorden.
Markeert gesyndiceerde tekst zonder noindex of canonical naar het origineel.
Markeert een ontbrekende Over ons-pagina of een die niet door de hele site gelinkt is.
Leest de entiteiten van belangrijke HTML-pagina's met je Google Natural Language-sleutel, voor de contentchecks.
De statuscode van elke URL, overal in dezelfde kleur: 2xx groen, 3xx oranje, 4xx en 5xx rood, met Geen antwoord apart benoemd.
Waar redirects heen gaan, hoeveel hops ze nemen, loops, tijdelijke redirects, meta refresh en JavaScript-redirects, en de links die ernaar wijzen.
Markeert interne URL's met 2 of meer redirecthops, redirectloops, redirects naar zichzelf en ontbrekende of misvormde Location-headers.
Markeert interne 302-, 303- en 307-redirects, en laat doelen voor inloggen en aanmelden met rust.
Markeert interne redirects die eindigen op een 4xx of 5xx, een noindex-URL, een gecanonicaliseerde of een geblokkeerde URL, of op een andere website.
Markeert URL's die alleen redirecten om een slash toe te voegen of hoofdletters te wijzigen, en pagina's die alleen zo verschillen zonder canonical ertussen.
Markeert redirectende afbeeldingen, scripts en stylesheets, en externe links die redirecten of op een fout eindigen.
Kolomsets voor canonicals en voor meta robots-directives, met filters voor Noindex en Nofollow.
Toont de responseheaders van elke URL.
Toont de HTML die een URL stuurde, en de gerenderde HTML als de crawl hem renderde.
Zegt per HTML-pagina of ze Server-gerenderd, Gehydrateerd of Vereist JavaScript is.
Markeert titles, canonicals, links en hoofdtekst die pas verschijnen of veranderen nadat JavaScript draait.
Twintig checks op AMP-URL's en hun canonicals, inclusief de AMP-validator.
Markeert lange URL's, underscores, dubbele slashes, herhaalde segmenten, losse leestekens en te veel parameters.
Toont de HTML-pagina's per map en per crawldiepte.
Tekent de crawl als boom vanaf de start-URL, elke stip gekleurd op statuscode, met een legenda die erop filtert.
Je eigen URL-groepen op regex, per site, elk met de statuscodes geteld, en een kolom Segment in Alle URL's.
Doorzoekt de HTML van elke pagina op tekst of een regex, of haalt waarden op via XPath, CSS-selector of regex, en slaat een extractie op als kolom die bij elke crawl opnieuw draait.
Toont het contenttype, de grootte en de responstijd van elke URL, met responstijden gekleurd vanaf 800 ms en 1,800 ms.
Haalt alleen de URL's opnieuw op die een check markeert, voert elke check opnieuw uit en zegt hoeveel er zijn opgelost.
Zet een check uit of wijzigt zijn niveau naar Moet opgelost of Bekijken voor één property, bewaard voor elke latere crawl.
Laat hele checkcategorieën weg uit een crawl.
Eén scherm voor rendering: hoeveel HTML-pagina's in de HTML staan, deels in de HTML of JavaScript nodig hebben, wat alleen JavaScript laat zien, wat elke AI-crawler krijgt, per paginagroep, en de pagina's die niet helemaal in de HTML staan.
De tabs Technische SEO en AI-zoekmachines van het dashboard tonen het aandeel pagina's in de HTML, de pagina's die JavaScript nodig hebben, die waarvan de hoofdcontent alleen met JavaScript verschijnt, en de AI-crawlers die de volledige pagina krijgen.
Of elke HTML-pagina geïndexeerd kan worden: statuscode, noindex, canonical, robots.txt, en HTML die de head breekt vóór de SEO-tags.
Markeert elke URL als Indexeerbaar of niet, en waarom: status 200, geen noindex, canonical naar zichzelf of geen.
Legt elke regel van het live bestand of een concept in gewone woorden uit, zoals Google het documenteert en RFC 9309 het definieert, met de gecrawlde URL's waarop elke regel van toepassing is.
Toont wat Googlebot, Bingbot en de AI-crawlers onder robots.txt mogen ophalen, met de URL's waarvoor elk geblokkeerd is.
Toetst een concept aan elke URL van de crawl voordat het live gaat, met de URL's die nieuw geblokkeerd en nieuw toegestaan worden.
Zegt het als de eigen groep van een crawler in robots.txt de regels van de *-groep laat vervallen.
Wat de XML-sitemaps bevatten tegenover wat de crawl vond: ontbrekende indexeerbare pagina's, en vermelde URL's die redirecten, noindex hebben, een fout geven of wees zijn.
Haalt de pagina's op die alleen in de XML-sitemaps staan, als stap 2, en telt ze apart.
Geeft robots.txt en de sitemaps op trage sites eigen tijd en zegt het als er een niet antwoordde.
Schrijft een XML-sitemap van de indexeerbare pagina's, op elke diepte of tot diepte 3 of 5.
Markeert gepagineerde archiefpagina's die 200 geven zonder items, kapotte rel=next-ketens en paginatie met een canonical naar pagina 1.
Bewaart elke robots.txt-versie en XML-sitemap die de crawls lazen, en markeert wijzigingen in robots.txt-regels sinds de vorige crawl.
Markeert HTML die de head beëindigt vóór de SEO-tags (een noscript met tekst, een ongeldig element, weggelaten of herhaalde head-tags), waardoor titles en canonicals in de body worden gelezen.
Markeert canonicals die een loop of keten vormen, wijzen naar redirects, noindex, 4xx, 5xx, HTTP- of externe URL's, of alleen door JavaScript gezet worden.
Markeert noindex, nofollow en canonicals die verschillen tussen de HTML en de HTTP-header, dubbel zijn opgegeven of verkeerd gespeld zijn.
Markeert pagina's die afbeeldingen, scripts of stylesheets gebruiken die robots.txt blokkeert.
Markeert varianten in hoofdletters, slash aan het eind en volgorde van parameters die dezelfde HTML teruggeven.
Markeert HTML-pagina's die 200 antwoorden met een zin als niet gevonden of geen resultaten gevonden in hun title of H1.
Markeert HTML boven 2 MB met links of content voorbij de grens die Google leest, en JavaScript- of CSS-bestanden boven 2 MB.
Markeert een scherpe verandering in crawlbare URL's en robots.txt-regels die sinds de vorige crawl zijn gewijzigd.
Markeert XML-sitemaps boven 50 MB of 50,000 vermeldingen, lege sitemaps, relatieve sitemapregels in robots.txt, en URL's op een andere host of een ander protocol.
Controleert of de site je IndexNow-sleutelbestand host, met Sleutel maken om er een aan te maken.
Leest het URL-inspectie-oordeel van Google voor tot 200 URL's per crawl en markeert indexeerbare pagina's die Google niet indexeert of waarvoor Google een andere canonical koos.
Stuurt na een Crawl van de volledige site die vanzelf eindigt de pagina's die sinds de vorige volledige crawl zijn gewijzigd of nieuw zijn naar IndexNow (Bing, Yandex, Seznam, Naver en Yep), alleen als de site je sleutel host; het venster zegt wat er is verstuurd of geweigerd.
Toont de pagina's die als expliciet gelabeld zijn (de meta rating adult, het RTA-label of een Rating-header) en de pagina's die de crawler een leeftijdspoort tonen, zodat jij ze kunt bekijken.
Kapotte links, links naar redirects, anchors, en pagina's waar weinig links naartoe gaan.
Toont elke link naar en van een URL met de anchortekst.
Legt vast of elke link in de content, het menu, de footer of de filters staat, met de kolommen Inlinks uit de content en Inlinks uit menu en footer.
Geeft elke URL een score van 0 tot 100 voor het interne linkgewicht dat ze krijgt, een interne PageRank over de gevolgde links van de crawl.
Het aantal klikken vanaf de start-URL voor elke URL, met een melding vanaf diepte 4.
Markeert indexeerbare pagina's waar geen interne link naartoe gaat, gevonden via de XML-sitemaps, de serverlog of Google Search Console.
Elke URL op andere sites waar de site naar linkt, elk één keer opgevraagd, met 4xx, 5xx en geen antwoord gerapporteerd.
Zet het opvragen van elke externe URL aan of uit voor een crawl; staat standaard aan.
Stelt interne links voor op basis van de tekst van de HTML-pagina's: pagina's die het onderwerp van een andere pagina noemen zonder ernaar te linken.
Toont URL Rating, Trust Flow, Page Authority of Authority Score, verwijzende domeinen en backlinks per URL met je eigen sleutel van Ahrefs, Majestic, Moz of Semrush.
Markeert interne links zonder anchortekst of met een niet-beschrijvende anchortekst, en gelinkte afbeeldingen zonder alt.
Markeert pagina's die alleen via nofollow-links bereikbaar zijn, interne outlinks met nofollow en affiliatelinks zonder sponsored of nofollow.
Markeert lege, misvormde en witruimte-hrefs, links die alleen onclick gebruiken, trackingparameters, lokale bestandspaden, localhost en fragmenten zonder bijbehorende ID.
Markeert URL's die alleen via een canonical, een redirect of noindex-pagina's bereikbaar zijn, en pagina's met inlinks vanaf maar één URL.
Telt adressen die links verkeerd schreven (een spatie aan het eind, een dubbele slash, een teken dat twee keer gecodeerd is) als een eigen bak.
Markeert HTML-pagina's die linken naar een staging-, ontwikkel- of lokale host.
Toont elke afbeelding die de crawl ophaalde of die een pagina gebruikt, met de grootte, alt-tekst en het aantal HTML-pagina's dat haar gebruikt.
Markeert ontbrekende, te lange, nep- en herhaalde alt-tekst, en onderscheidt een ontbrekende alt van een decoratieve.
Markeert afbeeldingen boven 100 KB, GIF's boven 100 KB en afbeeldingen zonder width en height.
Markeert met rendering aan afbeeldingen die in de verkeerde beeldverhouding of met een te lage resolutie voor hun formaat worden getoond.
Markeert afbeeldingen die niet gecomprimeerd zijn, niet in een modern formaat staan of groter zijn dan getoond, en een lazy-loaded LCP-afbeelding.
Markeert video's zonder ondertitelingstrack.
Laat je een grote beeldbibliotheek per paginagroep steekproefsgewijs ophalen in plaats van helemaal, met de aantallen en de tijd van elke keuze.
Laat de afbeeldingen in de wachtrij liggen, terwijl elke pagina nog steeds wordt gecrawld en de alt-tekst nog steeds uit de HTML wordt gelezen.
Markeert op sites die afbeeldingen in licentie geven ImageObject-markup zonder licentiegegevens, en leest een steekproef van geleverde afbeeldingen op hun IPTC- en XMP-rechten, die Google nodig heeft voor de badge Licensable.
Taal- en regioversies van elke pagina en of ze naar elkaar verwijzen: retourlinks, zelfverwijzing, x-default, ongeldige codes, gecanonicaliseerde en noindex-doelen.
Hreflang-talen en Hreflang-doelen voor elke HTML-pagina, met de volledige lijst bij hoveren.
Markeert een ontbrekende, lege of ongeldige html lang, en lang-waarden die niet kloppen met hreflang of met de eigen tekst van de pagina.
Markeert ontbrekende retourlinks, ontbrekende zelfverwijzingen en retourlinks die naar gecanonicaliseerde URL's wijzen.
Markeert een ontbrekende x-default in de set van de homepage en een kapot, noindex- of gecanonicaliseerd x-default-doel.
Markeert hreflang-doelen die geen 200 geven, noindex of gecanonicaliseerd zijn, geblokkeerd zijn of geen inlinks hebben.
Valideert elke hreflang-taal- en landcode en markeert regionale codes zonder fallback op alleen taal.
Markeert taalequivalenten zonder hreflang en een doelmarkt zonder hreflang op welke pagina dan ook.
Leest hreflang uit de HTML-head en de HTTP Link-header, en markeert een set die via meer dan één methode is opgegeven.
Markeert een antwoord dat per Accept-Language verschilt op een manier die Googlebot niet ziet.
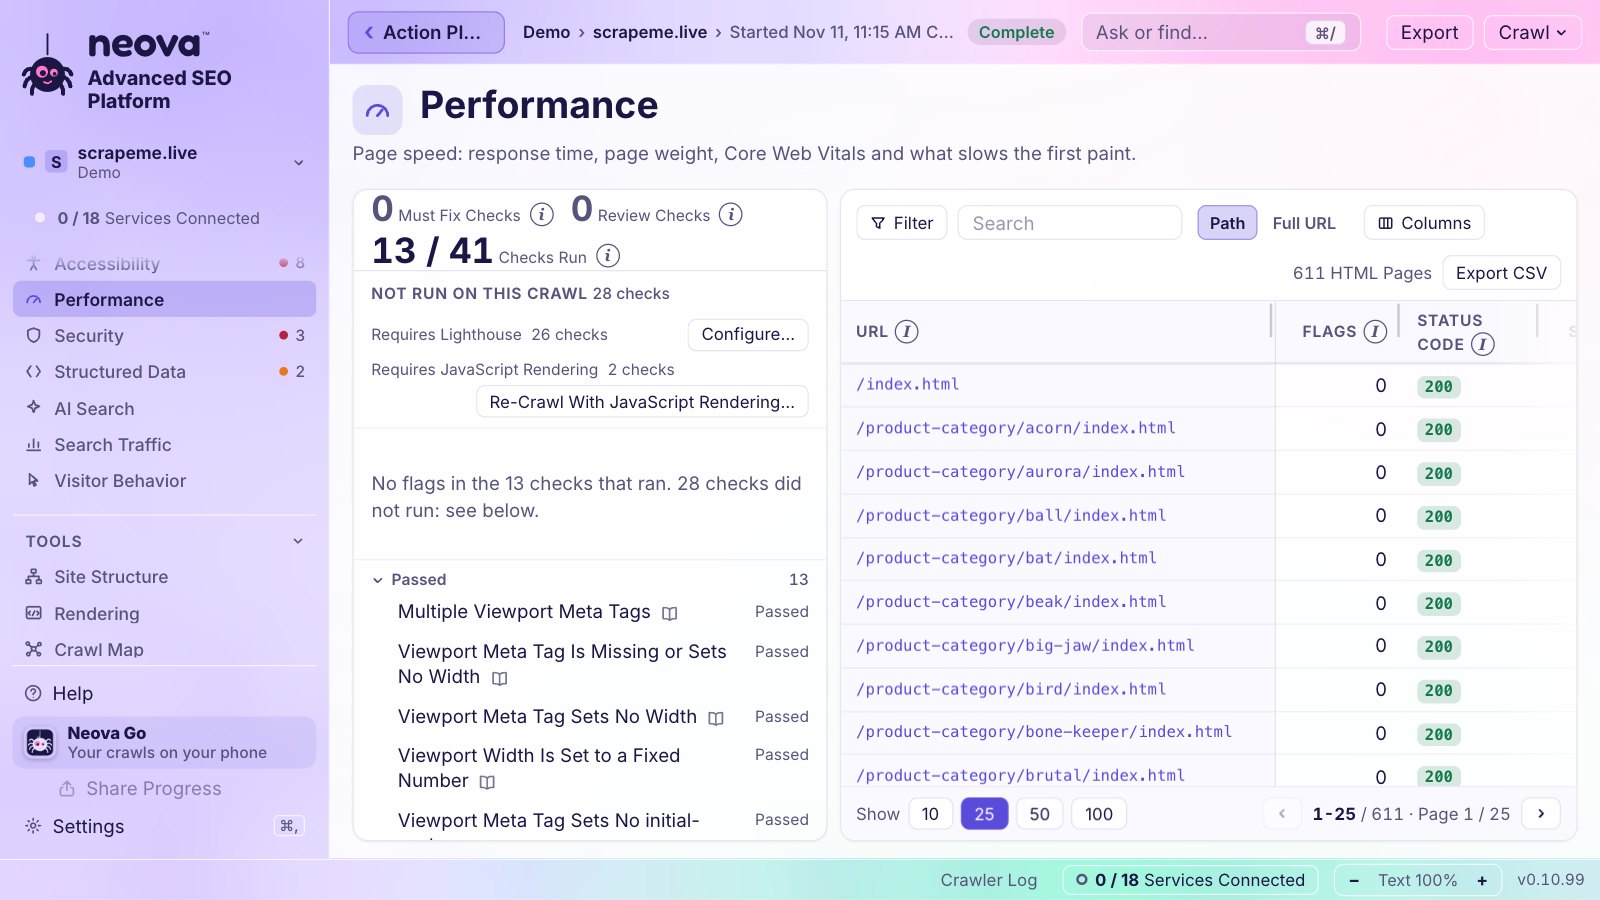
Paginasnelheid: responstijd, paginagewicht, Core Web Vitals en wat de eerste weergave vertraagt.
Draait tijdens de crawl Lighthouse-labchecks op één HTML-pagina per paginagroep.
LCP, INP en CLS van echte Chrome-gebruikers op telefoons, het 75e percentiel, met je Chrome UX Report-sleutel.
Tekent op de eerste dag zo'n 40 weken velddata uit de Chrome UX Report History, één punt per week, met de grenzen van Google voor goed en slecht.
LCP, INP en CLS van de HTML-pagina's met de meeste links in elke paginagroep, zodat een trage template opvalt.
Leest het Chrome UX Report voor de origin, de URL's met de meeste links van elke paginagroep en de 10 URL's met de meeste links, zonder crawl.
Maakt de momentopname vanzelf, standaard dagelijks, of wekelijks of maandelijks, ook met het venster dicht.
Geeft een alert als een metric een slechter oordeel krijgt of terugkomt op Goed, volgens de grenzen van Google.
Toont de laatste metingen naast elkaar, gekleurd Goed, Verbetering nodig of Slecht, met hun datum.
Stelt 0 tot 3 HTML-pagina's per paginagroep in voor elke momentopname en zegt hoeveel Chrome UX Report-verzoeken dat kost.
Het niveau Site-audit leest na de crawl de Core Web Vitals uit het Chrome UX Report.
Bewaart elke momentopname op je computer, langer dan de 28 dagen die het Chrome UX Report toont.
Markeert uitgeschakelde tekstcompressie, niet-geminificeerde CSS en JavaScript, korte cachetijden en pagina's zonder ETag of Last-Modified.
Markeert render-blocking verzoeken, lang werk op de main thread, ongebruikte CSS en JavaScript, verouderde JavaScript, HTTP/1.1-resources, trage derde partijen en een Lighthouse-score onder 50.
Markeert een trage serverrespons, CLS boven 0.1 en Core Web Vitals buiten het goede bereik, in lab- of velddata.
Markeert pagina's waarvan de JavaScript-rendering langer dan 4 seconden duurt.
Markeert ontbrekende of vaste viewports, zoomblokkades en tekst onder 12 CSS-px op telefoons.
Mediane responstijd, die van 9 op de 10 en de traagste terwijl de crawl loopt, met de 10 traagste pagina's.
Wat mensen met hulptechnologie verhindert elke pagina te gebruiken: namen, labels, ARIA, landmarks, koppen, tabellen en formulieren.
Voert met rendering aan axe-core-regels en bezoekerstests uit: contrast, toetsenbordfocus, focusvallen, zoom tot 200%, reflow op 320 px en aanraakdoelen van 24 px.
Markeert knoppen, links, formuliervelden, afbeeldingen, dialogen en frames zonder toegankelijke naam, en velden die alleen via een title een naam krijgen.
Markeert ongeldige rollen en attributen, ontbrekende verplichte attributen, verkeerde ouder- of kindrollen en verouderde rollen.
Markeert pagina's zonder main-landmark, dubbele of geneste landmarks, overgeslagen kopniveaus en geen manier om herhaalde blokken over te slaan.
Markeert tabellen zonder kopcellen, ongeldige scope en headers, en lijsten of definitielijsten die verkeerd zijn opgebouwd.
Markeert een ontbrekende focusindicator, focusvallen, positieve tabindex, dialogen die de focus niet vasthouden en scrollbare gebieden zonder toetsenbordtoegang.
Markeert tekst met onvoldoende contrast, tekst onder het verhoogde contrast en links die alleen door kleur te onderscheiden zijn.
Markeert uitgeschakelde zoom, tekst die bij 200% zoom wegvalt, content die op 320 px breed wordt afgekapt, vergrendelde oriëntatie en aanraakdoelen onder 24 px.
Markeert video zonder ondertiteling of audiodescriptie, stille video zonder alternatief en audio zonder transcript.
Markeert velden zonder label of met meerdere labels, ongeldige autocomplete-waarden, velden die plakken blokkeren en foutmeldingen zonder tekst.
Een lokaal model leest pagina's voor 7 checks die oordeelsvermogen vragen, zoals grafieken zonder tekstalternatief.
Wat AI-crawlers mogen ophalen, wat ze voorgeschoteld krijgen en hoe AI-antwoorden de site citeren.
Vraagt voorbeeldpagina's op als 10 AI-agents (ChatGPT, Claude, Perplexity, hun crawlers, Meta AI, Google-Extended, Common Crawl) en toont wie volledige toegang krijgt en wat robots.txt toestaat.
Beoordeelt een gepubliceerde llms.txt, een Markdown-versie via de Accept-header, discovery-manifesten voor agents en WebMCP-tools; een site zonder deze bestanden wordt niet gemarkeerd.
Markeert belangrijke pagina's die AI-zoekcrawlers blokkeren of snippets beperken, en AI-regels die afwijken van je geschreven beleid.
Markeert een Markdown-versie die leeg is of minder dan de helft van de hoofdtekst bevat.
Markeert hoofdcontent die pas na de eerste 5,000 tekens van de bodytekst begint.
Markeert onzichtbare overlays over knoppen en velden, taakknoppen die slecht te zien zijn, en ongedateerde beslissingen over agent-checkout voor Google UCP of OpenAI ACP.
Markeert belangrijke pagina's die Applebot blokkeren, en geblokkeerde AI-fetchers die door gebruikers worden gestart.
Markeert dalende citaties in Bing AI en belangrijke URL's die Bing AI nooit citeert, uit Bing Webmaster Tools.
Rapporteert sessies die via AI binnenkomen en hun engagement tegenover organisch, uit Google Analytics 4.
Stelt tot 20 van je prompts aan ChatGPT en Perplexity via je DataForSEO-account en rapporteert merkvermeldingen, geciteerde URL's en sites van derden die in plaats van jou geciteerd worden.
Zegt voor elke gevolgde zoekopdracht of Google een AI Overview toont en of die jou citeert, audit na audit.
Crawlt met GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot en andere AI-user agents.
Toont geverifieerde bezoeken en weigeringen van AI-crawlers per URL uit de serverlog.
Draait je eigen prompts op elke HTML-pagina (concepten voor meta descriptions, FAQ-ideeën, zoekintentie, hoofdentiteiten) met Ollama op je computer of met je sleutel van Anthropic, OpenAI of Google Gemini, met de antwoorden als kolommen.
Draait 44 checks die oordeelsvermogen vragen over alle categorieën heen, met een lokaal model via Ollama; er verlaat niets de computer en de meldingen tellen niet mee in de aantallen.
Welke AI-assistenten bediend worden, AI Overviews, wat elke AI-assistent krijgt en verzoeken van geverifieerde bots.
Laadt voor elke gevolgde zoekopdracht de AI Overview van Google 3 keer via DataForSEO en rapporteert hoeveel van de bronnen op pagina één ranken, of jouw pagina daar rankt en of de Overview haar citeert, als melding Bekijken.
Schema-markup op elke pagina: geldig, met waarschuwingen of met fouten, en de kolom Schematypes.
Geeft een oordeel voor elk schematype op een URL.
Markeert pagina's die een type gestructureerde data of rich result missen dat hun paginagroep wel heeft.
Markeert productprijzen die niet op de pagina staan, verlopen aanbiedingen, datums die niet overeenkomen en ontbrekende verplichte eigenschappen.
Markeert gestructureerde data met syntaxfouten, ontbrekende verplichte of aanbevolen eigenschappen, of tekst die afwijkt van de pagina.
Markeert Organization- of Person-markup zonder identificerende eigenschappen.
Controleert Speakable-selectors, pagina's achter een betaalmuur zonder isAccessibleForFree false, en HowTo-, QAPage- en FAQ-markup tegenover de pagina.
Markeert ongeldige rich results en AMP- of rich result-fouten die Google meldt.
Vergelijkt Organization-markup met het Google Bedrijfsprofiel, via DataForSEO.
HTTPS, mixed content en de beveiligingsheaders die elke pagina stuurt.
Toont de beveiligingsheaders die elke URL stuurt.
Markeert HTTP-pagina's, redirects van HTTPS naar HTTP, certificaten die ongeldig zijn of bijna verlopen, en TLS 1.0 of 1.1.
Markeert externe scripts en stijlen zonder integrity-hash, en formulieren of wachtwoordvelden via HTTP.
Markeert een ontbrekende Content-Security-Policy, Strict-Transport-Security, nosniff, bescherming tegen clickjacking of Cross-Origin-Opener-Policy, en een onveilige Referrer-Policy.
Markeert HTTPS-pagina's die HTTP- of protocolrelatieve resources laden of naar HTTP-pagina's linken.
Markeert responseheaders die de server of het framework verraden, en een Content-Type dat niet bij het bestand past.
Markeert een certificaat dat de via SNI gestuurde hostnaam niet dekt.
Met rendering aan markeert het cookies van derden en toestemmingsvragen bij het laden.
Logt in via Googles eigen pagina in je browser, met alleen leesrechten, en koppelt klikken, vertoningen en CTR aan elke URL van elke crawl.
Koppelt bezoeken en engagement aan de pagina's van de crawl voor de analytics-checks, verbonden met dezelfde Google-login.
Bewaart één login per Google-account en gebruikt voor elke site het eigen account van de property.
Vraagt welke Google Search Console- en Google Analytics 4-property bij elke site hoort, met die van de site al voorgeselecteerd.
29 checks die Google-data aan de crawl koppelen, zoals noindex-, geredirecte of 4xx-URL's die nog klikken krijgen.
Markeert organische landingspagina's met 10 seconden engagement of minder, 80% bounce of meer, formulieren zonder key events, en organische sessies onder 70% van het recente gemiddelde.
Markeert zoekopdrachten waarbij meerdere URL's de vertoningen delen, of waarbij de homepage of een niet-indexeerbare URL het vaakst verschijnt.
Rapporteert vertoningen en klikken per zoekweergave.
Markeert GA- of GTM-ID's die twee keer geladen worden, en indexeerbare URL's zonder GA- of GTM-ID.
Rangschikt checks op de klikken van de URL's die ze markeren, zodat de meldingen die verkeer kosten bovenaan staan.
Bewaart elke maand Google Search Console-data op je computer nadat Google die na 16 maanden wist, met Nu archiveren en een maandelijkse planning.
Klikken en vertoningen per dag over de laatste 28 dagen tegenover de 28 daarvoor, in een grafiek.
De zoekopdrachten die klikken opleveren, met vertoningen en positie.
Volgt dagelijks tot 25 zoekopdrachten per property uit Google Search Console: positie over 7 en 90 dagen, verandering, klikken en vertoningen, met zoekopdrachten op positie 4 tot 20 als suggestie.
Inspecteert tot 200 URL's per crawl, eerst de meest aangeklikte, dan de meest gelinkte.
Klikken en vertoningen uit Google Discover, bewaard bij elke gearchiveerde maand.
Zet de rankingupdates en incidenten van Google uit de laatste twee jaar op je klikken per dag, met de klikken voor en na elke update.
Klikken, zoekopdrachten, crawlfouten en geïndexeerde URL's uit Bing, met je API-sleutel en een Test die je sites opsomt.
Rankings, AI-antwoorden, concurrenten en backlinks via je eigen DataForSEO-account, betaald per verzoek.
De echte mobiele positie van elke gevolgde zoekopdracht in de top 20, met de beste concurrent ernaast.
Zoekopdrachten waarop een concurrent in de top 20 staat en jij niet, met hun zoekvolume.
Leest een dienst die je na een crawl hebt verbonden en voert de checks ervan opnieuw uit op die crawl, zonder opnieuw te crawlen.
Toont hoeveel diensten verbonden zijn in de statusbalk, onder de property in de zijbalk en als dashboardblok; elk opent Verbindingen.
Toont de verzoeken die elke verbinding voor een property doet, afgezet tegen de quota van Google, allemaal op je eigen sleutel en account.
Elke crawl bevat de links naar de rapporten Beveiligingsproblemen en Handmatige acties van Search Console voor de property, omdat Googles API die niet kan lezen; zo open je ze allebei zelf.
Zet de property naast haar concurrenten op hun laatste bruikbare crawl, elke metric gekleurd naar wie voorloopt en wie achterblijft, met het verschil met de beste concurrent.
Somt de metrics op waarin een concurrent voorloopt, het grootste verschil eerst, met de checks achter elk getal.
Neemt een hele geplakte lijst zoals die is, directe concurrenten als primair (maximaal 5) en indirecte als secundair, en zet hun crawls in één stap in de wachtrij.
Leest eerst de XML-sitemaps van elke concurrent, crawlt standaard 750 URL's en biedt 1,000, 2,500 of 5,000 aan als de sitemaps er meer bevatten.
Vindt via DataForSEO de sites die op dezelfde zoekopdrachten ranken, verdeeld in primair en secundair.
Stelt nooit winkels, bezorgapps of marktplaatsen voor als concurrent; je kunt ze nog steeds zelf toevoegen.
Crawlt een concurrent op de plek waar de homepage nu staat als die naar een ander domein is verhuisd.
Stelt een subportfolio "<property> | Concurrenten" voor de concurrenten van een property voor en houdt het aan de property gekoppeld.
Telt alleen de checks die elke vergeleken crawl kon beoordelen, en zet niets af tegen een crawl die voortijdig stopte.
Zoekopdrachten met ranking, top 10, geschatte bezoeken en verwijzende domeinen voor de property en elke concurrent, audit na audit.
Verwijzende domeinen en backlinks van de property en haar concurrenten, uit DataForSEO Backlinks.
Toont elke concurrent onder zijn property met balken voor URL's en meldingen, en meldingen per URL vergeleken.
Een maandkalender van elke crawl en geplande run, voorbij en komend, met een filter op property.
Crawls van de volledige site die vanzelf draaien, Dagelijks, Wekelijks, Elke N weken of Maandelijks, met de instellingen van de property, terwijl het venster dicht is.
Google Search Console-archivering volgens een planning, standaard maandelijks.
Zegt wat een geplande crawl kost voordat je hem toevoegt: URL's per run en runs per maand.
Geeft 15 minuten voor de start van een geplande crawl een notificatie, en zegt dat hij draait met het venster dicht.
Verschuift één run met 1, 3, 6 of 9 uur of naar een datum en tijd, of slaat hem over, terwijl de planning haar ritme houdt.
Stopt een lopende geplande crawl veilig en geeft hem een nieuw tijdstip.
Herhaalt de Volledige audit elke maand vanuit de planner; Neova maakt de analyse en de PDF af zodra het weer opent.
Geeft een alert als Core Web Vitals van score veranderen, de klikken van de laatste 7 dagen 20% of meer dalen, een gevolgde zoekopdracht de top 10 verlaat of binnenkomt of 3 posities verliest, of een nieuwe crawl nieuwe meldingen heeft.
Bewaart de laatste 300 alerts, met Nu checken en Alerts wissen.
Houdt Neova actief als het venster sluit, in de menubalk, met de voortgang van de crawl naast de klok.
Houdt het Dock-icoon of laat alleen het menubalkicoon staan.
Start Neova bij het inloggen, met het venster dicht.
Een telefoonpagina die je via een QR-code aan je beginscherm toevoegt: de laatste crawl van elke property, Core Web Vitals, klikken uit Google Search Console, gevolgde zoekopdrachten, de volgende run en lopende crawls, versleuteld op de Mac voordat het die verlaat.
De Mac stuurt de samenvatting elke 2 minuten terwijl een crawl loopt en anders elke 15; de telefoon kijkt elke 2 minuten en zegt hoe oud die is.
Maakt een link voor één lopende crawl, zodat iedereen die kan volgen en weet wanneer hij klaar is, met een eigen sleutel en zonder iets anders prijs te geven.
Een kopie van het live scherm die iedereen kan openen: voortgang, Uitsplitsing van URL's, Nieuwste URL's, Live crawlkaart, Responstijd, Redirects en fouten, Checks en Links & Nieuws.
De gedeelde pagina kan haar lezer een notificatie sturen als de crawl klaar is.
Elke groep 3xx, 4xx, 5xx en Geen antwoord van de hele crawl, tot 100 URL's per groep, de meest gelinkte eerst.
Plaatst alerts en de afloop van elke crawl in een of meer Slack-kanalen via een incoming webhook, bevestigd met een testbericht.
Plaatst alerts en de afloop van elke crawl in Teams-kanalen via een Workflows-webhook.
Stuurt de berichten van elk portfolio of elke property naar de eigen kanalen.
Een systeemnotificatie als een crawl klaar is terwijl Neova niet op de voorgrond staat, met een geluid naar keuze.
Toont alles wat Neova nu doet, de crawl, een audit, Checks uitvoeren, een geplande crawl en de wachtrij, elk met de knop die het opent.
Elk getal met een vorige waarde toont de verandering sinds de vorige vergelijkbare crawl.
Haalt alleen een lijst pagina's op, zonder ontdekking, en geeft paginaalerts bij wijzigingen in status, redirectdoel, title, canonical, noindex, H1 en grootte.
De stand van de crawl in één oogopslag: Crawlsamenvatting, Topchecks, Volgende acties, Statuscodes en Wijzigingen t.o.v. vorige crawl, elk getal opent zijn lijst.
Elke check met meldingen: ernst, gemarkeerde URL's van het aantal gecheckte, hoeveel er indexeerbaar zijn, verandering sinds de vorige crawl, categorie en klikken.
Elke check toont Gemarkeerd als, Wat dit meestal betekent en Wat je zou kunnen doen, met zijn ID, zijn bron en Over deze check, dat zijn pagina in de checkbibliotheek opent.
Elke URL, met kolomsets, filters op elke kolom, bewaarde weergaven, een kolomkiezer, een vastgezette URL-kolom en 10, 25, 50 of 100 rijen per pagina.
Elke tabel en elk raster exporteert wat het toont als CSV.
Elke kolom, elk getal en elke kaart heeft een ⓘ die zegt wat er geteld wordt.
Acht groepen en 13 tabs uit 39 blokken: samenvatting, prestaties, techniek, Core Web Vitals, content, zoekwoorden, AI-zoekmachines, social, concurrenten, algoritme-updates, workflow, programma en rapporten.
Tot 10 eigen dashboards, nieuw begonnen of gedupliceerd van een tab, met blokken die je toevoegt, verplaatst, van grootte verandert en verwijdert.
Het Actieplan als programma per status en eigenaar, bij elk item de check met de meldingen op de laatste crawl, rood als een item dat op Klaar staat nog steeds gemarkeerd is.
Eén ticket per check en paginagroep, Moet opgelost eerst, met de regel, het bewijs, de getroffen URL's, wanneer het klaar is, hoe je het checkt en waar je het oplost (de template als 90% van een groep gemarkeerd is).
Een latere crawl sluit, behoudt of heropent elk ticket op basis van zijn sleutel, en verwijdert er nooit een.
Begint elk ticket met de code van de property, zoals [DRH], en geeft die als label mee naar Jira en Linear.
Maakt per Neova-ticket één Jira-ticket in je Jira Cloud-project, met prioriteit, labels en de URL-lijst als bijlage, nooit dubbel.
Zet na elke volledige crawl vanuit het venster een verdwenen ticket op Done, heropent een ticket dat terugkwam en werkt de rest bij.
Bestanden in het formaat van de eigen CSV-import van elke tool: Jira, Linear, Asana, ClickUp, monday.com, Azure DevOps Boards, Notion, Airtable, Smartsheet, en het Markdown-takenbestand van Basecamp, elk met zijn importpagina.
Een klantrapport met je naam, logo en kleur: de crawl in cijfers, meldingen per categorie, wat je eerst oplost met voorbeeld-URL's, rendering en zichtbaarheid in AI, wijzigingen sinds de vorige crawl en hoe de crawl gemaakt is, in Letter of A4; checks van één familie tellen één keer, de tweede staat erbij als Ook gemarkeerd.
Geeft elke klant een eigen naam, logo en kleur op het rapport, met Opgesteld voor, Opgesteld door en notities.
Eén werkmap: Samenvatting, Tickets in volgorde van oplossen, Per paginagroep, een blad per check met de 1,000 meest aangeklikte en daarna meest gelinkte URL's, en Alle meldingen.
Elke HTML-pagina die 200 gaf, tot 200,000, met title, description, H1, canonical, indexeerbaar, diepte, inlinks, sitemap, grootte, responstijd, klikken en meldingen.
Stuurt de werkmap naar je Google Drive, omgezet naar Google Sheets.
Eén ZIP met wat je kiest: de PDF, de werkmap uitgebreid of beknopt, de tickets met hun URL-lijsten, de bestanden voor Jira en Linear, en elke gemarkeerde URL als één CSV per check, met een README.
De URL's, meldingen en tickets als CSV-bestanden, voor CSV, Excel (UTF-8 met BOM), Google Sheets en Looker Studio.
Elke export bevat een notitie als de crawl zonder rendering draaide of maar een deel van de site besloeg.
Bewaart exports standaard in Downloads, in een map Neova exports.
Bewaart exports in een map die je op de computer kiest.
Uploadt via de eigen interface van Google Drive naar de Google-accounts die in Neova zijn ingelogd, in hun map Neova exports, en vervangt een bestand met dezelfde naam zodat de gedeelde link blijft werken; Neova ziet alleen zijn eigen bestanden.
Bewaart in de mappen die de apps van Google Drive, OneDrive, Dropbox, iCloud Drive, Proton Drive en kDrive op een Mac synchroniseren (OneDrive, Dropbox en Google Drive op Windows), elk account uit tot je het aanzet.
Uploadt exports naar je eigen server via SFTP met een wachtwoord of sleutelbestand, FTPS of gewone FTP, getest voordat het bewaard wordt, met de sleutel van de server onthouden.
Bewaart de exports van elk portfolio of elke property in een eigen map of drive.
In Neova Online schrijft het een export direct in een map op je computer in Chrome, Edge, Vivaldi, Brave en Arc; andere browsers downloaden hem.
In Neova Online wordt een mapexport, zoals de CSV-tabellen of de Markdown-pagina's, gedownload als één ZIP.
Eén alleen-lezen link van een portfolio of property met de crawls, het Actieplan, de analyses, concurrenten en bestanden die je aanvinkt, versleuteld op je computer met een sleutel die alleen in de link meereist; Werk bij houdt het adres en Uitschakelen verwijdert het.
Wat je in welke volgorde doet: opgesteld uit de crawl (eerst Moet opgelost, dan klikken, dan bereik), door jou herschikt en verwoord, met eigen items erbij, met status, eigenaar en notitie, bewaard over crawls heen.
Kopieert het plan als Markdown of exporteert het als CSV.
Schrijft de volledige audit op je computer: huidige stand, geprioriteerde meldingen, zichtbaarheid in zoekmachines, gevolgde zoekopdrachten, keyword gaps en geprioriteerde acties ingevuld, met de secties die alleen een mens kan schrijven gemarkeerd als Nog te schrijven.
Bewaart rapporten die je toevoegt (Markdown, tekst, PDF of Word) bij de property, met Markeren als beoordeeld.
Opent een e-mail aan Neova Labs met de cijfers van de crawl er al in, voor de secties die geen check schrijft.
Eén run van elke stap: de crawl met elke check aan, Google, Bing en Analytics, Core Web Vitals, concurrenten en hun crawls, zoekdata van DataForSEO, het Actieplan, de analyse en de PDF in huisstijl.
Volledige audit uitvoeren vraagt of het de laatste crawl moet lezen of opnieuw moet crawlen, met het aantal URL's en de duur.
Crawl A tegenover crawl B: URL's nieuw, verwijderd en gewijzigd, meldingen nieuw en opgelost, crawl B gekleurd als beter of slechter.
Alles wat voor een property bewaard blijft na de eigen bewaartermijn van de bronnen: elke crawl, elke maand Google Search Console, elke Core Web Vitals-momentopname, robots.txt-versies, XML-sitemaps en URL-wijzigingen.
Elk voorstel, ticket en rapport vermeldt dat je het moet beoordelen voordat je het toepast, omdat Neova de pagina's ziet, niet het bedrijf erachter.
Een geplande crawl plaatst de afloop in Slack en Teams, en de maandelijkse Volledige audit maakt de PDF zodra Neova weer opent; er wordt nog geen exportbestand volgens planning geschreven.
Het PDF-rapport en de werkmap vertellen hoe de pagina's gerenderd worden (overall, per paginagroep en pagina voor pagina), wat robots.txt elke AI-crawler laat ophalen en wat de server hem geeft, en welke checks voor AI-zoekmachines geslaagd zijn of meldingen gaven.
Een Google Sheet, gebouwd voor Sheets vanuit de crawl: Overzicht met grafieken, een Actieplan met keuzelijsten voor Eigenaar, Status en Deadline, Problemen, URL's, Meldingen, Paginagroepen, Redirects & fouten, Rendering & AI en Over, elke keer als nieuw bestand in je Google-account bewaard.
Elk bestand dat Neova uit een crawl maakt (Klantpakket, PDF, werkmap, Google Sheet, exports, Neova-bestanden) staat in een lijst met waar het heen ging, de crawl, de datum en de grootte, met Open, Map openen, Pad kopiëren en Openen in Google Drive.
Hetzelfde Neova-venster in een browser op app.neova.app, met de engine op de server van Neova, die daar crawlt en checkt.
Accounts openen via een uitnodigingslink, op naam of open, één link per account.
Een wachtwoord dat gehasht wordt opgeslagen, een login die 30 dagen na je laatste bezoek geldig blijft, een wachttijd na 10 foute wachtwoorden, verzoeken van andere sites geweigerd, en een melding als de pagina in de ingebouwde browser van een andere app geopend wordt.
De crawls, data en downloads van elke persoon in eigen mappen, nooit leesbaar voor een ander.
Eén taak per persoon tegelijk, 10,000 URL's per crawl, 10 URL's per seconde en 10 GB aan crawls per account zolang Neova Online getest wordt.
Verbindt Google Search Console, Google Analytics 4 en Google Drive vanuit de browser, met de login bewaard in je eigen ruimte.
Sleutels en webhooks worden bewaard in je Neova Online-account en nooit meer getoond.
Elk nieuw account begint met een Demo: een testwinkel en drie concurrenten die al gecrawld zijn, met portfolio-instellingen, codes en een Actieplan, in één stap te verwijderen.
Een uitnodiging kan portfolio's meebrengen die uit een ander account zijn gekopieerd, met hun laatste crawls, instellingen en plannen, en een banner zolang ze worden klaargezet.
Het venster past op telefoons en tablets: de zijbalk wordt een uitschuifmenu, sheets vullen het hele scherm in één kolom, tabellen scrollen zijwaarts.
Logt de desktop-app één keer in bij Neova Online; de app bewaart een sleutel voor die computer, nooit het wachtwoord.
Houdt portfolio's, concurrenten, je volgorde, de keuzes voor Google Search Console en Google Analytics 4, kleuren en codes vanzelf gelijk.
Als de ene kant de inhoud van de andere al bevat, voegt inloggen meteen samen zonder te vragen; als ze echt verschillen, vraagt het waar je begint: Die van Neova Online houden, Die van deze Mac houden of Beide samenvoegen (aanbevolen, er gaat niets verloren), met de aantallen van elke kant en eerst een back-up apart gezet.
Uploadt of downloadt hele crawls in hervatbare delen die aan het einde gecontroleerd worden, naast elke lopende crawl.
Stuurt elke crawl die op deze computer klaar is naar Neova Online; standaard uit.
Neova Online toont een nieuwe versie bij de volgende keer dat de pagina laadt, nooit een oud venster uit de cache.
Biedt de installers en de tutorialvideo voor testers, met noindex.
Haalt de verbindingssleutels uit je Neova Online-account naar deze computer, of stuurt die van deze computer ernaartoe, na je wachtwoord, toont van elke sleutel alleen de laatste 4 tekens en vervangt nooit een sleutel tenzij je Vervangen aanvinkt.
Elk Neova Online-account mag 10 GB aan crawls bewaren; Instellingen toont hoeveel het account bevat en hoeveel crawls, waarschuwt vanaf 85%, en een upload of crawl die niet meer past wordt geweigerd, met wat je kunt doen.
Neova SEO Platform voor de Mac, met de engine ingebouwd als native code; crawlt op je computer.
Een Windows x64-installer voor je eigen account, zonder beheerderswachtwoord; testversie, nog niet ondertekend.
Op Windows zegt de app deze pc en gebruikt Ctrl voor elke ⌘-sneltoets.
De desktop-app op Linux: een .deb voor Ubuntu, Linux Mint en Debian, en een AppImage die je niet hoeft te installeren.
Het venster en de checkbibliotheek in het Engels, Frans, Duits, Spaans, Portugees (Brazilië), Italiaans, Japans, Nederlands, Pools, Turks, Koreaans, Chinees (vereenvoudigd), Russisch, Indonesisch en Vietnamees.
Neova Marmer (standaard), Neova, macOS, Liquid Glass, Windows 11, Linux, Terminal en Hoog contrast; een look verandert de kleuren, nooit waar dingen staan.
Licht, donker of de keuze van het systeem, met een accentkleur.
Compacte of ruime rijen, en tekst die meeschaalt met ⌘+ en ⌘−.
Toont URL's als pad of met protocol en host, in elke tabel.
Schrijft datums en tijden zoals jij wilt of zoals de taal het doet.
Toont of verbergt de rij Home; de naam Neova linksboven opent Home hoe dan ook.
⌘N Nieuwe crawl, ⌘K Properties zoeken, ⌘, Instellingen, ⌘[ Terug, ⇧⌘P Presentatiemodus, ⌘/ Vraag of zoek.
Eén veld vindt een weergave, een check op titel of ID, een pagina van de crawl, een property of een instelling, en onthoudt je recente keuzes.
Een langere vraag gaat naar een model op je computer, dat een antwoord kiest uit wat het venster al toont, zodat het nooit een getal verzint.
Vervaagt elk portfolio behalve het geopende, voor schermdelen met een klant.
Gaat terug naar het vorige scherm, waarvan de naam op de knop staat.
Eén focusring, elke rij bereikbaar met Tab, pijltoetsen binnen tabellen, sheets als dialoogvensters, en respect voor minder beweging.
Sleep de zijbalk, de lijst met checks en het detailpaneel naar de breedte die je wilt.
Afsluiten vraagt het één keer terwijl een crawl loopt, bewaart hem dan met zijn stappen en voortgang in beeld, en Hervatten zet hem later voort.
Noemt elke geplande crawl die op de achtergrond loopt en biedt aan hem te stoppen en te bewaren voor het afsluiten.
Een crawl die loopt terwijl Neova wordt bijgewerkt, bewaart zichzelf en gaat verder met Hervatten.
Bij stoppen wordt alleen de nieuwe HTML toegevoegd, en elke bewaarstap verschijnt met een balk en Nu sluiten.
Houdt de vrije schijfruimte tijdens een crawl in de gaten, waarschuwt als die krap wordt en stopt veilig onder 3 GB, zodat Hervatten verdergaat zodra er ruimte vrij is.
Een crawl die door een crash of een gesloten pipe is afgebroken, staat als onderbroken in de lijst, wordt nooit weggegooid, en de opslag wordt veilig teruggedraaid.
De wachtrij en audits blijven doorlopen terwijl het venster verborgen is.
Kijkt op app.neova.app of er een nieuwere versie is als de app opent, elke 30 minuten en als het venster weer op de voorgrond komt, en stuurt daarbij alleen het versienummer.
Kopieert de instellingen van het venster na elke wijziging naar een bestand, één back-up per versie, en zet ze terug als de opslag van het venster gewist wordt.
Verplaatst de plek waar Neova zijn crawls bewaart.
Het icoon toont Neova SEO onder de spin, vanaf 64 px.
Een nieuwere versie toont Nieuwe versie beschikbaar linksboven, in de knoppenbalk, bovenaan in Help en in Instellingen › Algemeen, met Downloaden; de app kijkt elke 30 minuten en als het venster weer op de voorgrond komt.
Elke tabel past de breedte van de kolommen aan wat erin staat; de overgebleven breedte gaat naar de URL en de kolommen die als eerste worden afgekapt; elke kolomkop heeft een greep om te slepen, dubbelklikken maakt hem passend, en een breedte die je instelt blijft bewaard.
Een optionele geanimeerde mascotte, 8 om uit te kiezen (Webster, The Head, Sir Canonical, Polly Glot, Hopper, Shelly, Bo, Zap), schattig of in pixelart, die je crawls in de gaten houdt; standaard Geen, en met Geen wordt er niets geladen.
Een tekstballon als een crawl je nodig heeft: het einde van een crawl met zijn checks Moet opgelost en hoeveel er nieuw zijn, een gestopte of mislukte crawl, een site die de crawler blokkeert, een schijf die volloopt, een geplande crawl die start; een klik opent het scherm dat hij noemt.
Een klik op het huisdier vertelt wat Neova aan het doen is en neemt, met een crawl open, een vraag erover aan, beantwoord via dezelfde weg als de vraagbalk (Ollama op je computer of je eigen AI-sleutel).
Op het bureaublad heeft het huisdier een eigen venster boven elk venster en op elk bureaublad, buiten het Dock; Neova blijft opletten als het geminimaliseerd is en een klik brengt het terug op het juiste scherm.
Zeven formaten van Mini (56 px) tot Kolossaal (320 px), standaard Groot, en een werkbalk onder het huisdier: Neova openen, Nieuwe crawl, Bezig en Meer (verbergen, instellingen, dempen), bij aanwijzen of altijd.
Crawls worden bewaard in Application Support/Neova op een Mac en %APPDATA%/Neova op Windows; er gaat niets naar Neova tenzij je synchroniseert of deelt.
Elke sleutel, token en login gaat via de standaardinvoer van de engine naar de sleutelhanger van het systeem, nooit naar een bestand, een opdrachtregel of het scherm.
De app bevat geen sleutel van Neova: Google, Chrome UX Report, DataForSEO en de andere gebruiken je eigen sleutel en account.
De engine wordt geleverd als native code, zonder leesbare broncode.
Google wordt verbonden met alleen-lezen scopes plus je e-mailadres; Verbreek verbinding trekt het token bij Google in.
DataForSEO staat uit, tenzij Nieuwe crawl het voor die crawl aanzet.
Schat vóór Start de kosten op basis van wat DataForSEO deze computer rekende voor de laatste 20 aanroepen van elk soort, anders op basis van de prijslijst, afgerond naar boven op de volgende $0.50 of dollar.
Stopt met verzoeken aan DataForSEO zodra de limiet die je instelt bereikt is, $0.50 tot $10 per crawl, standaard $1.
De zoekdata van de Volledige audit stoppen bij een eigen limiet in Amerikaanse dollars, en de audit zegt wat er is uitgegeven.
Serverlogs worden op je computer gelezen; er wordt nergens een IP-adres opgeslagen.
AI-beoordeling en Vragen gebruiken een model op je computer via Ollama, zodat er niets je computer verlaat; AI-prompts zegt wanneer paginatekst naar een provider gaat die je zelf koos.
Deellinks, Neova Go en Voortgang delen worden op je computer versleuteld, met de sleutel alleen in de link of QR-code, zodat de server opslaat wat hij zelf niet kan lezen.
Delen welke woordenlijstpagina's je opent staat standaard uit en stuurt alleen een willekeurige ID, de check en de taal.
Een verwijderde crawl gaat naar de Prullenmand, waar je hem kunt terugzetten, met bulkselectie van oude gestopte crawls.
NeovaBot zegt wie hij is, respecteert robots.txt en standaard 3 URL's per seconde, en lost nooit een CAPTCHA op.
Bewaart een crawl, een property met al haar crawls en data, of een portfolio als één .neova-bestand, met of zonder de opgeslagen HTML, in Downloads, Google Drive, elke drive of map; planningen, verbindingen, sleutels en wachtwoorden zitten er nooit in.
Installeert een .neova-bestand dat op een willekeurige Mac-, Windows- of Linux-computer is gemaakt, zegt wat nieuw is, er al is of onder een andere naam binnenkomt voordat er iets wordt geschreven, en vervangt nooit wat deze computer al heeft.
Het commando neova crawlt, importeert, publiceert en leest sites, pagina's, meldingen, tickets en alerts vanuit Terminal of scripts, als tabellen, CSV of JSON.
neova check vergelijkt een crawl met een baseline en stopt met exitcode 3 bij nieuwe meldingen, of bij een melding die boven een aandeel van de URL's uitgroeit.
Geeft AI-assistenten leestoegang tot je crawls, meldingen, tickets en instellingen via 16 tools, terwijl de data op je computer blijft.
Voegt Neova in één klik toe aan Claude Desktop, met kopieerbare configuraties voor Claude Code, Codex, Cursor, VS Code, Gemini CLI, LM Studio, Windsurf en ChatGPT.
Start, stopt en verwijdert crawls vanuit een assistent; bij elke start en verwijdering vraagt het eerst om je akkoord.
Leest de log van een crawl en benoemt wat er misging (reeksen 429 of 503, 403's, blokkades in robots.txt, pagina's die alleen JavaScript zijn, te weinig pagina's), met de instelling die je moet aanpassen.
Eén gewoon JSON-bestand bevat de uitsluitingslijst, de standaardwaarden en de instellingen en checkschakelaars van elke property.
Opent een Internal-export van Screaming Frog (met All Inlinks), een URL-export van Sitebulb, de JSON van SiteOne Crawler of elke CSV met een URL-kolom, en voert de Neova-checks erop uit.
Beoordeelt een import door een steekproef van 50 URL's opnieuw op te halen met 2 URL/s en door te vergelijken met de live sitemaps, zodat een import nooit doet alsof hij een crawl is.
De HTTP-API van Neova Online op app.neova.app/api/v1: portfolio's, properties, crawls, meldingen en tickets lezen, een crawl starten en tickets beheren, elk script met een eigen sleutel Alleen lezen of Lezen en schrijven, 60 verzoeken per minuut per sleutel en 20 sleutels per account.
Verzoeken van zoekmachines en AI-crawlers per URL van de crawl, uit de eigen toegangslog van de site.
Telt een verzoek alleen voor Googlebot, Bingbot of een AI-crawler als het adres op de lijst staat die het bedrijf erachter publiceert; een naam die elders gebruikt wordt, telt apart.
Somt HTML-pagina's op die Googlebot in de logperiode nooit bezocht, en URL's die de bots opvroegen maar die de crawl niet kent.
Telt de 429- en 403-antwoorden die elke bot kreeg.
Leest een Apache- of Nginx-log in combined-formaat, gewoon of gezipt.
Voor een site achter Cloudflare verzamelt het de verzoeken van zoekmachines en AI-crawlers in je eigen Cloudflare-account en leest die voor elke crawl, zonder dat je servertoegang nodig hebt.
Schrijft het verzoek dat je naar IT stuurt: alleen crawlerregels, niets te installeren, en wat security moet weten.
Een dashboardblok met de verzoeken van de bots.
Koppelt elke URL van de crawl van de oude site aan de crawl van de nieuwe site, met een betrouwbaarheid, voor een migratie op hetzelfde domein of naar een ander.
Toetst de live redirect van elke oude URL aan de mapping en markeert de foute of ontbrekende.
Vergelijkt een stagingcrawl met productie: statuscode, noindex, canonical, title, meta description, H1, en URL's die maar in één crawl staan.
Wisselt om welke crawl oud en nieuw is, of staging en productie.
Negeert robots.txt en gaat sneller op een site waarvan je bevestigt dat hij van jou is, met HTTP-authenticatie en eigen headers.
Crawlt een lijst oude URL's om te checken waar elk ervan uitkomt.
Als de startpagina van een staging-subdomein vooral naar de live site linkt, toont Nieuwe crawl de aantallen en voegt het in één klik de regel voor URL-herschrijving en de XML-sitemaps van de live site toe; een toegevoegde XML-sitemap die geen regel naar de site verplaatst, wordt gemarkeerd voordat de crawl start.
Elke property van jou als blok in haar kleur, met haar logo en kerncijfers, en haar concurrenten als rijen eronder.
Sleep properties in je eigen volgorde, bewaard op de Mac, online en op de telefoon.
Klapt een groep in tot één regel, Alles inklappen en Alles uitklappen, en een vastgezette zoekbalk die je opent met /.
Een tabel met elke property en elke concurrent genest onder zijn property.
Eén centrale plek per site: de crawls, Voor de klant, Core Web Vitals, Google Search Console, concurrenten, Actieplan, analyse en planningen.
Rapport in huisstijl (PDF), Werkmap met alle meldingen (Excel) en de tickets, elk met één knop, gemaakt uit de open crawl.
Elke knop bovenaan de property zegt wat hij doet en hoe hij verschilt van de andere.
Groepeert properties per klant of bedrijf, met een kleur, en subportfolio's één niveau diep.
Geeft elke property een kleur en een code van 2 tot 6 letters, voorgesteld op basis van het domein.
Vindt een property met ⌘K, de vastgezette en lopende eerst, elk portfolio met zijn properties en concurrenten eronder.
De laatste vijf crawls van de property, met wat er van elke crawl geworden is, met één klik te openen.
Selecteert crawls met een vinkje of met Oudere gestopte en onderbroken selecteren, daarna Selectie verwijderen.
Elke rij in een lijst heeft één hoofdknop, daarna ⋯ en rechtsklikken met elke actie, Verwijderen als laatste in rood.
De checkbibliotheek op app.neova.app/checks, Help van Neova SEO Platform, Wat is er nieuw, Probleem melden, toetscombinaties en Zoek naar updates.
Downloaden, installeren, je eerste crawl, Neova Online en de desktop-app, optionele verbindingen en de changelog, op app.neova.app/help.
Alle 694 checks per groep op app.neova.app/checks, elk met een eigen pagina en bron, te openen via Over deze check, overal waar een check genoemd wordt.
Zegt één keer dat de resultaten van Neova geautomatiseerde analyse ter informatie zijn, en dat jij beslist wat je aanpast.
Het paneel van elke check heeft Over deze check, dat de eigen pagina van de check in de checkbibliotheek opent, met wat de check markeert en de bron.
Elke versie sinds de eerste build, de nieuwste eerst, elke wijziging gelabeld als Nieuw, Beter of Opgelost met het releasemoment in jouw tijdzone; opent na een update één keer vanzelf. Bovenaan staat onder Binnenkort beschikbaar wat er gepland is.
Maakt één ZIP voor support met de versies van de app en de log en kleine bestanden van de gekozen crawl, met geheimen afgeschermd, en vertelt vooraf wat erin zit en wat er nooit in zit.
Geen functie past bij die zoekopdracht.
Free-abonnement, of 14 dagen Desktop gratis, zonder kaart. Mac, Windows en Linux. Je crawls blijven op je computer.
Download NeovaNeova Online, dezelfde Neova in de browser, hoort bij Desktop + Online en Agency: bekijk de abonnementen.