テクニカルSEO監査チェックリスト:クローラーで実行できる16のステップ
実践的なテクニカルSEOのチェックリストを、私たちがサイトを調べる順番で紹介します。各ステップで、何を確認するか、クローラーでどう確認するか、どのNeovaのチェック項目がフラグを付けるかを示します。
チェックリストの一覧
| # | 分野 | 合格の条件 |
|---|---|---|
| 1 | robots.txt | 200を返し、500 KiB未満 |
| 2 | ブロックされたリソース | DisallowされたCSSやJSが0件 |
| 3 | noindex | 意図した箇所だけ |
| 4 | canonical | 対象が200を返し、インデックス可能 |
| 5 | リンク切れ | 内部の4xxや5xxが0件 |
| 6 | リダイレクト | 1ホップ、301または308 |
| 7 | HTTPS | 200を返すのは1バージョンだけ |
| 8 | XMLサイトマップ | インデックス可能な200のURLのみ |
| 9 | クリック深度 | 重要なページは3以下 |
| 10 | 孤立ページ | インデックス可能なものが0件 |
| 11 | 重複 | 1ページにつき1 URL |
| 12 | hreflang | すべてのリターンリンクがある |
| 13 | レンダリング | 本文が生のHTMLにある |
| 14 | 速度 | LCP 2.5秒、INP 200ミリ秒、CLS 0.1 |
| 15 | 構造化データ | 構文エラーが0件 |
| 16 | ログとAIボット | 重要なページが訪問され、ブロックが0件 |
順番が大切です。クロールできないページはインデックスされず、インデックスされていないページのスキーマを今直す必要はありません。上から順に進めましょう。
始める前に:監査用のクロールを設定する
- サイト全体をクロールするか、テンプレートごとにサンプルを取る。大規模なサイトでは、ページグループごとのサンプルでほとんどのパターンが数分で見つかります。
- XMLサイトマップをオンにする。サイトマップには載っているのにリンクからたどれないページは、この方法でしか見つかりません。
- JavaScriptでサンプルをレンダリングする。サイトがJavaScriptフレームワークを使っているなら、ステップ13のデータのために行います。
- Google Search Consoleを接続する。クリック数とGoogle自身のインデックスの判定から、どの指摘事項が重要なページに関わるかがわかります。
- 速度は控えめに。自分のサイトでない限りは。
クロールを実行したことがなければ、設定はサイトをクロールする方法のガイドで、結果の読み方はテクニカルSEOクローラーのガイドで紹介しています。各領域の考え方まで含めたより長いフレームワークは、SEO ProCheckのテクニカルSEO監査チェックリストのフレームワークをご覧ください。
クロール可能性:robots.txtとブロックされたリソース
- 1. robots.txtが応答し、解析でき、ブロックすべきものだけをブロックしている。ファイルを取得してすべてのルールを読み、クロールしたURLと照らし合わせます。Googleはファイルの最初の500 KiBを読み、残りは無視します。クローラーでは、robots.txtでブロックされた内部URLを探し、パターンごとにそのブロックが意図的かどうかを判断します。Neovaのrobots.txtテスターは、Googleのドキュメントに沿ってすべての行をわかりやすい言葉で説明し、各ルールに一致するクロール済みのURLを示し、公開前の下書きもテストできます。チェック項目:robots.txtにアクセスできない、またはサイズが大きすぎる、内部URLがrobots.txtでDisallowされている。
- 2. ページが必要なスクリプト、スタイル、画像を使える。robots.txtがJavaScriptやCSSのファイルをブロックしていると、検索エンジンはそれなしでページをレンダリングします。クローラーではリソースもクロールし、Disallowされたファイルを使うページを一覧にします。チェック項目:HTMLページでrobots.txtによりDisallowされたJavaScriptファイルが使われている。
500 KiBの上限と、ファイルの各ステータスコードの解釈は、Googleのrobots.txtの仕様に記載されています。
インデックス可否:noindexとcanonical
- 3. インデックス可能なページに紛れ込んだnoindexがない。ステージングから残ったnoindexは、ページが検索から消える最もよくある理由の1つです。meta robotsタグとX-Robots-Tagヘッダーを確認し、両者が一致していることを確かめます。クローラーではnoindexのページの一覧を読み、どれも意図的であることを確認します。チェック項目:noindexディレクティブがある、noindexがHTMLとHTTPヘッダーで異なる。
- 4. canonicalが200を返すインデックス可能なURLを指している。canonicalはヒントであり、リダイレクト、エラー、noindexのページを指すヒントは、検索エンジンに無視されがちです。クローラーでは、canonicalの列をその指定先のステータスと並べて見ます。Search Consoleを接続しているなら、Googleが別のcanonicalを選んだページも探します。チェック項目:canonicalがリダイレクトするURLを指している、Googleが指定とは異なるcanonicalを選択している。
canonicalがどう評価されるかは、Googleの重複したURLの統合のガイドで解説されています。
ステータスコード、リダイレクト、HTTPS
- 5. 4xxや5xxのURLへの内部リンクがなく、ソフト404もない。内部のリンク切れはクロールを無駄にし、訪問者を失います。ソフト404はさらに見つけにくく、「見つかりません」と表示しながら200を返すページです。クローラーではステータスコードで並べ替え、各エラーのインリンクを開いて直すべきリンクを探します。ソフト404については、titleとH1から「見つかりません」を示す語句を探します。チェック項目:内部URLが4xx、5xxを返す、または応答がない、titleまたはH1にソフト404を示す語句がある。
- 6. 内部URL間にリダイレクトチェーン、ループ、一時的なリダイレクトがない。ホップごとに時間がかかり、Googlebotがたどるのは最大10回までで、エラーで終わるチェーンではページそのものが失われます。クローラーでは、すべてのリダイレクトをホップと最終的なステータスとともに一覧にし、内部リンクを最終的なURLに向けて更新します。チェック項目:内部URLがリダイレクトチェーンになっている、内部URLが一時的なリダイレクトを使っている。
- 7. HTTPSで200を返すサイトのバージョンが1つだけ。httpとhttps、wwwありとなしの4つのうち、3つは4つ目にリダイレクトすべきです。Neovaの開始URLのチェックは、クロールを始める前にサイトを読み、各バージョンがどうなっているかを示します。チェック項目:開始URLがHTTPで配信され、HTTPSへのリダイレクトがない。
どのリダイレクトを使うべきかはGoogleのリダイレクトとGoogle検索のページで、よくある質問にはSEO ProCheckのリダイレクトとHTTPステータスコードのFAQで答えています。
XMLサイトマップとhreflang
- 8. XMLサイトマップにすべてのインデックス可能なページが載っていて、それ以外は載っていない。サイトマップは、どのURLが重要かをサイトが検索エンジンに伝えるものです。1つのファイルに入るのは最大50,000 URL、非圧縮で50 MBまでです。リダイレクト、エラー、noindexのページ、別URLにcanonical指定されたURLが入っていると矛盾したシグナルになり、載っていないインデックス可能なページは見落とされがちです。クローラーではリンクの後にサイトマップをクロールし、2つのリストを双方向で比較します。Neovaはサイトマップにしかないページを別のステップで取得し、別に数えます。チェック項目:インデックス可能なURLがどのXMLサイトマップにもない、noindexのURLがXMLサイトマップに掲載されている、リダイレクトするURLがXMLサイトマップに掲載されている。
形式と上限については、Googleのサイトマップの概要をご覧ください。
- 12. hreflangのセットが完全で、正しいURLを指している。セット内のどのページも、自分自身とほかのすべてのバージョンを列挙し、どの指定先もリンクを返し、どの指定先も200を返すインデックス可能なURLであるべきです。言語コードと地域コードは有効でなければなりません。クローラーではHTMLのheadとHTTPのLinkヘッダーからhreflangを読み、各指定先のステータスとリターンリンクを確認します。チェック項目:hreflangのリターンリンクがない、hreflangが200以外のURLを指している。
ルールと例は、Googleのページのローカライズ版のガイドにあります。
サイト構造:深度、孤立ページ、重複
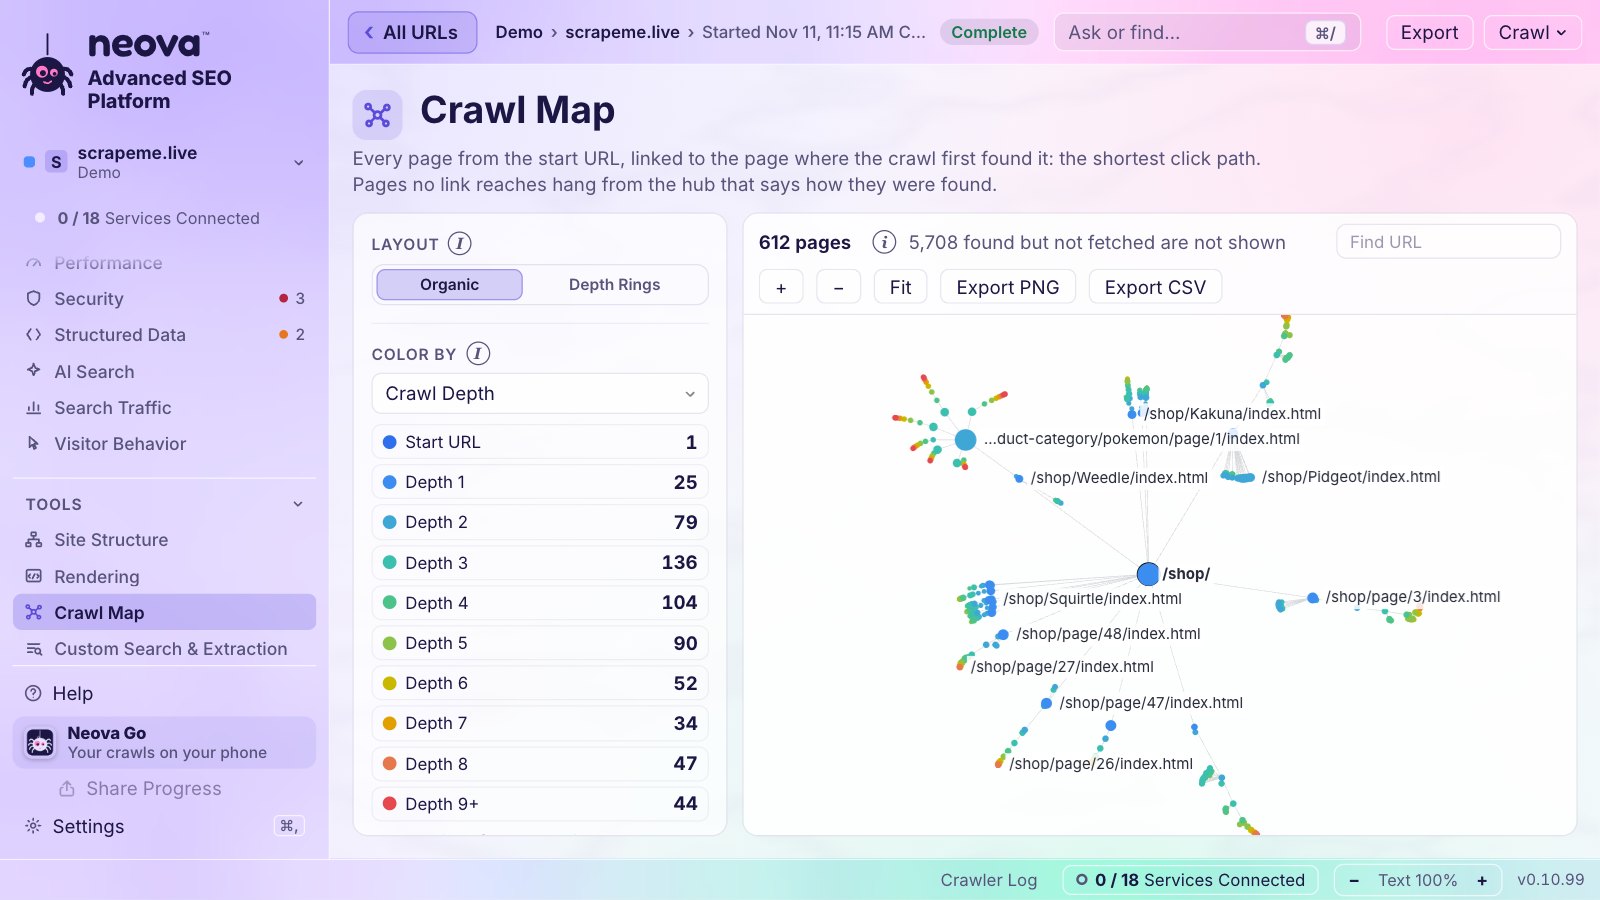
- 9. 重要なページがホームページから数クリックの位置にある。構造の深いところにあるページは見つかるのが遅く、クロールの頻度も下がります。クローラーではインデックス可能なページをクロール深度で並べ替え、4以上にあるものを確認します。Neovaは深度4以上のインデックス可能なページにフラグを付けます。チェック項目:インデックス可能なURLのクロール深度が4以上。
- 10. 孤立ページがなく、行き止まり経由でしか届かないページもない。孤立ページとは、どの内部リンクからもたどれないインデックス可能なページです。クロールをサイトマップ、サーバーログ、Search Consoleと比べると見つかります。リダイレクト、canonical、nofollowのリンク経由でしか届かないページも探しましょう。チェック項目:孤立URLが200を返し、インデックス可能、URLにリダイレクト経由でしか到達できない。
- 11. 競合する重複ページやURLのバリエーションがない。大文字と小文字の違い、末尾のスラッシュの有無、パラメータの順番の違いで同じページが存在すると、シグナルが分散します。クローラーではURLのバリエーションのHTMLを比較し、テキストやtitleが重複またはほぼ重複しているページをまとめます。チェック項目:URLのバリエーションが同じHTMLを返す、HTMLページ間のほぼ重複のコンテンツ。
大規模なサイトでは、同じ問題がボットの訪問先を左右します。その側面はクロールバジェットのガイドで扱っています。
レンダリング、速度、構造化データ
- 13. title、リンク、本文が元のHTMLにある。GoogleはJavaScriptをレンダリングしますが、クロールからかなり後になることもあり、ほかの多くのクローラーはサーバーが送るHTMLしか読みません。クローラーではテンプレートごとにサンプルをレンダリングし、レンダリング後のページを元のHTMLと比較します。Neovaは各ページにサーバーレンダリング、ハイドレーション済み、JavaScript が必要のいずれかを表示します。チェック項目:本文の大半がレンダリング後のHTMLにだけある、noindexディレクティブがJavaScriptで削除されている。詳しくはJavaScript SEOクローラーのガイドをご覧ください。
- 14. サーバーの応答とCore Web Vitalsが「良好」の範囲にある。「良好」とは、LCPが2.5秒以下、INPが200ミリ秒以下、CLSが0.1以下のことです。クローラーではテンプレートごとに1ページでLighthouseを実行し、実際の訪問者のデータはChrome UX Reportで確認します。Neovaは両方に対応しており、後者には自分のChrome UX Reportのキーを使います。チェック項目:ラボデータまたはフィールドデータでサーバーの応答時間が遅い、ラボデータまたはフィールドデータでCLSが0.1を超えている。
- 15. 構造化データが有効で、ページと一致している。構文エラーのあるマークアップは無視され、ページと食い違うマークアップも問題です。クローラーではすべてのページでスキーマを検証し、テンプレートごとに比較します。チェック項目:構造化データに構文エラーがある、構造化データに必須プロパティがない、または表示テキストと異なる。
背景については、GoogleのCore Web Vitalsと構造化データの概要をご覧ください。
サーバーログとAIクローラー
- 16. ログから、ボットが正しいURLを訪問していること、AIクローラーが意図したものを受け取っていることがわかる。クロールはサイトが何を返すかを示します。サーバーログは、Googlebot、Bingbot、AIクローラーが実際に何をリクエストし、何を受け取ったかを示します。リクエストをGooglebotとして数えるのは、そのアドレスが確認できた場合だけにします。ユーザーエージェントの文字列は簡単に偽装できるからです。そのうえで、ボットが一度も訪れない重要なページと、エラーに着いているボットの訪問を探します。AIクローラーについては、robots.txtがそれぞれに何の取得を許可しているかと、サーバーが実際に何を渡しているかを確認します。robots.txtで許可したクローラーでも、ファイアウォールやCDNのルールでブロックされることがあるからです。チェック項目:検索ボットへの3xx、4xx、5xxのレスポンスの割合が上昇している、AI検索クローラーのユーザーエージェントでのリクエストがブロックされている。
Neovaでは、サーバーログはApacheやNginxのログファイル、または自分のCloudflareアカウントから取り込み、ボットは各社が公開しているリストにアドレスがある場合だけ数えます。各AIアシスタントに提供される内容のビューでは、サンプルのページに10種類のAIエージェントとしてリクエストし、どれが完全にアクセスできるかを示します。どちらもログファイル分析とAIクローラーのガイドで詳しく紹介しており、GoogleはGooglebotの確認方法を解説しています。
私たち自身のサイトでこのチェックリストを試す
私たちは自分たちのサイトでも同じリストを使っています。2026年10月17日のNeovaによるseoprocheck.comのフルクロールでは、61分で10,222 URLを取得し、そのうち4,561件が200を返すHTMLページで、完了率は99.98%でした。フラグが付いたもの:
| フラグ | 数値 |
|---|---|
| meta descriptionが155文字を超えている | 582 |
| titleタグが60文字を超えている | 557 |
| titleの重複 | 56 |
| canonicalが別の内部URLを指している | 5 |
| alt属性のない画像 | 2 |
2026年11月20日のneova.appのSEOの見直しでは、このチェックリストの対象となる5つの問題が見つかり、すべてその日のうちに修正しました:
| ステップ | 修正前 | 修正後 |
|---|---|---|
| 7. http://のバージョン | 200 | httpsへ301 |
| 5. 存在しないアドレス | 503 | 404 |
| 1. Cloudflareのメール用スクリプト | 1,320ページでブロック | 許可 |
| 1. ファビコンのファイル | Disallow: /の対象 | 許可 |
| meta description | 一部が160文字超 | 160文字以下、1,354ページ |
ファビコンの問題はGoogleの検索結果にも表れていました。ファイルがブロックされていたため、neova.appの横にロゴではなく単なる文字が表示されていたのです。15言語で1,358件あるサイトマップのURLは、すべてのリターンリンクがそろっており、hreflangのステップに合格しました。
リストをひととおり終えたら、修正してから再クロールします。Neovaの修正を検証は、チェック項目がフラグを付けたURLだけを再取得し、何件が修正されたかを示します。クロールを比較では、2つのクロール間で何が変わったかがわかります。Neovaは694のチェック項目を実行します。自分のサイトで試すにはNeovaをダウンロードしてください。

よくある質問
テクニカルSEO監査チェックリストとは何ですか?
検索エンジンがサイトをクロール、レンダリング、インデックスできるかどうかを決める項目のリストで、決まった順番で確認していくものです。毎回同じ方法で進めることで、監査が定型の作業になります。
テクニカルSEO監査の手順は?
XMLサイトマップとともにサイトをクロールし、クロール可能性、インデックス可否、ステータスコードとリダイレクト、サイトマップ、サイト構造と重複、国際化のタグ、レンダリング、速度、構造化データ、最後にサーバーログを確認します。最も多くのインデックス可能なページに関わる問題から先に直し、再クロールします。
テクニカルSEO監査はどのくらいの頻度で行うべきですか?
完全な監査を年に1〜2回、大きなリリースのたびに軽めのクロールを行います。変化の多いサイトでは、毎週の定期クロールを前回と比較すると効果的です。
このチェックリストは無料のツールで実行できますか?
小規模なサイトならできます。NeovaのFreeプランでは、すべてのチェック項目、JavaScriptレンダリング、Search Consoleを使って、1回のクロールで最大1,000 URLまでクロールできます。サーバーログとCore Web Vitalsのスナップショットは有料プランで使えます。ほかの選択肢は無料SEOクローラーのガイドをご覧ください。
テクニカルSEO監査にサーバーログは必要ですか?
最初は必要ありません。チェックリストのほとんどはクロールでカバーできます。ログからはボットが実際に何をしたかがわかり、大規模なサイトや、ページのインデックスに時間がかかるときに特に重要です。