Checklist de auditoria de SEO técnico: 16 passos para rodar com um crawler
Um checklist prático de SEO técnico, na ordem em que trabalhamos um site. Cada passo diz o que verificar, como verificar num crawler e quais verificações da Neova o sinalizam.
O checklist num relance
| # | Área | Passa quando |
|---|---|---|
| 1 | robots.txt | Responde 200, menos de 500 KiB |
| 2 | Recursos bloqueados | 0 CSS ou JS bloqueados |
| 3 | Noindex | Só onde for intencional |
| 4 | Canonicals | O destino responde 200 e é indexável |
| 5 | Links quebrados | 0 internos 4xx ou 5xx |
| 6 | Redirecionamentos | 1 salto, 301 ou 308 |
| 7 | HTTPS | 1 versão responde 200 |
| 8 | Sitemaps XML | Só URLs 200 indexáveis |
| 9 | Profundidade de cliques | Páginas principais a 3 ou menos |
| 10 | Órfãs | 0 indexáveis |
| 11 | Duplicados | 1 URL por página |
| 12 | hreflang | Todos os links de retorno presentes |
| 13 | Renderização | Texto principal no HTML bruto |
| 14 | Velocidade | LCP 2,5 s, INP 200 ms, CLS 0,1 |
| 15 | Dados estruturados | 0 erros de sintaxe |
| 16 | Logs e bots de IA | Páginas principais visitadas, 0 bloqueios |
A ordem importa. Uma página que não pode ser rastreada não será indexada, e uma página que não está indexada ainda não precisa ter o schema corrigido. Trabalhe de cima para baixo.
Antes de começar: configure o crawl da auditoria
- Rastreie o site inteiro, ou uma amostra por template. Num site grande, uma amostra por grupo de páginas encontra a maioria dos padrões em minutos.
- Ative os sitemaps XML. Páginas que os sitemaps listam, mas que nenhum link alcança, só são encontradas assim.
- Renderize uma amostra com JavaScript se o site usa um framework JavaScript, para que o passo 13 tenha dados.
- Conecte o Google Search Console. Os cliques e o próprio veredito de índice do Google dizem quais achados afetam páginas que importam.
- Mantenha a velocidade educada, a menos que o site seja seu.
Se você nunca rodou um crawl, o guia de como rastrear um site trata da configuração, e o guia de crawler de SEO técnico mostra como ler os resultados. Para um roteiro mais longo, com o raciocínio por trás de cada área, veja o checklist de auditoria técnica de SEO no SEO ProCheck.
Rastreabilidade: robots.txt e recursos bloqueados
- 1. O robots.txt responde, é lido corretamente e bloqueia só o que deve. Busque o arquivo, leia cada regra e compare as regras com as URLs rastreadas. O Google lê os primeiros 500 KiB do arquivo e ignora o resto. Num crawler, procure URLs internas bloqueadas pelo robots.txt e decida, um padrão por vez, se o bloqueio é intencional. O Testador de robots.txt da Neova explica cada linha em linguagem simples, como o Google documenta, com as URLs rastreadas que cada regra atinge, e pode testar um rascunho antes de ir ao ar. Verificações: robots.txt inacessível ou grande demais, URL interna bloqueada pelo robots.txt.
- 2. As páginas conseguem usar os scripts, estilos e imagens de que precisam. Se o robots.txt bloqueia um arquivo JavaScript ou CSS, os buscadores renderizam a página sem ele. Num crawler, rastreie também os recursos e liste as páginas que usam um arquivo bloqueado. Verificação: Página HTML usa um arquivo JavaScript bloqueado pelo robots.txt.
A especificação do robots.txt do Google traz o limite de 500 KiB e como cada código de status do arquivo é interpretado.
Indexabilidade: noindex e canonicals
- 3. Páginas indexáveis não têm noindex perdido. Um noindex que sobrou do staging é um dos motivos mais comuns para uma página sair do índice. Confira a meta tag robots e o cabeçalho X-Robots-Tag e garanta que eles concordem. Num crawler, leia a lista de páginas com noindex: cada uma deve estar lá de propósito. Verificações: Diretiva noindex presente, Noindex difere entre o HTML e o cabeçalho HTTP.
- 4. As canonicals apontam para URLs indexáveis que respondem 200. Uma canonical é uma sugestão, e uma sugestão que aponta para um redirecionamento, um erro ou uma página com noindex costuma ser ignorada pelos buscadores. Num crawler, olhe a coluna canonical ao lado do status do destino. Com o Search Console conectado, procure também páginas em que o Google escolheu outra canonical. Verificações: Canonical aponta para uma URL que redireciona, Google escolheu uma canonical diferente da declarada.
O guia do Google sobre consolidar URLs duplicadas explica como as canonicals são avaliadas.
Códigos de status, redirecionamentos e HTTPS
- 5. Nenhum link interno para URLs 4xx ou 5xx, e nenhum soft 404. Links internos quebrados desperdiçam rastreamento e perdem visitantes. Um soft 404 é mais difícil de achar: uma página que diz "não encontrada", mas responde 200. Num crawler, ordene por código de status e abra os inlinks de cada erro para achar os links a corrigir. Para soft 404, procure frases de "não encontrado" nos titles e H1. Verificações: URL interna retorna 4xx, 5xx ou nenhuma resposta, Title ou H1 traz uma frase de soft 404.
- 6. Nenhuma cadeia, loop ou redirecionamento temporário entre URLs internas. Cada salto custa tempo, o Googlebot segue no máximo 10, e uma cadeia que termina num erro derruba a página inteira. Num crawler, liste cada redirecionamento com seus saltos e o status final, depois atualize os links internos para apontar para a URL final. Verificações: URL interna em uma cadeia de redirecionamentos, URL interna usa redirecionamento temporário.
- 7. Uma única versão do site responde 200, por HTTPS. http e https, com e sem www: três das quatro devem redirecionar para a quarta. A Verificação da URL inicial da Neova lê o site antes de o crawl começar e diz o que cada versão faz. Verificação: URL inicial servida por HTTP sem redirecionamento para HTTPS.
A página do Google sobre redirecionamentos e a Pesquisa Google mostra quais redirecionamentos usar, e o FAQ de redirecionamentos e códigos de status HTTP do SEO ProCheck responde as dúvidas comuns.
Sitemaps XML e hreflang
- 8. Os sitemaps XML listam todas as páginas indexáveis, e nada mais. Um sitemap é o site dizendo aos buscadores quais URLs importam. Um arquivo tem no máximo 50.000 URLs e 50 MB sem compressão. Redirecionamentos, erros, páginas com noindex e URLs canonicalizadas nele mandam sinais confusos, e páginas indexáveis que faltam nele passam despercebidas com facilidade. Num crawler, rastreie os sitemaps depois dos links e compare as duas listas nos dois sentidos. A Neova busca as páginas que só os sitemaps listam numa etapa separada e as conta à parte. Verificações: URL indexável fora de qualquer sitemap XML, URL em noindex listada em um sitemap XML, URL que redireciona listada em um sitemap XML.
Veja a visão geral de sitemaps do Google para o formato e os limites.
- 12. Os conjuntos de hreflang estão completos e apontam para as URLs certas. Cada página de um conjunto deve listar todas as outras versões e a si mesma, cada destino deve devolver o link e cada destino deve ser uma URL indexável que responde 200. Os códigos de idioma e região precisam ser válidos. Num crawler, leia o hreflang do head do HTML e do cabeçalho HTTP Link, depois confira o status de cada destino e o link de retorno. Verificações: Link de retorno do hreflang ausente, Hreflang aponta para uma URL que não retorna 200.
O guia do Google sobre versões localizadas das suas páginas traz as regras e exemplos.
Estrutura do site: profundidade, órfãs e duplicados
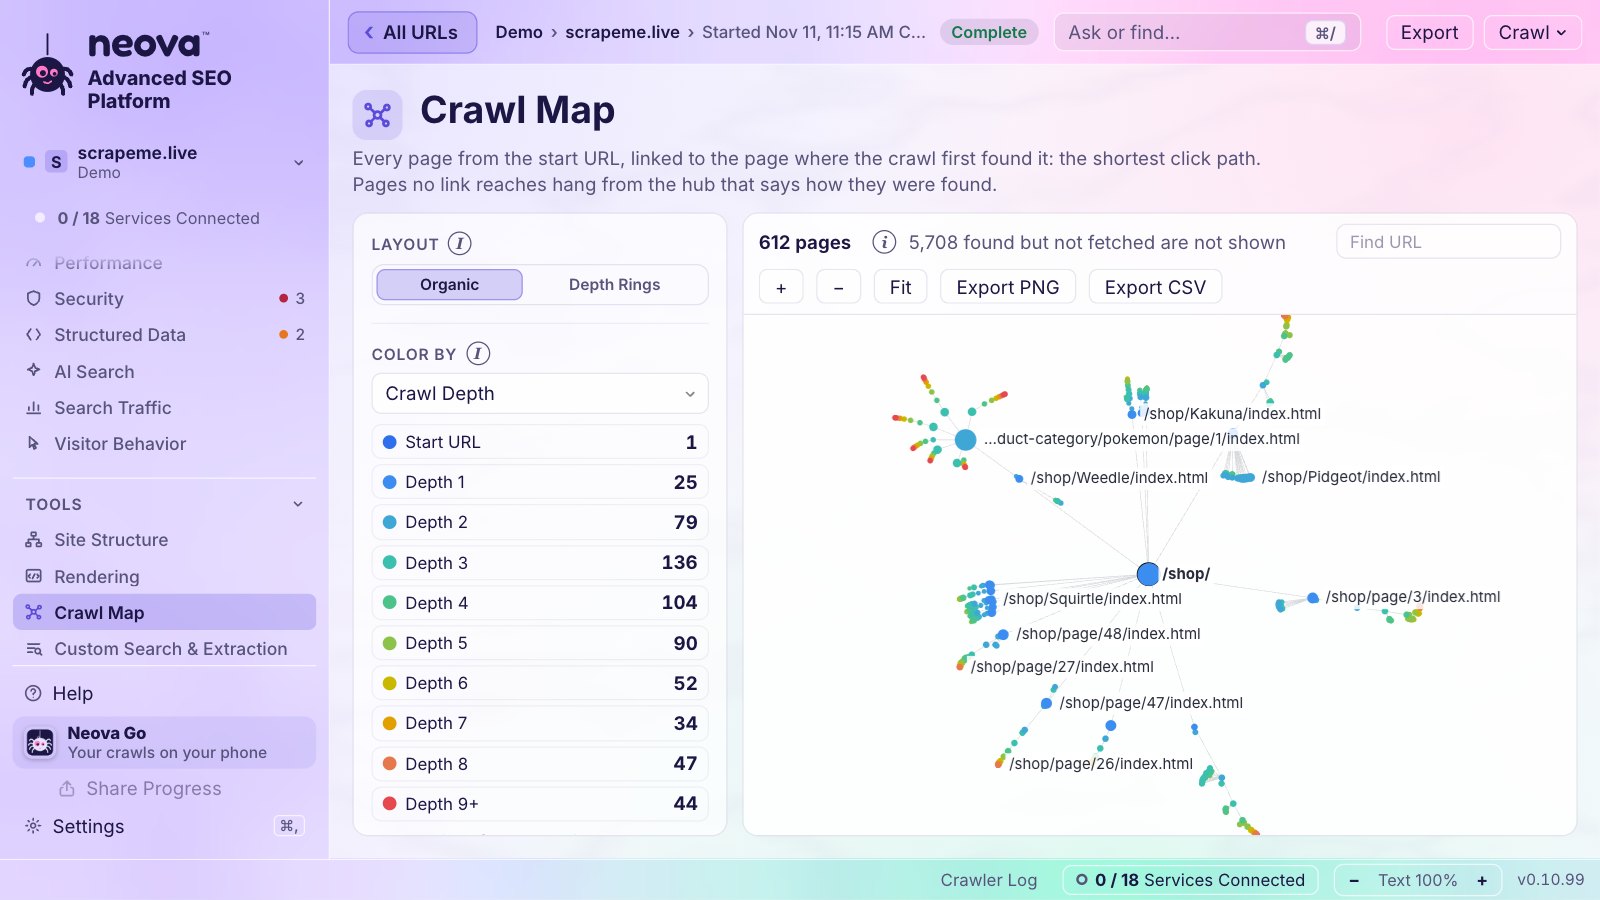
- 9. As páginas importantes ficam a poucos cliques da home. Páginas fundas na estrutura são encontradas mais tarde e rastreadas com menos frequência. Num crawler, ordene as páginas indexáveis por profundidade de crawl e veja o que está em 4 ou mais. A Neova sinaliza páginas indexáveis a partir da profundidade 4. Verificação: URL indexável na profundidade de crawl 4 ou mais.
- 10. Nenhuma página órfã e nenhuma página alcançada só por becos sem saída. Uma órfã é uma página indexável que nenhum link interno alcança. Você a encontra comparando o crawl com os sitemaps, o log do servidor ou o Search Console. Procure também páginas alcançadas só por um redirecionamento, uma canonical ou links nofollow. Verificações: URL órfã retorna 200 e é indexável, URL só pode ser alcançada por um redirecionamento.
- 11. Nenhuma página duplicada ou variante de URL competindo. A mesma página com duas grafias de maiúsculas e minúsculas, com e sem barra final, ou com parâmetros em outra ordem divide os sinais. Num crawler, compare o HTML das variantes de URL e agrupe as páginas com texto e titles duplicados ou quase duplicados. Verificações: Variantes de URL retornam o mesmo HTML, Conteúdo quase duplicado entre páginas HTML.
Num site grande, os mesmos problemas decidem onde os bots gastam as visitas; o guia de crawl budget trata desse lado.
Renderização, velocidade e dados estruturados
- 13. Titles, links e texto principal estão no HTML bruto. O Google renderiza JavaScript, às vezes bem depois do crawl, e muitos outros crawlers leem só o HTML que o servidor envia. Num crawler, renderize uma amostra por template e compare a página renderizada com o HTML bruto. A Neova marca cada página como Renderizada no servidor, Hidratada ou Precisa de JavaScript. Verificações: A maior parte do texto principal só aparece no HTML renderizado, Diretiva noindex removida por JavaScript. O guia de crawler de SEO para JavaScript vai mais fundo.
- 14. A resposta do servidor e as Core Web Vitals estão na faixa boa. Bom significa LCP de 2,5 s ou menos, INP de 200 ms ou menos e CLS de 0,1 ou menos. Num crawler, rode o Lighthouse numa página por template e leia o Chrome UX Report para dados de visitantes reais. A Neova faz os dois, o segundo com a sua própria chave do Chrome UX Report. Verificações: Tempo de resposta do servidor lento nos dados de laboratório ou de campo, CLS acima de 0,1 nos dados de laboratório ou de campo.
- 15. Os dados estruturados são válidos e batem com a página. Marcação com erros de sintaxe é ignorada, e marcação que discorda da página também é um problema. Num crawler, valide o schema em todas as páginas e compare dentro de cada template. Verificações: Dados estruturados com erros de sintaxe, Dados estruturados sem propriedades obrigatórias ou diferentes do texto visível.
Para o contexto, veja o Google sobre Core Web Vitals e a introdução aos dados estruturados.
Logs do servidor e crawlers de IA
- 16. Os logs mostram que os bots gastam as visitas nas URLs certas, e que os crawlers de IA recebem o que você quer que recebam. Um crawl mostra o que o site serve. Um log do servidor mostra o que o Googlebot, o Bingbot e os crawlers de IA pediram de fato, e o que receberam de volta. Conte uma requisição como Googlebot só quando o endereço dela confere; uma string de user agent é fácil de falsificar. Depois procure páginas principais que os bots nunca visitam e visitas de bots que caem em erros. Para os crawlers de IA, confira o que o robots.txt deixa cada um buscar e o que o servidor realmente entrega, já que uma regra de firewall ou CDN pode bloquear um crawler que o robots.txt permite. Verificações: Parcela de respostas 3xx, 4xx ou 5xx para bots de busca está subindo, Requisição com user agent de crawler de busca com IA é bloqueada.
Na Neova, o log do servidor vem de um arquivo de log do Apache ou do Nginx, ou da sua própria conta da Cloudflare, e só conta bots quando o endereço deles está na lista que cada empresa publica. A visão O que cada assistente de IA recebe consulta páginas de amostra como 10 agentes de IA e mostra quem tem acesso completo. Os guias de análise de arquivos de log e de crawlers de IA tratam dos dois a fundo, e o Google explica como verificar o Googlebot.
Este checklist nos nossos próprios sites
Rodamos a mesma lista nos nossos próprios sites. Um crawl completo da Neova em seoprocheck.com em 17 de outubro de 2026 buscou 10.222 URLs em 61 minutos, 4.561 delas páginas HTML que responderam 200, com 99,98% de completude. O que ele sinalizou:
| Sinalização | Quantidade |
|---|---|
| Meta description com mais de 155 caracteres | 582 |
| Title com mais de 60 caracteres | 557 |
| Title duplicado | 56 |
| Canonical para outra URL interna | 5 |
| Imagem sem texto alt | 2 |
Nossa revisão de SEO em neova.app em 20 de novembro de 2026 encontrou cinco coisas que o checklist cobre, todas corrigidas no mesmo dia:
| Etapa | Antes | Depois |
|---|---|---|
| 7. Versão http:// | 200 | 301 para https |
| 5. Endereço desconhecido | 503 | 404 |
| 1. Script de e-mail da Cloudflare | Bloqueado em 1.320 páginas | Liberado |
| 1. Arquivos de favicon | Atrás de Disallow: / | Liberado |
| Meta descriptions | Algumas acima de 160 | 160 ou menos, 1.354 páginas |
O do favicon era visível no Google: com os arquivos bloqueados, uma letra simples aparecia ao lado de neova.app no lugar do logo. As 1.358 URLs do sitemap do site, em 15 idiomas, passaram no passo do hreflang com todos os links de retorno no lugar.
Depois de percorrer a lista, corrija e rastreie de novo. O Verificar correção da Neova busca de novo só as URLs que uma verificação sinalizou e diz quantas foram corrigidas, e o Comparar crawls mostra o que mudou entre dois crawls. A Neova roda 694 verificações; baixe a Neova para rodá-las no seu site.

Perguntas
O que é um checklist de auditoria de SEO técnico?
Uma lista das coisas que decidem se os buscadores conseguem rastrear, renderizar e indexar um site, percorrida numa ordem fixa. Percorrê-la sempre do mesmo jeito transforma uma auditoria numa rotina.
Quais são os passos de uma auditoria de SEO técnico?
Rastreie o site com os sitemaps XML, depois verifique rastreabilidade, indexabilidade, códigos de status e redirecionamentos, sitemaps, estrutura do site e duplicados, tags internacionais, renderização, velocidade e dados estruturados e, por fim, os logs do servidor. Corrija primeiro os problemas que afetam mais páginas indexáveis e rastreie de novo.
Com que frequência devo fazer uma auditoria de SEO técnico?
Uma auditoria completa uma ou duas vezes por ano, e um crawl mais leve depois de cada release importante. Sites que mudam com frequência se beneficiam de um crawl agendado semanal comparado com o anterior.
Posso rodar este checklist com uma ferramenta grátis?
Num site pequeno, sim. O plano Free da Neova rastreia até 1.000 URLs por crawl com todas as verificações, renderização de JavaScript e Search Console. Logs do servidor e snapshots de Core Web Vitals vêm com os planos pagos. Veja o guia de crawler de SEO grátis para outras opções.
Preciso de logs do servidor para uma auditoria de SEO técnico?
Não para começar. Um crawl cobre a maior parte do checklist. Os logs acrescentam o que os bots fizeram de fato, o que importa mais em sites grandes e quando as páginas demoram a ser indexadas.