Checklist d'audit SEO technique : 16 étapes à mener avec un crawler
Une checklist SEO technique pratique, dans l'ordre où nous passons un site en revue. Chaque étape dit quoi vérifier, comment le vérifier dans un crawler, et quels checks Neova le signalent.
La checklist en un coup d'œil
| # | Domaine | Réussi quand |
|---|---|---|
| 1 | robots.txt | Répond 200, moins de 500 Kio |
| 2 | Ressources bloquées | 0 CSS ou JS interdit |
| 3 | Noindex | Seulement là où c'est voulu |
| 4 | Canoniques | La cible répond 200, indexable |
| 5 | Liens cassés | 0 interne en 4xx ou 5xx |
| 6 | Redirections | 1 saut, 301 ou 308 |
| 7 | HTTPS | 1 version répond 200 |
| 8 | Sitemaps XML | URL indexables en 200 seulement |
| 9 | Profondeur de clic | Pages clés à 3 ou moins |
| 10 | Orphelines | 0 indexable |
| 11 | Doublons | 1 URL par page |
| 12 | hreflang | Chaque lien de retour présent |
| 13 | Rendu | Texte principal dans le HTML brut |
| 14 | Vitesse | LCP 2,5 s, INP 200 ms, CLS 0,1 |
| 15 | Données structurées | 0 erreur de syntaxe |
| 16 | Logs et robots IA | Pages clés visitées, 0 blocage |
L'ordre compte. Une page qui ne peut pas être crawlée ne sera pas indexée, et une page qui n'est pas indexée n'a pas encore besoin qu'on corrige son schema. Travaillez de haut en bas.
Avant de commencer : configurez le crawl d'audit
- Crawlez tout le site, ou un échantillon par template. Sur un gros site, un échantillon par groupe de pages trouve la plupart des schémas récurrents en quelques minutes.
- Activez XML Sitemaps. Les pages que listent les sitemaps mais qu'aucun lien n'atteint ne se trouvent que de cette façon.
- Faites le rendu JavaScript d'un échantillon si le site utilise un framework JavaScript, pour que l'étape 13 ait des données.
- Connectez Google Search Console. Les clics et le verdict d'indexation de Google vous disent quels constats touchent des pages qui comptent.
- Gardez une vitesse courtoise, sauf si le site vous appartient.
Si vous n'avez jamais lancé de crawl, le guide comment crawler un site couvre la configuration, et le guide crawler SEO technique explique comment lire les résultats. Pour un cadre plus long, avec le raisonnement derrière chaque domaine, voir le cadre de checklist d'audit SEO technique sur SEO ProCheck.
Crawlabilité : robots.txt et ressources bloquées
- 1. Le robots.txt répond, se lit et ne bloque que ce qu'il doit bloquer. Récupérez-le, lisez chaque règle, et confrontez les règles aux URL crawlées. Google lit les 500 premiers Kio du fichier et ignore le reste. Dans un crawler, cherchez les URL internes bloquées par le robots.txt et décidez, motif par motif, si ce blocage est voulu. Le Testeur robots.txt de Neova explique chaque ligne en termes simples, tel que Google le documente, avec les URL crawlées que chaque règle concerne, et peut tester un brouillon avant sa mise en ligne. Checks : robots.txt inaccessible ou trop volumineux, URL interne bloquée par le robots.txt.
- 2. Les pages peuvent utiliser les scripts, les styles et les images dont elles ont besoin. Si le robots.txt bloque un fichier JavaScript ou CSS, les moteurs affichent la page sans lui. Dans un crawler, crawlez aussi les ressources, puis listez les pages qui utilisent un fichier interdit. Check : Page HTML qui utilise un fichier JavaScript interdit par le robots.txt.
La spécification du robots.txt de Google donne la limite de 500 Kio et la façon dont chaque code HTTP du fichier est interprété.
Indexabilité : noindex et canonicals
- 3. Les pages indexables ne portent aucun noindex égaré. Un noindex resté de la préproduction est l'une des raisons les plus courantes pour lesquelles une page disparaît. Vérifiez la balise meta robots et l'en-tête X-Robots-Tag, et assurez-vous qu'ils concordent. Dans un crawler, lisez la liste des pages en noindex : chacune doit y être volontairement. Checks : Directive noindex présente, Noindex différent entre le HTML et l'en-tête HTTP.
- 4. Les canonicals pointent vers des URL indexables qui répondent 200. Une canonical est un indice, et un indice qui pointe vers une redirection, une erreur ou une page en noindex est un indice que les moteurs ont tendance à ignorer. Dans un crawler, regardez la colonne canonical à côté du statut de sa cible. Avec Search Console connecté, cherchez aussi les pages où Google a choisi une autre canonique. Checks : Canonical qui pointe vers une URL qui redirige, Google a choisi une canonique différente de celle déclarée.
Le guide de Google sur la consolidation des URL en double explique comment les canonicals sont pondérées.
Codes HTTP, redirections et HTTPS
- 5. Aucun lien interne vers des URL en 4xx ou 5xx, et aucun soft 404. Les liens internes cassés gaspillent du crawl et font perdre des visiteurs. Un soft 404 est plus difficile à trouver : une page qui dit « introuvable » mais répond 200. Dans un crawler, triez par code HTTP, puis ouvrez les liens entrants de chaque erreur pour trouver les liens à corriger. Pour les soft 404, cherchez des formules « introuvable » dans les titles et les H1. Checks : URL interne qui renvoie 4xx, 5xx ou aucune réponse, Balise title ou H1 avec une formule de soft 404.
- 6. Aucune chaîne, boucle ou redirection temporaire entre URL internes. Chaque saut coûte du temps, Googlebot en suit au plus 10, et une chaîne qui finit sur une erreur fait disparaître la page entièrement. Dans un crawler, listez chaque redirection avec ses sauts et son statut final, puis mettez à jour les liens internes pour qu'ils pointent vers l'URL finale. Checks : URL interne dans une chaîne de redirections, URL interne avec une redirection temporaire.
- 7. Une seule version du site répond 200, en HTTPS. http et https, avec et sans www : trois des quatre doivent rediriger vers la quatrième. La Vérification de l'URL de départ de Neova lit le site avant le début du crawl et dit ce que fait chaque version. Check : URL de départ servie en HTTP sans redirection vers HTTPS.
La page de Google sur les redirections et la recherche Google indique quelles redirections utiliser, et la FAQ sur les redirections et les codes HTTP de SEO ProCheck répond aux questions courantes.
Sitemaps XML et hreflang
- 8. Les sitemaps XML listent chaque page indexable, et rien d'autre. Un sitemap, c'est le site qui dit aux moteurs quelles URL comptent. Un fichier contient au plus 50 000 URL et 50 Mo non compressés. Les redirections, les erreurs, les pages en noindex et les URL canonicalisées qu'il contient envoient des signaux contradictoires, et les pages indexables qui en sont absentes passent facilement inaperçues. Dans un crawler, crawlez les sitemaps après les liens, puis comparez les deux listes dans les deux sens. Neova récupère les pages que seuls les sitemaps listent dans une étape distincte et les compte à part. Checks : URL indexable absente de tout sitemap XML, URL en noindex listée dans un sitemap XML, URL qui redirige listée dans un sitemap XML.
Voir la présentation des sitemaps de Google pour le format et les limites.
- 12. Les ensembles hreflang sont complets et pointent vers les bonnes URL. Chaque page d'un ensemble doit lister toutes les autres versions et elle-même, chaque cible doit renvoyer le lien, et chaque cible doit être une URL indexable qui répond 200. Les codes de langue et de région doivent être valides. Dans un crawler, lisez les hreflang dans le head HTML et dans l'en-tête HTTP Link, puis vérifiez le statut de chaque cible et son lien de retour. Checks : Lien de retour hreflang manquant, Hreflang qui pointe vers une URL non 200.
Le guide de Google sur les versions localisées de vos pages donne les règles et des exemples.
Structure du site : profondeur, orphelines et doublons
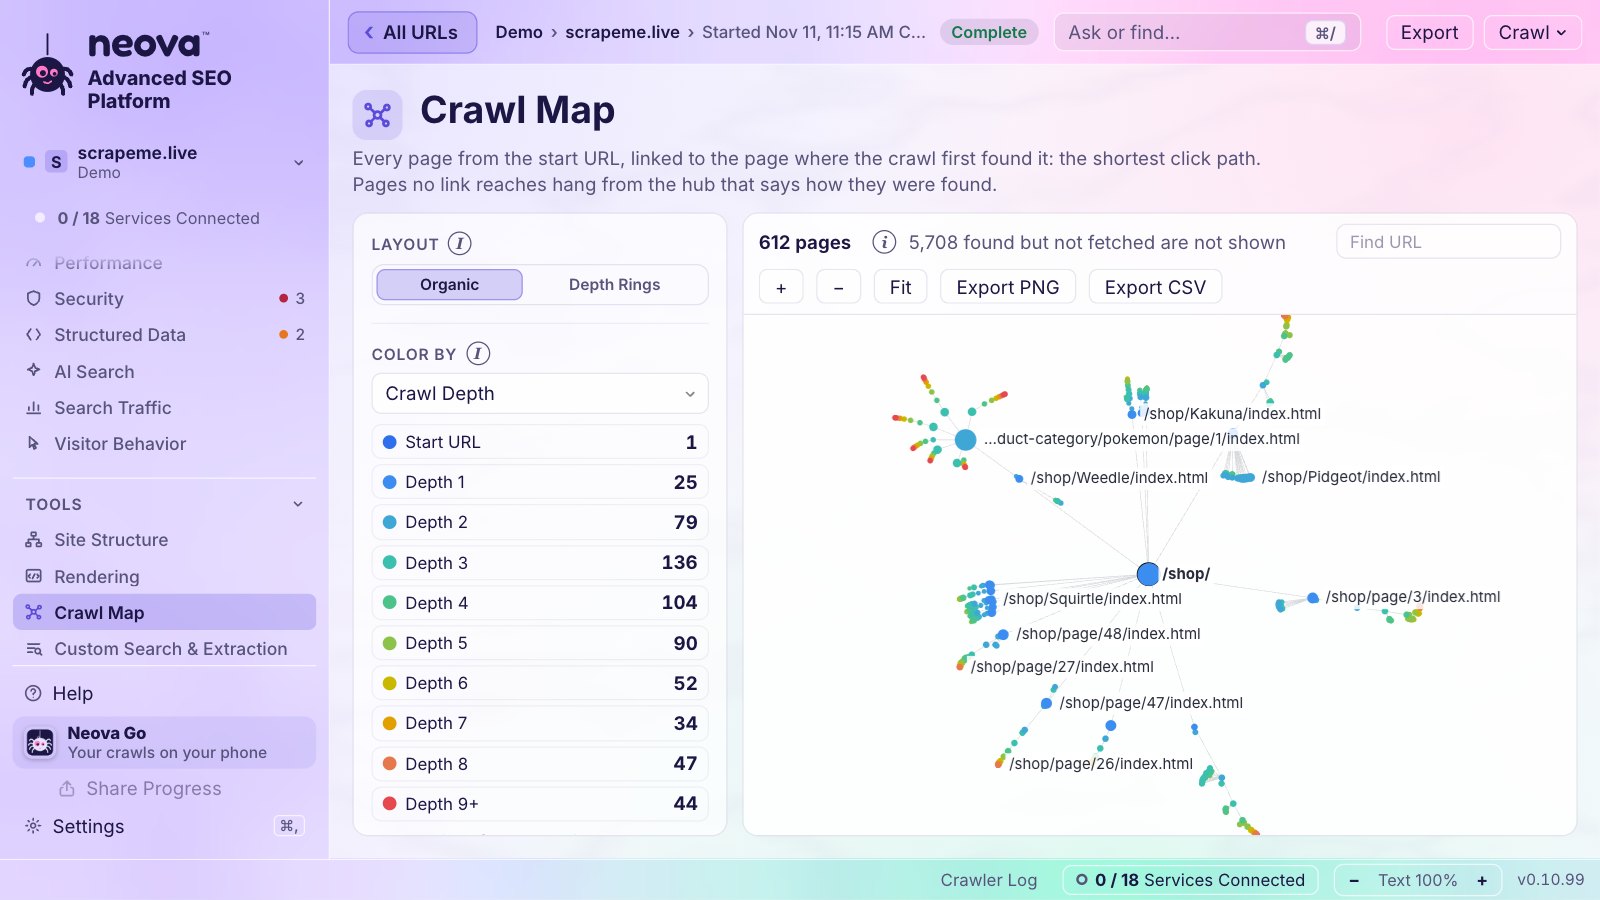
- 9. Les pages importantes sont à quelques clics de la page d'accueil. Les pages enfouies dans la structure sont trouvées plus tard et crawlées moins souvent. Dans un crawler, triez les pages indexables par profondeur de crawl et regardez ce qui se trouve à 4 ou plus. Neova signale les pages indexables à partir de la profondeur 4. Check : URL indexable à une profondeur de crawl de 4 ou plus.
- 10. Aucune page orpheline et aucune page atteinte seulement par des impasses. Une orpheline est une page indexable qu'aucun lien interne n'atteint. On la trouve en comparant le crawl aux sitemaps, au log serveur ou à Search Console. Cherchez aussi les pages atteintes uniquement par une redirection, une canonical ou des liens nofollow. Checks : URL orpheline qui répond 200 et est indexable, URL accessible uniquement par une redirection.
- 11. Aucune page en double ni variante d'URL en concurrence. La même page sous deux casses, avec et sans slash final, ou avec des paramètres dans un ordre différent divise les signaux. Dans un crawler, comparez le HTML des variantes d'URL, puis regroupez les pages au texte et aux titles dupliqués ou quasi dupliqués. Checks : Variantes d'URL qui renvoient le même HTML, Contenu quasi dupliqué entre pages HTML.
Sur un gros site, les mêmes problèmes décident où les robots passent leurs visites ; le guide budget de crawl couvre cet aspect.
Rendu, vitesse et données structurées
- 13. Les titles, les liens et le texte principal sont dans le HTML brut. Google fait le rendu du JavaScript, parfois bien après le crawl, et beaucoup d'autres crawlers ne lisent que le HTML envoyé par le serveur. Dans un crawler, faites le rendu d'un échantillon par template et comparez la page rendue au HTML brut. Neova marque chaque page Rendue côté serveur, Hydratée ou Nécessite JavaScript. Checks : L'essentiel du texte principal n'apparaît que dans le HTML rendu, Directive noindex retirée par JavaScript. Le guide du crawler SEO JavaScript va plus loin.
- 14. La réponse du serveur et les Core Web Vitals sont dans la zone « bon ». Bon signifie LCP de 2,5 s ou moins, INP de 200 ms ou moins et CLS de 0,1 ou moins. Dans un crawler, lancez Lighthouse sur une page par template, et lisez le Chrome UX Report pour les données de vrais visiteurs. Neova fait les deux, le second avec votre propre clé Chrome UX Report. Checks : Temps de réponse du serveur lent en labo ou sur le terrain, CLS supérieur à 0,1 en labo ou sur le terrain.
- 15. Les données structurées sont valides et correspondent à la page. Un balisage avec des erreurs de syntaxe est ignoré, et un balisage qui contredit la page pose aussi problème. Dans un crawler, validez le schema sur chaque page et comparez-le au sein de chaque template. Checks : Données structurées avec erreurs de syntaxe, Données structurées sans propriétés obligatoires ou différentes du texte visible.
Pour le contexte, voir les pages de Google sur les Core Web Vitals et l'introduction aux données structurées.
Logs serveur et crawlers IA
- 16. Les logs montrent que les robots passent leurs visites sur les bonnes URL, et que les crawlers IA reçoivent ce que vous voulez leur donner. Un crawl montre ce que sert le site. Un log serveur montre ce que Googlebot, Bingbot et les crawlers IA ont réellement demandé, et ce qu'ils ont reçu. Ne comptez une requête comme Googlebot que si son adresse est vérifiée ; un user agent est facile à imiter. Cherchez ensuite les pages clés que les robots ne visitent jamais, et les visites de robots qui tombent sur des erreurs. Pour les crawlers IA, vérifiez ce que le robots.txt permet à chacun de récupérer, et ce que le serveur lui remet vraiment, car une règle de pare-feu ou de CDN peut bloquer un crawler que le robots.txt autorise. Checks : Part croissante de réponses 3xx, 4xx ou 5xx pour les bots de recherche, Requête avec le user agent d'un crawler de recherche IA bloquée.
Dans Neova, le log serveur vient d'un fichier de log Apache ou Nginx, ou de votre propre compte Cloudflare, et ne compte les robots que si leur adresse figure sur la liste que publie chaque éditeur. La vue Ce qui est servi à chaque assistant IA interroge des pages échantillonnées en tant que 10 agents IA et montre qui obtient un accès complet. Les guides analyse de logs et crawlers IA traitent les deux en profondeur, et Google explique comment vérifier Googlebot.
Cette checklist sur nos propres sites
Nous passons la même liste sur nos propres sites. Un crawl complet Neova de seoprocheck.com du 17 octobre 2026 a récupéré 10 222 URL en 61 minutes, dont 4 561 pages HTML qui répondaient 200, avec une complétude de 99,98 %. Ce qu'il a signalé :
| Flag | Nombre |
|---|---|
| Meta description de plus de 155 caractères | 582 |
| Title de plus de 60 caractères | 557 |
| Title dupliqué | 56 |
| Canonical vers une autre URL interne | 5 |
| Image sans texte alt | 2 |
Notre passe SEO sur neova.app du 20 novembre 2026 a trouvé cinq points couverts par la checklist, tous corrigés le jour même :
| Étape | Avant | Après |
|---|---|---|
| 7. Version http:// | 200 | 301 vers https |
| 5. Adresse inconnue | 503 | 404 |
| 1. Script e-mail de Cloudflare | Bloqué sur 1 320 pages | Autorisé |
| 1. Fichiers favicon | Derrière Disallow: / | Autorisé |
| Meta descriptions | Certaines de plus de 160 | 160 ou moins, 1 354 pages |
Le problème du favicon se voyait dans Google : avec les fichiers bloqués, une simple lettre s'affichait à côté de neova.app au lieu du logo. Les 1 358 URL de sitemap du site en 15 langues ont passé l'étape hreflang avec chaque lien de retour en place.
Quand vous avez parcouru la liste, corrigez, puis crawlez à nouveau. Vérifier la correction de Neova ne récupère que les URL qu'un check a signalées et dit combien sont corrigées, et Comparer les crawls montre ce qui a changé entre deux crawls. Neova lance 694 checks ; téléchargez Neova pour les lancer sur votre site.

Questions
Qu'est-ce qu'une checklist d'audit SEO technique ?
Une liste de ce qui décide si les moteurs de recherche peuvent crawler, afficher et indexer un site, parcourue dans un ordre fixe. La suivre de la même façon à chaque fois fait d'un audit une routine.
Quelles sont les étapes d'un audit SEO technique ?
Crawlez le site avec ses sitemaps XML, puis vérifiez la crawlabilité, l'indexabilité, les codes HTTP et les redirections, les sitemaps, la structure du site et les doublons, les balises internationales, le rendu, la vitesse et les données structurées, et enfin les logs serveur. Corrigez d'abord les problèmes qui touchent le plus de pages indexables, puis crawlez à nouveau.
À quelle fréquence faire un audit SEO technique ?
Un audit complet une ou deux fois par an, et un crawl plus léger après chaque mise en production importante. Les sites qui changent souvent gagnent à avoir un crawl planifié chaque semaine, comparé au précédent.
Puis-je suivre cette checklist avec un outil gratuit ?
Sur un petit site, oui. L'offre Free de Neova crawle jusqu'à 1 000 URL par crawl avec tous les checks, le rendu JavaScript et Search Console. Les logs serveur et les instantanés Core Web Vitals viennent avec les offres payantes. Voir le guide du crawler SEO gratuit pour d'autres options.
Faut-il des logs serveur pour un audit SEO technique ?
Pas pour commencer. Un crawl couvre l'essentiel de la checklist. Les logs ajoutent ce que les robots ont réellement fait, ce qui compte surtout sur les gros sites et quand les pages tardent à être indexées.