Technische SEO-audit checklist: 16 stappen die je met een crawler uitvoert
Een praktische checklist voor technische SEO, in de volgorde waarin wij een site doorwerken. Elke stap zegt wat je controleert, hoe je het in een crawler controleert en welke checks van Neova het melden.
De checklist in een oogopslag
| # | Gebied | Geslaagd als |
|---|---|---|
| 1 | robots.txt | Antwoordt 200, kleiner dan 500 KiB |
| 2 | Geblokkeerde resources | 0 CSS of JS geblokkeerd |
| 3 | Noindex | Alleen waar bedoeld |
| 4 | Canonicals | Doel antwoordt 200, indexeerbaar |
| 5 | Kapotte links | 0 interne 4xx of 5xx |
| 6 | Redirects | 1 stap, 301 of 308 |
| 7 | HTTPS | 1 versie antwoordt 200 |
| 8 | XML-sitemaps | Alleen indexeerbare URL's met 200 |
| 9 | Klikdiepte | Belangrijke pagina's op 3 of minder |
| 10 | Weespagina's | 0 indexeerbare |
| 11 | Duplicaten | 1 URL per pagina |
| 12 | hreflang | Elke retourlink aanwezig |
| 13 | Rendering | Hoofdtekst in ruwe HTML |
| 14 | Snelheid | LCP 2,5 s, INP 200 ms, CLS 0,1 |
| 15 | Gestructureerde data | 0 syntaxfouten |
| 16 | Logs en AI-bots | Belangrijke pagina's bezocht, 0 blokkades |
De volgorde doet ertoe. Een pagina die niet gecrawld kan worden, wordt niet geïndexeerd, en bij een pagina die niet geïndexeerd is, hoeft het schema nog niet opgelost te worden. Werk van boven naar beneden.
Voordat je begint: zet de auditcrawl op
- Crawl de hele site, of een steekproef per template. Op een grote site vindt een steekproef per paginagroep de meeste patronen in een paar minuten.
- Zet XML-sitemaps aan. Pagina's die de sitemaps opsommen maar die geen link bereikt, vind je alleen zo.
- Render een steekproef met JavaScript als de site een JavaScript-framework gebruikt, zodat stap 13 data heeft.
- Koppel Google Search Console. Klikken en het eigen indexoordeel van Google vertellen je welke bevindingen pagina's raken die ertoe doen.
- Houd de snelheid beleefd, tenzij de site van jou is.
Heb je nog nooit een crawl gedraaid, dan behandelt de gids een website crawlen de opzet, en de gids technische SEO-crawler hoe je de resultaten leest. Voor een uitgebreider raamwerk met de redenering achter elk gebied, zie het raamwerk voor de checklist van een technische SEO-audit op SEO ProCheck.
Crawlbaarheid: robots.txt en geblokkeerde resources
- 1. robots.txt antwoordt, is te parsen en blokkeert alleen wat het moet. Haal het bestand op, lees elke regel en leg de regels naast de gecrawlde URL's. Google leest de eerste 500 KiB van het bestand en negeert de rest. Zoek in een crawler naar interne URL's die robots.txt blokkeert en beslis, één patroon tegelijk, of die blokkade bewust is. De robots.txt-tester van Neova legt elke regel in gewone taal uit, zoals Google het documenteert, met de gecrawlde URL's die elke regel raakt, en kan een concept testen voordat het live gaat. Checks: robots.txt is onbereikbaar of te groot, Interne URL is geblokkeerd door robots.txt.
- 2. Pagina's kunnen de scripts, stijlen en afbeeldingen gebruiken die ze nodig hebben. Blokkeert robots.txt een JavaScript- of CSS-bestand, dan renderen zoekmachines de pagina zonder. Crawl in een crawler ook de resources, en som dan de pagina's op die een geblokkeerd bestand gebruiken. Check: HTML-pagina gebruikt een door robots.txt geblokkeerd JavaScript-bestand.
De robots.txt-specificatie van Google bevat de limiet van 500 KiB en hoe elke statuscode van het bestand wordt gelezen.
Indexeerbaarheid: noindex en canonicals
- 3. Indexeerbare pagina's hebben geen verdwaalde noindex. Een noindex die van staging is blijven staan, is een van de meest voorkomende redenen dat een pagina uit de index valt. Controleer de meta robots-tag en de X-Robots-Tag-header, en zorg dat ze overeenkomen. Lees in een crawler de lijst met noindex-pagina's: elke pagina hoort daar bewust te staan. Checks: Noindex-directive is aanwezig, Noindex verschilt tussen HTML en HTTP-header.
- 4. Canonicals wijzen naar indexeerbare URL's die 200 antwoorden. Een canonical is een hint, en een hint die naar een redirect, een fout of een noindex-pagina wijst, negeren zoekmachines vaak. Kijk in een crawler naar de kolom canonical naast de status van het doel. Kijk met Search Console gekoppeld ook naar pagina's waarvoor Google een andere canonical koos. Checks: Canonical wijst naar een URL met een redirect, Google koos een andere canonical dan de opgegeven canonical.
De gids van Google over dubbele URL's consolideren legt uit hoe canonicals worden gewogen.
Statuscodes, redirects en HTTPS
- 5. Geen interne links naar URL's met 4xx of 5xx, en geen soft 404's. Kapotte interne links verspillen crawls en kosten bezoekers. Een soft 404 is lastiger te vinden: een pagina die niet gevonden zegt maar 200 antwoordt. Sorteer in een crawler op statuscode en open dan de inlinks van elke fout om de links te vinden die je moet aanpassen. Zoek voor soft 404's in titles en H1's naar zinnen als niet gevonden. Checks: Interne URL geeft 4xx, 5xx of geen respons, Title of H1 bevat een soft 404-zin.
- 6. Geen redirectketens, lussen of tijdelijke redirects tussen interne URL's. Elke stap kost tijd, Googlebot volgt er hoogstens 10, en een keten die op een fout eindigt, laat de pagina helemaal wegvallen. Som in een crawler elke redirect op met zijn stappen en eindstatus, en werk dan de interne links bij zodat ze naar de uiteindelijke URL wijzen. Checks: Interne URL zit in een redirectketen, Interne URL gebruikt een tijdelijke redirect.
- 7. Eén versie van de site antwoordt 200, via HTTPS. http en https, met en zonder www: drie van de vier moeten naar de vierde redirecten. De Check van de start-URL van Neova leest de site voordat de crawl begint en zegt wat elke versie doet. Check: Start-URL wordt via HTTP geleverd zonder redirect naar HTTPS.
De pagina van Google over redirects en Google Zoeken behandelt welke redirects je gebruikt, en de FAQ over redirects en HTTP-statuscodes op SEO ProCheck beantwoordt de veelgestelde vragen.
XML-sitemaps en hreflang
- 8. XML-sitemaps bevatten elke indexeerbare pagina, en verder niets. Een sitemap is de site die zoekmachines vertelt welke URL's ertoe doen. Eén bestand bevat hoogstens 50.000 URL's en 50 MB ongecomprimeerd. Redirects, fouten, noindex-pagina's en gecanonicaliseerde URL's erin geven tegenstrijdige signalen, en indexeerbare pagina's die eruit ontbreken, zie je makkelijk over het hoofd. Crawl in een crawler de sitemaps na de links, en vergelijk dan de twee lijsten in beide richtingen. Neova haalt de pagina's die alleen in de sitemaps staan in een aparte stap op en telt ze apart. Checks: Indexeerbare URL staat in geen enkele XML-sitemap, Noindex-URL staat in een XML-sitemap, Redirectende URL staat in een XML-sitemap.
Zie het overzicht van sitemaps van Google voor het formaat en de limieten.
- 12. hreflang-sets zijn volledig en wijzen naar de juiste URL's. Elke pagina in een set hoort elke andere versie en zichzelf te vermelden, elk doel hoort terug te linken, en elk doel hoort een indexeerbare URL te zijn die 200 antwoordt. Taal- en regiocodes moeten geldig zijn. Lees in een crawler hreflang uit de HTML-head en de HTTP Link-header, en controleer dan de status en de retourlink van elk doel. Checks: Retourlink van hreflang ontbreekt, Hreflang wijst naar een URL die geen 200 geeft.
De gids van Google over gelokaliseerde versies van je pagina's bevat de regels en voorbeelden.
Sitestructuur: diepte, weespagina's en duplicaten
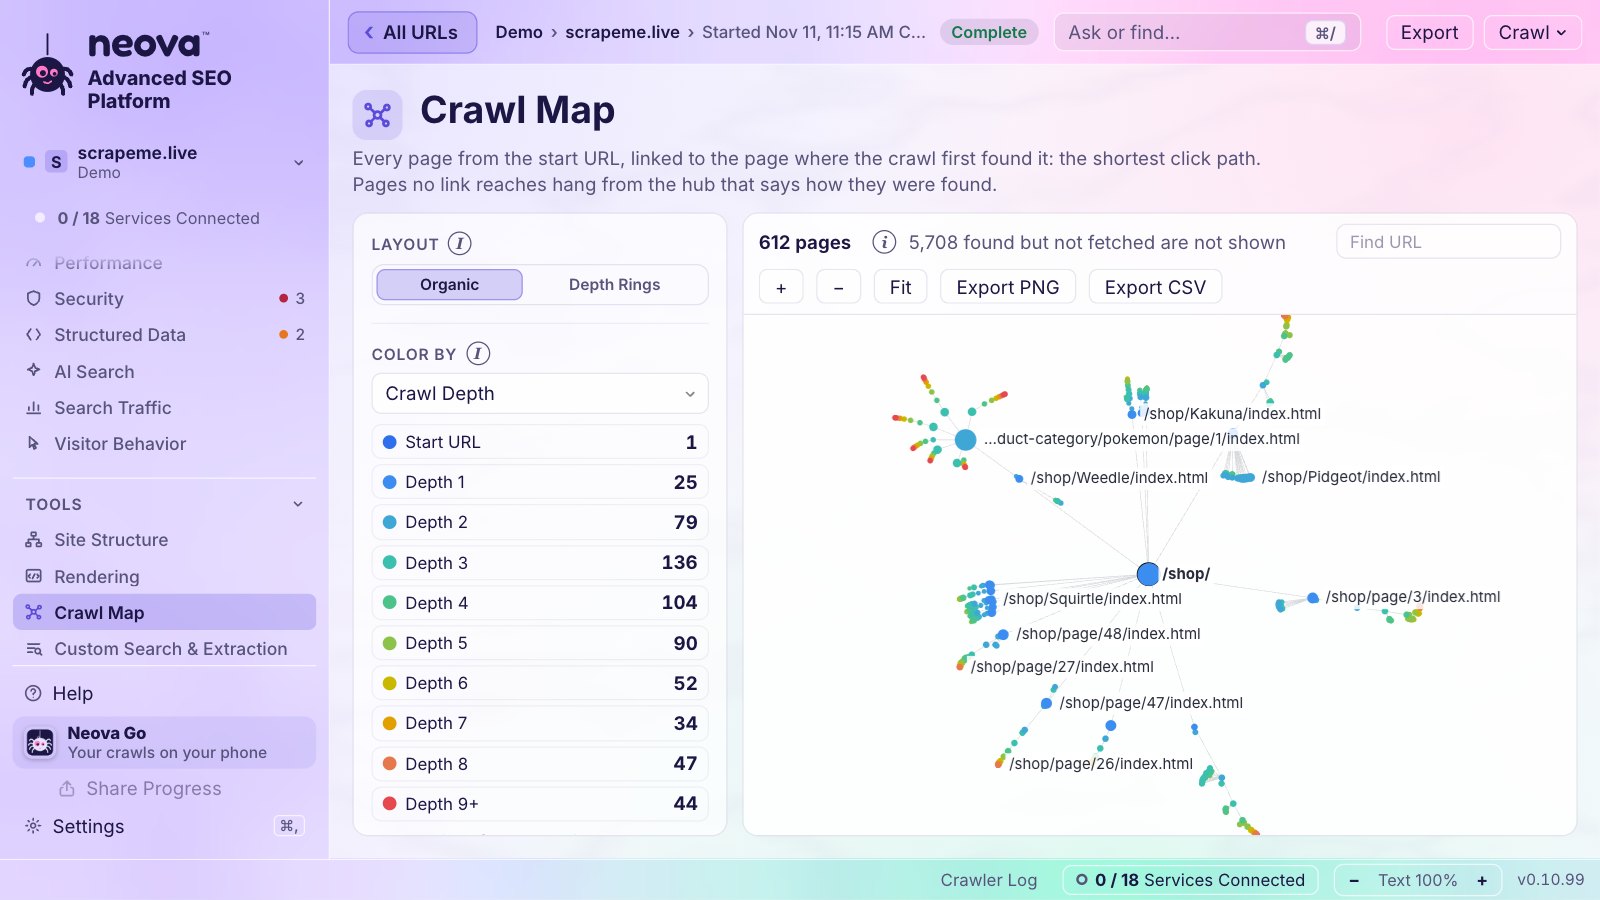
- 9. Belangrijke pagina's staan een paar klikken van de homepage. Pagina's diep in de structuur worden later gevonden en minder vaak gecrawld. Sorteer in een crawler indexeerbare pagina's op crawldiepte en kijk wat er op 4 of meer staat. Neova markeert indexeerbare pagina's vanaf diepte 4. Check: Indexeerbare URL zit op crawldiepte 4 of meer.
- 10. Geen weespagina's en geen pagina's die alleen via doodlopende wegen bereikt worden. Een weespagina is een indexeerbare pagina die geen interne link bereikt. Je vindt haar door de crawl te vergelijken met de sitemaps, de serverlog of Search Console. Zoek ook naar pagina's die alleen via een redirect, een canonical of nofollow-links bereikt worden. Checks: Wees-URL geeft 200 en is indexeerbaar, URL is alleen bereikbaar via een redirect.
- 11. Geen dubbele pagina's of URL-varianten die concurreren. Dezelfde pagina in twee hoofdlettervarianten, met en zonder slash aan het eind, of met parameters in een andere volgorde splitst signalen. Vergelijk in een crawler de HTML van URL-varianten, en groepeer dan pagina's met dubbele of bijna dubbele tekst en titles. Checks: URL-varianten geven dezelfde HTML, Bijna-duplicate content tussen HTML-pagina's.
Op een grote site bepalen dezelfde problemen waar bots hun bezoeken aan besteden; de gids crawlbudget behandelt die kant.
Rendering, snelheid en gestructureerde data
- 13. Titles, links en hoofdtekst staan in de ruwe HTML. Google rendert JavaScript, soms ruim na de crawl, en veel andere crawlers lezen alleen de HTML die de server stuurt. Render in een crawler een steekproef per template en vergelijk de gerenderde pagina met de ruwe HTML. Neova markeert elke pagina als Server-gerenderd, Gehydrateerd of Vereist JavaScript. Checks: Grootste deel van de hoofdtekst staat alleen in gerenderde HTML, Noindex-directive wordt door JavaScript verwijderd. De gids over de JavaScript SEO-crawler gaat dieper.
- 14. Serverrespons en Core Web Vitals zitten in het goede bereik. Goed betekent LCP 2,5 s of minder, INP 200 ms of minder en CLS 0,1 of minder. Draai in een crawler Lighthouse op één pagina per template, en lees het Chrome UX Report voor data van echte bezoekers. Neova doet allebei, het tweede met je eigen sleutel voor het Chrome UX Report. Checks: Reactietijd van de server is traag in labdata of velddata, CLS is hoger dan 0,1 in labdata of velddata.
- 15. Gestructureerde data is geldig en klopt met de pagina. Markup met syntaxfouten wordt genegeerd, en markup die niet met de pagina overeenkomt, is ook een probleem. Valideer in een crawler het schema op elke pagina en vergelijk het binnen elke template. Checks: Gestructureerde data bevat syntaxfouten, Gestructureerde data mist vereiste eigenschappen of wijkt af van de zichtbare tekst.
Zie voor de achtergrond Google over Core Web Vitals en de inleiding tot gestructureerde data.
Serverlogs en AI-crawlers
- 16. Logs tonen dat bots hun bezoeken aan de juiste URL's besteden, en AI-crawlers krijgen wat je ze wilt geven. Een crawl toont wat de site serveert. Een serverlog toont waar Googlebot, Bingbot en AI-crawlers echt om vroegen en wat ze terugkregen. Tel een verzoek alleen als Googlebot als het adres klopt; een user-agent-string is makkelijk te vervalsen. Zoek dan naar belangrijke pagina's die bots nooit bezoeken, en botbezoeken die op fouten landen. Controleer voor AI-crawlers wat robots.txt elk ervan laat ophalen, en wat de server ze echt geeft, want een firewall- of CDN-regel kan een crawler blokkeren die robots.txt toestaat. Checks: Aandeel 3xx-, 4xx- of 5xx-responsen voor zoekbots stijgt, Verzoek met de user agent van een AI-zoekcrawler wordt geblokkeerd.
In Neova komt de serverlog uit een logbestand van Apache of Nginx, of uit je eigen Cloudflare-account, en worden bots alleen geteld als hun adres op de lijst staat die elk bedrijf publiceert. De weergave Wat elke AI-assistent krijgt vraagt steekproefpagina's op als 10 AI-agents en toont wie volledige toegang krijgt. De gidsen loganalyse en AI-crawlers behandelen beide uitgebreid, en Google legt uit hoe je Googlebot verifieert.
Deze checklist op onze eigen sites
We draaien dezelfde lijst op onze eigen sites. Een volledige Neova-crawl van seoprocheck.com op 17 oktober 2026 haalde 10.222 URL's op in 61 minuten, waarvan 4.561 HTML-pagina's die 200 antwoordden, met 99,98% volledigheid. Wat hij meldde:
| Melding | Aantal |
|---|---|
| Meta description langer dan 155 tekens | 582 |
| Title langer dan 60 tekens | 557 |
| Dubbele title | 56 |
| Canonical naar een andere interne URL | 5 |
| Afbeelding zonder alt-tekst | 2 |
Onze SEO-ronde op neova.app op 20 november 2026 vond vijf dingen die de checklist dekt, allemaal dezelfde dag opgelost:
| Stap | Voor | Na |
|---|---|---|
| 7. http://-versie | 200 | 301 naar https |
| 5. Onbekend adres | 503 | 404 |
| 1. E-mailscript van Cloudflare | Geblokkeerd op 1.320 pagina's | Toegestaan |
| 1. Faviconbestanden | Achter Disallow: / | Toegestaan |
| Meta descriptions | Sommige langer dan 160 | 160 of minder, 1.354 pagina's |
Die van de favicon was zichtbaar in Google: met de bestanden geblokkeerd stond er een gewone letter naast neova.app in plaats van het logo. De 1.358 sitemap-URL's van de site in 15 talen haalden de hreflang-stap met elke retourlink op zijn plaats.
Heb je de lijst doorgewerkt, los dan op en crawl opnieuw. Oplossing verifiëren van Neova haalt alleen de URL's opnieuw op die een check markeerde en zegt hoeveel er opgelost zijn, en Crawls vergelijken toont wat er tussen twee crawls veranderde. Neova voert 694 checks uit; download Neova om ze op je site te draaien.

Vragen
Wat is een checklist voor een technische SEO-audit?
Een lijst van de dingen die bepalen of zoekmachines een site kunnen crawlen, renderen en indexeren, doorgewerkt in een vaste volgorde. Hem elke keer op dezelfde manier doorwerken, maakt van een audit een routine.
Wat zijn de stappen van een technische SEO-audit?
Crawl de site met de XML-sitemaps, en controleer dan crawlbaarheid, indexeerbaarheid, statuscodes en redirects, sitemaps, sitestructuur en duplicaten, internationale tags, rendering, snelheid en gestructureerde data, en ten slotte de serverlogs. Los eerst de problemen op die de meeste indexeerbare pagina's raken, en crawl dan opnieuw.
Hoe vaak moet ik een technische SEO-audit doen?
Een volledige audit een of twee keer per jaar, en een lichtere crawl na elke belangrijke release. Sites die vaak veranderen, hebben baat bij een wekelijkse geplande crawl die met de vorige wordt vergeleken.
Kan ik deze checklist met een gratis tool doorlopen?
Op een kleine site wel. Het Free-abonnement van Neova crawlt tot 1.000 URL's per crawl met elke check, JavaScript-rendering en Search Console. Serverlogs en snapshots van Core Web Vitals zitten in de betaalde abonnementen. Zie de gids over gratis SEO-crawlers voor andere opties.
Heb ik serverlogs nodig voor een technische SEO-audit?
Niet om te beginnen. Een crawl dekt het grootste deel van de checklist. Logs voegen toe wat bots echt deden, en dat telt het meest op grote sites en als pagina's traag geïndexeerd worden.