Checkliste für das technische SEO-Audit: 16 Schritte, die Sie mit einem Crawler prüfen
Eine praktische Checkliste für technisches SEO, in der Reihenfolge, in der wir eine Website durcharbeiten. Jeder Schritt sagt, was zu prüfen ist, wie Sie es in einem Crawler prüfen und welche Checks von Neova es melden.
Die Checkliste auf einen Blick
| # | Bereich | Bestanden, wenn |
|---|---|---|
| 1 | robots.txt | Antwortet mit 200, unter 500 KiB |
| 2 | Gesperrte Ressourcen | 0 CSS- oder JS-Dateien gesperrt |
| 3 | Noindex | Nur wo beabsichtigt |
| 4 | Canonicals | Ziel antwortet mit 200, indexierbar |
| 5 | Defekte Links | 0 interne 4xx oder 5xx |
| 6 | Weiterleitungen | 1 Sprung, 301 oder 308 |
| 7 | HTTPS | 1 Version antwortet mit 200 |
| 8 | XML-Sitemaps | Nur indexierbare 200-URLs |
| 9 | Klicktiefe | Wichtige Seiten bei 3 oder weniger |
| 10 | Verwaiste Seiten | 0 indexierbare |
| 11 | Duplikate | 1 URL pro Seite |
| 12 | hreflang | Jeder Rücklink vorhanden |
| 13 | Rendering | Haupttext im rohen HTML |
| 14 | Geschwindigkeit | LCP 2,5 s, INP 200 ms, CLS 0,1 |
| 15 | Strukturierte Daten | 0 Syntaxfehler |
| 16 | Logs und KI-Bots | Wichtige Seiten besucht, 0 Sperren |
Die Reihenfolge zählt. Eine Seite, die nicht gecrawlt werden kann, wird nicht indexiert, und bei einer Seite, die nicht indexiert ist, muss das Schema noch nicht korrigiert werden. Arbeiten Sie von oben nach unten.
Vor dem Start: Den Audit-Crawl einrichten
- Crawlen Sie die ganze Website oder eine Stichprobe pro Template. Auf einer großen Website findet eine Stichprobe pro Seitengruppe die meisten Muster in Minuten.
- Schalten Sie XML-Sitemaps ein. Seiten, die die Sitemaps auflisten, aber kein Link erreicht, finden Sie nur so.
- Rendern Sie eine Stichprobe mit JavaScript, wenn die Website ein JavaScript-Framework nutzt, damit Schritt 13 Daten hat.
- Verbinden Sie die Google Search Console. Klicks und Googles eigenes Urteil zur Indexierung zeigen, welche Ergebnisse Seiten betreffen, die zählen.
- Halten Sie die Geschwindigkeit höflich, außer die Website gehört Ihnen.
Wenn Sie noch nie einen Crawl durchgeführt haben, behandelt der Ratgeber Website crawlen die Einrichtung und der Ratgeber Technischer SEO Crawler das Lesen der Ergebnisse. Für ein ausführlicheres Rahmenwerk mit den Begründungen hinter jedem Bereich siehe die Checkliste für das technische SEO-Audit auf SEO ProCheck.
Crawlbarkeit: robots.txt und gesperrte Ressourcen
- 1. Die robots.txt antwortet, lässt sich parsen und sperrt nur, was sie soll. Rufen Sie sie ab, lesen Sie jede Regel und gleichen Sie die Regeln mit den gecrawlten URLs ab. Google liest die ersten 500 KiB der Datei und ignoriert den Rest. Suchen Sie in einem Crawler nach internen URLs, die per robots.txt gesperrt sind, und entscheiden Sie Muster für Muster, ob die Sperre gewollt ist. Der robots.txt-Tester von Neova erklärt jede Zeile in einfachen Worten, so wie Google sie dokumentiert, mit den gecrawlten URLs, auf die jede Regel zutrifft, und kann einen Entwurf testen, bevor er live geht. Checks: robots.txt ist nicht erreichbar oder zu groß, Interne URL ist per robots.txt gesperrt.
- 2. Seiten können die Skripte, Styles und Bilder nutzen, die sie brauchen. Sperrt die robots.txt eine JavaScript- oder CSS-Datei, rendern Suchmaschinen die Seite ohne sie. Crawlen Sie in einem Crawler auch die Ressourcen und listen Sie dann Seiten auf, die eine gesperrte Datei nutzen. Check: HTML-Seite nutzt eine per robots.txt gesperrte JavaScript-Datei.
Googles robots.txt-Spezifikation nennt die Grenze von 500 KiB und wie jeder Statuscode der Datei gelesen wird.
Indexierbarkeit: Noindex und Canonicals
- 3. Indexierbare Seiten tragen kein verirrtes noindex. Ein vom Staging übrig gebliebenes noindex ist einer der häufigsten Gründe, warum eine Seite herausfällt. Prüfen Sie den Meta-Robots-Tag und den X-Robots-Tag-Header und stellen Sie sicher, dass sie übereinstimmen. Lesen Sie in einem Crawler die Liste der noindex-Seiten: Jede sollte absichtlich dort stehen. Checks: Noindex-Anweisung ist vorhanden, Noindex unterscheidet sich zwischen HTML und HTTP-Header.
- 4. Canonicals zeigen auf indexierbare URLs, die mit 200 antworten. Ein Canonical ist ein Hinweis, und einen Hinweis, der auf eine Weiterleitung, einen Fehler oder eine noindex-Seite zeigt, ignorieren Suchmaschinen gern. Schauen Sie sich in einem Crawler die Spalte Canonical neben dem Status ihres Ziels an. Mit verbundener Search Console suchen Sie außerdem nach Seiten, bei denen Google ein anderes Canonical gewählt hat. Checks: Canonical zeigt auf eine weiterleitende URL, Google hat ein anderes Canonical als das angegebene gewählt.
Googles Leitfaden zum Zusammenfassen doppelter URLs erklärt, wie Canonicals gewichtet werden.
Statuscodes, Weiterleitungen und HTTPS
- 5. Keine internen Links auf 4xx- oder 5xx-URLs und keine Soft 404. Defekte interne Links verschwenden Crawls und kosten Besucher. Ein Soft 404 ist schwerer zu finden: eine Seite, die „nicht gefunden“ sagt, aber mit 200 antwortet. Sortieren Sie in einem Crawler nach Statuscode und öffnen Sie dann die Inlinks jedes Fehlers, um die zu korrigierenden Links zu finden. Für Soft 404 durchsuchen Sie Titles und H1 nach Formulierungen wie „nicht gefunden“. Checks: Interne URL liefert 4xx, 5xx oder keine Antwort, Title oder H1 enthält eine Soft-404-Formulierung.
- 6. Keine Weiterleitungsketten, Schleifen oder temporären Weiterleitungen zwischen internen URLs. Jeder Sprung kostet Zeit, der Googlebot folgt höchstens 10, und eine Kette, die auf einem Fehler endet, lässt die Seite ganz fallen. Listen Sie in einem Crawler jede Weiterleitung mit ihren Sprüngen und ihrem Endstatus auf und lassen Sie dann die internen Links auf die endgültige URL zeigen. Checks: Interne URL steckt in einer Weiterleitungskette, Interne URL nutzt eine temporäre Weiterleitung.
- 7. Eine Version der Website antwortet mit 200, über HTTPS. http und https, mit und ohne www: Drei der vier sollten auf die vierte weiterleiten. Die Start-URL-Prüfung von Neova liest die Website vor dem Crawl und sagt, was jede Version tut. Check: Start-URL wird über HTTP ohne Weiterleitung auf HTTPS ausgeliefert.
Googles Seite zu Weiterleitungen und der Google Suche erklärt, welche Weiterleitungen Sie nutzen sollten, und das FAQ zu Weiterleitungen und HTTP-Statuscodes auf SEO ProCheck beantwortet die häufigen Fragen.
XML-Sitemaps und hreflang
- 8. XML-Sitemaps listen jede indexierbare Seite und sonst nichts. Mit einer Sitemap sagt die Website den Suchmaschinen, welche URLs zählen. Eine Datei enthält höchstens 50.000 URLs und 50 MB unkomprimiert. Weiterleitungen, Fehler, noindex-Seiten und kanonisierte URLs darin senden widersprüchliche Signale, und indexierbare Seiten, die darin fehlen, werden leicht übersehen. Crawlen Sie in einem Crawler die Sitemaps nach den Links und vergleichen Sie dann beide Listen in beide Richtungen. Neova ruft die Seiten, die nur in den Sitemaps stehen, in einem eigenen Schritt ab und zählt sie getrennt. Checks: Indexierbare URL steht in keiner XML-Sitemap, Noindex-URL steht in einer XML-Sitemap, Weiterleitende URL steht in einer XML-Sitemap.
Format und Grenzen stehen in Googles Übersicht zu Sitemaps.
- 12. hreflang-Sets sind vollständig und zeigen auf die richtigen URLs. Jede Seite eines Sets sollte jede andere Version und sich selbst auflisten, jedes Ziel sollte den Link erwidern, und jedes Ziel sollte eine indexierbare URL sein, die mit 200 antwortet. Sprach- und Regionscodes müssen gültig sein. Lesen Sie in einem Crawler hreflang aus dem HTML-Head und dem HTTP-Link-Header und prüfen Sie dann Status und Rücklink jedes Ziels. Checks: Hreflang-Rücklink fehlt, Hreflang zeigt auf eine URL ohne 200.
Googles Leitfaden zu lokalisierten Versionen Ihrer Seiten enthält die Regeln und Beispiele.
Website-Struktur: Tiefe, verwaiste Seiten und Duplikate
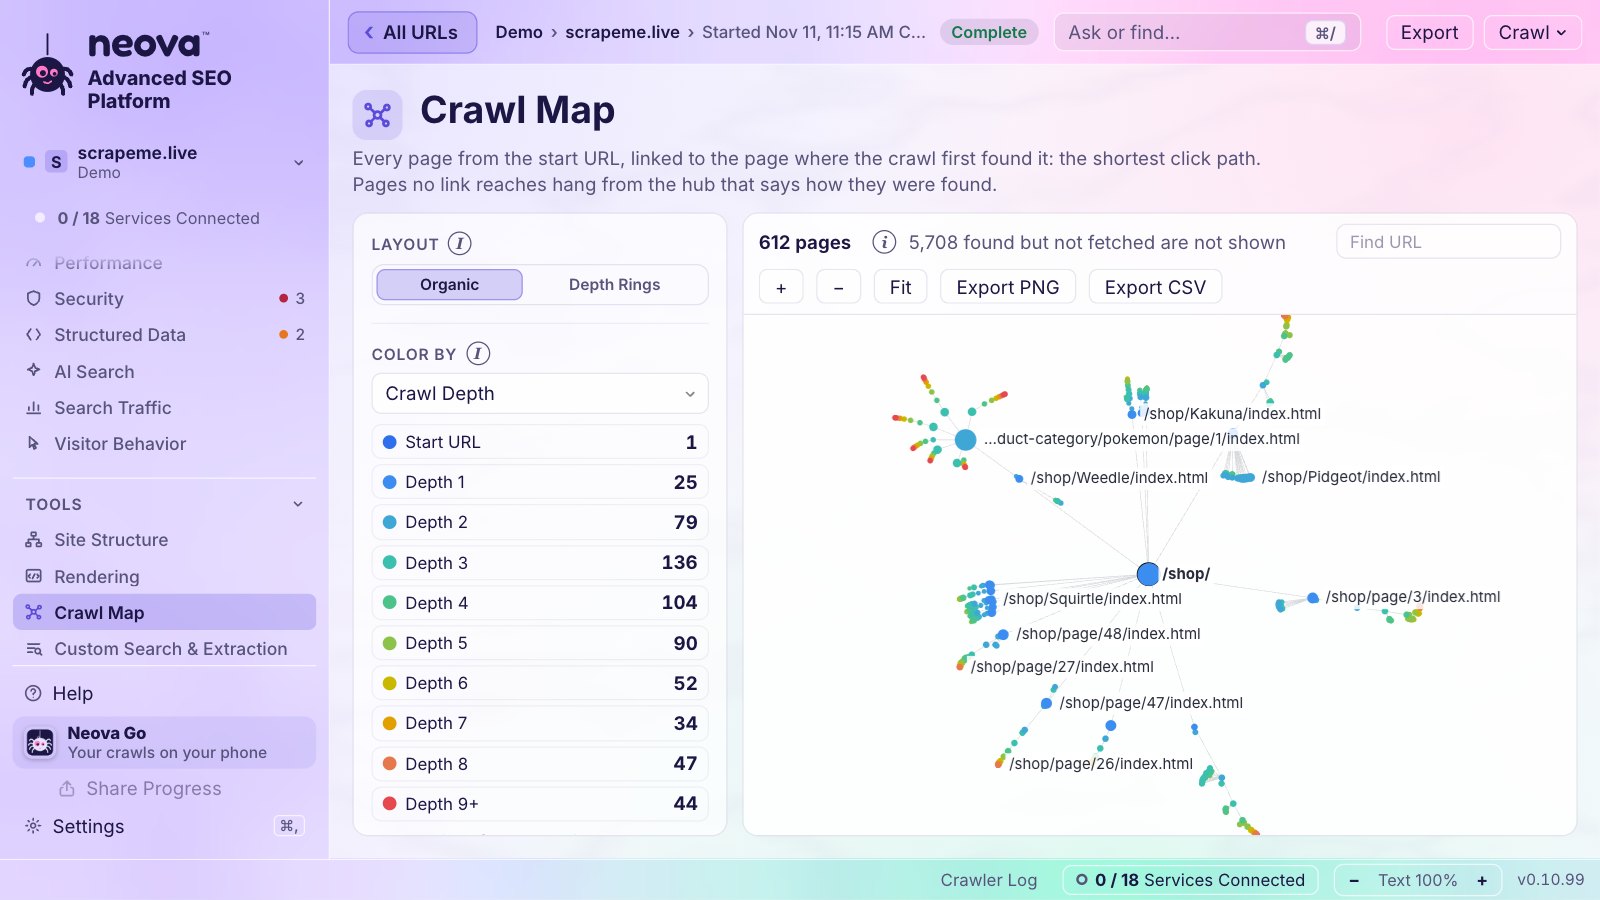
- 9. Wichtige Seiten liegen wenige Klicks von der Startseite entfernt. Seiten tief in der Struktur werden später gefunden und seltener gecrawlt. Sortieren Sie in einem Crawler indexierbare Seiten nach Crawl-Tiefe und sehen Sie sich an, was bei 4 oder mehr liegt. Neova meldet indexierbare Seiten ab Tiefe 4. Check: Indexierbare URL liegt auf Crawl-Tiefe 4 oder mehr.
- 10. Keine verwaisten Seiten und keine Seiten, die nur über Sackgassen erreichbar sind. Eine verwaiste Seite ist eine indexierbare Seite, die kein interner Link erreicht. Sie finden sie, indem Sie den Crawl mit den Sitemaps, dem Server-Log oder der Search Console vergleichen. Achten Sie auch auf Seiten, die nur über eine Weiterleitung, ein Canonical oder nofollow-Links erreicht werden. Checks: Verwaiste URL liefert 200 und ist indexierbar, URL ist nur über eine Weiterleitung erreichbar.
- 11. Keine doppelten Seiten oder URL-Varianten, die konkurrieren. Dieselbe Seite in zwei Schreibweisen, mit und ohne abschließenden Slash oder mit Parametern in anderer Reihenfolge teilt die Signale. Vergleichen Sie in einem Crawler das HTML der URL-Varianten und gruppieren Sie dann Seiten mit doppeltem oder fast doppeltem Text und Titles. Checks: URL-Varianten liefern dasselbe HTML, Fast doppelte Inhalte auf mehreren HTML-Seiten.
Auf einer großen Website entscheiden dieselben Probleme, wo Bots ihre Besuche verbringen; der Ratgeber Crawl-Budget behandelt diese Seite.
Rendering, Ladezeit und strukturierte Daten
- 13. Titles, Links und Haupttext stehen im rohen HTML. Google rendert JavaScript, manchmal lange nach dem Crawl, und viele andere Crawler lesen nur das HTML, das der Server schickt. Rendern Sie in einem Crawler eine Stichprobe pro Template und vergleichen Sie die gerenderte Seite mit dem rohen HTML. Neova markiert jede Seite als Serverseitig gerendert, Hydriert oder Braucht JavaScript. Checks: Der meiste Haupttext erscheint nur im gerenderten HTML, Noindex-Anweisung wird per JavaScript entfernt. Der Ratgeber JavaScript SEO Crawler geht tiefer.
- 14. Serverantwort und Core Web Vitals liegen im guten Bereich. Gut heißt LCP 2,5 s oder weniger, INP 200 ms oder weniger und CLS 0,1 oder weniger. Lassen Sie in einem Crawler Lighthouse auf einer Seite pro Template laufen und lesen Sie den Chrome UX Report für Daten echter Besucher. Neova macht beides, das Zweite mit Ihrem eigenen Chrome-UX-Report-Schlüssel. Checks: Serverantwortzeit ist in Labor- oder Felddaten langsam, CLS liegt in Labor- oder Felddaten über 0,1.
- 15. Strukturierte Daten sind gültig und passen zur Seite. Markup mit Syntaxfehlern wird ignoriert, und Markup, das der Seite widerspricht, ist ebenfalls ein Problem. Validieren Sie in einem Crawler das Schema auf jeder Seite und vergleichen Sie es innerhalb jedes Templates. Checks: Strukturierte Daten haben Syntaxfehler, Strukturierten Daten fehlen erforderliche Properties oder sie weichen vom sichtbaren Text ab.
Zum Hintergrund siehe Google zu Core Web Vitals und die Einführung in strukturierte Daten.
Server-Logs und KI-Crawler
- 16. Logs zeigen, dass Bots ihre Besuche auf die richtigen URLs verwenden und KI-Crawler bekommen, was sie bekommen sollen. Ein Crawl zeigt, was die Website ausliefert. Ein Server-Log zeigt, was Googlebot, Bingbot und KI-Crawler tatsächlich angefragt haben und was sie zurückbekamen. Zählen Sie eine Anfrage nur dann als Googlebot, wenn ihre Adresse geprüft ist; ein User-Agent-String ist leicht zu fälschen. Suchen Sie dann nach wichtigen Seiten, die Bots nie besuchen, und nach Bot-Besuchen, die auf Fehlern landen. Prüfen Sie bei KI-Crawlern, was die robots.txt jedem erlaubt und was der Server ihm wirklich ausliefert, denn eine Firewall- oder CDN-Regel kann einen Crawler sperren, den die robots.txt erlaubt. Checks: Anteil von 3xx-, 4xx- oder 5xx-Antworten an Suchbots steigt, Anfrage mit dem User Agent eines KI-Such-Crawlers wird blockiert.
In Neova kommt das Server-Log aus einer Apache- oder Nginx-Logdatei oder aus Ihrem eigenen Cloudflare-Konto und zählt Bots nur, wenn ihre Adresse auf der Liste steht, die das jeweilige Unternehmen veröffentlicht. Die Ansicht „Was jeder KI-Assistent ausgeliefert bekommt“ fragt Stichprobenseiten als 10 KI-Agenten ab und zeigt, wer vollen Zugriff erhält. Die Ratgeber Logfile-Analyse und KI-Crawler behandeln beides im Detail, und Google erklärt, wie Sie den Googlebot verifizieren.
Diese Checkliste auf unseren eigenen Websites
Wir gehen dieselbe Liste auf unseren eigenen Websites durch. Ein vollständiger Neova-Crawl von seoprocheck.com am 17. Oktober 2026 rief 10.222 URLs in 61 Minuten ab, davon 4.561 HTML-Seiten, die mit 200 antworteten, bei 99,98 % Vollständigkeit. Was er meldete:
| Meldung | Anzahl |
|---|---|
| Meta-Description über 155 Zeichen | 582 |
| Title über 60 Zeichen | 557 |
| Doppelter Title | 56 |
| Canonical auf eine andere interne URL | 5 |
| Bild ohne Alt-Text | 2 |
Unser SEO-Durchgang auf neova.app am 20. November 2026 fand fünf Dinge, die die Checkliste abdeckt, alle noch am selben Tag behoben:
| Schritt | Vorher | Nachher |
|---|---|---|
| 7. http://-Version | 200 | 301 auf https |
| 5. Unbekannte Adresse | 503 | 404 |
| 1. E-Mail-Skript von Cloudflare | Auf 1.320 Seiten gesperrt | Erlaubt |
| 1. Favicon-Dateien | Hinter Disallow: / | Erlaubt |
| Meta Descriptions | Einige über 160 | 160 oder weniger, 1.354 Seiten |
Das Favicon-Problem war in Google sichtbar: Mit gesperrten Dateien erschien neben neova.app ein einfacher Buchstabe statt des Logos. Die 1.358 Sitemap-URLs der Website in 15 Sprachen bestanden den hreflang-Schritt mit jedem Rücklink an seinem Platz.
Wenn Sie die Liste durchgearbeitet haben: beheben, dann erneut crawlen. „Behebung prüfen“ in Neova ruft nur die URLs erneut ab, die ein Check gemeldet hat, und sagt, wie viele behoben sind, und Crawls vergleichen zeigt, was sich zwischen zwei Crawls geändert hat. Neova führt 694 Checks aus; laden Sie Neova herunter, um sie auf Ihrer Website auszuführen.

Fragen
Was ist eine Checkliste für das technische SEO-Audit?
Eine Liste der Dinge, die entscheiden, ob Suchmaschinen eine Website crawlen, rendern und indexieren können, abgearbeitet in einer festen Reihenfolge. Wer sie jedes Mal gleich durchgeht, macht aus einem Audit eine Routine.
Was sind die Schritte eines technischen SEO-Audits?
Crawlen Sie die Website mit ihren XML-Sitemaps und prüfen Sie dann Crawlbarkeit, Indexierbarkeit, Statuscodes und Weiterleitungen, Sitemaps, Website-Struktur und Duplikate, internationale Tags, Rendering, Ladezeit und strukturierte Daten und zum Schluss die Server-Logs. Beheben Sie zuerst die Probleme, die die meisten indexierbaren Seiten betreffen, und crawlen Sie dann erneut.
Wie oft sollte ich ein technisches SEO-Audit durchführen?
Ein vollständiges Audit ein- oder zweimal im Jahr und ein leichterer Crawl nach jedem größeren Release. Websites, die sich oft ändern, profitieren von einem wöchentlich geplanten Crawl, der mit dem vorherigen verglichen wird.
Kann ich diese Checkliste mit einem kostenlosen Tool abarbeiten?
Bei einer kleinen Website ja. Der Free-Tarif von Neova crawlt bis zu 1.000 URLs pro Crawl mit jedem Check, JavaScript-Rendering und Search Console. Server-Logs und Core-Web-Vitals-Momentaufnahmen gibt es in den bezahlten Tarifen. Weitere Optionen finden Sie im Ratgeber zum kostenlosen SEO Crawler.
Brauche ich Server-Logs für ein technisches SEO-Audit?
Nicht für den Anfang. Ein Crawl deckt den Großteil der Checkliste ab. Logs ergänzen, was Bots tatsächlich getan haben, und das zählt vor allem auf großen Websites und wenn Seiten nur langsam indexiert werden.