Teknik SEO denetim kontrol listesi: bir crawler ile uygulayabileceğiniz 16 adım
Pratik bir teknik SEO kontrol listesi, bir sitede çalıştığımız sırayla. Her adım neyin kontrol edileceğini, bir crawler'da nasıl kontrol edileceğini ve hangi Neova kontrollerinin bunu işaretlediğini söyler.
Bir bakışta kontrol listesi
| # | Alan | Geçme koşulu |
|---|---|---|
| 1 | robots.txt | 200 döndürür, 500 KiB'ın altında |
| 2 | Engellenen kaynaklar | Engellenmiş 0 CSS ya da JS |
| 3 | Noindex | Yalnızca amaçlanan yerlerde |
| 4 | Canonical'lar | Hedef 200 döndürür, indekslenebilir |
| 5 | Kırık linkler | 0 iç 4xx ya da 5xx |
| 6 | Yönlendirmeler | 1 atlama, 301 ya da 308 |
| 7 | HTTPS | 1 sürüm 200 döndürür |
| 8 | XML site haritaları | Yalnızca dizine eklenebilir 200 URL'ler |
| 9 | Tıklama derinliği | Önemli sayfalar 3 ya da daha az |
| 10 | Yetim sayfalar | 0 indekslenebilir |
| 11 | Kopyalar | Sayfa başına 1 URL |
| 12 | hreflang | Her dönüş linki mevcut |
| 13 | Render | Ana metin ham HTML'de |
| 14 | Hız | LCP 2,5 sn, INP 200 ms, CLS 0,1 |
| 15 | Yapılandırılmış veri | 0 söz dizimi hatası |
| 16 | Loglar ve yapay zeka botları | Önemli sayfalar ziyaret edilmiş, 0 engelleme |
Sıra önemlidir. Taranamayan bir sayfa indekslenmez, indekslenmeyen bir sayfanın da schema'sının henüz düzeltilmesine gerek yoktur. Yukarıdan başlayın.
Başlamadan önce: denetim taramasını kurun
- Tüm siteyi ya da şablon başına bir örneklemi tarayın. Büyük bir sitede sayfa grubu başına bir örneklem, kalıpların çoğunu dakikalar içinde bulur.
- XML site haritalarını açın. Site haritalarının listelediği ama hiçbir linkin ulaşmadığı sayfalar yalnızca bu şekilde bulunur.
- JavaScript ile bir örneklemi render edin; site bir JavaScript framework'ü kullanıyorsa, 13. adım için veri olsun diye.
- Google Search Console'u bağlayın. Tıklamalar ve Google'ın kendi indeks kararı, hangi bulguların önemli sayfalara dokunduğunu söyler.
- Hızı nazik tutun; site size ait değilse.
Daha önce tarama yapmadıysanız bir web sitesi nasıl taranır rehberi kurulumu, teknik SEO crawler rehberi de sonuçların nasıl okunacağını anlatır. Her alanın arkasındaki gerekçeyle daha uzun bir çerçeve için SEO ProCheck'teki teknik SEO denetimi kontrol listesi çerçevesine bakın.
Taranabilirlik: robots.txt ve engellenen kaynaklar
- 1. robots.txt yanıt verir, ayrıştırılır ve yalnızca engellemesi gerekeni engeller. Dosyayı getirin, her kuralı okuyun ve kuralları taranan URL'lerle eşleştirin. Google dosyanın ilk 500 KiB'ını okur ve gerisini yok sayar. Bir crawler'da robots.txt ile engellenen iç URL'lere bakın ve her seferinde bir kalıp için bu engellemenin kasıtlı olup olmadığına karar verin. Neova'nın robots.txt test aracı her satırı Google'ın dokümante ettiği şekilde sade bir dille, her kuralın eşleştiği taranan URL'lerle birlikte açıklar ve bir taslağı yayına girmeden test edebilir. Kontroller: robots.txt'ye ulaşılamıyor ya da dosya çok büyük, İç URL robots.txt ile engellenmiş.
- 2. Sayfalar ihtiyaç duydukları betikleri, stilleri ve görselleri kullanabilir. robots.txt bir JavaScript ya da CSS dosyasını engellerse arama motorları sayfayı o dosya olmadan render eder. Bir crawler'da kaynakları da tarayın, ardından engellenmiş bir dosya kullanan sayfaları listeleyin. Kontrol: HTML sayfası robots.txt ile engellenmiş bir JavaScript dosyası kullanıyor.
Google'ın robots.txt spesifikasyonu 500 KiB sınırını ve dosyanın her durum kodunun nasıl okunduğunu içerir.
İndekslenebilirlik: noindex ve canonical'lar
- 3. İndekslenebilir sayfalarda başıboş bir noindex yok. Staging'den kalan bir noindex, bir sayfanın indeksten düşmesinin en yaygın nedenlerinden biridir. Meta robots etiketini ve X-Robots-Tag header'ını kontrol edin ve uyumlu olduklarından emin olun. Bir crawler'da noindex sayfalarının listesini okuyun: her biri orada kasıtlı olarak bulunmalıdır. Kontroller: Noindex direktifi var, Noindex, HTML ile HTTP üstbilgisi arasında farklı.
- 4. Canonical'lar 200 döndüren indekslenebilir URL'lere işaret eder. Canonical bir ipucudur ve bir yönlendirmeye, bir hataya ya da bir noindex sayfasına işaret eden ipucu, arama motorlarının genellikle yok saydığı türdendir. Bir crawler'da canonical sütununa hedefinin durumuyla birlikte bakın. Search Console bağlıysa Google'ın başka bir canonical seçtiği sayfalara da bakın. Kontroller: Canonical yönlendirilen bir URL'ye işaret ediyor, Google bildirilenden farklı bir canonical seçti.
Google'ın kopya URL'leri birleştirme rehberi canonical'ların nasıl tartıldığını açıklar.
Durum kodları, yönlendirmeler ve HTTPS
- 5. 4xx ya da 5xx URL'lere iç link yok, soft 404 yok. Kırık iç linkler taramayı boşa harcar ve ziyaretçi kaybettirir. Soft 404'ü bulmak daha zordur: bulunamadı diyen ama 200 döndüren bir sayfa. Bir crawler'da durum koduna göre sıralayın, ardından düzeltilecek linkleri bulmak için her hatanın gelen linklerini açın. Soft 404'ler için title'larda ve H1'lerde bulunamadı ifadelerini arayın. Kontroller: İç URL 4xx, 5xx döndürüyor ya da yanıt vermiyor, Title veya H1 bir soft 404 ifadesi taşıyor.
- 6. İç URL'ler arasında yönlendirme zinciri, döngü ya da geçici yönlendirme yok. Her atlama zaman kaybettirir, Googlebot en fazla 10 atlamayı izler ve bir hatayla biten zincir sayfayı tamamen düşürür. Bir crawler'da her yönlendirmeyi atlamaları ve nihai durumuyla listeleyin, ardından iç linkleri nihai URL'ye işaret edecek şekilde güncelleyin. Kontroller: İç URL bir yönlendirme zincirinde, İç URL geçici yönlendirme kullanıyor.
- 7. Sitenin tek bir sürümü HTTPS üzerinden 200 döndürür. http ve https, www'lu ve www'suz: dördünden üçü dördüncüye yönlendirmelidir. Neova'nın Başlangıç URL'si kontrolü tarama başlamadan önce siteyi okur ve her sürümün ne yaptığını söyler. Kontrol: Başlangıç URL'si HTTPS'ye yönlendirme olmadan HTTP üzerinden sunuluyor.
Google'ın yönlendirmeler ve Google Arama sayfası hangi yönlendirmelerin kullanılacağını anlatır, SEO ProCheck'teki yönlendirmeler ve HTTP durum kodları SSS sayfası da sık sorulan soruları yanıtlar.
XML site haritaları ve hreflang
- 8. XML site haritaları her indekslenebilir sayfayı listeler, başka hiçbir şeyi değil. Site haritası, sitenin arama motorlarına hangi URL'lerin önemli olduğunu söylemesidir. Bir dosya en fazla 50.000 URL ve sıkıştırılmamış 50 MB tutar. İçindeki yönlendirmeler, hatalar, noindex sayfaları ve canonical ile başka yere bağlanmış URL'ler karışık sinyaller gönderir, içinde bulunmayan indekslenebilir sayfalar da kolayca gözden kaçar. Bir crawler'da site haritalarını linklerden sonra tarayın, ardından iki listeyi iki yönde karşılaştırın. Neova yalnızca site haritalarının listelediği sayfaları ayrı bir adımda getirir ve ayrı sayar. Kontroller: İndekslenebilir URL hiçbir XML site haritasında yok, noindex içeren URL bir XML site haritasında listeleniyor, Yönlendiren URL bir XML site haritasında listeleniyor.
Format ve sınırlar için Google'ın site haritalarına genel bakış sayfasına bakın.
- 12. hreflang kümeleri eksiksizdir ve doğru URL'lere işaret eder. Bir kümedeki her sayfa diğer tüm sürümleri ve kendisini listelemeli, her hedef linki geri vermeli ve her hedef 200 döndüren indekslenebilir bir URL olmalıdır. Dil ve bölge kodları geçerli olmalıdır. Bir crawler'da hreflang'i HTML head'den ve HTTP Link header'ından okuyun, ardından her hedefin durumunu ve dönüş linkini kontrol edin. Kontroller: hreflang dönüş linki eksik, hreflang 200 dışında yanıt veren bir URL'ye işaret ediyor.
Google'ın sayfalarınızın yerelleştirilmiş sürümleri rehberi kuralları ve örnekleri içerir.
Site yapısı: derinlik, yetim sayfalar ve kopyalar
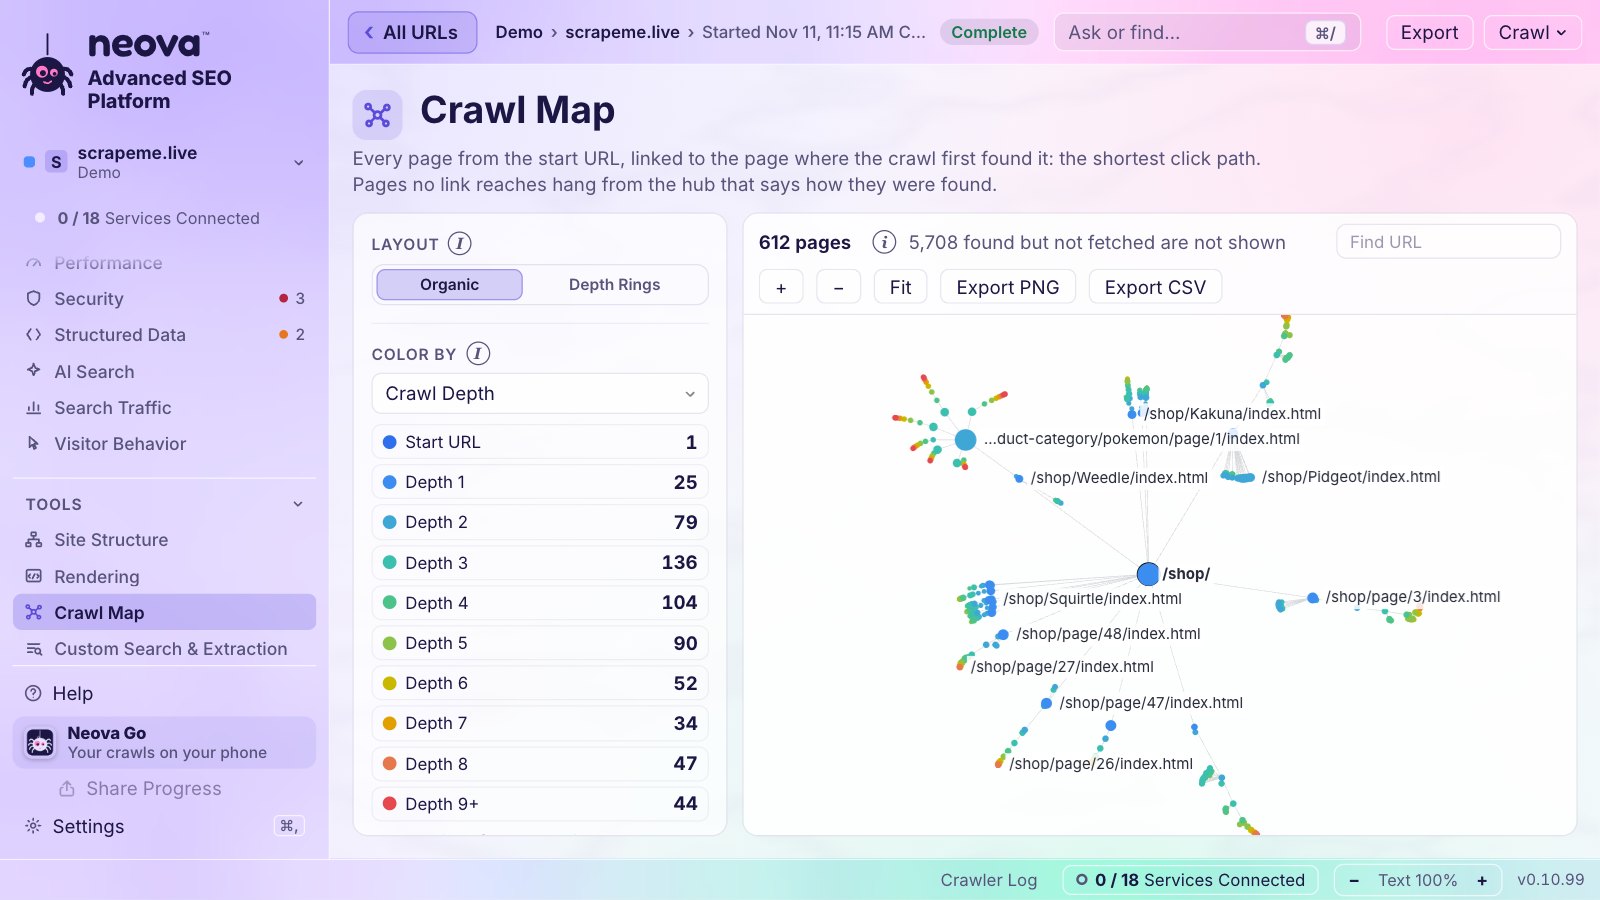
- 9. Önemli sayfalar ana sayfadan birkaç tıklama uzaklıkta durur. Yapının derinlerindeki sayfalar daha geç bulunur ve daha seyrek taranır. Bir crawler'da indekslenebilir sayfaları tarama derinliğine göre sıralayın ve 4 ya da daha derinde olanlara bakın. Neova indekslenebilir sayfaları 4. derinlikten itibaren işaretler. Kontrol: İndekslenebilir URL 4 veya daha fazla tarama derinliğinde.
- 10. Yetim sayfa ve yalnızca çıkmaz yollardan ulaşılan sayfa yok. Yetim sayfa, hiçbir iç linkin ulaşmadığı indekslenebilir bir sayfadır. Onu taramayı site haritalarıyla, sunucu loguyla ya da Search Console ile karşılaştırarak bulursunuz. Yalnızca bir yönlendirme, bir canonical ya da nofollow linkler üzerinden ulaşılan sayfalara da bakın. Kontroller: Yetim URL 200 döndürüyor ve indekslenebilir, URL'ye yalnızca bir yönlendirme üzerinden ulaşılabiliyor.
- 11. Birbiriyle yarışan kopya sayfa ya da URL varyantı yok. Aynı sayfanın iki farklı harf büyüklüğüyle, sonda eğik çizgili ve çizgisiz ya da farklı sırada parametrelerle bulunması sinyalleri böler. Bir crawler'da URL varyantlarının HTML'ini karşılaştırın, ardından kopya ya da neredeyse kopya metin ve title'lara sahip sayfaları gruplayın. Kontroller: URL varyantları aynı HTML'i döndürüyor, HTML sayfaları arasında neredeyse kopya içerik.
Büyük bir sitede botların ziyaretlerini nereye harcadığını da aynı sorunlar belirler; tarama bütçesi rehberi bu tarafı ele alır.
Render, hız ve yapılandırılmış veri
- 13. Title'lar, linkler ve ana metin ham HTML'de bulunur. Google JavaScript'i render eder, bazen taramadan epey sonra; diğer birçok crawler ise yalnızca sunucunun gönderdiği HTML'i okur. Bir crawler'da şablon başına bir örneklemi render edin ve render edilmiş sayfayı ham HTML ile karşılaştırın. Neova her sayfayı Sunucuda oluşturulmuş, Hidratlanmış ya da JavaScript gerektirir olarak işaretler. Kontroller: Ana metnin çoğu yalnızca oluşturulmuş HTML'de görünüyor, Noindex direktifi JavaScript tarafından kaldırılıyor. JavaScript SEO crawler rehberi daha derine iner.
- 14. Sunucu yanıtı ve Core Web Vitals iyi aralıktadır. İyi demek LCP'nin 2,5 sn ya da daha az, INP'nin 200 ms ya da daha az ve CLS'nin 0,1 ya da daha az olması demektir. Bir crawler'da şablon başına bir sayfada Lighthouse çalıştırın ve gerçek ziyaretçi verileri için Chrome UX Report'u okuyun. Neova ikisini de yapar, ikincisini kendi Chrome UX Report anahtarınızla. Kontroller: Sunucu yanıt süresi laboratuvar ya da saha verilerinde yavaş, CLS laboratuvar veya saha verilerinde 0,1'in üzerinde.
- 15. Yapılandırılmış veri geçerlidir ve sayfayla eşleşir. Söz dizimi hatası olan işaretleme yok sayılır; sayfayla çelişen işaretleme de bir sorundur. Bir crawler'da schema'yı her sayfada doğrulayın ve her şablon içinde karşılaştırın. Kontroller: Yapılandırılmış veride söz dizimi hataları var, Yapılandırılmış veride zorunlu özellikler eksik ya da veri görünür metinden farklı.
Arka plan için Google'ın Core Web Vitals sayfasına ve yapılandırılmış veriye giriş sayfasına bakın.
Sunucu logları ve yapay zeka crawler'ları
- 16. Loglar botların ziyaretlerini doğru URL'lere harcadığını, yapay zeka crawler'larının da almalarını istediğiniz şeyi aldığını gösterir. Bir tarama sitenin ne sunduğunu gösterir. Bir sunucu logu ise Googlebot'un, Bingbot'un ve yapay zeka crawler'larının gerçekte ne istediğini ve ne aldığını gösterir. Bir isteği yalnızca adresi doğrulandığında Googlebot olarak sayın; user agent dizesini taklit etmek kolaydır. Ardından botların hiç ziyaret etmediği önemli sayfaları ve hatalara düşen bot ziyaretlerini arayın. Yapay zeka crawler'ları için robots.txt'nin her birine neyi getirme izni verdiğini ve sunucunun ona gerçekte ne verdiğini kontrol edin; çünkü bir güvenlik duvarı ya da CDN kuralı, robots.txt'nin izin verdiği bir crawler'ı engelleyebilir. Kontroller: Arama botlarına verilen 3xx, 4xx veya 5xx yanıtlarının payı artıyor, Yapay zeka arama botu user agent'ıyla yapılan istek engelleniyor.
Neova'da sunucu logu bir Apache ya da Nginx log dosyasından veya kendi Cloudflare hesabınızdan gelir ve botları yalnızca adresleri her şirketin yayımladığı listede olduğunda sayar. Her yapay zeka asistanına ne sunuluyor görünümü, örneklenen sayfaları 10 yapay zeka ajanı olarak ister ve kimin tam erişim aldığını gösterir. Log analizi ve yapay zeka crawler'ları rehberleri ikisini de ayrıntılı ele alır; Google da Googlebot'un nasıl doğrulanacağını açıklar.
Bu kontrol listesi kendi sitelerimizde
Aynı listeyi kendi sitelerimizde çalıştırıyoruz. seoprocheck.com'un 17 Ekim 2026'daki tam Neova taraması 61 dakikada 10.222 URL getirdi; bunların 4.561'i 200 döndüren HTML sayfalarıydı ve tamlık %99,98'di. İşaretledikleri:
| İşaret | Sayı |
|---|---|
| Meta description 155 karakteri aşıyor | 582 |
| Title 60 karakteri aşıyor | 557 |
| Kopya title | 56 |
| Canonical başka bir iç URL'ye | 5 |
| Alt metni olmayan görsel | 2 |
20 Kasım 2026'da neova.app üzerindeki SEO geçişimiz, kontrol listesinin kapsadığı beş şey buldu; hepsi aynı gün düzeltildi:
| Adım | Önce | Sonra |
|---|---|---|
| 7. http:// sürümü | 200 | https'e 301 |
| 5. Bilinmeyen adres | 503 | 404 |
| 1. Cloudflare e-posta betiği | 1.320 sayfada engellenmiş | İzinli |
| 1. Favicon dosyaları | Disallow: / arkasında | İzinli |
| Meta description'lar | Bazıları 160'ın üzerinde | 160 ya da daha az, 1.354 sayfa |
Favicon sorunu Google'da görünüyordu: dosyalar engelliyken neova.app'in yanında logo yerine düz bir harf görünüyordu. Sitenin 15 dildeki 1.358 site haritası URL'si, her dönüş linki yerinde olarak hreflang adımını geçti.
Listeyi bitirdiğinizde düzeltin, sonra yeniden tarayın. Neova'nın Düzeltmeyi doğrula özelliği yalnızca bir kontrolün işaretlediği URL'leri yeniden getirir ve kaç tanesinin düzeltildiğini söyler; Taramaları karşılaştır da iki tarama arasında neyin değiştiğini gösterir. Neova 694 kontrol çalıştırır; bunları sitenizde çalıştırmak için Neova'yı indirin.

Sorular
Teknik SEO denetimi kontrol listesi nedir?
Arama motorlarının bir siteyi tarayıp render edip indeksleyip indeksleyemeyeceğini belirleyen şeylerin, sabit bir sırayla işlenen listesi. Her seferinde aynı şekilde ilerlemek, bir denetimi rutine dönüştürür.
Teknik SEO denetiminin adımları nelerdir?
Siteyi XML site haritalarıyla birlikte tarayın, ardından taranabilirliği, indekslenebilirliği, durum kodlarını ve yönlendirmeleri, site haritalarını, site yapısını ve kopyaları, uluslararası etiketleri, render'ı, hızı ve yapılandırılmış veriyi, son olarak da sunucu loglarını kontrol edin. Önce en çok indekslenebilir sayfaya dokunan sorunları düzeltin, sonra yeniden tarayın.
Teknik SEO denetimini ne sıklıkla yapmalıyım?
Yılda bir ya da iki kez tam bir denetim, her önemli sürümden sonra da daha hafif bir tarama. Sık değişen siteler, bir öncekiyle karşılaştırılan haftalık zamanlanmış bir taramadan fayda görür.
Bu kontrol listesini ücretsiz bir araçla uygulayabilir miyim?
Küçük bir sitede evet. Neova'nın Free planı her kontrol, JavaScript render ve Search Console ile tarama başına 1.000 URL'ye kadar tarar. Sunucu logları ve Core Web Vitals anlık görüntüleri ücretli planlarla gelir. Diğer seçenekler için ücretsiz SEO crawler rehberine bakın.
Teknik SEO denetimi için sunucu loglarına ihtiyacım var mı?
Başlamak için hayır. Bir tarama kontrol listesinin çoğunu karşılar. Loglar botların gerçekte ne yaptığını ekler; bu en çok büyük sitelerde ve sayfalar geç indekslendiğinde önemlidir.