技术 SEO 诊断清单:用爬虫就能完成的 16 个步骤
一份实用的技术 SEO 清单,按我们检查网站的顺序排列。每一步都说明要检查什么、如何在爬虫中检查,以及哪些 Neova 检查项会标记它。
清单一览
| # | 领域 | 通过标准 |
|---|---|---|
| 1 | robots.txt | 返回 200,小于 500 KiB |
| 2 | 被屏蔽的资源 | 0 个 CSS 或 JS 被禁止 |
| 3 | Noindex | 只在有意设置的地方 |
| 4 | canonical | 目标返回 200,且可索引 |
| 5 | 死链 | 0 个内部 4xx 或 5xx |
| 6 | 重定向 | 1 跳,301 或 308 |
| 7 | HTTPS | 只有 1 个版本返回 200 |
| 8 | XML 站点地图 | 只放可索引的 200 URL |
| 9 | 点击深度 | 关键页面不超过 3 |
| 10 | 孤立页面 | 0 个可索引 |
| 11 | 重复项 | 每个页面 1 个 URL |
| 12 | hreflang | 所有返回链接都存在 |
| 13 | 渲染 | 正文在原始 HTML 中 |
| 14 | 速度 | LCP 2.5 秒、INP 200 毫秒、CLS 0.1 |
| 15 | 结构化数据 | 0 个语法错误 |
| 16 | 日志与 AI 爬虫 | 关键页面有访问,0 个屏蔽 |
顺序很重要。无法抓取的页面不会被索引,未被索引的页面暂时也不需要修 Schema。从上往下做。
开始之前:设置诊断抓取
- 抓取整个网站,或每个模板抽样。在大型网站上,每个页面组抽样几分钟就能发现大部分规律。
- 开启 XML 站点地图。站点地图列出但没有链接到达的页面,只能这样找到。
- 如果网站使用 JavaScript 框架,用 JavaScript 渲染一部分样本,这样第 13 步才有数据。
- 连接 Google Search Console。点击数据和 Google 自己的索引判定能告诉您哪些发现涉及重要页面。
- 保持礼貌的速度,除非网站是您自己的。
如果您以前没有运行过抓取,如何抓取网站指南介绍了设置方法,技术 SEO 爬虫指南介绍了如何解读结果。如需更详细的框架以及每个方面背后的道理,请参阅 SEO ProCheck 上的技术 SEO 诊断清单框架。
可抓取性:robots.txt 与被屏蔽的资源
- 1. robots.txt 能访问、能解析,且只屏蔽该屏蔽的内容。获取它,读懂每条规则,并把规则与抓取到的 URL 对照。Google 读取该文件的前 500 KiB,其余部分忽略。在爬虫中,查找被 robots.txt 屏蔽的内部 URL,并逐个模式判断这种屏蔽是否是有意的。Neova 的 robots.txt 测试工具会按 Google 文档的说明,用通俗的话解释每一行,列出每条规则匹配到的已抓取 URL,还能在草稿上线前测试它。检查项:robots.txt 无法访问或过大、内部 URL 被 robots.txt 禁止抓取。
- 2. 页面能使用所需的脚本、样式和图片。如果 robots.txt 屏蔽了某个 JavaScript 或 CSS 文件,搜索引擎渲染页面时就不会用到它。在爬虫中,同时抓取这些资源,然后列出使用了被禁止文件的页面。检查项:HTML 页面使用了被 robots.txt 禁止抓取的 JavaScript 文件。
Google 的 robots.txt 规范写明了 500 KiB 的限制,以及该文件的各个状态码如何解读。
可索引性:noindex 与 canonical
- 3. 可索引页面没有多余的 noindex。从预发布环境遗留下来的 noindex 是页面掉出索引最常见的原因之一。检查 meta robots 标签和 X-Robots-Tag 响应头,确保两者一致。在爬虫中,阅读 noindex 页面列表:每一个都应该是有意为之。检查项:存在 noindex 指令、HTML 与 HTTP 响应头中的 noindex 不同。
- 4. canonical 指向返回 200 的可索引 URL。canonical 只是一种提示,指向重定向、错误或 noindex 页面的提示往往会被搜索引擎忽略。在爬虫中,把 canonical 列与其目标的状态放在一起看。连接 Search Console 后,还要查找 Google 选择了其他 canonical 的页面。检查项:canonical 指向发生重定向的 URL、Google 选择的 canonical 与声明的不同。
Google 关于整合重复网址的指南解释了 canonical 是如何被权衡的。
状态码、重定向与 HTTPS
- 5. 没有指向 4xx 或 5xx URL 的内部链接,也没有软 404。失效的内部链接会浪费抓取并流失访问者。软 404 更难发现:页面写着“未找到”,却返回 200。在爬虫中,按状态码排序,然后打开每个错误的入链,找到需要修改的链接。对于软 404,在 title 和 H1 中搜索“未找到”类用语。检查项:内部 URL 返回 4xx、5xx 或没有响应、title 或 H1 含有软 404 用语。
- 6. 内部 URL 之间没有重定向链、循环或临时重定向。每一跳都耗费时间,Googlebot 最多跟随 10 跳,而以错误结尾的重定向链会让页面彻底丢失。在爬虫中,列出每个重定向及其跳数和最终状态,然后更新内部链接,让它们直接指向最终 URL。检查项:内部 URL 位于重定向链中、内部 URL 使用了临时重定向。
- 7. 网站只有一个版本通过 HTTPS 返回 200。http 和 https,带 www 和不带 www:四个版本中有三个应重定向到第四个。Neova 的起始 URL 检查会在抓取开始前读取网站,并说明每个版本的情况。检查项:起始 URL 通过 HTTP 提供,且没有重定向到 HTTPS。
Google 关于重定向与 Google 搜索的页面介绍了该用哪种重定向,SEO ProCheck 上的重定向与 HTTP 状态码常见问题解答了常见疑问。
XML 站点地图与 hreflang
- 8. XML 站点地图列出每个可索引页面,且只列出这些页面。站点地图是网站在告诉搜索引擎哪些 URL 重要。一个文件最多包含 50,000 个 URL,未压缩时最大 50 MB。其中的重定向、错误、noindex 页面和已 canonical 到其他 URL 的页面会传递混乱的信号,而缺失的可索引页面很容易被忽视。在爬虫中,先抓取链接再抓取站点地图,然后双向对比两份列表。Neova 会把只有站点地图列出的页面作为单独一步获取,并分开计数。检查项:可索引 URL 不在任何 XML 站点地图中、XML 站点地图中列出了 noindex URL、XML 站点地图中列出了发生重定向的 URL。
格式和限制请参阅 Google 的站点地图概览。
- 12. hreflang 组完整,并指向正确的 URL。组内每个页面都应列出所有其他版本和它自己,每个目标都应返回链接,并且每个目标都应是返回 200 的可索引 URL。语言和地区代码必须有效。在爬虫中,从 HTML head 和 HTTP Link 响应头读取 hreflang,然后检查每个目标的状态及其返回链接。检查项:缺少 hreflang 返回链接、hreflang 指向非 200 的 URL。
Google 关于网页的本地化版本的指南给出了规则和示例。
网站结构:深度、孤立页面与重复内容
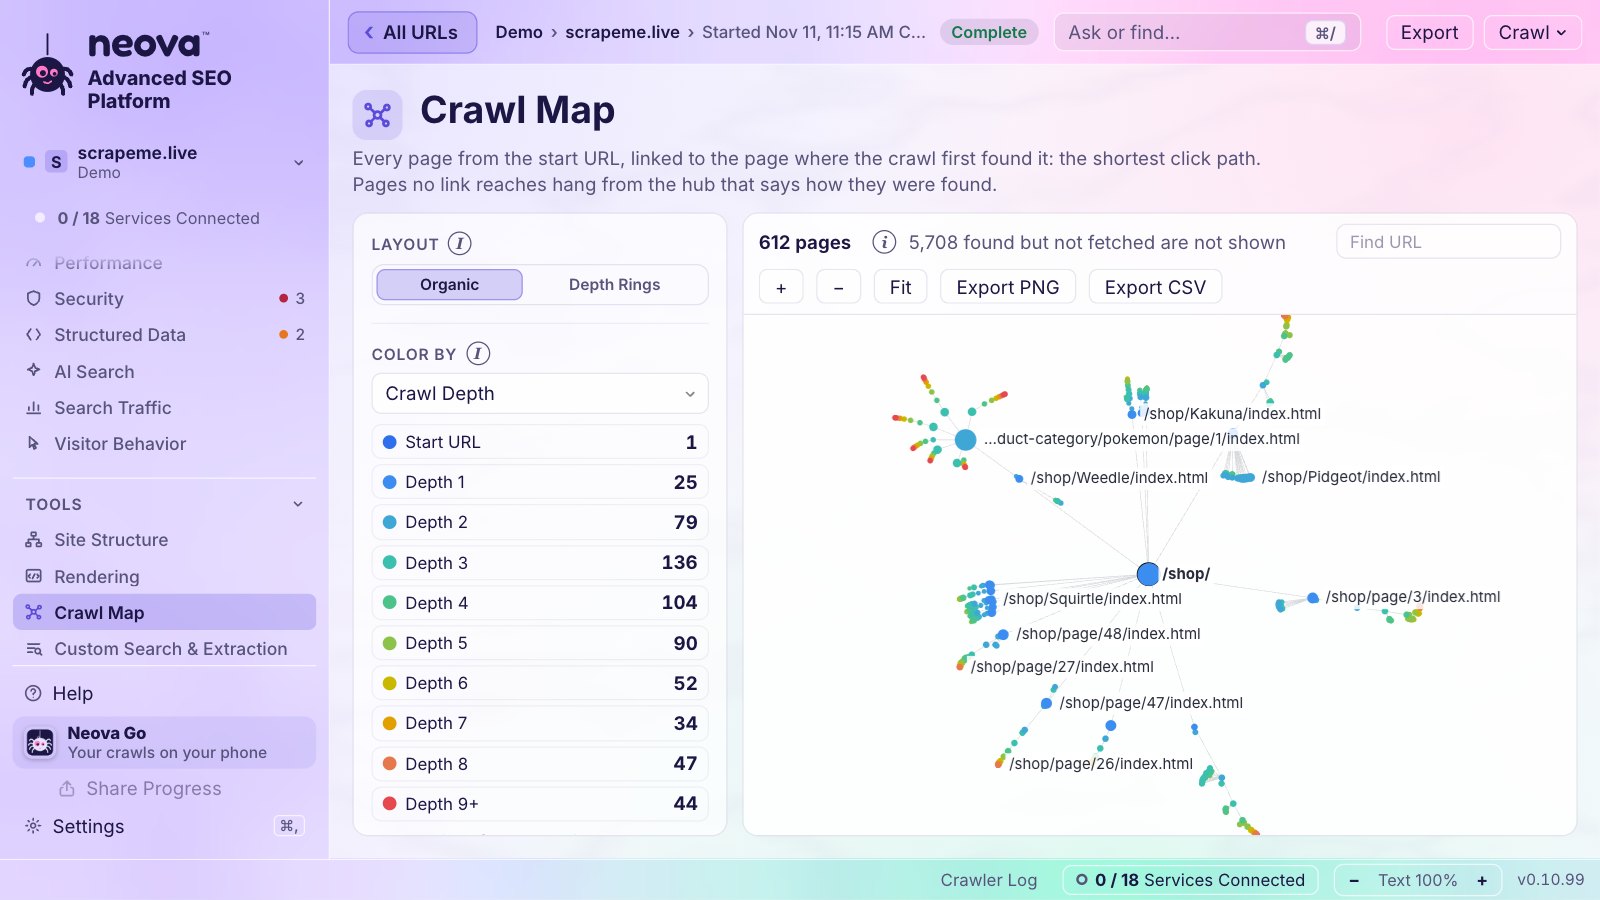
- 9. 重要页面距首页只有几次点击。结构深处的页面被发现得更晚,被抓取得更少。在爬虫中,按抓取深度对可索引页面排序,看看哪些在 4 层或更深。Neova 从深度 4 开始标记可索引页面。检查项:可索引 URL 的抓取深度为 4 或以上。
- 10. 没有孤立页面,也没有只能通过死胡同到达的页面。孤立页面是指没有任何内部链接到达的可索引页面。把抓取与站点地图、服务器日志或 Search Console 对比就能找到它。还要查找只能通过重定向、canonical 或 nofollow 链接到达的页面。检查项:孤立 URL 返回 200 且可索引、URL 只能通过重定向到达。
- 11. 没有相互竞争的重复页面或 URL 变体。同一个页面以两种大小写出现、带或不带末尾斜杠、参数顺序不同,都会分散信号。在爬虫中,比较 URL 变体的 HTML,然后把文本和 title 重复或近似重复的页面归组。检查项:URL 变体返回相同的 HTML、HTML 页面之间存在近似重复内容。
在大型网站上,同样的问题决定了爬虫把访问花在哪里;抓取预算指南介绍了这一面。
渲染、速度与结构化数据
- 13. title、链接和正文都在原始 HTML 中。Google 会渲染 JavaScript,有时要在抓取之后很久才渲染,而很多其他爬虫只读取服务器发送的 HTML。在爬虫中,每个模板渲染一部分样本,并把渲染后的页面与原始 HTML 对比。Neova 会把每个页面标为“服务器端渲染”“客户端水合”或“需要 JavaScript”。检查项:大部分正文只出现在渲染后的 HTML 中、noindex 指令被 JavaScript 删除。JavaScript SEO 爬虫指南有更深入的介绍。
- 14. 服务器响应和 Core Web Vitals 处于良好范围。良好意味着 LCP 不超过 2.5 秒、INP 不超过 200 毫秒、CLS 不超过 0.1。在爬虫中,对每个模板的一个页面运行 Lighthouse,并读取 Chrome UX Report 获取真实访问者数据。Neova 两者都能做,后者需要使用您自己的 Chrome UX Report 密钥。检查项:实验室数据或实际用户数据中的服务器响应时间较慢、实验室数据或实际用户数据中的 CLS 超过 0.1。
- 15. 结构化数据有效,并与页面一致。有语法错误的标记会被忽略,与页面内容不一致的标记同样是问题。在爬虫中,验证每个页面上的 Schema,并在每个模板内进行比较。检查项:结构化数据有语法错误、结构化数据缺少必需属性或与可见文本不一致。
背景知识请参阅 Google 关于 Core Web Vitals 的说明以及结构化数据简介。
服务器日志与 AI 爬虫
- 16. 日志显示爬虫把访问花在正确的 URL 上,AI 爬虫拿到的正是您想给它们的内容。抓取显示网站提供了什么。服务器日志显示 Googlebot、Bingbot 和 AI 爬虫实际请求了什么、拿到了什么。只有当请求的地址经过验证时,才把它计为 Googlebot;User-Agent 字符串很容易伪造。然后查找爬虫从未访问的关键页面,以及落在错误上的爬虫访问。对于 AI 爬虫,检查 robots.txt 允许每个爬虫获取什么,以及服务器实际交给它什么,因为防火墙或 CDN 规则可能拦截 robots.txt 允许的爬虫。检查项:搜索引擎爬虫的 3xx、4xx 或 5xx 响应占比正在上升、使用 AI 搜索爬虫 User-Agent 的请求被拦截。
在 Neova 中,服务器日志来自 Apache 或 Nginx 日志文件,或来自您自己的 Cloudflare 账户,并且只有当爬虫的地址在各公司公布的列表中时才计数。“各 AI 助手获取到的内容”视图会以 10 个 AI 代理的身份请求抽样页面,并显示谁获得了完整访问。日志文件分析和 AI 爬虫指南对两者都有深入介绍,Google 也解释了如何验证 Googlebot。
这份清单用在我们自己的网站上
我们在自己的网站上运行同一份清单。2026年10月17日 Neova 对 seoprocheck.com 的完整抓取在 61 分钟内获取了 10,222 个 URL,其中 4,561 个是返回 200 的 HTML 页面,完整度 99.98%。它标记了:
| 标记 | 数量 |
|---|---|
| meta description 超过 155 个字符 | 582 |
| title 超过 60 个字符 | 557 |
| 重复 title | 56 |
| canonical 指向另一个内部 URL | 5 |
| 缺少 alt 文本的图片 | 2 |
2026年11月20日我们对 neova.app 做 SEO 检查时,发现了清单涵盖的五个问题,当天全部修复:
| 步骤 | 之前 | 之后 |
|---|---|---|
| 7. http:// 版本 | 200 | 301 到 https |
| 5. 未知地址 | 503 | 404 |
| 1. Cloudflare 邮件脚本 | 在 1,320 个页面上被屏蔽 | 允许 |
| 1. 网站图标文件 | 被 Disallow: / 挡住 | 允许 |
| meta description | 部分超过 160 | 160 或以下,1,354 个页面 |
网站图标的问题在 Google 中就能看到:文件被屏蔽后,neova.app 旁边显示的是一个普通字母,而不是 logo。网站 15 种语言的 1,358 个站点地图 URL 通过了 hreflang 这一步,所有返回链接都齐全。
做完整份清单后,修复,然后再次抓取。Neova 的“验证修复”只重新获取某项检查标记过的 URL,并说明已修复多少;“比较抓取”显示两次抓取之间的变化。Neova 运行 694 项检查;下载 Neova,在您的网站上运行它们。

常见问题
什么是技术 SEO 诊断清单?
一份决定搜索引擎能否抓取、渲染和索引网站的事项清单,按固定顺序逐项检查。每次都按同样的方式做,诊断就变成了例行工作。
技术 SEO 诊断有哪些步骤?
连同 XML 站点地图一起抓取网站,然后检查可抓取性、可索引性、状态码与重定向、站点地图、网站结构与重复内容、国际化标签、渲染、速度和结构化数据,最后检查服务器日志。先修复涉及可索引页面最多的问题,然后再次抓取。
应该多久做一次技术 SEO 诊断?
每年做一两次完整诊断,每次重大发布后做一次较轻的抓取。经常变化的网站适合每周定时抓取一次,并与上一次对比。
能用免费工具完成这份清单吗?
小网站可以。Neova 的免费套餐每次抓取最多 1,000 个 URL,包含所有检查项、JavaScript 渲染和 Search Console。服务器日志和 Core Web Vitals 快照包含在付费套餐中。其他选择请参阅免费 SEO 爬虫指南。
技术 SEO 诊断需要服务器日志吗?
起步时不需要。抓取就能覆盖清单的大部分内容。日志补充的是爬虫实际做了什么,这在大型网站上以及页面迟迟未被索引时最重要。