Screaming Frog và Sitebulb đã đặt ra chuẩn mực cho các crawler SEO, và chúng tôi đã học được rất nhiều từ cả hai. Dưới đây là Neova đặt cạnh hai công cụ này cùng Semrush, Ahrefs, Lumar và JetOctopus, theo tài liệu của chính họ, kèm liên kết.
4nơi để dùng: Mac, Windows, Linux, mọi trình duyệt
15ngôn ngữ
Crawl nhiều trang web cùng lúc
App desktop
Crawl website khách hàng, đối thủ của họ và website của chính bạn trong một lần. Tối đa 4 website crawl cùng lúc trong một cửa sổ, mỗi website theo tốc độ và giới hạn URL riêng, và một bộ canh bộ nhớ giữ website tiếp theo lại khi máy tính sắp hết bộ nhớ.
Hai lần crawl, một cửa sổ2 lần crawl đang chạy ở trên cùng: click vào một lần để theo dõi.Đang thực hiệnMọi lần crawl, tốc độ của nó, số slot đang dùng và bộ nhớ còn trống.
Tối đa 4 lần crawl cùng lúcBắt đầu một lần crawl, rồi thêm lần nữa: tối đa 4 website crawl cùng lúc. Cài đặt › Crawl › Số lần crawl cùng lúc, mặc định là 2; lần tiếp theo chờ đến lượt trong hàng đợi.
Mỗi lần crawl một tốc độ riêngMỗi lần crawl giữ tốc độ, giới hạn URL và thiết lập riêng, nên một website khách hàng chậm không bao giờ kéo các lần crawl khác lại.
Bộ canh bộ nhớMỗi lần crawl để dành phần bộ nhớ nó cần, nhiều hơn khi render JavaScript. Khi máy tính sắp hết bộ nhớ, lần crawl tiếp theo sẽ chờ và nói rõ lý do.
Một cửa sổ cho tất cảChuyển giữa các lần crawl đang chạy ở trên cùng màn hình trực tiếp. Đang chạy hiện tất cả, mỗi lần có Tạm dừng, Dừng và Mở.
Screaming Frog: mỗi bản app chạy một lần crawl: mỗi website một cửa sổ, kèm bộ nhớ riêng. nguồn Sitebulb: app desktop chạy audit lần lượt từng cái; chạy cùng lúc chỉ có trên gói Medium và Enterprise của Sitebulb Cloud. nguồn
Nhìn vào bên trong
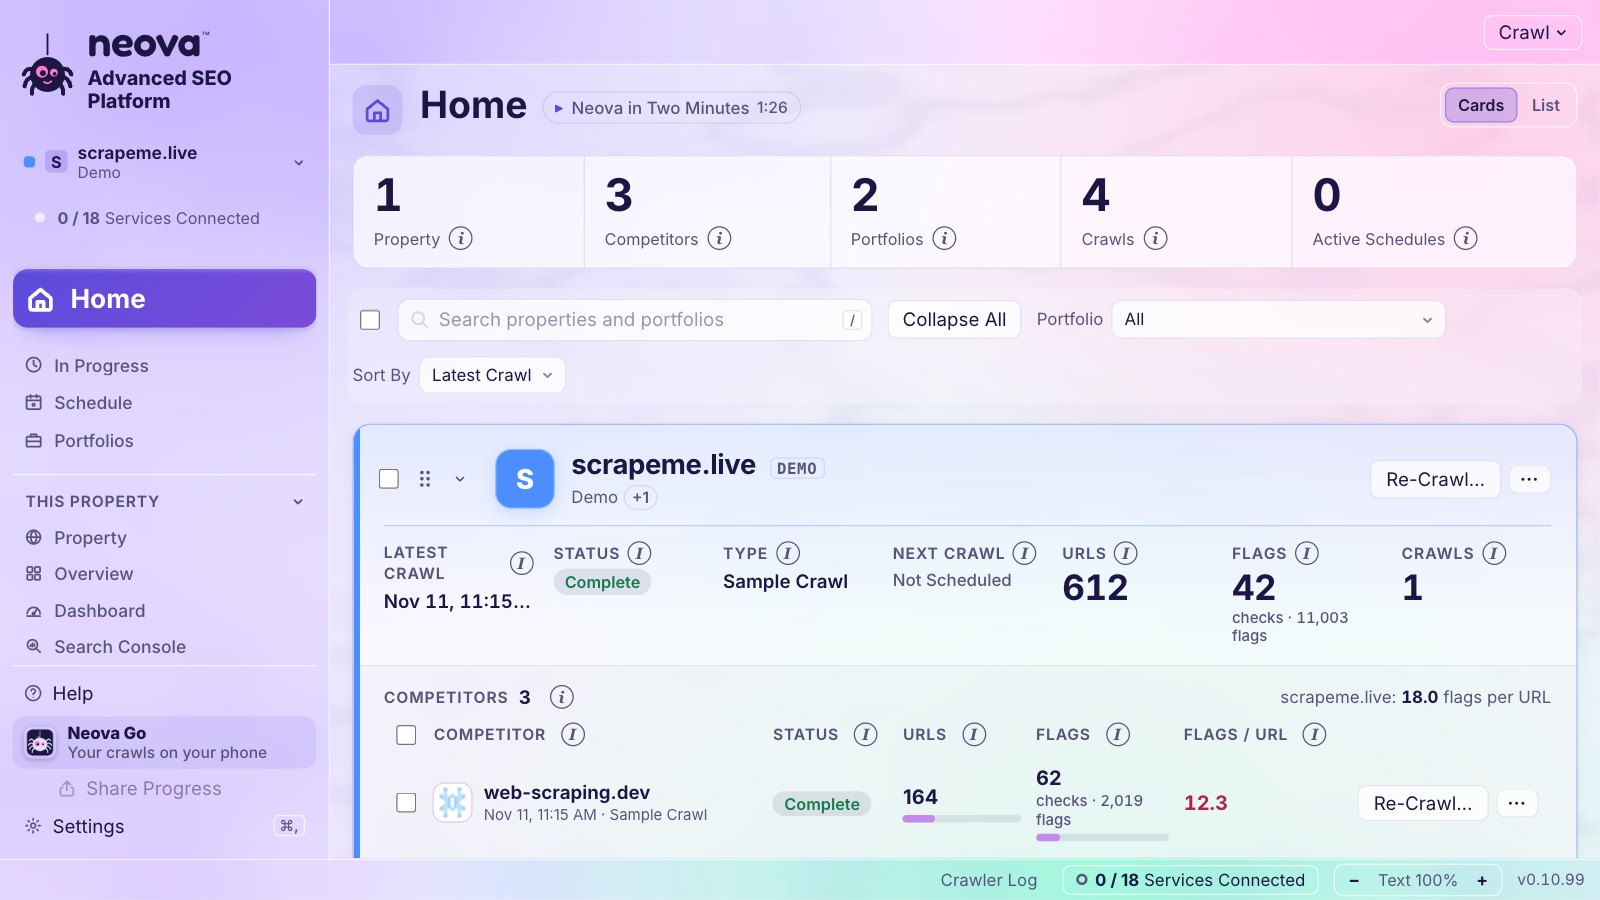
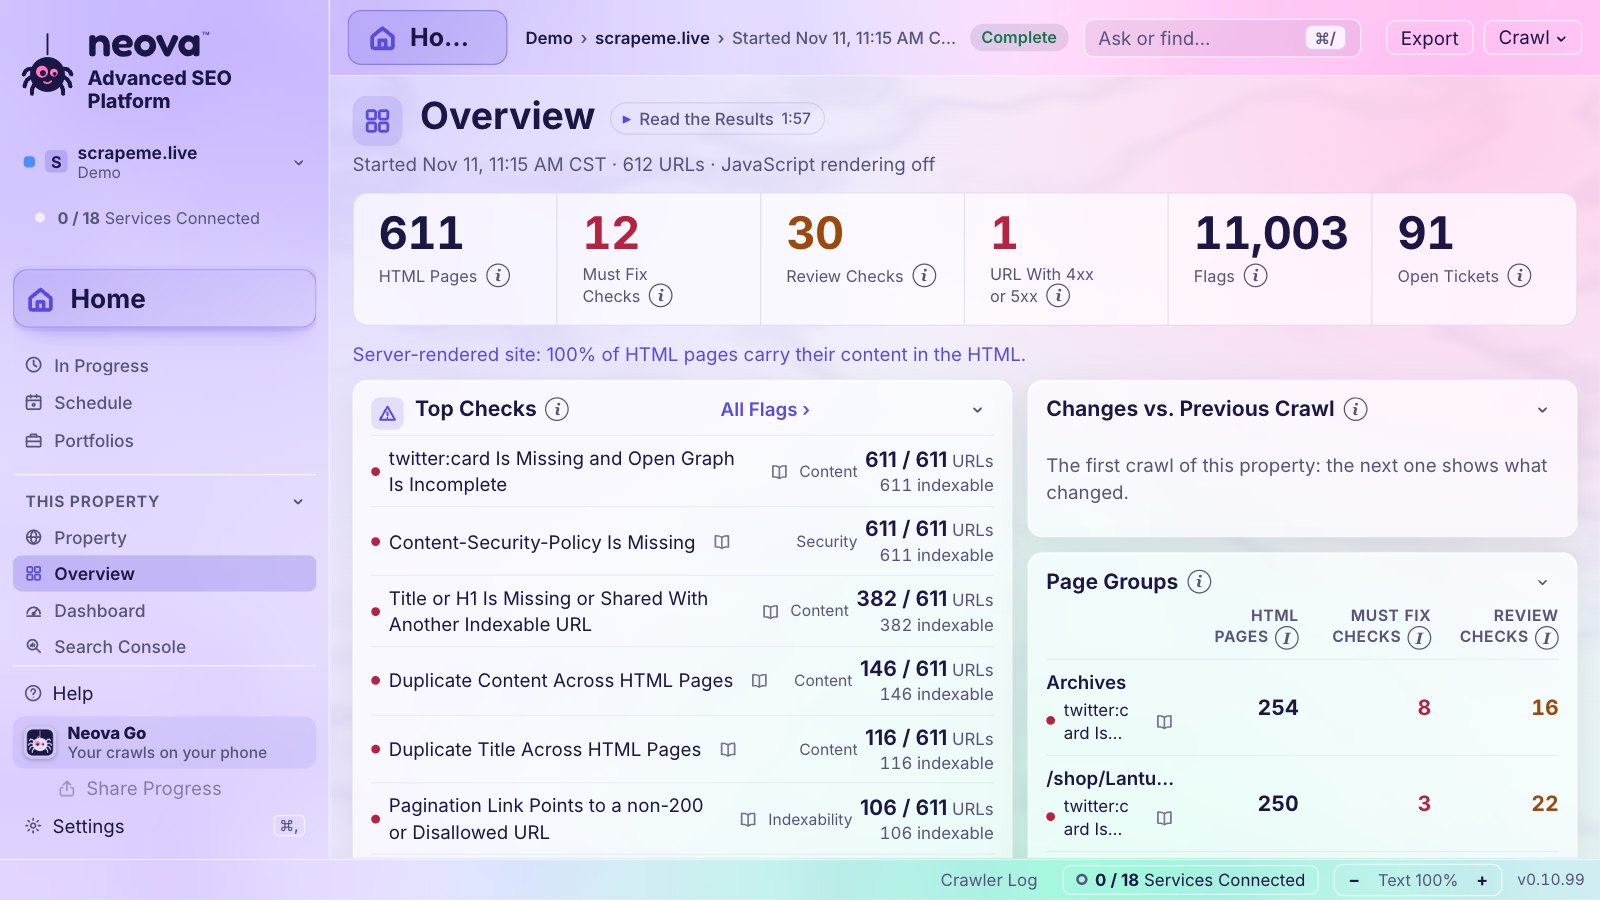
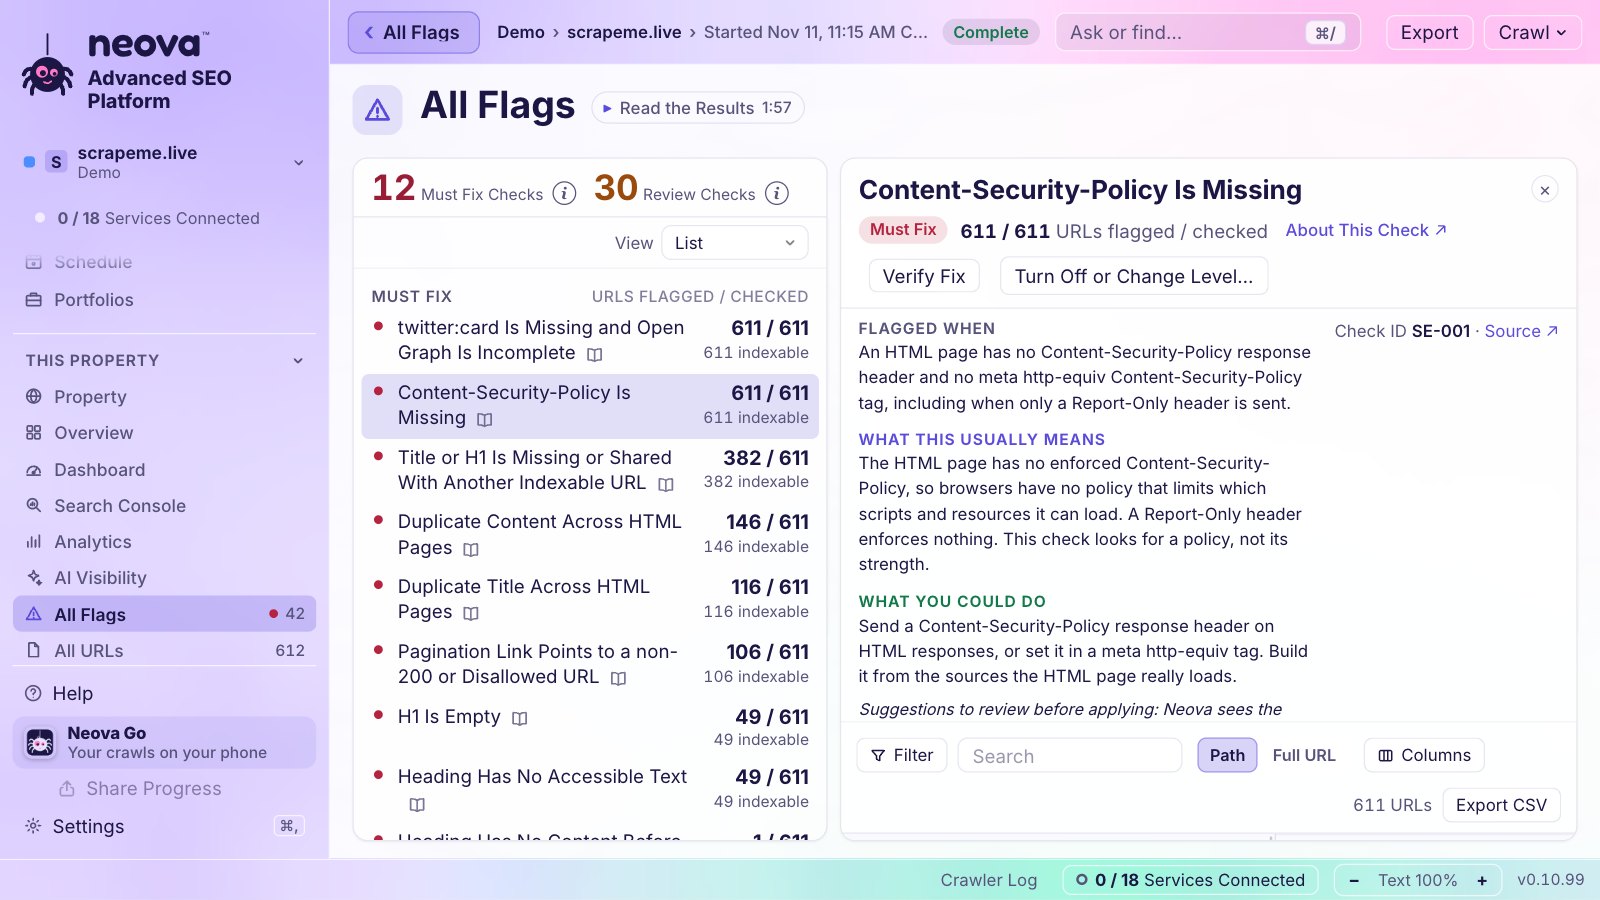
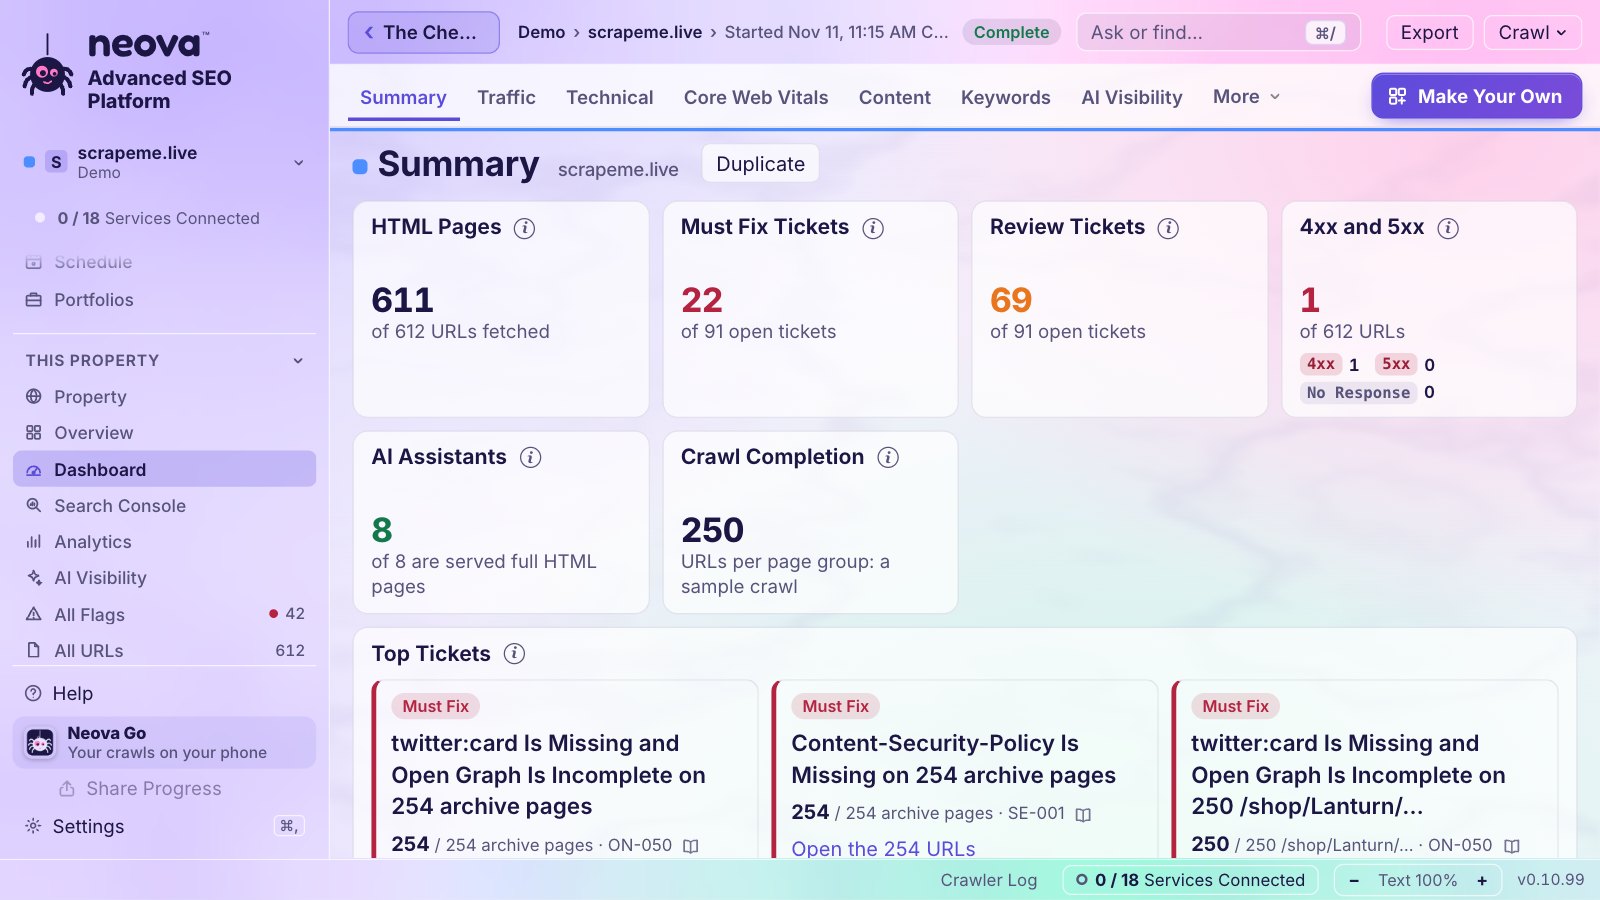
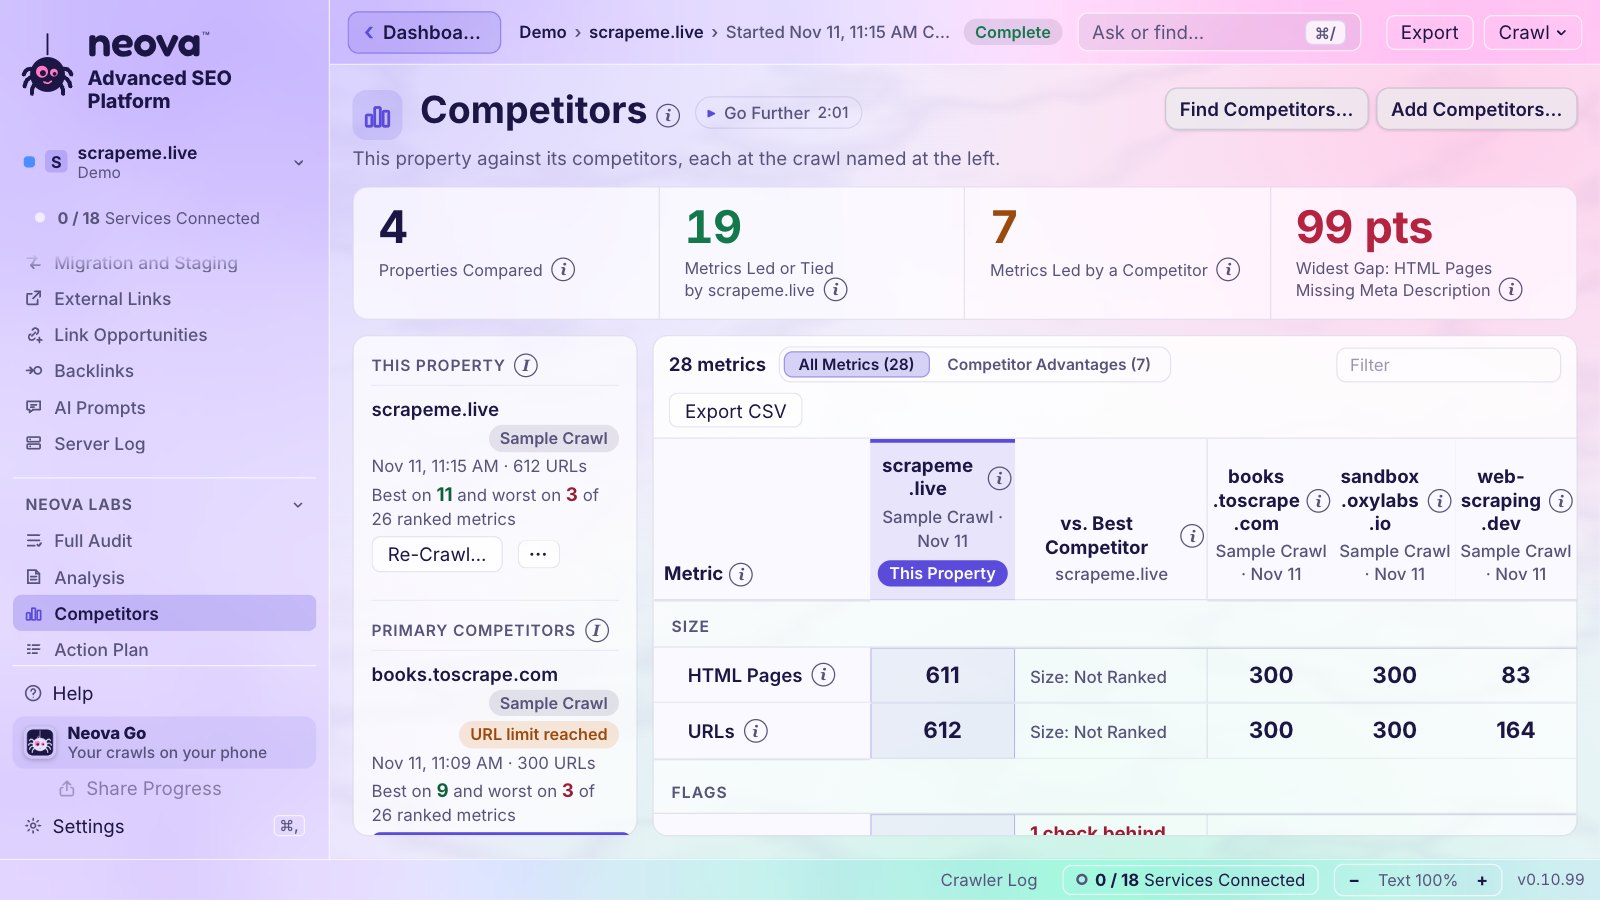
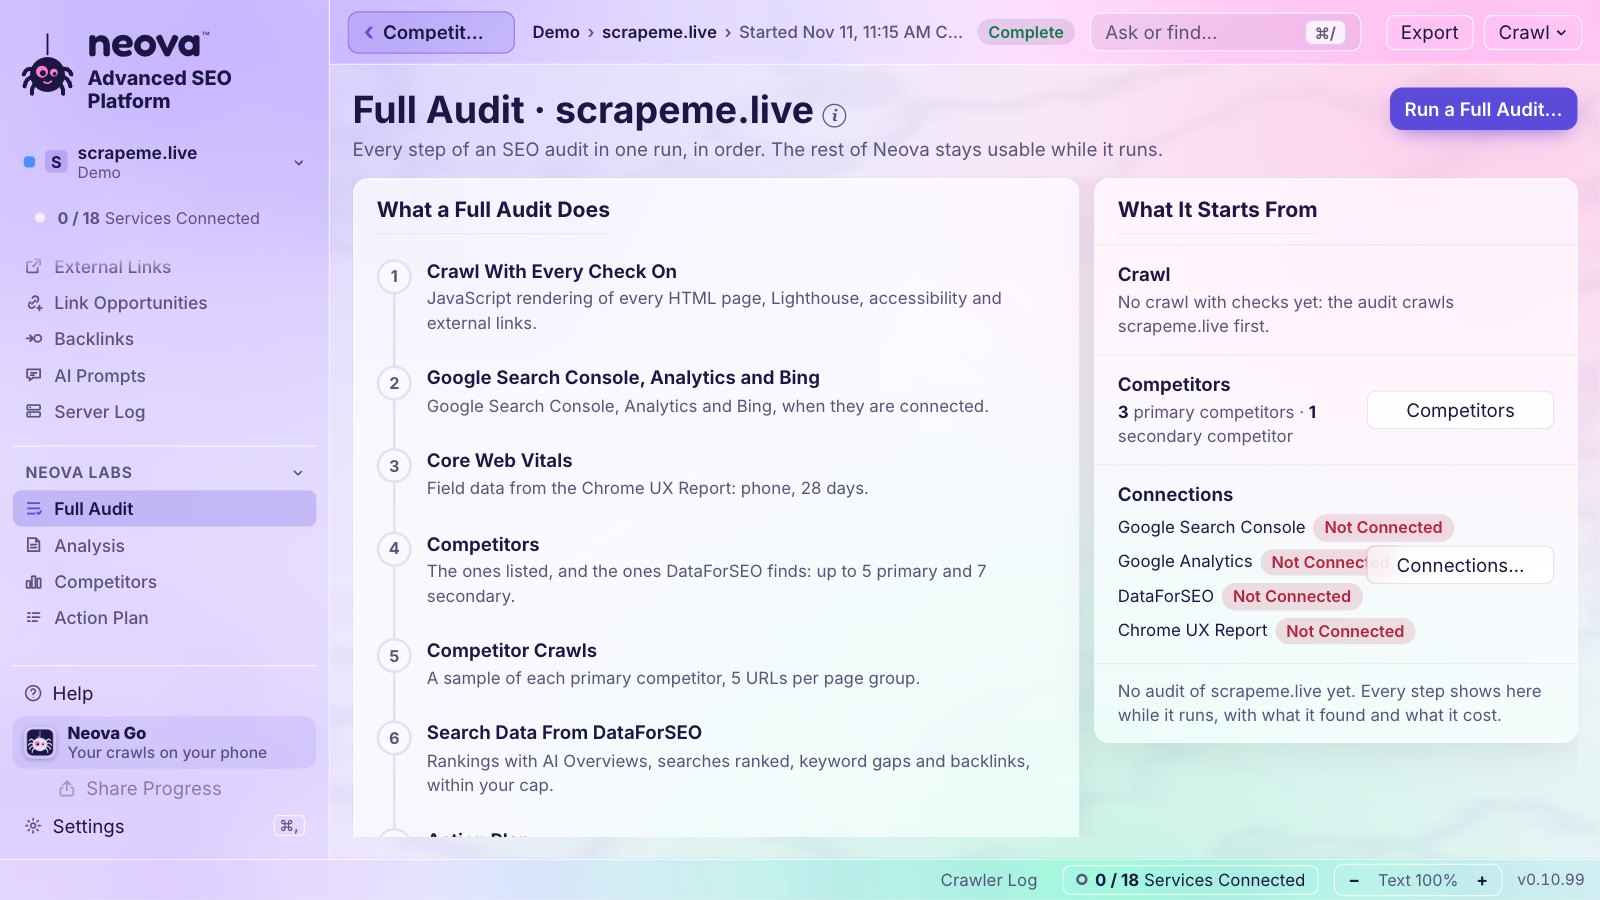
Neova trên shop demo mà mọi tài khoản Neova Online đều có sẵn từ đầu. Click vào một màn hình để xem cỡ lớn.
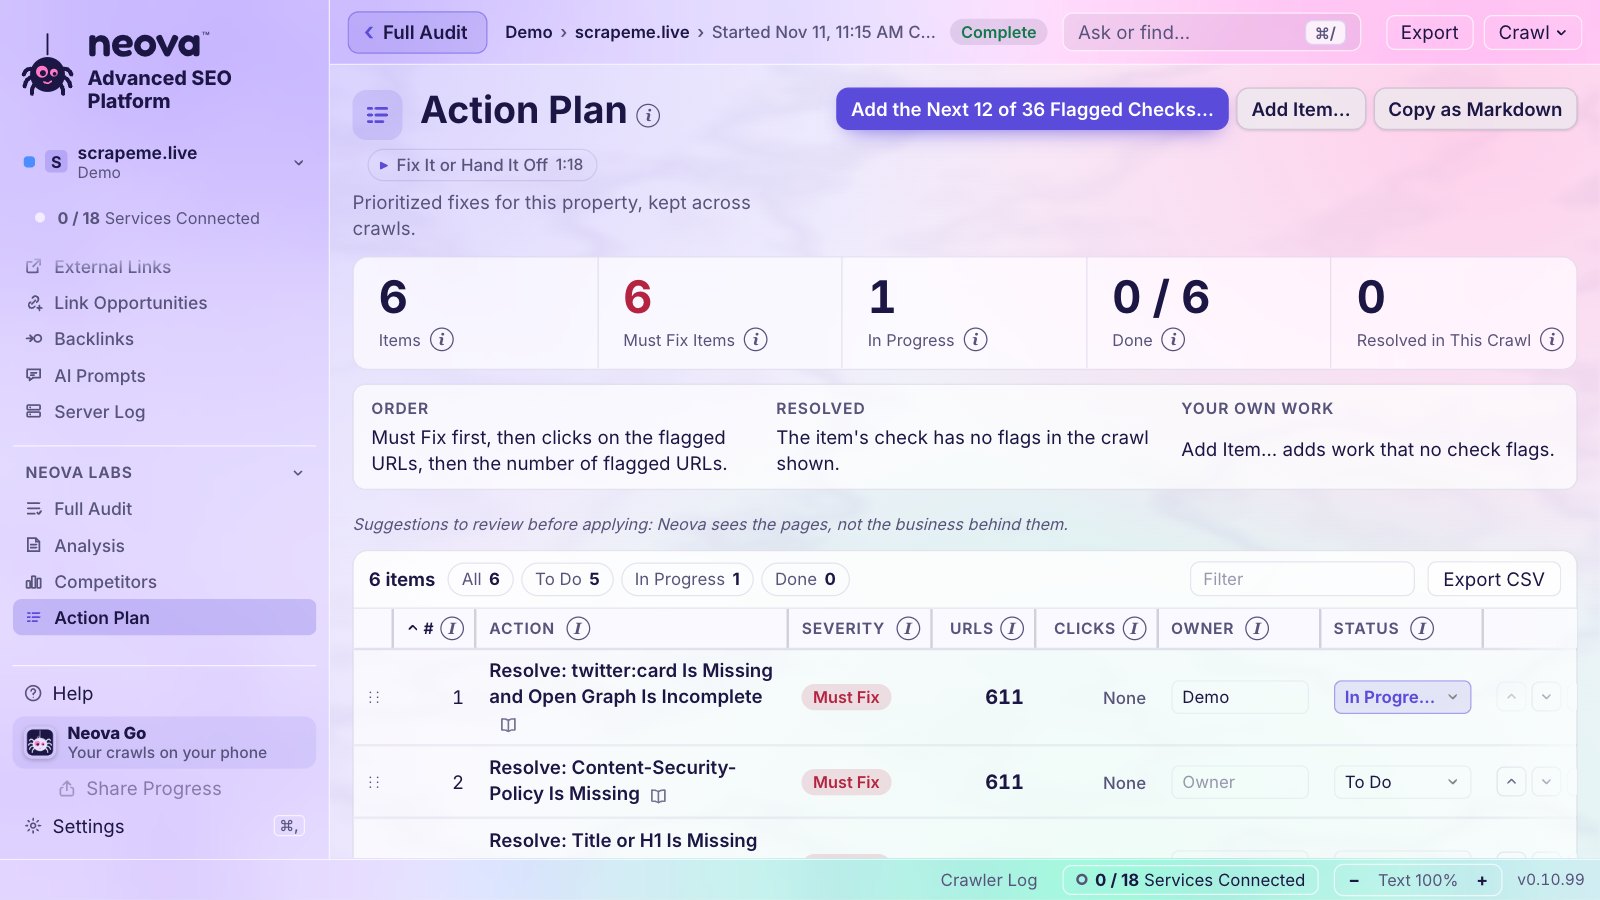
Trang chủMọi tài sản cùng đối thủ, số URL và số mục đánh dấu trên mỗi URL.Crawl trực tiếpCác bước, bản đồ crawl, thời gian phản hồi và từng URL ngay khi về.Tổng quanWebsite trong một cái nhìn: mục kiểm tra hàng đầu, thay đổi, nhóm trang.Tất cả mục đánh dấuMọi mục đánh dấu kèm lý do, cách sửa, nguồn và các trang của nó.Dashboard13 tab, 39 khối, và dashboard của riêng bạn.Đối thủWebsite của bạn đặt cạnh website của họ, từng chỉ số, tô màu theo bên dẫn đầu.Audit đầy đủCrawl, dữ liệu tìm kiếm, đối thủ, kế hoạch và báo cáo trong một lần chạy.Kế hoạch hành độngMỗi cách sửa có người phụ trách và trạng thái, gửi sang Jira nếu bạn muốn.
Chỉ có ở Neova
Đã đối chiếu tài liệu của họ
Những gì Neova làm mà không công cụ nào trong Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar và JetOctopus làm, theo chính tài liệu của họ, đọc ngày 11 tháng 11 năm 2026. Mỗi thẻ nói bằng lời dễ hiểu đó là gì, và vì sao nó quan trọng.
Chia sẻ lần crawl trực tiếp với bất kỳ ai
Chia sẻ tiến độ cho bạn một link tới lần crawl đang chạy. Ai cũng mở được trên điện thoại hay máy tính, không cần tài khoản, và xem trực tiếp: tiến độ, phân loại URL, bản đồ crawl, thời gian phản hồi, redirect và lỗi, cùng thông báo khi crawl xong.
Chi tiết
Khách hàng hay sếp của bạn theo dõi lần crawl mà không cần đăng nhập vào đâu cả, và chỉ thấy đúng lần crawl đó. Dừng chia sẻ là link ngừng ngay.
Screaming Frog: một bản tổng quan crawl trên Looker Studio, lấy dữ liệu từ Google Sheet được cập nhật 'mỗi lần chạy crawl theo lịch', có thể gửi email tới 'mọi bên liên quan'. nguồn Sitebulb: dashboard Data Studio của Cloud mở được 'mà không cần tài khoản Sitebulb' và cập nhật 'mỗi lần một lần crawl chạy' nguồn Semrush: người xem được mời 'vẫn phải tạo tài khoản' nguồn Ahrefs: khách hàng nhận kết quả 'qua file xuất, báo cáo theo lịch hoặc dashboard Data Studio trực tiếp' nguồn Lumar: 'link công khai cho phép bất kỳ ai xem các lần crawl và báo cáo', hết hạn sau '24 giờ đến 6 tháng' nguồn JetOctopus: không tìm thấy link công khai nguồn
Chia sẻ mọi lần crawl, khóa bằng khóa của bạn
Đăng một link chia sẻ là Neova mã hóa các lần crawl của website ngay trên máy tính của bạn trước khi chúng rời máy. Khóa chỉ nằm trong link, nên ngay cả server của chúng tôi cũng không đọc được. Dừng chia sẻ, và link không còn mở được gì.
Chi tiết
Giao cho khách hàng toàn bộ bản audit, mọi tab và mọi bảng, mà vẫn toàn quyền quyết định ai được xem và xem trong bao lâu.
Screaming Frog: một bản tổng quan crawl trên Looker Studio, lấy dữ liệu từ Google Sheet được cập nhật 'mỗi lần chạy crawl theo lịch', có thể gửi email tới 'mọi bên liên quan'. nguồn Sitebulb: dashboard Data Studio của Cloud mở được 'mà không cần tài khoản Sitebulb' và cập nhật 'mỗi lần một lần crawl chạy' nguồn Semrush: người xem được mời 'vẫn phải tạo tài khoản' nguồn Ahrefs: khách hàng nhận kết quả 'qua file xuất, báo cáo theo lịch hoặc dashboard Data Studio trực tiếp' nguồn Lumar: 'link công khai cho phép bất kỳ ai xem các lần crawl và báo cáo', hết hạn sau '24 giờ đến 6 tháng' nguồn JetOctopus: không tìm thấy link công khai nguồn
Máy tính của bạn, trình duyệt của bạn, điện thoại của bạn
Crawl trên chính máy Mac, PC hoặc Linux của bạn, mở cùng các portfolio, thiết lập và lần crawl trong Neova Online từ bất kỳ trình duyệt nào, và theo dõi từ điện thoại. Một tài khoản, luôn đồng bộ.
Chi tiết
Crawler desktop nằm trên một máy tính, crawler cloud nằm trong trình duyệt. Neova đi theo bạn, và lần crawl của bạn nằm trên máy tính của bạn trừ khi bạn chọn khác.
Screaming Frog: Không tìm thấy trong tài liệu của họ. nguồn Sitebulb: Desktop cộng bản Cloud trên trình duyệt nguồn Semrush: nền tảng trên trình duyệt cộng một app iOS chỉ cho thứ hạng nguồn Ahrefs: chỉ có trên trình duyệt; Ahrefs nói bạn xem được kết quả crawl 'từ bất kỳ đâu, vào bất kỳ lúc nào' và 'thậm chí từ smartphone' (2024). nguồn Lumar: Không tìm thấy trong tài liệu của họ. nguồn JetOctopus: Không tìm thấy trong tài liệu của họ. nguồn
Neova Go: website của bạn trong túi áo
Trên điện thoại, lần crawl gần nhất, Core Web Vitals, lượt click, từ khóa đang theo dõi và lần chạy tiếp theo của mọi tài sản, khóa bằng một khóa không bao giờ rời máy tính của bạn. Trên thanh menu, tiến độ lần crawl cạnh đồng hồ, và Hoãn hoặc Bỏ qua cho lần crawl theo lịch tiếp theo.
Chi tiết
Bạn biết một lần crawl đã xong hay một template chậm đi mà không cần mở laptop.
Screaming Frog: Không tìm thấy trong tài liệu của họ. nguồn Sitebulb: Không tìm thấy trong tài liệu của họ. nguồn Semrush: một app iOS chỉ cho thứ hạng nguồn Ahrefs: không tìm thấy app điện thoại. App web trên cloud chạy được trên điện thoại nguồn Lumar: Không tìm thấy trong tài liệu của họ. nguồn JetOctopus: Không tìm thấy trong tài liệu của họ. nguồn
Ticket tự đóng
Mục đánh dấu thành ticket, mỗi ticket cho một mục kiểm tra và một nhóm trang. Khi lần crawl sau thấy vấn đề đã được sửa, ticket tự đóng; nếu vấn đề quay lại, ticket mở lại. Gửi sang Jira, và Jira cũng cập nhật theo.
Chi tiết
Dev của bạn nhận một ticket rõ ràng thay vì 4,000 URL, và không ai phải đuổi theo những ticket đã sửa từ mấy tuần trước.
Screaming Frog: Không tìm thấy trong tài liệu của họ. nguồn Sitebulb: không có Jira tích hợp sẵn. Dev Handoff Skill, chạy qua một trợ lý AI, viết ticket 'thẳng vào Jira, Linear, Asana, Monday hoặc ClickUp'. nguồn Semrush: Site Audit có thể 'gửi task sang một board Trello' nguồn Ahrefs: không tìm thấy tính năng Jira hay ticket. nguồn Lumar: Task được tạo tay từ báo cáo và di chuyển bằng cách 'kéo thả task vào các mục trạng thái khác nhau' nguồn JetOctopus: Không tìm thấy trong tài liệu của họ. nguồn
Mục kiểm tra nào cũng nêu nguồn
Mỗi mục kiểm tra nói rõ nó dựa trên trang nào của Google, W3C, web.dev hoặc một nguồn chính thức khác, kèm link, và bạn nên làm gì.
Chi tiết
Khi dev hỏi vì sao, bạn gửi nguồn, không phải ý kiến của bạn.
Screaming Frog: cả 8 hướng dẫn issue được lấy mẫu đều kết thúc bằng 'Further Reading' trỏ tới Google hoặc web.dev, nhưng chỉ là tài liệu đọc thêm, không phải cơ sở của quy tắc nguồn Sitebulb: nhiều Hint kết thúc bằng 'Further Reading' (Google, MDN, tài liệu Lighthouse, cả blog), nhưng 'Canonical points to a redirecting URL' không dẫn nguồn nào. nguồn Semrush: một số cách sửa có link tới Google ('vui lòng xem bài viết này của Google') nguồn Ahrefs: một số trang trợ giúp có link tới Google ('Hướng dẫn này của Google sẽ cho bạn biết mọi thứ'), trong khi các trang issue như 'Hreflang to broken page' không dẫn nguồn bên ngoài nào. nguồn Lumar: Không tìm thấy trong tài liệu của họ. nguồn JetOctopus: Không tìm thấy trong tài liệu của họ. nguồn
Bing Webmaster Tools, kể cả trích dẫn trong Bing AI
Neova đọc dữ liệu của chính Bing về website của bạn, kể cả tần suất câu trả lời AI của Bing trích dẫn các trang của bạn.
Chi tiết
Bing cung cấp dữ liệu cho ChatGPT search và Copilot. Dữ liệu của Bing cho thấy mức hiện diện của bạn trong tìm kiếm AI.
Screaming Frog: Bingbot chỉ là một user agent có sẵn nguồn Sitebulb: Bing chỉ là một user agent có sẵn nguồn Semrush: chỉ theo dõi thứ hạng trên Bing nguồn Ahrefs: Site Audit đẩy thay đổi qua IndexNow ('được Bing, Yep và các công cụ tìm kiếm khác hỗ trợ') nguồn Lumar: không có Bing Webmaster Tools nguồn JetOctopus: Bingbot trong log và công cụ kiểm tra robots.txt ('Dữ liệu đầy đủ về Googlebot, Bingbot, GPTBot, ClaudeBot và hơn 40 crawler khác') nguồn
Mở các lần crawl Screaming Frog và Sitebulb của bạn
Đã crawl website bằng Screaming Frog hoặc Sitebulb? Mở lần crawl đó trong Neova, và các trang của nó được chấm theo website thật bằng các mục kiểm tra của Neova.
Chi tiết
Giữ những công cụ bạn quen, thêm Neova ở chỗ cần, mà không phải crawl hai lần.
Screaming Frog: chế độ list đọc URL từ bất kỳ file .txt, .xls, .xlsx, .csv hoặc .xml nào ('bạn có thể tải thẳng file tải về từ Adwords lên') nguồn Sitebulb: nhập danh sách URL (.csv hoặc .txt) nguồn Semrush: Backlink Audit nhập file backlink (CSV, 'tối đa 50 MB') nguồn Ahrefs: Không tìm thấy trong tài liệu của họ. nguồn Lumar: nhập file CSV xuất ra làm nguồn crawl (Majestic, Ahrefs, Open Site Explorer, Screaming Frog Log File Analyser, Splunk, Logz.io nguồn JetOctopus: chỉ nhập chung chung: 'Để nhập, bạn có thể dùng file định dạng CSV hoặc TXT', ghép theo khóa URL nguồn
Có sẵn bên trong, không bán riêng
Các công cụ khác cũng có những thứ này, thường là add-on hoặc sản phẩm riêng với giá riêng. Trong Neova, chúng là một phần của app. Khi cần dữ liệu bên ngoài, như DataForSEO hay Google, bạn dùng tài khoản của chính mình theo giá của bên đó, không cộng thêm gì. Mở Các công cụ khác làm gì ở từng mục để xem trang tài liệu của họ.
Xem ChatGPT và Perplexity có nhắc đến bạn không
Neova đặt chính các câu hỏi của bạn cho ChatGPT và Perplexity, như một khách hàng sẽ hỏi, và cho bạn biết thương hiệu của bạn có xuất hiện trong câu trả lời không.
Các công cụ khác làm gì
Ngày càng nhiều người hỏi trợ lý AI trước khi tìm kiếm. Đây là cách bạn biết mình có mặt ở đó hay không.
Screaming Frog: Không tìm thấy trong tài liệu của họ. nguồn Sitebulb: Không tìm thấy trong tài liệu của họ. nguồn Semrush: Có, trong AI Visibility Toolkit ($99/tháng) nguồn Ahrefs: prompt tùy chỉnh trong Brand Radar trên ChatGPT, Perplexity, Gemini, Copilot, AI Overviews nguồn Lumar: Trong AI Visibility (bật theo từng tài khoản) nguồn JetOctopus: 'JetOctopus không theo dõi trích dẫn, lượt nhắc thương hiệu hay sắc thái trong câu trả lời AI' nguồn
Trợ lý AI thực sự nhận được gì
Neova tải trang của bạn dưới vai 10 bot AI (ChatGPT, Claude, Perplexity và các bot khác), kiểm tra llms.txt và các file cho agent, và cho thấy mỗi bot nhận được gì.
Các công cụ khác làm gì
Một trang khách truy cập thấy được có thể bị chặn hoặc trống trơn với trợ lý AI. Giờ bạn thấy được điều đó.
Screaming Frog: Không tìm thấy trong tài liệu của họ. nguồn Sitebulb: Không tìm thấy trong tài liệu của họ. nguồn Semrush: Site Audit có thông báo 'Llms.txt not found (AI Search)' và 'Llms.txt file has formatting issues (AI Search)' nguồn Ahrefs: chỉ có một công cụ tạo file miễn phí ('tạo file llms.txt hoàn hảo cho bạn') nguồn Lumar: Trong Agentic Readiness Scanner miễn phí của Lumar, tách riêng khỏi nền tảng crawl nguồn JetOctopus: Không tìm thấy trong tài liệu của họ. nguồn
Đối thủ của bạn, được tìm ra và so sánh
Neova tìm các website cạnh tranh với bạn trên cùng các từ khóa, crawl những website gần nhất, và đặt mọi chỉ số cạnh nhau, tô màu theo bên dẫn đầu.
Các công cụ khác làm gì
Bạn thấy đối thủ hơn bạn ở đâu, và hơn bao nhiêu, mà không cần bảng tính.
Screaming Frog: Không tìm thấy trong tài liệu của họ. nguồn Sitebulb: Không tìm thấy trong tài liệu của họ. nguồn Semrush: Position Tracking: 'Báo cáo Competitors Discovery cho thấy các đối thủ organic đang xếp hạng cho từ khóa của bạn' nguồn Ahrefs: Dự án mới 'nhận gợi ý đối thủ dựa trên các website xếp hạng cho từ khóa tương tự' nguồn Lumar: Trong AI Visibility: 'Thương hiệu được tự động phát hiện từ câu trả lời của nhà cung cấp AI' và Lumar xếp mỗi thương hiệu vào Own, Competitor, Other hoặc Context. nguồn JetOctopus: Không tìm thấy trong tài liệu của họ. nguồn
Log server, kể cả sau Cloudflare
Neova đọc log Apache hoặc Nginx của bạn, hoặc đọc thẳng log của Cloudflare, và chỉ đếm bot đã xác minh, để bạn thấy Googlebot và bot AI thực sự tải những gì.
Các công cụ khác làm gì
Log cho thấy công cụ tìm kiếm làm gì trên website của bạn, không phải một crawler đoán gì.
Screaming Frog: một sản phẩm riêng, Screaming Frog Log File Analyser (Windows, macOS, Linux), để 'xác minh bot của công cụ tìm kiếm và bot AI'. nguồn Sitebulb: FAQ: 'Sitebulb chưa phân tích log file, nhưng tính năng này đang được phát triển và sẽ sớm có!' nguồn Semrush: Có, là một sản phẩm Enterprise riêng nguồn Ahrefs: Bot Analytics, một công cụ riêng miễn phí trong giai đoạn beta cho các gói trả phí, 'nạp dữ liệu request HTTP' từ Cloudflare, Vercel, CloudFront, AWS load balancer hoặc Fastly nguồn Lumar: có sẵn, nhưng từ bản tóm tắt theo từng URL nguồn JetOctopus: Có trong mọi gói, không phải sản phẩm riêng nguồn
Core Web Vitals từ người dùng thật, có xu hướng
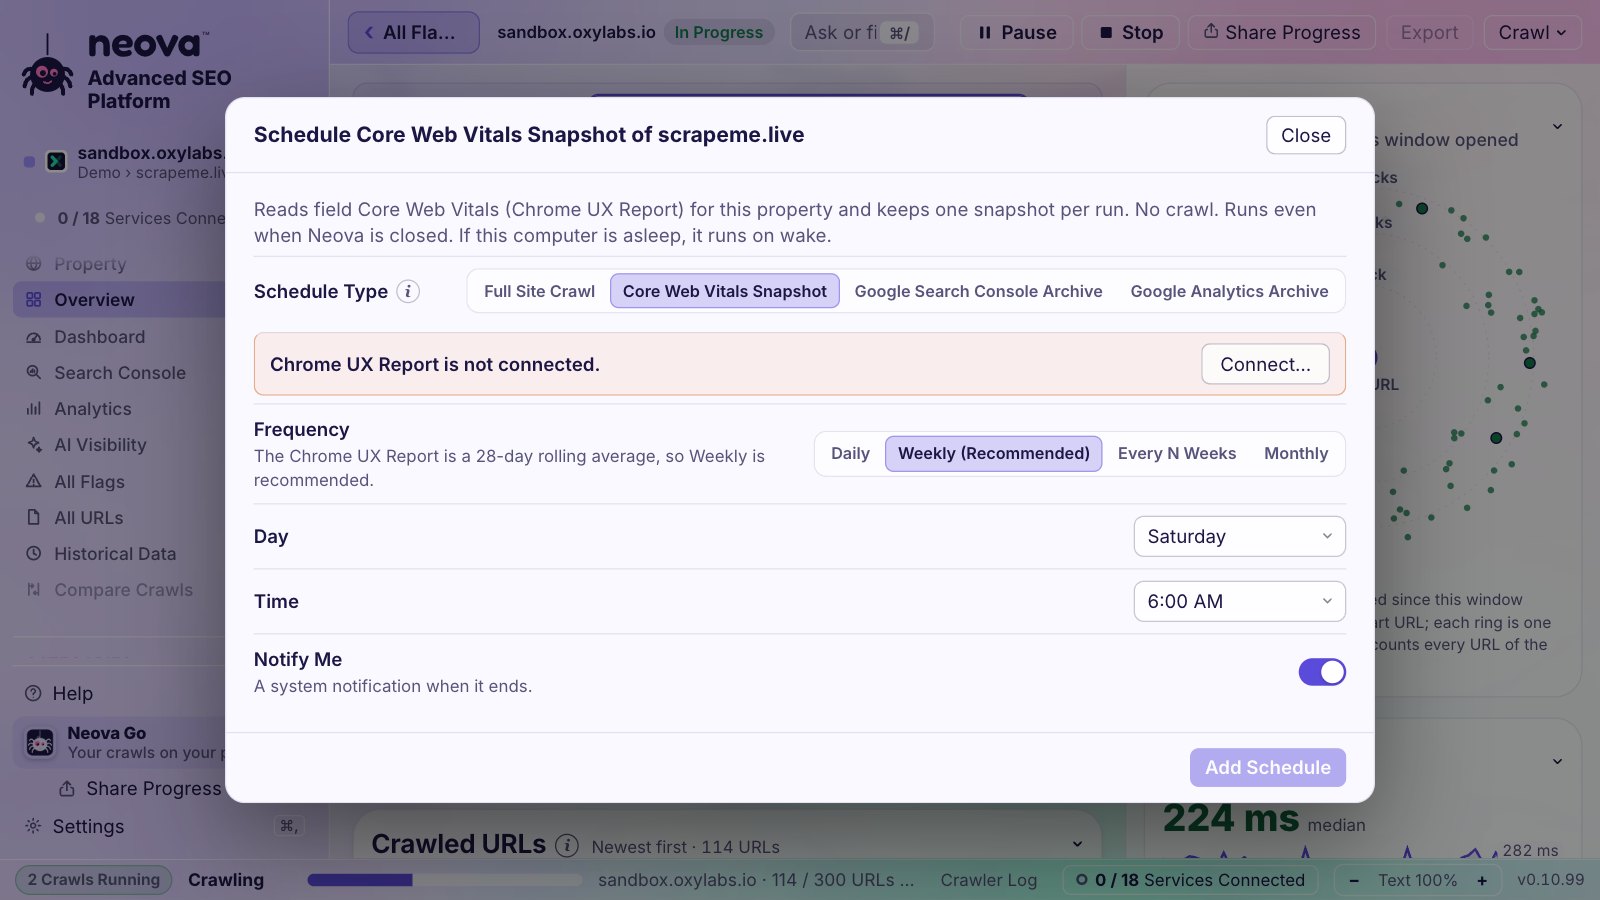
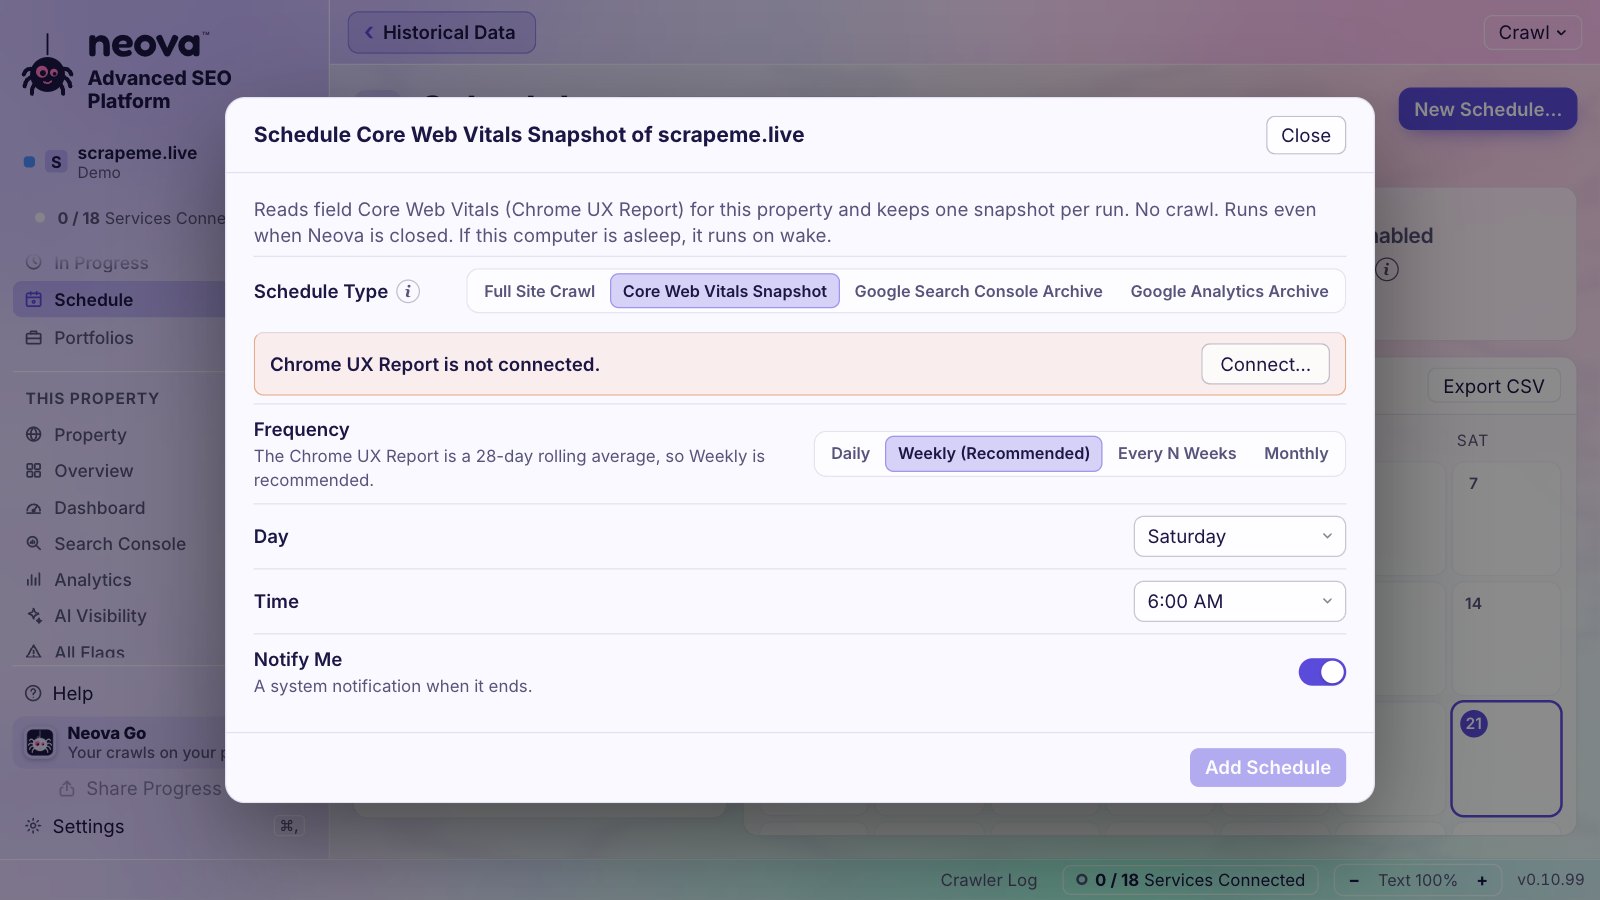
Với khóa Chrome UX Report miễn phí của bạn, Neova đọc trải nghiệm của người dùng Chrome thật: xu hướng 40 tuần ngay từ ngày đầu, góc nhìn theo nhóm trang, ảnh chụp theo lịch, và cảnh báo.
Các công cụ khác làm gì
Kiểm tra lab cho biết một trang có thể nhanh đến đâu. Dữ liệu người dùng thật cho biết trang đó nhanh thế nào với khách truy cập của bạn, và đó là thứ Google dùng.
Screaming Frog: không tìm thấy biểu đồ xu hướng CWV trong app. nguồn Sitebulb: Google Sheet 'Historical Audit Data' có một dòng cho mỗi audit để làm 'dữ liệu chuỗi thời gian hoặc biểu đồ' trong Looker Studio, và có giá trị theo dải Core Web Vitals (changelog, 13 nguồn Semrush: dữ liệu lab (Lighthouse) nguồn Ahrefs: báo cáo Performance của Site Audit nguồn Lumar: Trong Site Speed: 'một biểu đồ xu hướng cho mỗi KPI' (FCP, LCP, TBT, CLS), chia Slow, Moderate, Fast, mỗi lần crawl một điểm (dữ liệu lab) nguồn JetOctopus: kiểm tra CWV theo lịch ('+Create a CWV schedule') nguồn
Jira, không còn việc vặt
Mỗi ticket sang Jira kèm các trang, mục kiểm tra và cách sửa, và Neova giữ hai bên khớp nhau sau mỗi lần crawl.
Các công cụ khác làm gì
Đội của bạn làm việc ở đúng nơi họ vẫn làm.
Screaming Frog: Không tìm thấy trong tài liệu của họ. nguồn Sitebulb: không có tích hợp Jira sẵn nguồn Semrush: chỉ có 'Send to Trello' tích hợp sẵn nguồn Ahrefs: không tìm thấy tích hợp Jira. nguồn Lumar: tích hợp Jira Cloud nguồn JetOctopus: Không tìm thấy trong tài liệu của họ. nguồn
Dashboard
Mở một tài sản, rồi Dashboard: mọi thứ Neova biết về website, trên một màn hình, và bao nhiêu góc nhìn riêng tùy bạn cần.
Website của bạn trên một màn hìnhTám nhóm, 13 tab, 39 khối. Con số nào cũng hiện mức thay đổi so với lần crawl trước.
Tốc độ, 40 tuần trở lạiCore Web Vitals của người dùng Chrome thật ngay từ ngày đầu, với ngưỡng tốt và kém của Google, cả theo nhóm trang.
Lượt click và từ khóaLượt click và lượt hiển thị mỗi ngày so với 28 ngày trước đó, và 25 từ khóa đang theo dõi cùng vị trí của chúng.
Cập nhật của Google trên lượt click của bạnHai năm cập nhật thuật toán xếp hạng vẽ trên traffic của bạn, kèm trước và sau mỗi lần cập nhật.
Tìm kiếm AITrợ lý AI nào ghé thăm, mỗi trợ lý nhận được gì, AI Overviews, và bot đã xác minh.
Nội dung trong một cái nhìnĐộ dài title, description và H1, nhóm trang, và các trang được link nhiều nhất.
Chương trìnhKế hoạch hành động theo trạng thái và người phụ trách; một cách sửa đã đánh dấu Xong mà vẫn bị đánh dấu sẽ chuyển màu đỏ.
Tự làm của riêng bạnTối đa 10 dashboard: tạo mới hoặc sao chép một tab, rồi thêm, di chuyển, đổi cỡ và xóa khối.
Canh chừng thay bạn
Neova không dừng ở lần crawl. Neova theo dõi website của bạn giữa các lần crawl và báo cho bạn khi có gì thay đổi, trên máy tính, điện thoại hoặc các kênh của đội bạn.
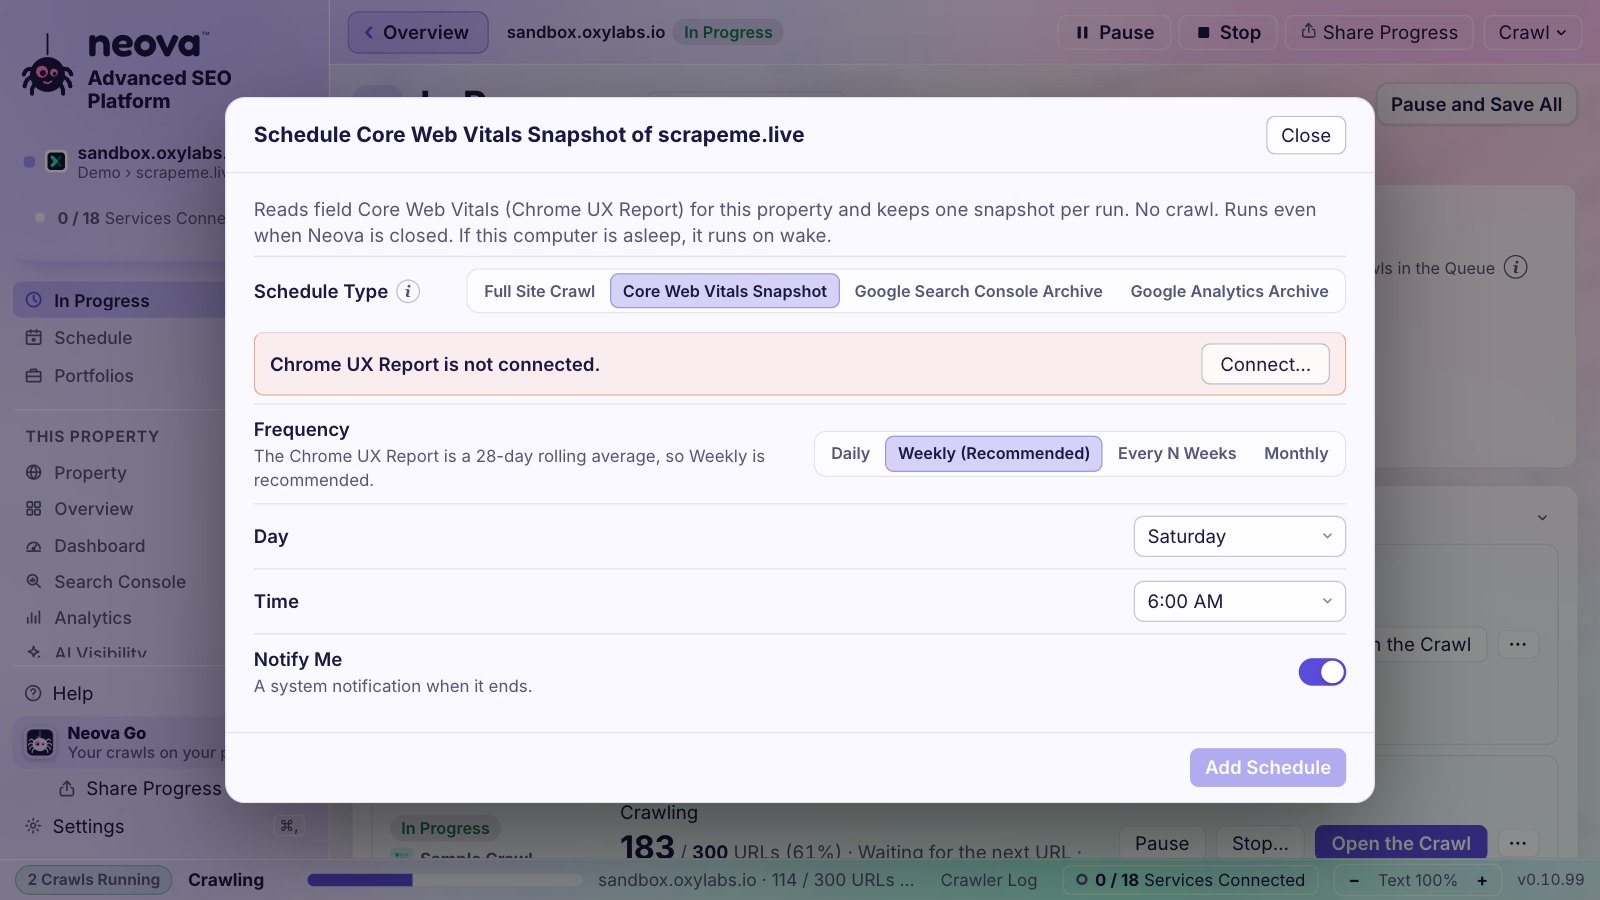
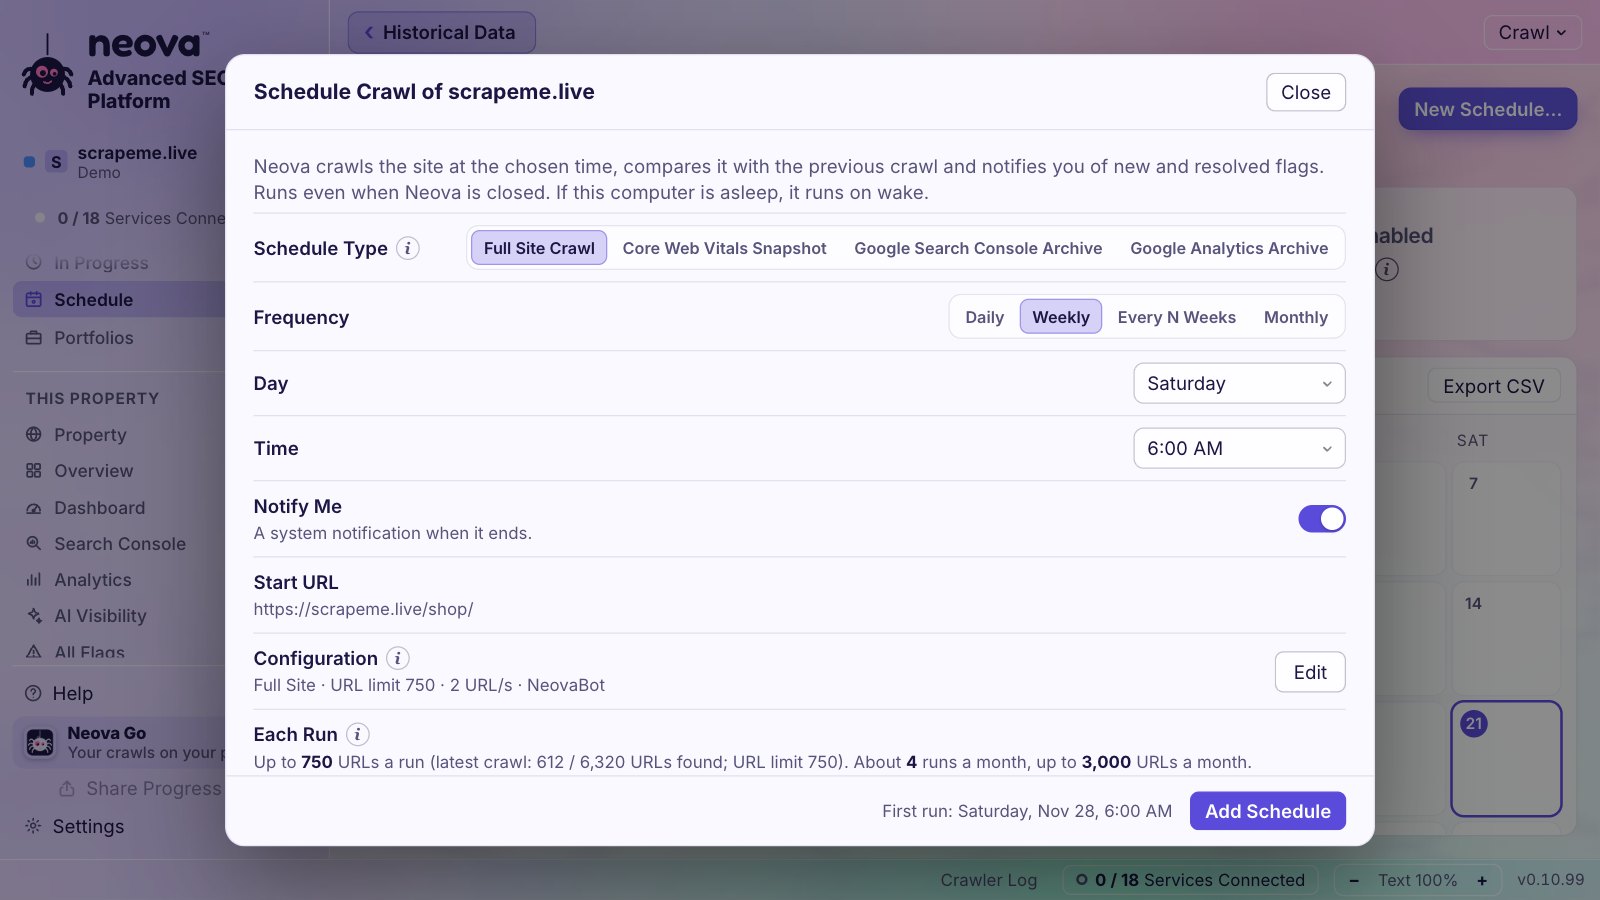
Lịch chạyBao lâu một lần, ngày và giờ, và mỗi lần chạy tốn bao nhiêu.Neova GoThanh menu, cảnh báo, và điện thoại của bạn.Ảnh chụp nhanh Core Web VitalsTốc độ từ người dùng thật theo lịch riêng, không cần crawl.
Crawl theo lịchHằng ngày, hằng tuần, vài tuần một lần hoặc hằng tháng, cho từng tài sản, kể cả khi cửa sổ đã đóng. Báo trước 15 phút, Hoãn hoặc Bỏ qua ngay từ thanh menu, và chi phí của một lịch hiện ra trước khi bạn thêm nó.
Cảnh báo đáng quan tâmCore Web Vitals đổi mức, lượt click giảm từ 20% trở lên trong một tuần, một từ khóa đang theo dõi vào hoặc rời top 10 hay tụt 3 bậc, một lần crawl mới có mục đánh dấu mới. Kiểm tra sau mỗi lần chạy theo lịch, hoặc khi bạn click Kiểm tra ngay.
Crawl theo dõiChỉ kiểm tra lại các trang chủ chốt của bạn, không tìm URL mới, và báo cho bạn khi mã trạng thái, redirect, title, canonical, noindex, H1 hoặc dung lượng trang thay đổi.
Ảnh chụp nhanh Core Web VitalsTốc độ của người dùng Chrome thật theo lịch, không cần crawl, cộng dồn vào một đường xu hướng bạn theo dõi được tuần này qua tuần khác.
Từ khóa theo dõi, mỗi ngàyTối đa 25 từ khóa mỗi tài sản lấy từ Search Console: vị trí trong 7 và 90 ngày, lượt click và lượt hiển thị, và Google có hiện AI Overview trích dẫn bạn hay không.
Cập nhật của Google trên lượt click của bạnHai năm cập nhật thuật toán xếp hạng và sự cố của Google vẽ trên lượt click mỗi ngày của bạn, kèm lượt click trước và sau mỗi lần.
Audit đầy đủ mỗi thángToàn bộ bản audit, kèm đối thủ, lặp lại mỗi tháng; Neova hoàn tất phần phân tích và file PDF vào lần mở app tiếp theo.
Cảnh báo ở nơi bạn đang ởNeova Go trên thanh menu và điện thoại, thông báo khi một lần crawl xong, cùng Slack và Microsoft Teams, mỗi portfolio hoặc tài sản gửi tới kênh riêng của nó.
Còn có trong Neova
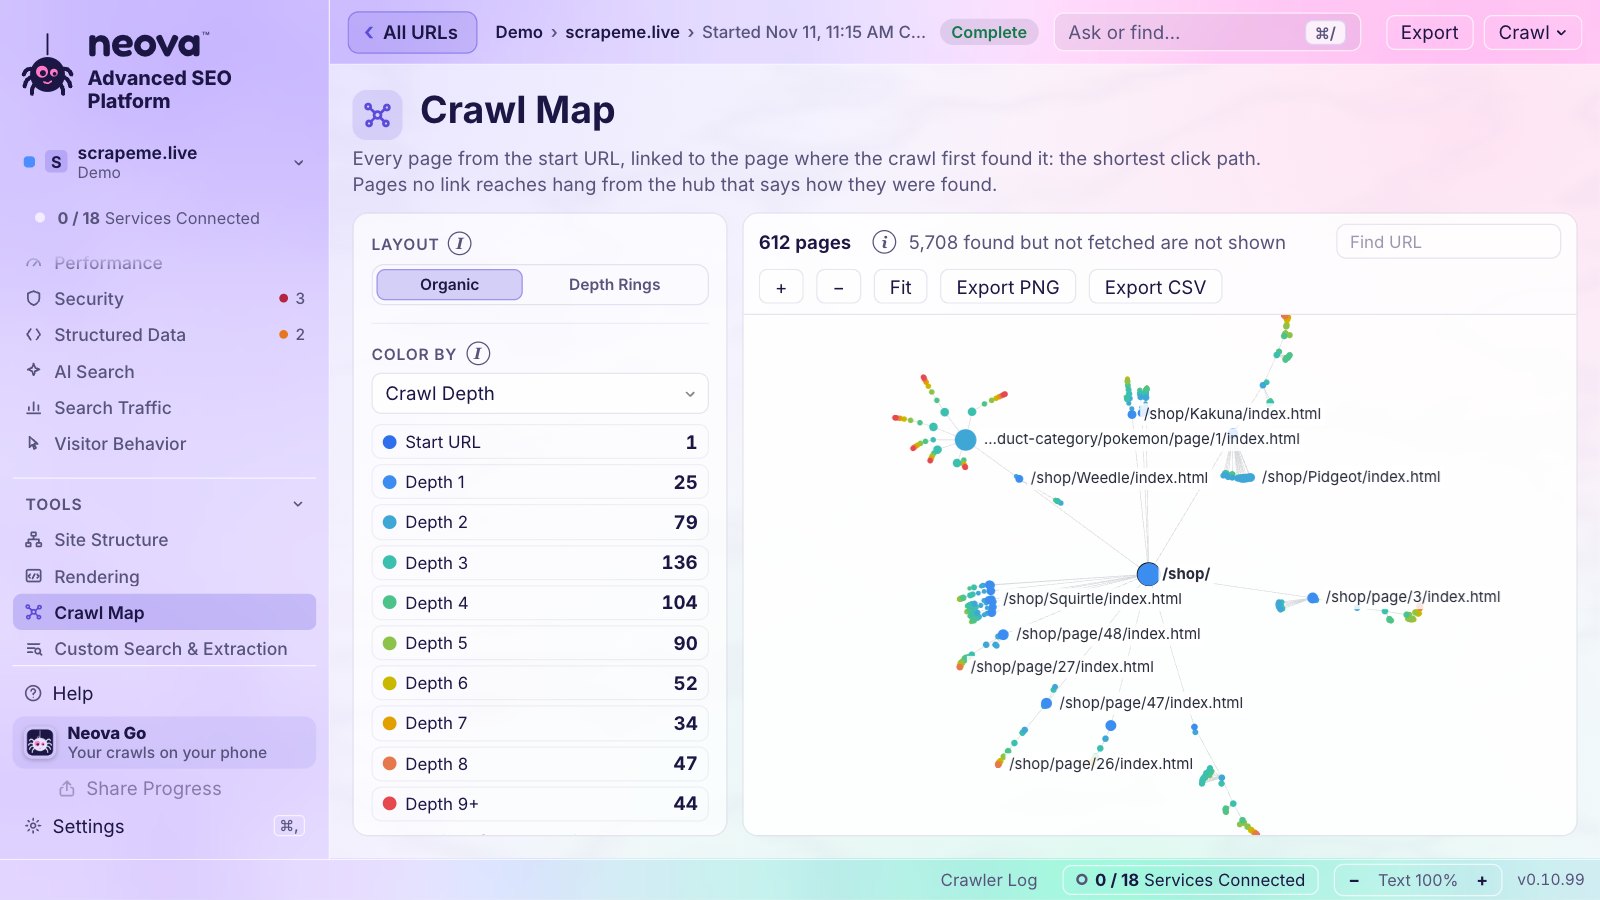
Bản đồ crawlMỗi trang được tìm thấy lần đầu thế nào, tô màu theo mã trạng thái.Tất cả URLMọi URL kèm mã trạng thái, khả năng index và dung lượng.Dữ liệu lịch sửCác lần crawl và dữ liệu Search Console của bạn, giữ lại sau khi Google xóa.
Log crawlerMọi URL lần crawl tải về, trực tiếp, kèm mã trạng thái tô màu và thời gian phản hồi; các bước in đậm, lỗi màu đỏ. Sao chép để gửi bộ phận hỗ trợ chỉ với một click.
Giải thích lần crawl bị chặnKhi một website từ chối lần crawl, Neova nói vì sao (bị giới hạn tốc độ, tường lửa, chặn theo quốc gia) và cần làm gì, kèm một header bí mật để đưa vào danh sách cho phép, gửi cho bộ phận IT.
Chẩn đoán lần crawlĐọc log của một lần crawl và chỉ ra chỗ hỏng: lỗi 429, 403, chặn bởi robots.txt, trang chỉ có JavaScript, kèm thiết lập cần đổi.
Phân loại URLMỗi URL tìm thấy được xếp vào đúng một nhóm, nên bạn luôn biết mấy nghìn URL dư ra đến từ đâu, ngay khi lần crawl đang chạy.
Lần crawl trực tiếp bạn theo dõi đượcCác bước có mũi tên, URL mới nhất, bản đồ crawl trực tiếp và biểu đồ thời gian phản hồi, cùng Chia sẻ tiến độ để ai cũng theo dõi được.
Search Console và Analytics, giữ mãiGoogle xóa dữ liệu Search Console ở mốc 16 tháng và dữ liệu sự kiện Analytics ở mốc 2 hoặc 14 tháng. Neova lưu trữ cả hai hằng tháng trên máy tính của bạn, theo lịch: trang, truy vấn, từng ngày và Discover từ Search Console; từng ngày, trang đích tự nhiên, kênh, nguồn và quốc gia từ Analytics. Giữ lại bao lâu tùy bạn.
Biết trước khi bắt đầuĐọc trước vài trang và cho biết sitemap liệt kê bao nhiêu URL, dự kiến bao nhiêu ảnh, để bạn chọn quy mô lần crawl.
Lần crawl không bao giờ mấtTrang được lưu trước, có bộ canh dung lượng ổ đĩa, Thoát sẽ lưu lần crawl, bản cập nhật chờ nó xong, và Tiếp tục chạy lại với chính thiết lập của nó.
Chi phí hiện trướcChi phí DataForSEO được ước tính trước khi tiêu bất cứ khoản nào, có mức trần cho mỗi lần crawl. Hóa đơn dữ liệu gửi thẳng cho bạn, theo giá của nhà cung cấp.
Thử với dữ liệu thậtMọi tài khoản Neova Online đều bắt đầu với một Demo: một shop và ba đối thủ, đã crawl sẵn, mọi thiết lập đã điền đủ.
Khóa của bạn vẫn là của bạnMọi khóa, token và thông tin đăng nhập đều vào keychain của hệ thống, không bao giờ vào file hay hiện trên màn hình. Neova không kèm API key nào của riêng mình: thứ bạn trả tiền được tính thẳng cho bạn.
15 ngôn ngữCửa sổ app và thư viện mục kiểm tra bằng tiếng Anh, Pháp, Đức, Tây Ban Nha, Bồ Đào Nha, Ý, Nhật, Hà Lan, Ba Lan, Thổ Nhĩ Kỳ, Hàn, Trung, Nga, Indonesia và tiếng Việt.
Làm việc cùng
31 dịch vụ
Neova kết nối với 31 dịch vụ bạn đang dùng, từ Google Search Console đến Slack, Jira và cloud drive của chính bạn. Dịch vụ nào cũng tùy chọn.
Google
Google Search Console
Google Analytics
Chrome UX Report
Google Cloud
Gemini
Microsoft và Bing
Bing Webmaster Tools
OneDrive
Microsoft Teams
Dữ liệu SEO
DataForSEO
Semrush
Ahrefs
Majestic
Moz
SEO Gets
AI
Anthropic
OpenAI
Ollama
Ticket
Jira
Linear
Asana
ClickUp
monday.com
Cảnh báo và log
Slack
Microsoft Teams
Cloudflare
Tệp và lưu trữ
Google Drive
Dropbox
iCloud Drive
Proton Drive
kDrive
OneDrive
Mở lần crawl của họ
Screaming Frog
Sitebulb
Logo thuộc về chủ sở hữu của chúng và chỉ cho thấy Neova kết nối được với các dịch vụ này. Neova không liên kết với bất kỳ bên nào trong số đó.
Đặt cạnh nhau
78 tính năng
Mọi tính năng, mỗi công cụ một dấu. Hiện chi tiết thêm mô tả từng tính năng, kèm trang tài liệu của chính công cụ đó làm nguồn.
Crawl ở đâu và thế nàoScreaming Frog 15Sitebulb 13Semrush 10Ahrefs 10Lumar 13JetOctopus 13Neova 17trên 17
Tính năng
Screaming Frog
Sitebulb
Semrush
Ahrefs
Lumar
JetOctopus
Neova
App desktop
✓'Cần hệ điều hành 64-bit để chạy SEO Spider. nguồn
✓Chỉ Windows và macOS ('bản 64-bit của Windows 10 hoặc 11' nguồn
◐Trên server của bạnkhông có bản trình duyệt hay bản hosted. nguồn
✓Sitebulb CloudSitebulb Cloud: 'Sitebulb Cloud cho bạn mọi khả năng của bản Desktop, dùng qua trình duyệt web.' Mỗi khách hàng có một server dạng yoursite.sitebulb.cloud. nguồn
✓Ứng dụng webHoàn toàn trên trình duyệt: Semrush tự mô tả là 'nền tảng SaaS hàng đầu về quản lý mức hiện diện trực tuyến'. nguồn
✓Ứng dụng webSaaS trên trình duyệt: 'Chúng tôi cung cấp quyền truy cập Ứng dụng qua một trình duyệt web được hỗ trợ theo mô hình phần mềm dạng dịch vụ (SaaS) nguồn
✓Ứng dụng webNền tảng cloud chạy trên trình duyệt nguồn
✓Neova OnlineNeova Online trên mọi trình duyệt, chung tài khoản với app desktop, luôn đồng bộ
Kết xuất JavaScript
✓'Render trang web bằng Chromium WRS tích hợp để crawl các website và framework động, nặng JavaScript, như Angular, React và Vue.js.' Chỉ có với license trả phí. nguồn
✓'Chế độ crawl render JavaScript đã bao gồm trong giá gói (không tính phí riêng)', nhưng 'một trang render JS được tính bằng hai trang crawl thường'. nguồn
✓Chrome, cho mọi trang hoặc một số trang
Chế độ list
✓'Mode > List': 'kiểm tra một danh sách URL định sẵn... nguồn
✓Quy tắc 'Allow subfolders' và 'Disallow subfolders', cùng 'Parameters to ignore' để Site Audit bỏ tham số URL khi crawl. nguồn
✓Quy tắc regex: 'Only crawl URLs matching the pattern' và 'Don't crawl URLs matching the pattern', cùng 'Remove URL parameters' và quy tắc viết lại URL. nguồn
✓Trường 'Included Only URLs' và 'Excluded URLs' (regex Ruby nguồn
✓Quy tắc 'Allow Pattern' và 'Deny Pattern' trong thiết lập Advanced, dạng đường dẫn URL hoặc regex với tiền tố 'rx:' nguồn
✓Bao gồm, loại trừ, và một danh sách loại trừ cho mọi lần crawl
Giới hạn tốc độ crawl
✓'điều khiển tốc độ của SEO Spider, theo số luồng chạy đồng thời hoặc theo số URL yêu cầu mỗi giây' (mặc định 5 luồng). nguồn
✓Số luồng hoặc số phiên bản Chrome và 'Max HTML URLs per Second' nguồn
✓Tốc độ mặc định 'giới hạn tối đa 30 URL mỗi phút' nguồn
✓Tốc độ crawl tính theo URL mỗi giây (mức tối đa của tài khoản do Lumar đặt), và bạn có thể 'thêm giới hạn để giảm hoặc tăng tốc độ crawl vào những thời điểm nhất định'. nguồn
✓robots.txt Overwrite để 'kiểm tra một robots.txt mới trước khi đưa lên chạy thật' trên cả một lần crawl đầy đủ nguồn
✓Robots.txt Multi-tool miễn phí 'kiểm tra tính hợp lệ của file robots.txt, làm nổi bật các chỉ thị mâu thuẫn' và mô phỏng quy tắc theo từng bot nguồn
✓Công cụ kiểm tra robots.txt; tuân theo, bỏ qua hoặc dùng bản nháp
User agent tùy chỉnh
✓'các user agent có sẵn cho Googlebot, Bingbot, nhiều trình duyệt và hơn nữa' cùng user agent tùy chỉnh cho request HTTP và một Robots User-Agent riêng. nguồn
✓Các user agent có sẵn 'gồm Google, Bing, Yahoo và Yandex', cùng 'Custom User Agent' và một UA tùy chỉnh cho robots.txt. nguồn
◐xác thực basic ('đưa thông tin xác thực vào mọi request bằng xác thực basic'), DNS tùy chỉnh, danh sách IP cho phép và cookie đăng nhập qua header request tùy chỉnh nguồn
◐'Trong HTTP Auth, nhập User (tên đăng nhập) nguồn
✓Xác thực, header và form
Tạm dừng và tiếp tục
✓Tạm dừng và tiếp tục trong app ('Bạn có thể tiếp tục lần crawl nếu nó đã bị tạm dừng') nguồn
✓'Sitebulb cho phép bạn tạm dừng rồi tiếp tục bất cứ khi nào thuận tiện' nguồn
✓Không giới hạnFAQ: 'bạn có thể chạy các lần crawl, lớn và nhỏ, cùng một lúc' và 'Chúng tôi không giới hạn số tên miền khác nhau bạn có thể crawl'. nguồn
✓Không giới hạn'Số lần crawl đồng thời không giới hạn trên mọi gói JetOctopus, không tính thêm phí.' Dự án và tên miền cũng không giới hạn. nguồn
✓4 trong một cửa sổTối đa 4 website cùng lúc, mỗi website một tốc độ riêng, có bộ canh bộ nhớ (0.10.38)
Giới hạn URL
✓Không giới hạn, trả phíMiễn phí: 500 URL mỗi lần crawl. nguồn
✓Sơ đồ crawl và thư mục dạng force-directed (2D và 3D), đồ thị cây crawl và thư mục, word cloud, và sơ đồ cụm nội dung ngữ nghĩa (v22.0). nguồn
✓'Crawl map' tương tác ('Best Software Innovation' tại US Search Awards 2018), các kiểu trực quan hóa website khác, biểu đồ và dòng thời gian. nguồn
◐biểu đồ cùng góc nhìn 'Site Structure' về 'tên miền con và thư mục con, với số URL và số lỗi trong mỗi mục'. nguồn
✓'Trực quan hóa dữ liệu bằng biểu đồ và đồ thị' cho khả năng index, tốc độ tải, trùng lặp và mã trạng thái nguồn
◐biểu đồ phân tách, phễu và xu hướng trên dashboard và mọi báo cáo (tab 'Trends & Segments', 'Breakdown'). nguồn
✓'JetOctopus có hơn 97 báo cáo, 381 biểu đồ, 26 bộ dữ liệu' nguồn
✓Bản đồ crawl
So sánh lần crawl
✓'Mode > Compare' hiện URL Added, New, Removed và Missing theo từng tab và bộ lọc, một tab Change Detection và so sánh cấu trúc website (cần license và lưu trữ database nguồn
✓'Audit Comparison': 'Theo dõi thay đổi theo thời gian, tìm ra những gì khác so với lần audit trước' nguồn
✓'Compare Crawls' cho bạn 'xem bất kỳ lần audit nào trước đây trong một bản so sánh song song' với các lỗi Fixed và New nguồn
✓'Site Audit cho phép bạn so sánh hai lần crawl bất kỳ' nguồn
✓Mọi báo cáo đều so sánh với lần crawl trước nguồn
✓'Bạn có thể so sánh bất kỳ lần crawl nào, không chỉ hai lần gần nhất', với mọi biểu đồ và bảng dữ liệu của crawler, cả theo segment nguồn
✓HTML giống hệt, URL giống nhau về mặt kỹ thuật, title, description và H1 trùng lặp nguồn
✓'Nếu bot Site Audit phát hiện nhiều trang giống nhau 85% về nội dung, nó sẽ đánh dấu chúng là nội dung trùng lặp.' Title và description trùng lặp nguồn
✓Báo cáo trùng lặp về title, description, H1 và nội dung nguồn
✓'Duplicate Pages' có chung 'title, description giống hệt và nội dung gần như giống hệt' nguồn
✓Báo cáo 'Duplication' cho title, description, H1, H2 và nội dung chính, trong đó 'bạn có thể chọn tỷ lệ phần trăm trùng lặp' nguồn
✓Nội dung trùng lặp và gần trùng lặp
Nội dung mỏng
✓Mục kiểm tra 'Low Content Pages' trong nhóm Content, số từ mỗi trang, và 'Low Relevance Content'. nguồn
✓Regex Custom Extraction (30 chỉ số trích xuất) nguồn
✓'bạn có thể cấu hình tối đa 50 quy tắc trích xuất tùy chỉnh trong một lần crawl' nguồn
✓Tìm kiếm và trích xuất
AI xem xét nội dung trang
✓OpenAI, Gemini, Anthropic, OllamaTích hợp API trực tiếp với OpenAI, Gemini, Anthropic và Ollama (LM Studio qua tích hợp OpenAI) nguồn
◐MCP, chỉ đọckhông có prompt AI nào chạy trên nội dung trang trong lúc crawl. nguồn
◐Từng trang mộtContent Toolkit, mỗi lần một trang nguồn
◐Tác vụ có sẵnchỉ có các tác vụ AI cố định: 'Ask AI' và 'Batch AI' viết title và meta description (Project Boost), cùng tính năng phát hiện nội dung AI nguồn
◐Tích hợp sẵnkhông có prompt do người dùng viết chạy trên nội dung trang. nguồn
◐Tích hợp sẵn, MCPkhông có prompt của người dùng chạy trên từng trang nguồn
✓Ollama, Anthropic, OpenAI44 mục kiểm tra do AI xem xét, chạy bằng Ollama ngay trên máy tính của bạn; khóa Anthropic và OpenAI trong Kết nối
Độ tương đồng ngữ nghĩa
✓Vector embedding từ OpenAI, Gemini hoặc Ollama 'để nhận ra các trang tương đồng về ngữ nghĩa và nội dung ít liên quan, cũng như tìm kiếm ngữ nghĩa và sơ đồ cụm nội dung nguồn
◐không có sẵn. Một bài hướng dẫn trên website của họ (ngày 8 tháng 10 năm 2026, tác giả khách mời) nguồn
✓29Thư viện Hints: On Page 22 và Duplicate Content 7 (tổng 29), cùng báo cáo Spelling Errors và báo cáo độ dễ đọc. nguồn
✓Tổng cộng 140+'Có khả năng kiểm tra hơn 140 lỗi website' nguồn
✓Tổng cộng 170+'Quét hơn 170 lỗi' thuộc nhóm kỹ thuật và on-page, cùng lỗi tùy chỉnh nguồn
✓43 báo cáoKhông công bố tổng số. Con số do chúng tôi tự đếm từ danh sách báo cáo API của họ nguồn
✓Tổng cộng khoảng 100Khoảng 100: bản quét lỗi chạy 'khoảng 100 mục kiểm tra dựng sẵn trên crawl, log và Search Console, nhóm theo mức độ nghiêm trọng'. nguồn
✓8282 mục kiểm tra nội dung, 20 mục trong đó do AI xem xét
✓Lỗi 'Pages returning 4XX status code' và 'Pages returning 5XX status code', lỗi DNS và lỗi crawl, cùng thông báo cho link ngoài trả về 403. nguồn
✓Các trang không trả 200 được 'liệt kê dưới vấn đề tương ứng' (404, 4XX, 5XX, 403, hết thời gian chờ, redirect hỏng) nguồn
✓Báo cáo cho trang 200, redirect 301 và không phải 301, '4xx Errors', '5xx Errors', 'Uncategorized HTTP Response Codes' và URL lỗi nguồn
✓Biểu đồ và bảng dữ liệu mã trạng thái trong crawl và log nguồn
✓Có, tô màu ở mọi nơi
Redirect và chuỗi redirect
✓'Tìm redirect tạm thời và vĩnh viễn, phát hiện chuỗi và vòng lặp redirect' nguồn
✓13 gợi ý Redirects (redirect hỏng, vòng lặp redirect, redirect dấu gạch chéo cuối và chữ hoa thường, meta refresh) nguồn
✓'Redirect chains and loops' (Error), 'Pages with temporary redirects', 'URLs with a permanent redirect' nguồn
✓Vấn đề 'Redirect chain' 'báo cáo các URL dẫn đến một chuỗi redirect' nguồn
✓Các báo cáo 'Redirect Chains' ('redirect sang một URL khác cũng là redirect'), 'Redirect Loops', redirect hỏng, JavaScript và meta refresh, và 'Max Redirections'. nguồn
✓Bảng dữ liệu chuỗi redirect, nơi 'bạn cũng có thể đổi số bước trong chuỗi redirect' nguồn
✓22 mục kiểm tra redirect, chuỗi và vòng lặp
Canonical
✓Tab Canonicals bao gồm thẻ canonical và HTTP header nguồn
✓Lỗi 'Pages with a broken canonical link', 'Pages with multiple canonical URLs' và 'AMP pages with no canonical tag' nguồn
✓Các vấn đề như 'Canonical points to redirect', canonical trỏ đến 4XX hoặc 5XX, trang không canonical được khai báo làm canonical, và canonical lệch HTTP/HTTPS. nguồn
✓'Conflicting Canonical Tags' ('trong thẻ canonical HTML hoặc trong HTTP header'), Canonical to Non-200, Pages without Canonical Tag, Unlinked Canonical Pages, Change nguồn
✓Với rel=canonical, 'chúng tôi đã tạo vài báo cáo cho các vấn đề phổ biến nhất', cùng một chế độ riêng cho tên miền phụ mobile tách biệt. nguồn
✓Có
Báo cáo khả năng index
✓Mỗi URL là 'Indexable' hoặc 'Non-Indexable', kèm lý do trong 'Indexability Status' nguồn
✓'kiểm tra chỉ thị robots chồng chéo hoặc mâu thuẫn, vấn đề canonical và lỗi cấu hình robots.txt' nguồn
✓Kiểm tra khả năng crawl của các trang phân trang trong crawl và log nguồn
✓Mục kiểm tra phân trang
Hreflang
✓'Audit thẻ trả về bị thiếu, mã ngôn ngữ không nhất quán và sai, hreflang trả mã khác 200 và hơn thế' nguồn
✓'kiểm tra thẻ hreflang hợp lệ, hai chiều, duy nhất, nhất quán và tự tham chiếu' nguồn
◐Báo cáo International SEO kiểm tra xung đột, giá trị, link hỏng và thẻ thiếu, nhưng 'hiện tại Semrush chỉ kiểm tra HTML của website' (không kiểm tra sitemap hay header). nguồn
✓Đánh dấu mã sai, thiếu tự tham chiếu, thiếu thẻ trả về, hreflang trỏ đến trang hỏng hoặc không canonical nguồn
✓Mục kiểm tra sitemap: 'URLs Not In Sitemap', 'Orphan URLs', 'Non-Indexable URLs In Sitemap', 'XML Sitemap With Over 50k URLs', 'XML Sitemap Over 50mb', 'URLs In Multiple Sitem nguồn
✓9 gợi ý XML Sitemaps (4XX, 5XX, noindex, đã canonical sang URL khác, bị disallow, redirect, hết thời gian chờ, URL trong nhiều sitemap), phát hiện trang mồ côi và công cụ tạo sitemap XML. nguồn
✓Các lỗi như 'Format errors in sitemap.xml files', 'Incorrect pages found in sitemap.xml', 'Sitemap.xml files are too large' nguồn
✓Các vấn đề sitemap như 'Non-canonical page in sitemap', trang noindex, 3XX, 4XX hoặc 5XX trong sitemap, trang sitemap hết thời gian chờ và sai định dạng (chỉ XML). nguồn
✓URL không index được, lỗi và redirect trong sitemap, sitemap hỏng hoặc bị disallow, quá nhiều URL, sitemap trống nguồn
✓Báo cáo sitemap với URL mồ côi và URL khác 200, 'Sitemaps problems by depth' và bảng 'Sitemap files' nguồn
✓20 mục kiểm tra sitemap XML
Internal link và Link Score
✓'Phân tích internal link, số lượng link, độ sâu crawl và tính Link Score nội bộ' nguồn
✓'URL Rank, hay UR, đo sức mạnh nội bộ của trang dựa trên trọng số link tương đối' nguồn
✓Báo cáo Internal Linking và ILR cho từng trang nguồn
✓Page Rating (PR) chấm sức mạnh link của mỗi URL 'trên thang logarit từ 1 đến 100' nguồn
✓DeepRank: 'thước đo trọng số internal link, tính theo cách tương tự thuật toán PageRank cơ bản của Google', thang từ 0 đến 10 nguồn
◐phân tích link chuyên sâu (link trỏ đến, anchor, nofollow, Linking Explorer) nguồn
✓Link Score và 51 mục kiểm tra link
Trang mồ côi
✓'Để tìm trang mồ côi cần thêm nguồn URL, lấy từ sitemap XML và tích hợp API Google Analytics và Search Console.' nguồn
✓Trang mồ côi là 'URL được phát hiện trong audit nhưng KHÔNG phải bởi crawler', tìm qua sitemap XML, Google Analytics, Search Console hoặc danh sách URL nguồn
✓Thông báo 'Orphaned pages (from Google Analytics)' và 'Orphaned pages (in sitemap)' nguồn
◐'Orphan page' bao gồm các URL không có internal link trỏ đến, đến từ URL khởi đầu crawl hoặc 'tìm thấy trong file sitemap' nguồn
✓Báo cáo cấu hình mobile (responsive, dynamic, mobile tách biệt), 'Discouraged Viewport Types' ('tương thích mobile kém'), lệch nhau giữa bản mobile tách biệt nguồn
✓Một lần crawl bằng Googlebot Mobile 'làm lộ các vấn đề trải nghiệm mobile' như 'cấu hình viewport sai, cỡ chữ không đạt, vùng chạm' nguồn
✓Mục kiểm tra viewport và mobile
Hình ảnh
✓Thiếu alt text và thuộc tính alt, 'Over 100 kb', alt text dài hơn 100 ký tự, 'Incorrectly Sized Images', 'Missing Size Attributes', ảnh nền, missing image t nguồn
✓Các gợi ý như 'Images with missing alt text', 'Has an anchored image with no alt text', 'Transferred image size is over 100KB', 'Properly size images', 'Add dimensions to images', next nguồn
✓'Chúng tôi xem xét kích thước ảnh, thời gian tải và loại nội dung', ảnh hỏng và thuộc tính alt ('Set' và 'Not set') nguồn
✓'Broken Images', 'Links with Images Missing Alt Tags', luật image-alt về khả năng tiếp cận, và các audit ảnh của Lighthouse trong Site Speed (thiếu kích thước, ngoài màn hình, chưa tối ưu, non-resp nguồn
✓20 mục kiểm tra hình ảnh, và lấy mẫu ảnh theo nhóm trang
Tốc độ và Core Web VitalsScreaming Frog 3Sitebulb 1Semrush 1Ahrefs 4Lumar 4JetOctopus 3Neova 4trên 4
Tính năng
Screaming Frog
Sitebulb
Semrush
Ahrefs
Lumar
JetOctopus
Neova
Lighthouse
✓'Kết nối API PSI để lấy chỉ số Lighthouse, cơ hội cải thiện tốc độ, chẩn đoán và Chrome User Experience Report (CrUX) nguồn
✓Lighthouse 'Opportunities and Diagnostics' chạy 'trên từng trang web được crawl' bởi Chrome Crawler tích hợp, cùng chỉ số lab Web Vitals (LCP, CLS, TBT, TTI, FCP nguồn
✓Báo cáo Core Web Vitals 'chạy bằng công cụ Lighthouse của Google' (LCP, CLS, TBT) nguồn
✓PageSpeed Insights cho từng trang, bằng khóa Google API miễn phí của chính bạn nguồn
✓Trong Site Speed: 'chỉ số hiệu suất Lighthouse ở quy mô lớn', với báo cáo cơ hội và chẩn đoán cho từng trang và một Lighthouse Viewer nhúng sẵn (tháng 6 năm 2025). nguồn
✓PageSpeed API bằng khóa của bạn ('Giới hạn của bạn là 30,000 yêu cầu mỗi ngày') nguồn
◐Google Sheet 'Historical Audit Data' có một dòng cho mỗi lần audit để làm 'dữ liệu chuỗi thời gian hoặc biểu đồ' trong Looker Studio, và có giá trị mức Core Web Vitals (changelog, 13 nguồn
◐không thấy báo cáo bot AI hay thiết lập sẵn cho bot AI nguồn
✓'Blocked from AI Search' kiểm tra robots.txt cho ChatGPT-User, OAI-SearchBot, Googlebot, Google-Extended, Perplexity-User, PerplexityBot, Claude-User, Claude-SearchBot. nguồn
✓Các vấn đề AI Discoverability (tháng 9 năm 2026) nguồn
✓'ChatGPT Blocked' ('bị chặn trong robots.txt với token user agent GPTBot hoặc ChatGPT-User'), Google AI Blocked (Google-Extended), Bing AI Blocked, AI Bot Blocked, Common nguồn
✓Robots.txt Multi-tool miễn phí giúp 'kiểm tra luật truy cập cho bot tìm kiếm và bot AI ở một nơi', gồm GPTBot, ClaudeBot và PerplexityBot. nguồn
✓Mỗi bot AI được phép tải gì, và 10 trợ lý AI thực sự nhận được gì
◐không có mục kiểm tra riêng cho câu trả lời AI. nguồn
◐không có mục kiểm tra cho câu trả lời AI. Báo cáo Response vs Render được giới thiệu là để 'xác định chính xác những gì LLM nhìn thấy' nguồn
✓Mục kiểm tra AI Search: 'Too much content', 'Outdated Content' (Last-Modified quá sáu tháng), 'Low Semantic HTML Usage', 'Content not optimized' (heading, đoạn văn dài, r nguồn
✓AI Discoverability: trang 'quá chậm hoặc quá nặng với bot AI', 'Pages requiring JavaScript rendering', 'Similar AI-generated content' nguồn
✓AI Page Optimizer sẽ 'đối chiếu từ khóa mục tiêu với title, meta và nội dung chính' cho các truy vấn mở rộng (query fan-out), và kiểm tra 'liệu JavaScript có giấu nội dung của bạn khỏi agent AI không'. nguồn
✓GA4 và GA360: lượt truy cập, tỷ lệ thoát, lượt xem trang và chuyển đổi cho từng URL, lọc được theo organic, 'Google or Bing Organic Search Landing Pages, or All' nguồn
✓'tích hợp chỉ hoạt động với Google Analytics 4. nguồn
◐Bingbot trong log và công cụ kiểm tra robots.txt ('dữ liệu đầy đủ về Googlebot, Bingbot, GPTBot, ClaudeBot và hơn 40 crawler khác') nguồn
✓Bing Webmaster Tools, gồm cả trích dẫn trong Bing AI
Theo dõi thứ hạng
◐không có công cụ theo dõi thứ hạng. Tích hợp GSC Search Analytics cho 'Position' trung bình của từng URL. nguồn
◐không có công cụ theo dõi thứ hạng. Báo cáo Keywords dùng dữ liệu GSC nguồn
✓Position Tracking 'theo dõi thứ hạng tìm kiếm của website mỗi ngày' theo thiết bị và vị trí 'đến tận mã bưu chính', trên Google, Bing, Baidu, ChatGPT Search và AI Mode. nguồn
✓Rank Tracker: Google, 'theo dõi trên mobile và desktop', hơn 190 địa điểm đến tận mã ZIP, 19 tính năng SERP nguồn
◐không có công cụ theo dõi thứ hạng; chỉ vị trí GSC theo trang và truy vấn. nguồn
◐Thứ hạng dựa trên GSC, không có công cụ theo dõi thứ hạng SERP nguồn
✓25 lượt tìm kiếm được theo dõi mỗi ngày từ Search Console; vị trí thật qua DataForSEO
Dữ liệu từ khóa
◐Chỉ số GSC Search Analytics cho từng URL (tùy chỉnh khoảng ngày và chiều dữ liệu) nguồn
✓Báo cáo Keywords xây từ Google Search Console ('bật Keyword Analysis'), có từ khóa thương hiệu. nguồn
✓Position Tracking: 'Competitors Discovery Report cho thấy các đối thủ organic đang xếp hạng cho từ khóa của bạn' nguồn
✓Dự án mới 'nhận gợi ý đối thủ dựa trên các website xếp hạng cho từ khóa tương tự' nguồn
✓Trong AI Visibility: 'thương hiệu được tự động phát hiện từ câu trả lời của nhà cung cấp AI' và Lumar xếp mỗi thương hiệu vào Own, Competitor, Other hoặc Context. nguồn
✓'New scheduled crawl' với tần suất hằng ngày, hằng tuần, hai tuần một lần hoặc hằng tháng, ngày bắt đầu và múi giờ nguồn
✓Lịch có báo trước, Hoãn và Bỏ qua (app desktop)
Phát hiện thay đổi
✓Tab 'Change Detection' ở chế độ Compare cho các yếu tố bạn chọn (title, description, H1, số từ và hơn thế) nguồn
✓'Lost and Found so sánh các chỉ số URL chính và gợi ý xuất hiện trong lần audit hiện tại với lần audit gần nhất trước đó' (Found, Lost, Remained) nguồn
◐so sánh giữa các lần crawl, và báo cáo Robots.txt 'sẽ cho bạn biết nếu Semrush nhận thấy thay đổi trong file robots.txt'. nguồn
✓Always-on audit: 'giờ bạn có thể xem mọi thay đổi trên website vào bất kỳ ngày nào' nguồn
✓Changed Metrics cho thấy 'chỉ số nào đã thay đổi giữa các lần crawl' theo từng URL, cùng các báo cáo như Pages with Changed Title, Status Code và Canonical URLs. nguồn
✓Cảnh báo cùng custom extraction để 'theo dõi thay đổi của yếu tố on-page và xem chúng có khớp giá trị mong đợi không' nguồn
✓Thay đổi nội dung giữa các lần crawl; thay đổi sáng lên ngay khi đang crawl
Cảnh báo và thông báo
✓Email khi crawl xong qua Outlook, Gmail hoặc SMTP tùy chỉnh, kèm bảng Issues nguồn
✓'Sitebulb sẽ gửi bạn một email thân thiện mỗi khi audit xong' (đặt theo từng dự án, cho phép nhiều địa chỉ). nguồn
✓Site Audit gửi 'email cập nhật tự động' khi chạy theo lịch nguồn
✓Always-on audit gửi email 'nếu một trang mới bị ảnh hưởng bởi vấn đề mức lỗi' (cả vấn đề tùy chỉnh), cùng email khi crawl xong, báo cáo Rank Tracker và Ahrefs Alerts. nguồn
◐Báo cáo PDF tùy chỉnh được theo từng phần, và một khách hàng được trích trên trang tính năng của họ khen 'PDF và báo cáo CSV white-label hoàn toàn' nguồn
✓Có, với add-on Pro Report ($20/tháng mỗi báo cáo) nguồn
–'Hiện tại chúng tôi không cho phép white-label báo cáo.' nguồn
◐FAQ: 'giao diện có thể white-label bằng logo của bạn'. nguồn
✓Xuất CSV dạng bảng tính, xuất Google Sheets (Keywords Explorer, Brand Radar, Bot Analytics), connector Looker Studio cho Site Audit, Site Explorer, Rank Tra nguồn
✓Tải báo cáo CSV (cùng CSV with Exploded Metric cho Excel), connector Looker Studio của 'Google Partner chính thức' kèm template, và dashboard Google Sheets qua Zapi nguồn
✓Xuất ra 'Excel, Google Sheets, CSV hoặc Google Data Studio (Looker)' nguồn
✓File Excel (mở được trong Google Sheets), CSV sẵn cho Looker Studio
Nơi xuất
✓Thư mục trên máy; Google Drive dưới dạng Google Sheets (thủ công hoặc theo lịch nguồn
✓Xuất CSV và .xlsx, tự lưu sau mỗi lần audit vào thư mục trên máy 'HOẶC một thư mục lưu dùng chung, như dịch vụ lưu trữ đám mây Dropbox' nguồn
✓Tải CSV, Google Sheets (một số báo cáo), PDF qua lệnh in, connector Looker Studio, cùng API v3 và MCP nguồn
✓Tải báo cáo CSV hoặc XML, dữ liệu thô dạng file Parquet, connector BigQuery và Looker Studio, Google Sheets qua Zapier, công cụ BI (Tableau, Power BI), API và webhook nguồn
✓File CSV, Excel, Google Sheets và sitemap từ bảng dữ liệu, cùng connector Data Studio, BigQuery ('xuất dữ liệu crawl và GSC thẳng vào BigQuery'), API và MCP. nguồn
✓Google Drive, OneDrive, Dropbox, iCloud Drive, Proton Drive, kDrive, SFTP hoặc FTPS, bất kỳ thư mục nào
Dashboard tùy chỉnh
✓Tab Dashboard của v25.0: 'tự dựng dashboard tùy chỉnh' từ các widget (biểu đồ, bộ đếm, tỷ lệ phần trăm, bảng tổng quan, danh sách vấn đề, biểu đồ phân đoạn...) nguồn
✓API v3 từ gói Lite trở lên, 200,000 đến 2,000,000 đơn vị/tháng, với endpoint Site Audit, Site Explorer, Keywords Explorer, Rank Tracker và Brand Radar. nguồn
✓'Lumar GraphQL API dành cho mọi người dùng', theo 'chính sách sử dụng hợp lý' nguồn
✓Mọi gói: 'dùng mọi chức năng thiết yếu của JetOctopus, gồm tạo dự án và lần crawl, dữ liệu biểu đồ, bảng dữ liệu và xuất dữ liệu'. nguồn
✓REST API của Neova Online với khóa API (0.10.38), cùng MCP server và dòng lệnh
◐Mỗi người một giấy phépgiấy phép tính theo người dùng ('Nếu đội của bạn có năm người muốn dùng SEO Spider, bạn cần 5 giấy phép'), giảm giá từ 5 giấy phép. nguồn
✓2 đến 10+ người dùngGói Cloud có sẵn người dùng (Mini 2, Small 5, Medium 10, Enterprise 10+) nguồn
✓Từ $45 mỗi người dùng'Người dùng thêm từ $45/tháng' nguồn
✓Từ $40 mỗi người dùngCó 1 người dùng; người dùng thêm tính phí nguồn
✓4 vai trò, SSOVai trò trong nhóm 'Admin, Editor, Reporter và Viewer' với quyền theo từng app nguồn
✓Không giới hạn người dùng'Dự án và chỗ ngồi (người dùng) nguồn
Sắp cóSắp có. Hiện mỗi tài khoản một người
Ngôn ngữ giao diện
✓7'Giao diện có bằng tiếng Anh, Tây Ban Nha, Đức, Pháp, Ý, Hà Lan và Thổ Nhĩ Kỳ' (7 ngôn ngữ nguồn
◐Log File Analysermột sản phẩm riêng, Screaming Frog Log File Analyser (Windows, macOS, Linux), để 'xác minh bot của công cụ tìm kiếm và bot AI'. nguồn
–Sắp cóFAQ: 'Sitebulb chưa phân tích file log, nhưng tính năng này đang được phát triển và sẽ sớm có!' nguồn
✓EnterpriseCó, là một sản phẩm Enterprise riêng nguồn
◐Bot AnalyticsBot Analytics, một công cụ riêng miễn phí trong giai đoạn beta cho gói trả phí, 'nhận dữ liệu request HTTP' từ Cloudflare, Vercel, CloudFront, load balancer của AWS hoặc Fastly nguồn
◐Đã bao gồmcó, nhưng từ bản tóm tắt theo từng URL nguồn
✓Đã bao gồmCó trong mọi gói, không phải sản phẩm riêng nguồn
✓Đã bao gồmCó sẵn: log Apache và Nginx, đọc thẳng từ Cloudflare, chỉ tính bot đã xác minh
Staging và migration
✓'So sánh môi trường staging với production bằng URL Mapping nâng cao' nguồn
✓Crawl website staging với xác thực HTTP hoặc form và thiết lập robots đã chỉnh, rồi so sánh audit giữa 'hai Projects bất kỳ'. nguồn
✓Có, trong Semrush Enterprise Site Intelligence nguồn
◐'Crawl website staging và website giới hạn truy cập... nguồn
✓'crawl môi trường staging hoặc test và so sánh với website đang chạy', với Test Site Domain, DNS tùy chỉnh, basic auth và ghi đè robots.txt. nguồn
✓'So sánh lần crawl của website staging và website thật giúp bạn dựng một phiên bản chạy tốt, không lỗi' nguồn
✓Staging so với production, và bản đồ redirect
Mở file xuất của crawler khác
◐chế độ list đọc URL từ mọi file .txt, .xls, .xlsx, .csv hoặc .xml ('bạn có thể tải thẳng một file tải về từ Adwords') nguồn
✓Từ $29 mỗi thángChỉ cloud: Starter $29/tháng, Lite $129, Standard $249, Advanced $449, Enterprise theo yêu cầu nguồn
–Theo yêu cầuKhông công bố giá: 'Chúng tôi định giá giải pháp theo nhu cầu riêng của bạn. nguồn
✓Từ $349 mỗi thángChỉ cloud, giá theo tháng khi trả theo năm (in-house) nguồn
✓Từ $19 mỗi thángCó gói miễn phí; gói trả phí từ $19 mỗi tháng (giá tại Mỹ)
✓Có◐Một phần–Các công cụ khác: không có, hoặc không thấy trong tài liệu của họ–Neova: chưa cóSắp cóNeova: sắp cóMỗi câu trả lời về các công cụ khác đều có link đến trang trên website hoặc tài liệu của chính họ.
Những gì Neova không làm
Neova không có cơ sở dữ liệu từ khóa hay backlink riêng: Ahrefs, Semrush, SE Ranking và Moz giữ cơ sở dữ liệu của họ, còn Neova dùng khóa của bạn và Search Console của bạn. Hãy dùng Neova cùng các bộ công cụ đó, không phải thay cho chúng.
Sắp có: tài khoản nhóm và cảnh báo qua email (hiện cảnh báo đến qua hệ thống, Neova Go, Slack và Microsoft Teams).
Chưa có so sánh độ tương đồng ngữ nghĩa.
Các cột Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar và JetOctopus: chỉ những gì website và tài liệu của chính họ ghi, đọc vào ngày 11 tháng 11 năm 2026, kèm link đến từng trang. "Không thấy trong tài liệu của họ" nghĩa là chúng tôi không tìm thấy, không có nghĩa là không làm được. Cột Neova: những gì Neova và Neova Online làm được hôm nay, đọc từ app. 141 mục kiểm tra của Neova không có trong danh sách công khai nào của 10 công cụ SEO chúng tôi đã so sánh (Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar, Moz, SE Ranking, Seobility, Sitechecker và Conductor): mỗi danh sách được đối chiếu từng mục với thư viện của Neova vào ngày 25 tháng 10 năm 2026. 67 mục kiểm tra thêm từ đó đến nay chưa được tính cho đến khi được so sánh. Các tên này là nhãn hiệu của chủ sở hữu; Neova không liên kết với bên nào. Nếu một dòng sai hoặc đã cũ, hãy viết cho hello@neova.app và chúng tôi sẽ sửa.




 Google Search Console
 Google Analytics
 Chrome UX Report
 Google Cloud
 Gemini
 Bing Webmaster Tools
 OneDrive
 Microsoft Teams
 DataForSEO
 Semrush
 Ahrefs
 Majestic
 Moz
 SEO Gets
 Anthropic
 OpenAI
 Ollama
 Jira
 Linear
 Asana
 ClickUp
 monday.com
 Slack
 Cloudflare
 Google Drive
 Dropbox
 iCloud Drive
 Proton Drive
 kDrive
 Screaming Frog
 Sitebulb
 Lumar
 JetOctopus