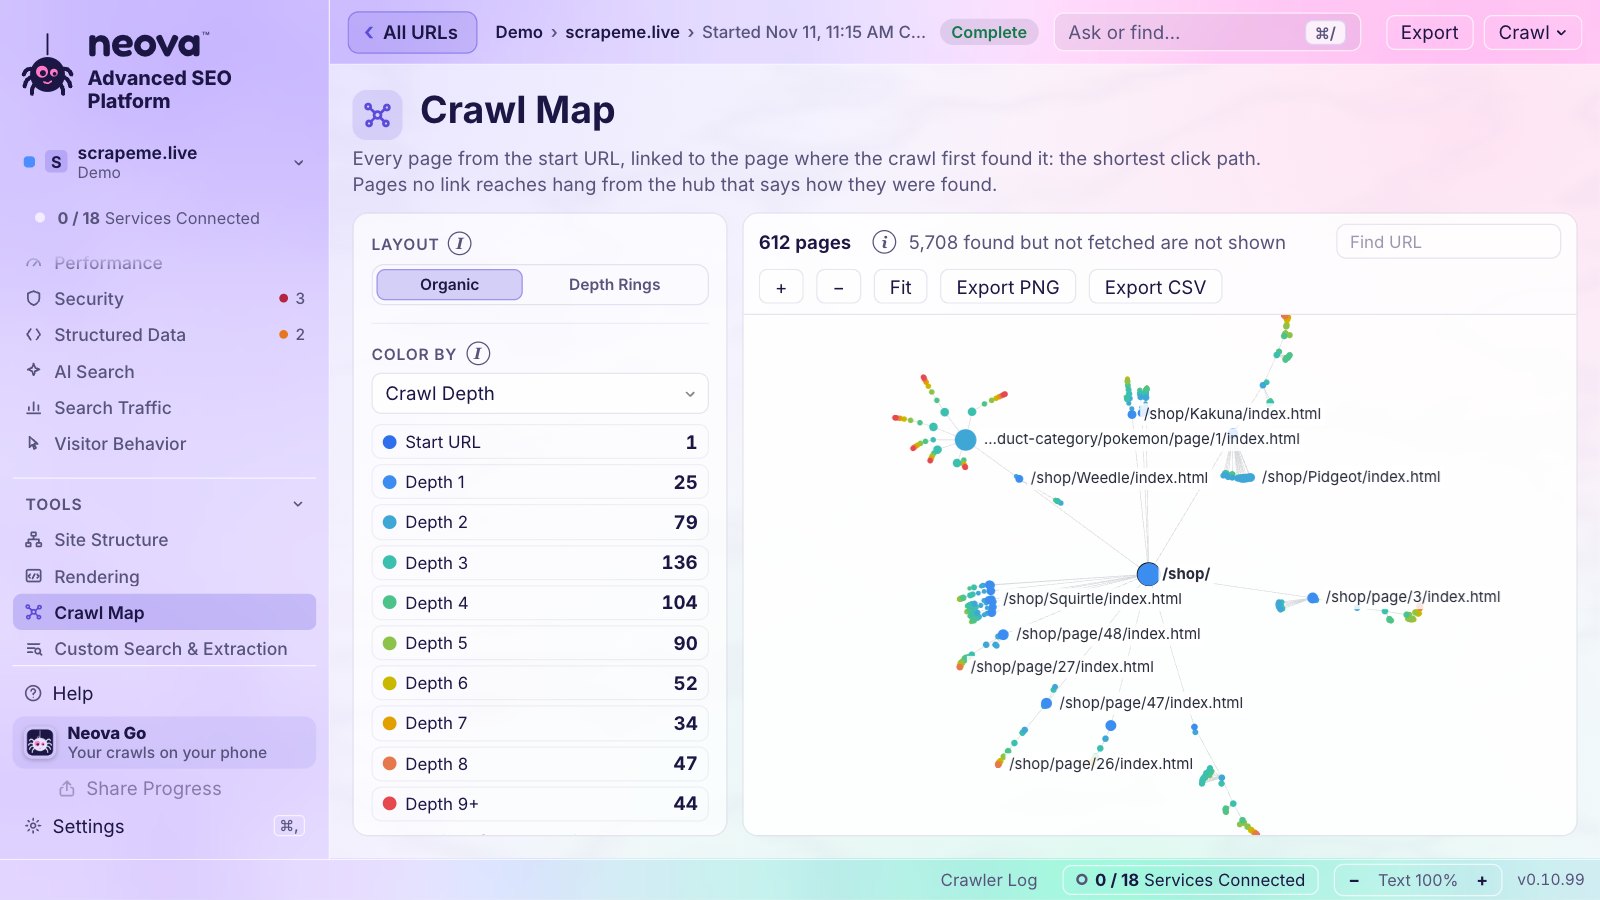
デスクトップアプリ ✓ 「SEO Spiderの実行には64ビットのOSが必要です」出典 ✓ WindowsとmacOSのみ (「Windows 10または11の64ビット版」)出典 – ドキュメントには見当たりません。出典 – Webアプリのみ、インストール不要出典 – クラウドのみのSaaS、デスクトップアプリなし出典 – クラウドのSaaSのみ、デスクトップアプリなし出典 ✓ Mac (Appleシリコン)、Windows、Linux ブラウザで ◐ 自社サーバーで ブラウザ版やホスティング版はありません。出典 ✓ Sitebulb Cloud Sitebulb Cloud:「Sitebulb Cloudでは、デスクトップ版のすべての機能をWebブラウザから使えます」。顧客ごとに yoursite.sitebulb.cloud のようなサーバーが用意されます。出典 ✓ Webアプリ 完全にブラウザベース:Semrushは自社を「オンラインでの可視性を管理する、業界をリードするSaaSプラットフォーム」と説明しています。出典 ✓ Webアプリ Ahrefsはクラウドのみ出典 ✓ Webアプリ ブラウザベースのSaaS:「当社は、対応するWebブラウザを通じて、SaaS (サービスとしてのソフトウェア) の形でアプリケーションへのアクセスを提供します」出典 ✓ Webアプリ ブラウザベースのクラウドプラットフォーム出典 ✓ Neova Online どのブラウザでもNeova Online。デスクトップアプリと同じアカウントで、常に同期 JavaScript レンダリング ✓ 「内蔵のChromium WRSでWebページをレンダリングし、Angular、React、Vue.jsなどのフレームワークを使った、JavaScriptを多用する動的なサイトをクロールします」。有料ライセンスのみ。出典 ✓ Chrome Crawler:「SitebulbはGoogleと同じく、Evergreen Chromiumのレンダリングエンジンを使っています」出典 ✓ あり。GuruまたはBusinessプラン (Semrush One Pro+またはAdvanced)出典 ✓ クロール設定の「Execute JavaScript」出典 ✓ Page Rendering Service出典 ✓ 「JavaScriptレンダリングのクロールモードはプランの料金に含まれます (追加料金なし)」。ただし「JSでレンダリングした1ページは、通常のクロール2ページ分として数えます」。出典 ✓ Chromeで、すべてのページまたは指定した数のページを リストモード ✓ 「Mode > List」:「あらかじめ用意したURLのリストをチェック…」出典 ✓ クロールのソース「URL List」出典 ✓ クロールのソース「Import URLs from file」出典 ✓ 開始URLのソース「Custom URL list」出典 ✓ クロールのソースとしてのURLリスト出典 ✓ クロールモード「URL list」出典 ✓ リストクロール XMLサイトマップのクロール ✓ 「XMLサイトマップを単独で、またはクロールの一部としてクロールし、不足しているページ、インデックス不可のページ、孤立ページを見つけます」出典 ✓ Crawl Sourcesは「XMLサイトマップのURLや、指定したURLリストもクロールするように設定できます」。出典 ✓ クロールのソース「Robots.txt sitemap」と「Sitemap by URL」。ただし「Site Auditが一度に使うサイトマップのURLは1つです」出典 ✓ URLのソースとして「Auto-detected sitemaps」または「Specific sitemaps」出典 ✓ クロールのソースとしてのサイトマップ。単独でも、Webクロールと一緒でも出典 ✓ クロールモード「Only Sitemap」、または追加のURLソースとしてのサイトマップ出典 ✓ XMLサイトマップをクロールに含めて、または単独で 対象と除外のルール ✓ 正規表現の「Configuration > Include」と「Configuration > Exclude」出典 ✓ 「Include & Exclude URLs」の設定出典 ✓ 「Allow subfolders」と「Disallow subfolders」のルール、さらにクロール中にURLパラメータを取り除く「Parameters to ignore」。出典 ✓ 正規表現のルール「Only crawl URLs matching the pattern」と「Don't crawl URLs matching the pattern」、さらに「Remove URL parameters」とURLの書き換えルール。出典 ✓ 「Included Only URLs」と「Excluded URLs」の欄 (Rubyの正規表現)出典 ✓ 詳細設定の「Allow Pattern」と「Deny Pattern」のルール。URLのパス、または接頭辞「rx:」つきの正規表現で指定出典 ✓ 対象、除外、そしてクロールごとの除外リスト クロール速度の制限 ✓ 「同時スレッド数、または1秒あたりのリクエストURL数でSEO Spiderの速度を制御」(初期値は5スレッド)。出典 ✓ スレッド数またはChromeのインスタンス数と「Max HTML URLs per Second」出典 ✓ 3種類のクロール間隔の設定出典 ✓ 初期設定の速度は「1分あたり最大30 URLに制限」出典 ✓ クロール速度は1秒あたりのURL数 (アカウントの上限はLumarが設定)。「特定の時間帯にクロール速度を下げたり上げたりする制限を追加」もできます。出典 ✓ 「速度 (スレッド数) はご自身で選べます」出典 ✓ 1秒あたりのリクエスト数。サイトが苦しくなると速度を落とします robots.txtテスター ✓ 「サイトのrobots.txtをダウンロード、編集、テストできる、カスタムのrobots.txt設定」出典 ◐ 「Virtual robots.txt」で、公開中のファイルを取得して編集し、自分の版でクロールできます出典 ◐ URLのテスターはありません。Robots.txtレポートは、ファイルの問題と「robots.txtファイルへのあらゆる変更」にフラグを立てます出典 ◐ robots.txtテスターはありません。出典 ✓ robots.txt Overwriteで「新しいrobots.txtを公開前にテスト」でき、クロール全体に適用されます出典 ✓ 無料のRobots.txt Multi-toolが「robots.txtファイルを検証し、矛盾するディレクティブを強調表示」し、ボットごとにルールをシミュレートします出典 ✓ robots.txtテスター。従う、無視する、下書きを使う カスタムのユーザーエージェント ✓ 「Googlebot、Bingbot、各種ブラウザなどのユーザーエージェントのプリセットを内蔵」。さらにカスタムのHTTPリクエストのユーザーエージェントと、別のRobots User-Agent。出典 ✓ 「Google、Bing、Yahoo、Yandexを含む」プリセット、さらに「Custom User Agent」とrobots.txt用のカスタムUA。出典 ◐ 固定の3つの選択肢のみ出典 ◐ AhrefsSiteAuditの2つの文字列のみ出典 ✓ 「幅広いユーザーエージェント…」出典 ◐ プリセットのみ。「ユーザーエージェントは全部で5種類です」出典 ✓ あらゆるユーザーエージェント、そしてAIクローラーとしてのクロール ログインと認証 ✓ 「2種類の認証。ベーシック認証とダイジェスト認証を含む標準ベースの認証と、Webフォームベースの認証」出典 ✓ HTTP認証とフォームベースの認証、さらにカスタムのHTTPヘッダー。出典 ◐ ベーシック認証のみ。「ベーシック認証で隠された」サイト向けの「Crawl with my credentials」、さらにWeb Bot Authの署名オプション。出典 ◐ HTTP認証のみ、Advanced以上のプラン出典 ◐ ベーシック認証 (「すべてのリクエストにベーシック認証の資格情報を含める」)、カスタムDNS、IPの許可リスト、カスタムのリクエストヘッダーによるログインCookie出典 ◐ 「HTTP Authで、User (ログイン) を入力…」出典 ✓ 認証、ヘッダー、フォーム 一時停止と再開 ✓ アプリ内で一時停止と再開 (「一時停止したクロールは再開できます」)出典 ✓ 「Sitebulbでは一時停止して、都合のよいときに再開できます」出典 – ドキュメントには見当たりません。出典 – ドキュメントには見当たりません。出典 ✓ クロールの上限に達すると、「クロール設定を調整する、クロールを再開する、または確定する」ことができます出典 ✓ 実行中のクロールは一時停止と再開ができます出典 ✓ 一時停止、再開、そして終了時はまずクロールを保存 複数サイトの同時クロール ✓ サイトごとに1ウィンドウ FAQ:「クロールしたいドメインごとにSEO Spiderを1つずつ、複数起動してください」、またはドメインのリストでリストモードを使います。出典 ◐ Cloud:Medium以上 デスクトップ版は監査をキューに入れます (「順番に実行されます」)出典 ✓ 最大5件 「Number of Audits Running at Once」出典 – ドキュメントには見当たりません。出典 ✓ 制限なし FAQ:「大小のクロールをすべて同時に実行できます」、「クロールできるドメインの数に制限はありません」。出典 ✓ 無制限 「JetOctopusのすべてのプランで同時クロール数は無制限、追加料金もありません」。プロジェクトとドメインの数も無制限です。出典 ✓ 1ウィンドウで4件 最大4サイトを同時に、それぞれの速度で、メモリガードつき (0.10.38) URLの上限 ✓ 無制限(有料版) 無料版:1回のクロールで500 URL。出典 ✓ 1万~1,000万 Liteは「1回の監査で10,000 URL」出典 ✓ 2万~10万 1回の監査あたり:無料は100、ProとGuruは20,000、Businessは100,000。出典 ✓ 2.5万~500万 月ごとのクロールクレジット出典 ◐ プランごとに設定 プランの上限は公開されていません出典 ✓ 100M+ 「1億URLを超えるサイトもクロールできます」出典 ✓ 制限なし パソコン上では、私たちによる上限はありません クロールトラップをライブで検出 ◐ トラップ専用のレポートはありません。出典 ◐ Hintの「URL contains repetitive elements」(「通常、クローラーが相対URLのリンクに出会ったときに起こります」)出典 – ドキュメントには見当たりません。出典 ◐ トラップの検出はなく、設定できる上限で抑えます出典 ✓ 「Pages with Repeated Pathsレポートは、不正なリンクが無限のURLを生むことで起こるスパイダートラップを特定します」出典 ◐ スパイダートラップ専用のレポートはありません出典 ✓ 検出:毎分、新しいURLの出どころ、クロールトラップのフラグ、そしてクロール中の「残す」「スキップ」「除外」 ページグループ ✓ 「Configuration > Segments」出典 ◐ HTMLテンプレートによる自動グループ化で「テンプレートごとにSEOの問題を分類」出典 ✓ あり。Semrush EnterpriseのSite Intelligenceで出典 ✓ フィルター (サブフォルダ、サブドメイン) による「Segment crawls」出典 ✓ セグメンテーション:「Lumarの豊富な指標をもとにカスタムセグメントを作成」。セグメントの推移とMonitorのアラートつき出典 ✓ 「セグメントの数に制限はありません」出典 ✓ HTMLから見つけたページグループと、セグメント クロールの可視化 ✓ 力学モデルによるクロール図とディレクトリ図 (2Dと3D)、クロールとディレクトリのツリーグラフ、ワードクラウド、意味的なコンテンツクラスター図 (v22.0)。出典 ✓ インタラクティブな「クロールマップ」(US Search Awards 2018の「Best Software Innovation」受賞)、その他のサイトの可視化、グラフ、タイムライン。出典 ◐ グラフと、「サブドメインとサブフォルダ、それぞれのURL数と問題の数」を示す「Site Structure」ビュー。出典 ✓ インデックス可能性、読み込み速度、重複、ステータスコードについて「データをグラフで可視化」出典 ◐ ダッシュボードとすべてのレポートに内訳、ファネル、推移のグラフ (「Trends & Segments」「Breakdown」タブ)。出典 ✓ 「JetOctopusには97以上のレポート、381のグラフ、26のデータセットがあります」出典 ✓ クロールマップ クロールの比較 ✓ 「Mode > Compare」で、タブとフィルターごとにAdded、New、Removed、MissingのURL、Change Detectionタブ、サイト構造の比較を表示 (ライセンスとデータベース保存が必要)出典 ✓ 「Audit Comparison」:「時間とともに変化を追跡し、前回の監査から何が変わったかを確認」出典 ✓ 「Compare Crawls」で「過去のサイト監査を並べて比較」でき、FixedとNewの問題を表示出典 ✓ 「Site Auditでは任意の2つのクロールを比較できます」出典 ✓ すべてのレポートが前回のクロールと比較します出典 ✓ 「直近の2つだけでなく、どのクロールでも比較できます」。クローラーのすべてのグラフとデータ表で、セグメントごとにも出典 ✓ クロールを比較 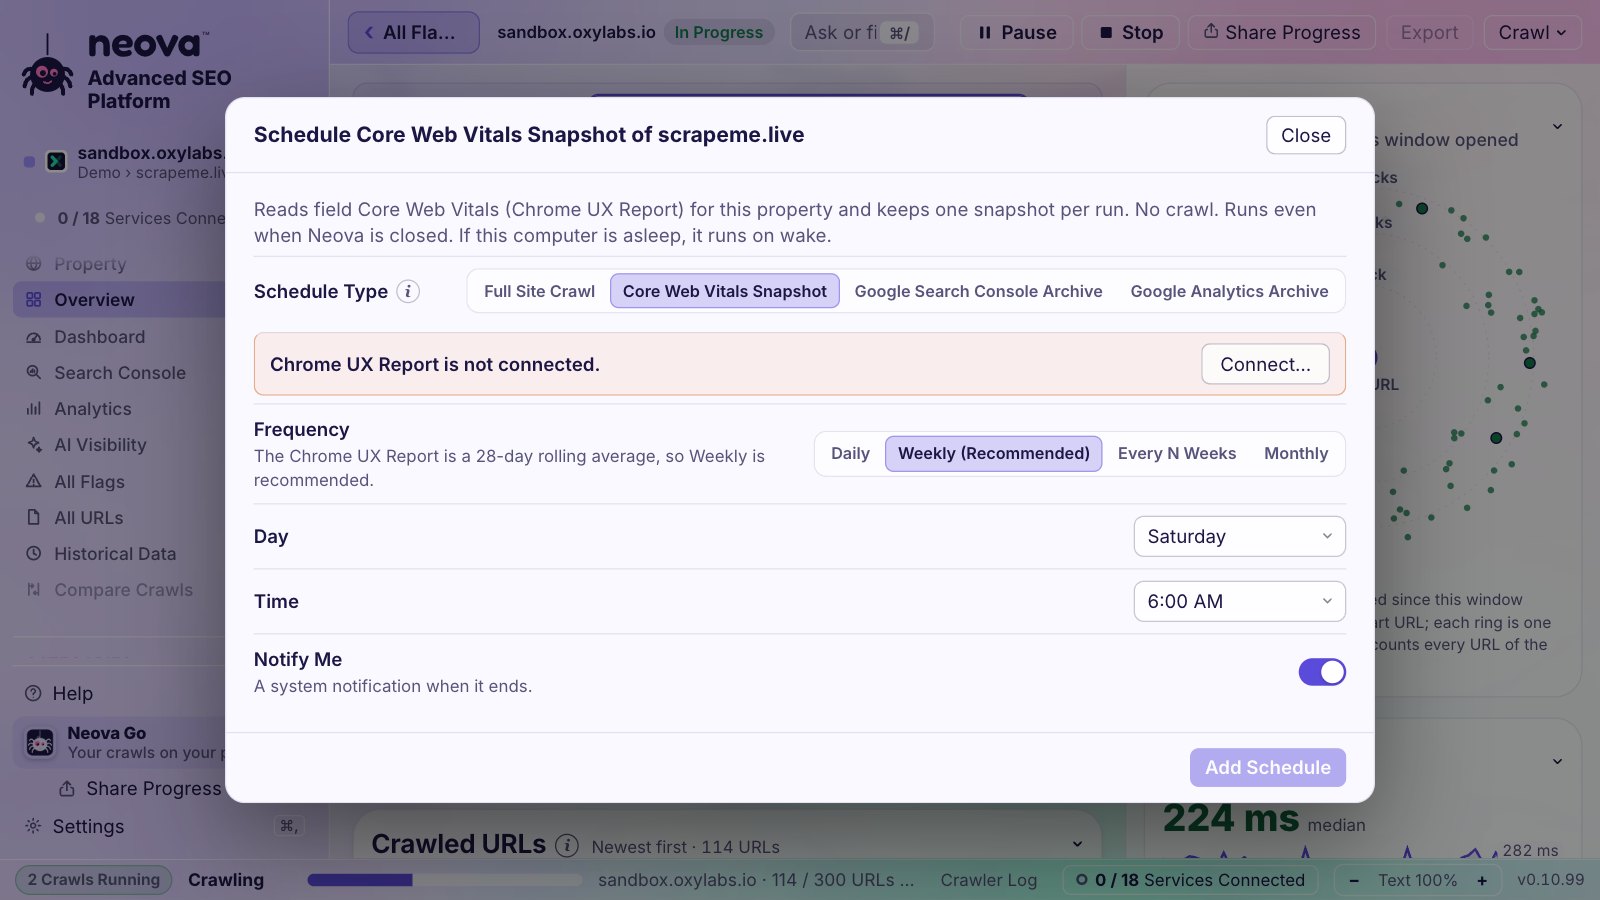




 Google Search Console
 Google Analytics
 Chrome UX Report
 Google Cloud
 Gemini
 Bing Webmaster Tools
 OneDrive
 Microsoft Teams
 DataForSEO
 Semrush
 Ahrefs
 Majestic
 Moz
 SEO Gets
 Anthropic
 OpenAI
 Ollama
 Jira
 Linear
 Asana
 ClickUp
 monday.com
 Slack
 Cloudflare
 Google Drive
 Dropbox
 iCloud Drive
 Proton Drive
 kDrive
 Screaming Frog
 Sitebulb
 Lumar
 JetOctopus