Screaming Frog e Sitebulb hanno fissato lo standard per i crawler SEO, e abbiamo imparato molto da entrambi. Ecco Neova accanto a loro e a Semrush, Ahrefs, Lumar e JetOctopus, in base alla loro documentazione, con i link.
4posti dove usarlo: Mac, Windows, Linux, qualsiasi browser
15lingue
Crawl di più siti insieme
App desktop
Scansiona il tuo cliente, i suoi concorrenti e il tuo sito in un colpo solo. Fino a 4 siti vengono scansionati contemporaneamente in una sola finestra, ognuno con il proprio ritmo e limite di URL, e una protezione della memoria tiene in attesa il successivo quando il computer ne ha poca.
Due crawl, una finestra2 crawl in corso in alto: fai clic su uno per seguirlo.In corsoOgni crawl, il suo ritmo, gli slot in uso e la memoria libera.
Fino a 4 insiemeAvvia un crawl, poi un altro: fino a 4 siti vengono scansionati contemporaneamente. Impostazioni › Crawl › Crawl contemporanei, 2 per impostazione predefinita; il successivo aspetta il suo turno in coda.
Ognuno al suo ritmoOgni crawl mantiene la propria velocità, il proprio limite di URL e le proprie impostazioni, così il sito lento di un cliente non rallenta mai gli altri.
Una protezione della memoriaOgni crawl riserva la memoria di cui ha bisogno, di più con il rendering JavaScript. Quando il computer ne ha poca, il crawl successivo aspetta e dice perché.
Una finestra per tuttiPassa da un crawl in corso all'altro in cima alla schermata live. In corso li mostra tutti, ognuno con Pausa, Interrompi e Apri.
Screaming Frog: un crawl per ogni copia dell'app: una finestra, con la sua memoria, per ogni sito. fonte Sitebulb: l'app desktop esegue gli audit uno dopo l'altro; in contemporanea solo con i piani Medium ed Enterprise di Sitebulb Cloud. fonte
Uno sguardo all'interno
Neova sul negozio demo con cui parte ogni account Neova Online. Fai clic su una schermata per vederla a grandezza intera.
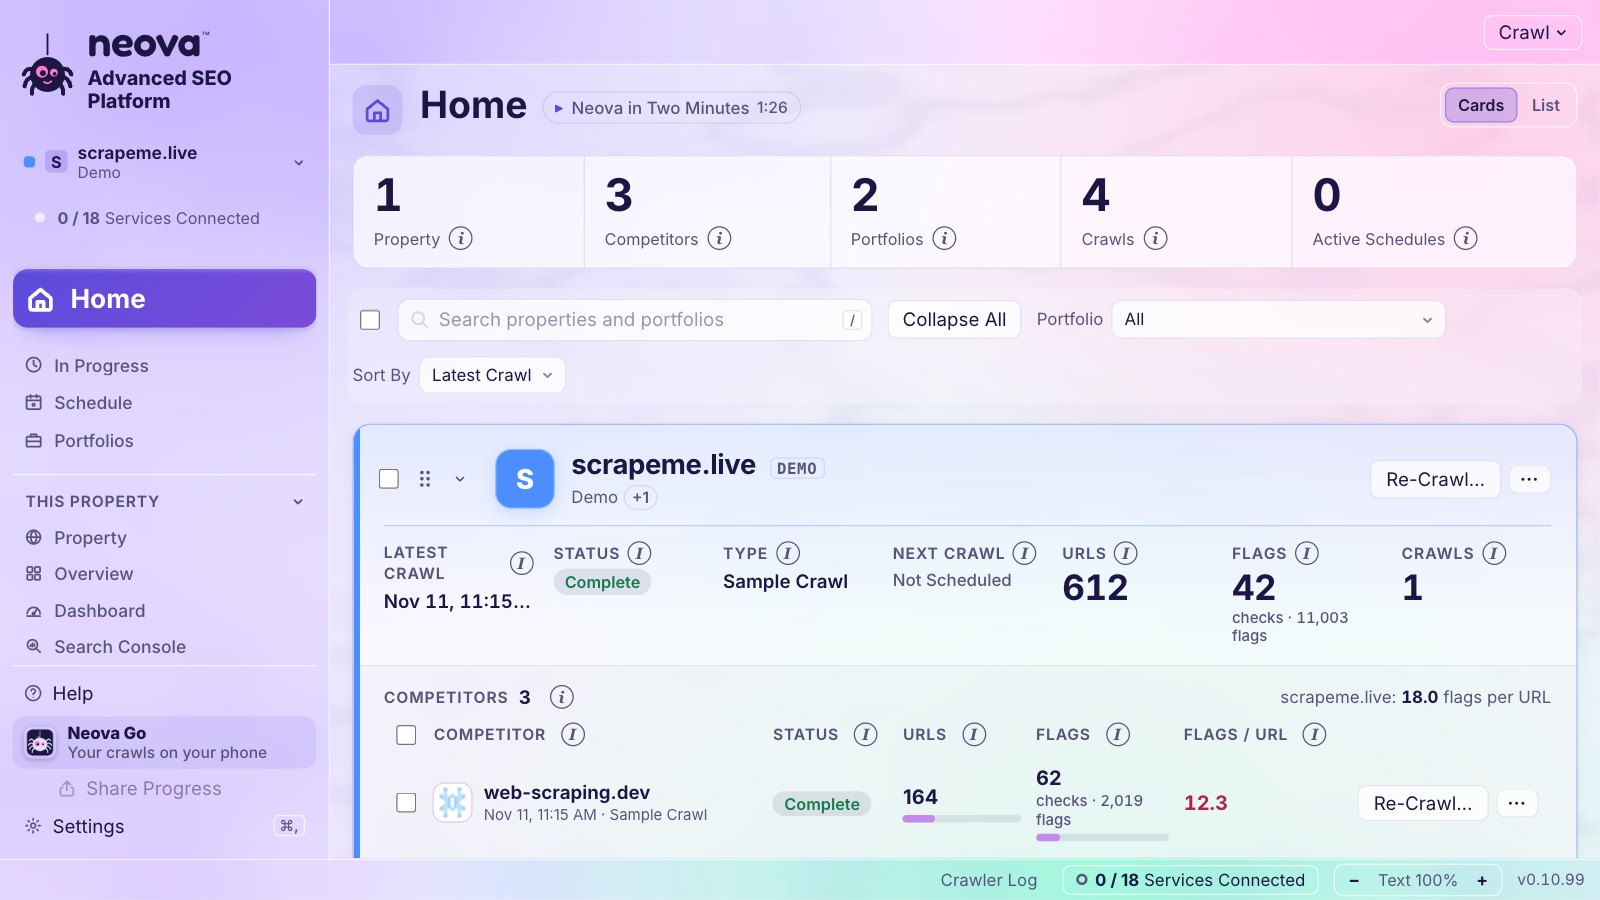
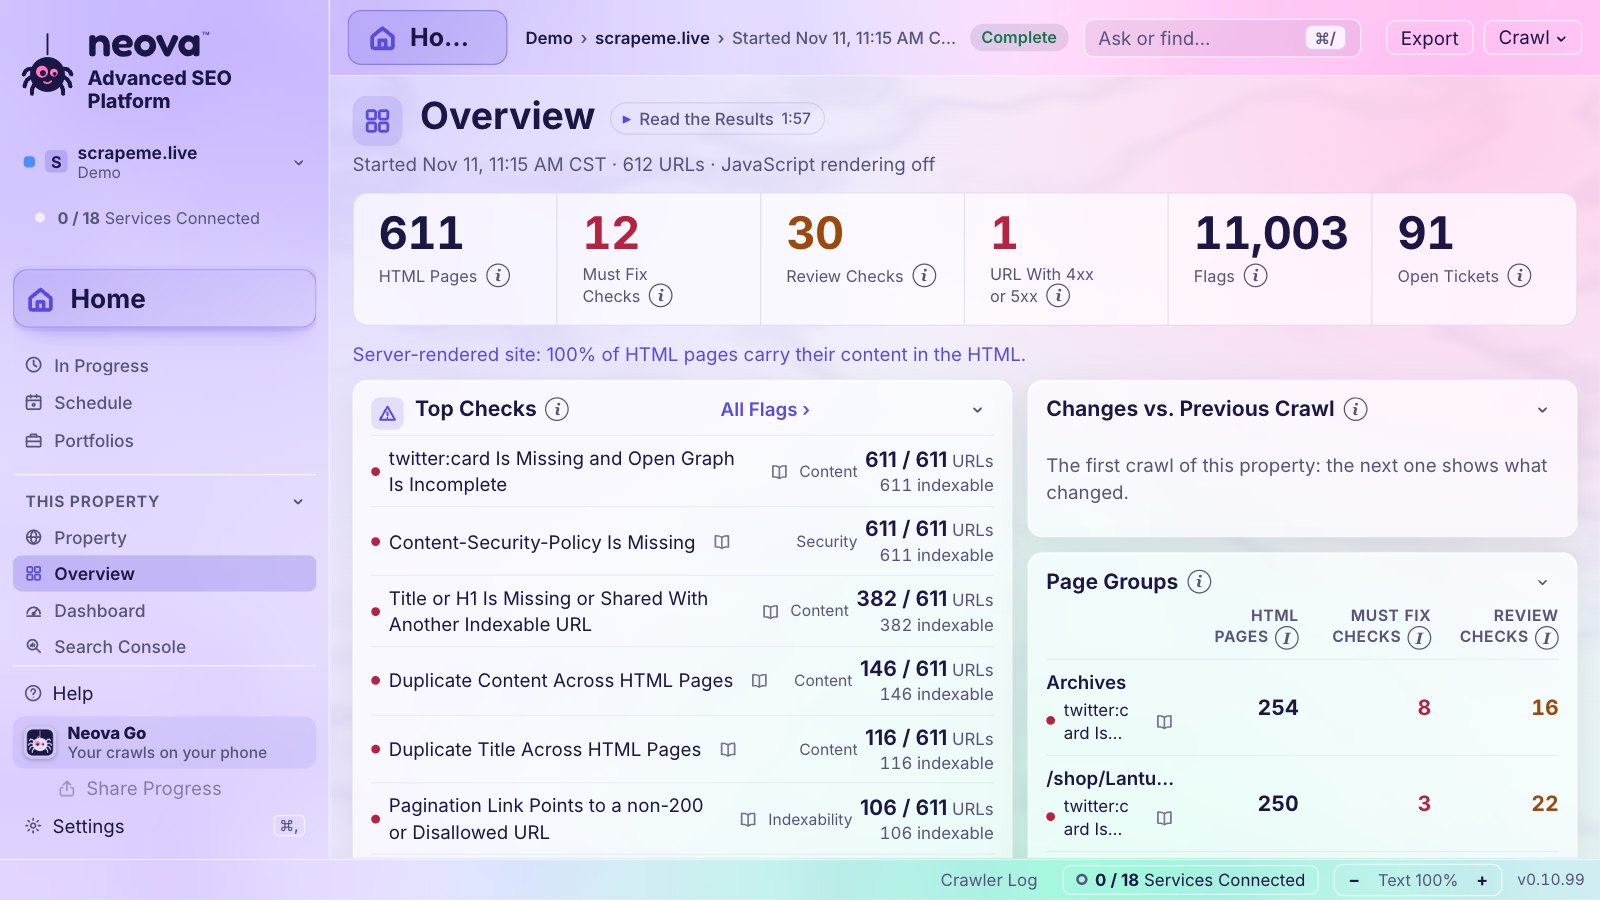
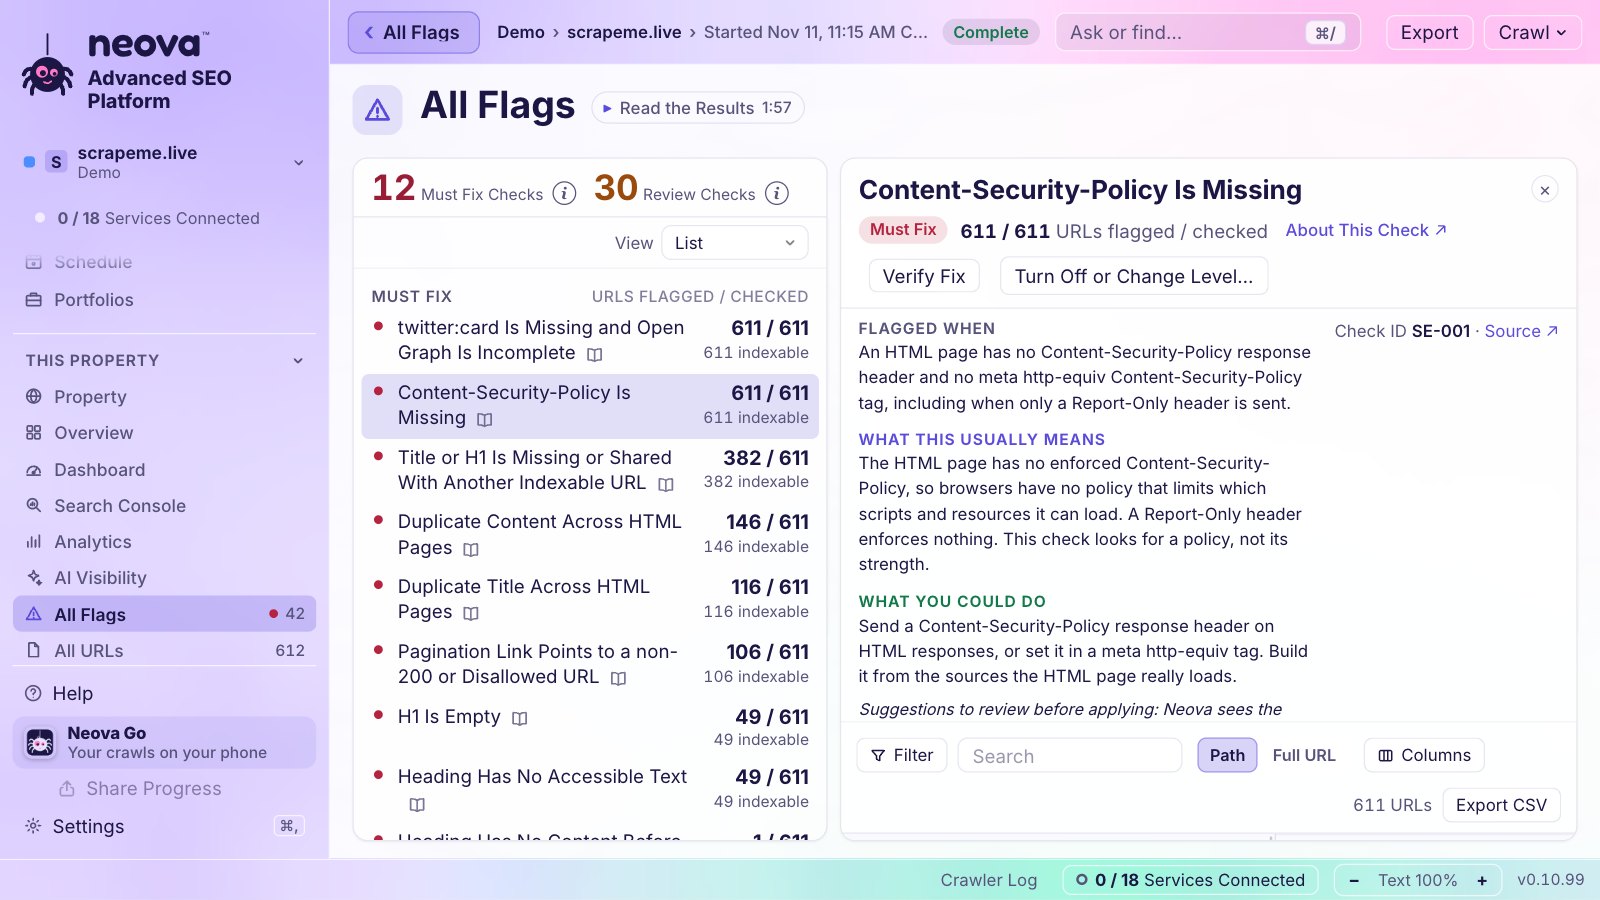
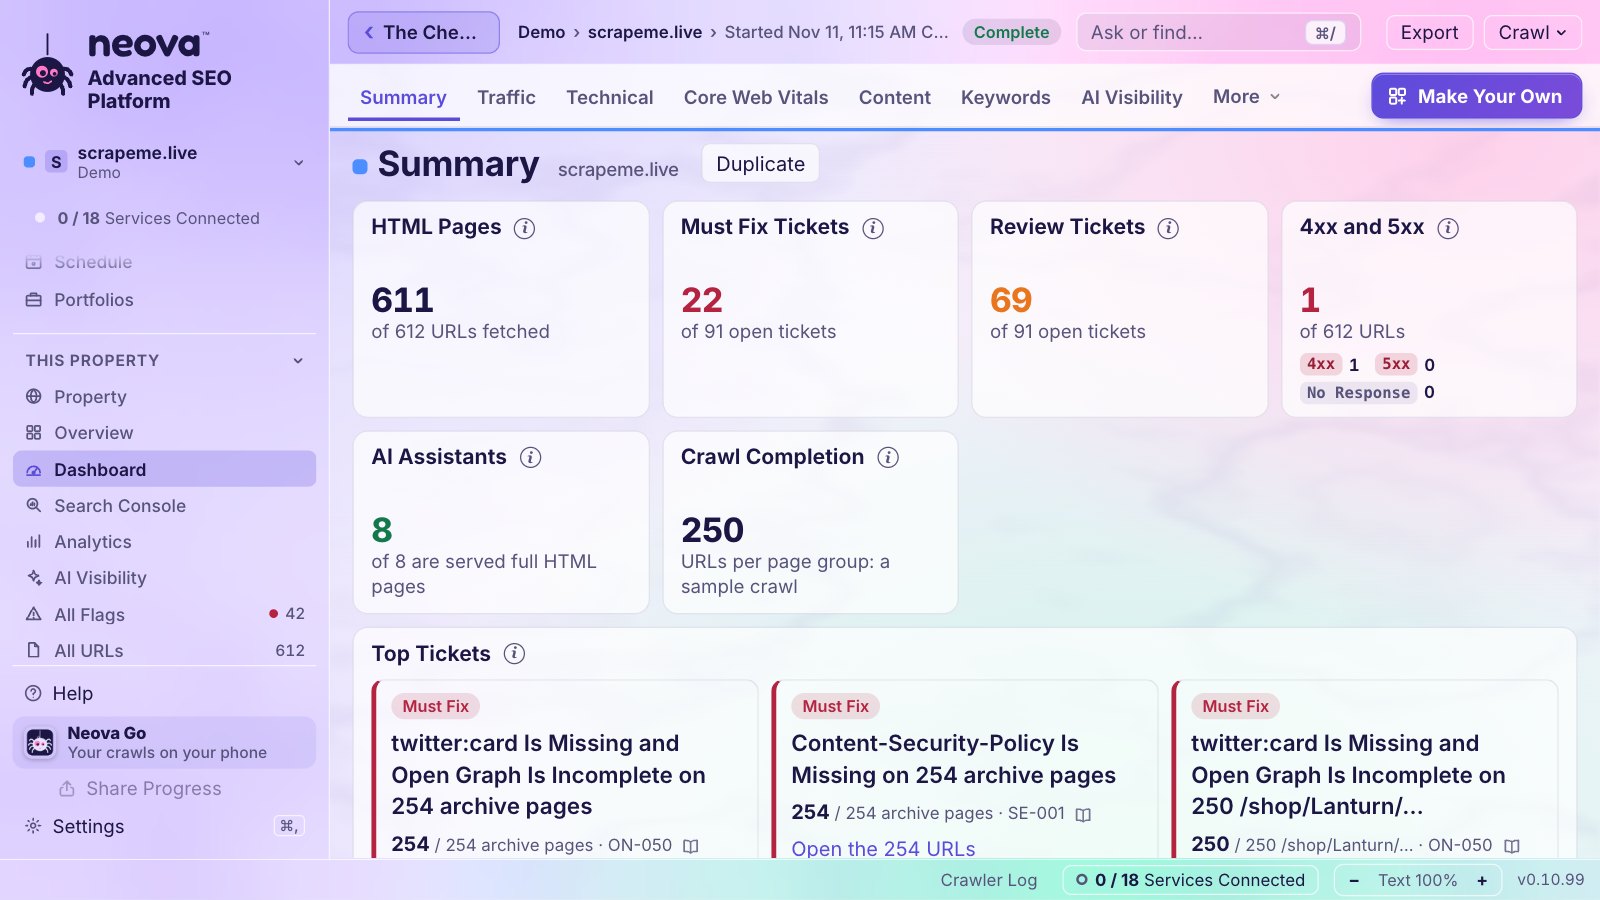
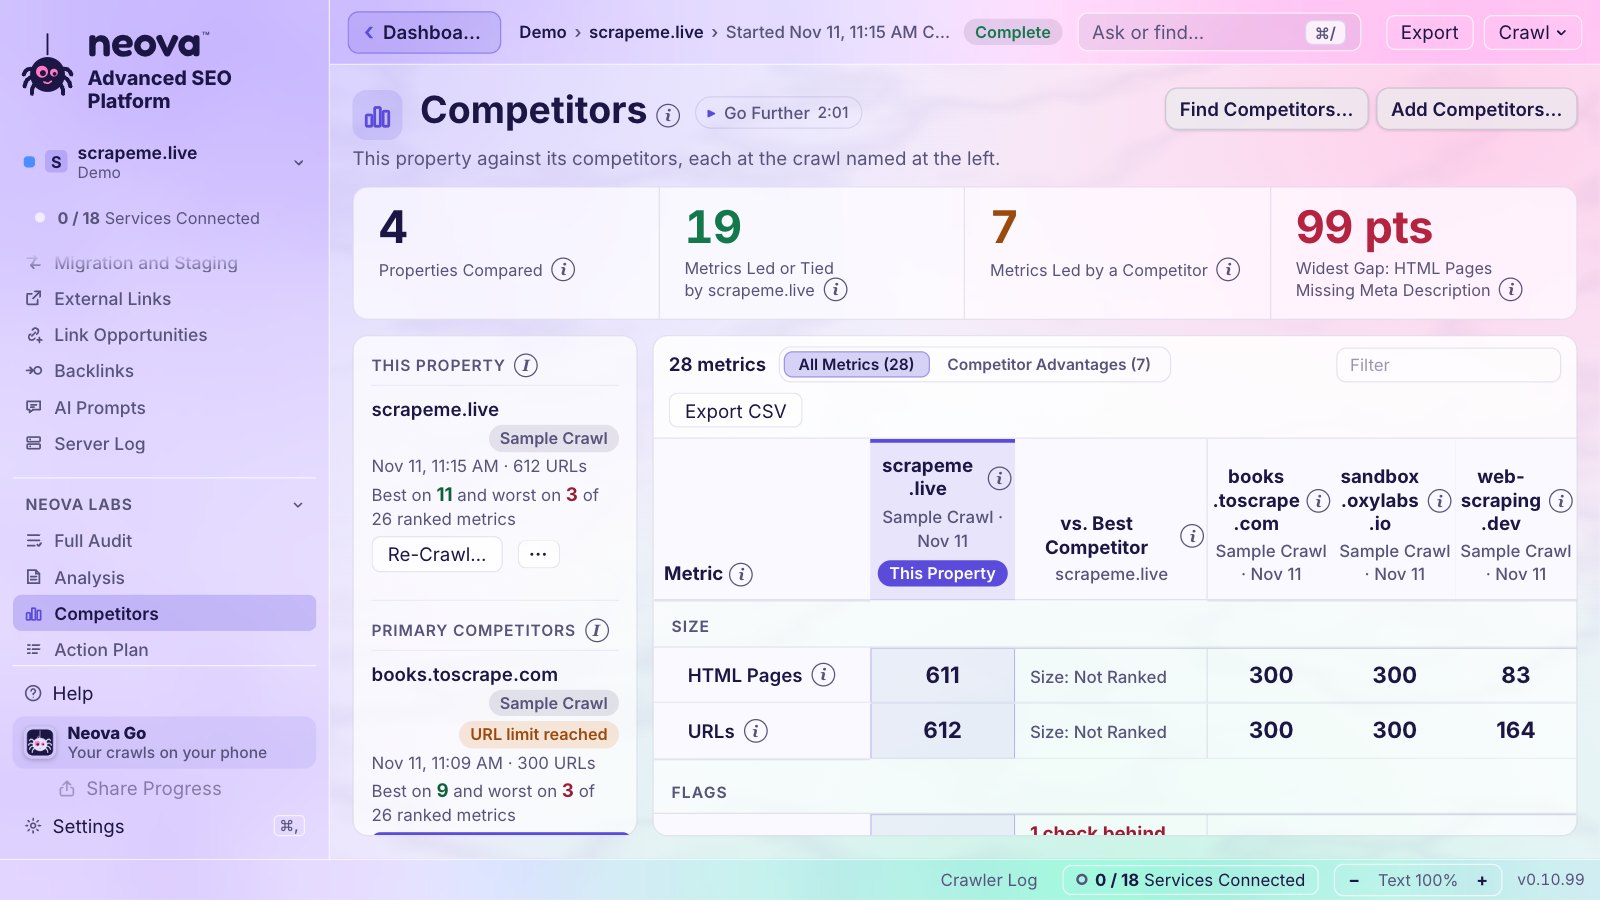
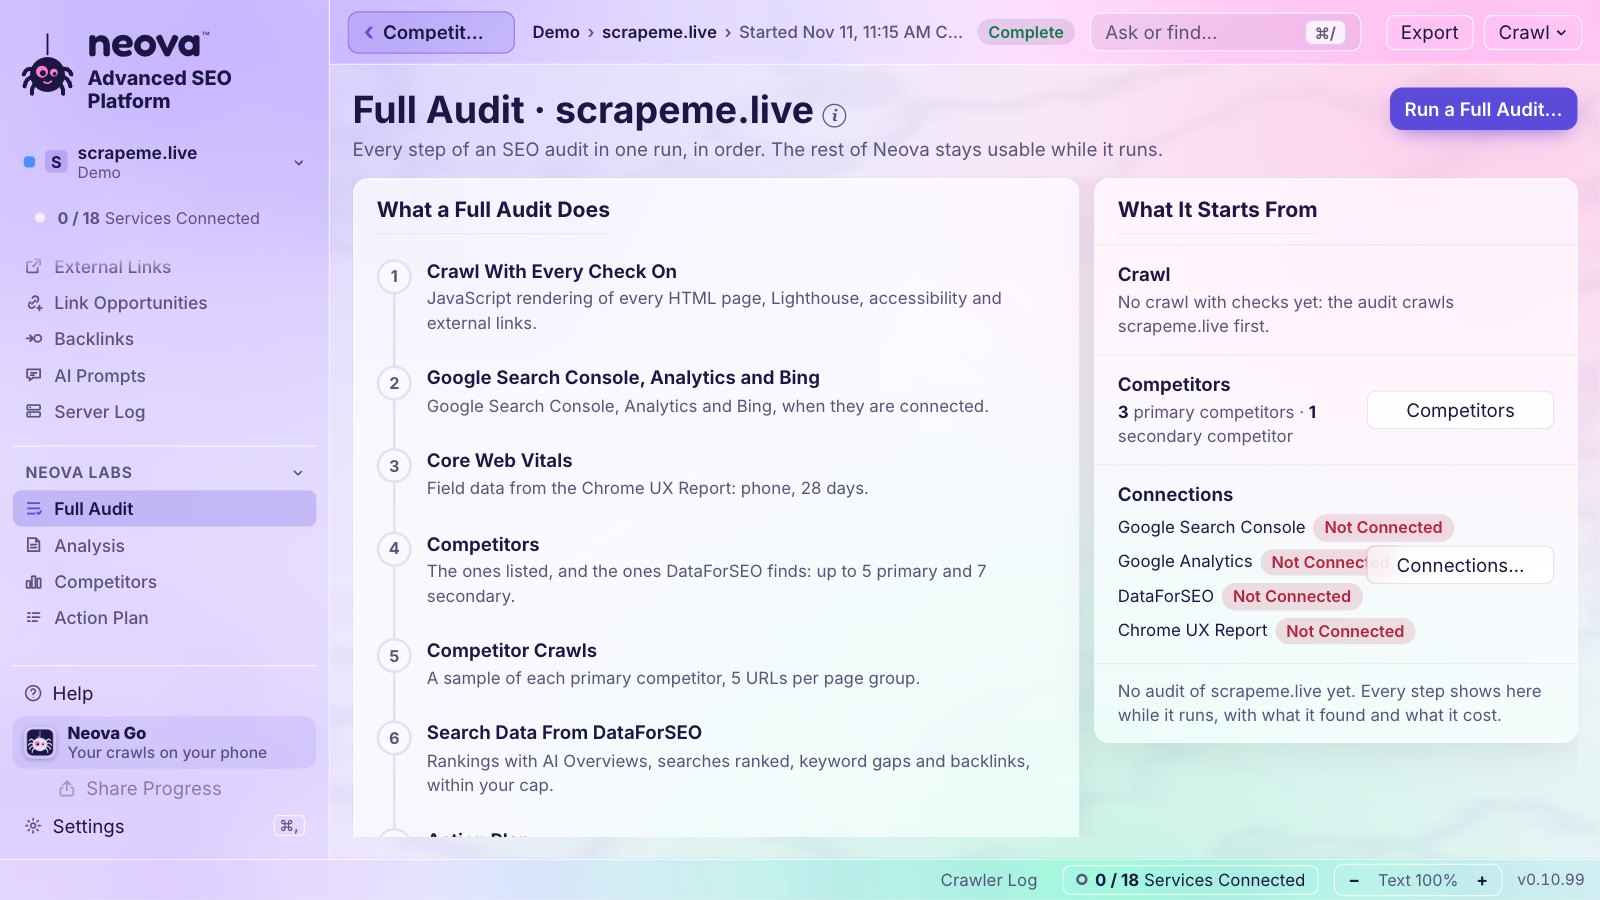
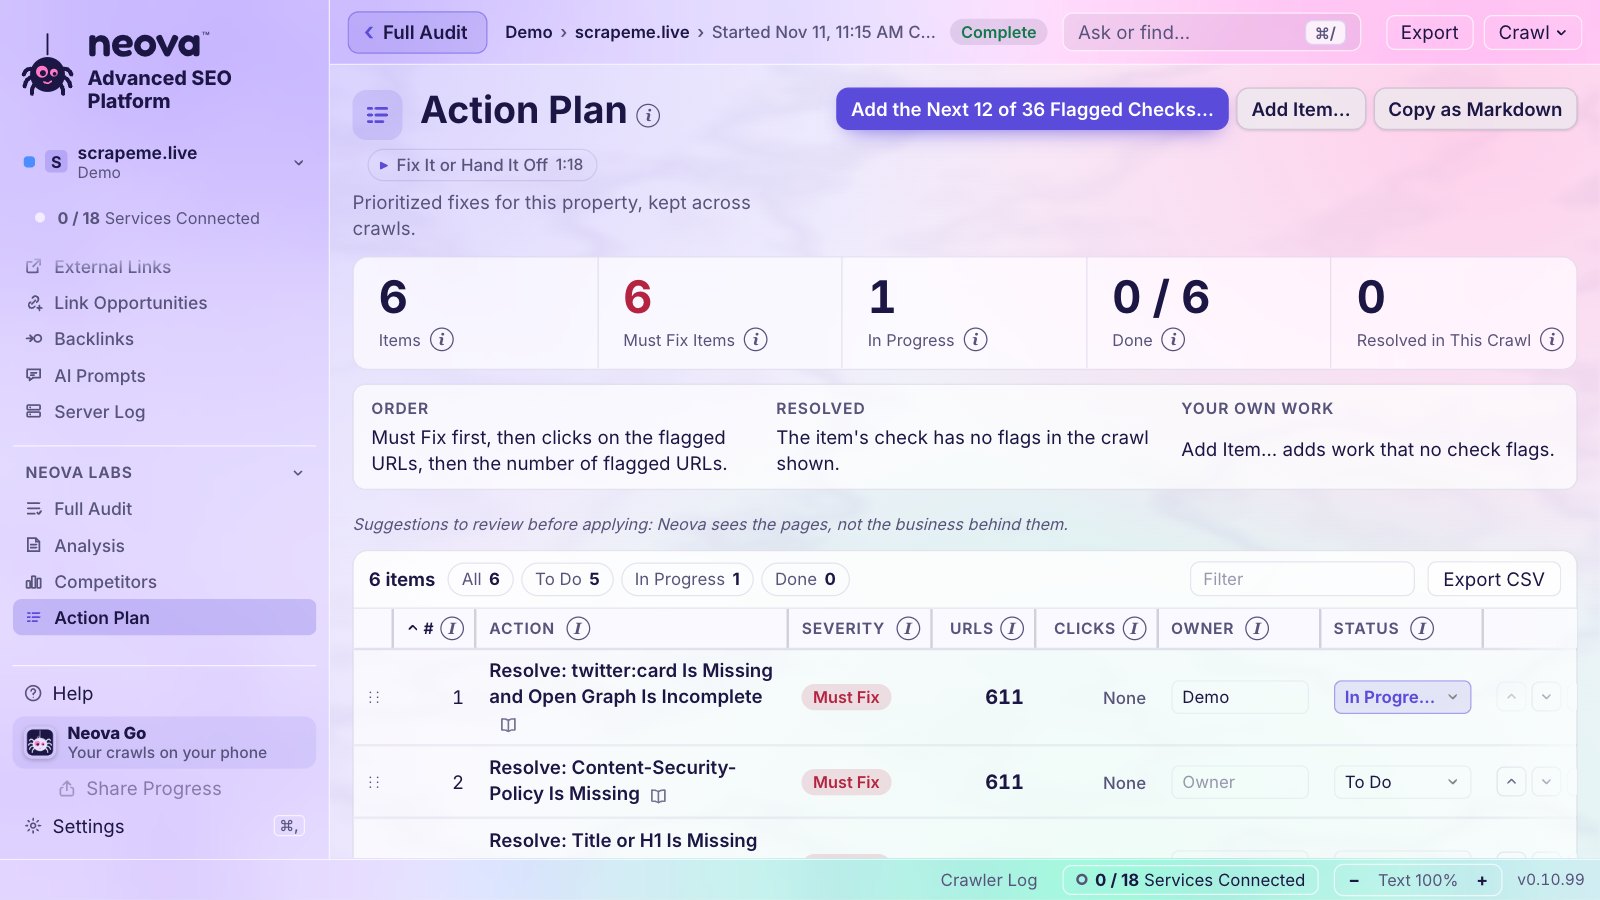
HomeOgni proprietà con i suoi concorrenti, gli URL e le segnalazioni per URL.Il crawl liveLe fasi, la mappa del crawl, i tempi di risposta e ogni URL man mano che arriva.PanoramicaIl sito a colpo d'occhio: controlli principali, modifiche, gruppi di pagine.Tutte le segnalazioniOgni segnalazione con il perché, come correggerla, la sua fonte e le sue pagine.La dashboard13 schede, 39 blocchi e dashboard tutte tue.ConcorrentiIl tuo sito accanto al loro, metrica per metrica, colorato in base a chi è in testa.Audit completoCrawl, dati di ricerca, concorrenti, piano e report in un'unica esecuzione.Piano d'azioneOgni correzione con un responsabile e uno stato, inviata a Jira se vuoi.
Solo in Neova
Verificato nella loro documentazione
Cosa fa Neova che nessuno tra Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar e JetOctopus fa, secondo la loro documentazione, letta l'11 novembre 2026. Ogni scheda dice di cosa si tratta in parole semplici, e perché conta.
Condividi un crawl live con chiunque
Condividi avanzamento ti dà un link al crawl in corso. Chiunque lo apre su un telefono o un computer, senza account, e lo segue in diretta: avanzamento, ripartizione degli URL, mappa del crawl, tempi di risposta, redirect ed errori, e un avviso quando finisce.
Dettagli
Il tuo cliente o il tuo capo segue il crawl senza accedere a nulla, e vede quel crawl e nient'altro. Interrompi condivisione lo chiude all'istante.
Screaming Frog: una panoramica del crawl in Looker Studio, alimentata da un Google Sheet che si aggiorna «ogni volta che viene eseguito il crawl pianificato», può essere inviata via email a «qualsiasi stakeholder». fonte Sitebulb: le dashboard Data Studio di Cloud si aprono «senza bisogno di un account Sitebulb» e si aggiornano «ogni volta che viene eseguito un crawl» fonte Semrush: chi viene invitato a vedere «deve comunque creare un account» fonte Ahrefs: i clienti ricevono i risultati «tramite esportazioni, report pianificati o dashboard Data Studio live» fonte Lumar: «i link pubblici permettono a chiunque di vedere i crawl e i report», con scadenza «da 24 ore a 6 mesi» fonte JetOctopus: nessun link pubblico trovato fonte
Condividi ogni crawl, protetto dalla tua chiave
Pubblica un link di condivisione e Neova cifra i crawl del sito sul tuo computer prima che lo lascino. La chiave è solo nel link, quindi nemmeno il nostro server può leggerli. Interrompi la condivisione e il link non apre più nulla.
Dettagli
Consegna a un cliente l'intero audit, ogni scheda e ogni tabella, e mantieni il pieno controllo su chi lo vede e per quanto tempo.
Screaming Frog: una panoramica del crawl in Looker Studio, alimentata da un Google Sheet che si aggiorna «ogni volta che viene eseguito il crawl pianificato», può essere inviata via email a «qualsiasi stakeholder». fonte Sitebulb: le dashboard Data Studio di Cloud si aprono «senza bisogno di un account Sitebulb» e si aggiornano «ogni volta che viene eseguito un crawl» fonte Semrush: chi viene invitato a vedere «deve comunque creare un account» fonte Ahrefs: i clienti ricevono i risultati «tramite esportazioni, report pianificati o dashboard Data Studio live» fonte Lumar: «i link pubblici permettono a chiunque di vedere i crawl e i report», con scadenza «da 24 ore a 6 mesi» fonte JetOctopus: nessun link pubblico trovato fonte
Il tuo computer, il tuo browser, il tuo telefono
Scansiona sul tuo Mac, PC o computer Linux, apri gli stessi portfolio, impostazioni e crawl in Neova Online da qualsiasi browser e tieni d'occhio tutto dal telefono. Un solo account, sempre allineato.
Dettagli
I crawler desktop restano su un computer, quelli cloud restano in un browser. Neova va dove sei tu, e i tuoi crawl restano sul tuo computer, a meno che tu non scelga diversamente.
Screaming Frog: non trovato nella loro documentazione. fonte Sitebulb: desktop più Cloud nel browser fonte Semrush: piattaforma nel browser più un'app iOS solo per i posizionamenti fonte Ahrefs: solo browser; Ahrefs dice che puoi vedere i risultati del crawl «da qualsiasi luogo e in qualsiasi momento» e «perfino dallo smartphone» (2024). fonte Lumar: non trovato nella loro documentazione. fonte JetOctopus: non trovato nella loro documentazione. fonte
Neova Go: i tuoi siti in tasca
Sul telefono, l'ultimo crawl di ogni proprietà, i Core Web Vitals, i clic, le ricerche monitorate e la prossima esecuzione, protetti da una chiave che non lascia mai il tuo computer. Nella barra dei menu, l'avanzamento del crawl accanto all'orologio, e Rimanda o Salta per il prossimo crawl pianificato.
Dettagli
Sai che un crawl è finito o che un template è diventato più lento senza aprire il portatile.
Screaming Frog: non trovato nella loro documentazione. fonte Sitebulb: non trovato nella loro documentazione. fonte Semrush: un'app iOS solo per i posizionamenti fonte Ahrefs: nessuna app per telefono trovata. La web app cloud funziona sui telefoni fonte Lumar: non trovato nella loro documentazione. fonte JetOctopus: non trovato nella loro documentazione. fonte
Ticket che si chiudono da soli
Le segnalazioni diventano ticket, uno per controllo e gruppo di pagine. Quando il crawl successivo trova il problema risolto, il ticket si chiude; se il problema torna, si riapre. Invia a Jira, e Jira si allinea.
Dettagli
I tuoi sviluppatori ricevono un ticket chiaro invece di 4.000 URL, e nessuno insegue ticket risolti settimane fa.
Screaming Frog: non trovato nella loro documentazione. fonte Sitebulb: nessuna integrazione nativa con Jira. La Dev Handoff Skill, eseguita tramite un assistente AI, scrive ticket «direttamente in Jira, Linear, Asana, Monday o ClickUp». fonte Semrush: Site Audit può «inviare attività a una bacheca Trello» fonte Ahrefs: nessuna funzione Jira o ticket trovata. fonte Lumar: le attività si creano a mano dai report e si spostano «trascinando le attività nelle diverse sezioni di stato» fonte JetOctopus: non trovato nella loro documentazione. fonte
Ogni controllo cita la sua fonte
Ogni controllo dice su quale pagina di Google, del W3C, di web.dev o di un'altra fonte ufficiale si basa, con il link, e cosa fare.
Dettagli
Quando uno sviluppatore chiede perché, gli mandi la fonte, non la tua opinione.
Screaming Frog: tutte le 8 guide ai problemi esaminate finiscono con «Further Reading» con link a Google o web.dev, ma come lettura, non come base della regola fonte Sitebulb: molti Hint finiscono con «Further Reading» (Google, MDN, documentazione di Lighthouse, anche blog), ma «Canonical points to a redirecting URL» non cita alcuna fonte. fonte Semrush: alcune correzioni rimandano a Google («consulta questo articolo di Google») fonte Ahrefs: alcune pagine di aiuto rimandano a Google («Questa guida di Google ti dirà tutto»), mentre pagine di problemi come «Hreflang to broken page» non citano fonti esterne. fonte Lumar: non trovato nella loro documentazione. fonte JetOctopus: non trovato nella loro documentazione. fonte
Bing Webmaster Tools, con le citazioni AI di Bing
Neova legge i dati di Bing sul tuo sito, compreso quanto spesso le risposte AI di Bing citano le tue pagine.
Dettagli
Bing alimenta la ricerca di ChatGPT e Copilot. I suoi dati mostrano la tua visibilità nella ricerca AI.
Screaming Frog: Bingbot è solo un preset di user agent fonte Sitebulb: Bing è solo un preset di user agent fonte Semrush: solo monitoraggio dei posizionamenti su Bing fonte Ahrefs: Site Audit invia le modifiche tramite IndexNow («supportato da Bing, Yep e altri motori di ricerca») fonte Lumar: niente Bing Webmaster Tools fonte JetOctopus: Bingbot nei log e nel tester del robots.txt («Dati completi su Googlebot, Bingbot, GPTBot, ClaudeBot e oltre 40 altri crawler») fonte
Apri i tuoi crawl di Screaming Frog e Sitebulb
Hai già scansionato il sito con Screaming Frog o Sitebulb? Apri quel crawl in Neova, e le sue pagine vengono valutate sul sito live con i controlli di Neova.
Dettagli
Tieni gli strumenti che conosci e aggiungi Neova dove serve, senza scansionare due volte.
Screaming Frog: la modalità elenco legge gli URL da qualsiasi file .txt, .xls, .xlsx, .csv o .xml («puoi caricare direttamente un download di Adwords») fonte Sitebulb: importa elenchi di URL (.csv o .txt) fonte Semrush: Backlink Audit importa file di backlink (CSV, «fino a 50 MB») fonte Ahrefs: non trovato nella loro documentazione. fonte Lumar: importa esportazioni CSV come fonti del crawl (Majestic, Ahrefs, Open Site Explorer, Screaming Frog Log File Analyser, Splunk, Logz.io fonte JetOctopus: solo importazione generica: «Per l'importazione puoi usare un file in formato CSV o TXT», unito tramite la chiave URL fonte
Inclusi, non venduti a parte
Anche gli altri hanno queste funzioni, spesso come componente aggiuntivo o prodotto separato con un prezzo a sé. In Neova fanno parte dell'app. Dove servono dati esterni, come DataForSEO o Google, usi il tuo account al suo prezzo, senza ricarichi. Apri Cosa fanno gli altri per ognuna, con la pagina della loro documentazione.
Scopri se ChatGPT e Perplexity ti citano
Neova fa le tue domande a ChatGPT e Perplexity, come farebbe un cliente, e ti dice se il tuo brand compare nella risposta.
Cosa fanno gli altri
Sempre più persone chiedono agli assistenti AI prima di cercare. Così sai se lì esisti.
Screaming Frog: non trovato nella loro documentazione. fonte Sitebulb: non trovato nella loro documentazione. fonte Semrush: sì, nell'AI Visibility Toolkit ($99/mese) fonte Ahrefs: prompt personalizzati di Brand Radar su ChatGPT, Perplexity, Gemini, Copilot, AI Overviews fonte Lumar: in AI Visibility (attivato per account) fonte JetOctopus: «JetOctopus non monitora citazioni, menzioni del brand o sentiment nelle risposte AI» fonte
Cosa ricevono davvero gli assistenti AI
Neova recupera le tue pagine come 10 crawler AI (ChatGPT, Claude, Perplexity e altri), controlla il tuo llms.txt e i file per gli agenti, e mostra cosa riceve ciascuno.
Cosa fanno gli altri
Una pagina che i tuoi visitatori vedono può essere bloccata o vuota per un assistente AI. Ora puoi vederlo.
Screaming Frog: non trovato nella loro documentazione. fonte Sitebulb: non trovato nella loro documentazione. fonte Semrush: avvisi di Site Audit «Llms.txt not found (AI Search)» e «Llms.txt file has formatting issues (AI Search)» fonte Ahrefs: solo un generatore gratuito («crea per te il file llms.txt perfetto») fonte Lumar: nell'Agentic Readiness Scanner gratuito di Lumar, separato dalla piattaforma di crawl fonte JetOctopus: non trovato nella loro documentazione. fonte
I tuoi concorrenti, trovati e confrontati
Neova trova i siti che competono con te sulle stesse ricerche, scansiona i più vicini e mette ogni metrica fianco a fianco, colorata in base a chi è in testa.
Cosa fanno gli altri
Vedi dove un concorrente ti batte, e di quanto, senza un foglio di calcolo.
Screaming Frog: non trovato nella loro documentazione. fonte Sitebulb: non trovato nella loro documentazione. fonte Semrush: Position Tracking: «il report Competitors Discovery rivela i concorrenti organici che si posizionano per le tue keyword» fonte Ahrefs: i nuovi progetti «ricevono suggerimenti di concorrenti in base ai siti che si posizionano per keyword simili» fonte Lumar: in AI Visibility: «i brand vengono scoperti automaticamente dalle risposte dei provider AI» e Lumar classifica ciascuno come Own, Competitor, Other o Context. fonte JetOctopus: non trovato nella loro documentazione. fonte
Log del server, anche dietro Cloudflare
Neova legge i tuoi log di Apache o Nginx, o direttamente quelli di Cloudflare, e conta solo i bot verificati, così vedi cosa recuperano davvero Googlebot e i crawler AI.
Cosa fanno gli altri
I log mostrano cosa fanno i motori di ricerca sul tuo sito, non cosa ipotizza un crawler.
Screaming Frog: un prodotto separato, Screaming Frog Log File Analyser (Windows, macOS, Linux), per «verificare i bot dei motori di ricerca e dell'AI». fonte Sitebulb: FAQ: «Sitebulb non fa ancora l'analisi dei file di log, ma è in sviluppo e sarà disponibile presto!» fonte Semrush: sì, come prodotto Enterprise separato fonte Ahrefs: Bot Analytics, uno strumento separato gratuito in beta sui piani a pagamento, «acquisisce i dati delle richieste HTTP» da Cloudflare, Vercel, CloudFront, load balancer AWS o Fastly fonte Lumar: incluso, ma da riepiloghi per URL fonte JetOctopus: incluso in ogni piano, non un prodotto separato fonte
Core Web Vitals degli utenti reali, con l'andamento
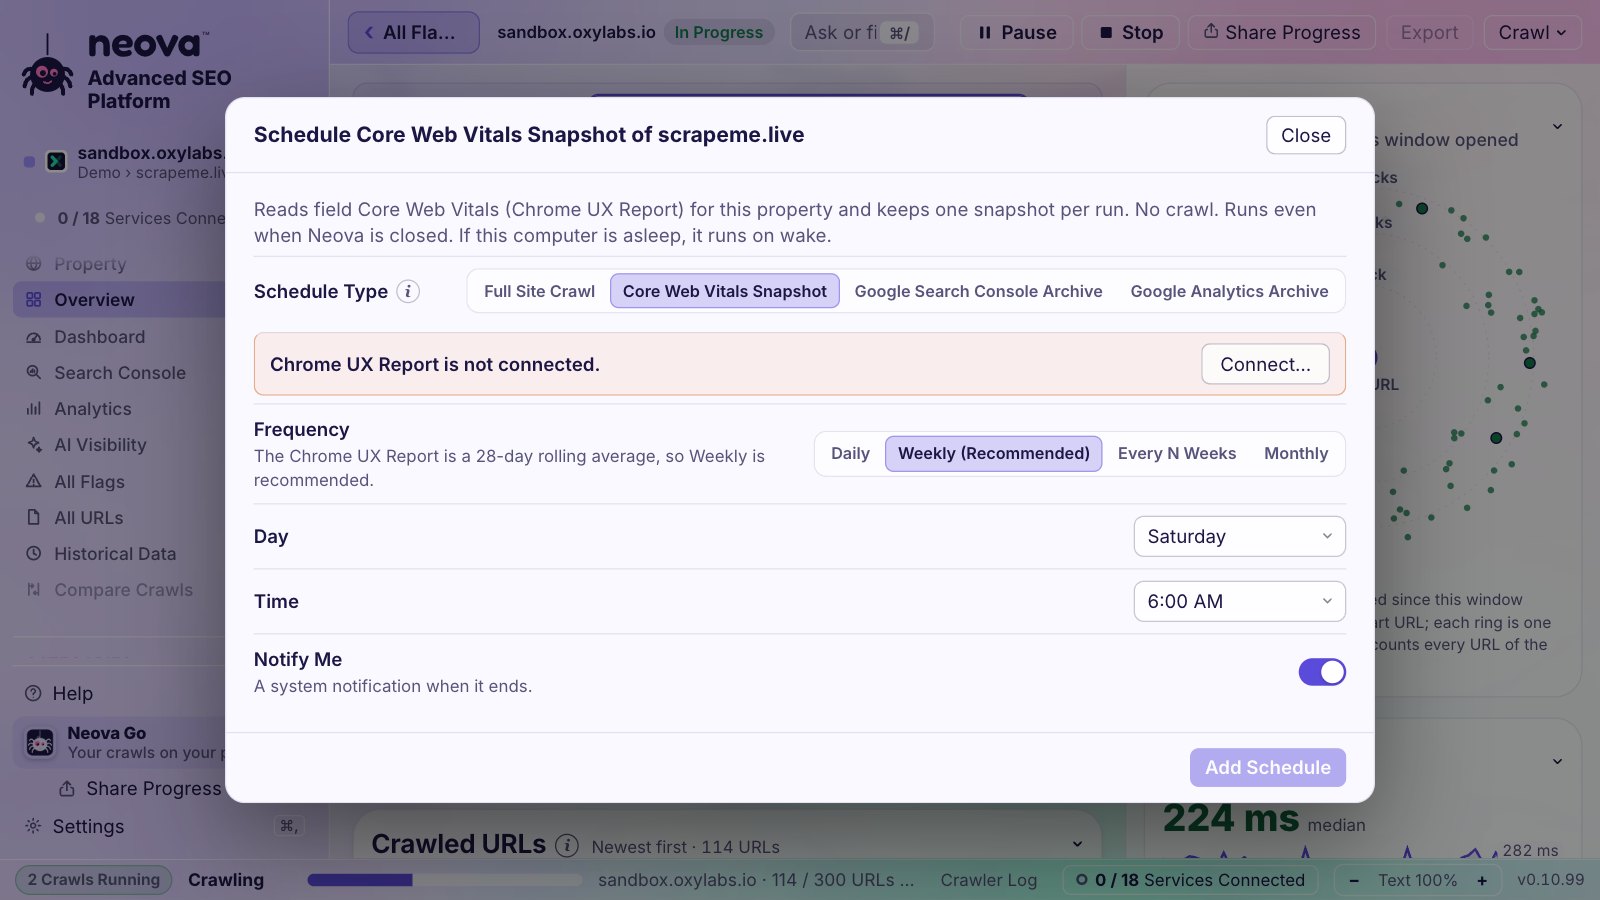
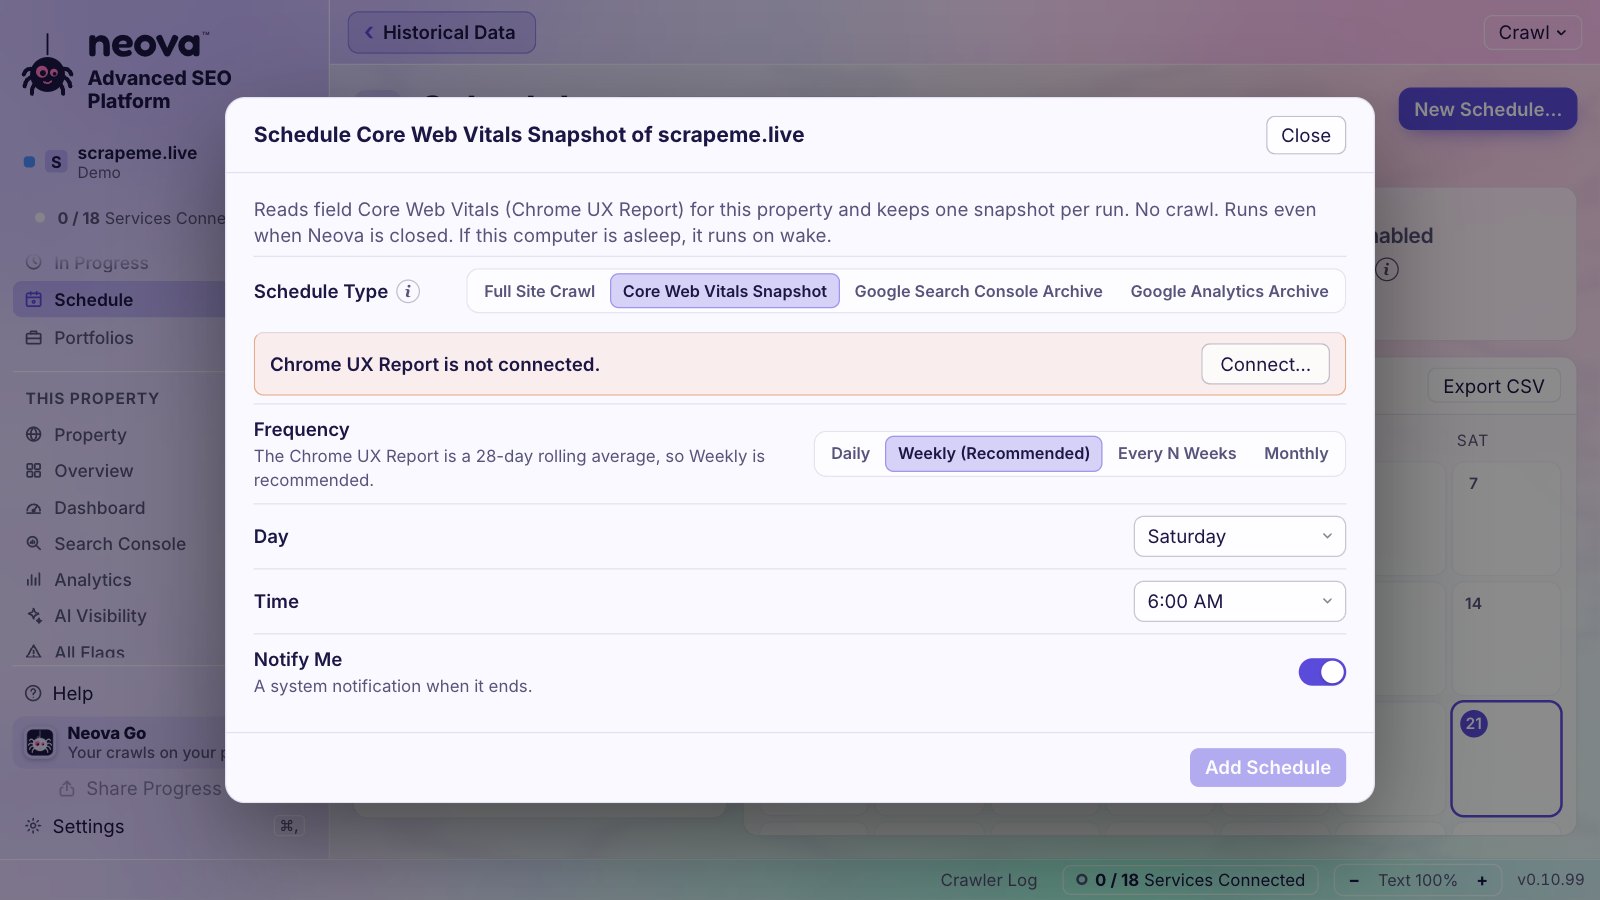
Con la tua chiave gratuita del Chrome UX Report, Neova legge l'esperienza reale degli utenti di Chrome: un andamento di 40 settimane fin dal primo giorno, una vista per gruppo di pagine, istantanee pianificate e avvisi.
Cosa fanno gli altri
I test di laboratorio dicono quanto potrebbe essere veloce una pagina. I dati degli utenti reali dicono quanto è veloce per i tuoi visitatori, ed è questo che usa Google.
Screaming Frog: nessun grafico dell'andamento dei CWV nell'app trovato. fonte Sitebulb: il Google Sheet «Historical Audit Data» ha una riga per audit per «dati di serie storiche o grafici» in Looker Studio, e include i valori di fascia dei Core Web Vitals (changelog, 13 fonte Semrush: dati di laboratorio (Lighthouse) fonte Ahrefs: report Performance di Site Audit fonte Lumar: in Site Speed: «un grafico dell'andamento per ciascun KPI» (FCP, LCP, TBT, CLS), diviso in Slow, Moderate, Fast, un punto per crawl (dati di laboratorio) fonte JetOctopus: controlli CWV pianificati («+Create a CWV schedule») fonte
Jira senza lavoro inutile
Ogni ticket va su Jira con le sue pagine, il suo controllo e come correggerlo, e Neova mantiene i due allineati dopo ogni crawl.
Cosa fanno gli altri
Il tuo team lavora dove lavora già.
Screaming Frog: non trovato nella loro documentazione. fonte Sitebulb: nessuna integrazione nativa con Jira fonte Semrush: solo «Send to Trello» nativo fonte Ahrefs: nessuna integrazione con Jira trovata. fonte Lumar: integrazione con Jira Cloud fonte JetOctopus: non trovato nella loro documentazione. fonte
La dashboard
Apri una proprietà, poi Dashboard: tutto ciò che Neova sa del sito, in una schermata, e tutte le viste personalizzate che ti servono.
Il tuo sito in una schermataOtto gruppi, 13 schede, 39 blocchi. Ogni numero mostra la variazione rispetto al crawl precedente.
Velocità, 40 settimane indietroI Core Web Vitals degli utenti reali di Chrome dal primo giorno, con le soglie buono e scarso di Google, anche per gruppo di pagine.
Clic e ricercheClic e impressioni al giorno rispetto ai 28 giorni precedenti, e 25 ricerche monitorate con le loro posizioni.
Gli aggiornamenti di Google sui tuoi clicDue anni di aggiornamenti del ranking tracciati sul tuo traffico, con il prima e il dopo di ciascuno.
Ricerca AIQuali assistenti AI visitano il sito, cosa riceve ciascuno, AI Overviews e bot verificati.
I contenuti a colpo d'occhioLunghezze di title, description e H1, gruppi di pagine e le tue pagine più linkate.
Il programmaIl piano d'azione per stato e responsabile; una correzione segnata come Fatta ma ancora segnalata diventa rossa.
Crea la tuaFino a 10 dashboard: creane una nuova o copia una scheda, poi aggiungi, sposta, ridimensiona e rimuovi blocchi.
Fa la guardia per te
Neova non si ferma al crawl. Tiene d'occhio i tuoi siti tra un crawl e l'altro e ti avvisa quando qualcosa si muove, sul computer, sul telefono o nei canali del tuo team.
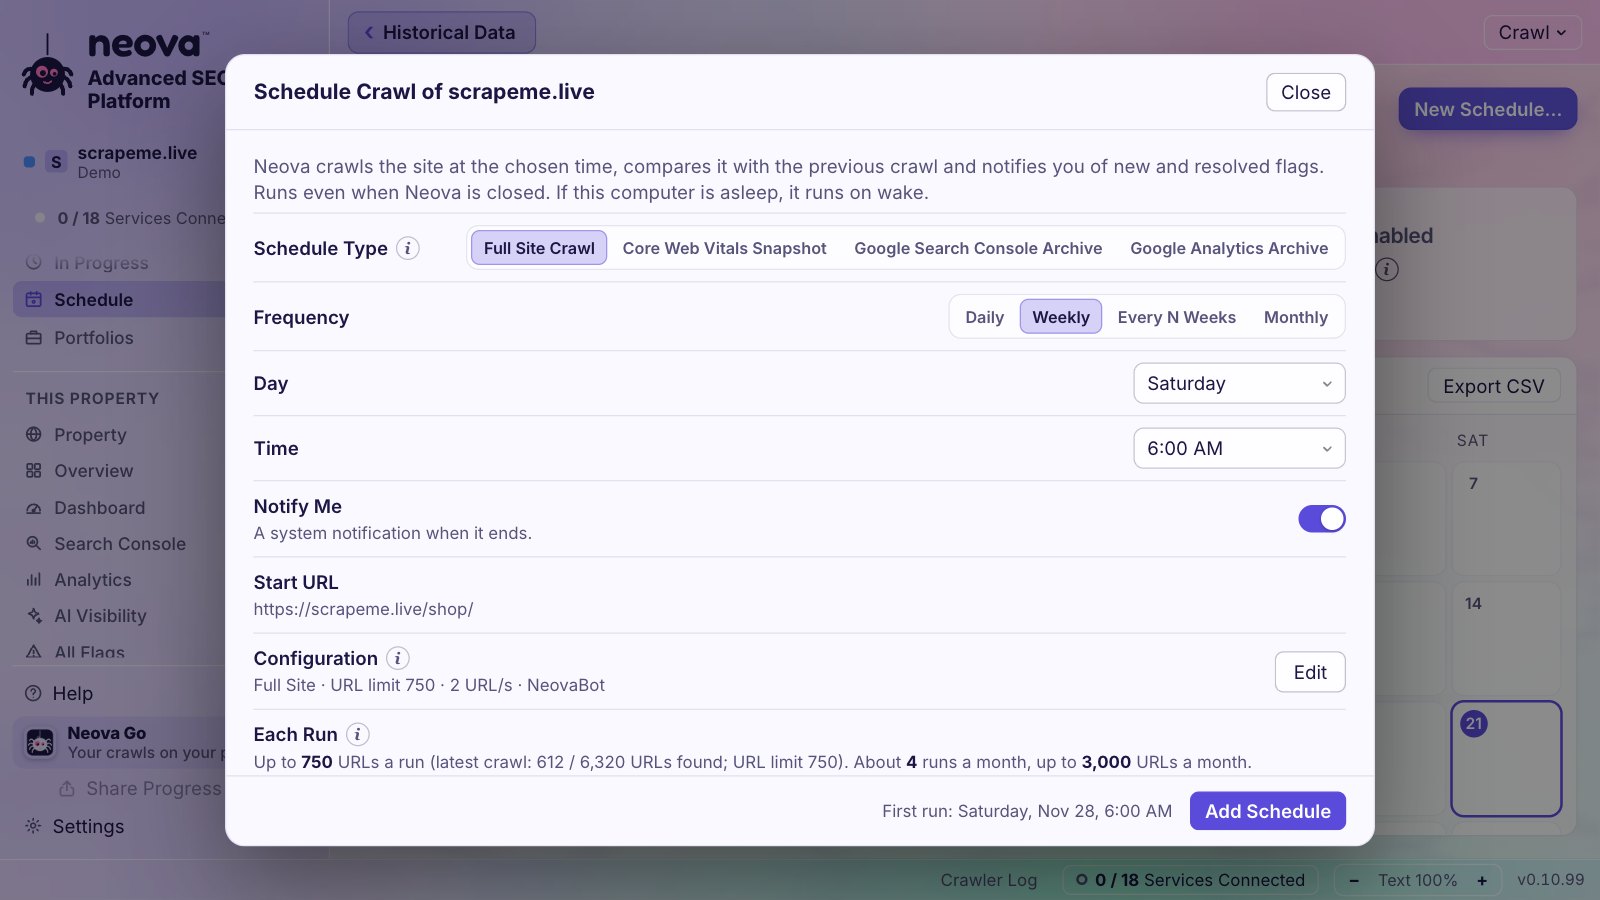
Una pianificazioneCon quale frequenza, il giorno e l'ora, e quanto costa ogni esecuzione.Neova GoLa barra dei menu, gli avvisi e il tuo telefono.Istantanee Core Web VitalsLa velocità degli utenti reali con una pianificazione tutta sua, senza crawl.
Crawl pianificatiOgni giorno, ogni settimana, ogni poche settimane o ogni mese, per proprietà, anche con la finestra chiusa. Un preavviso 15 minuti prima, Rimanda o Salta dalla barra dei menu, e il costo di una pianificazione mostrato prima di aggiungerla.
Avvisi che contanoI Core Web Vitals cambiano fascia, i clic calano del 20% o più in una settimana, una ricerca monitorata entra o esce dalla top 10 o perde 3 posizioni, un nuovo crawl ha nuove segnalazioni. Verificati dopo ogni esecuzione pianificata, o quando fai clic su Controlla ora.
Crawl di monitoraggioRicontrolla solo le tue pagine chiave, senza scoperta di nuovi URL, e ti avvisa quando cambiano stato, redirect, title, canonical, noindex, H1 o dimensione della pagina.
Istantanee Core Web VitalsLa velocità degli utenti reali di Chrome con una pianificazione, senza crawl, che si aggiunge a un andamento da seguire settimana dopo settimana.
Ricerche monitorate, ogni giornoFino a 25 ricerche per proprietà da Search Console: posizione a 7 e 90 giorni, clic e impressioni, e se Google mostra un AI Overview che ti cita.
Gli aggiornamenti di Google sui tuoi clicDue anni di aggiornamenti del ranking e incidenti di Google tracciati sui tuoi clic giornalieri, con i tuoi clic prima e dopo ciascuno.
Un audit completo ogni meseL'intero audit, con i concorrenti, ripetuto ogni mese; Neova completa l'analisi e il PDF alla successiva apertura.
Avvisi dove sei tuNeova Go nella barra dei menu e sul telefono, una notifica quando un crawl finisce, e Slack e Microsoft Teams, con ogni portfolio o proprietà che invia ai propri canali.
Anche in Neova
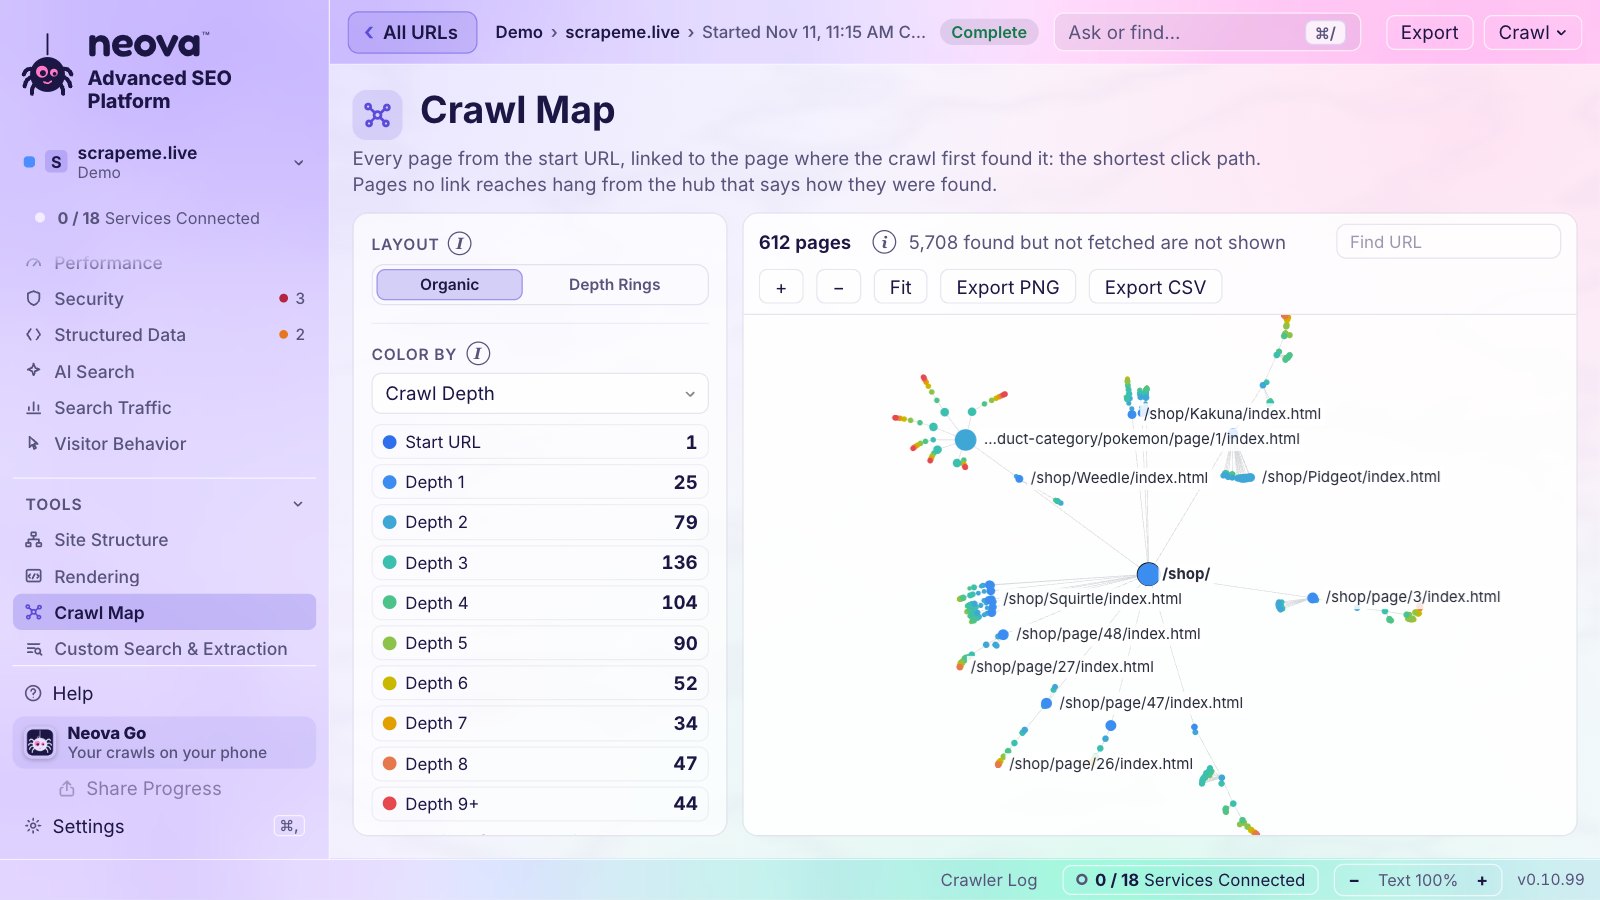
Mappa del crawlCome è stata trovata ogni pagina la prima volta, colorata per stato.Tutti gli URLOgni URL con il suo stato, l'indicizzabilità e la dimensione.Dati storiciI tuoi crawl e Search Console, conservati anche dopo che Google li cancella.
Log del crawlerOgni URL che il crawl recupera, in diretta, con il codice di stato colorato e il tempo di risposta; le fasi in grassetto, gli errori in rosso. Copialo per l'assistenza con un clic.
Crawl bloccato, spiegatoQuando un sito rifiuta il crawl, Neova dice perché (limite di richieste, un firewall, un blocco per paese) e cosa fare, con un header segreto di allowlist da passare all'IT.
Diagnosi di un crawlLegge il log di un crawl e indica cosa è andato storto, 429, 403, blocchi del robots.txt, pagine solo JavaScript, con l'impostazione da cambiare.
Ripartizione degli URLOgni URL trovato finisce in una sola categoria, così sai sempre da dove arrivano le migliaia in più, mentre il crawl è in corso.
Un crawl live da seguireFasi con frecce, Ultimi URL, una mappa del crawl in diretta e il grafico dei tempi di risposta, e Condividi avanzamento per farlo seguire a chiunque.
Search Console e Analytics, conservati per sempreGoogle cancella i dati di Search Console a 16 mesi e i dati evento di Analytics a 2 o 14. Neova archivia ogni mese di entrambi sul tuo computer, in modo programmato: pagine, query, giorni e Discover da Search Console; giorni, pagine di destinazione organiche, canali, sorgenti e paesi da Analytics. Per tutto il tempo che vuoi.
Sai cosa aspettarti prima di iniziareLegge prima alcune pagine e ti dice quanti URL elencano le sitemap e quante immagini aspettarti, così scegli tu la dimensione del crawl.
Un crawl che non perdi maiPrima le pagine, una protezione del disco, Esci salva il crawl, gli aggiornamenti lo aspettano e Riprendi continua con le sue impostazioni.
Costi mostrati primaI costi di DataForSEO vengono stimati prima di spendere qualsiasi cosa, con un tetto per ogni crawl. Le fatture dei dati arrivano a te, al prezzo del fornitore.
Provalo con dati realiOgni account Neova Online parte con una Demo: un negozio e tre concorrenti, già scansionati, con tutte le impostazioni compilate.
Le tue chiavi restano tueOgni chiave, token e accesso finisce nel portachiavi del sistema, mai in un file o sullo schermo. Neova non include chiavi API proprie: quello che paghi ti viene fatturato direttamente.
In 15 lingueLa finestra e la libreria dei controlli in inglese, francese, tedesco, spagnolo, portoghese, italiano, giapponese, olandese, polacco, turco, coreano, cinese, russo, indonesiano e vietnamita.
Funziona con
31 servizi
Neova si collega a 31 servizi che usi già, da Google Search Console a Slack, Jira e il tuo cloud drive. Ognuno è facoltativo.
Google
Google Search Console
Google Analytics
Chrome UX Report
Google Cloud
Gemini
Microsoft e Bing
Bing Webmaster Tools
OneDrive
Microsoft Teams
Dati SEO
DataForSEO
Semrush
Ahrefs
Majestic
Moz
SEO Gets
IA
Anthropic
OpenAI
Ollama
Ticket
Jira
Linear
Asana
ClickUp
monday.com
Avvisi e log
Slack
Microsoft Teams
Cloudflare
File e archiviazione
Google Drive
Dropbox
iCloud Drive
Proton Drive
kDrive
OneDrive
Apre i loro crawl
Screaming Frog
Sitebulb
I loghi appartengono ai rispettivi proprietari e indicano solo che Neova si collega a questi servizi. Neova non è affiliata a nessuno di essi.
Fianco a fianco
78 funzionalità
Ogni funzionalità, un segno per strumento. Mostra dettagli aggiunge cosa fa ciascuno, con la pagina della documentazione di quello strumento da cui proviene.
Dove e come scansionaScreaming Frog 15Sitebulb 13Semrush 10Ahrefs 10Lumar 13JetOctopus 13Neova 17su 17
Funzionalità
Screaming Frog
Sitebulb
Semrush
Ahrefs
Lumar
JetOctopus
Neova
App desktop
✓«Per eseguire SEO Spider serve un sistema operativo a 64 bit.» fonte
✓Solo Windows e macOS («versione a 64 bit di Windows 10 o 11») fonte
◐Sul tuo servernessuna versione browser o in hosting. fonte
✓Sitebulb CloudSitebulb Cloud: «Sitebulb Cloud ti offre tutte le capacità della versione Desktop, accessibili dal browser.» Ogni cliente riceve un server come yoursite.sitebulb.cloud. fonte
✓App webInteramente nel browser: Semrush si descrive come «la principale piattaforma SaaS per la gestione della visibilità online». fonte
✓Neova OnlineNeova Online in qualsiasi browser, sullo stesso account dell'app desktop, sempre sincronizzato
Rendering JavaScript
✓«Esegui il rendering delle pagine web con il WRS Chromium integrato per scansionare siti e framework dinamici e ricchi di JavaScript, come Angular, React e Vue.js.» Solo con licenza a pagamento. fonte
✓Chrome Crawler: «Sitebulb usa un motore di rendering Chromium Evergreen, proprio come Google» fonte
✓Sì, nei piani Guru o Business (Semrush One Pro+ o Advanced) fonte
✓«La modalità di crawl con rendering JavaScript è inclusa nel prezzo del piano (nessun costo aggiuntivo)», ma «una pagina renderizzata in JS conta come due normali pagine scansionate». fonte
✓Chrome, per tutte le pagine o per un certo numero
Modalità elenco
✓«Mode > List»: «controlla un elenco predefinito di URL... fonte
✓Regole «Allow subfolders» e «Disallow subfolders», più «Parameters to ignore», così Site Audit elimina i parametri degli URL durante il crawl. fonte
✓Regole regex: «Only crawl URLs matching the pattern» e «Don't crawl URLs matching the pattern», più «Remove URL parameters» e regole di riscrittura degli URL. fonte
✓Campi «Included Only URLs» ed «Excluded URLs» (regex Ruby fonte
✓Regole «Allow Pattern» e «Deny Pattern» nelle impostazioni avanzate, come percorsi URL o regex con il prefisso «rx:» fonte
✓Inclusioni, esclusioni e un elenco di esclusione per ogni crawl
Limiti di velocità del crawl
✓«controlla la velocità di SEO Spider, tramite il numero di thread simultanei o gli URL richiesti al secondo» (5 thread di default). fonte
✓Numero di thread o di istanze di Chrome e «Max HTML URLs per Second» fonte
✓La velocità predefinita è «limitata a un massimo di 30 URL al minuto» fonte
✓Velocità del crawl in URL al secondo (massimo per account stabilito da Lumar), e puoi «aggiungere restrizioni per ridurre o aumentare la velocità dei crawl in determinati orari». fonte
✓robots.txt Overwrite per «testare un nuovo robots.txt prima di metterlo online» su un crawl completo fonte
✓Il Robots.txt Multi-tool gratuito «convalida il tuo file robots.txt, evidenzia le direttive in conflitto» e simula le regole per ogni bot fonte
✓Tester del robots.txt; rispettalo, ignoralo o usa una bozza
User agent personalizzato
✓«user agent predefiniti integrati per Googlebot, Bingbot, vari browser e altro», più uno user agent personalizzato per le richieste HTTP e un Robots User-Agent separato. fonte
✓Preset «tra cui Google, Bing, Yahoo e Yandex», più «Custom User Agent» e uno user agent personalizzato per il robots.txt. fonte
◐solo preset, «Ci sono 5 user agent in tutto» fonte
✓Qualsiasi user agent, e Scansiona come un crawler AI
Login e autenticazione
✓«due forme di autenticazione: quella basata su standard, che comprende l'autenticazione basic e digest, e quella basata su moduli web.» fonte
✓Autenticazione HTTP e autenticazione tramite moduli, più header HTTP personalizzati. fonte
◐solo autenticazione basic: «Crawl with my credentials» per i siti «nascosti da autenticazione di accesso basic», più un'opzione di firma Web Bot Auth. fonte
◐Solo autenticazione HTTP, dal piano Advanced in su fonte
◐autenticazione basic («includi le credenziali di autenticazione in tutte le richieste usando l'autenticazione basic»), DNS personalizzato, allowlist degli IP e cookie di login tramite header di richiesta personalizzati fonte
✓Quando si raggiungono i limiti del crawl puoi «modificare le impostazioni del crawl, riprendere il crawl o completarlo» fonte
✓I crawl in corso si possono mettere in pausa e riprendere fonte
✓Pausa, Riprendi, ed Esci salva prima il crawl
Crawl di più siti insieme
✓Una finestra per crawlFAQ: «Apri più istanze di SEO Spider, una per ogni dominio che vuoi scansionare», oppure usa la modalità elenco con un elenco di domini. fonte
◐Cloud: da Medium in suLa versione desktop mette in coda gli audit («verranno eseguiti uno dopo l'altro») fonte
✓Nessun limiteFAQ: «puoi eseguire crawl, grandi e piccoli, tutti nello stesso momento» e «Non limitiamo il numero di domini diversi che puoi scansionare». fonte
✓Illimitato«I crawl simultanei sono illimitati in tutti i piani JetOctopus, senza costi aggiuntivi.» Anche progetti e domini sono illimitati. fonte
✓4 in una finestraFino a 4 siti insieme, ognuno al suo ritmo, con una protezione della memoria (0.10.38)
Limiti di URL
✓Illimitato, a pagamentoGratis: 500 URL per crawl. fonte
✓Diagrammi force-directed del crawl e delle directory (2D e 3D), grafici ad albero del crawl e delle directory, word cloud e il diagramma dei cluster semantici dei contenuti (v22.0). fonte
✓«Crawl maps» interattive («Best Software Innovation» agli US Search Awards 2018), altre visualizzazioni del sito, grafici e timeline. fonte
◐grafici più una vista «Site Structure» di «sottodomini e sottocartelle, con il numero di URL e di problemi in ciascuno». fonte
✓«Visualizza i dati con grafici e diagrammi» per indicizzabilità, velocità di caricamento, duplicati e codici di stato fonte
◐grafici di ripartizione, funnel e andamento nelle dashboard e in ogni report (schede «Trends & Segments», «Breakdown»). fonte
✓«JetOctopus offre oltre 97 report, 381 grafici, 26 dataset» fonte
✓Mappa del crawl
Confronto tra crawl
✓«Mode > Compare» mostra URL Added, New, Removed e Missing per scheda e filtro, una scheda Change Detection e il confronto della struttura del sito (richiede licenza e archiviazione su database fonte
✓«Audit Comparison»: «Monitora le modifiche nel tempo, scopri cosa è cambiato dall'ultimo audit» fonte
✓«Compare Crawls» ti permette di «vedere qualsiasi audit passato in un confronto fianco a fianco» con i problemi Fixed e New fonte
✓«Site Audit ti permette di confrontare due crawl qualsiasi» fonte
✓Ogni report si confronta con il crawl precedente fonte
✓«Puoi confrontare qualsiasi crawl, non solo gli ultimi due», con tutti i grafici e le tabelle di dati del crawler, anche per segmento fonte
✓Ricerca personalizzata nel codice sorgente e «Custom Extraction: estrai qualsiasi dato dall'HTML di un URL con XPath, selettori CSS Path o regex» fonte
✓Estrazione di contenuti tramite selettore CSS (selettore visivo punta e clicca) fonte
✓Custom Extraction con regex (30 metriche di estrazione) fonte
✓«puoi configurare fino a 50 regole di estrazione personalizzate durante un crawl» fonte
✓Ricerca ed estrazione
Revisione AI dei contenuti delle pagine
✓OpenAI, Gemini, Anthropic, OllamaIntegrazioni API dirette con OpenAI, Gemini, Anthropic e Ollama (LM Studio tramite l'integrazione OpenAI) fonte
◐MCP, sola letturanessun prompt AI eseguito sui contenuti delle pagine durante un crawl. fonte
◐Una pagina alla voltaContent Toolkit, una pagina alla volta fonte
◐Attività predefinitesolo attività AI fisse: «Ask AI» e «Batch AI» scrivono title e meta description (Project Boost), più il rilevamento dei contenuti generati dall'AI fonte
◐Integratonessun prompt scritto dall'utente sui contenuti delle pagine. fonte
◐Integrato, MCPnessun prompt dell'utente eseguito su ogni pagina fonte
✓Ollama, Anthropic, OpenAI44 controlli di revisione AI eseguiti da Ollama sul tuo computer; chiavi Anthropic e OpenAI in Collegamenti
Somiglianza semantica
✓Embedding vettoriali da OpenAI, Gemini o Ollama «per individuare pagine semanticamente simili e contenuti poco pertinenti, oltre alla ricerca semantica e al diagramma dei cluster di contenuti fonte
◐niente di integrato. Una guida sul loro sito (8 ottobre 2026, autore ospite) fonte
✓29Libreria Hints: On Page 22 e Duplicate Content 7 (29 in tutto), più i report Spelling Errors e leggibilità. fonte
✓140+ in totale«Con la possibilità di controllare oltre 140 problemi del sito» fonte
✓170+ in totale«Analizza oltre 170 problemi» nelle categorie tecniche e on-page, più problemi personalizzati fonte
✓43 reportNessun totale pubblicato. Il mio conteggio dal loro elenco di report API fonte
✓Circa 100 in totaleCirca 100: l'analisi dei problemi esegue «circa 100 controlli predefiniti su crawl, log e Search Console, raggruppati per gravità». fonte
✓8282 controlli sui contenuti, 20 dei quali di revisione AI
✓Scheda Response Codes: bloccati dal robots.txt, nessuna risposta, 2XX, 3XX, 4XX e 5XX, per URL interni ed esterni. fonte
✓«Status Code: il codice di stato HTTP (ad es. fonte
✓Errori «Pages returning 4XX status code» e «Pages returning 5XX status code», errori DNS e di crawl, più un avviso per i link esterni che restituiscono 403. fonte
✓Le pagine non 200 sono «elencate sotto il rispettivo problema» (404, 4XX, 5XX, 403, timeout, redirect non funzionanti) fonte
✓Report per pagine 200, redirect 301 e non 301, «4xx Errors», «5xx Errors», «Uncategorized HTTP Response Codes» e URL non riusciti fonte
✓Grafici e tabelle dei codici di stato nei crawl e nei log fonte
✓Sì, con colori ovunque
Redirect e catene
✓«Trova i redirect temporanei e permanenti, individua catene e loop di redirect» fonte
✓13 hint Redirects (redirect non funzionanti, loop di redirect, redirect per slash finale e maiuscole, meta refresh) fonte
✓«Redirect chains and loops» (Error), «Pages with temporary redirects», «URLs with a permanent redirect» fonte
✓Il problema «Redirect chain» «segnala gli URL che portano a una serie di redirect» fonte
✓Report «Redirect Chains» («redirect verso un altro URL che è a sua volta un redirect»), «Redirect Loops», redirect non funzionanti, JavaScript e meta refresh, e «Max Redirections». fonte
✓Tabella delle catene di redirect, dove «puoi anche cambiare il numero di salti nella catena di redirect» fonte
✓22 controlli sui redirect, catene e loop
Canonical
✓La scheda Canonicals copre gli elementi link canonical e gli header HTTP fonte
✓Errori «Pages with a broken canonical link», «Pages with multiple canonical URLs» e «AMP pages with no canonical tag» fonte
✓Problemi come «Canonical points to redirect», canonical verso 4XX o 5XX, pagina non canonical indicata come canonical e canonical HTTP/HTTPS non coerenti. fonte
✓«Conflicting Canonical Tags» («nei tag canonical HTML o negli header HTTP»), Canonical to Non-200, Pages without Canonical Tag, Unlinked Canonical Pages, Change fonte
✓Per rel=canonical, «abbiamo creato diversi report con i problemi più comuni», più una modalità apposita per i sottodomini mobile separati. fonte
✓Sì
Report di indicizzabilità
✓Ogni URL è «Indexable» o «Non-Indexable» con un motivo in «Indexability Status» fonte
✓«verifica direttive robots sovrapposte o incoerenti, problemi di canonical ed errori di configurazione del robots.txt» fonte
◐nessuna colonna né report di indicizzabilità fonte
✓Categoria di problemi Indexability e grafico di distribuzione fonte
✓«Non-Indexable Pages» («escluse dall'indicizzazione tramite noindex o canonical»), report su noindex, pagine canonicalizzate e bloccate fonte
✓Segmento «Indexable» integrato per tutti i report fonte
✓145 controlli di indicizzabilità
Paginazione
✓Scheda Pagination per rel=«next» e rel=«prev» fonte
◐hint «Pagination URL has no incoming internal links» e «Query string contains paginated parameters» fonte
✓Verifica la scansionabilità delle pagine paginate nel crawl e nei log fonte
✓Controlli di paginazione
Hreflang
✓«Verifica tag di ritorno mancanti, codici lingua incoerenti e errati, hreflang con risposta non 200 e altro» fonte
✓«verifica che i tag hreflang siano validi, reciproci, unici, coerenti e autoreferenziali» fonte
◐Il report International SEO verifica conflitti, valori, link non funzionanti e tag mancanti, ma «al momento Semrush controlla solo l'HTML del tuo sito» (non sitemap né header). fonte
✓Segnala codici non validi, autoreferenza mancante, tag di ritorno mancanti, hreflang verso pagine non funzionanti o non canonical fonte
✓Controlli Sitemaps: «URLs Not In Sitemap», «Orphan URLs», «Non-Indexable URLs In Sitemap», «XML Sitemap With Over 50k URLs», «XML Sitemap Over 50mb», «URLs In Multiple Sitem fonte
✓9 hint XML Sitemaps (4XX, 5XX, noindex, canonicalizzate, bloccate, redirect, timeout, URL in più sitemap), rilevamento delle pagine orfane e un generatore di sitemap XML. fonte
✓Errori come «Format errors in sitemap.xml files», «Incorrect pages found in sitemap.xml», «Sitemap.xml files are too large» fonte
✓Problemi di sitemap come «Non-canonical page in sitemap», pagine noindex, 3XX, 4XX o 5XX nella sitemap, pagine della sitemap in timeout e formato non valido (solo XML). fonte
✓URL non indicizzabili, in errore e in redirect nelle sitemap, sitemap non funzionanti o bloccate, troppi URL, sitemap vuote fonte
✓Report sitemap con URL orfani e non 200, «Sitemaps problems by depth» e una tabella «Sitemap files» fonte
✓20 controlli sulla sitemap XML
Link interni e Link Score
✓«Analizza i link interni, il numero di link, la profondità di crawl e calcola il Link Score interno» fonte
✓«URL Rank, o UR, è una misura della forza interna di una pagina basata sul peso relativo dei link» fonte
✓Page Rating (PR) valuta la forza dei link di ogni URL «su una scala logaritmica da 1 a 100» fonte
✓DeepRank: «una misura del peso dei link interni calcolata in modo simile all'algoritmo PageRank di base di Google», su una scala da 0 a 10 fonte
◐analisi approfondita dei link (inlink, anchor, nofollow, Linking Explorer) fonte
✓Link Score e 51 controlli sui link
Pagine orfane
✓«Per scoprire le pagine orfane servono altre fonti di URL, che arrivano dalle sitemap XML e dall'integrazione con le API di Google Analytics e Search Console.» fonte
✓Le pagine orfane sono «URL scoperti nell'audit, ma NON dal crawler», trovati tramite sitemap XML, Google Analytics, Search Console o elenchi di URL fonte
✓Notice «Orphaned pages (from Google Analytics)» e «Orphaned pages (in sitemap)» fonte
◐«Orphan page» copre gli URL senza link interni in entrata, arrivati dai seed del crawl o «trovati nel file sitemap» fonte
✓Report sulle pagine orfane per fonte (Search Console, analytics, sitemap, file di log, elenchi di URL, backlink), ad esempio fonte
✓Report «Orphan Pages» dalle fonti di URL sitemap e GSC, filtrabile per fonte fonte
✓Pagine orfane, da Search Console, Analytics e sitemap XML
Sicurezza e HTTPS
✓«Scopri pagine non sicure, contenuti misti, moduli non sicuri, header di sicurezza mancanti e altro» fonte
✓Il report Security verifica protocolli TLS, cipher suite e certificati fonte
✓Report sulla configurazione mobile (responsive, dinamica, mobile separato), «Discouraged Viewport Types» («scarsa compatibilità mobile»), discrepanze del mobile separato fonte
✓Un crawl con Googlebot Mobile «fa emergere i problemi di usabilità mobile» come «viewport configurato male, dimensioni dei caratteri non conformi, target di tocco» fonte
✓Controlli su viewport e mobile
Immagini
✓Testo alt e attributo alt mancanti, «Over 100 kb», testo alt oltre 100 caratteri, «Incorrectly Sized Images», «Missing Size Attributes», immagini di sfondo, missing image t fonte
✓Gli hint sulle immagini sono questi: «Images with missing alt text», «Has an anchored image with no alt text», «Transferred image size is over 100KB», «Properly size images», «Add dimensions to images», e anche i formati di nuova generazione fonte
✓«Esaminiamo dimensioni, tempi di caricamento e tipi di contenuto delle immagini», immagini non funzionanti e attributi alt («Set» e «Not set») fonte
✓«Broken Images», «Links with Images Missing Alt Tags», regole di accessibilità image-alt e audit Lighthouse sulle immagini in Site Speed (senza dimensioni, fuori schermo, non ottimizzate, non resp fonte
◐crawl delle immagini (disattivato per impostazione predefinita) fonte
✓20 controlli sulle immagini e campionamento delle immagini per gruppo di pagine
Velocità e Core Web VitalsScreaming Frog 3Sitebulb 1Semrush 1Ahrefs 4Lumar 4JetOctopus 3Neova 4su 4
Funzionalità
Screaming Frog
Sitebulb
Semrush
Ahrefs
Lumar
JetOctopus
Neova
Lighthouse
✓«Collegati all'API PSI per metriche Lighthouse, opportunità di velocità, diagnostica e Chrome User Experience Report (CrUX) fonte
✓«Opportunities and Diagnostics» di Lighthouse eseguiti «su ogni singola pagina web scansionata» dal Chrome Crawler integrato, più le metriche di laboratorio Web Vitals (LCP, CLS, TBT, TTI, FCP fonte
✓Report Core Web Vitals «basato sullo strumento Lighthouse di Google» (LCP, CLS, TBT) fonte
✓PageSpeed Insights per pagina con la tua chiave API Google gratuita fonte
✓In Site Speed: «metriche di prestazione Lighthouse su larga scala», con report di opportunità e diagnostica per pagina e un Lighthouse Viewer integrato (giugno 2025). fonte
✓API PageSpeed con la tua chiave («il tuo limite sarà di 30,000 richieste al giorno») fonte
✓LCP, INP, CLS e FID di CrUX per pagina, con categorie e distribuzioni fonte
✓In Site Speed: il CRUX Domain Summary «mostra le metriche CrUX per un dominio principale e per gli altri domini trovati» (CLS, FCP, INP, LCP, TTFB). fonte
◐il foglio Google «Historical Audit Data» ha una riga per audit per «dati in serie temporale o grafici» in Looker Studio, e include i valori delle fasce Core Web Vitals (changelog, 13 fonte
✓In Site Speed: «un grafico dell'andamento per ciascun KPI» (FCP, LCP, TBT, CLS), diviso in Slow, Moderate, Fast, un punto per crawl (dati di laboratorio) fonte
◐controlli CWV pianificati («+Create a CWV schedule») fonte
✓Un andamento di 40 settimane dal primo giorno, e una vista per gruppo di pagine
Core Web Vitals pianificati
✓I crawl pianificati possono usare l'API PSI fonte
◐audit pianificati e ricorrenti (Pro e Cloud) fonte
◐solo dentro i Site Audit pianificati («Weekly», «Daily»), il cui report Core Web Vitals ritesta le stesse 10 pagine con Lighthouse. fonte
✓I CWV vengono recuperati a ogni crawl con PSI attivo, anche in quelli pianificati fonte
◐nessun report sui crawler AI né preset per i bot AI fonte
✓«Blocked from AI Search» verifica il robots.txt per ChatGPT-User, OAI-SearchBot, Googlebot, Google-Extended, Perplexity-User, PerplexityBot, Claude-User, Claude-SearchBot. fonte
✓Problemi AI Discoverability (settembre 2026) fonte
✓«ChatGPT Blocked» («bloccato nel robots.txt per i token user agent GPTBot o ChatGPT-User»), Google AI Blocked (Google-Extended), Bing AI Blocked, AI Bot Blocked, Common fonte
✓Il Robots.txt Multi-tool gratuito permette di «verificare in un unico posto le regole di accesso per i crawler di ricerca e AI», tra cui GPTBot, ClaudeBot e PerplexityBot. fonte
✓Cosa può scaricare ogni crawler AI, e cosa ricevono davvero 10 assistenti AI
◐nessun controllo dedicato alle risposte AI. fonte
◐nessun controllo sulle risposte AI. Il report Response vs Render è presentato per «identificare esattamente cosa vedono gli LLM» fonte
✓Controlli AI Search: «Too much content», «Outdated Content» (Last-Modified oltre sei mesi), «Low Semantic HTML Usage», «Content not optimized» (heading, paragrafi lunghi, r fonte
✓AI Discoverability: pagine «troppo lente o pesanti per i crawler AI», «Pages requiring JavaScript rendering», «Similar AI-generated content» fonte
✓AI Page Optimizer permette di «confrontare le keyword target con title, meta e contenuto» per le query fan-out, e verifica «se JavaScript nasconde i tuoi contenuti agli agenti AI». fonte
✓GA4 e GA360: visite, frequenza di rimbalzo, visualizzazioni di pagina e conversioni per URL, filtrabili per organico, «Google or Bing Organic Search Landing Pages, or All» fonte
✓«l'integrazione funziona solo con Google Analytics 4. fonte
◐Bingbot nei log e nel tester del robots.txt («dati completi su Googlebot, Bingbot, GPTBot, ClaudeBot e altri 40+ crawler») fonte
✓Bing Webmaster Tools, comprese le citazioni nell'AI di Bing
Monitoraggio del ranking
◐nessun rank tracker. L'integrazione con Search Analytics di GSC dà la «Position» media per URL. fonte
◐nessun rank tracker. Il report Keywords usa i dati di GSC fonte
✓Position Tracking «monitora ogni giorno il posizionamento del tuo sito» per dispositivo e località «fino al codice postale», su Google, Bing, Baidu, ChatGPT Search e AI Mode. fonte
✓Rank Tracker: Google, «monitoraggio mobile e desktop», 190+ località fino al codice postale, 19 funzionalità della SERP fonte
◐nessun rank tracker; solo la posizione GSC per pagina e query. fonte
◐Ranking basati su GSC, nessun rank tracker sulla SERP fonte
✓25 ricerche monitorate al giorno da Search Console; posizioni reali tramite DataForSEO
Dati sulle keyword
◐Metriche Search Analytics di GSC per URL (intervallo di date e dimensioni configurabili) fonte
✓Report Keywords costruito da Google Search Console («enable Keyword Analysis»), con le keyword di brand. fonte
✓Position Tracking: «il report Competitors Discovery rivela i concorrenti organici posizionati per le tue keyword» fonte
✓I nuovi progetti «ricevono suggerimenti di concorrenti in base ai siti posizionati per keyword simili» fonte
✓In AI Visibility: «i brand vengono scoperti automaticamente dalle risposte dei provider AI» e Lumar classifica ciascuno come Own, Competitor, Other o Context. fonte
✓La scheda Schedule imposta «il giorno, l'ora e il fuso orario» fonte
✓«imposta pianificazioni per i tuoi crawl (ad es. fonte
✓«New scheduled crawl» con frequenza giornaliera, settimanale, ogni due settimane o mensile, data di inizio e fuso orario fonte
✓Pianificazioni con preavviso, Rimanda e Salta (app desktop)
Rilevamento delle modifiche
✓Scheda «Change Detection» della modalità Compare per gli elementi scelti (title, description, H1, numero di parole e altro) fonte
✓«Lost and Found confronta le metriche chiave degli URL e gli hint attivati dal tuo audit attuale con l'audit precedente più recente» (Found, Lost, Remained) fonte
◐confronto tra crawl, e il report Robots.txt «ti dirà se Semrush ha notato modifiche al tuo file robots.txt». fonte
✓Always-on audit: «ora puoi vedere tutto ciò che è cambiato sul tuo sito in qualsiasi giorno» fonte
✓Changed Metrics mostra «quali metriche sono cambiate da un crawl all'altro» per URL, più report come Pages with Changed Title, Status Code e Canonical URLs. fonte
✓Avvisi più estrazione personalizzata per «monitorare le modifiche agli elementi della pagina e vedere se corrispondono ai valori attesi» fonte
✓Modifiche ai contenuti tra un crawl e l'altro; le modifiche si evidenziano mentre scansiona
Avvisi e notifiche
✓Email a fine crawl tramite Outlook, Gmail o SMTP personalizzato, con una tabella Issues fonte
✓«Sitebulb ti manderà una email amichevole ogni volta che il tuo audit è finito» (impostato per progetto, più indirizzi possibili). fonte
✓Site Audit invia «aggiornamenti automatici via email» quando è pianificato fonte
✓Always-on audit manda una email «se una nuova pagina è colpita da un problema di livello errore» (anche per problemi personalizzati), più email a fine crawl, report di Rank Tracker e Ahrefs Alerts. fonte
✓Crawl Email Alerts sull'avanzamento del crawl fonte
✓Avvisi illimitati per log, GSC, crawl e Core Web Vitals fonte
✓Notifiche di sistema, Neova Go sul telefono, Slack e Microsoft Teams; email in arrivo
◐I report PDF si personalizzano per sezione, e la citazione di un cliente nella loro pagina delle funzionalità elogia «PDF e report CSV completamente white-label» fonte
✓Sì, con l'add-on Pro Report ($20/mese per report) fonte
–«Al momento non permettiamo di rendere white-label i nostri report.» fonte
◐FAQ: «l'interfaccia può essere resa white-label con il tuo logo». fonte
✓Esportazioni CSV in formati per fogli di calcolo, esportazione in Google Sheets (Keywords Explorer, Brand Radar, Bot Analytics), connettori Looker Studio per Site Audit, Site Explorer, Rank Tra fonte
✓Download dei report in CSV (più CSV con Exploded Metric per Excel), un connettore Looker Studio da «Google Partner ufficiale» con modelli, e dashboard Google Sheets tramite Zapi fonte
✓Esportazione in «Excel, Google Sheets, CSV o Google Data Studio (Looker)» fonte
✓Cartella di lavoro Excel (per Google Sheets), CSV pronto per Looker Studio
Destinazioni di esportazione
✓Cartella locale; Google Drive come Google Sheets (manuale o pianificato fonte
✓Esportazioni CSV e .xlsx, salvate in automatico dopo ogni audit in una cartella locale «O in una cartella condivisa, come un servizio di archiviazione cloud tipo Dropbox» fonte
✓Download CSV, Google Sheets (alcuni report), PDF tramite stampa, connettori Looker Studio, più API v3 e MCP fonte
✓Download dei report in CSV o XML, dati grezzi come file Parquet, connettori BigQuery e Looker Studio, Google Sheets tramite Zapier, strumenti BI (Tableau, Power BI), l'API e i webhook fonte
✓File CSV, Excel, Google Sheets e sitemap dalle tabelle di dati, più connettore Data Studio, BigQuery («esporta i dati del crawl e di GSC direttamente in BigQuery»), API e MCP. fonte
✓Scheda Dashboard della v25.0: «crea le tue dashboard personalizzate» con i widget (grafici, contatori, percentuali, tabelle riepilogative, elenco dei problemi, grafico dei segmenti...) fonte
◐nessuno strumento CLI; servizio cloud gestito tramite l'API o MCP, con token «per pipeline CI, script e agenti automatici» (Codex CLI, Gemini CLI). fonte
✓API v3 dal piano Lite in su, da 200,000 a 2,000,000 unità/mese, con endpoint Site Audit, Site Explorer, Keywords Explorer, Rank Tracker e Brand Radar. fonte
✓«l'API GraphQL di Lumar è disponibile per tutti gli utenti», con «una policy di utilizzo corretto» fonte
✓Tutti i piani: «accesso a tutte le funzioni essenziali di JetOctopus, tra cui creazione di progetti e crawl, dati dei grafici, tabelle di dati ed esportazioni». fonte
✓API REST di Neova Online con chiavi API (0.10.38), più il server MCP e la riga di comando
◐Una licenza a personale licenze sono per utente («se cinque persone del tuo team vogliono usare SEO Spider, ti servono 5 licenze»), sconti da 5 in su. fonte
✓Da 2 a 10+ utentiI piani Cloud includono utenti (Mini 2, Small 5, Medium 10, Enterprise 10+) fonte
✓Da $45 a utente«Utenti aggiuntivi a partire da $45/mese» fonte
✓Da $40 a utente1 utente incluso; utenti extra fonte
✓4 ruoli, SSORuoli del team «Admin, Editor, Reporter e Viewer» con permessi per app fonte
✓Utenti illimitati«Progetti e postazioni (utenti) fonte
PrestoIn arrivo. Oggi una persona per account
Lingue dell'interfaccia
✓7«L'interfaccia è disponibile in inglese, spagnolo, tedesco, francese, italiano, olandese e turco» (7 lingue fonte
◐Inglese, giapponesenessun elenco delle lingue dell'interfaccia trovato. fonte
–IngleseNon trovato nella loro documentazione. fonte
✓1515 lingue
Log del server
◐Log File Analyserun prodotto separato, Screaming Frog Log File Analyser (Windows, macOS, Linux), per «verificare i bot dei motori di ricerca e dell'AI». fonte
–ProssimamenteFAQ: «Sitebulb non fa ancora l'analisi dei file di log, ma è in sviluppo e sarà disponibile presto!» fonte
✓EnterpriseSì, come prodotto Enterprise separato fonte
◐Bot AnalyticsBot Analytics, uno strumento separato gratuito in beta sui piani a pagamento, «acquisisce i dati delle richieste HTTP» da Cloudflare, Vercel, CloudFront, load balancer AWS o Fastly fonte
✓InclusoIncluso in ogni piano, non un prodotto separato fonte
✓InclusoIncluso: log Apache e Nginx, Cloudflare letto direttamente, solo bot verificati
Staging e migrazioni
✓«Confronta gli ambienti di staging e produzione con l'URL Mapping avanzato» fonte
✓Scansiona i siti di staging con autenticazione HTTP o tramite modulo e impostazioni robots adattate, poi confronta gli audit tra «due Progetti qualsiasi». fonte
✓Sì, in Semrush Enterprise Site Intelligence fonte
◐«Scansiona siti di staging e ad accesso limitato... fonte
✓«scansiona il tuo ambiente di staging o di test e confrontalo con il sito live», con Test Site Domain, DNS personalizzato, basic auth e sovrascrittura del robots.txt. fonte
✓«Confrontare il crawl di un sito di staging e di quello live ti aiuta a costruire una versione funzionante senza errori» fonte
✓Staging rispetto a produzione, e una mappa dei redirect
Apre le esportazioni di altri crawler
◐la modalità elenco legge gli URL da qualsiasi file .txt, .xls, .xlsx, .csv o .xml («puoi caricare direttamente un download di Adwords») fonte
✓500 URL«Scarica e scansiona 500 URL gratis»... fonte
–Prova di 14 giorniNessuna versione gratuita: una «prova gratuita di 14 giorni» uguale a Pro, «senza carta di credito e senza impegno anticipato». fonte
✓100 paginePiano gratuito: «1 progetto demo», «10 report al giorno in tutti gli strumenti principali», «Non serve la carta di credito». fonte
✓5,000 per progettoAhrefs Free (ex Webmaster Tools), per i siti verificati fonte
✓Da $29 al meseSolo cloud: Starter $29/mese, Lite $129, Standard $249, Advanced $449, Enterprise su richiesta fonte
–Su richiestaNessun prezzo pubblico: «Definiamo il prezzo delle nostre soluzioni in base alle tue esigenze. fonte
✓Da $349 al meseSolo cloud, al mese con fatturazione annuale (in-house) fonte
✓Da $19 al mesePiano gratuito; piani a pagamento da $19 al mese (prezzo USA)
✓Sì◐In parte–Gli altri strumenti: no, o non trovato nella loro documentazione–Neova: non ancoraPrestoNeova: in arrivoOgni risposta sugli altri strumenti rimanda alla pagina del loro sito o della loro documentazione da cui proviene.
Cosa Neova non fa
Nessun database proprio di keyword o backlink: Ahrefs, Semrush, SE Ranking e Moz hanno i loro, e Neova usa invece le tue chiavi e la tua Search Console. Usalo insieme a queste suite, non al loro posto.
In arrivo: account di team e avvisi via email (oggi gli avvisi arrivano tramite il sistema, Neova Go, Slack e Microsoft Teams).
Ancora nessuna similarità semantica.
Colonne Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar e JetOctopus: solo ciò che dichiarano il loro sito e la loro documentazione, letti l'11 novembre 2026, con un link a ogni pagina. «Non trovato nella loro documentazione» significa che non l'abbiamo trovato, non che non si possa fare. Colonna di Neova: ciò che fanno oggi Neova e Neova Online, letto dall'app. 141 controlli di Neova non sono in nessuno degli elenchi pubblicati dai 10 strumenti SEO che abbiamo confrontato (Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar, Moz, SE Ranking, Seobility, Sitechecker e Conductor): ogni elenco confrontato voce per voce con la libreria di Neova il 25 ottobre 2026. I 67 controlli aggiunti da allora non sono contati finché non vengono confrontati. Questi nomi sono marchi dei rispettivi proprietari; Neova non è affiliata a nessuno di loro. Se una riga è sbagliata o non aggiornata, scrivi a hello@neova.app e la correggeremo.




 Google Search Console
 Google Analytics
 Chrome UX Report
 Google Cloud
 Gemini
 Bing Webmaster Tools
 OneDrive
 Microsoft Teams
 DataForSEO
 Semrush
 Ahrefs
 Majestic
 Moz
 SEO Gets
 Anthropic
 OpenAI
 Ollama
 Jira
 Linear
 Asana
 ClickUp
 monday.com
 Slack
 Cloudflare
 Google Drive
 Dropbox
 iCloud Drive
 Proton Drive
 kDrive
 Screaming Frog
 Sitebulb
 Lumar
 JetOctopus