Screaming Frog und Sitebulb haben die Messlatte für SEO-Crawler gesetzt, und wir haben von beiden viel gelernt. Hier steht Neova neben ihnen und neben Semrush, Ahrefs, Lumar und JetOctopus, nach deren eigener Dokumentation, mit Links.
4Orte, an denen Sie es nutzen: Mac, Windows, Linux, jeder Browser
15Sprachen
Mehrere Websites gleichzeitig crawlen
Desktop-App
Crawlen Sie Ihren Kunden, seine Wettbewerber und Ihre eigene Website in einem Durchgang. Bis zu 4 Websites crawlen gleichzeitig in einem Fenster, jede mit eigenem Tempo und URL-Limit, und ein Speicherwächter hält die nächste zurück, wenn der Arbeitsspeicher Ihres Computers knapp wird.
Zwei Crawls, ein Fenster„2 Crawls laufen“ oben: Klicken Sie auf einen, um ihn zu verfolgen.In BearbeitungJeder Crawl, sein Tempo, die belegten Plätze und der freie Arbeitsspeicher.
Bis zu 4 gleichzeitigStarten Sie einen Crawl, dann noch einen: Bis zu 4 Websites crawlen gleichzeitig. Einstellungen › Crawl › Gleichzeitige Crawls, standardmäßig 2; der nächste wartet in der Warteschlange, bis er dran ist.
Jeder in seinem TempoJeder Crawl behält seine eigene Geschwindigkeit, sein URL-Limit und seine Einstellungen, sodass eine langsame Kunden-Website die anderen nie ausbremst.
Ein SpeicherwächterJeder Crawl reserviert den Arbeitsspeicher, den er braucht, mit JavaScript-Rendering mehr. Wird der Speicher knapp, wartet der nächste Crawl und sagt, warum.
Ein Fenster für alleWechseln Sie oben im Live-Screen zwischen den laufenden Crawls. „In Bearbeitung“ zeigt sie alle, jeden mit Pause, Stoppen und Öffnen.
Screaming Frog: ein Crawl pro App-Instanz: ein Fenster, und dessen Arbeitsspeicher, für jede Website. Quelle Sitebulb: Die Desktop-App führt Audits nacheinander aus; gleichzeitig nur in den Tarifen Medium und Enterprise von Sitebulb Cloud. Quelle
Ein Blick hinein
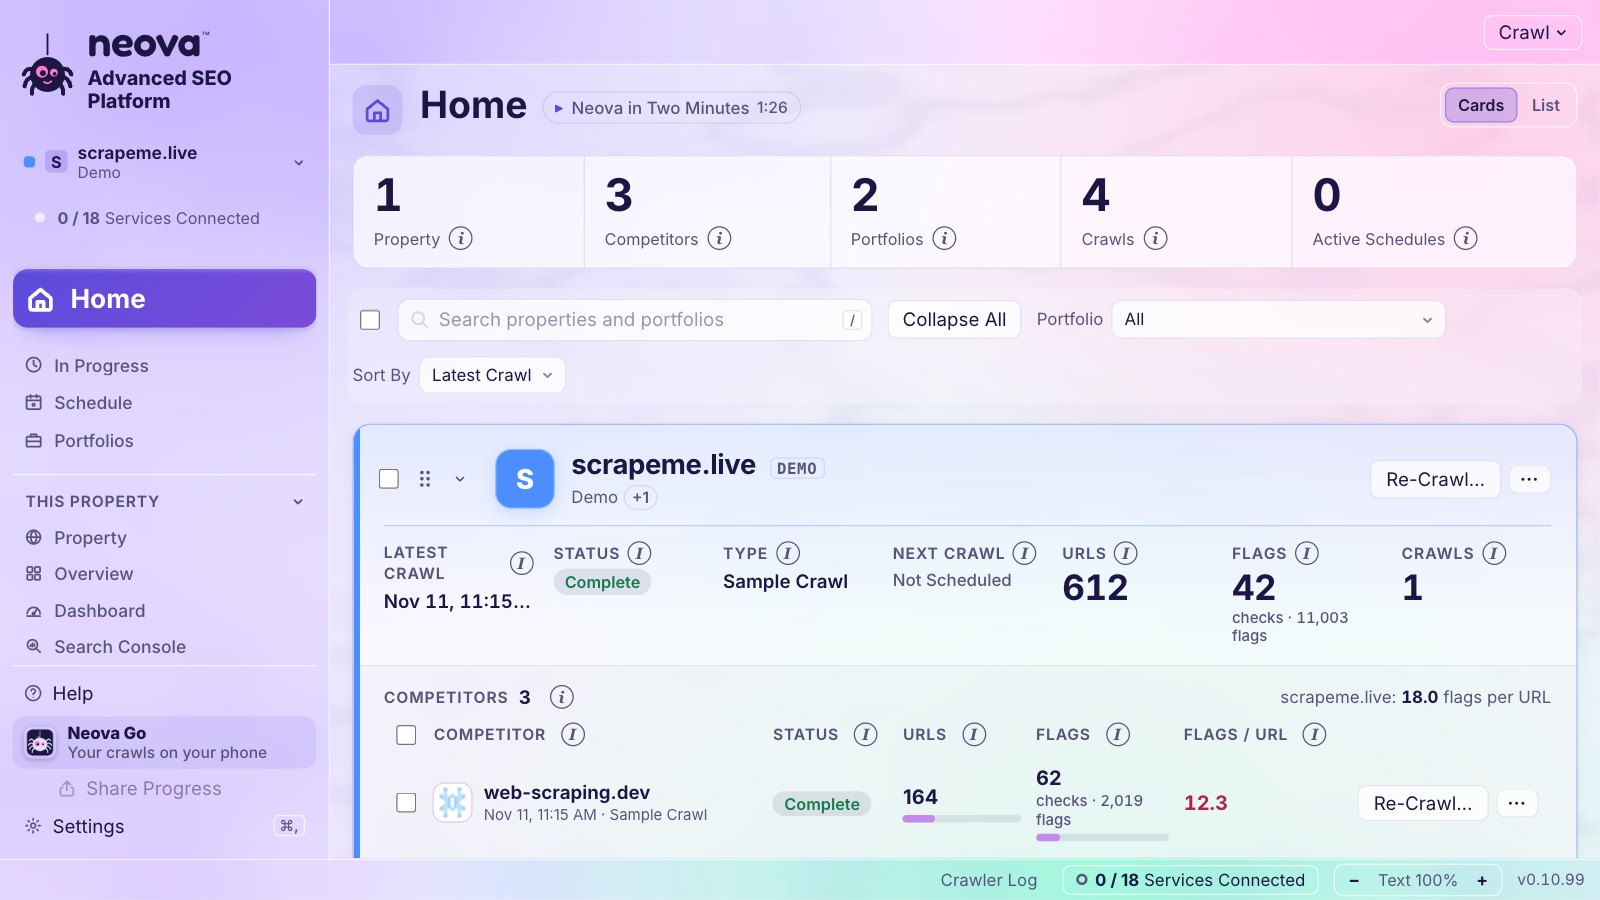
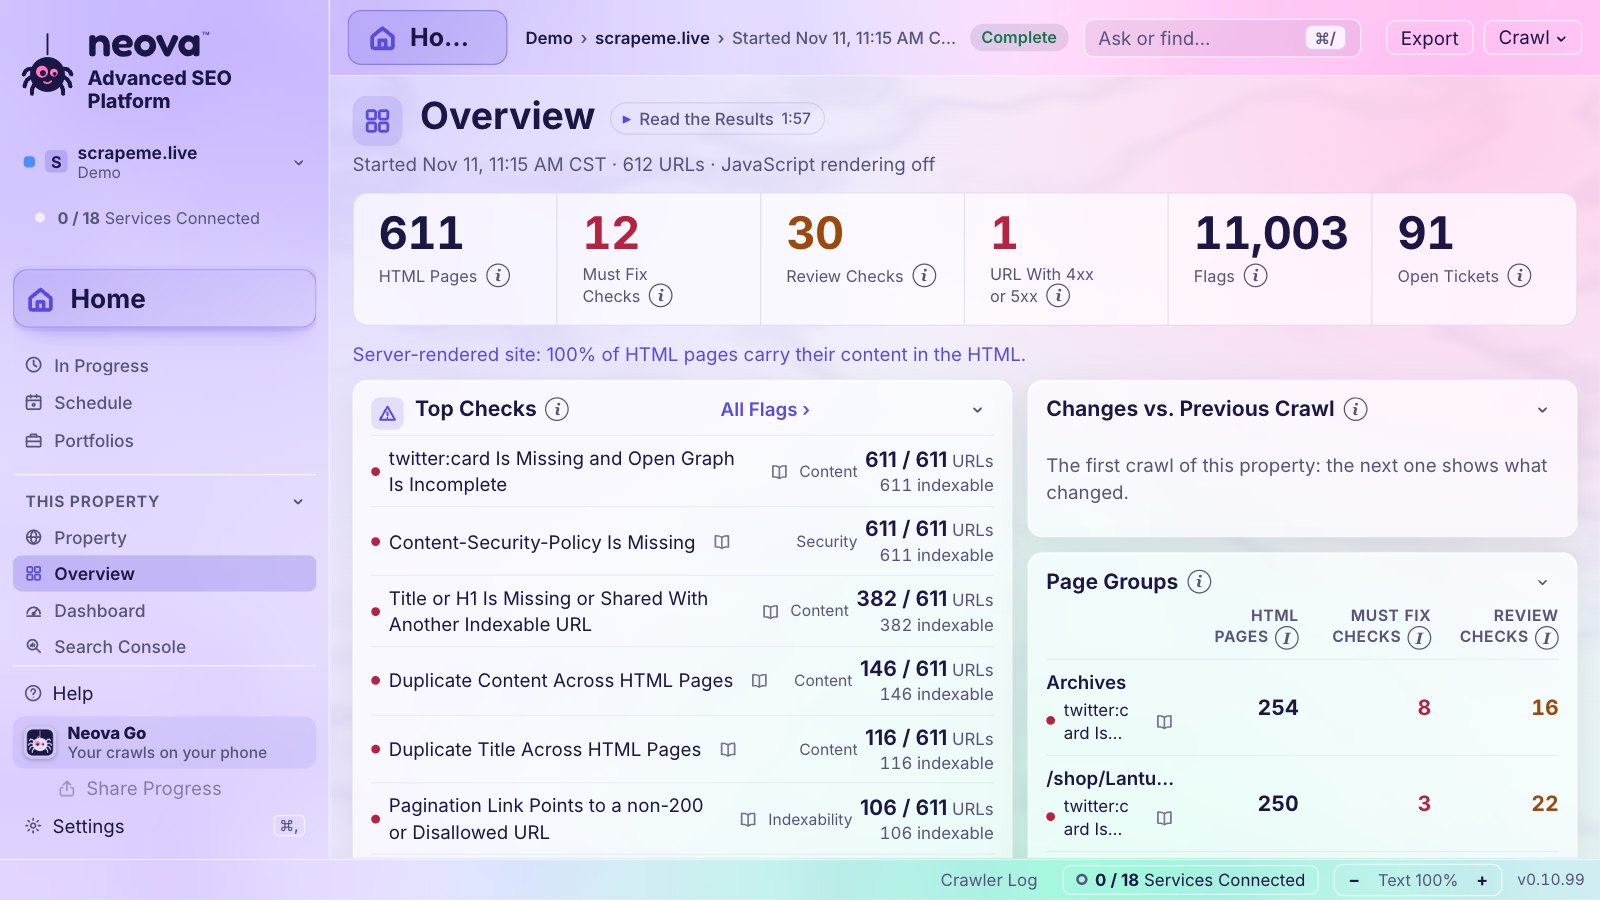
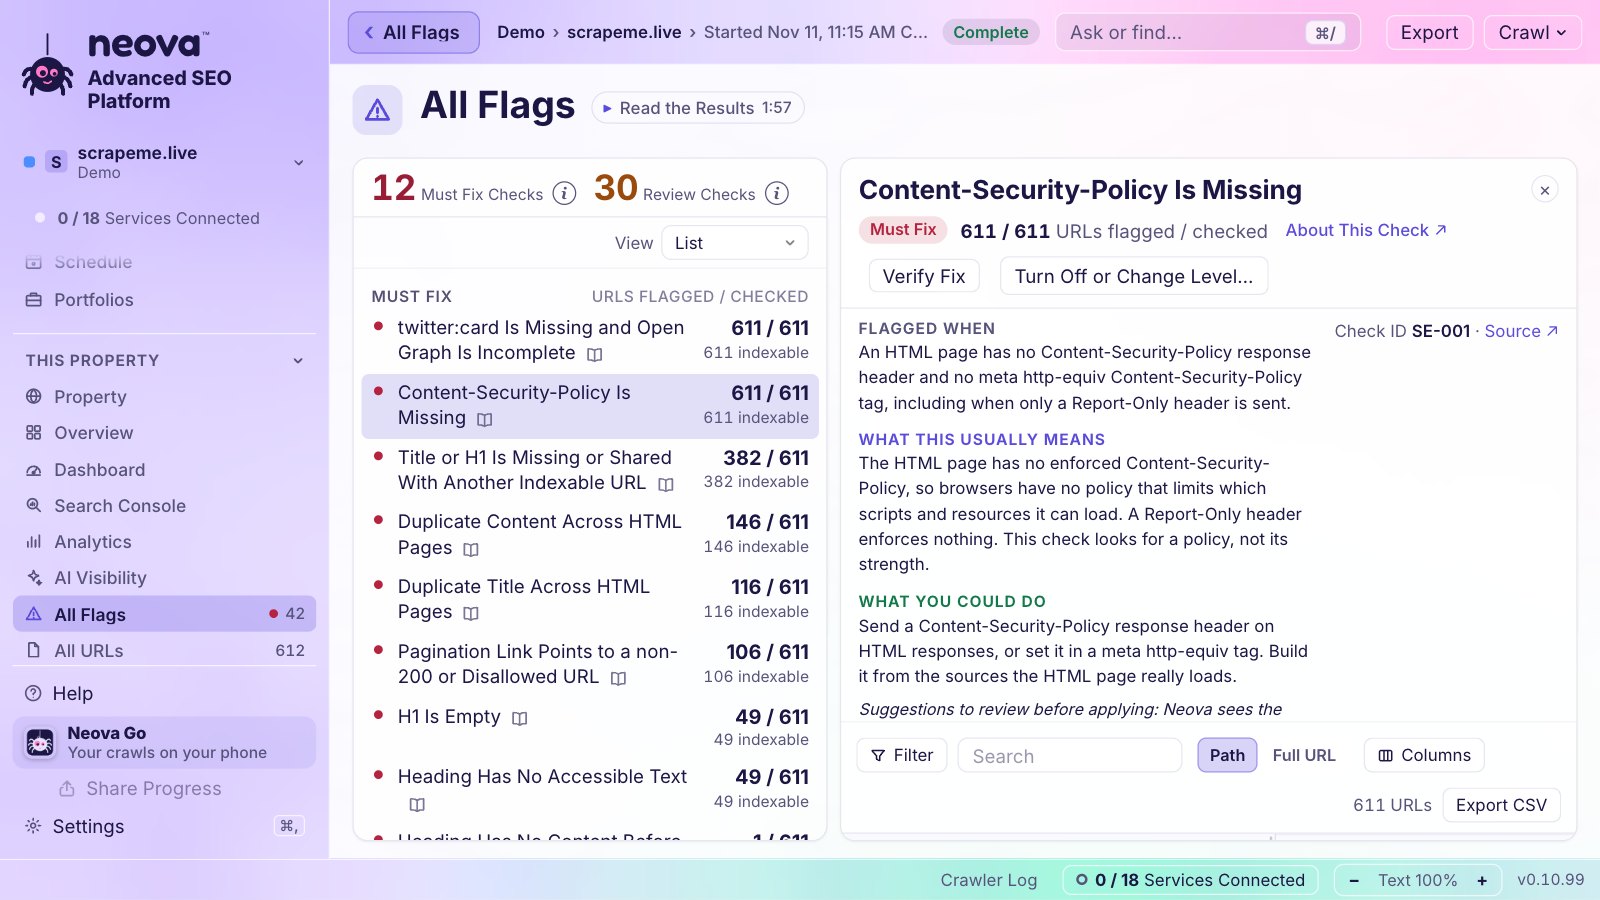
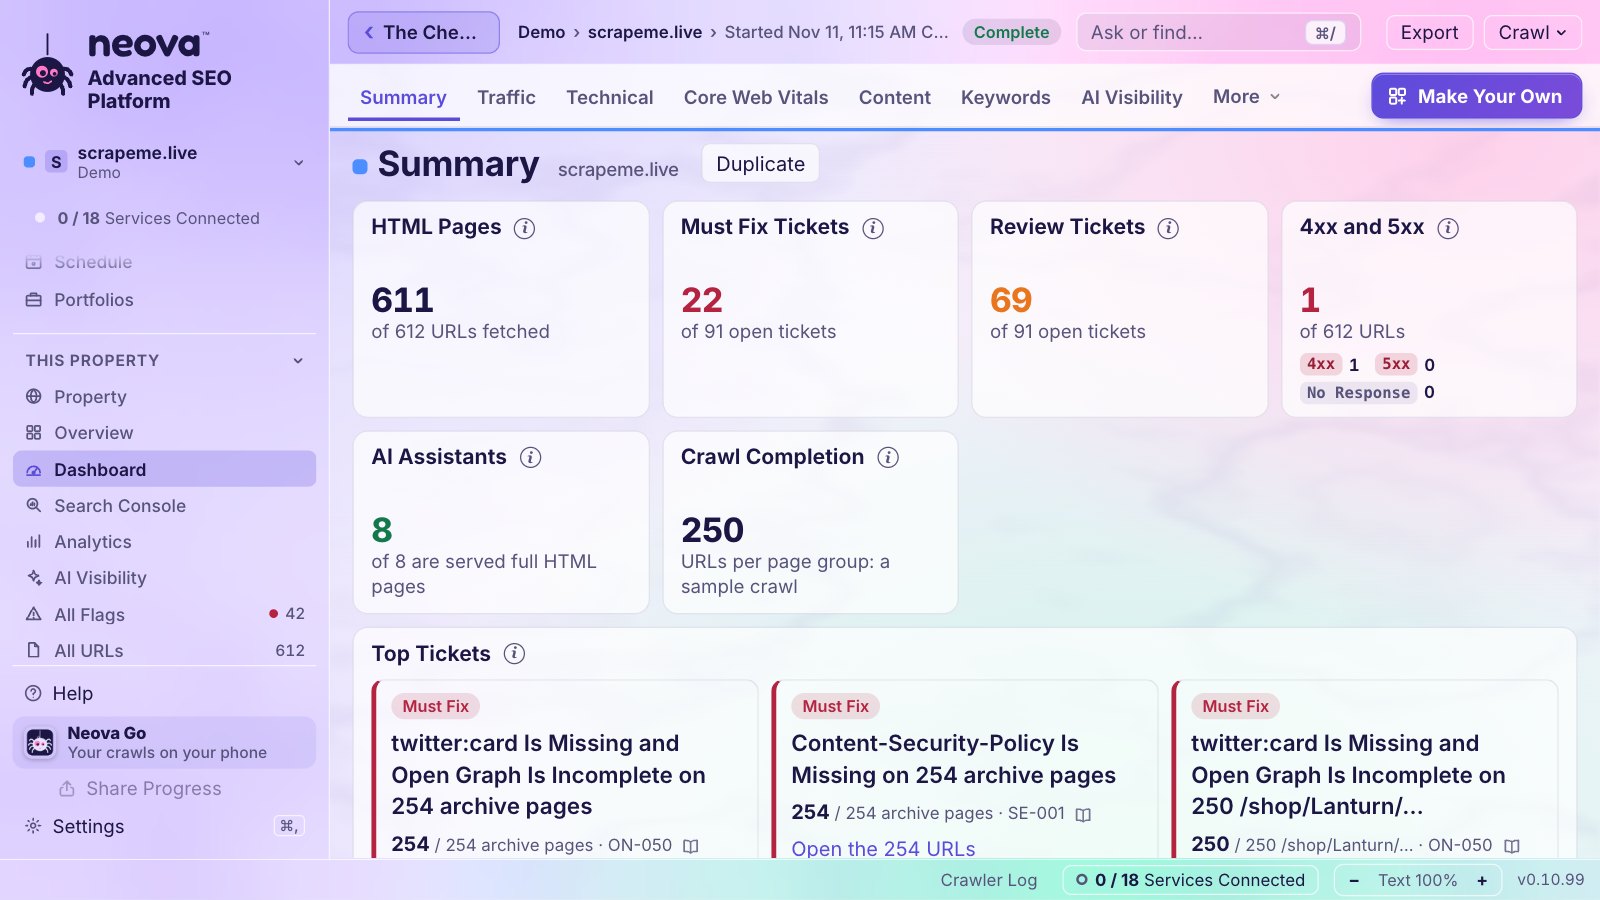
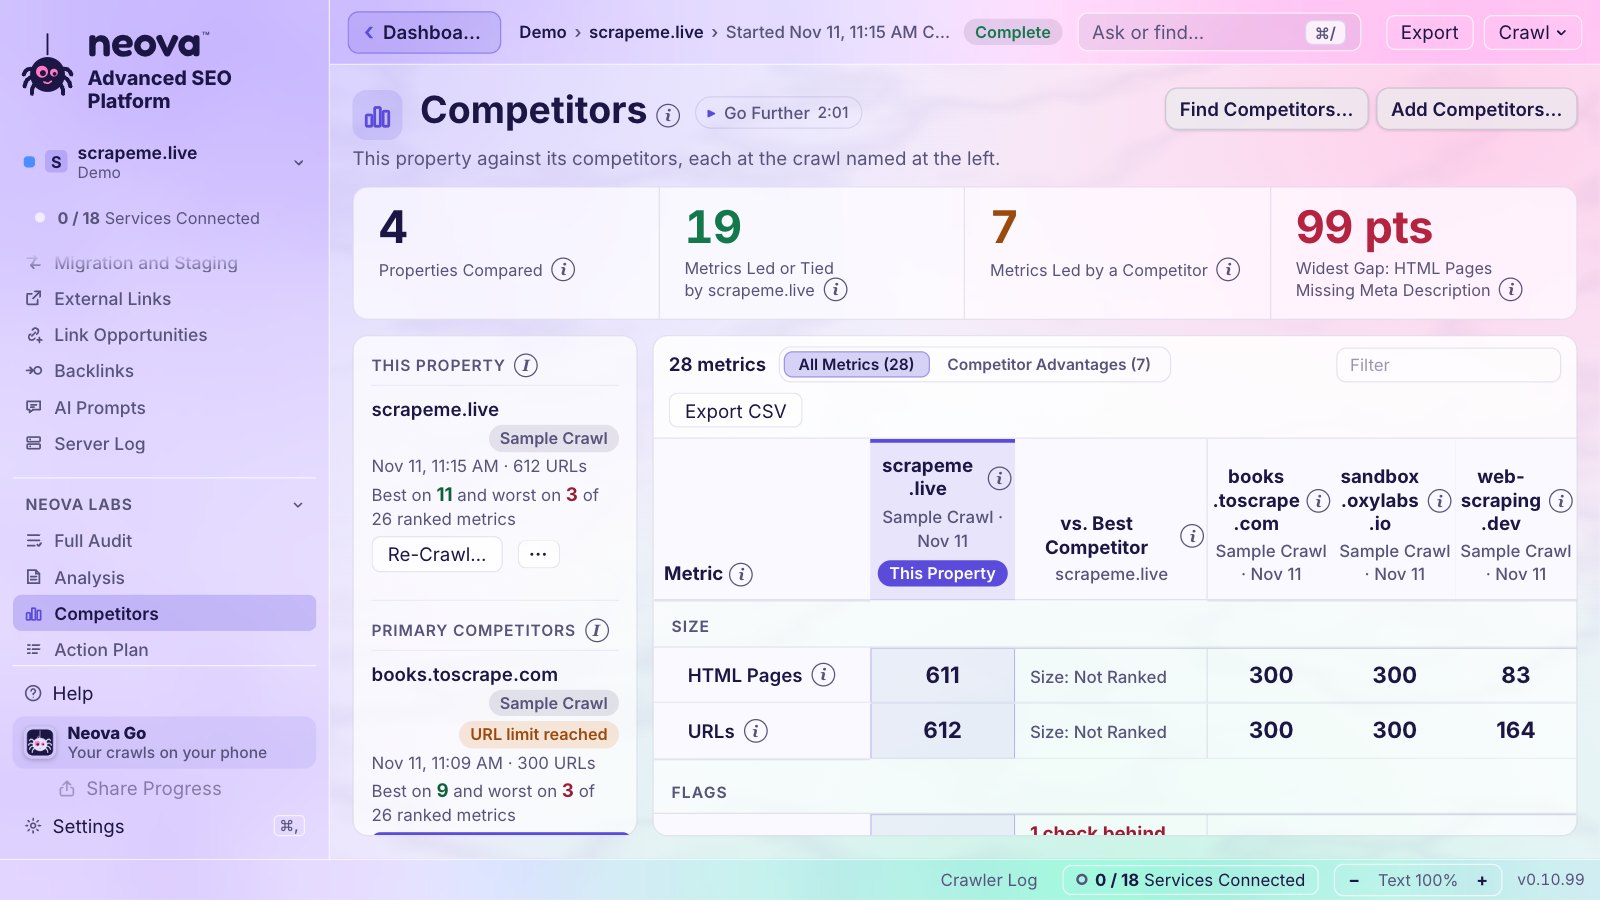
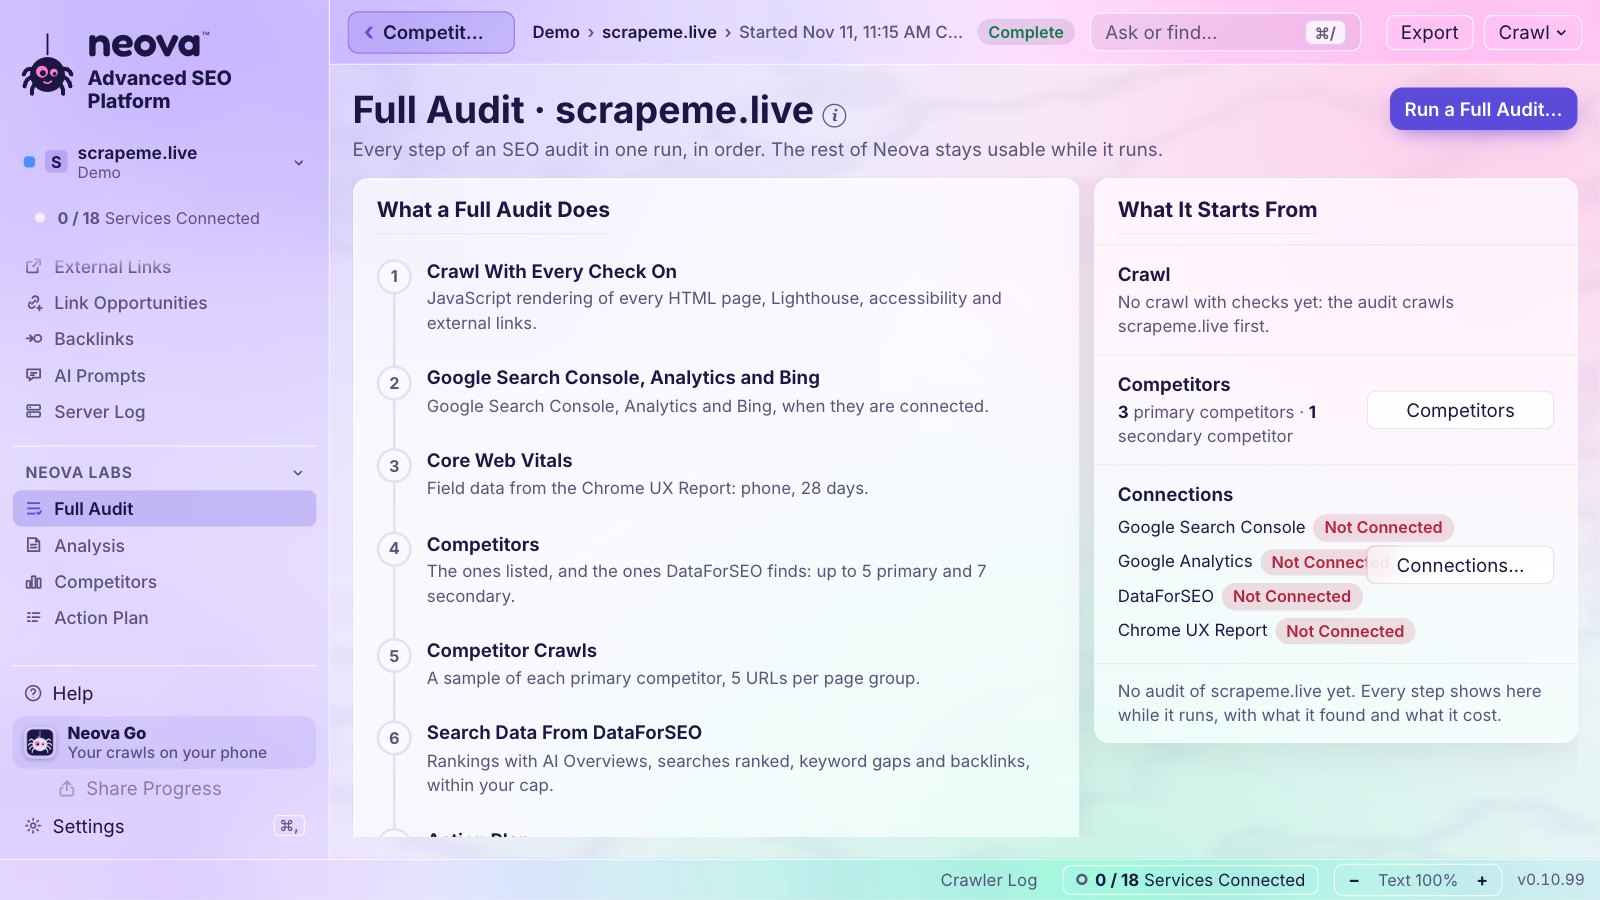
Neova mit dem Demo-Shop, mit dem jedes Konto von Neova Online startet. Klicken Sie auf einen Screen, um ihn in voller Größe zu sehen.
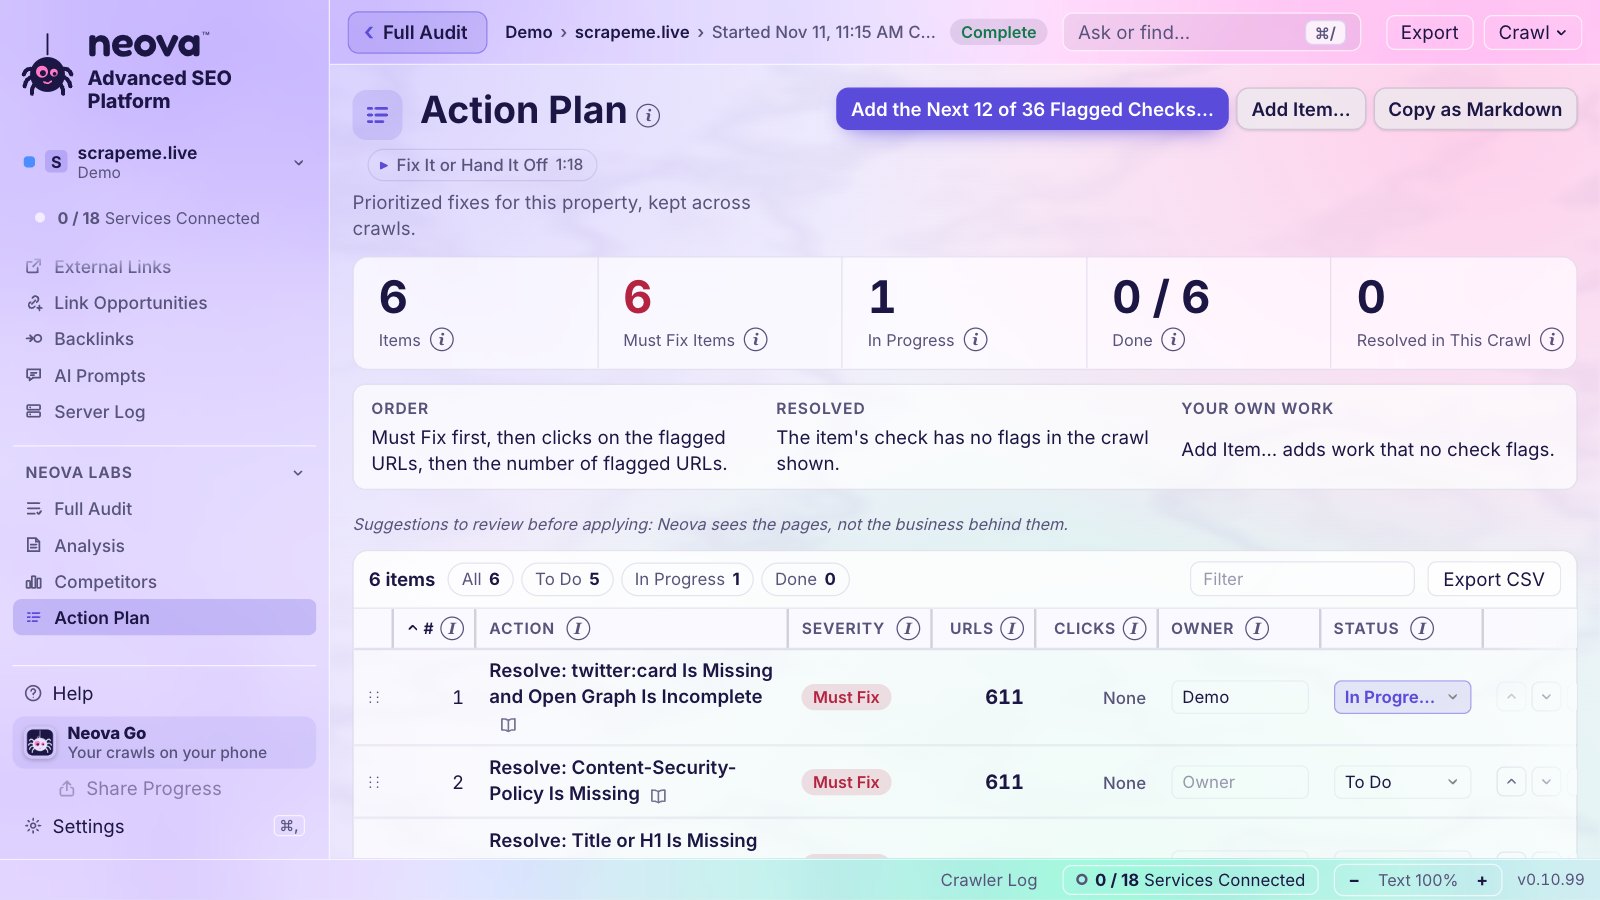
StartJede Property mit ihren Wettbewerbern, URLs und Meldungen pro URL.Der Live-CrawlSchritte, die Crawl-Karte, Antwortzeiten und jede URL, sobald sie kommt.ÜberblickDie Website auf einen Blick: wichtigste Checks, Änderungen, Seitengruppen.Alle MeldungenJede Meldung mit Begründung, Korrektur, Quelle und ihren Seiten.Das Dashboard13 Tabs, 39 Blöcke und eigene Dashboards.WettbewerberIhre Website neben der ihren, Kennzahl für Kennzahl, farbig nach Vorsprung.Vollständiges AuditCrawl, Suchdaten, Wettbewerber, Plan und Bericht in einem Durchlauf.AktionsplanJede Korrektur mit Verantwortlichem und Status, auf Wunsch an Jira gesendet.
Nur in Neova
In deren Dokumentation geprüft
Was Neova kann und keiner von Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar und JetOctopus, laut deren eigener Dokumentation, gelesen am 11. November 2026. Jede Karte sagt in einfachen Worten, was es ist und warum es zählt.
Einen Live-Crawl mit jedem teilen
„Fortschritt teilen“ gibt Ihnen einen Link zum laufenden Crawl. Jeder öffnet ihn auf Telefon oder Computer, ohne Konto, und verfolgt ihn live: Fortschritt, die Aufschlüsselung der URLs, die Crawl-Karte, Antwortzeiten, Weiterleitungen und Fehler, und eine Nachricht, wenn er endet.
Details
Ihr Kunde oder Ihre Chefin verfolgt den Crawl, ohne sich irgendwo anzumelden, und sieht diesen Crawl und sonst nichts. „Freigabe beenden“ beendet ihn sofort.
Screaming Frog: Eine Crawl-Übersicht in Looker Studio, gespeist aus einem Google Sheet, das sich „bei jedem geplanten Crawl“ aktualisiert, lässt sich per E-Mail an „beliebige Stakeholder“ senden. Quelle Sitebulb: Die Data-Studio-Dashboards von Cloud öffnen sich „ohne Sitebulb-Konto“ und aktualisieren sich „bei jedem Crawl“ Quelle Semrush: Eingeladene Betrachter „müssen trotzdem ein Konto anlegen“ Quelle Ahrefs: Kunden erhalten Ergebnisse „über Exporte, geplante Berichte oder Live-Dashboards in Data Studio“ Quelle Lumar: „Öffentliche Links erlauben jedem, die Crawls und Berichte anzusehen“, Ablauf „24 Stunden bis 6 Monate“ Quelle JetOctopus: kein öffentlicher Link gefunden Quelle
Jeden Crawl teilen, verschlüsselt mit Ihrem Schlüssel
Veröffentlichen Sie einen Freigabelink, und Neova verschlüsselt die Crawls der Website auf Ihrem Computer, bevor sie ihn verlassen. Der Schlüssel steckt nur im Link, sodass nicht einmal unser Server sie lesen kann. Beenden Sie die Freigabe, und der Link öffnet nichts mehr.
Details
Geben Sie einem Kunden das ganze Audit, jeden Tab und jede Tabelle, und behalten Sie die volle Kontrolle darüber, wer es wie lange sieht.
Screaming Frog: Eine Crawl-Übersicht in Looker Studio, gespeist aus einem Google Sheet, das sich „bei jedem geplanten Crawl“ aktualisiert, lässt sich per E-Mail an „beliebige Stakeholder“ senden. Quelle Sitebulb: Die Data-Studio-Dashboards von Cloud öffnen sich „ohne Sitebulb-Konto“ und aktualisieren sich „bei jedem Crawl“ Quelle Semrush: Eingeladene Betrachter „müssen trotzdem ein Konto anlegen“ Quelle Ahrefs: Kunden erhalten Ergebnisse „über Exporte, geplante Berichte oder Live-Dashboards in Data Studio“ Quelle Lumar: „Öffentliche Links erlauben jedem, die Crawls und Berichte anzusehen“, Ablauf „24 Stunden bis 6 Monate“ Quelle JetOctopus: kein öffentlicher Link gefunden Quelle
Ihr Computer, Ihr Browser, Ihr Telefon
Crawlen Sie auf Ihrem eigenen Mac, PC oder Linux-Rechner, öffnen Sie dieselben Portfolios, Einstellungen und Crawls in Neova Online in jedem Browser, und behalten Sie alles vom Telefon aus im Blick. Ein Konto, immer synchron.
Details
Desktop-Crawler bleiben auf einem Computer, Cloud-Crawler bleiben im Browser. Neova geht dorthin, wo Sie sind, und Ihre Crawls bleiben auf Ihrem Computer, wenn Sie nichts anderes wählen.
Screaming Frog: In der Dokumentation nicht gefunden. Quelle Sitebulb: Desktop plus Cloud im Browser Quelle Semrush: Browser-Plattform plus eine iOS-App nur für Rankings Quelle Ahrefs: nur Browser; laut Ahrefs lassen sich Crawl-Ergebnisse „jederzeit und von überall“ ansehen, „sogar vom Smartphone“ (2024). Quelle Lumar: In der Dokumentation nicht gefunden. Quelle JetOctopus: In der Dokumentation nicht gefunden. Quelle
Neova Go: Ihre Websites in der Hosentasche
Auf Ihrem Telefon: für jede Property der letzte Crawl, Core Web Vitals, Klicks, verfolgte Suchen und der nächste Lauf, verschlüsselt mit einem Schlüssel, der Ihren Computer nie verlässt. In Ihrer Menüleiste: der Fortschritt des Crawls neben der Uhr und „Verschieben“ oder „Überspringen“ für den nächsten geplanten Crawl.
Details
Sie wissen, dass ein Crawl beendet ist oder ein Template langsamer wurde, ohne Ihren Laptop aufzuklappen.
Screaming Frog: In der Dokumentation nicht gefunden. Quelle Sitebulb: In der Dokumentation nicht gefunden. Quelle Semrush: eine iOS-App nur für Rankings Quelle Ahrefs: keine Telefon-App gefunden. Die Cloud-Web-App funktioniert auf Telefonen Quelle Lumar: In der Dokumentation nicht gefunden. Quelle JetOctopus: In der Dokumentation nicht gefunden. Quelle
Tickets, die sich selbst schließen
Meldungen werden zu Tickets, eines pro Check und Seitengruppe. Findet der nächste Crawl das Problem behoben, schließt sich das Ticket; kommt es zurück, öffnet es sich wieder. Senden Sie es an Jira, und Jira zieht mit.
Details
Ihre Entwickler bekommen ein klares Ticket statt 4,000 URLs, und niemand jagt Tickets hinterher, die vor Wochen behoben wurden.
Screaming Frog: In der Dokumentation nicht gefunden. Quelle Sitebulb: kein natives Jira. Der Dev Handoff Skill, über einen KI-Assistenten ausgeführt, schreibt Tickets „direkt in Jira, Linear, Asana, Monday oder ClickUp“. Quelle Semrush: Site Audit kann „Aufgaben an ein Trello-Board senden“ Quelle Ahrefs: keine Jira- oder Ticket-Funktion gefunden. Quelle Lumar: Aufgaben werden von Hand aus Berichten erstellt und verschoben, indem man sie „per Drag-and-drop in verschiedene Statusbereiche zieht“ Quelle JetOctopus: In der Dokumentation nicht gefunden. Quelle
Jeder Check nennt seine Quelle
Jeder Check sagt, auf welcher Seite von Google, dem W3C, web.dev oder einer anderen offiziellen Quelle er beruht, mit Link, und was zu tun ist.
Details
Fragt ein Entwickler, warum, schicken Sie die Quelle, nicht Ihre Meinung.
Screaming Frog: Alle 8 geprüften Issue-Anleitungen enden mit „Further Reading“ und Links zu Google oder web.dev, aber als Lektüre, nicht als Grundlage der Regel Quelle Sitebulb: Viele Hints enden mit „Further Reading“ (Google, MDN, Lighthouse-Doku, auch Blogs), aber „Canonical points to a redirecting URL“ nennt überhaupt keine Quelle. Quelle Semrush: Manche Korrekturen verlinken Google („siehe diesen Google-Artikel“) Quelle Ahrefs: Manche Hilfeseiten verlinken Google („Diese Anleitung von Google sagt Ihnen alles“), während Issue-Seiten wie „Hreflang to broken page“ keine externe Quelle nennen. Quelle Lumar: In der Dokumentation nicht gefunden. Quelle JetOctopus: In der Dokumentation nicht gefunden. Quelle
Bing Webmaster Tools, einschließlich Bing AI Citations
Neova liest Bings eigene Daten zu Ihrer Website, auch wie oft die KI-Antworten von Bing Ihre Seiten zitieren.
Details
Bing speist die ChatGPT-Suche und Copilot. Seine Daten zeigen Ihre Sichtbarkeit in der KI-Suche.
Screaming Frog: Bingbot nur als User-Agent-Voreinstellung Quelle Sitebulb: Bing nur als User-Agent-Voreinstellung Quelle Semrush: nur Bing-Rank-Tracking Quelle Ahrefs: Site Audit übermittelt Änderungen per IndexNow („unterstützt von Bing, Yep und anderen Suchmaschinen“) Quelle Lumar: keine Bing Webmaster Tools Quelle JetOctopus: Bingbot in Logfiles und im robots.txt-Tester („Vollständige Daten zu Googlebot, Bingbot, GPTBot, ClaudeBot und 40+ weiteren Crawlern“) Quelle
Ihre Crawls aus Screaming Frog und Sitebulb öffnen
Die Website schon mit Screaming Frog oder Sitebulb gecrawlt? Öffnen Sie diesen Crawl in Neova, und seine Seiten werden mit den Checks von Neova an der Live-Website bewertet.
Details
Behalten Sie die Tools, die Sie kennen, und nehmen Sie Neova dazu, wo es hilft, ohne zweimal zu crawlen.
Screaming Frog: Der Listenmodus liest URLs aus jeder .txt-, .xls-, .xlsx-, .csv- oder .xml-Datei („Sie können direkt einen AdWords-Download hochladen“) Quelle Sitebulb: importiert URL-Listen (.csv oder .txt) Quelle Semrush: Backlink Audit importiert Backlink-Dateien (CSV, „bis zu 50 MB“) Quelle Ahrefs: In der Dokumentation nicht gefunden. Quelle Lumar: importiert CSV-Exporte als Crawl-Quellen (Majestic, Ahrefs, Open Site Explorer, Screaming Frog Log File Analyser, Splunk, Logz.io Quelle JetOctopus: nur allgemeiner Import: „Für den Import können Sie eine Datei im CSV- oder TXT-Format verwenden“, verknüpft über die URL Quelle
Eingebaut, nicht separat verkauft
Die anderen haben das auch, oft als Add-on oder als eigenes Produkt mit eigenem Preis. In Neova gehört es zur App. Wo externe Daten nötig sind, etwa von DataForSEO oder Google, nutzen Sie Ihr eigenes Konto zu dessen Preis, ohne Aufschlag. Öffnen Sie „Was die anderen tun“ bei jedem Punkt, mit der Seite aus deren Dokumentation.
Sehen, ob ChatGPT und Perplexity Sie erwähnen
Neova stellt ChatGPT und Perplexity Ihre eigenen Fragen, so wie ein Kunde es täte, und sagt Ihnen, ob Ihre Marke in der Antwort vorkommt.
Was die anderen tun
Immer mehr Menschen fragen KI-Assistenten, bevor sie suchen. So wissen Sie, ob Sie dort existieren.
Screaming Frog: In der Dokumentation nicht gefunden. Quelle Sitebulb: In der Dokumentation nicht gefunden. Quelle Semrush: Ja, im AI Visibility Toolkit ($99/Monat) Quelle Ahrefs: Brand Radar mit eigenen Prompts für ChatGPT, Perplexity, Gemini, Copilot, AI Overviews Quelle Lumar: In AI Visibility (pro Konto freigeschaltet) Quelle JetOctopus: „JetOctopus verfolgt keine Zitierungen, Markenerwähnungen oder Stimmungen in KI-Antworten“ Quelle
Was KI-Assistenten tatsächlich ausgeliefert bekommen
Neova ruft Ihre Seiten als 10 KI-Crawler ab (ChatGPT, Claude, Perplexity und andere), prüft Ihre llms.txt und Agent-Dateien und zeigt, was jeder bekommt.
Was die anderen tun
Eine Seite, die Ihre Besucher sehen, kann für einen KI-Assistenten blockiert oder leer sein. Jetzt sehen Sie es.
Screaming Frog: In der Dokumentation nicht gefunden. Quelle Sitebulb: In der Dokumentation nicht gefunden. Quelle Semrush: Site-Audit-Hinweise „Llms.txt not found (AI Search)“ und „Llms.txt file has formatting issues (AI Search)“ Quelle Ahrefs: nur ein kostenloser Generator („erstellt die perfekte llms.txt-Datei für Sie“) Quelle Lumar: Im kostenlosen Agentic Readiness Scanner von Lumar, getrennt von der Crawl-Plattform Quelle JetOctopus: In der Dokumentation nicht gefunden. Quelle
Ihre Wettbewerber, gefunden und verglichen
Neova findet die Websites, die bei denselben Suchen mit Ihnen konkurrieren, crawlt die nächsten davon und stellt jede Kennzahl nebeneinander, farbig nach Vorsprung.
Was die anderen tun
Sie sehen, wo ein Wettbewerber Sie schlägt und um wie viel, ohne Tabellenkalkulation.
Screaming Frog: In der Dokumentation nicht gefunden. Quelle Sitebulb: In der Dokumentation nicht gefunden. Quelle Semrush: Position Tracking: „Der Competitors Discovery Report zeigt organische Wettbewerber, die für Ihre Keywords ranken“ Quelle Ahrefs: Neue Projekte „erhalten Vorschläge für Wettbewerber auf Basis von Websites, die für ähnliche Keywords ranken“ Quelle Lumar: In AI Visibility: „Marken werden automatisch aus den Antworten der KI-Anbieter erkannt“, und Lumar ordnet jede als Own, Competitor, Other oder Context ein. Quelle JetOctopus: In der Dokumentation nicht gefunden. Quelle
Server-Logs, sogar hinter Cloudflare
Neova liest Ihre Apache- oder Nginx-Logs oder direkt die von Cloudflare und zählt nur verifizierte Bots, sodass Sie sehen, was Googlebot und KI-Crawler wirklich abrufen.
Was die anderen tun
Logs zeigen, was Suchmaschinen auf Ihrer Website tun, nicht, was ein Crawler vermutet.
Screaming Frog: ein eigenes Produkt, der Screaming Frog Log File Analyser (Windows, macOS, Linux), um „Suchmaschinen- und KI-Bots zu verifizieren“. Quelle Sitebulb: FAQ: „Sitebulb macht noch keine Logfile-Analyse, aber sie ist in Entwicklung und bald verfügbar!“ Quelle Semrush: Ja, als eigenes Enterprise-Produkt Quelle Ahrefs: Bot Analytics, ein eigenes Tool, in der Beta kostenlos in bezahlten Tarifen, „verarbeitet HTTP-Anfragedaten“ von Cloudflare, Vercel, CloudFront, AWS-Load-Balancern oder Fastly Quelle Lumar: enthalten, aber aus Zusammenfassungen pro URL Quelle JetOctopus: In jedem Tarif enthalten, kein eigenes Produkt Quelle
Core Web Vitals echter Nutzer, mit Trend
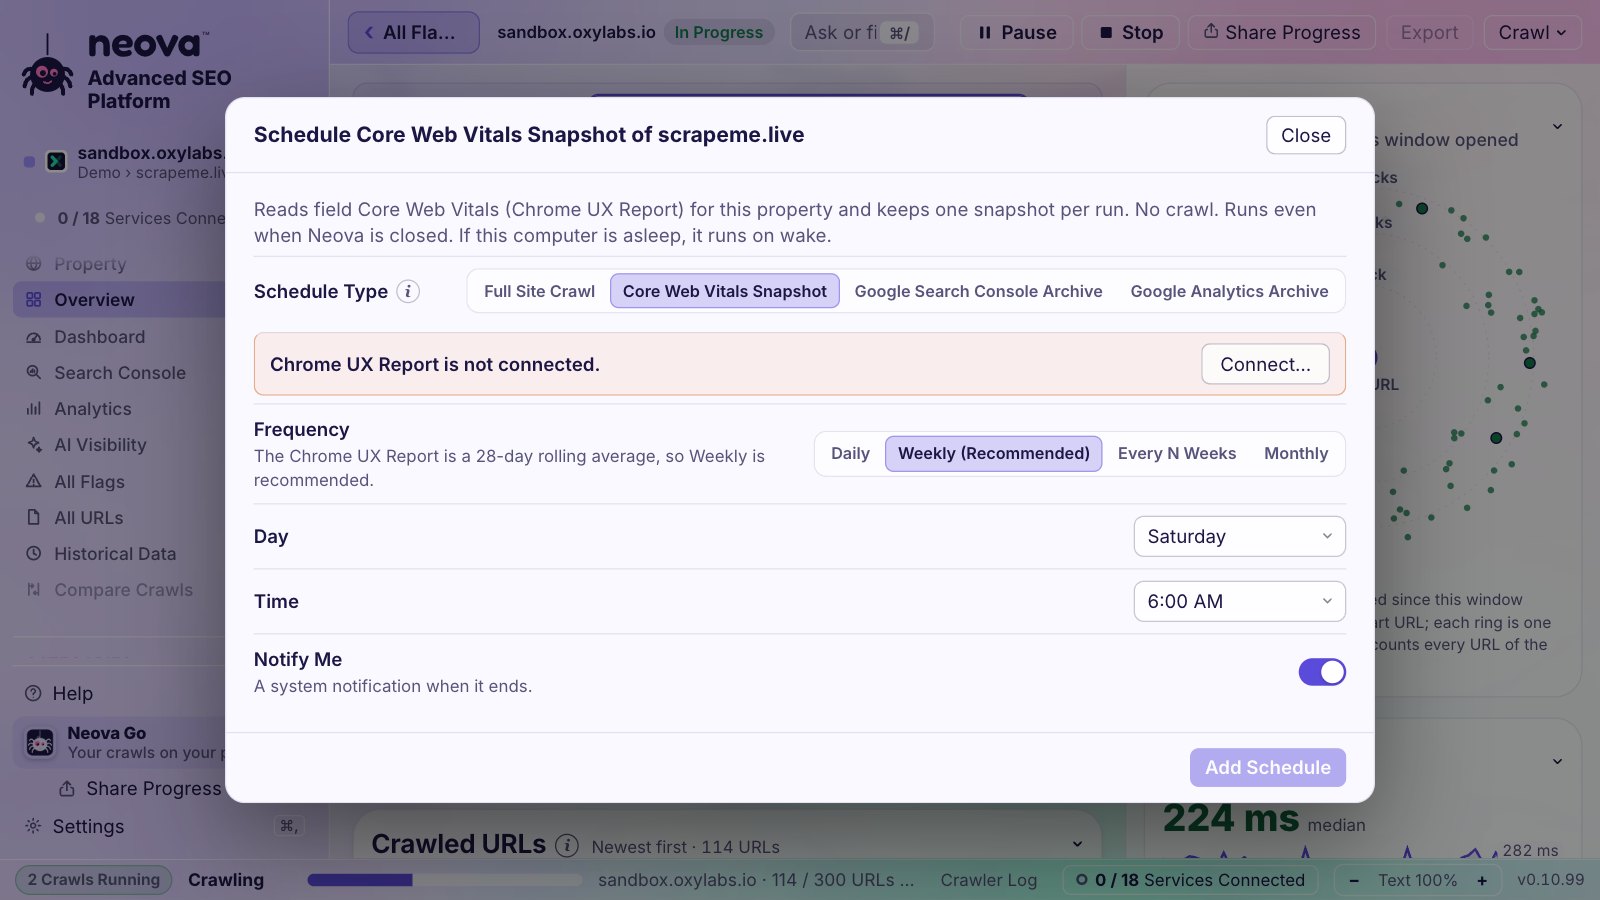
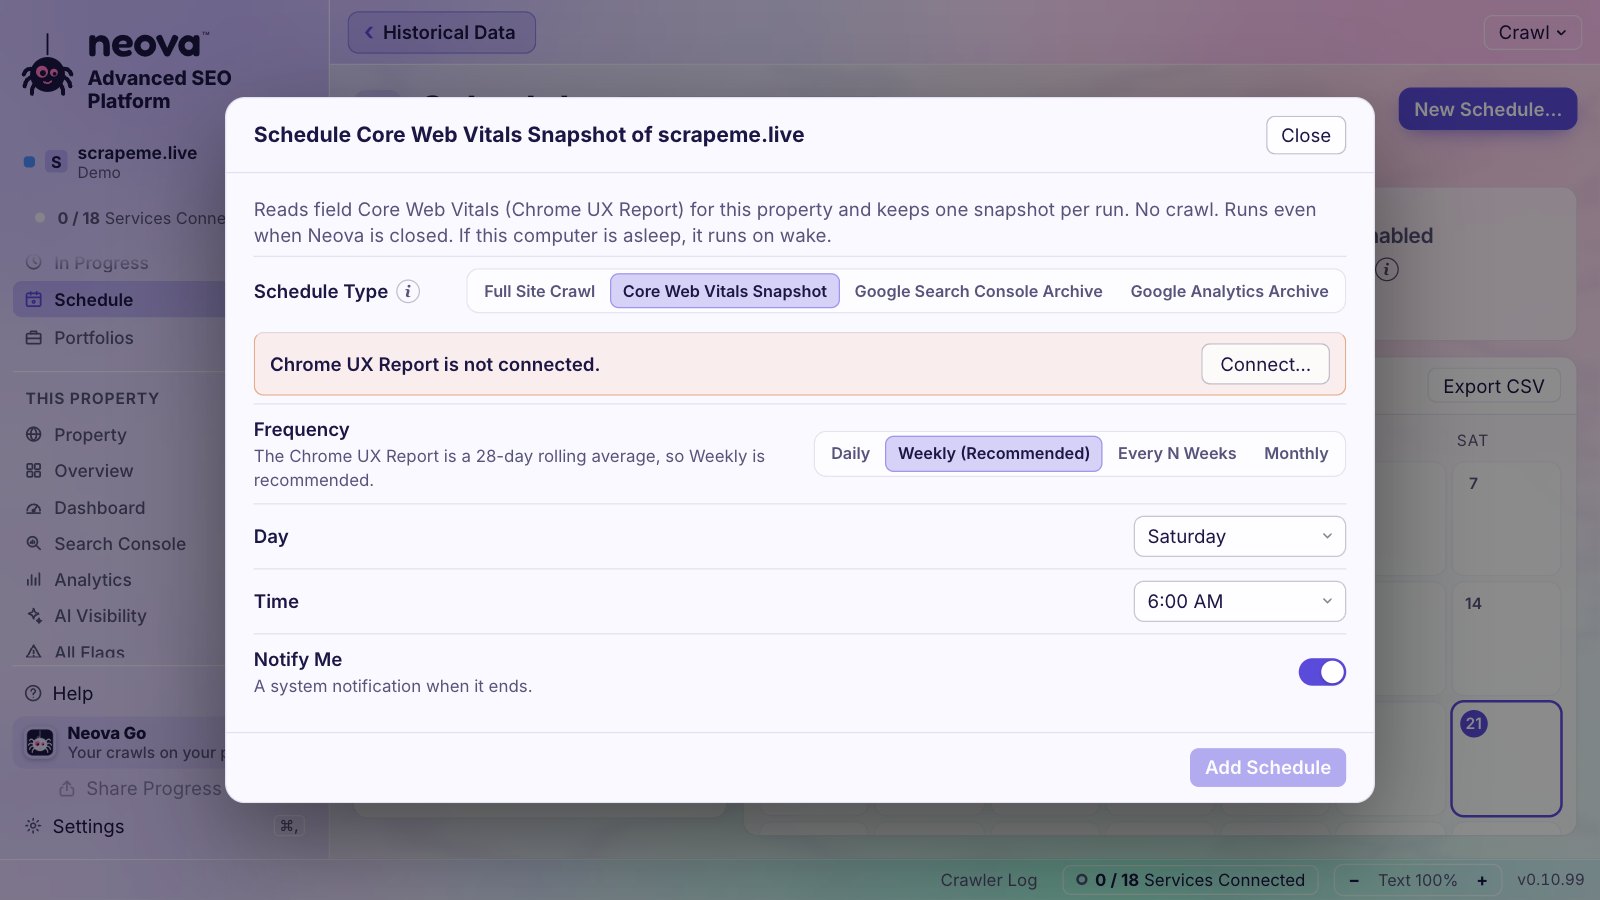
Mit Ihrem kostenlosen Schlüssel für den Chrome UX Report liest Neova, was echte Chrome-Nutzer erleben: ein Trend über 40 Wochen ab dem ersten Tag, eine Ansicht pro Seitengruppe, Snapshots nach Zeitplan und Warnungen.
Was die anderen tun
Labortests sagen, wie schnell eine Seite sein könnte. Daten echter Nutzer sagen, wie schnell sie für Ihre Besucher ist, und genau das nutzt Google.
Screaming Frog: kein CWV-Trenddiagramm in der App gefunden. Quelle Sitebulb: Das Google Sheet „Historical Audit Data“ hat eine Zeile pro Audit für „Zeitreihen oder Diagramme“ in Looker Studio und enthält Bandwerte der Core Web Vitals (Changelog, 13 Quelle Semrush: Labordaten (Lighthouse) Quelle Ahrefs: Performance-Bericht im Site Audit Quelle Lumar: In Site Speed: „ein Trenddiagramm für jeden der KPIs“ (FCP, LCP, TBT, CLS), unterteilt in Slow, Moderate, Fast, ein Punkt pro Crawl (Labordaten) Quelle JetOctopus: geplante CWV-Checks („+Create a CWV schedule“) Quelle
Jira ohne Fleißarbeit
Jedes Ticket geht mit seinen Seiten, seinem Check und der Korrektur an Jira, und Neova hält beide nach jedem Crawl synchron.
Was die anderen tun
Ihr Team arbeitet dort, wo es ohnehin arbeitet.
Screaming Frog: In der Dokumentation nicht gefunden. Quelle Sitebulb: keine native Jira-Integration Quelle Semrush: nativ nur „Send to Trello“ Quelle Ahrefs: keine Jira-Integration gefunden. Quelle Lumar: Integration mit Jira Cloud Quelle JetOctopus: In der Dokumentation nicht gefunden. Quelle
Das Dashboard
Öffnen Sie eine Property, dann Dashboard: alles, was Neova über die Website weiß, auf einem Screen, und so viele eigene Ansichten, wie Sie brauchen.
Ihre Website auf einem ScreenAcht Gruppen, 13 Tabs, 39 Blöcke. Jede Zahl zeigt ihre Änderung seit dem vorigen Crawl.
Geschwindigkeit, 40 Wochen zurückCore Web Vitals echter Chrome-Nutzer ab dem ersten Tag, mit Googles Grenzen für gut und schlecht, auch pro Seitengruppe.
Klicks und SuchenKlicks und Impressionen pro Tag im Vergleich zu den 28 Tagen davor und 25 verfolgte Suchen mit ihren Positionen.
Googles Updates auf Ihren KlicksZwei Jahre Ranking-Updates auf Ihren Traffic gelegt, mit Vorher und Nachher für jedes.
KI-SucheWelche KI-Assistenten vorbeikommen, was jeder ausgeliefert bekommt, AI Overviews und verifizierte Bots.
Content auf einen BlickLängen von Title, Description und H1, Seitengruppen und Ihre am meisten verlinkten Seiten.
Das ProgrammDer Aktionsplan nach Status und Verantwortlichem; eine als erledigt markierte Korrektur, die noch gemeldet wird, wird rot.
Eigene erstellenBis zu 10 Dashboards: neu beginnen oder einen Tab kopieren, dann Blöcke hinzufügen, verschieben, in der Größe ändern und entfernen.
Behält alles für Sie im Blick
Neova hört nicht beim Crawl auf. Es beobachtet Ihre Websites zwischen den Crawls und sagt Ihnen, wenn sich etwas bewegt, auf Ihrem Computer, Ihrem Telefon oder in den Kanälen Ihres Teams.
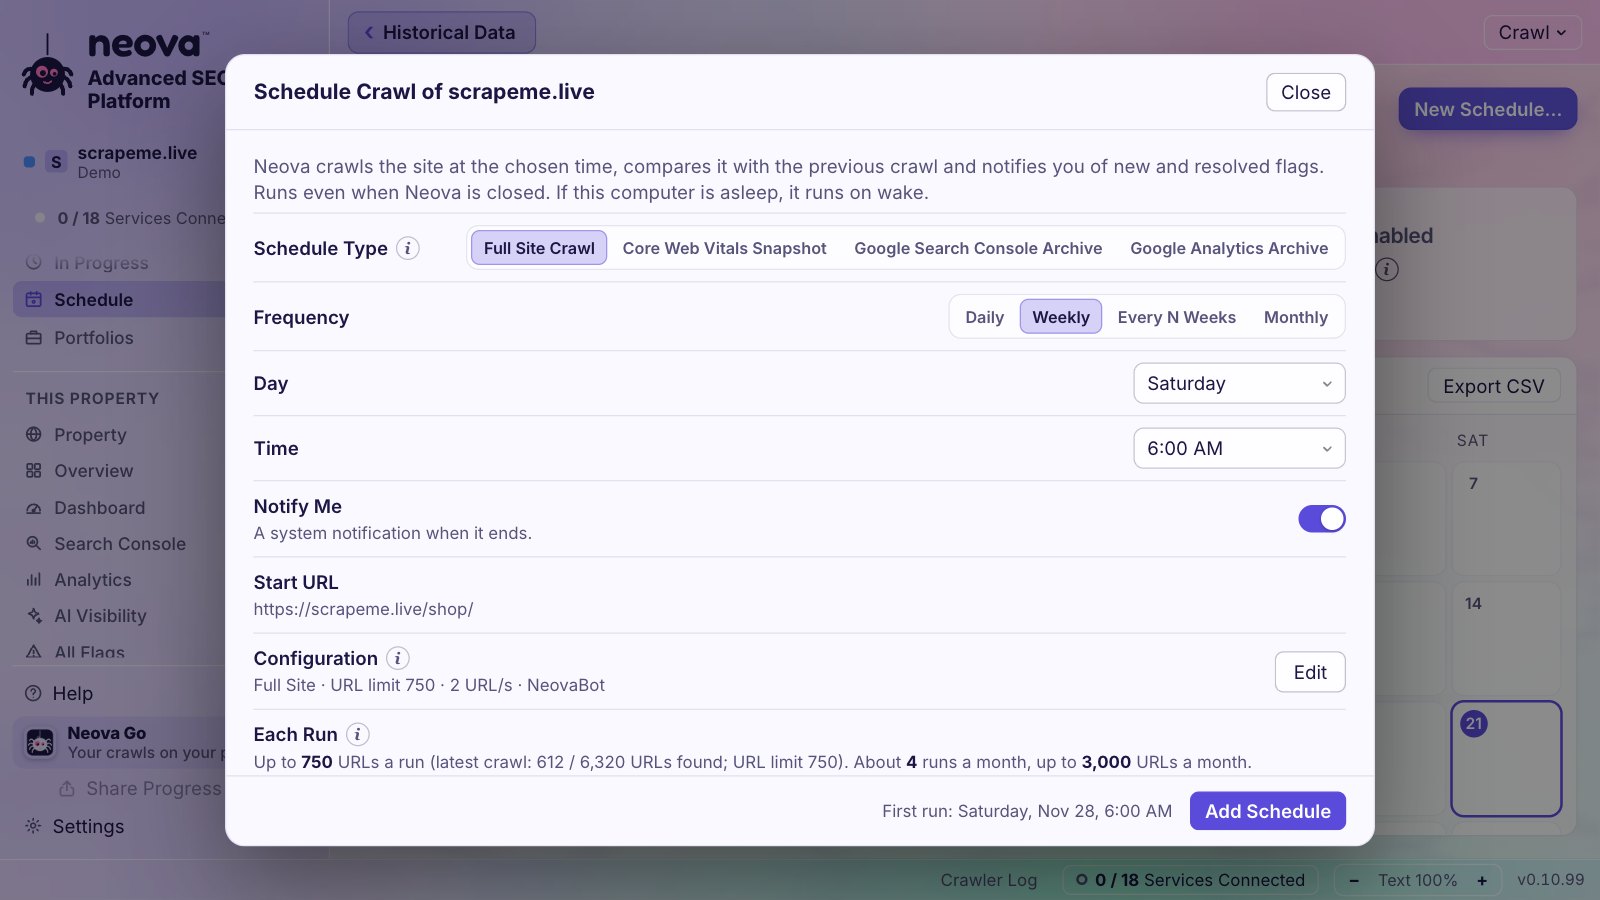
Ein ZeitplanWie oft, Tag und Uhrzeit und was jeder Lauf kostet.Neova GoDie Menüleiste, Warnungen und Ihr Telefon.Core-Web-Vitals-SnapshotsGeschwindigkeit echter Nutzer nach eigenem Zeitplan, ohne Crawl.
Geplante CrawlsTäglich, wöchentlich, alle paar Wochen oder monatlich, pro Property, auch bei geschlossenem Fenster. Eine Vorwarnung 15 Minuten vorher, „Verschieben“ oder „Überspringen“ in der Menüleiste, und die Kosten eines Zeitplans sehen Sie, bevor Sie ihn anlegen.
Warnungen, die zählenCore Web Vitals wechseln die Bewertung, Klicks fallen in einer Woche um 20 % oder mehr, eine verfolgte Suche steigt in die Top 10 ein, fällt heraus oder verliert 3 Plätze, ein neuer Crawl bringt neue Meldungen. Geprüft nach jedem geplanten Lauf oder wenn Sie auf „Jetzt prüfen“ klicken.
Beobachtungs-CrawlPrüft nur Ihre wichtigsten Seiten erneut, ohne neue URLs zu suchen, und warnt Sie, wenn sich Status, Weiterleitung, Title, Canonical, noindex, H1 oder Seitengröße ändern.
Core-Web-Vitals-SnapshotsDie Geschwindigkeit echter Chrome-Nutzer nach Zeitplan, ohne Crawl, als Trend, den Sie Woche für Woche verfolgen können.
Verfolgte Suchen, jeden TagBis zu 25 Suchen pro Property aus der Search Console: Position über 7 und 90 Tage, Klicks und Impressionen, und ob Google eine AI Overview zeigt, die Sie zitiert.
Google-Updates auf Ihren KlicksZwei Jahre Ranking-Updates und Störungen von Google auf Ihre Klicks pro Tag gelegt, mit Ihren Klicks vor und nach jedem.
Jeden Monat ein vollständiges AuditDas ganze Audit, mit Wettbewerbern, jeden Monat wiederholt; Neova schließt die Analyse und das PDF ab, sobald es das nächste Mal geöffnet wird.
Warnungen dort, wo Sie sindNeova Go in der Menüleiste und auf Ihrem Telefon, eine Mitteilung, wenn ein Crawl endet, sowie Slack und Microsoft Teams, wobei jedes Portfolio und jede Property an eigene Kanäle sendet.
Außerdem in Neova
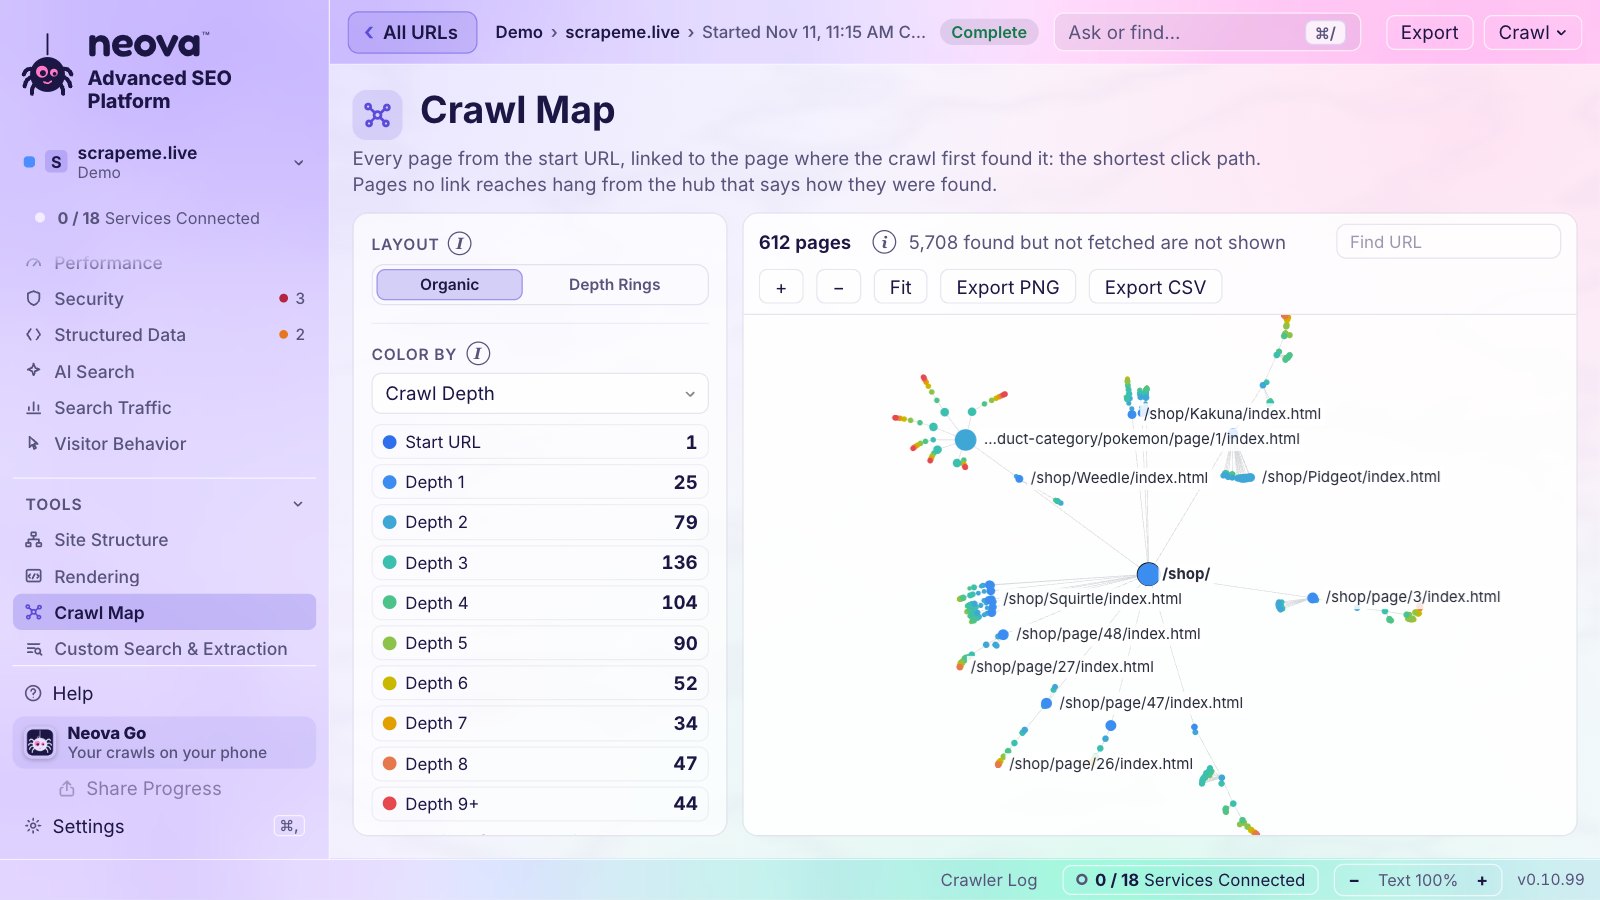
Crawl-KarteWie jede Seite zuerst gefunden wurde, farbig nach Status.Alle URLsJede URL mit Status, Indexierbarkeit und Größe.Historische DatenIhre Crawls und Search-Console-Daten, aufbewahrt, nachdem Google sie löscht.
Crawler-LogJede URL, die der Crawl abruft, live, mit farbigem Statuscode und Antwortzeit; die Schritte fett, Fehlschläge rot. Mit einem Klick für den Support kopieren.
Blockierter Crawl, erklärtVerweigert eine Website den Crawl, sagt Neova, warum (Rate-Limit, Firewall, Länder-Sperre) und was zu tun ist, mit einem geheimen Allowlist-Header für Ihre IT.
Einen Crawl diagnostizierenLiest das Log eines Crawls und benennt, was schiefging, 429er, 403er, Sperren per robots.txt, reine JavaScript-Seiten, mit der Einstellung, die zu ändern ist.
URL-AufschlüsselungJede gefundene URL landet in genau einer Kategorie, sodass Sie schon während des Crawls immer wissen, woher die zusätzlichen Tausende kommen.
Ein Live-Crawl, den Sie verfolgen könnenSchritte mit Pfeilen, „Neueste URLs“, eine Live-Crawl-Karte und das Antwortzeit-Diagramm, und „Fortschritt teilen“, damit jeder mitverfolgen kann.
Search Console und Analytics, dauerhaft aufbewahrtGoogle löscht Search-Console-Daten nach 16 Monaten und Analytics-Ereignisdaten nach 2 oder 14. Neova archiviert jeden Monat von beiden auf Ihrem Computer, nach Zeitplan: Seiten, Suchanfragen, Tage und Discover aus der Search Console; Tage, organische Landingpages, Kanäle, Quellen und Länder aus Analytics. So lange Sie möchten.
Wissen, bevor Sie startenLiest zuerst ein paar Seiten und sagt, wie viele URLs die Sitemaps auflisten und wie viele Bilder zu erwarten sind, damit Sie die Größe des Crawls wählen.
Ein Crawl, der nie verloren gehtSeiten zuerst, ein Speicherplatzwächter, Beenden sichert den Crawl, Updates warten auf ihn, und Fortsetzen macht mit seinen eigenen Einstellungen weiter.
Kosten zuerst angezeigtDataForSEO-Kosten werden geschätzt, bevor etwas ausgegeben wird, mit einer Obergrenze pro Crawl. Die Rechnungen für Ihre Daten gehen an Sie, zum Preis des Anbieters.
Mit echten Daten ausprobierenJedes Konto von Neova Online startet mit einer Demo: ein Shop und drei Wettbewerber, bereits gecrawlt, alle Einstellungen ausgefüllt.
Ihre Schlüssel bleiben IhreJeder Schlüssel, jedes Token und jede Anmeldung kommt in den Schlüsselbund Ihres Systems, nie in eine Datei oder auf den Bildschirm. Neova liefert keinen eigenen API-Schlüssel mit: Was Sie bezahlen, wird Ihnen direkt berechnet.
In 15 SprachenDas Fenster und der Check-Katalog auf Englisch, Französisch, Deutsch, Spanisch, Portugiesisch, Italienisch, Japanisch, Niederländisch, Polnisch, Türkisch, Koreanisch, Chinesisch, Russisch, Indonesisch und Vietnamesisch.
Funktioniert mit
31 Dienste
Neova verbindet sich mit 31 Diensten, die Sie schon nutzen, von der Google Search Console über Slack und Jira bis zu Ihrem eigenen Cloud-Speicher. Jeder ist optional.
Google
Google Search Console
Google Analytics
Chrome UX Report
Google Cloud
Gemini
Microsoft und Bing
Bing Webmaster Tools
OneDrive
Microsoft Teams
SEO-Daten
DataForSEO
Semrush
Ahrefs
Majestic
Moz
SEO Gets
KI
Anthropic
OpenAI
Ollama
Tickets
Jira
Linear
Asana
ClickUp
monday.com
Warnungen und Logs
Slack
Microsoft Teams
Cloudflare
Dateien und Speicher
Google Drive
Dropbox
iCloud Drive
Proton Drive
kDrive
OneDrive
Öffnet deren Crawls
Screaming Frog
Sitebulb
Die Logos gehören ihren Inhabern und zeigen nur, dass sich Neova mit diesen Diensten verbindet. Neova ist mit keinem von ihnen verbunden.
Im direkten Vergleich
78 Funktionen
Jede Funktion, eine Markierung pro Tool. „Details anzeigen“ ergänzt, was jedes Tool dabei tut, mit der Seite aus dessen eigener Dokumentation, von der es stammt.
Wo und wie gecrawlt wirdScreaming Frog 15Sitebulb 13Semrush 10Ahrefs 10Lumar 13JetOctopus 13Neova 17von 17
Funktion
Screaming Frog
Sitebulb
Semrush
Ahrefs
Lumar
JetOctopus
Neova
Desktop-App
✓„Für den SEO Spider ist ein 64-Bit-Betriebssystem erforderlich.“ Quelle
✓Nur Windows und macOS („64-Bit-Version von Windows 10 oder 11“) Quelle
◐Auf Ihrem Serverkeine Browser- oder gehostete Version. Quelle
✓Sitebulb CloudSitebulb Cloud: „Sitebulb Cloud bietet Ihnen alle Möglichkeiten von Desktop, im Webbrowser.“ Jeder Kunde bekommt einen Server wie yoursite.sitebulb.cloud. Quelle
✓Web-AppVollständig browserbasiert: Semrush beschreibt sich als „die führende SaaS-Plattform für das Management der Online-Sichtbarkeit“. Quelle
✓Web-AppBrowserbasiertes SaaS: „Wir stellen den Zugang zur Anwendung über einen unterstützten Webbrowser als Software-as-a-Service (SaaS) bereit …“ Quelle
✓Neova OnlineNeova Online in jedem Browser, mit demselben Konto wie die Desktop-App, immer synchron
JavaScript-Rendering
✓„Webseiten mit dem integrierten Chromium WRS rendern, um dynamische, JavaScript-lastige Websites und Frameworks wie Angular, React und Vue.js zu crawlen.“ Nur mit bezahlter Lizenz. Quelle
✓Chrome Crawler: „Sitebulb nutzt eine Evergreen-Chromium-Rendering-Engine, genau wie Google“ Quelle
✓Ja, in den Tarifen Guru oder Business (Semrush One Pro+ oder Advanced) Quelle
✓„Der Crawl-Modus mit JavaScript-Rendering ist im Tarifpreis enthalten (keine Zusatzgebühr)“, aber „eine per JS gerenderte Seite zählt wie zwei normal gecrawlte Seiten“. Quelle
✓Chrome, für jede Seite oder eine bestimmte Anzahl von Seiten
Listenmodus
✓„Mode > List“: „eine vordefinierte Liste von URLs prüfen …“ Quelle
✓Regeln „Allow subfolders“ und „Disallow subfolders“ sowie „Parameters to ignore“, damit Site Audit URL-Parameter beim Crawlen entfernt. Quelle
✓Regex-Regeln: „Nur URLs crawlen, die dem Muster entsprechen“ und „URLs, die dem Muster entsprechen, nicht crawlen“, dazu „Remove URL parameters“ und Regeln zum Umschreiben von URLs. Quelle
✓Felder „Included Only URLs“ und „Excluded URLs“ (Ruby-Regex) Quelle
✓Regeln „Allow Pattern“ und „Deny Pattern“ in den erweiterten Einstellungen, als URL-Pfade oder Regex mit dem Präfix „rx:“ Quelle
✓Einschließen, Ausschließen und eine Ausschlussliste für jeden Crawl
Grenzen für die Crawl-Geschwindigkeit
✓„die Geschwindigkeit des SEO Spider steuern, entweder über die Zahl gleichzeitiger Threads oder über die pro Sekunde angefragten URLs“ (Standard 5 Threads). Quelle
✓Anzahl der Threads oder Chrome-Instanzen und „Max HTML URLs per Second“ Quelle
✓Die Standardgeschwindigkeit ist „auf höchstens 30 URLs pro Minute begrenzt“ Quelle
✓Crawl-Geschwindigkeit in URLs pro Sekunde (das Kontomaximum legt Lumar fest), und Sie können „Einschränkungen hinzufügen, um die Geschwindigkeit von Crawls zu bestimmten Zeiten zu senken oder zu erhöhen“. Quelle
✓„Sie wählen die Geschwindigkeit (Anzahl der Threads)“ Quelle
✓Anfragen pro Sekunde, und es wird langsamer, wenn eine Website kämpft
robots.txt-Tester
✓„eigene robots.txt-Konfiguration, mit der Sie die robots.txt einer Website herunterladen, bearbeiten und testen können“ Quelle
◐„Virtual robots.txt“ ruft die Live-Datei ab, lässt Sie sie bearbeiten und mit Ihrer Version crawlen Quelle
◐kein URL-Tester. Der Robots.txt-Bericht meldet Probleme der Datei und „jede Änderung an Ihrer robots.txt-Datei“ Quelle
✓robots.txt Overwrite, um „eine neue robots.txt zu testen, bevor sie live geht“, über einen ganzen Crawl Quelle
✓Das kostenlose Robots.txt Multi-tool „validiert Ihre robots.txt-Datei, hebt widersprüchliche Direktiven hervor“ und simuliert Regeln pro Bot Quelle
✓robots.txt-Tester; beachten, ignorieren oder einen Entwurf nutzen
Eigener User-Agent
✓„eingebaute User-Agent-Voreinstellungen für Googlebot, Bingbot, verschiedene Browser und mehr“ sowie ein eigener User-Agent für HTTP-Anfragen und ein separater Robots-User-Agent. Quelle
✓Voreinstellungen „darunter Google, Bing, Yahoo und Yandex“, dazu „Custom User Agent“ und ein eigener User-Agent für die robots.txt. Quelle
◐nur Voreinstellungen, „Es gibt insgesamt 5 User-Agents“ Quelle
✓Jeder User-Agent, und Crawlen als KI-Crawler
Logins und Authentifizierung
✓„zwei Arten der Authentifizierung: standardbasiert, darunter Basic- und Digest-Authentifizierung, und über Webformulare.“ Quelle
✓HTTP-Authentifizierung und formularbasierte Authentifizierung, dazu eigene HTTP-Header. Quelle
◐nur Basic Auth: „Crawl with my credentials“ für Websites, die „per Basic-Authentifizierung verborgen“ sind, dazu eine Option für Web-Bot-Auth-Signaturen. Quelle
◐Basic-Authentifizierung („Anmeldedaten per Basic-Authentifizierung in alle Anfragen aufnehmen“), eigenes DNS, IP-Allowlisting und Login-Cookies über eigene Request-Header Quelle
◐„Geben Sie unter HTTP Auth den Benutzer (Login) ein …“ Quelle
✓Authentifizierung, Header und Formulare
Pausieren und Fortsetzen
✓Pausieren und Fortsetzen in der App („Sie können den Crawl fortsetzen, wenn er pausiert wurde“) Quelle
✓„Mit Sitebulb können Sie pausieren und fortsetzen, wann immer es Ihnen passt“ Quelle
✓Sind die Crawl-Limits erreicht, können Sie „Ihre Crawl-Einstellungen anpassen, den Crawl fortsetzen oder ihn abschließen“ Quelle
✓Laufende Crawls lassen sich pausieren und fortsetzen Quelle
✓Pausieren, Fortsetzen, und Beenden sichert zuerst den Crawl
Mehrere Websites gleichzeitig crawlen
✓Ein Fenster pro CrawlFAQ: „Öffnen Sie mehrere Instanzen des SEO Spider, eine für jede Domain, die Sie crawlen möchten“, oder nutzen Sie den Listenmodus mit einer Liste von Domains. Quelle
◐Cloud: ab MediumDesktop stellt Audits in eine Warteschlange („sie laufen nacheinander“) Quelle
✓Bis zu 5„Number of Audits Running at Once“ Quelle
✓Kein LimitFAQ: „Sie können Crawls, große und kleine, alle gleichzeitig ausführen“ und „Wir begrenzen die Zahl der verschiedenen Domains nicht, die Sie crawlen können“. Quelle
✓Unbegrenzt„Gleichzeitige Crawls sind in allen JetOctopus-Tarifen unbegrenzt, ohne Zusatzkosten.“ Auch Projekte und Domains sind unbegrenzt. Quelle
✓4 in einem FensterBis zu 4 Websites gleichzeitig, jede im eigenen Tempo, mit Speicherwächter (0.10.38)
URL-Limits
✓Unbegrenzt, kostenpflichtigKostenlos: 500 URLs pro Crawl. Quelle
◐automatische Gruppierung nach HTML-Template, um „SEO-Probleme nach Template zu segmentieren“ Quelle
✓Ja, in Semrush Enterprise Site Intelligence Quelle
✓„Segment crawls“ nach Filtern (Unterverzeichnis, Subdomain) Quelle
✓Segmentierung: „Eigene Segmente auf Basis der umfangreichen Kennzahlen von Lumar erstellen“, mit Segment-Trends und Monitor-Warnungen Quelle
✓„Wir begrenzen die Zahl der Segmente nicht“ Quelle
✓Seitengruppen, aus dem HTML erkannt, und Segmente
Crawl-Visualisierungen
✓Kräftebasierte Crawl- und Verzeichnisdiagramme (2D und 3D), Crawl- und Verzeichnisbäume, Wortwolken und das Diagramm semantischer Content-Cluster (v22.0). Quelle
✓Interaktive „Crawl Maps“ („Best Software Innovation“ bei den US Search Awards 2018), weitere Website-Visualisierungen, Diagramme und Zeitleisten. Quelle
◐Diagramme und eine Ansicht „Site Structure“ mit „Subdomains und Unterverzeichnissen, mit der Zahl der URLs und Probleme in jedem“. Quelle
✓„Visualisiert Daten mit Diagrammen und Grafiken“ zu Indexierbarkeit, Ladezeit, Duplikaten und Statuscodes Quelle
◐Aufschlüsselungs-, Trichter- und Trenddiagramme auf Dashboards und in jedem Bericht (Tabs „Trends & Segments“, „Breakdown“). Quelle
✓„JetOctopus bietet über 97 Berichte, 381 Diagramme, 26 Datensätze“ Quelle
✓Crawl-Karte
Crawl-Vergleich
✓„Mode > Compare“ zeigt hinzugefügte, neue, entfernte und fehlende URLs pro Tab und Filter, einen Tab zur Änderungserkennung und einen Vergleich der Website-Struktur (erfordert Lizenz und Datenbankspeicher) Quelle
✓„Audit Comparison“: „Änderungen über die Zeit verfolgen und herausfinden, was seit Ihrem letzten Audit anders ist“ Quelle
✓Mit „Compare Crawls“ können Sie „jedes frühere Site Audit im direkten Vergleich ansehen“, mit behobenen und neuen Problemen Quelle
✓„Mit Site Audit können Sie zwei beliebige Crawls vergleichen“ Quelle
✓Jeder Bericht vergleicht mit dem vorigen Crawl Quelle
✓„Sie können beliebige Crawls vergleichen, nicht nur die letzten zwei“, mit allen Crawler-Diagrammen und Datentabellen, auch nach Segment Quelle
✓Identisches HTML, technisch identische URLs, doppelte Titles, Descriptions und H1 Quelle
✓„Erkennt der Site-Audit-Bot mehrere Seiten mit 85 % inhaltlicher Ähnlichkeit, meldet er sie als Duplicate Content.“ Doppelte Titles und Descriptions Quelle
✓Duplikat-Bericht zu Titles, Descriptions, H1 und Content Quelle
✓„Duplicate Pages“ haben „einen identischen Title, eine identische Description und nahezu identischen Content“ Quelle
✓Berichte „Duplication“ für Titles, Descriptions, H1, H2 und Hauptinhalt, bei denen „Sie den Prozentsatz der Duplizierung wählen können“ Quelle
✓Duplicate Content und Near Duplicates
Thin Content
✓Check „Low Content Pages“ in der Kategorie Content, Wortzahl pro Seite und „Low Relevance Content“. Quelle
✓Regex-Custom-Extraction (30 Extraktionskennzahlen) Quelle
✓„Sie können während eines Crawls bis zu 50 eigene Extraktionsregeln einrichten“ Quelle
✓Suche und Extraktion
KI-Prüfung des Seiteninhalts
✓OpenAI, Gemini, Anthropic, OllamaDirekte API-Integrationen mit OpenAI, Gemini, Anthropic und Ollama (LM Studio über die OpenAI-Integration) Quelle
◐MCP, nur Lesezugriffwährend eines Crawls laufen keine KI-Prompts auf dem Seiteninhalt. Quelle
◐Seite für SeiteContent Toolkit, eine Seite nach der anderen Quelle
◐Vorgegebene Aufgabennur feste KI-Aufgaben: „Ask AI“ und „Batch AI“ schreiben Titles und Meta-Descriptions (Project Boost), dazu eine Erkennung von KI-Content Quelle
◐Integriertkeine selbst geschriebenen Prompts auf dem Seiteninhalt. Quelle
◐Integriert, MCPkeine eigenen Prompts pro Seite Quelle
✓Ollama, Anthropic, OpenAI44 KI-Prüfungs-Checks, ausgeführt von Ollama auf Ihrem eigenen Computer; Schlüssel für Anthropic und OpenAI unter Verbindungen
Semantische Ähnlichkeit
✓Vektor-Embeddings von OpenAI, Gemini oder Ollama, „um semantisch ähnliche Seiten und Content mit geringer Relevanz zu erkennen, ebenso für die semantische Suche und das Content-Cluster-Diagramm“ Quelle
◐nichts eingebaut. Eine Anleitung auf ihrer Website (8. Oktober 2026, Gastautor) Quelle
✓29Hints-Bibliothek: On Page 22 und Duplicate Content 7 (zusammen 29), dazu die Berichte zu Rechtschreibfehlern und Lesbarkeit. Quelle
✓140+ insgesamt„Mit der Möglichkeit, über 140+ Website-Probleme zu prüfen“ Quelle
✓170+ insgesamt„Sucht nach 170+ Problemen“ in technischen und On-Page-Kategorien, dazu eigene Probleme Quelle
✓43 BerichteKeine Gesamtzahl veröffentlicht. Meine Zählung ihrer API-Berichtsliste Quelle
✓Rund 100 insgesamtEtwa 100: Der Problem-Scan führt „rund 100 vorgefertigte Checks über Crawl, Logs und Search Console aus, nach Schweregrad gruppiert“. Quelle
✓Tab „Response Codes“: durch robots.txt blockiert, keine Antwort, 2XX, 3XX, 4XX und 5XX, für interne und externe URLs. Quelle
✓„Status Code: Der HTTP-Statuscode (z. B. …“ Quelle
✓Fehler „Pages returning 4XX status code“ und „Pages returning 5XX status code“, DNS- und Crawl-Fehler, dazu ein Hinweis für externe Links, die 403 liefern. Quelle
✓Seiten ohne 200 werden „unter dem jeweiligen Problem aufgeführt“ (404, 4XX, 5XX, 403, Zeitüberschreitung, defekte Weiterleitungen) Quelle
✓Berichte für 200er-Seiten, 301- und andere Weiterleitungen, „4xx Errors“, „5xx Errors“, „Uncategorized HTTP Response Codes“ und fehlgeschlagene URLs Quelle
✓Statuscode-Diagramme und Datentabellen in Crawls und Logs Quelle
✓Ja, überall farbig markiert
Weiterleitungen und Ketten
✓„Temporäre und permanente Weiterleitungen finden, Weiterleitungsketten und -schleifen erkennen“ Quelle
✓13 Redirects-Hinweise (defekte Weiterleitungen, Weiterleitungsschleifen, Weiterleitungen für Schrägstrich am Ende und Groß-/Kleinschreibung, Meta-Refresh) Quelle
✓„Redirect chains and loops“ (Error), „Pages with temporary redirects“, „URLs with a permanent redirect“ Quelle
✓Das Problem „Redirect chain“ „meldet URLs, die eine Reihe von Weiterleitungen auslösen“ Quelle
✓Berichte „Redirect Chains“ („Weiterleitung auf eine andere URL, die ebenfalls weiterleitet“), „Redirect Loops“, defekte, JavaScript- und Meta-Refresh-Weiterleitungen sowie „Max Redirections“. Quelle
✓Datentabelle für Weiterleitungsketten, in der „Sie auch die Anzahl der Hops in der Weiterleitungskette ändern können“ Quelle
✓22 Weiterleitungs-Checks, Ketten und Schleifen
Canonicals
✓Der Tab „Canonicals“ deckt Canonical-Link-Elemente und HTTP-Header ab Quelle
✓Indexability-Hinweise decken Canonicals ab Quelle
✓Errors „Pages with a broken canonical link“, „Pages with multiple canonical URLs“ und „AMP pages with no canonical tag“ Quelle
✓Probleme wie „Canonical points to redirect“, Canonical auf 4XX oder 5XX, nicht kanonische Seite als Canonical angegeben und HTTP/HTTPS-Abweichungen im Canonical. Quelle
✓„Conflicting Canonical Tags“ („entweder in den HTML-Canonical-Tags oder in HTTP-Headern“), Canonical to Non-200, Pages without Canonical Tag, Unlinked Canonical Pages, Change Quelle
✓Für rel=canonical: „Wir haben mehrere Berichte zu den häufigsten Problemen erstellt“, dazu ein eigener Modus für separate mobile Subdomains. Quelle
✓Ja
Indexierbarkeitsbericht
✓Jede URL ist „Indexable“ oder „Non-Indexable“, mit einem Grund unter „Indexability Status“ Quelle
✓„auf überlappende oder widersprüchliche Robots-Direktiven, Canonical-Probleme und Konfigurationsfehler in der robots.txt prüfen“ Quelle
◐keine Spalte und kein Bericht zur Indexierbarkeit Quelle
✓Problemkategorie „Indexability“ und Verteilungsdiagramm Quelle
✓„Non-Indexable Pages“ („durch noindex oder Canonical von der Indexierung ausgeschlossen“), Berichte zu noindex, kanonisierten und gesperrten Seiten Quelle
✓Eingebautes Segment „Indexable“ für alle Berichte Quelle
✓145 Indexierbarkeits-Checks
Paginierung
✓Tab „Pagination“ für rel=„next“ und rel=„prev“ Quelle
◐Hinweise „Pagination URL has no incoming internal links“ und „Query string contains paginated parameters“ Quelle
✓Prüft die Crawlbarkeit paginierter Seiten in Crawl und Logs Quelle
✓Paginierungs-Checks
Hreflang
✓„Fehlende Rückverweise, inkonsistente und falsche Sprachcodes, hreflang auf Seiten ohne 200 und mehr prüfen“ Quelle
✓„prüfen, ob hreflang-Tags gültig, wechselseitig, eindeutig, konsistent und selbstreferenzierend sind“ Quelle
◐Der Bericht „International SEO“ prüft Konflikte, Werte, defekte Links und fehlende Tags, aber „derzeit prüft Semrush nur das HTML Ihrer Website“ (keine Sitemaps oder Header). Quelle
✓Meldet ungültige Codes, fehlende Selbstreferenz, fehlende Rückverweise, hreflang auf defekte oder nicht kanonische Seiten Quelle
✓Sitemap-Checks: „URLs Not In Sitemap“, „Orphan URLs“, „Non-Indexable URLs In Sitemap“, „XML Sitemap With Over 50k URLs“, „XML Sitemap Over 50mb“, „URLs In Multiple Sitem Quelle
✓9 XML-Sitemaps-Hinweise (4XX, 5XX, noindex, kanonisiert, gesperrt, Weiterleitung, Zeitüberschreitung, URL in mehreren Sitemaps), Erkennung verwaister Seiten und ein XML-Sitemap-Generator. Quelle
✓Errors wie „Format errors in sitemap.xml files“, „Incorrect pages found in sitemap.xml“, „Sitemap.xml files are too large“ Quelle
✓Sitemap-Probleme wie „Non-canonical page in sitemap“, Seiten mit noindex, 3XX, 4XX oder 5XX in der Sitemap, Sitemap-Seiten mit Zeitüberschreitung und ungültiges Format (nur XML). Quelle
✓Nicht indexierbare, fehlerhafte und weiterleitende URLs in Sitemaps, defekte oder gesperrte Sitemaps, zu viele URLs, leere Sitemaps Quelle
✓Sitemap-Bericht mit verwaisten URLs und URLs ohne 200, „Sitemaps problems by depth“ und eine Tabelle „Sitemap files“ Quelle
✓20 XML-Sitemap-Checks
Interne Links und Link Score
✓„Interne Links, Linkanzahl und Crawltiefe analysieren und den internen Link Score berechnen“ Quelle
✓„URL Rank, kurz UR, misst die interne Stärke einer Seite anhand des relativen Linkgewichts“ Quelle
✓Bericht „Internal Linking“ und ILR pro Seite Quelle
✓Page Rating (PR) bewertet die Linkstärke jeder URL „auf einer logarithmischen Skala von 1 bis 100“ Quelle
✓DeepRank: „ein Maß für das interne Linkgewicht, ähnlich berechnet wie Googles grundlegender PageRank-Algorithmus“, auf einer Skala von 0 bis 10 Quelle
◐tiefe Linkanalyse (Inlinks, Ankertexte, nofollow, Linking Explorer) Quelle
✓Link Score und 51 Link-Checks
Verwaiste Seiten
✓„Um verwaiste Seiten zu finden, braucht es zusätzliche URL-Quellen: XML-Sitemaps und die Anbindung der APIs von Google Analytics und Search Console.“ Quelle
✓Verwaiste Seiten sind „URLs, die im Audit gefunden wurden, aber NICHT vom Crawler“, gefunden über XML-Sitemaps, Google Analytics, Search Console oder URL-Listen Quelle
✓Notices „Orphaned pages (from Google Analytics)“ und „Orphaned pages (in sitemap)“ Quelle
◐„Orphan page“ umfasst URLs ohne eingehende interne Links, die aus Crawl-Seeds stammen oder „in der Sitemap-Datei gefunden“ wurden Quelle
✓Berichte zu verwaisten Seiten pro Quelle (Search Console, Analytics, Sitemaps, Logfiles, URL-Listen, Backlinks), z. B. Quelle
✓Bericht „Orphan Pages“ aus Sitemap- und GSC-URL-Quellen, nach Quelle filterbar Quelle
✓Verwaiste Seiten, aus Search Console, Analytics und XML-Sitemaps
Sicherheit und HTTPS
✓„Unsichere Seiten, Mixed Content, unsichere Formulare, fehlende Sicherheits-Header und mehr finden“ Quelle
✓Der Bericht „Security“ prüft TLS-Protokolle, Cipher-Suites und Zertifikate Quelle
◐HTTPS-Checks (Mixed Content, Zertifikate, altes TLS, „Subdomains don't support HSTS“) Quelle
◐HTTPS-Checks wie „HTTPS page has internal links to HTTP“, Weiterleitungen von HTTPS auf HTTP und Mixed Content Quelle
✓„HTTPS Pages without HSTS“, HTTP-Seiten, HTTP-Skripte auf HTTPS-Seiten, Mixed Content, Links von HTTPS auf HTTP Quelle
◐Nur Mixed Content bei HTTPS, etwa „Links to HTTP pages (mixed content)“ und HTTP-Bilder Quelle
✓29 Sicherheits-Checks
AMP
✓„AMP-URLs crawlen und mit dem offiziellen integrierten AMP Validator validieren“ Quelle
✓Berichte zur mobilen Konfiguration (responsiv, dynamisch, separate mobile Version), „Discouraged Viewport Types“ („schlechte mobile Kompatibilität“), Abweichungen bei separater mobiler Version Quelle
✓Ein Crawl mit Googlebot Mobile „bringt Probleme der mobilen Nutzerfreundlichkeit ans Licht“, etwa „falsch konfigurierter Viewport, zu kleine Schrift, Tippziele“ Quelle
✓Viewport- und Mobil-Checks
Bilder
✓Fehlender Alt-Text und fehlendes alt-Attribut, „Over 100 kb“, Alt-Text über 100 Zeichen, „Incorrectly Sized Images“, „Missing Size Attributes“, Hintergrundbilder, missing image t Quelle
✓Hinweise wie „Images with missing alt text“ und „Has an anchored image with no alt text“, außerdem „Transferred image size is over 100KB“, „Properly size images“ und „Add dimensions to images“, dazu Bilder im next Quelle
✓„Wir prüfen Bildgröße, Ladezeit und Content-Typen“, defekte Bilder und alt-Attribute („Set“ und „Not set“) Quelle
✓„Broken Images“, „Links with Images Missing Alt Tags“, Barrierefreiheitsregeln image-alt und Lighthouse-Bildaudits in Site Speed (ohne Größe, außerhalb des Viewports, nicht optimiert, nicht resp Quelle
✓20 Bild-Checks und Bildstichproben pro Seitengruppe
Speed und Core Web VitalsScreaming Frog 3Sitebulb 1Semrush 1Ahrefs 4Lumar 4JetOctopus 3Neova 4von 4
Funktion
Screaming Frog
Sitebulb
Semrush
Ahrefs
Lumar
JetOctopus
Neova
Lighthouse
✓„Über die PSI-API Lighthouse-Metriken, Speed-Empfehlungen, Diagnosen und den Chrome User Experience Report (CrUX) Quelle
✓Lighthouse „Opportunities and Diagnostics“ laufen „über jede einzelne gecrawlte Webseite“ mit dem eingebauten Chrome Crawler, dazu Web-Vitals-Labormetriken (LCP, CLS, TBT, TTI, FCP Quelle
✓Bericht „Core Web Vitals“, „basierend auf Googles Lighthouse“ (LCP, CLS, TBT) Quelle
✓PageSpeed Insights pro Seite mit Ihrem eigenen kostenlosen Google-API-Schlüssel Quelle
✓In Site Speed: „Lighthouse-Performance-Metriken in großem Maßstab“, mit Berichten zu Empfehlungen und Diagnosen pro Seite und einem eingebetteten Lighthouse Viewer (Juni 2025). Quelle
✓PageSpeed-API mit eigenem Schlüssel („Ihr Limit liegt bei 30,000 Anfragen pro Tag“) Quelle
✓LCP, INP und CLS echter Chrome-Nutzer, mit Ihrem Chrome-UX-Report-Schlüssel
Core-Web-Vitals-Verlauf
◐kein Verlaufsdiagramm für CWV in der App gefunden. Quelle
◐Das Google Sheet „Historical Audit Data“ hat eine Zeile pro Audit für „Zeitreihen oder Diagramme“ in Looker Studio und enthält Bandwerte der Core Web Vitals (Changelog, 13 Quelle
✓In Site Speed: „ein Verlaufsdiagramm für jede der KPIs“ (FCP, LCP, TBT, CLS), aufgeteilt in Slow, Moderate, Fast, ein Punkt pro Crawl (Labordaten) Quelle
◐geplante CWV-Checks („+Create a CWV schedule“) Quelle
✓Ein 40-Wochen-Verlauf ab dem ersten Tag und eine Ansicht pro Seitengruppe
◐kein Bericht zu KI-Crawlern und keine Voreinstellung für KI-Bots gefunden Quelle
✓„Blocked from AI Search“ prüft die robots.txt für ChatGPT-User, OAI-SearchBot, Googlebot, Google-Extended, Perplexity-User, PerplexityBot, Claude-User, Claude-SearchBot. Quelle
✓Probleme unter „AI Discoverability“ (Sept. 2026) Quelle
✓„ChatGPT Blocked“ („in der robots.txt für die User-Agent-Tokens GPTBot oder ChatGPT-User gesperrt“), Google AI Blocked (Google-Extended), Bing AI Blocked, AI Bot Blocked, Common Quelle
✓Das kostenlose Robots.txt Multi-tool soll „Zugriffsregeln für Such- und KI-Crawler an einem Ort prüfen“, darunter GPTBot, ClaudeBot und PerplexityBot. Quelle
✓Was jeder KI-Crawler abrufen darf und was 10 KI-Assistenten tatsächlich ausgeliefert bekommen
◐keine Checks für KI-Antworten. Der Bericht „Response vs Render“ wird damit beworben, „genau zu erkennen, was LLMs sehen können“ Quelle
✓AI-Search-Checks: „Too much content“, „Outdated Content“ (Last-Modified älter als sechs Monate), „Low Semantic HTML Usage“, „Content not optimized“ (Überschriften, lange Absätze, r Quelle
✓AI Discoverability: Seiten „zu langsam oder zu schwer für KI-Crawler“, „Pages requiring JavaScript rendering“, „Similar AI-generated content“ Quelle
✓Der AI Page Optimizer soll für Query-Fan-outs „Ziel-Keywords mit Title, Meta-Angaben und Inhalt abgleichen“ und prüft, „ob JavaScript Ihre Inhalte vor KI-Agenten verbirgt“. Quelle
✓„Verbindung zu den Google-APIs Search Analytics und URL Inspection“ Quelle
✓FAQ: „Impressionen, Klicks, CTR, durchschnittliche Position“, „Keyword-Daten in großen Mengen“, „Indexierbarkeitsdaten über die URL Inspection API“. Quelle
✓GSC ist angebunden an Position Tracking, On Page SEO Checker, Backlink Audit, Organic Traffic Insights, My Reports und Project Dashboard Quelle
✓„Link Google Account“ importiert „bis zu 16 Monate an Daten“ und speichert sie weiter Quelle
✓GA4 und GA360: Besuche, Absprungrate, Seitenaufrufe und Conversions pro URL, filterbar auf organisch, „Google or Bing Organic Search Landing Pages, or All“ Quelle
✓„die Integration funktioniert nur mit Google Analytics 4. Quelle
◐Bingbot in Logs und im robots.txt-Tester („Vollständige Daten zu Googlebot, Bingbot, GPTBot, ClaudeBot und 40+ weiteren Crawlern“) Quelle
✓Bing Webmaster Tools, einschließlich Zitaten in Bing AI
Rank-Tracking
◐kein Rank-Tracker. Die Integration von GSC Search Analytics liefert die durchschnittliche „Position“ pro URL. Quelle
◐kein Rank-Tracker. Der Bericht „Keywords“ nutzt GSC-Daten Quelle
✓Position Tracking „überwacht täglich die Suchrankings Ihrer Website“ nach Gerät und Standort „bis hinunter zur Postleitzahl“, auf Google, Bing, Baidu, ChatGPT Search und AI Mode. Quelle
✓Rank Tracker: Google, „Mobile and desktop tracking“, 190+ Standorte bis zur Postleitzahl, 19 SERP-Features Quelle
◐kein Rank-Tracker; nur GSC-Position pro Seite und Suchanfrage. Quelle
◐Rankings auf GSC-Basis, kein SERP-Rank-Tracker Quelle
✓25 verfolgte Suchbegriffe pro Tag aus der Search Console; echte Positionen über DataForSEO
Keyword-Daten
◐GSC-Search-Analytics-Metriken pro URL (Zeitraum und Dimensionen einstellbar) Quelle
✓Bericht „Keywords“ aus der Google Search Console („enable Keyword Analysis“), mit Marken-Keywords. Quelle
✓Keywords Explorer: „28,7 Mrd. Keywords, gefiltert aus 110 Mrd. gefundenen“, 217 Standorte, Suchvolumen, Keyword Difficulty, Traffic-Potenzial Quelle
✓GSC-Suchanfragen pro Seite, bis zu 2,000 hochgeladene Ziel-Suchanfragen und Suchvolumen, das „von einem Drittanbieter stammt“ (Relevance Reporting) Quelle
◐Nur GSC-Suchanfragen und Ahrefs-Keyword-Metriken Quelle
✓Suchanfragen aus der Search Console; Keyword-Lücken über DataForSEO
Backlink-Metriken
✓„Externe Linkmetriken aus den APIs von Majestic, Ahrefs und Moz in einen Crawl holen“ Quelle
–Keine Integration von Ahrefs, Majestic oder Moz gefunden. Quelle
◐jede Website lässt sich crawlen und zwei Crawls lassen sich vergleichen Quelle
◐jede Domain lässt sich auditieren („Crawl unlimited domains“) Quelle
◐jeder Wettbewerber ist ein eigenes Site-Audit-Projekt („Enter your competitor's URL“) Quelle
✓Site Audit crawlt Websites, die Sie nicht verifizieren können, als nicht verifizierte Projekte („von 5 im Lite-Tarif bis 100 im Enterprise-Tarif“) Quelle
◐jede Domain lässt sich crawlen („Wir begrenzen die Zahl der verschiedenen Domains, die Sie crawlen können, nicht“) Quelle
✓„Sie können jeden Wettbewerber crawlen und seine Struktur, Seitentypen und Templates sehen“ Quelle
✓Die Ansicht „Wettbewerber“: jede Kennzahl im direkten Vergleich, farbig danach, wer vorn liegt
✓Position Tracking: „Der Competitors Discovery Report zeigt organische Wettbewerber, die für Ihre Keywords ranken“ Quelle
✓Neue Projekte „erhalten Vorschläge für Wettbewerber auf Basis von Websites, die für ähnliche Keywords ranken“ Quelle
✓In AI Visibility: „Marken werden automatisch aus den Antworten der KI-Anbieter erkannt“, und Lumar ordnet jede als Own, Competitor, Other oder Context ein. Quelle
✓Der Tab „Schedule“ legt „den Tag, die Uhrzeit und die Zeitzone“ fest Quelle
✓„Zeitpläne für Ihre Crawls einrichten (z. B. Quelle
✓„New scheduled crawl“ mit täglicher, wöchentlicher, zweiwöchentlicher oder monatlicher Frequenz, Startdatum und Zeitzone Quelle
✓Zeitpläne mit Vorwarnung, Verschieben und Überspringen (Desktop-App)
Änderungserkennung
✓Tab „Change Detection“ im Vergleichsmodus für gewählte Elemente (Titles, Descriptions, H1, Wortzahl und mehr) Quelle
✓„Lost and Found vergleicht die wichtigsten URL-Metriken und ausgelösten Hinweise Ihres aktuellen Audits mit dem letzten vorherigen Audit“ (Found, Lost, Remained) Quelle
◐Vergleich von Crawl zu Crawl, und der Bericht „Robots.txt“ „teilt Ihnen mit, ob Semrush Änderungen an Ihrer robots.txt bemerkt hat“. Quelle
✓Always-on audit: „Sie sehen jetzt alles, was sich an einem beliebigen Tag auf Ihrer Website geändert hat“ Quelle
✓Changed Metrics zeigt pro URL, „welche Metriken sich von Crawl zu Crawl geändert haben“, dazu Berichte wie Pages with Changed Title, Status Code und Canonical URLs. Quelle
✓Warnungen plus Custom Extraction, um „Änderungen an Onpage-Elementen zu verfolgen und zu sehen, ob sie den erwarteten Werten entsprechen“ Quelle
✓Inhaltliche Änderungen zwischen Crawls; Änderungen leuchten schon während des Crawls auf
Warnungen und Benachrichtigungen
✓E-Mail nach Abschluss des Crawls über Outlook, Gmail oder eigenes SMTP, mit einer Tabelle der Issues Quelle
✓„Sitebulb schickt Ihnen eine freundliche E-Mail, sobald Ihr Audit fertig ist“ (pro Projekt eingestellt, mehrere Adressen möglich). Quelle
✓Site Audit verschickt bei Zeitplänen „automatische E-Mail-Updates“ Quelle
✓Always-on audit schickt E-Mails, „wenn eine neue Seite von einem Problem der Stufe Error betroffen ist“ (auch eigene Issues), dazu E-Mails bei Crawl-Ende, Rank-Tracker-Berichte und Ahrefs Alerts. Quelle
◐„Sitebulb Cloud lässt sich mit Slack verbinden, sodass Sie Slack-Benachrichtigungen zum Fortschritt der Audits erhalten“ (nur Cloud, Admin-Nutzer) Quelle
◐Slack nur für Wettbewerber-Warnungen in Traffic & Market Quelle
◐keine nativen Warnungen in Slack oder Teams gefunden (Warnungen kommen per E-Mail). Quelle
✓In Lumar Monitor: Warnungen „in der App oder per E-Mail, Slack oder Microsoft Teams“ Quelle
✓„Echtzeit-Benachrichtigungen per E-Mail, Slack oder MS Teams erhalten“ Quelle
✓Slack und Microsoft Teams, pro Kanal, plus Webhooks
◐kein eingebauter PDF-Auditbericht gefunden. Quelle
✓„PDF-Berichte für jeden einzelnen Bericht oder für das ganze Audit in einem Dokument erstellen“, mit Auswahl von Berichten, Diagrammen und Tabellen. Quelle
✓Jeder Tab in Site Audit lässt sich als PDF exportieren Quelle
✓Report Builder: „Klicken Sie auf die Schaltfläche Print to PDF“ Quelle
◐PDF-Berichte lassen sich nach Abschnitten anpassen, und ein Kundenzitat auf der Feature-Seite lobt „komplett White-Label-PDFs und CSV-Berichte“ Quelle
✓Ja, mit dem Add-on Pro Report ($20/Monat pro Bericht) Quelle
–„Derzeit erlauben wir kein White-Labeling unserer Berichte.“ Quelle
◐FAQ: „Die Oberfläche lässt sich mit Ihrem eigenen Logo als White-Label gestalten“. Quelle
✓CSV-Exporte in Tabellenformaten, Export nach Google Sheets (Keywords Explorer, Brand Radar, Bot Analytics), Looker-Studio-Connectoren für Site Audit, Site Explorer, Rank Tra Quelle
✓CSV-Berichte zum Herunterladen (plus CSV mit Exploded Metric für Excel), ein Looker-Studio-Connector als „offizieller Google-Partner“ mit Vorlagen und Google-Sheets-Dashboards über Zapi Quelle
✓Export nach „Excel, Google Sheets, CSV oder Google Data Studio (Looker)“ Quelle
✓Excel-Arbeitsmappe (für Google Sheets), CSV fertig für Looker Studio
Exportziele
✓Lokaler Ordner; Google Drive als Google Sheets (manuell oder geplant Quelle
✓CSV- und .xlsx-Exporte, nach jedem Audit automatisch in einem lokalen Ordner gespeichert, „ODER in einem freigegebenen Speicherordner, etwa bei einem Cloud-Speicherdienst wie Dropbox“ Quelle
✓CSV-Download, Google Sheets (einige Berichte), PDF über Drucken, Looker-Studio-Connectoren, plus API v3 und MCP Quelle
✓Berichte als CSV oder XML zum Herunterladen, Rohdaten als Parquet-Dateien, Connectoren für BigQuery und Looker Studio, Google Sheets über Zapier, BI-Tools (Tableau, Power BI), die API und Webhook Quelle
✓CSV-, Excel-, Google-Sheets- und Sitemap-Dateien aus Datentabellen, plus Data-Studio-Connector, BigQuery („Crawl- und GSC-Daten direkt nach BigQuery exportieren“), API und MCP. Quelle
✓Dashboard-Tab in v25.0: „Ihre eigenen Dashboards bauen“ aus Widgets (Diagramme, Zähler, Prozentwerte, Übersichtstabellen, Issue-Liste, Segment-Diagramm …) Quelle
◐kein CLI-Tool; Cloud-Dienst, gesteuert über die API oder MCP, mit Tokens „für CI-Pipelines, Skripte und automatisierte Agenten“ (Codex CLI, Gemini CLI). Quelle
✓API v3 ab Lite, 200,000 bis 2,000,000 Units pro Monat, mit Endpunkten für Site Audit, Site Explorer, Keywords Explorer, Rank Tracker und Brand Radar. Quelle
✓„die GraphQL-API von Lumar steht allen Nutzern zur Verfügung“, unter „einer Fair-Use-Richtlinie“ Quelle
✓Alle Tarife: „Zugriff auf alle wesentlichen Funktionen von JetOctopus, darunter das Anlegen von Projekten und Crawls, Diagrammdaten, Datentabellen und Exporte“. Quelle
✓REST-API von Neova Online mit API-Schlüsseln (0.10.38), plus der MCP-Server und die Kommandozeile
◐Eine Lizenz pro PersonLizenzen gelten pro Nutzer („Wenn fünf Personen aus Ihrem Team den SEO Spider nutzen möchten, brauchen Sie 5 Lizenzen“), Rabatte ab 5. Quelle
✓2 bis 10+ NutzerCloud-Tarife enthalten Nutzer (Mini 2, Small 5, Medium 10, Enterprise 10+) Quelle
✓Ab $45 pro Nutzer„Weitere Nutzer ab $45/Monat“ Quelle
✓Ab $40 pro Nutzer1 Nutzer inklusive; weitere Nutzer Quelle
✓4 Rollen, SSOTeamrollen „Admin, Editor, Reporter and Viewer“ mit Berechtigungen pro App Quelle
✓Unbegrenzt viele Nutzer„Projekte und Plätze (Nutzer) Quelle
BaldBald verfügbar. Heute eine Person pro Konto
Sprachen der Oberfläche
✓7„Die Oberfläche gibt es auf Englisch, Spanisch, Deutsch, Französisch, Italienisch, Niederländisch und Türkisch“ (7 Sprachen Quelle
✓1515 Sprachen: Englisch, Deutsch, Spanisch, Französisch, Indonesisch, Italienisch, Niederländisch, Polnisch, Portugiesisch, Schwedisch, Türkisch, Ukrainisch, Chinesisch, Japanisch und Koreanisch. Quelle
◐Englisch, Japanischkeine Liste der Oberflächensprachen gefunden. Quelle
–EnglischIn der Dokumentation nicht gefunden. Quelle
✓1515 Sprachen
Server-Logs
◐Log File Analyserein eigenes Produkt, der Screaming Frog Log File Analyser (Windows, macOS, Linux), um „Suchmaschinen- und KI-Bots zu verifizieren“. Quelle
–Bald verfügbarFAQ: „Sitebulb kann noch keine Logfile-Analyse, aber sie ist in Arbeit und bald verfügbar!“ Quelle
✓EnterpriseJa, als eigenes Enterprise-Produkt Quelle
◐Bot AnalyticsBot Analytics, ein eigenes Tool, in der Beta in bezahlten Tarifen kostenlos, „liest HTTP-Anfragedaten ein“ von Cloudflare, Vercel, CloudFront, AWS-Load-Balancern oder Fastly Quelle
◐Inklusiveenthalten, aber aus Zusammenfassungen pro URL Quelle
✓InklusiveIn jedem Tarif enthalten, kein eigenes Produkt Quelle
✓InklusiveEnthalten: Apache- und Nginx-Logs, Cloudflare direkt gelesen, nur verifizierte Bots
Staging und Migrationen
✓„Staging mit Produktionsumgebungen vergleichen, mit erweitertem URL Mapping“ Quelle
✓Staging-Websites mit HTTP- oder Formular-Authentifizierung und angepassten Robots-Einstellungen crawlen, dann Audits über „zwei beliebige Projekte“ vergleichen. Quelle
✓Ja, in Semrush Enterprise Site Intelligence Quelle
◐„Staging- und zugangsbeschränkte Websites crawlen … Quelle
✓„Ihre Staging- oder Testumgebung crawlen und mit Ihrer Live-Website vergleichen“, mit Test Site Domain, eigenem DNS, Basic Auth und Überschreiben der robots.txt. Quelle
✓„Der Vergleich der Crawls von Staging- und Live-Website hilft Ihnen, eine funktionierende Version ohne Fehler zu bauen“ Quelle
✓Staging vs. Produktion und eine Weiterleitungszuordnung
Öffnet Exporte anderer Crawler
◐Der Listenmodus liest URLs aus jeder .txt-, .xls-, .xlsx-, .csv- oder .xml-Datei („Sie können direkt einen Adwords-Download hochladen“) Quelle
✓500 URLs„Herunterladen und 500 URLs kostenlos crawlen“ … Quelle
–14 Tage testenKeine kostenlose Version: eine „14-tägige kostenlose Testphase“ mit dem Umfang von Pro, „keine Kreditkarte und keine Vorabverpflichtung“. Quelle
✓100 SeitenKostenloser Tarif: „1 Demoprojekt“, „10 Berichte pro Tag in allen wichtigen Tools“, „Keine Kreditkarte erforderlich“. Quelle
✓5,000 pro ProjektAhrefs Free (früher Webmaster Tools), für verifizierte Websites Quelle
◐7 Tage testenkein kostenloser Tarif; 7-tägige Testphase nach einer Demo, ohne Karte Quelle
✓1,000 URLsFree-Tarif mit jedem Check; Desktop 14 Tage kostenlos, ohne Karte
Preis
✓$279 pro JahrNur Desktop, kein Cloud-Tarif Quelle
✓Ab $18 pro MonatDesktop Lite: $18 / £12.50 / €15 pro Monat oder $180 / £125 / €150 pro Jahr. Quelle
✓Ab $139 pro MonatSEO $139/Monat, Starter $199/Monat, Pro+ $299/Monat (jährlich $117.33, $165.17, $248.17/Monat) Quelle
✓Ab $29 pro MonatNur Cloud: Starter $29/Monat, Lite $129, Standard $249, Advanced $449, Enterprise auf Anfrage Quelle
–Auf AnfrageKeine öffentlichen Preise: „Wir kalkulieren unsere Lösungen nach Ihrem individuellen Bedarf. Quelle
✓Ab $349 pro MonatNur Cloud, pro Monat bei jährlicher Abrechnung (Inhouse) Quelle
✓Ab $19 pro MonatKostenloser Tarif, bezahlte Tarife ab $19 pro Monat (US-Preis)
✓Ja◐Teilweise–Die anderen Tools: nein, oder in ihrer Dokumentation nicht gefunden–Neova: noch nichtBaldNeova: bald verfügbarJede Angabe zu den anderen Tools verlinkt auf die Seite ihrer eigenen Website oder Dokumentation, aus der sie stammt.
Was Neova nicht kann
Keine eigene Keyword- oder Backlink-Datenbank: Die haben Ahrefs, Semrush, SE Ranking und Moz, und Neova nutzt stattdessen Ihre Schlüssel und Ihre Search Console. Nutzen Sie Neova zusammen mit diesen Suiten, nicht an ihrer Stelle.
Bald verfügbar: Team-Konten und E-Mail-Warnungen (Warnungen kommen heute über das System, Neova Go, Slack und Microsoft Teams).
Noch keine semantische Ähnlichkeit.
Spalten für Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar und JetOctopus: nur, was deren eigene Website und Dokumentation angeben, gelesen am 11. November 2026, mit einem Link zu jeder Seite. „In der Dokumentation nicht gefunden“ heißt, dass wir es nicht gefunden haben, nicht, dass es nicht geht. Neovas Spalte: was Neova und Neova Online heute können, aus der App abgelesen. 141 von Neovas Checks stehen in keiner der veröffentlichten Listen der 10 verglichenen SEO-Tools (Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar, Moz, SE Ranking, Seobility, Sitechecker und Conductor): Jede Liste wurde am 25. Oktober 2026 einzeln mit Neovas Katalog abgeglichen. Die 67 seitdem hinzugekommenen Checks zählen erst, wenn sie verglichen sind. Diese Namen sind Marken ihrer Inhaber; Neova ist mit keinem von ihnen verbunden. Wenn eine Zeile falsch oder veraltet ist, schreiben Sie an hello@neova.app, und wir korrigieren sie.




 Google Search Console
 Google Analytics
 Chrome UX Report
 Google Cloud
 Gemini
 Bing Webmaster Tools
 OneDrive
 Microsoft Teams
 DataForSEO
 Semrush
 Ahrefs
 Majestic
 Moz
 SEO Gets
 Anthropic
 OpenAI
 Ollama
 Jira
 Linear
 Asana
 ClickUp
 monday.com
 Slack
 Cloudflare
 Google Drive
 Dropbox
 iCloud Drive
 Proton Drive
 kDrive
 Screaming Frog
 Sitebulb
 Lumar
 JetOctopus