Screaming Frog et Sitebulb ont placé la barre haut pour les crawlers SEO, et nous avons beaucoup appris de l'un comme de l'autre. Voici Neova à côté d'eux, et de Semrush, Ahrefs, Lumar et JetOctopus, d'après leur propre documentation, avec les liens.
4façons de l'utiliser : Mac, Windows, Linux, n'importe quel navigateur
15langues
Crawler plusieurs sites à la fois
Application de bureau
Crawlez votre client, ses concurrents et votre propre site en une fois. Jusqu'à 4 sites sont crawlés en même temps dans une seule fenêtre, chacun à son rythme et avec sa limite d'URL, et un garde-fou mémoire met le suivant en attente quand votre ordinateur manque de mémoire.
Deux crawls, une fenêtre2 crawls en cours en haut : cliquez sur l'un d'eux pour le suivre.En coursChaque crawl, son rythme, les emplacements utilisés et la mémoire libre.
Jusqu'à 4 à la foisLancez un crawl, puis un autre : jusqu'à 4 sites sont crawlés en même temps. Réglages › Crawl › Crawls simultanés, 2 par défaut ; le suivant attend son tour dans la file.
Chacun à son rythmeChaque crawl garde sa propre vitesse, sa limite d'URL et ses réglages, si bien qu'un site client lent ne freine jamais les autres.
Un garde-fou mémoireChaque crawl réserve la mémoire dont il a besoin, davantage avec le rendu JavaScript. Quand l'ordinateur manque de mémoire, le crawl suivant attend et indique pourquoi.
Une seule fenêtre pour tousPassez d'un crawl en cours à l'autre en haut de l'écran en direct. En cours les affiche tous, chacun avec Pause, Arrêter et Ouvrir.
Screaming Frog : un crawl par instance de l'application, soit une fenêtre, et sa mémoire, pour chaque site. source Sitebulb : l'application de bureau exécute les audits l'un après l'autre ; en simultané uniquement sur les forfaits Medium et Enterprise de Sitebulb Cloud. source
Un aperçu de l'intérieur
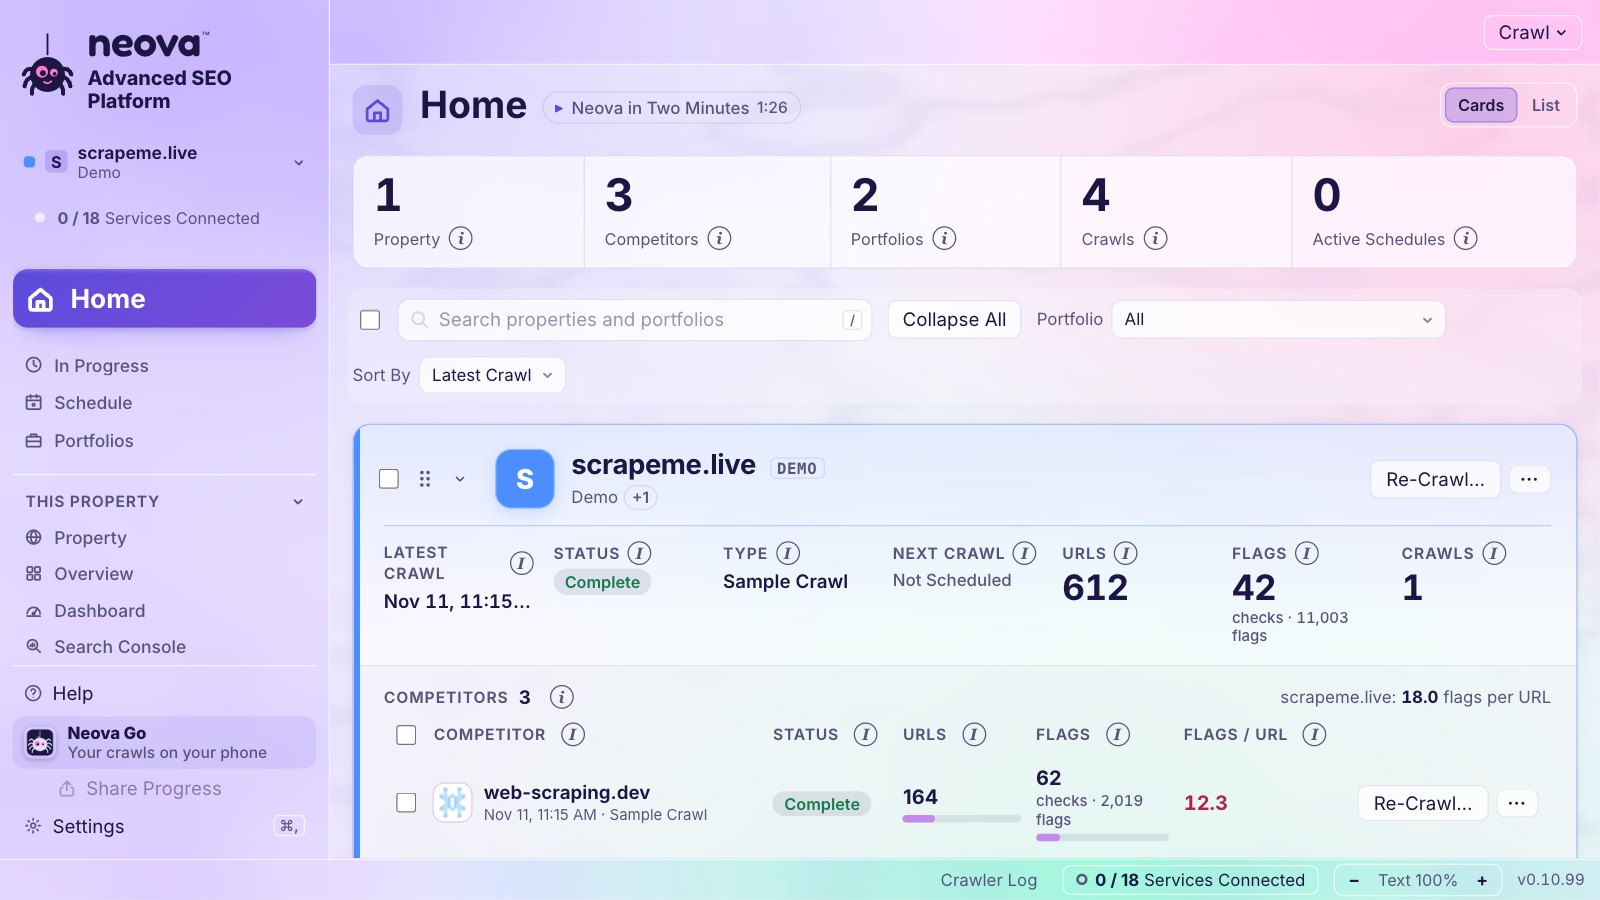
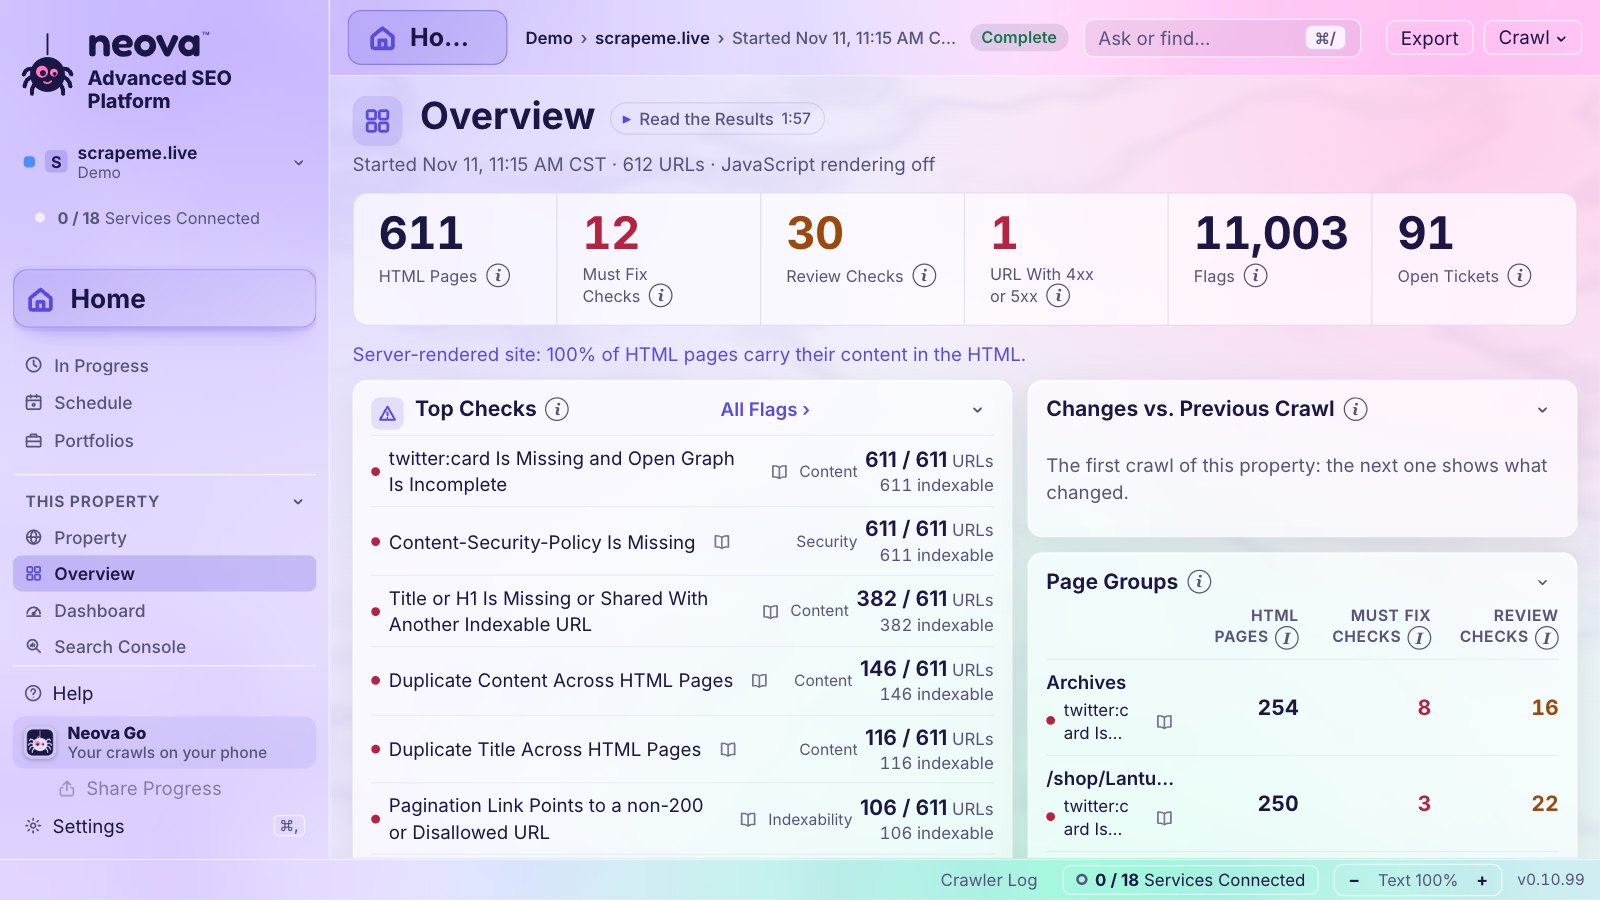
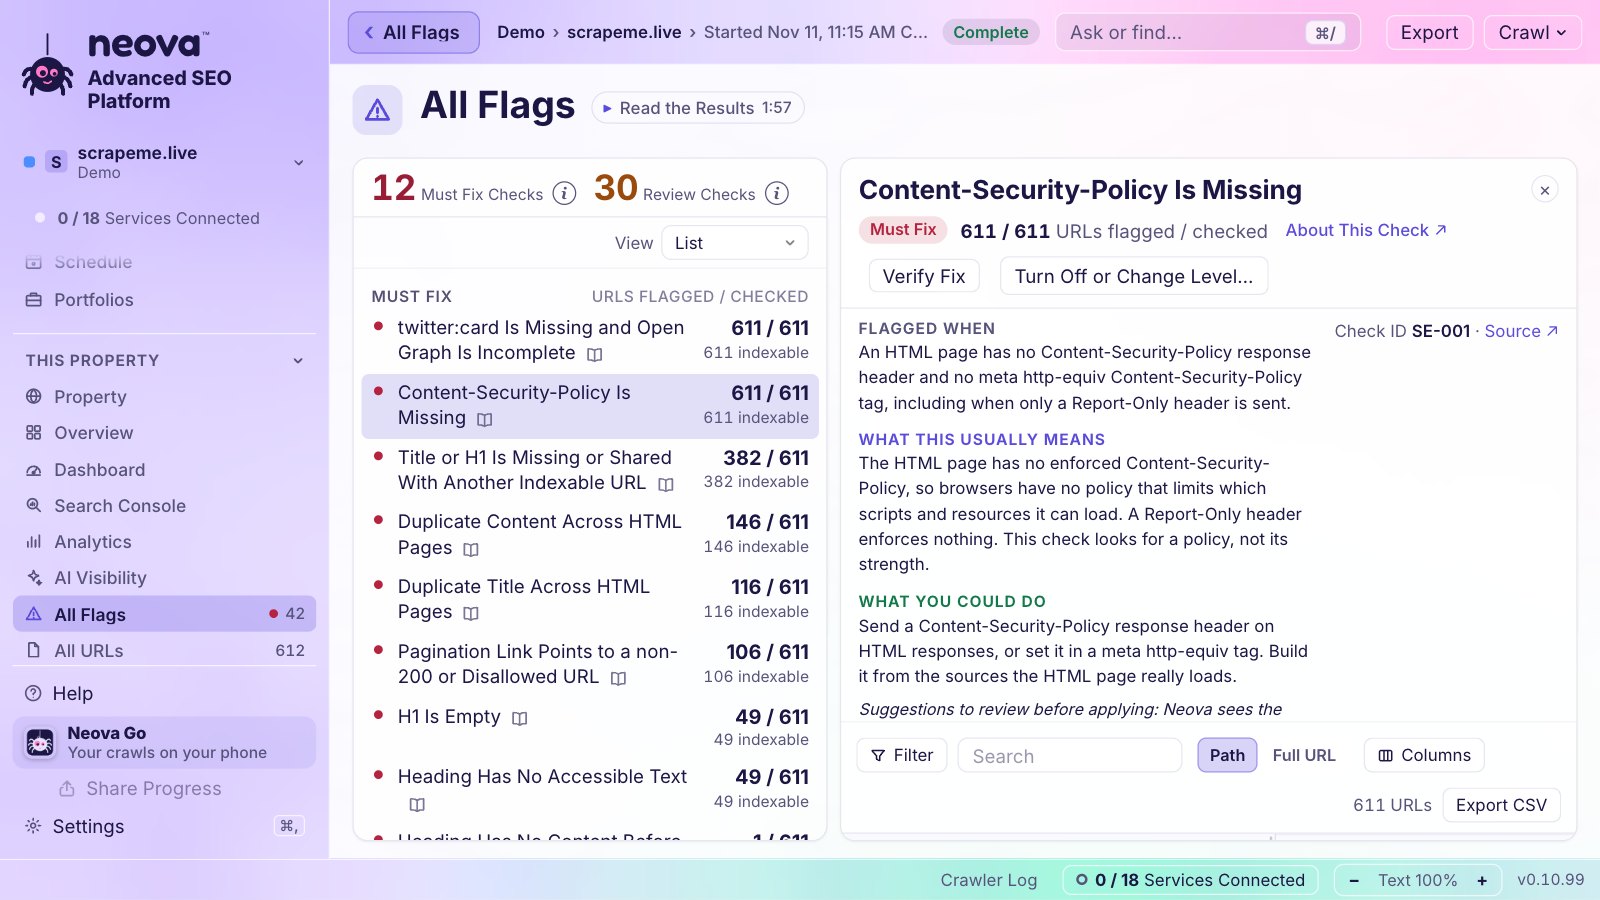
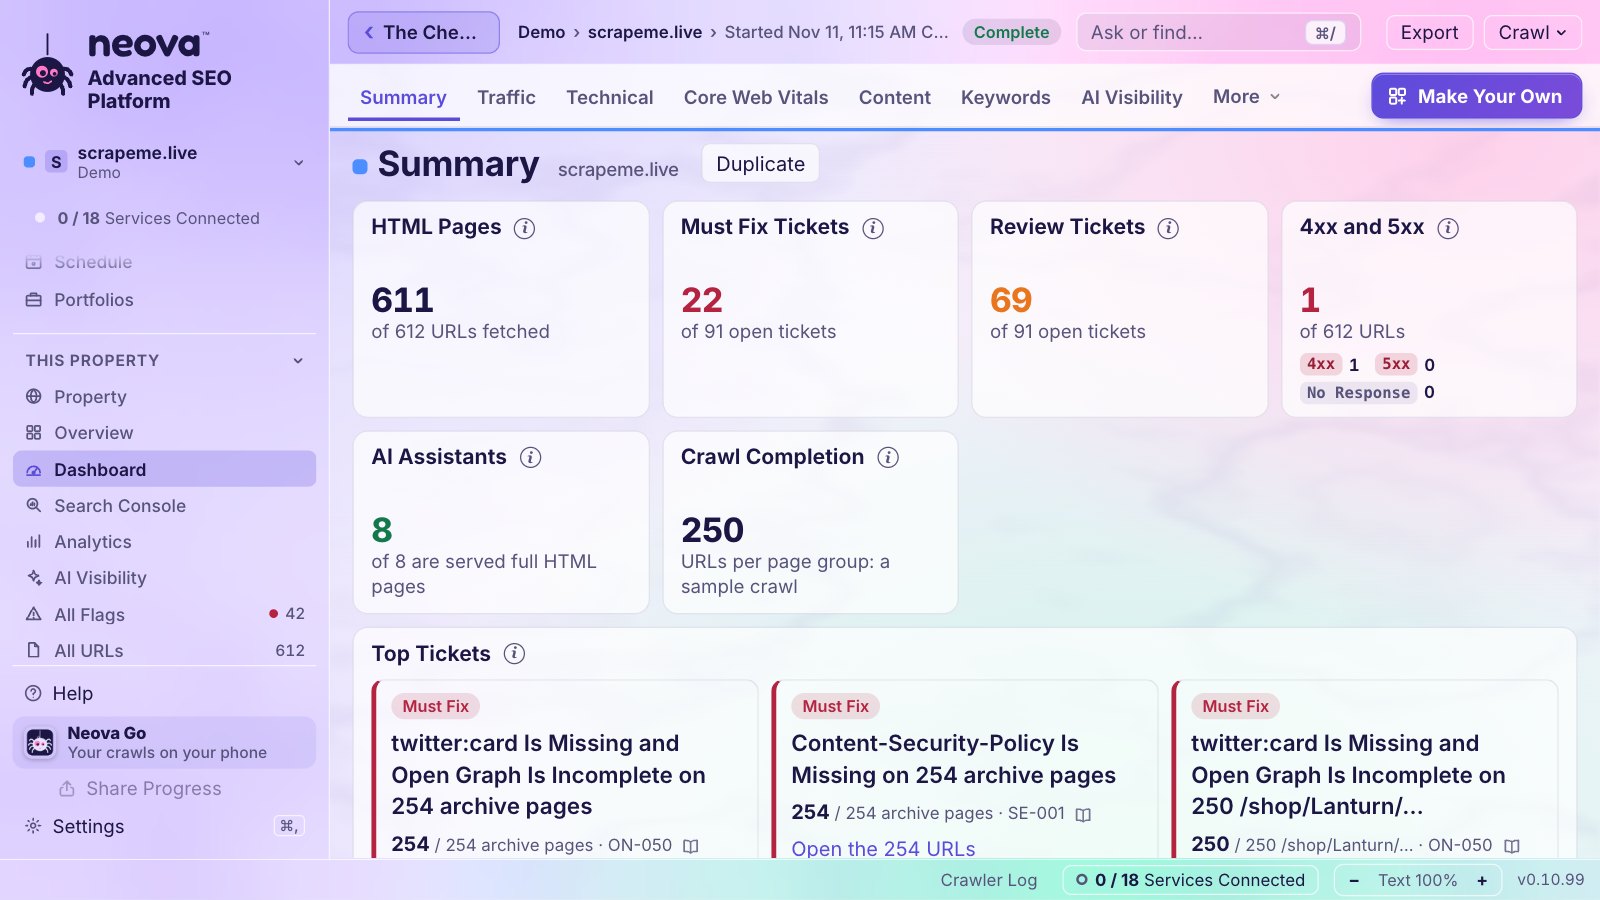
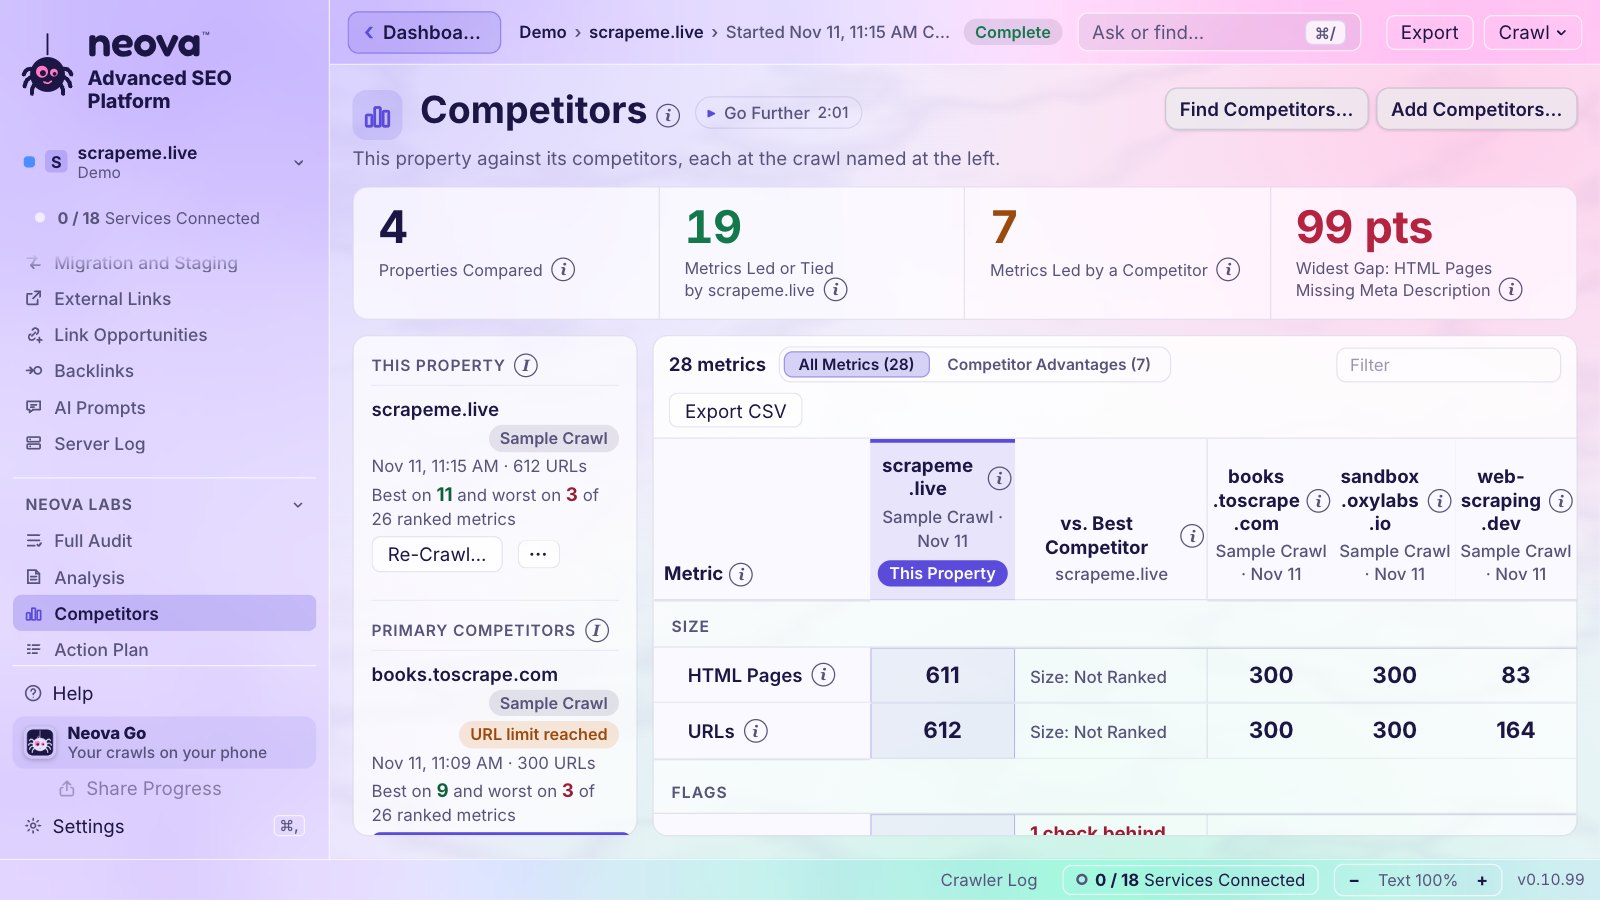
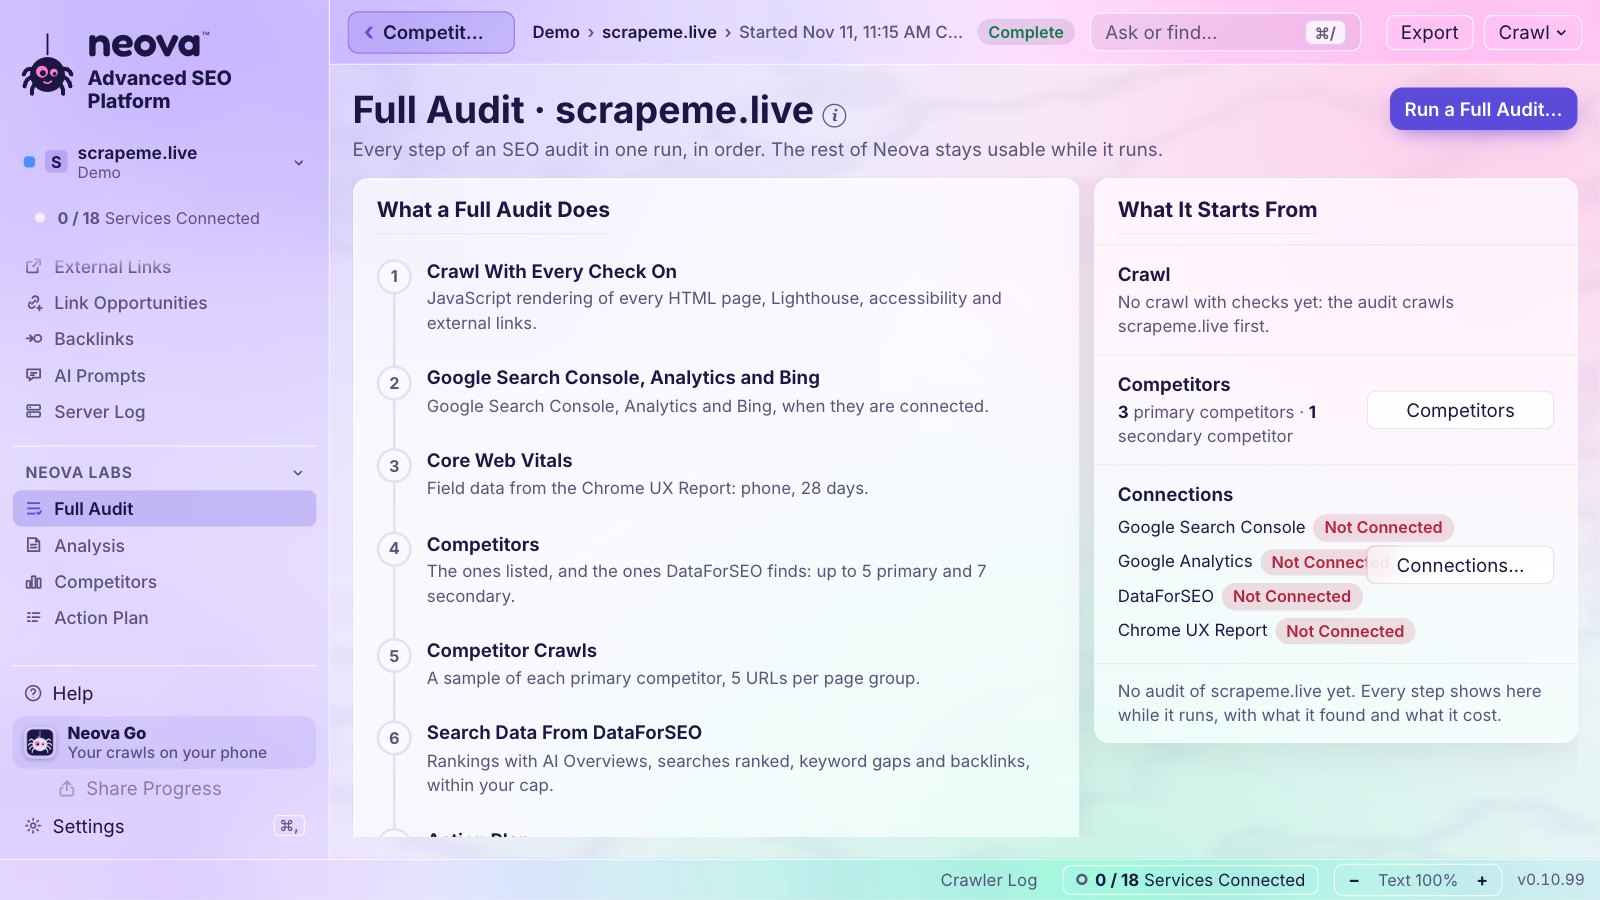
Neova sur la boutique de démonstration avec laquelle démarre chaque compte Neova Online. Cliquez sur un écran pour le voir en taille réelle.
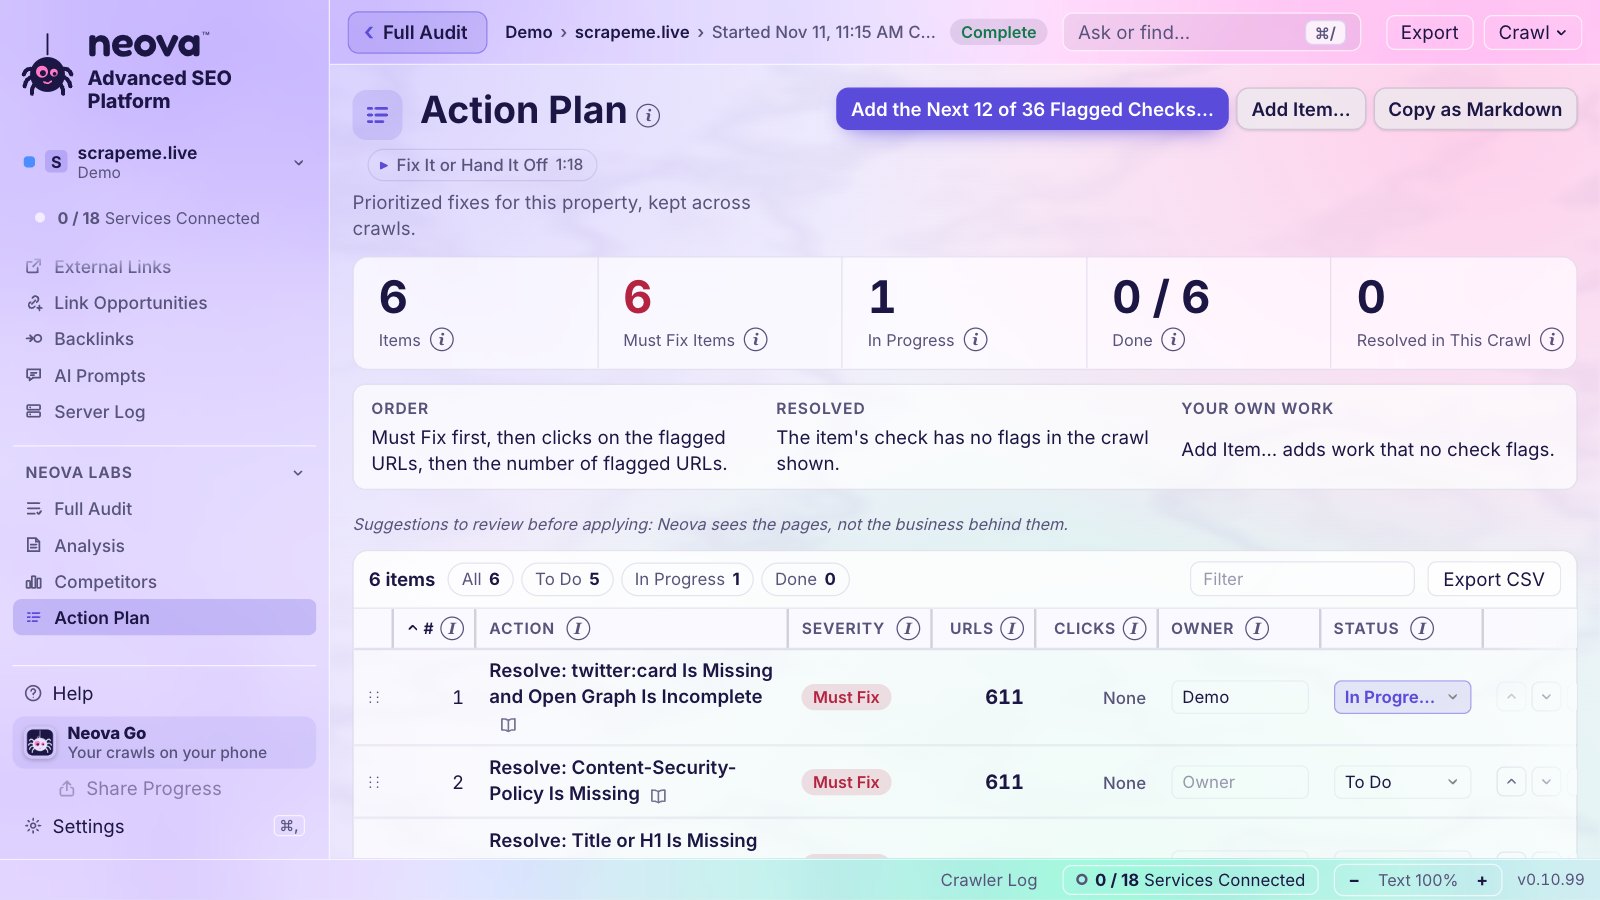
AccueilChaque propriété avec ses concurrents, ses URL et ses flags par URL.Le crawl en directLes étapes, la carte du crawl, les temps de réponse et chaque URL à mesure qu'elle arrive.Vue d'ensembleLe site d'un coup d'œil : principaux checks, changements, groupes de pages.Tous les flagsChaque flag avec sa raison, son correctif, sa source et ses pages.Le tableau de bord13 onglets, 39 blocs, et vos propres tableaux de bord.ConcurrentsVotre site face aux leurs, métrique par métrique, en couleur selon qui mène.Audit completCrawl, données de recherche, concurrents, plan et rapport en une seule passe.Plan d'actionChaque correctif avec un responsable et un statut, envoyé dans Jira si vous le souhaitez.
Seulement dans Neova
Vérifié dans leur documentation
Ce que fait Neova et qu'aucun de Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar et JetOctopus ne fait, d'après leur propre documentation, lue le 11 novembre 2026. Chaque carte dit ce que c'est en termes simples, et pourquoi c'est important.
Partagez un crawl en direct avec n'importe qui
Partager la progression vous donne un lien vers le crawl en cours. N'importe qui l'ouvre sur un téléphone ou un ordinateur, sans compte, et le suit en direct : la progression, la répartition des URL, la carte du crawl, les temps de réponse, les redirections et les erreurs, et un avis quand il se termine.
Détails
Votre client ou votre patron suit le crawl sans se connecter à quoi que ce soit, et ne voit que ce crawl. Arrêter le partage y met fin immédiatement.
Screaming Frog : une vue d'ensemble du crawl dans Looker Studio, alimentée par une Google Sheet mise à jour « à chaque exécution du crawl planifié », peut être envoyée par e-mail à « toutes les parties prenantes ». source Sitebulb : les tableaux de bord Data Studio de Cloud s'ouvrent « sans compte Sitebulb » et se mettent à jour « à chaque crawl » source Semrush : les lecteurs invités « doivent quand même créer un compte » source Ahrefs : les clients reçoivent les résultats « via des exports, des rapports planifiés ou des tableaux de bord Data Studio en direct » source Lumar : « les liens publics permettent à n'importe qui de voir les crawls et les rapports », expiration « de 24 heures à 6 mois » source JetOctopus : aucun lien public trouvé source
Partagez chaque crawl, verrouillé par votre clé
Publiez un lien de partage et Neova chiffre les crawls du site sur votre ordinateur avant qu'ils ne le quittent. La clé n'existe que dans le lien, si bien que même notre serveur ne peut pas les lire. Arrêtez le partage, et le lien n'ouvre plus rien.
Détails
Remettez à un client l'audit complet, chaque onglet et chaque tableau, en gardant le plein contrôle sur qui le voit et pendant combien de temps.
Screaming Frog : une vue d'ensemble du crawl dans Looker Studio, alimentée par une Google Sheet mise à jour « à chaque exécution du crawl planifié », peut être envoyée par e-mail à « toutes les parties prenantes ». source Sitebulb : les tableaux de bord Data Studio de Cloud s'ouvrent « sans compte Sitebulb » et se mettent à jour « à chaque crawl » source Semrush : les lecteurs invités « doivent quand même créer un compte » source Ahrefs : les clients reçoivent les résultats « via des exports, des rapports planifiés ou des tableaux de bord Data Studio en direct » source Lumar : « les liens publics permettent à n'importe qui de voir les crawls et les rapports », expiration « de 24 heures à 6 mois » source JetOctopus : aucun lien public trouvé source
Crawlez sur votre Mac, votre PC ou votre machine Linux, ouvrez les mêmes portfolios, réglages et crawls dans Neova Online depuis n'importe quel navigateur, et gardez un œil sur tout depuis votre téléphone. Un seul compte, toujours synchronisé.
Détails
Les crawlers de bureau restent sur un ordinateur, les crawlers cloud restent dans un navigateur. Neova va là où vous êtes, et vos crawls restent sur votre ordinateur sauf si vous en décidez autrement.
Screaming Frog : introuvable dans leur documentation. source Sitebulb : bureau plus Cloud dans le navigateur source Semrush : plateforme dans le navigateur plus une application iOS pour les positions uniquement source Ahrefs : navigateur uniquement ; Ahrefs dit que l'on peut consulter les résultats de crawl « de n'importe où, à tout moment » et « même depuis votre smartphone » (2024). source Lumar : introuvable dans leur documentation. source JetOctopus : introuvable dans leur documentation. source
Neova Go : vos sites dans votre poche
Sur votre téléphone, le dernier crawl de chaque propriété, les Core Web Vitals, les clics, les recherches suivies et la prochaine exécution, verrouillés par une clé qui ne quitte jamais votre ordinateur. Dans votre barre des menus, la progression du crawl à côté de l'horloge, et Reporter ou Passer pour le prochain crawl planifié.
Détails
Vous savez qu'un crawl est terminé ou qu'un template a ralenti sans ouvrir votre ordinateur portable.
Screaming Frog : introuvable dans leur documentation. source Sitebulb : introuvable dans leur documentation. source Semrush : une application iOS pour les positions uniquement source Ahrefs : aucune application mobile trouvée. L'application web cloud fonctionne sur téléphone source Lumar : introuvable dans leur documentation. source JetOctopus : introuvable dans leur documentation. source
Des tickets qui se ferment tout seuls
Les flags deviennent des tickets, un par check et par groupe de pages. Quand le crawl suivant constate que le problème est corrigé, le ticket se ferme ; s'il revient, il se rouvre. Envoyez-les dans Jira, et Jira suit.
Détails
Vos développeurs reçoivent un ticket clair au lieu de 4,000 URL, et personne ne relance des tickets corrigés il y a des semaines.
Screaming Frog : introuvable dans leur documentation. source Sitebulb : pas de Jira natif. Le Dev Handoff Skill, exécuté via un assistant IA, écrit les tickets « directement dans Jira, Linear, Asana, Monday ou ClickUp ». source Semrush : Site Audit peut « envoyer des tâches vers un tableau Trello » source Ahrefs : aucune fonctionnalité Jira ni ticket trouvée. source Lumar : les tâches sont créées à la main depuis les rapports et déplacées en « glissant-déposant les tâches dans différentes colonnes de statut » source JetOctopus : introuvable dans leur documentation. source
Chaque check cite sa source
Chaque check indique sur quelle page de Google, du W3C, de web.dev ou d'une autre source officielle il repose, avec le lien, et ce qu'il faut faire.
Détails
Quand un développeur demande pourquoi, vous envoyez la source, pas votre avis.
Screaming Frog : les 8 guides d'issues consultés se terminent tous par « Further Reading » avec des liens vers Google ou web.dev, mais comme lecture, pas comme fondement de la règle source Sitebulb : beaucoup de Hints se terminent par « Further Reading » (Google, MDN, documentation Lighthouse, mais aussi des blogs), mais « Canonical points to a redirecting URL » ne cite aucune source. source Semrush : certains correctifs renvoient vers Google (« please see this Google article ») source Ahrefs : certaines pages d'aide renvoient vers Google (« This guide from Google will tell you everything »), tandis que des pages d'issues comme « Hreflang to broken page » ne citent aucune source externe. source Lumar : introuvable dans leur documentation. source JetOctopus : introuvable dans leur documentation. source
Bing Webmaster Tools, y compris les citations dans l'IA de Bing
Neova lit les propres données de Bing sur votre site, y compris la fréquence à laquelle les réponses IA de Bing citent vos pages.
Détails
Bing alimente ChatGPT search et Copilot. Ses données montrent votre visibilité dans la recherche IA.
Screaming Frog : Bingbot n'est qu'un user agent prédéfini source Sitebulb : Bing n'est qu'un user agent prédéfini source Semrush : suivi des positions Bing uniquement source Ahrefs : Site Audit envoie les changements via IndexNow (« pris en charge par Bing, Yep et d'autres moteurs de recherche ») source Lumar : pas de Bing Webmaster Tools source JetOctopus : Bingbot dans les logs et le testeur de robots.txt (« données complètes sur Googlebot, Bingbot, GPTBot, ClaudeBot et plus de 40 autres crawlers ») source
Ouvrez vos crawls Screaming Frog et Sitebulb
Vous avez déjà crawlé le site avec Screaming Frog ou Sitebulb ? Ouvrez ce crawl dans Neova, et ses pages sont évaluées par rapport au site en ligne avec les checks de Neova.
Détails
Gardez les outils que vous connaissez, et ajoutez Neova là où il aide, sans crawler deux fois.
Screaming Frog : le mode liste lit des URL depuis n'importe quel fichier .txt, .xls, .xlsx, .csv ou .xml (« vous pouvez importer directement un téléchargement Adwords ») source Sitebulb : importe des listes d'URL (.csv ou .txt) source Semrush : Backlink Audit importe des fichiers de backlinks (CSV, « jusqu'à 50 Mo ») source Ahrefs : introuvable dans leur documentation. source Lumar : importe des exports CSV comme sources de crawl (Majestic, Ahrefs, Open Site Explorer, Screaming Frog Log File Analyser, Splunk, Logz.io source JetOctopus : import générique uniquement : « Pour l'import, vous pouvez utiliser un fichier au format CSV ou TXT », joint par la clé URL source
Intégré, pas vendu à part
Les autres les ont aussi, souvent en option payante ou comme produit séparé avec son propre prix. Dans Neova, ils font partie de l'application. Quand des données externes sont nécessaires, comme DataForSEO ou Google, vous utilisez votre propre compte à son propre prix, sans rien en plus. Ouvrez Ce que font les autres pour chacun, avec la page de leur documentation.
Voyez si ChatGPT et Perplexity vous mentionnent
Neova pose vos propres questions à ChatGPT et Perplexity, comme le ferait un client, et vous dit si votre marque apparaît dans la réponse.
Ce que font les autres
De plus en plus de gens interrogent les assistants IA avant de chercher. C'est ainsi que vous savez si vous y existez.
Screaming Frog : introuvable dans leur documentation. source Sitebulb : introuvable dans leur documentation. source Semrush : oui, dans l'AI Visibility Toolkit (99 $/mois) source Ahrefs : prompts personnalisés Brand Radar sur ChatGPT, Perplexity, Gemini, Copilot, AI Overviews source Lumar : dans AI Visibility (activé par compte) source JetOctopus : « JetOctopus ne suit pas les citations, les mentions de marque ni le sentiment dans les réponses IA » source
Ce que les assistants IA reçoivent vraiment
Neova récupère vos pages en tant que 10 crawlers IA (ChatGPT, Claude, Perplexity et d'autres), vérifie votre llms.txt et vos fichiers pour agents, et montre ce que chacun reçoit.
Ce que font les autres
Une page que vos visiteurs voient peut être bloquée ou vide pour un assistant IA. Désormais, vous pouvez le voir.
Screaming Frog : introuvable dans leur documentation. source Sitebulb : introuvable dans leur documentation. source Semrush : avertissements Site Audit « Llms.txt not found (AI Search) » et « Llms.txt file has formatting issues (AI Search) » source Ahrefs : seulement un générateur gratuit (« construire le fichier llms.txt parfait pour vous ») source Lumar : dans l'Agentic Readiness Scanner gratuit de Lumar, séparé de la plateforme de crawl source JetOctopus : introuvable dans leur documentation. source
Vos concurrents, trouvés et comparés
Neova trouve les sites qui sont en concurrence avec vous sur les mêmes recherches, crawle les plus proches, et place chaque métrique côte à côte, en couleur selon qui mène.
Ce que font les autres
Vous voyez où un concurrent vous devance, et de combien, sans tableur.
Screaming Frog : introuvable dans leur documentation. source Sitebulb : introuvable dans leur documentation. source Semrush : Position Tracking : « le rapport Competitors Discovery révèle les concurrents organiques positionnés sur vos mots-clés » source Ahrefs : les nouveaux projets « reçoivent des suggestions de concurrents d'après les sites positionnés sur des mots-clés similaires » source Lumar : dans AI Visibility : « les marques sont découvertes automatiquement à partir des réponses des fournisseurs d'IA » et Lumar classe chacune en Own, Competitor, Other ou Context. source JetOctopus : introuvable dans leur documentation. source
Logs serveur, même derrière Cloudflare
Neova lit vos logs Apache ou Nginx, ou directement ceux de Cloudflare, et ne compte que les bots vérifiés, pour que vous voyiez ce que Googlebot et les crawlers IA récupèrent vraiment.
Ce que font les autres
Les logs montrent ce que les moteurs de recherche font sur votre site, pas ce qu'un crawler suppose.
Screaming Frog : un produit séparé, le Screaming Frog Log File Analyser (Windows, macOS, Linux), pour « vérifier les bots des moteurs de recherche et de l'IA ». source Sitebulb : FAQ : « Sitebulb ne fait pas encore d'analyse de logs, mais c'est en cours de développement et ce sera bientôt disponible ! » source Semrush : oui, comme produit Enterprise séparé source Ahrefs : Bot Analytics, un outil séparé gratuit en bêta sur les forfaits payants, « ingère les données de requêtes HTTP » de Cloudflare, Vercel, CloudFront, des load balancers AWS ou de Fastly source Lumar : inclus, mais à partir de résumés par URL source JetOctopus : inclus dans chaque forfait, pas un produit séparé source
Core Web Vitals d'utilisateurs réels, avec une tendance
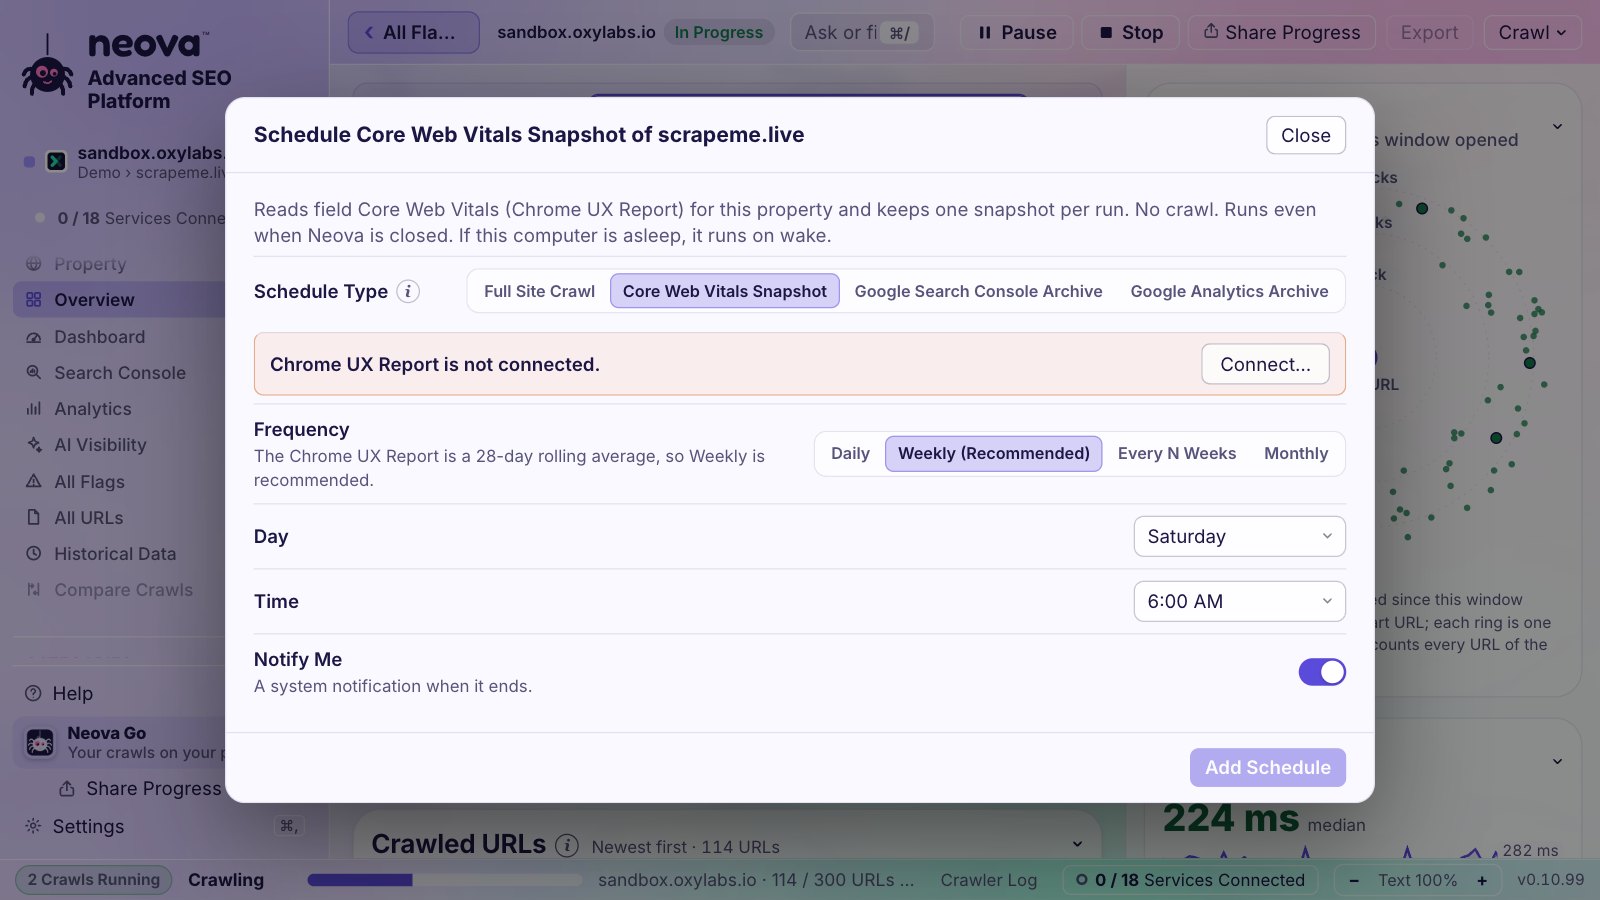
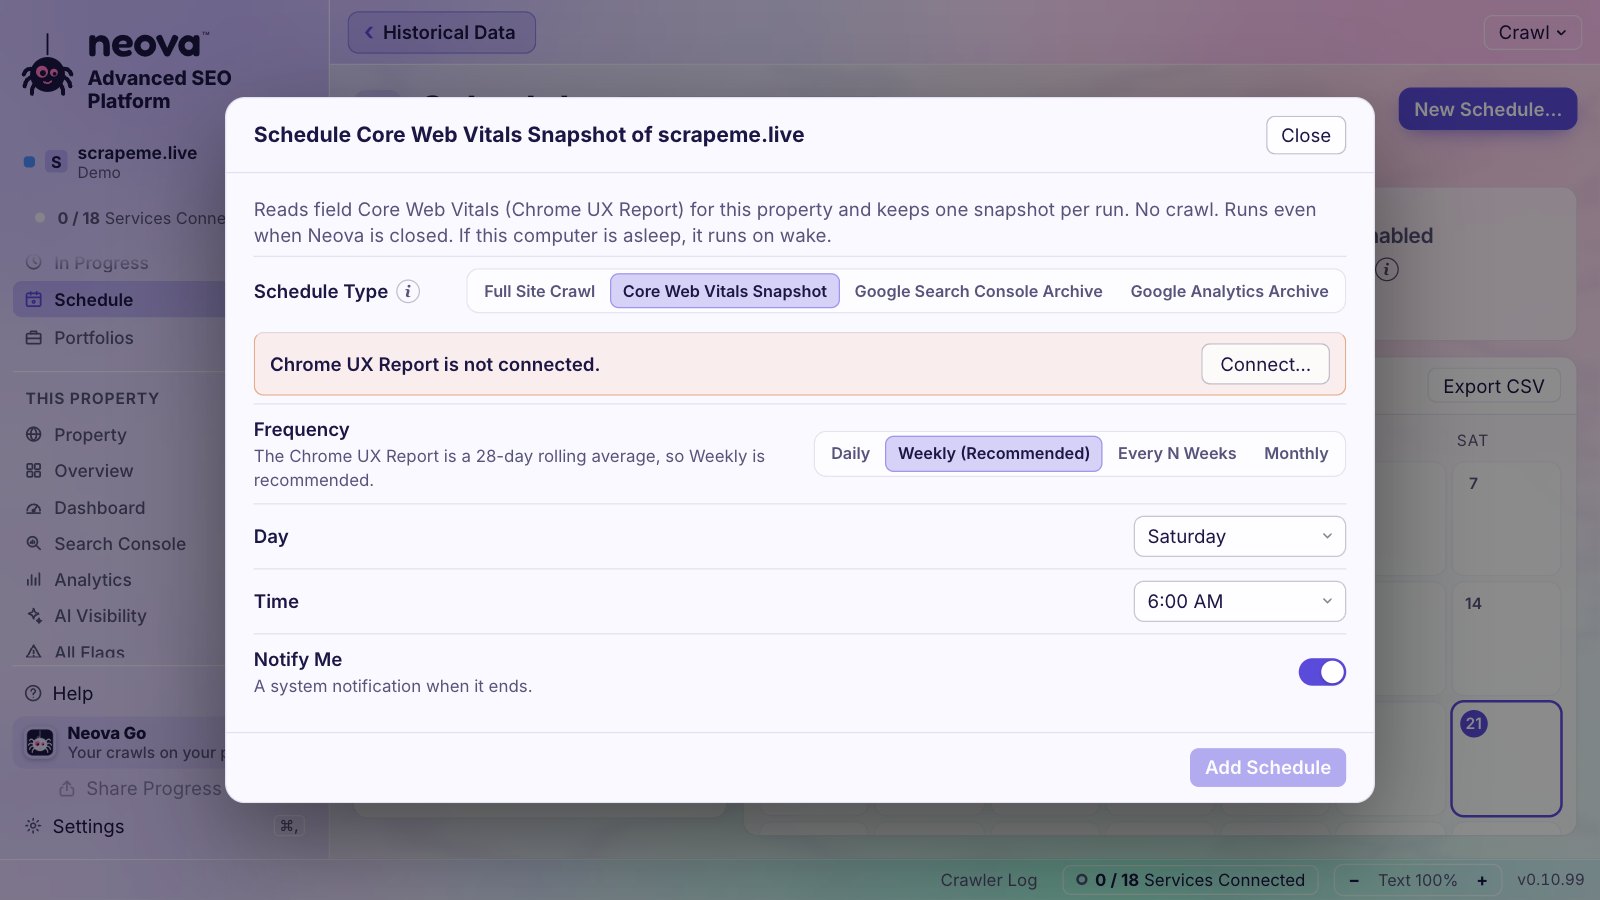
Avec votre clé Chrome UX Report gratuite, Neova lit ce que vivent les vrais utilisateurs de Chrome : une tendance sur 40 semaines dès le premier jour, une vue par groupe de pages, des instantanés planifiés et des alertes.
Ce que font les autres
Les tests en laboratoire disent à quelle vitesse une page pourrait être. Les données d'utilisateurs réels disent à quelle vitesse elle l'est pour vos visiteurs, et c'est ce que Google utilise.
Screaming Frog : aucun graphique de tendance CWV dans l'application trouvé. source Sitebulb : la Google Sheet « Historical Audit Data » contient une ligne par audit pour des « séries temporelles ou graphiques » dans Looker Studio, et inclut les valeurs par tranche des Core Web Vitals (changelog, 13 source Semrush : données de laboratoire (Lighthouse) source Ahrefs : rapport Performance de Site Audit source Lumar : dans Site Speed : « un graphique de tendance pour chacun des KPI » (FCP, LCP, TBT, CLS), réparti en Slow, Moderate, Fast, un point par crawl (données de laboratoire) source JetOctopus : checks CWV planifiés (« +Create a CWV schedule ») source
Jira sans la corvée
Chaque ticket part dans Jira avec ses pages, son check et son correctif, et Neova garde les deux synchronisés après chaque crawl.
Ce que font les autres
Votre équipe travaille là où elle travaille déjà.
Screaming Frog : introuvable dans leur documentation. source Sitebulb : pas d'intégration Jira native source Semrush : « Send to Trello » natif uniquement source Ahrefs : aucune intégration Jira trouvée. source Lumar : intégration Jira Cloud source JetOctopus : introuvable dans leur documentation. source
Le tableau de bord
Ouvrez une propriété, puis Tableau de bord : tout ce que Neova sait du site, sur un seul écran, et autant de vues personnelles que nécessaire.
Votre site sur un seul écranHuit groupes, 13 onglets, 39 blocs. Chaque chiffre montre son évolution depuis le crawl précédent.
La vitesse, sur 40 semainesLes Core Web Vitals des vrais utilisateurs de Chrome dès le premier jour, avec les seuils bon et mauvais de Google, par groupe de pages aussi.
Clics et recherchesClics et impressions par jour comparés aux 28 jours précédents, et 25 recherches suivies avec leurs positions.
Les mises à jour de Google sur vos clicsDeux ans de mises à jour de classement tracées sur votre trafic, avec l'avant et l'après de chacune.
Recherche IAQuels assistants IA passent, ce que chacun reçoit, les AI Overviews et les bots vérifiés.
Le contenu d'un coup d'œilLongueurs des balises title, des meta descriptions et des H1, groupes de pages, et vos pages les plus liées.
Le programmeLe plan d'action par statut et par responsable ; un correctif marqué Terminé mais encore flagué passe au rouge.
Créez le vôtreJusqu'à 10 tableaux de bord : partez de zéro ou copiez un onglet, puis ajoutez, déplacez, redimensionnez et supprimez des blocs.
Veille pour vous
Neova ne s'arrête pas au crawl. Il surveille vos sites entre les crawls et vous prévient quand quelque chose bouge, sur votre ordinateur, votre téléphone ou les canaux de votre équipe.
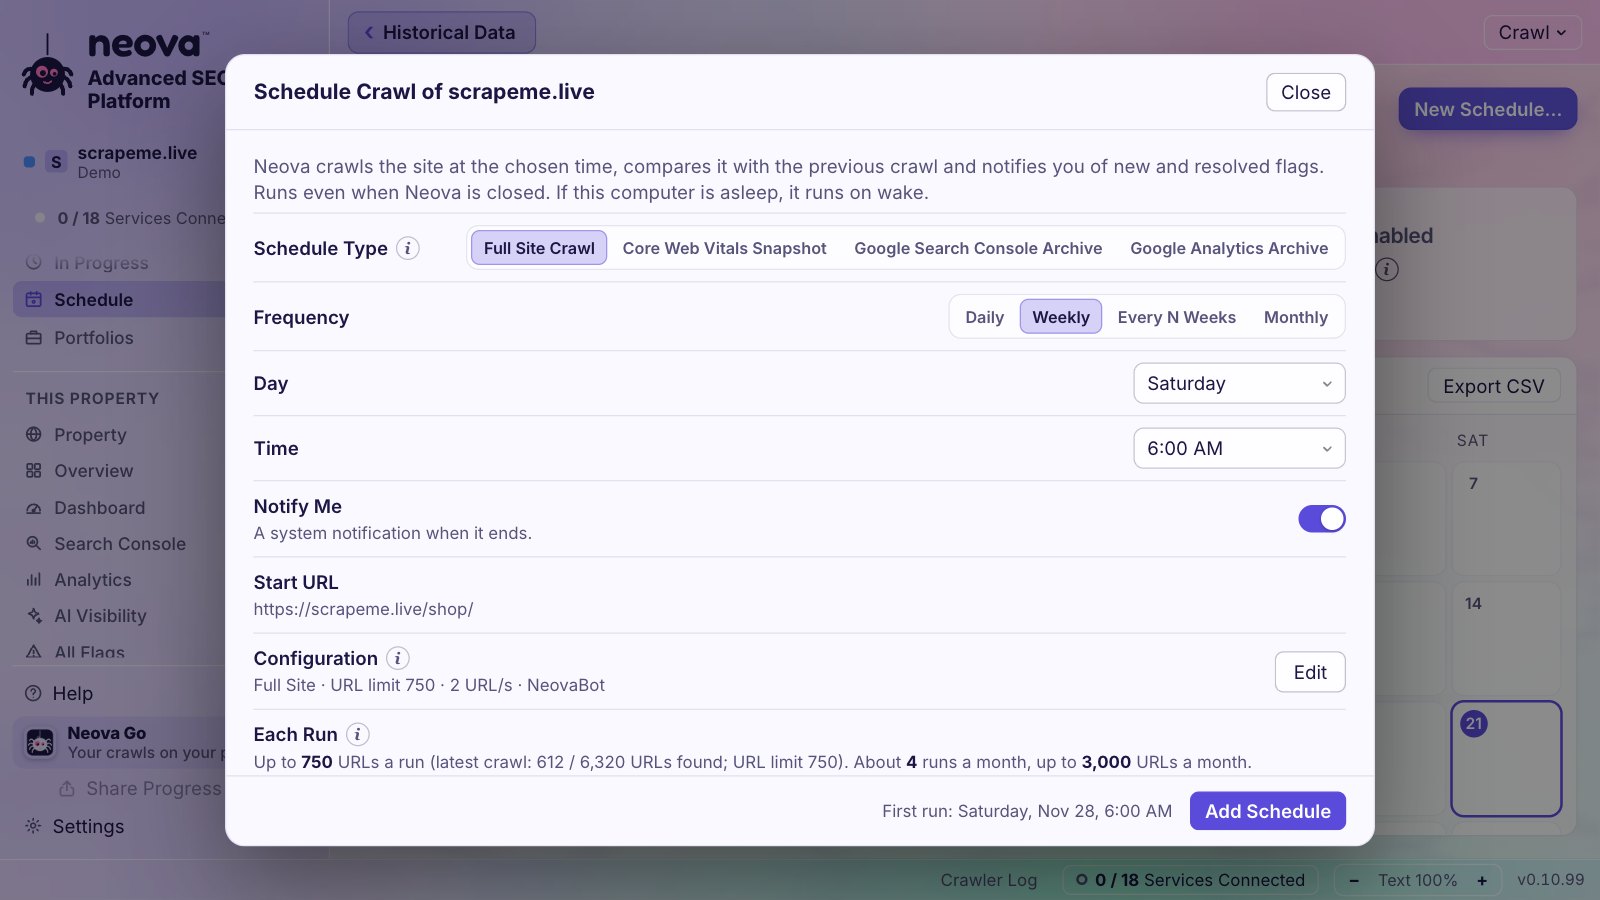
Une planificationÀ quelle fréquence, le jour et l'heure, et ce que coûte chaque exécution.Neova GoLa barre des menus, les alertes et votre téléphone.Instantanés Core Web VitalsLa vitesse vécue par les utilisateurs réels, selon son propre calendrier, sans crawl.
Des crawls planifiésChaque jour, chaque semaine, toutes les quelques semaines ou chaque mois, par propriété, fenêtre fermée. Un rappel 15 minutes avant, Reporter ou Passer depuis la barre des menus, et le coût d'une planification affiché avant de l'ajouter.
Des alertes qui comptentLes Core Web Vitals changent de note, les clics baissent de 20 % ou plus en une semaine, une recherche suivie entre dans le top 10 ou en sort, ou perd 3 places, un nouveau crawl a de nouveaux flags. Vérifié après chaque exécution planifiée, ou quand vous cliquez sur Vérifier maintenant.
Crawl de surveillanceRevérifie uniquement vos pages clés, sans découverte, et vous alerte quand un code HTTP, une redirection, une balise title, une canonique, un noindex, un H1 ou la taille d'une page change.
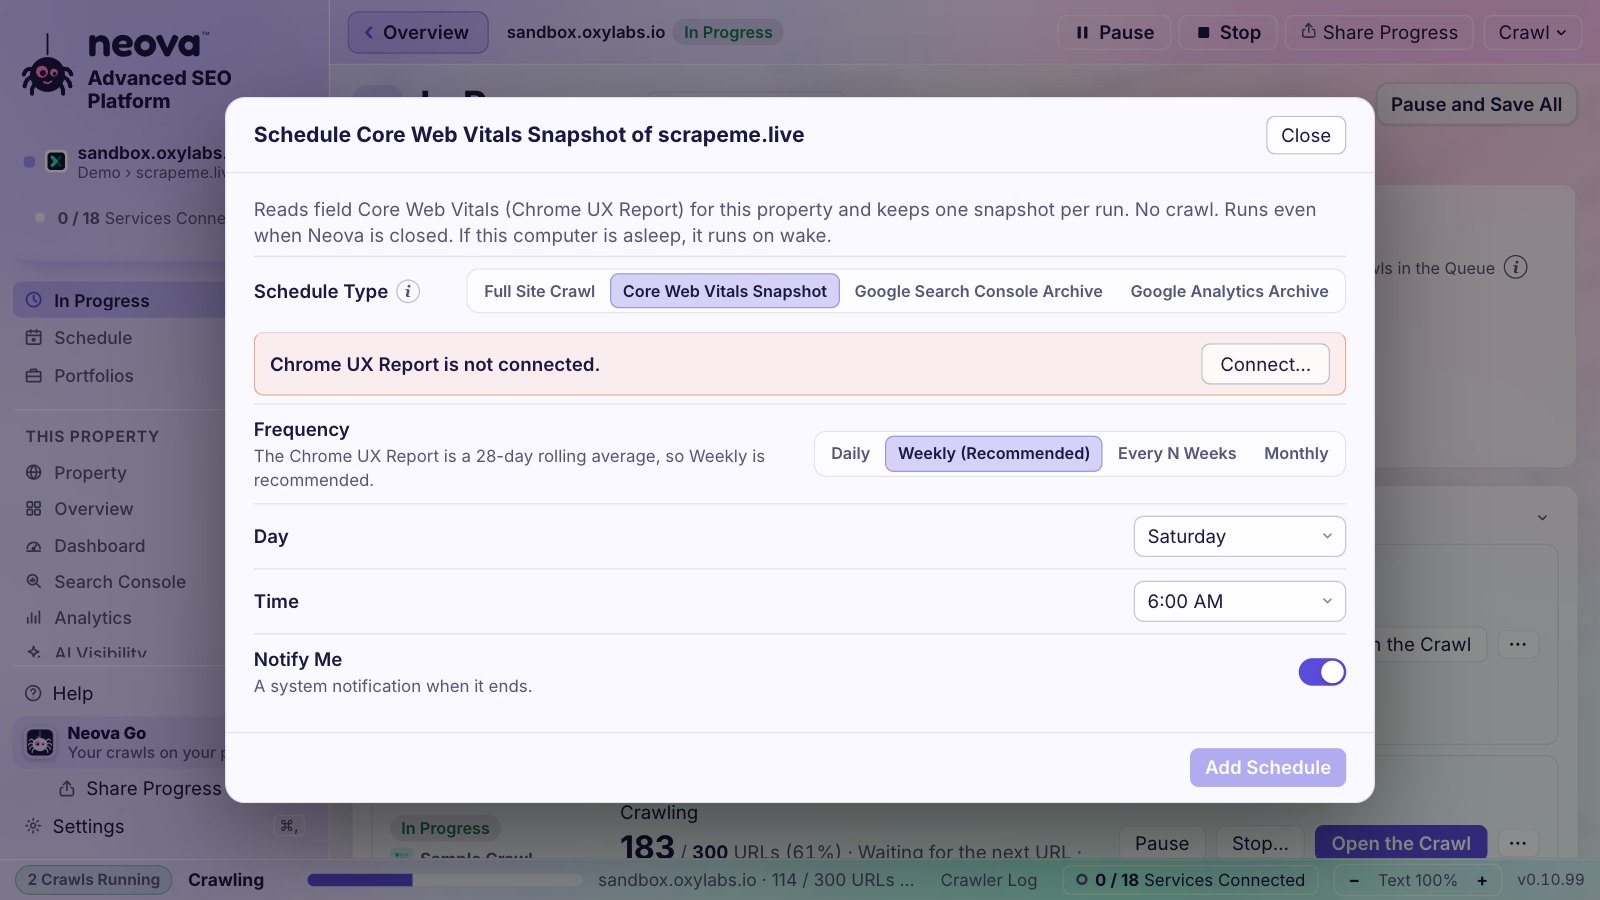
Instantanés Core Web VitalsLa vitesse vécue par les vrais utilisateurs de Chrome, selon un calendrier, sans crawl, pour alimenter une tendance que vous suivez semaine après semaine.
Recherches suivies, chaque jourJusqu'à 25 recherches par propriété depuis Search Console : la position sur 7 et 90 jours, les clics et impressions, et si Google affiche un AI Overview qui vous cite.
Les mises à jour de Google sur vos clicsDeux ans de mises à jour de classement et d'incidents Google tracés sur vos clics par jour, avec vos clics avant et après chacun.
Un audit complet chaque moisL'audit complet, avec les concurrents, répété chaque mois ; Neova termine l'analyse et le PDF à sa prochaine ouverture.
Des alertes là où vous êtesNeova Go dans la barre des menus et sur votre téléphone, une notification à la fin d'un crawl, et Slack et Microsoft Teams, chaque portfolio ou propriété envoyant vers ses propres canaux.
Aussi dans Neova
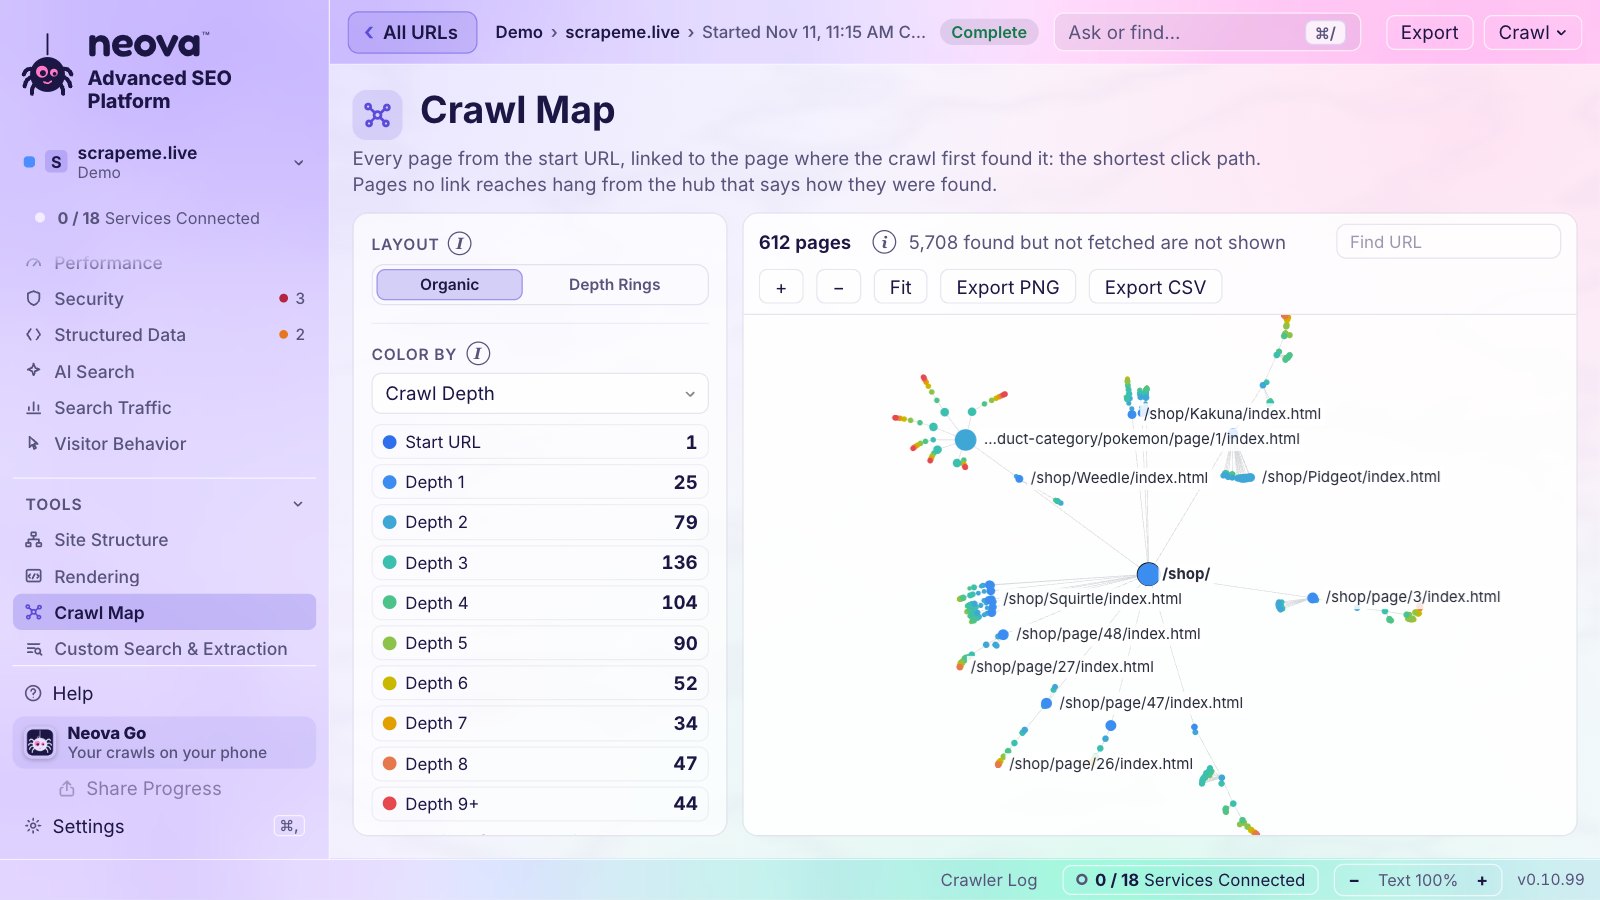
Carte du crawlComment chaque page a été trouvée la première fois, en couleur selon son statut.Toutes les URLChaque URL avec son code HTTP, son indexabilité et sa taille.HistoriqueVos crawls et vos données Search Console, conservés après que Google les a supprimés.
Log du crawlerChaque URL que le crawl récupère, en direct, avec son code HTTP en couleur et son temps de réponse ; les étapes en gras, les échecs en rouge. Copiez-le pour le support en un clic.
Crawl bloqué : l'explicationQuand un site refuse le crawl, Neova dit pourquoi (limite de débit, pare-feu, blocage par pays) et quoi faire, avec un en-tête secret de liste blanche à transmettre à l'équipe informatique.
Diagnostiquer un crawlLit le log d'un crawl et nomme ce qui n'a pas marché, 429, 403, blocages par le robots.txt, pages uniquement en JavaScript, avec le réglage à modifier.
Répartition des URLChaque URL trouvée va dans une seule catégorie, pour que vous sachiez toujours d'où viennent les milliers d'URL en trop, pendant que le crawl tourne.
Un crawl en direct que vous pouvez suivreDes étapes fléchées, les dernières URL, une carte du crawl en direct et le graphique des temps de réponse, et Partager la progression pour que n'importe qui puisse le suivre.
Search Console et Analytics, conservés pour de bonGoogle supprime les données Search Console au bout de 16 mois et les données d'événements Analytics au bout de 2 ou 14. Neova archive chaque mois des deux sur votre ordinateur, selon un calendrier : pages, requêtes, jours et Discover depuis Search Console ; jours, pages d'atterrissage organiques, canaux, sources et pays depuis Analytics. Aussi longtemps que vous le voulez.
Sachez avant de commencerLit d'abord quelques pages et indique combien d'URL les sitemaps listent et combien d'images prévoir, pour que vous choisissiez la taille du crawl.
Un crawl que vous ne perdez jamaisLes pages d'abord, un garde-fou disque, Quitter enregistre le crawl, les mises à jour l'attendent, et Reprendre continue avec ses propres réglages.
Les coûts affichés d'abordLes coûts DataForSEO sont estimés avant toute dépense, avec un plafond par crawl. Vos factures de données vous sont adressées directement, au prix du fournisseur.
Essayez-le avec de vraies donnéesChaque compte Neova Online démarre avec une démo : une boutique et trois concurrents, déjà crawlés, tous les réglages remplis.
Vos clés restent les vôtresChaque clé, jeton et identifiant va dans le trousseau de votre système, jamais dans un fichier ni à l'écran. Neova n'embarque aucune clé API à lui : ce que vous payez vous est facturé directement.
En 15 languesLa fenêtre et la bibliothèque des checks en anglais, français, allemand, espagnol, portugais, italien, japonais, néerlandais, polonais, turc, coréen, chinois, russe, indonésien et vietnamien.
Compatible avec
31 services
Neova se connecte à 31 services que vous utilisez déjà, de Google Search Console à Slack, Jira et votre propre stockage cloud. Chacun est facultatif.
Google
Google Search Console
Google Analytics
Chrome UX Report
Google Cloud
Gemini
Microsoft et Bing
Bing Webmaster Tools
OneDrive
Microsoft Teams
Données SEO
DataForSEO
Semrush
Ahrefs
Majestic
Moz
SEO Gets
IA
Anthropic
OpenAI
Ollama
Tickets
Jira
Linear
Asana
ClickUp
monday.com
Alertes et logs
Slack
Microsoft Teams
Cloudflare
Fichiers et stockage
Google Drive
Dropbox
iCloud Drive
Proton Drive
kDrive
OneDrive
Ouvre leurs crawls
Screaming Frog
Sitebulb
Les logos appartiennent à leurs propriétaires et indiquent seulement que Neova se connecte à ces services. Neova n'est affilié à aucun d'eux.
Côte à côte
78 fonctionnalités
Chaque fonctionnalité, une marque par outil. Afficher les détails ajoute ce que fait chacune, avec la page de la documentation de l'outil dont elle provient.
Où et comment il crawleScreaming Frog 15Sitebulb 13Semrush 10Ahrefs 10Lumar 13JetOctopus 13Neova 17sur 17
Fonctionnalité
Screaming Frog
Sitebulb
Semrush
Ahrefs
Lumar
JetOctopus
Neova
Application de bureau
✓« Un OS 64 bits est nécessaire pour exécuter le SEO Spider. » source
✓Windows et macOS uniquement (« version 64 bits de Windows 10 ou 11 ») source
–Application web uniquement, rien à installer source
–SaaS uniquement dans le cloud, pas d'application de bureau source
–SaaS cloud uniquement, pas d'application de bureau source
✓Mac (Apple silicon), Windows et Linux
Dans le navigateur
◐Sur votre serveuraucune version navigateur ni hébergée. source
✓Sitebulb CloudSitebulb Cloud : « Sitebulb Cloud vous offre toutes les capacités de Desktop, accessibles depuis votre navigateur web. » Chaque client reçoit un serveur du type yoursite.sitebulb.cloud. source
✓Application webEntièrement dans le navigateur : Semrush se décrit comme « la plateforme SaaS leader de la gestion de la visibilité en ligne ». source
✓Application webAhrefs est uniquement dans le cloud source
✓Application webSaaS dans le navigateur : « Nous donnons accès à l'Application via un navigateur web compatible, sous forme de logiciel en tant que service (SaaS) » source
✓Application webPlateforme cloud dans le navigateur source
✓Neova OnlineNeova Online dans n'importe quel navigateur, sur le même compte que l'application de bureau, toujours synchronisé
Rendu JavaScript
✓« Faites le rendu des pages web avec le WRS Chromium intégré pour crawler les sites et frameworks dynamiques riches en JavaScript, comme Angular, React et Vue.js. » Licence payante uniquement. source
✓Chrome Crawler : « Sitebulb utilise un moteur de rendu Chromium Evergreen, tout comme Google » source
✓Oui, sur les formules Guru ou Business (Semrush One Pro+ ou Advanced) source
✓« Le mode de crawl avec rendu JavaScript est inclus dans le prix du forfait (sans frais séparés) », mais « une page rendue en JS compte pour deux pages crawlées normales ». source
✓Chrome, pour chaque page ou un nombre de pages donné
Mode liste
✓« Mode > List » : « vérifier une liste prédéfinie d'URL... » source
✓Règles « Allow subfolders » et « Disallow subfolders », plus « Parameters to ignore » pour que Site Audit retire les paramètres d'URL pendant le crawl. source
✓Règles regex : « Only crawl URLs matching the pattern » et « Don't crawl URLs matching the pattern », plus « Remove URL parameters » et des règles de réécriture d'URL. source
✓Champs « Included Only URLs » et « Excluded URLs » (regex Ruby) source
✓Règles « Allow Pattern » et « Deny Pattern » dans les réglages avancés, sous forme de chemins d'URL ou de regex avec le préfixe « rx: » source
✓Inclusion, exclusion, et une liste d'exclusion pour chaque crawl
Limites de vitesse de crawl
✓« contrôler la vitesse du SEO Spider, soit par le nombre de threads simultanés, soit par le nombre d'URL demandées par seconde » (5 threads par défaut). source
✓Nombre de threads ou d'instances Chrome et « Max HTML URLs per Second » source
✓La vitesse par défaut est « limitée à 30 URL maximum par minute » source
✓Vitesse de crawl en URL par seconde (maximum du compte fixé par Lumar), et vous pouvez « ajouter des restrictions pour réduire ou augmenter la vitesse des crawls à certains moments ». source
✓« Vous choisissez la vitesse (nombre de threads) » source
✓Requêtes par seconde, et il ralentit quand un site peine
Testeur de robots.txt
✓« configuration robots.txt personnalisée, qui permet de télécharger, modifier et tester le robots.txt d'un site » source
◐« Virtual robots.txt » permet de récupérer le fichier en ligne, de le modifier et de crawler avec votre version source
◐pas de testeur d'URL. Le rapport Robots.txt signale les problèmes du fichier et « toute modification de votre fichier robots.txt » source
✓robots.txt Overwrite pour « tester un nouveau robots.txt avant sa mise en ligne » sur un crawl complet source
✓Le Robots.txt Multi-tool gratuit « valide votre fichier robots.txt, met en évidence les directives contradictoires » et simule les règles par bot source
✓Testeur de robots.txt ; respecter, ignorer ou utiliser un brouillon
User agent personnalisé
✓« user agents prédéfinis intégrés pour Googlebot, Bingbot, divers navigateurs et plus encore », plus un user agent de requête HTTP personnalisé et un Robots User-Agent séparé. source
✓Préréglages « dont Google, Bing, Yahoo et Yandex », plus « Custom User Agent » et un UA personnalisé pour le robots.txt. source
◐préréglages uniquement, « Il y a 5 user agents au total » source
✓N'importe quel user agent, et Crawler en tant que crawler IA
Connexions et authentification
✓« deux formes d'authentification : basée sur les standards, qui comprend l'authentification basic et digest, et basée sur les formulaires web. » source
✓Authentification HTTP et par formulaire, plus des en-têtes HTTP personnalisés. source
◐authentification basic uniquement : « Crawl with my credentials » pour les sites « protégés par une authentification d'accès basic », plus une option de signature Web Bot Auth. source
◐Authentification HTTP uniquement, à partir de la formule Advanced source
◐authentification basic (« inclure les identifiants d'authentification dans toutes les requêtes via l'authentification basic »), DNS personnalisé, liste blanche d'IP et cookies de connexion via des en-têtes de requête personnalisés source
◐« Sous HTTP Auth, saisissez l'utilisateur (identifiant) » source
✓Authentification, en-têtes et formulaires
Pause et reprise
✓Pause et reprise dans l'application (« Vous pouvez reprendre le crawl s'il a été mis en pause ») source
✓« Sitebulb vous permet de mettre en pause puis de reprendre quand cela vous arrange » source
✓Quand les limites de crawl sont atteintes, vous pouvez « ajuster vos réglages de crawl, reprendre le crawl ou le finaliser » source
✓Les crawls en cours peuvent être mis en pause et repris source
✓Pause, Reprendre, et Quitter enregistre d'abord le crawl
Crawler plusieurs sites à la fois
✓Une fenêtre par crawlFAQ : « Ouvrez plusieurs instances du SEO Spider, une pour chaque domaine à crawler », ou utilisez le mode liste avec une liste de domaines. source
◐Cloud : Medium et plusDesktop met les audits en file d'attente (« ils s'exécuteront l'un après l'autre ») source
✓Jusqu'à 5« Number of Audits Running at Once » source
✓Sans limiteFAQ : « vous pouvez lancer des crawls, grands et petits, tous en même temps » et « Nous ne limitons pas le nombre de domaines différents que vous pouvez crawler ». source
✓Illimité« Les crawls simultanés sont illimités sur tous les forfaits JetOctopus, sans frais supplémentaires. » Les projets et domaines sont illimités aussi. source
✓4 dans une fenêtreJusqu'à 4 sites à la fois, chacun à son rythme, avec un garde-fou mémoire (0.10.38)
Limites d'URL
✓Illimité, payantGratuit : 500 URL par crawl. source
◐regroupement automatique par template HTML pour « segmenter les problèmes SEO selon le template » source
✓Oui, dans Semrush Enterprise Site Intelligence source
✓« Segmenter les crawls » par filtres (sous-dossier, sous-domaine) source
✓Segmentation : « Créez des segments personnalisés à partir des nombreuses métriques de Lumar », avec des tendances par segment et des alertes Monitor source
✓« Nous ne limitons pas le nombre de segments » source
✓Groupes de pages déduits du HTML, et segments
Visualisations du crawl
✓Diagrammes de crawl et de répertoires à forces dirigées (2D et 3D), arborescences de crawl et de répertoires, nuages de mots et diagramme de clusters de contenu sémantique (v22.0). source
✓« Crawl maps » interactives (« Best Software Innovation » aux US Search Awards 2018), autres visualisations du site, graphiques et chronologies. source
◐des graphiques plus une vue « Site Structure » des « sous-domaines et sous-dossiers, avec le nombre d'URL et de problèmes dans chacun ». source
✓« Visualise les données avec des graphiques » pour l'indexabilité, la vitesse de chargement, les doublons et les codes HTTP source
◐graphiques de répartition, d'entonnoir et de tendance sur les tableaux de bord et chaque rapport (onglets « Trends & Segments » et « Breakdown »). source
✓« JetOctopus propose plus de 97 rapports, 381 graphiques, 26 jeux de données » source
✓Carte du crawl
Comparaison de crawls
✓« Mode > Compare » affiche les URL Added, New, Removed et Missing par onglet et par filtre, un onglet Change Detection et une comparaison de la structure du site (licence et stockage en base de données requis) source
✓« Audit Comparison » : « Suivez les changements dans le temps, découvrez ce qui a changé depuis votre dernier audit » source
✓« Compare Crawls » permet de « voir n'importe lequel de vos audits passés en comparaison côte à côte », avec les problèmes corrigés et nouveaux source
✓« Site Audit permet de comparer deux crawls quelconques » source
✓Chaque rapport se compare au crawl précédent source
✓« Vous pouvez comparer n'importe quels crawls, pas seulement les deux derniers », avec tous les graphiques et tableaux du crawler, aussi par segment source
✓HTML identique, URL techniquement identiques, balises title, meta descriptions et H1 dupliqués source
✓« Si le bot de Site Audit identifie plusieurs pages dont le contenu est similaire à 85 %, il les signale comme contenu dupliqué. » Balises title et meta descriptions dupliquées source
✓Rapport Duplicates sur les balises title, les meta descriptions, les H1 et le contenu source
✓Les « Duplicate Pages » partagent « une balise title et une description identiques et un contenu quasi identique » source
✓Rapports « Duplication » pour les balises title, les meta descriptions, les H1, les H2 et le contenu principal, où « vous pouvez choisir le pourcentage de duplication » source
✓Contenu dupliqué et quasi dupliqué
Contenu pauvre
✓Check « Low Content Pages » dans la catégorie Content, nombre de mots par page, et « Low Relevance Content ». source
✓Recherche personnalisée dans le code source et « Custom Extraction : récupérez n'importe quelle donnée du HTML d'une URL avec XPath, des sélecteurs CSS Path ou des regex » source
✓Extraction de contenu par sélecteur CSS (sélecteur visuel en pointer-cliquer) source
✓Custom Extraction par regex (30 métriques d'extraction) source
✓« vous pouvez configurer jusqu'à 50 règles d'extraction personnalisées pendant un crawl » source
✓Recherche et extraction
Revue IA du contenu des pages
✓OpenAI, Gemini, Anthropic, OllamaIntégrations API directes avec OpenAI, Gemini, Anthropic et Ollama (LM Studio via l'intégration OpenAI) source
◐MCP, lecture seuleaucun prompt IA exécuté sur le contenu des pages pendant un crawl. source
◐Une page à la foisContent Toolkit, une page à la fois source
◐Tâches prédéfiniestâches IA fixes uniquement : « Ask AI » et « Batch AI » rédigent les balises title et meta descriptions (Project Boost), plus une détection de contenu IA source
◐Intégrépas de prompts rédigés par l'utilisateur sur le contenu des pages. source
◐Intégré, MCPaucun prompt utilisateur exécuté sur chaque page source
✓Ollama, Anthropic, OpenAI44 checks de revue IA exécutés par Ollama sur votre propre ordinateur ; clés Anthropic et OpenAI dans Connexions
Similarité sémantique
✓Embeddings vectoriels d'OpenAI, Gemini ou Ollama « pour identifier les pages sémantiquement similaires et le contenu peu pertinent, ainsi que pour la recherche sémantique et le diagramme de clusters de contenu » source
◐rien d'intégré. Un guide sur leur site (8 octobre 2026, auteur invité) source
✓29Bibliothèque Hints : On Page 22 et Duplicate Content 7 (29 au total), plus les rapports Spelling Errors et lisibilité. source
✓140+ au total« Avec la possibilité de vérifier plus de 140 problèmes de site » source
✓170+ au total« Détecte plus de 170 problèmes » dans les catégories technique et on-page, plus des problèmes personnalisés source
✓43 rapportsAucun total publié. Notre décompte de la liste des rapports de leur API source
✓Environ 100 au totalEnviron 100 : l'analyse des problèmes exécute « environ 100 checks prédéfinis sur le crawl, les logs et Search Console, regroupés par gravité ». source
✓Erreurs « Pages returning 4XX status code » et « Pages returning 5XX status code », échecs DNS et de crawl, plus un avertissement pour les liens externes qui renvoient 403. source
✓Les pages hors 200 sont « listées sous leur problème respectif » (404, 4XX, 5XX, 403, délai dépassé, redirections cassées) source
✓Rapports pour les pages 200, les redirections 301 et non 301, « 4xx Errors », « 5xx Errors », « Uncategorized HTTP Response Codes » et les URL en échec source
✓Graphiques et tableaux de codes HTTP dans les crawls et les logs source
✓Oui, avec un code couleur partout
Redirections et chaînes
✓« Trouver les redirections temporaires et permanentes, identifier les chaînes et boucles de redirections » source
✓13 hints Redirects (redirections cassées, boucles de redirections, redirections de slash final et de casse, meta refresh) source
✓« Redirect chains and loops » (Error), « Pages with temporary redirects », « URLs with a permanent redirect » source
✓Le problème « Redirect chain » « signale les URL qui aboutissent à une série de redirections » source
✓Rapports « Redirect Chains » (« redirige vers une autre URL qui est elle aussi une redirection »), « Redirect Loops », redirections cassées, JavaScript et meta refresh, et « Max Redirections ». source
✓Tableau des chaînes de redirections, où « vous pouvez aussi changer le nombre de sauts dans la chaîne de redirections » source
✓22 checks de redirection, chaînes et boucles
Canoniques
✓L'onglet Canonicals couvre les éléments link canoniques et les en-têtes HTTP source
✓Les hints Indexability couvrent les canoniques source
✓Erreurs « Pages with a broken canonical link », « Pages with multiple canonical URLs » et « AMP pages with no canonical tag » source
✓Des problèmes comme « Canonical points to redirect », canonique vers une 4XX ou une 5XX, page non canonique indiquée comme canonique, et canoniques HTTP/HTTPS discordantes. source
✓« Conflicting Canonical Tags » (« dans les balises canoniques HTML ou dans les en-têtes HTTP »), Canonical to Non-200, Pages without Canonical Tag, Unlinked Canonical Pages, Change source
✓Pour rel=canonical, « nous avons créé plusieurs rapports avec les problèmes les plus courants », plus un mode spécial pour les sous-domaines mobiles séparés. source
✓Oui
Rapport d'indexabilité
✓Chaque URL est « Indexable » ou « Non-Indexable », avec une raison « Indexability Status » source
✓« vérifier les directives robots qui se chevauchent ou se contredisent, les problèmes de canoniques et les erreurs de configuration du robots.txt » source
◐pas de colonne ni de rapport d'indexabilité source
✓Catégorie de problèmes Indexability et graphique de répartition source
✓« Non-Indexable Pages » (« empêchées d'être indexées par un noindex ou une canonique »), rapports noindex, canonicalisées et bloquées source
✓Segment « Indexable » intégré à tous les rapports source
✓145 checks d'indexabilité
Pagination
✓Onglet Pagination pour rel='next' et rel='prev' source
◐hints « Pagination URL has no incoming internal links » et « Query string contains paginated parameters » source
✓Vérifie la crawlabilité des pages paginées dans le crawl et les logs source
✓Checks de pagination
Hreflang
✓« Auditer les balises de retour manquantes, les codes de langue incohérents et incorrects, les hreflang vers des réponses hors 200, et plus encore » source
✓« vérifier que les balises hreflang sont valides, réciproques, uniques, cohérentes et auto-référentes » source
◐Le rapport International SEO vérifie les conflits, les valeurs, les liens cassés et les balises manquantes, mais « pour l'instant, Semrush ne vérifie que le HTML de votre site » (ni les sitemaps ni les en-têtes). source
✓Signale les codes invalides, l'auto-référence manquante, les balises de retour manquantes, les hreflang vers des pages cassées ou non canoniques source
✓Le rapport « Indexation » affiche « une liste des problèmes hreflang trouvés pendant le crawl » source
✓37 checks hreflang
Validation des données structurées
✓« Extraire et valider les données structurées selon les spécifications Schema.org et les fonctionnalités de résultats enrichis de Google. » source
✓« valider les données structurées à la fois selon Schema.org et selon les consignes Search Feature de Google (pour les résultats enrichis) » (Pro). source
✓Checks Sitemaps : « URLs Not In Sitemap », « Orphan URLs », « Non-Indexable URLs In Sitemap », « XML Sitemap With Over 50k URLs », « XML Sitemap Over 50mb », « URLs In Multiple Sitemaps »… source
✓9 hints XML Sitemaps (4XX, 5XX, noindex, canonicalisées, bloquées, redirection, délai dépassé, URL dans plusieurs sitemaps), détection des orphelines, et un générateur de sitemap XML. source
✓Des erreurs comme « Format errors in sitemap.xml files », « Incorrect pages found in sitemap.xml », « Sitemap.xml files are too large » source
✓Des problèmes de sitemap comme « Non-canonical page in sitemap », pages noindex, 3XX, 4XX ou 5XX dans le sitemap, pages du sitemap en délai dépassé et format invalide (XML uniquement). source
✓URL non indexables, en erreur ou redirigées dans les sitemaps, sitemaps cassés ou bloqués, trop d'URL, sitemaps vides source
✓Rapport sitemap avec les URL orphelines et hors 200, « Sitemaps problems by depth » et un tableau « Sitemap files » source
✓20 checks de sitemap XML
Liens internes et Link Score
✓« Analyser les liens internes, le nombre de liens, la profondeur de crawl et calculer le Link Score interne » source
✓« L'URL Rank, ou UR, mesure la force interne d'une page à partir du poids relatif des liens » source
✓Le Page Rating (PR) note la force des liens de chaque URL « sur une échelle logarithmique de 1 à 100 » source
✓DeepRank : « une mesure du poids des liens internes calculée de façon similaire à l'algorithme PageRank de base de Google », sur une échelle de 0 à 10 source
◐analyse approfondie des liens (liens entrants, ancres, nofollow, Linking Explorer) source
✓Link Score et 51 checks de liens
Pages orphelines
✓« Pour découvrir les pages orphelines, il faut des sources d'URL supplémentaires : les sitemaps XML et l'intégration des API Google Analytics et Search Console. » source
✓Les orphelines sont « des URL découvertes pendant l'audit, mais PAS par le crawler », trouvées via les sitemaps XML, Google Analytics, Search Console ou des listes d'URL source
✓Notices « Orphaned pages (from Google Analytics) » et « Orphaned pages (in sitemap) » source
◐« Orphan page » couvre les URL sans lien interne entrant venues des URL de départ du crawl ou « trouvées dans le fichier sitemap » source
✓Rapports d'orphelines par source (Search Console, analytics, sitemaps, fichiers de logs, listes d'URL, backlinks), par ex. source
✓Rapport « Orphan Pages » à partir des sources d'URL sitemap et GSC, filtrable par source source
✓Pages orphelines, depuis Search Console, Analytics et les sitemaps XML
Sécurité et HTTPS
✓« Découvrir les pages non sécurisées, le contenu mixte, les formulaires non sécurisés, les en-têtes de sécurité manquants, et plus encore » source
✓Le rapport Security vérifie les protocoles TLS, les suites de chiffrement et les certificats source
◐Checks HTTPS (contenu mixte, certificats, ancien TLS, « Subdomains don't support HSTS ») source
◐Checks HTTPS comme « HTTPS page has internal links to HTTP », redirections HTTPS vers HTTP et contenu mixte source
✓« HTTPS Pages without HSTS », pages HTTP, scripts HTTP sur des pages HTTPS, contenu mixte, liens HTTPS vers HTTP source
◐Uniquement le contenu mixte HTTPS, comme « Links to HTTP pages (mixed content) » et les images HTTP source
✓29 checks de sécurité
AMP
✓« Crawler les URL AMP et les valider avec l'AMP Validator officiel intégré » source
✓Rapports de configuration mobile (responsive, dynamique, mobile séparé), « Discouraged Viewport Types » (« mauvaise compatibilité mobile »), écarts du mobile séparé source
✓Un crawl Googlebot Mobile « fait ressortir les problèmes d'ergonomie mobile » comme « viewport mal configuré, tailles de police non conformes, zones tactiles » source
✓Checks viewport et mobile
Images
✓Texte alternatif et attribut alt manquants, « Over 100 kb », texte alternatif de plus de 100 caractères, « Incorrectly Sized Images », « Missing Size Attributes », images d'arrière-plan… source
✓Des hints sur les images comme « Images with missing alt text », « Has an anchored image with no alt text », « Transferred image size is over 100KB », « Properly size images » ou « Add dimensions to images », et d'autres… source
◐« Images without alt attributes » (Warning) source
✓« Nous examinons la taille des images, le temps de chargement et les types de contenu », les images cassées et les attributs alt (« Set » et « Not set ») source
✓« Broken Images », « Links with Images Missing Alt Tags », règles d'accessibilité image-alt, et audits d'images Lighthouse dans Site Speed (sans dimensions, hors écran, non optimisées, non responsive…) source
✓20 checks d'images, et un échantillonnage des images par groupe de pages
Vitesse et Core Web VitalsScreaming Frog 3Sitebulb 1Semrush 1Ahrefs 4Lumar 4JetOctopus 3Neova 4sur 4
Fonctionnalité
Screaming Frog
Sitebulb
Semrush
Ahrefs
Lumar
JetOctopus
Neova
Lighthouse
✓« Se connecter à l'API PSI pour les métriques Lighthouse, les opportunités de vitesse, les diagnostics et le Chrome User Experience Report (CrUX) source
✓Les « Opportunities and Diagnostics » de Lighthouse tournent « sur chaque page web crawlée » par le Chrome Crawler intégré, plus les métriques de laboratoire Web Vitals (LCP, CLS, TBT, TTI, FCP…) source
✓Rapport Core Web Vitals « propulsé par l'outil Lighthouse de Google » (LCP, CLS, TBT) source
✓PageSpeed Insights par page, avec votre propre clé API Google gratuite source
✓Dans Site Speed : « les métriques de performance Lighthouse à grande échelle », avec des rapports d'opportunités et de diagnostics par page et un Lighthouse Viewer intégré (juin 2025). source
✓API PageSpeed avec votre propre clé (« votre limite sera de 30,000 requêtes par jour ») source
✓LCP, INP, CLS et FID CrUX par page, avec catégories et répartitions source
✓Dans Site Speed : le CRUX Domain Summary « affiche les métriques CrUX du domaine principal et des autres domaines découverts » (CLS, FCP, INP, LCP, TTFB). source
✓Le LCP, l'INP et le CLS des vrais utilisateurs de Chrome, avec votre clé Chrome UX Report
Tendance Core Web Vitals
◐aucun graphique de tendance CWV dans l'application. source
◐la Google Sheet « Historical Audit Data » a une ligne par audit pour des « séries temporelles ou des graphiques » dans Looker Studio, et inclut les valeurs par tranche des Core Web Vitals (changelog, 13… source
✓Dans Site Speed : « un graphique de tendance pour chacun des KPI » (FCP, LCP, TBT, CLS), réparti en Slow, Moderate, Fast, un point par crawl (données de laboratoire) source
◐checks CWV planifiés (« +Create a CWV schedule ») source
✓Une tendance sur 40 semaines dès le premier jour, et une vue par groupe de pages
Core Web Vitals planifiés
✓Les crawls planifiés peuvent utiliser l'API PSI source
◐audits planifiés et récurrents (Pro et Cloud) source
◐uniquement dans les Site Audits planifiés (« Weekly », « Daily »), dont le rapport Core Web Vitals reteste les 10 mêmes pages avec Lighthouse. source
✓Les CWV sont récupérés à chaque crawl quand PSI est activé, crawls planifiés compris source
◐aucun rapport sur les crawlers IA ni préréglage de bot IA trouvé source
✓« Blocked from AI Search » vérifie le robots.txt pour ChatGPT-User, OAI-SearchBot, Googlebot, Google-Extended, Perplexity-User, PerplexityBot, Claude-User, Claude-SearchBot. source
✓« ChatGPT Blocked » (« bloqué dans le robots.txt pour les tokens de user-agent GPTBot ou ChatGPT-User »), Google AI Blocked (Google-Extended), Bing AI Blocked, AI Bot Blocked, Common… source
✓Le Robots.txt Multi-tool gratuit permet de « vérifier au même endroit les règles d'accès des moteurs de recherche et des crawlers IA », dont GPTBot, ClaudeBot et PerplexityBot. source
✓Ce que chaque crawler IA a le droit de récupérer, et ce que 10 assistants IA reçoivent réellement
◐pas de checks de réponses IA. Le rapport Response vs Render est présenté comme le moyen d'« identifier exactement ce que les LLM peuvent voir » source
✓Checks AI Search : « Too much content », « Outdated Content » (Last-Modified de plus de six mois), « Low Semantic HTML Usage », « Content not optimized » (titres, longs paragraphes…) source
✓AI Discoverability : pages « trop lentes ou trop lourdes pour les crawlers IA », « Pages requiring JavaScript rendering », « Similar AI-generated content » source
✓AI Page Optimizer permet de « confronter les mots-clés cibles au title, à la meta et au contenu » pour les query fan-outs, et vérifie « si JavaScript cache votre contenu aux agents IA ». source
✓GA4 et GA360 : visites, taux de rebond, pages vues et conversions par URL, filtrables sur l'organique, « Google or Bing Organic Search Landing Pages, or All » source
✓« l'intégration ne fonctionne qu'avec Google Analytics 4. source
✓Google Analytics 4
Bing Webmaster Tools
◐Bingbot n'est qu'un préréglage de user agent source
◐Bingbot dans les logs et le testeur de robots.txt (« données complètes sur Googlebot, Bingbot, GPTBot, ClaudeBot et plus de 40 autres crawlers ») source
✓Bing Webmaster Tools, y compris les citations Bing AI
Suivi de positions
◐pas d'outil de suivi de positions. L'intégration GSC Search Analytics donne la « Position » moyenne par URL. source
◐pas d'outil de suivi de positions. Le rapport Keywords utilise les données GSC source
✓Position Tracking « surveille chaque jour les positions de votre site dans les résultats de recherche » par appareil et par lieu « jusqu'au code postal », sur Google, Bing, Baidu, ChatGPT Search et AI Mode. source
✓Rank Tracker : Google, « suivi mobile et desktop », plus de 190 lieux jusqu'au code postal, 19 fonctionnalités de SERP source
◐pas d'outil de suivi de positions ; uniquement la position GSC par page et par requête. source
◐Positions issues de GSC, pas de suivi de positions dans les SERP source
✓25 recherches suivies par jour depuis Search Console ; les positions réelles via DataForSEO
Données de mots-clés
◐Métriques GSC Search Analytics par URL (période et dimensions configurables) source
✓Rapport Keywords construit à partir de Google Search Console (« enable Keyword Analysis »), avec les mots-clés de marque. source
✓Keywords Explorer : « 28.7B de mots-clés filtrés parmi 110B découverts », 217 lieux, volume, Keyword Difficulty, potentiel de trafic source
✓Requêtes GSC par page, jusqu'à 2,000 requêtes cibles importées, et un volume de recherche qui « provient d'un fournisseur tiers » (Relevance Reporting) source
◐Requêtes GSC et métriques de mots-clés Ahrefs uniquement source
✓Requêtes Search Console ; les mots-clés manquants via DataForSEO
Métriques de backlinks
✓« Importer dans un crawl les métriques de liens externes des API Majestic, Ahrefs et Moz » source
–Aucune intégration Ahrefs, Majestic ou Moz trouvée. source
✓Index de backlinks propre (plus de 43T de backlinks) source
✓L'index propre d'Ahrefs (« 35T de backlinks actifs ») source
✓Intégration Majestic (« l'intégration des données de backlinks Majestic dans Lumar est gratuite ») source
✓Position Tracking : « le rapport Competitors Discovery révèle les concurrents organiques qui se positionnent sur vos mots-clés » source
✓Les nouveaux projets « reçoivent des suggestions de concurrents à partir des sites qui se positionnent sur des mots-clés similaires » source
✓Dans AI Visibility : « les marques sont découvertes automatiquement à partir des réponses des fournisseurs d'IA », et Lumar classe chacune en Own, Competitor, Other ou Context. source
✓« planifier des crawls qui s'exécutent automatiquement dans le SEO Spider, une seule fois ou à intervalles choisis », avec API, exports et Looker Studio source
✓« Les utilisateurs de Sitebulb Pro et Cloud peuvent configurer des Projects pour lancer des audits planifiés, ponctuels ou récurrents » source
✓Planification « Weekly », « Daily » ou « Once » source
✓L'onglet Schedule règle « le jour, jusqu'à l'heure et au fuseau horaire » source
✓« configurer des plannings pour vos crawls (par ex. source
✓« New scheduled crawl » avec une fréquence quotidienne, hebdomadaire, toutes les deux semaines ou mensuelle, une date de début et un fuseau horaire source
✓Des plannings avec un rappel, Reporter et Passer (application de bureau)
Détection des changements
✓Onglet « Change Detection » du mode Compare pour les éléments choisis (titles, descriptions, H1, nombre de mots, et plus) source
✓« Lost and Found compare les principales métriques d'URL et les hints déclenchés par votre audit actuel avec l'audit précédent le plus récent » (Found, Lost, Remained) source
◐comparaison d'un crawl à l'autre, et le rapport Robots.txt « vous indique si Semrush a remarqué des changements dans votre fichier robots.txt ». source
✓Audit permanent : « vous pouvez désormais voir tout ce qui a changé sur votre site, n'importe quel jour » source
✓Changed Metrics montre « quelles métriques ont changé d'un crawl à l'autre » par URL, plus des rapports comme Pages with Changed Title, Status Code et Canonical URLs. source
✓Des alertes, plus l'extraction personnalisée pour « suivre les changements d'éléments on-page et voir s'ils correspondent aux valeurs attendues » source
✓Les changements de contenu entre deux crawls ; les changements s'allument pendant le crawl
Alertes et notifications
✓E-mail à la fin du crawl via Outlook, Gmail ou un SMTP personnalisé, avec un tableau Issues source
✓« Sitebulb vous enverra un e-mail sympathique dès que votre audit sera terminé » (réglé par projet, plusieurs adresses possibles). source
✓Site Audit envoie des « mises à jour automatiques par e-mail » quand il est planifié source
✓L'audit permanent envoie un e-mail « si une nouvelle page est touchée par un problème de niveau erreur » (problèmes personnalisés compris), plus des e-mails de fin de crawl, les rapports Rank Tracker et Ahrefs Alerts. source
✓Crawl Email Alerts sur l'avancement du crawl source
✓Alertes illimitées pour les logs, GSC, le crawl et les Core Web Vitals source
✓Notifications système, Neova Go sur votre téléphone, Slack et Microsoft Teams ; l'e-mail arrive bientôt
◐« Sitebulb Cloud peut être intégré à Slack pour que vous receviez des notifications Slack sur l'avancement des audits » (Cloud uniquement, utilisateur admin) source
◐Slack uniquement pour les alertes concurrentielles Traffic & Market source
◐aucune alerte native Slack ou Teams trouvée (les alertes sont par e-mail). source
✓Dans Lumar Monitor : des alertes « dans l'application ou par e-mail, Slack ou Microsoft Teams » source
✓« Recevez des notifications en temps réel par e-mail, Slack ou MS Teams » source
✓Slack et Microsoft Teams, par canal, plus des webhooks
✓« créer des rapports PDF pour n'importe quel rapport, ou pour l'audit entier dans un seul document », en choisissant les rapports, graphiques et tableaux. source
✓Chaque onglet de Site Audit s'exporte en PDF source
✓Report Builder : « cliquez sur le bouton Print to PDF » source
◐Les rapports PDF sont personnalisables par section, et un témoignage client sur leur page de fonctionnalités salue des « PDF et rapports CSV entièrement en marque blanche » source
✓Oui, avec le module Pro Report ($20/mois par rapport) source
–« Pour le moment, nous ne permettons pas de mettre nos rapports en marque blanche. » source
◐FAQ : « l'interface peut être mise en marque blanche avec votre propre logo ». source
✓Exports CSV aux formats tableur, export Google Sheets (Keywords Explorer, Brand Radar, Bot Analytics), connecteurs Looker Studio pour Site Audit, Site Explorer, Rank Tracker… source
✓Téléchargement de rapports CSV (plus un CSV with Exploded Metric pour Excel), un connecteur Looker Studio de « partenaire officiel de Google » avec des modèles, et des tableaux de bord Google Sheets via Zapier… source
✓Export vers « Excel, Google Sheets, CSV ou Google Data Studio (Looker) » source
✓Classeur Excel (vers Google Sheets), CSV prêt pour Looker Studio
Destinations d'export
✓Dossier local ; Google Drive en Google Sheets (manuel ou planifié source
✓Exports CSV et .xlsx, enregistrés automatiquement après chaque audit dans un dossier local « OU un dossier d'enregistrement partagé, par exemple un service de stockage cloud comme Dropbox » source
✓Téléchargement CSV, Google Sheets (certains rapports), PDF par impression, connecteurs Looker Studio, plus l'API v3 et MCP source
✓Téléchargement de rapports CSV ou XML, données brutes en fichiers Parquet, connecteurs BigQuery et Looker Studio, Google Sheets via Zapier, outils de BI (Tableau, Power BI), l'API et les webhooks… source
✓Fichiers CSV, Excel, Google Sheets et sitemap depuis les tableaux de données, plus un connecteur Data Studio, BigQuery (« exportez les données de crawl et de GSC directement vers BigQuery »), l'API et MCP. source
✓Google Drive, OneDrive, Dropbox, iCloud Drive, Proton Drive, kDrive, SFTP ou FTPS, n'importe quel dossier
Tableaux de bord personnalisés
✓Onglet Dashboard de la v25.0 : « créez vos propres tableaux de bord personnalisés » à partir de widgets (graphiques, compteurs, pourcentages, tableaux de synthèse, liste des problèmes, graphique des segments…) source
◐pas d'outil CLI ; un service cloud piloté par l'API ou MCP, avec des jetons « pour les pipelines CI, les scripts et les agents automatisés » (Codex CLI, Gemini CLI). source
–FAQ : « Sitebulb Cloud a-t-il une API ? Pas encore, non. source
✓Oui, en module complémentaire de l'offre Business source
✓API v3 à partir de Lite, de 200,000 à 2,000,000 unités par mois, avec des endpoints Site Audit, Site Explorer, Keywords Explorer, Rank Tracker et Brand Radar. source
✓« l'API GraphQL de Lumar est disponible pour tous les utilisateurs », dans le cadre d'une « politique d'utilisation raisonnable » source
✓Toutes les offres : « accès à toutes les fonctions essentielles de JetOctopus, dont la création de projets et de crawls, les données des graphiques, les tableaux de données et les exports ». source
✓API REST de Neova Online avec des clés API (0.10.38), plus le serveur MCP et la ligne de commande
✓Toutes les offres, en lecture et en écriture source
✓Serveur MCP
Comptes d'équipe
◐Une licence par personneles licences sont par utilisateur (« si cinq personnes de votre équipe veulent utiliser le SEO Spider, il vous faudra 5 licences »), remises à partir de 5. source
✓2 à 10+ utilisateursLes offres Cloud incluent des utilisateurs (Mini 2, Small 5, Medium 10, Enterprise 10+) source
✓Dès $45 par utilisateur« Utilisateurs supplémentaires à partir de $45/mois » source
✓Dès $40 par utilisateur1 utilisateur inclus ; utilisateurs supplémentaires source
✓4 rôles, SSORôles d'équipe « Admin, Editor, Reporter et Viewer », avec des permissions par application source
✓Utilisateurs illimités« Projets et sièges (utilisateurs) source
BientôtBientôt disponible. Aujourd'hui, une personne par compte
Langues de l'interface
✓7« L'interface est disponible en anglais, espagnol, allemand, français, italien, néerlandais et turc » (7 langues source
◐Anglais, japonaisaucune liste des langues de l'interface trouvée. source
–AnglaisIntrouvable dans leur documentation. source
✓1515 langues
Logs serveur
◐Log File Analyserun produit distinct, le Screaming Frog Log File Analyser (Windows, macOS, Linux), pour « vérifier les bots des moteurs de recherche et de l'IA ». source
–BientôtFAQ : « Sitebulb ne fait pas encore d'analyse de logs, mais c'est en développement et ce sera bientôt disponible ! » source
✓EnterpriseOui, en produit Enterprise distinct source
◐Bot AnalyticsBot Analytics, un outil distinct gratuit en bêta sur les offres payantes, « ingère les données de requêtes HTTP » de Cloudflare, Vercel, CloudFront, des load balancers AWS ou de Fastly source
◐Inclusinclus, mais à partir de résumés par URL source
✓InclusInclus dans toutes les offres, pas un produit distinct source
✓InclusInclus : logs Apache et Nginx, Cloudflare lu directement, bots vérifiés uniquement
Préproduction et migrations
✓« Comparer la préproduction aux environnements de production grâce à l'URL Mapping avancé » source
✓Crawl des sites de préproduction avec authentification HTTP ou par formulaire et réglages robots adaptés, puis comparaison des audits entre « deux Projects quelconques ». source
✓Oui, dans Semrush Enterprise Site Intelligence source
◐« Crawler les sites de préproduction et à accès restreint… source
✓« crawler votre environnement de préproduction ou de test et le comparer à votre site en ligne », avec Test Site Domain, DNS personnalisé, authentification basique et remplacement du robots.txt. source
✓« Comparer le crawl d'un site de préproduction et du site en ligne vous aidera à construire une version fonctionnelle sans erreurs » source
✓Préproduction vs production, et un plan de redirections
Ouvre les exports des autres crawlers
◐le mode liste lit les URL de n'importe quel fichier .txt, .xls, .xlsx, .csv ou .xml (« vous pouvez importer directement un téléchargement Adwords ») source
◐Essai de 7 jourspas d'offre gratuite ; essai de 7 jours après une démo, sans carte source
✓1,000 URLOffre Free avec tous les checks ; Desktop gratuit pendant 14 jours, sans carte
Prix
✓$279 par anDesktop uniquement, pas d'offre cloud source
✓Dès $18 par moisDesktop Lite : $18 / £12.50 / €15 par mois ou $180 / £125 / €150 par an. source
✓Dès $139 par moisSEO $139/mois, Starter $199/mois, Pro+ $299/mois (en annuel $117.33, $165.17, $248.17/mois) source
✓Dès $29 par moisCloud uniquement : Starter $29/mois, Lite $129, Standard $249, Advanced $449, Enterprise sur demande source
–Sur demandePas de prix publics : « nous fixons le prix de nos solutions selon vos besoins. source
✓Dès $349 par moisCloud uniquement, par mois en facturation annuelle (en interne) source
✓Dès $19 par moisOffre gratuite, offres payantes à partir de $19 par mois (prix US)
✓Oui◐En partie–Les autres outils : non, ou introuvable dans leur documentation–Neova : pas encoreBientôtNeova : bientôt disponibleChaque réponse sur les autres outils renvoie à la page de leur site ou de leur documentation d'où elle provient.
Ce que Neova ne fait pas
Pas de base de mots-clés ni de backlinks à lui : Ahrefs, Semrush, SE Ranking et Moz ont les leurs, et Neova utilise à la place vos clés et votre Search Console. Utilisez-le avec ces suites, pas à leur place.
Bientôt disponibles : les comptes d'équipe et les alertes par e-mail (aujourd'hui, les alertes arrivent par le système, Neova Go, Slack et Microsoft Teams).
Pas encore de similarité sémantique.
Colonnes Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar et JetOctopus : uniquement ce que leur propre site et leur documentation indiquent, lu le 11 novembre 2026, avec un lien vers chaque page. « Introuvable dans leur documentation » signifie que nous ne l'avons pas trouvé, pas que c'est impossible. Colonne Neova : ce que font aujourd'hui Neova et Neova Online, relevé dans l'application. 141 checks de Neova ne figurent dans aucune des listes publiées des 10 outils SEO que nous avons comparés (Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar, Moz, SE Ranking, Seobility, Sitechecker et Conductor) : chaque liste a été confrontée une par une à la bibliothèque de Neova le 25 octobre 2026. Les 67 checks ajoutés depuis ne sont pas comptés tant qu'ils n'ont pas été comparés. Ces noms sont des marques de leurs propriétaires ; Neova n'est affilié à aucun d'eux. Si une ligne est fausse ou dépassée, écrivez à hello@neova.app et nous la corrigerons.




 Google Search Console
 Google Analytics
 Chrome UX Report
 Google Cloud
 Gemini
 Bing Webmaster Tools
 OneDrive
 Microsoft Teams
 DataForSEO
 Semrush
 Ahrefs
 Majestic
 Moz
 SEO Gets
 Anthropic
 OpenAI
 Ollama
 Jira
 Linear
 Asana
 ClickUp
 monday.com
 Slack
 Cloudflare
 Google Drive
 Dropbox
 iCloud Drive
 Proton Drive
 kDrive
 Screaming Frog
 Sitebulb
 Lumar
 JetOctopus