Neova高级 SEO 平台

功能

Screaming Frog 和 Sitebulb 为 SEO 爬虫树立了标杆,我们从两者身上都学到了很多。下面把 Neova 与它们以及 Semrush、Ahrefs、Lumar 和 JetOctopus 放在一起对比,信息来自各家自己的文档,并附有链接。

同时抓取多个网站

桌面应用

一次抓取客户网站、其竞争对手和您自己的网站。一个窗口里最多同时抓取 4 个网站,各按自己的速度和 URL 上限运行;电脑内存不足时,内存保护会让下一个抓取先等着。

两次抓取,一个窗口
两个抓取,一个窗口顶部显示「2 个抓取进行中」:点击其中一个即可查看。
进行中
进行中每个抓取、它的速度、已用的抓取槽位和可用内存。
最多同时 4 个开始一个抓取,再开始一个:最多可同时抓取 4 个网站。「设置」›「抓取」›「同时抓取数」,默认 2 个;下一个会在队列中排队等候。
各按各的速度每个抓取都保留自己的速度、URL 上限和设置,慢吞吞的客户网站不会拖住其他抓取。
内存保护每个抓取都会预留所需的内存,启用 JavaScript 渲染时会更多。电脑内存不足时,下一个抓取会等待并说明原因。
一个窗口管所有抓取在实时界面顶部切换正在运行的抓取。「进行中」列出全部抓取,每个都有「暂停」「停止」和「打开」。

Screaming Frog:每个应用副本只能运行一个抓取,每个网站一个窗口、一份内存。来源
Sitebulb:桌面应用按顺序逐个运行诊断;只有 Sitebulb Cloud 的 Medium 和 Enterprise 套餐才能同时运行。来源

看看里面

这是 Neova 抓取每个 Neova Online 账户自带的演示商店的样子。点击界面查看大图。

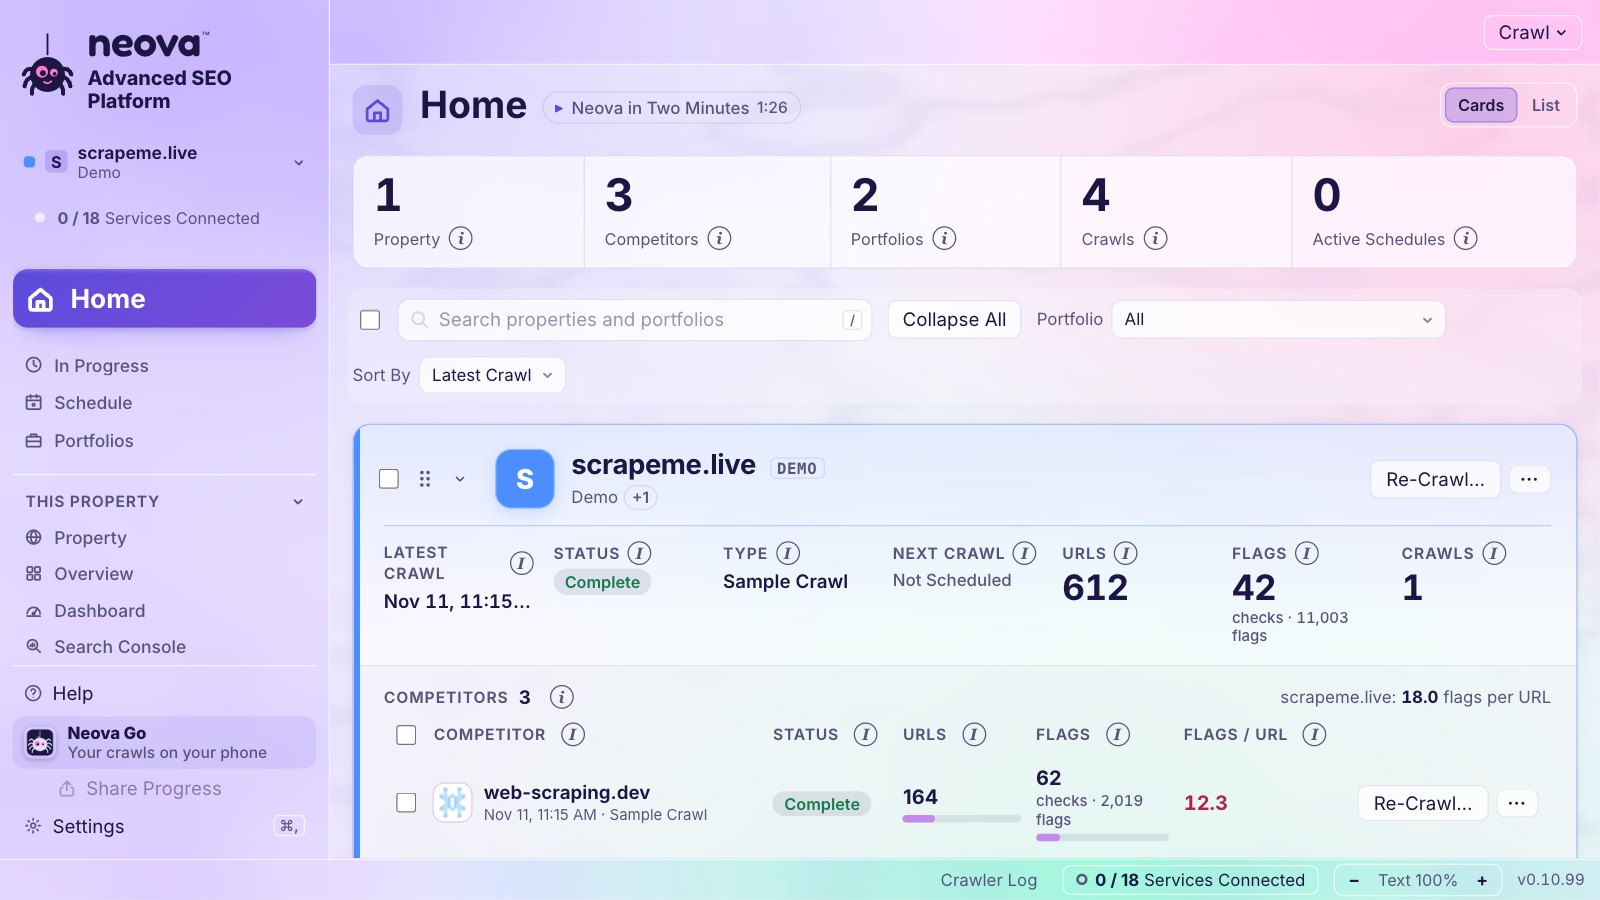
主页
主页每个资源及其竞争对手、URL 数量和每个 URL 的标记数。
实时抓取
实时抓取步骤、抓取地图、响应时间,以及实时进来的每个 URL。
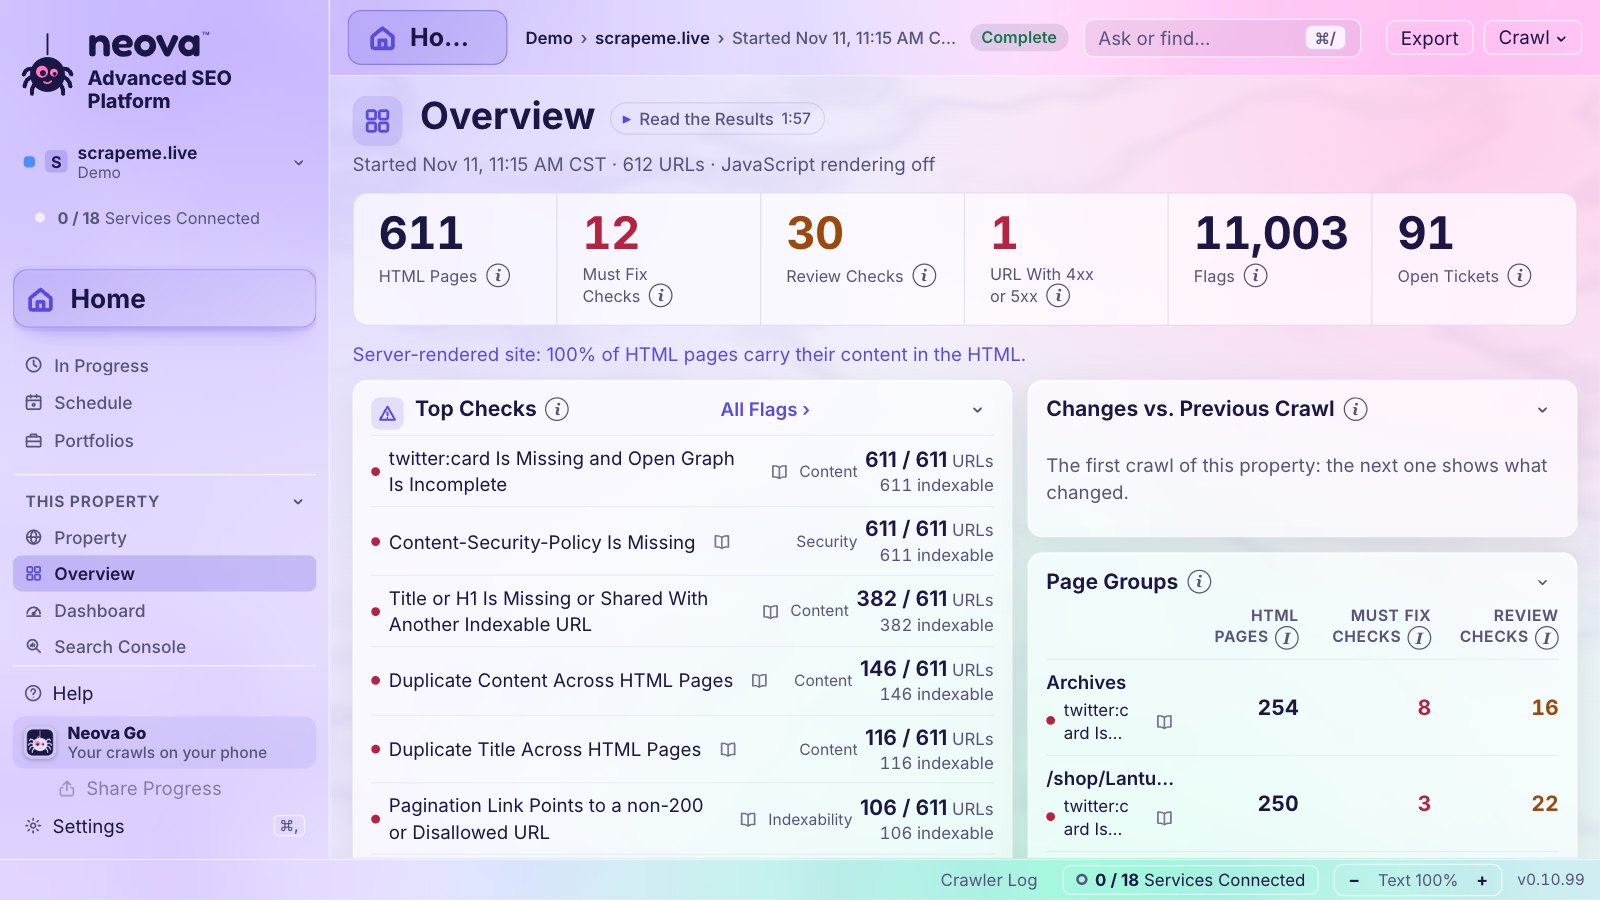
概览
概览一眼看清网站:主要检查项、变化、页面组。
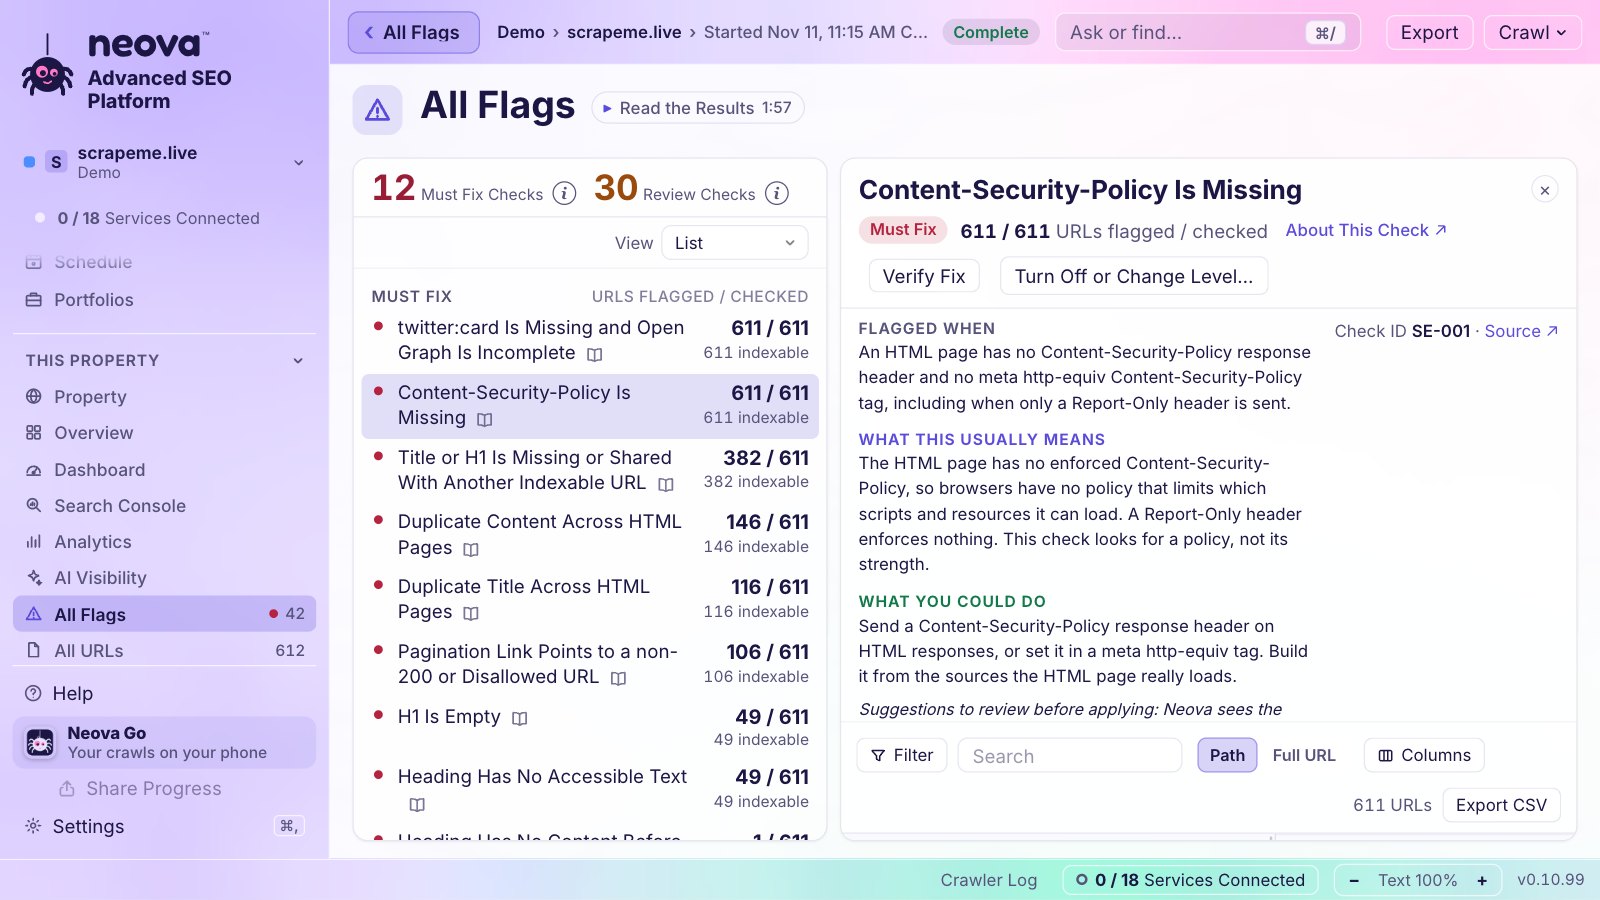
所有标记
所有标记每条标记都附原因、修复方法、来源和涉及的页面。
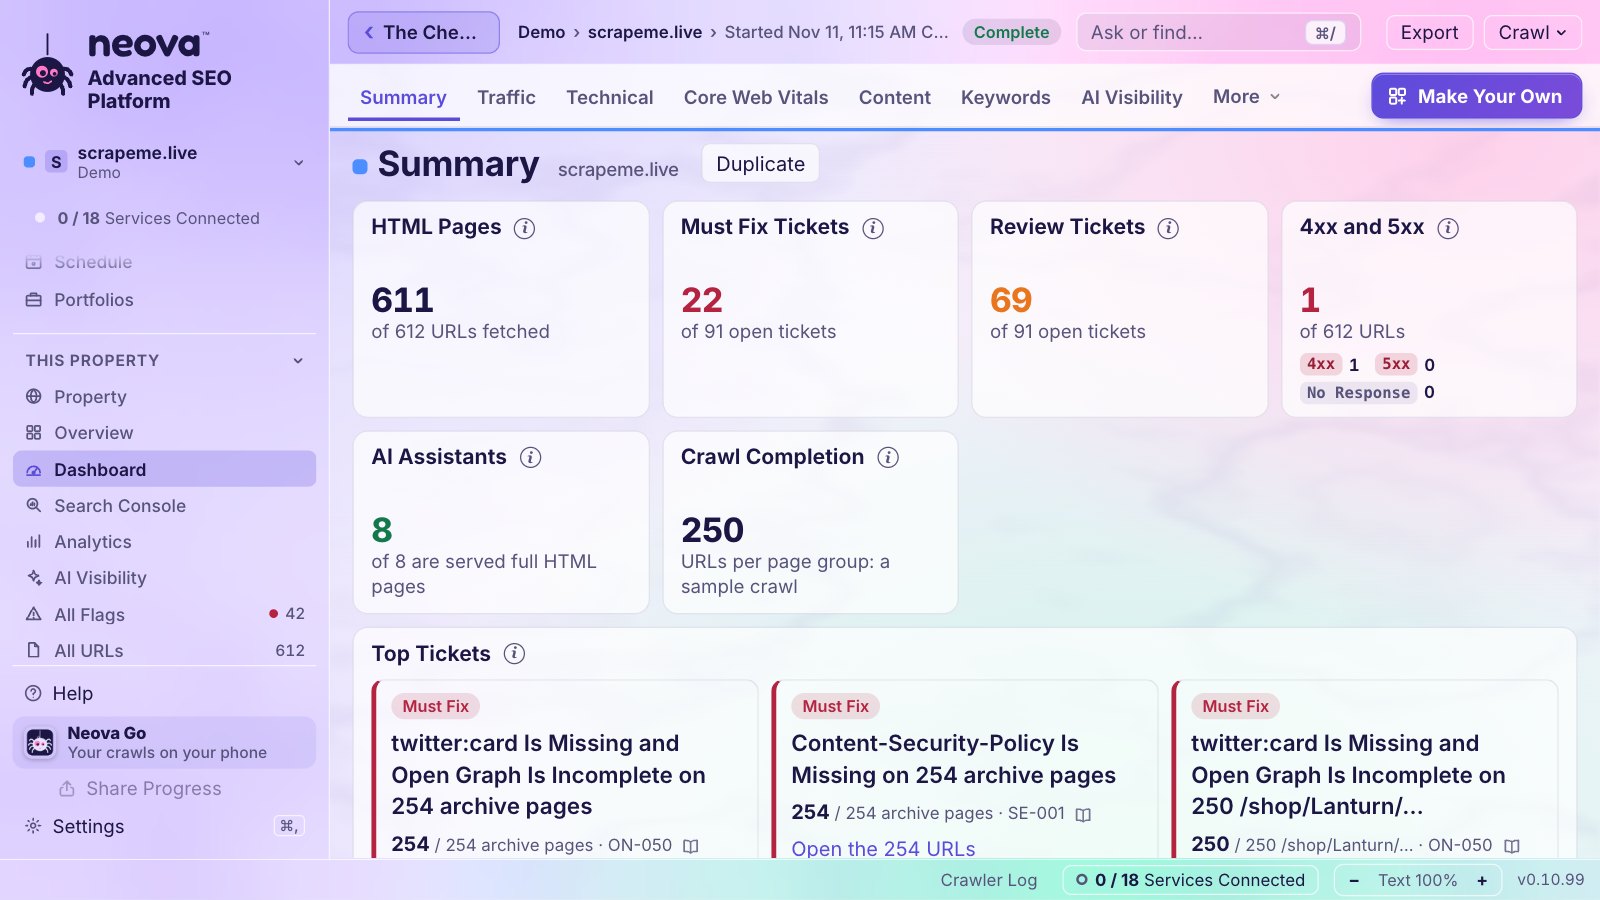
仪表盘
仪表盘13 个标签页、39 个模块,还能创建自己的仪表盘。
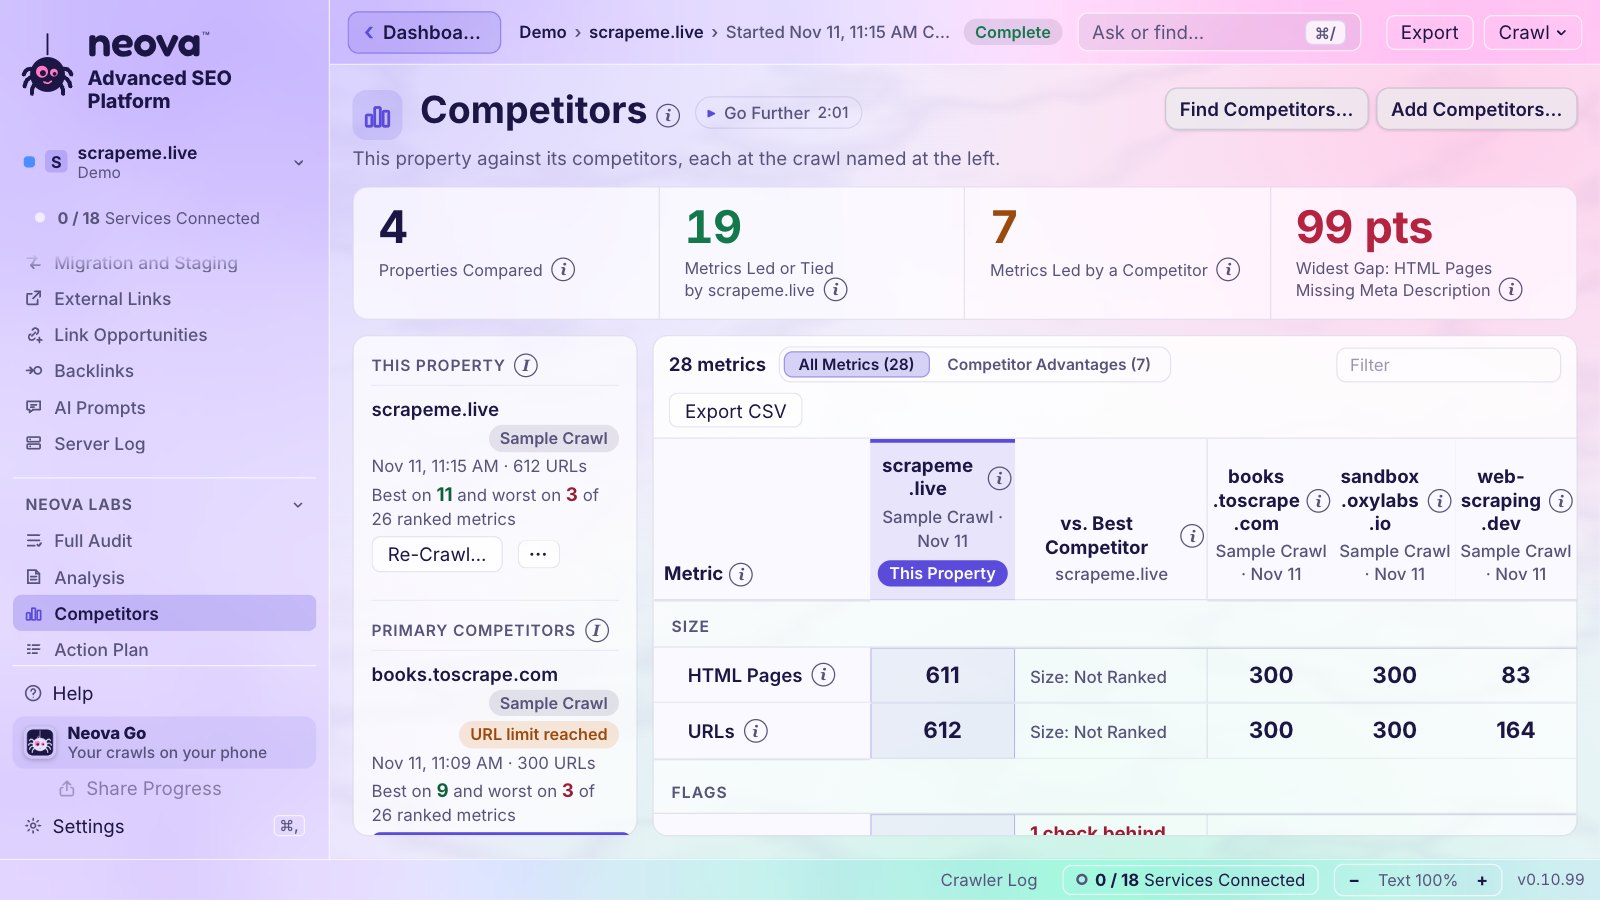
竞争对手
竞争对手您的网站与他们的网站逐项指标对比,按谁领先着色。
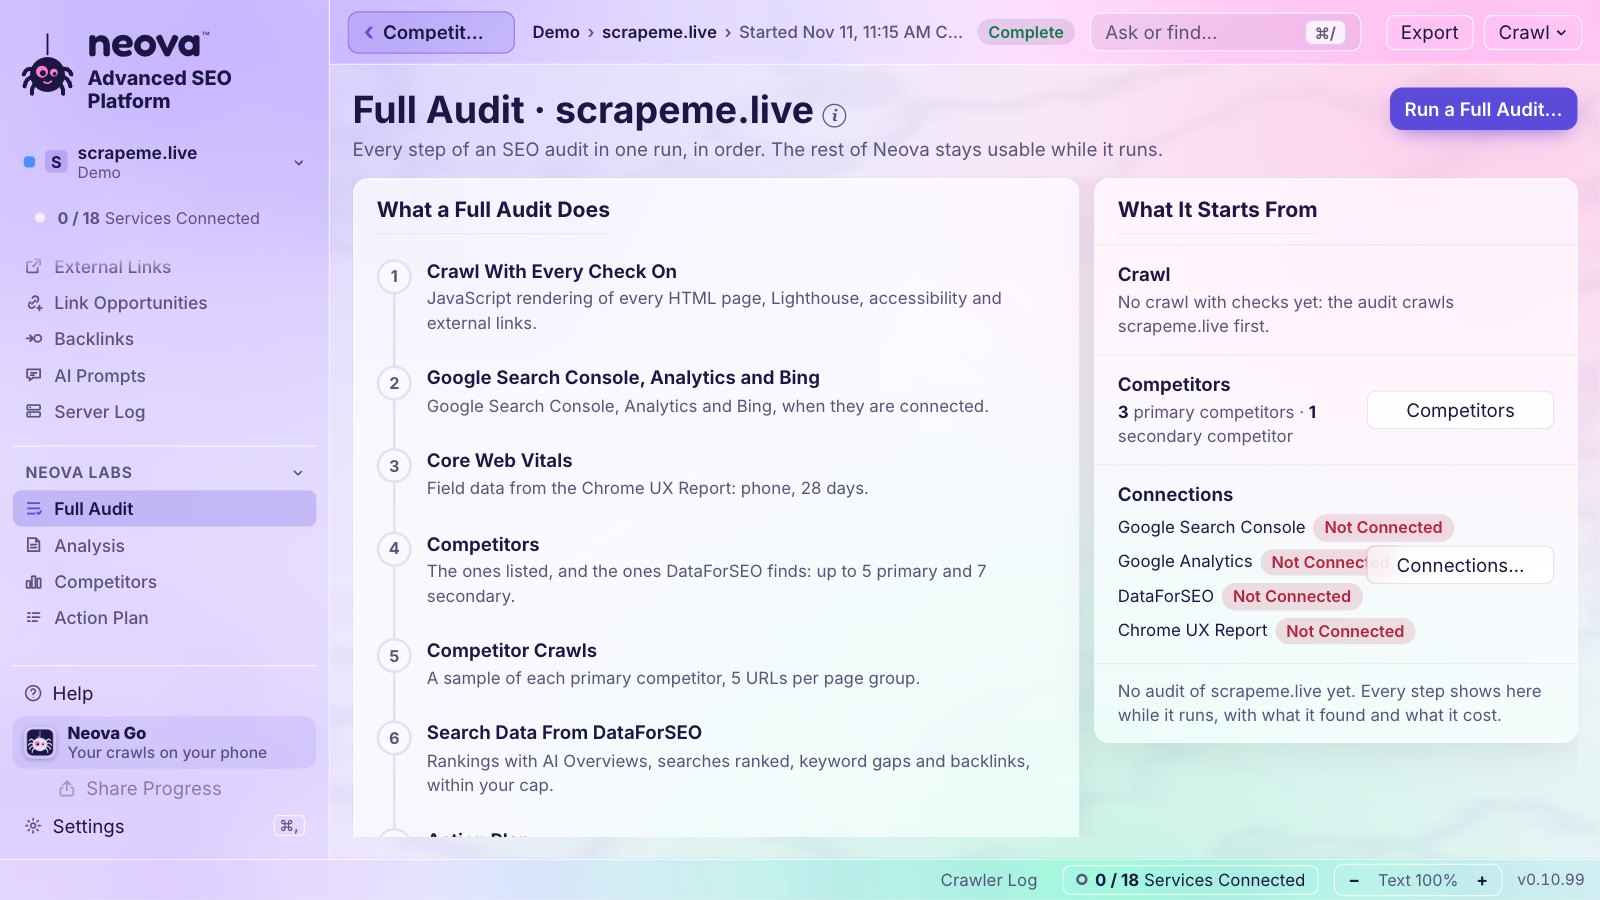
完整诊断
完整诊断抓取、搜索数据、竞争对手、计划和报告,一次运行全搞定。
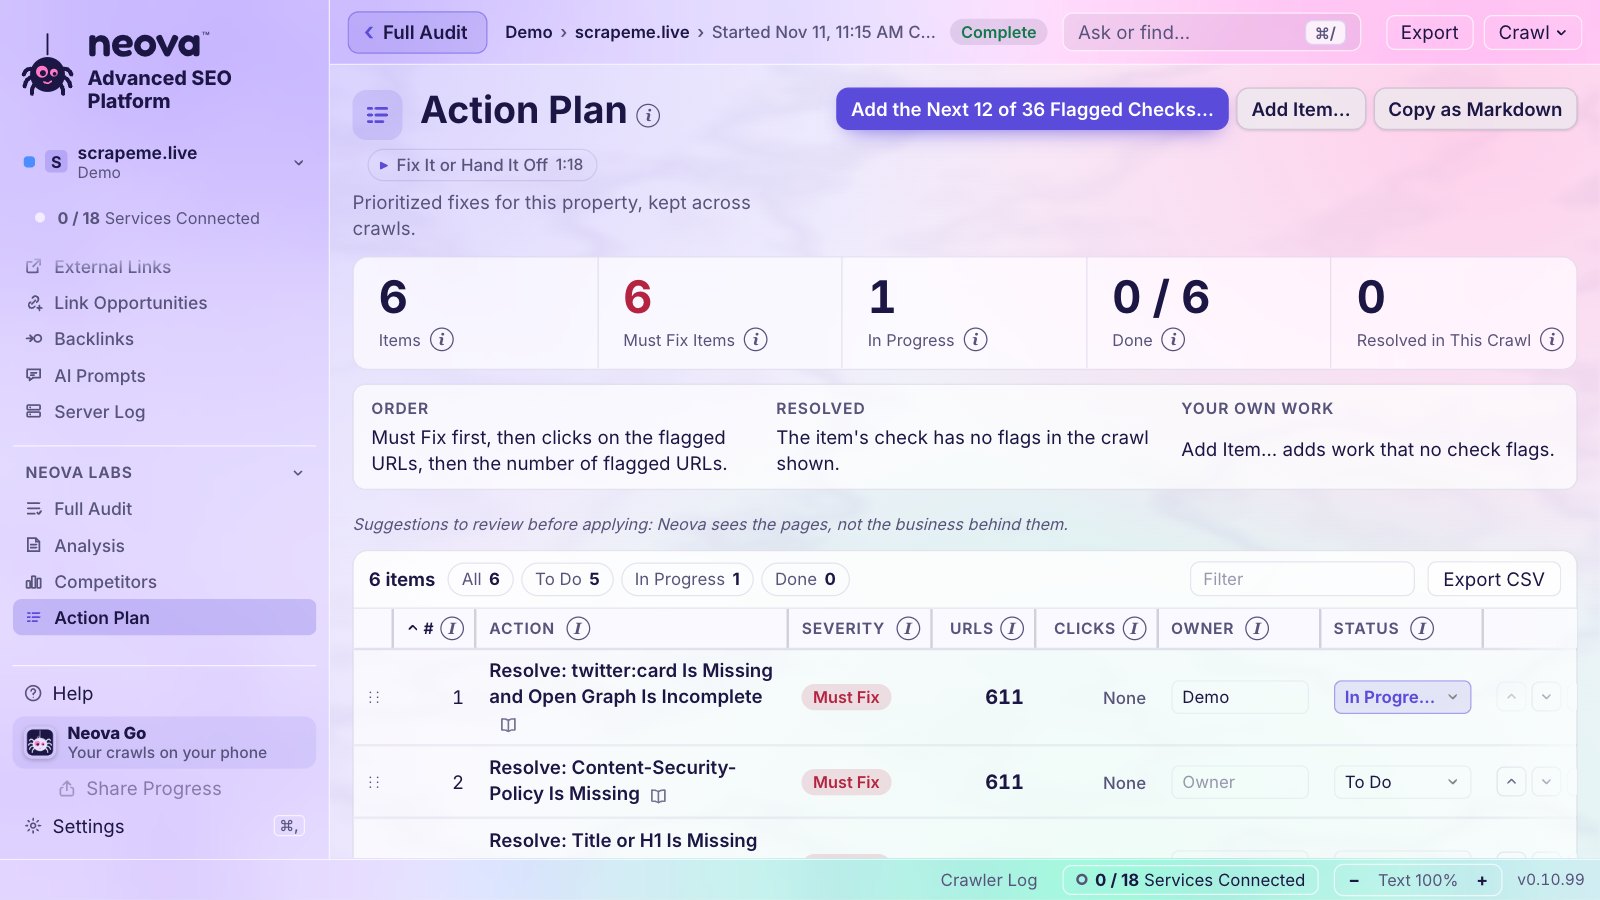
行动计划
行动计划每个修复方案都有负责人和状态,愿意的话可以发到 Jira。

只有 Neova 才有

已查阅它们的文档

根据 Screaming Frog、Sitebulb、Semrush、Ahrefs、Lumar 和 JetOctopus 各自的文档(查阅于 2026年11月11日),这些是 Neova 能做而它们都做不到的事。每张卡片用大白话说明它是什么,以及为什么重要。

把实时抓取分享给任何人

「分享进度」会生成一个指向正在运行的抓取的链接。任何人都能在手机或电脑上打开,无需账户,实时观看:进度、URL 分布、抓取地图、响应时间、重定向和错误,抓取结束时还会收到通知。

详情

您的客户或上司无需登录任何东西就能跟进抓取,而且只能看到这一次抓取。点「停止分享」立即失效。

Screaming Frog:Looker Studio 抓取概览由一个 Google 表格提供数据,该表格「每次运行计划抓取时」更新,可以通过邮件发给「任何相关人员」。来源
Sitebulb:Cloud 的 Data Studio 仪表盘「无需 Sitebulb 账户」即可打开,并在「每次运行抓取时」更新 来源
Semrush:受邀查看者「仍需创建账户」来源
Ahrefs:客户通过「导出、定期报告或实时 Data Studio 仪表盘」获取结果 来源
Lumar:「公开链接允许任何人查看抓取和报告」,有效期「24 小时到 6 个月」来源
JetOctopus:未找到公开链接 来源

分享每一次抓取,用您的密钥加密

发布分享链接时,Neova 会在网站的抓取数据离开您的电脑之前将其加密。密钥只存在于链接中,连我们的服务器都无法读取。点「停止分享」后,链接就什么也打不开了。

详情

把完整的诊断交给客户,每个标签页、每张表格都在,而谁能看、能看多久,完全由您掌控。

Screaming Frog:Looker Studio 抓取概览由一个 Google 表格提供数据,该表格「每次运行计划抓取时」更新,可以通过邮件发给「任何相关人员」。来源
Sitebulb:Cloud 的 Data Studio 仪表盘「无需 Sitebulb 账户」即可打开,并在「每次运行抓取时」更新 来源
Semrush:受邀查看者「仍需创建账户」来源
Ahrefs:客户通过「导出、定期报告或实时 Data Studio 仪表盘」获取结果 来源
Lumar:「公开链接允许任何人查看抓取和报告」,有效期「24 小时到 6 个月」来源
JetOctopus:未找到公开链接 来源

您的电脑、您的浏览器、您的手机

在您自己的 Mac、PC 或 Linux 电脑上抓取,在任意浏览器里通过 Neova Online 打开同样的资源组合、设置和抓取,再用手机随时关注。一个账户,保持同步。

详情

桌面爬虫只能待在一台电脑上,云端爬虫只能待在浏览器里。Neova 跟着您走,而除非您选择,否则抓取数据始终留在您的电脑上。

Screaming Frog:文档中未找到。来源
Sitebulb:桌面版加浏览器端 Cloud 来源
Semrush:浏览器平台,加一款仅用于排名的 iOS 应用 来源
Ahrefs:仅浏览器;Ahrefs 称可以「随时随地」查看抓取结果,「甚至用智能手机」(2024)。来源
Lumar:文档中未找到。来源
JetOctopus:文档中未找到。来源

Neova Go:把您的网站装进口袋

在手机上,查看每个资源的最近一次抓取、Core Web Vitals、点击量、跟踪的搜索词和下次运行时间,全部用一把从不离开您电脑的密钥加密。在菜单栏里,时钟旁显示抓取进度,还能对下一次计划抓取选择「推迟」或「跳过」。

详情

不用打开笔记本,就知道抓取已经结束,或某个模板变慢了。

Screaming Frog:文档中未找到。来源
Sitebulb:文档中未找到。来源
Semrush:一款仅用于排名的 iOS 应用 来源
Ahrefs:未找到手机应用。其云端网页应用可在手机上使用 来源
Lumar:文档中未找到。来源
JetOctopus:文档中未找到。来源

会自动关闭的工单

标记变成工单,每个检查项和页面组一张。下一次抓取发现问题已修复时,工单自动关闭;问题再次出现,工单重新打开。发送到 Jira,Jira 也会同步。

详情

开发人员拿到的是一张清楚的工单,而不是 4,000 个 URL;也没人再去追几周前就修好的工单。

Screaming Frog:文档中未找到。来源
Sitebulb:没有原生 Jira 集成。通过 AI 助手运行的 Dev Handoff Skill 会把工单「直接写入 Jira、Linear、Asana、Monday 或 ClickUp」。来源
Semrush:Site Audit 可以「把任务发送到 Trello 看板」来源
Ahrefs:未找到 Jira 或工单功能。来源
Lumar:任务需从报告中手动创建,并通过「把任务拖放到不同的状态区」来移动 来源
JetOctopus:文档中未找到。来源

每项检查都注明来源

每项检查都会说明它依据的是 Google、W3C、web.dev 或其他官方来源的哪个页面,附上链接,并告诉您该怎么做。

详情

开发人员问为什么时,您发过去的是来源,而不是个人意见。

Screaming Frog:抽查的 8 篇问题指南末尾都有「Further Reading」,链接到 Google 或 web.dev,但只是延伸阅读,不是规则的依据 来源
Sitebulb:许多 Hints 末尾有「Further Reading」(Google、MDN、Lighthouse 文档,也有博客),但「Canonical points to a redirecting URL」完全没有引用来源。来源
Semrush:部分修复建议链接到 Google(「请参阅这篇 Google 文章」)来源
Ahrefs:部分帮助页链接到 Google(「Google 的这份指南会告诉您一切」),而「Hreflang to broken page」等问题页没有引用任何外部来源。来源
Lumar:文档中未找到。来源
JetOctopus:文档中未找到。来源

Bing Webmaster Tools,包括 Bing AI 引用

Neova 读取 Bing 关于您网站的自有数据,包括 Bing 的 AI 回答引用您页面的频率。

详情

Bing 为 ChatGPT 搜索和 Copilot 提供数据。它的数据能反映您在 AI 搜索中的可见度。

Screaming Frog:Bingbot 只是一个 User-Agent 预设 来源
Sitebulb:Bing 只是一个 User-Agent 预设 来源
Semrush:仅有 Bing 排名跟踪 来源
Ahrefs:Site Audit 通过 IndexNow 推送变更(「Bing、Yep 和其他搜索引擎支持」)来源
Lumar:没有 Bing Webmaster Tools 来源
JetOctopus:日志和 robots.txt 测试工具中有 Bingbot(「Googlebot、Bingbot、GPTBot、ClaudeBot 及 40 多种其他爬虫的完整数据」)来源

打开您的 Screaming Frog 和 Sitebulb 抓取

已经用 Screaming Frog 或 Sitebulb 抓取过网站?在 Neova 中打开那次抓取,用 Neova 的检查项对照线上网站给它的页面评分。

详情

继续用您熟悉的工具,在需要的地方加上 Neova,不必抓取两遍。

Screaming Frog:列表模式可从任意 .txt、.xls、.xlsx、.csv 或 .xml 文件读取 URL(「可以直接上传 Adwords 下载文件」)来源
Sitebulb:导入 URL 列表(.csv 或 .txt)来源
Semrush:Backlink Audit 可导入外链文件(CSV,「最大 50 MB」)来源
Ahrefs:文档中未找到。来源
Lumar:可将 CSV 导出文件作为抓取来源导入(Majestic、Ahrefs、Open Site Explorer、Screaming Frog Log File Analyser、Splunk、Logz.io 来源
JetOctopus:只有通用导入:「导入时可以使用 CSV 或 TXT 格式的文件」,按 URL 键关联 来源

内置,不另外收费

其他工具也有这些功能,但往往是附加组件或单独定价的独立产品。在 Neova 里,它们都是应用的一部分。需要外部数据时(比如 DataForSEO 或 Google),您使用自己的账户,按对方的价格付费,我们不加任何费用。打开每项下面的「其他工具怎么做」,可以看到它们文档的对应页面。

看看 ChatGPT 和 Perplexity 是否提到您

Neova 像顾客一样,向 ChatGPT 和 Perplexity 提出您自己的问题,并告诉您回答里是否出现了您的品牌。

其他工具怎么做

越来越多的人先问 AI 助手,再去搜索。这样您就能知道自己在那里是否存在。

Screaming Frog:文档中未找到。来源
Sitebulb:文档中未找到。来源
Semrush:有,在 AI Visibility Toolkit 中($99/月)来源
Ahrefs:Brand Radar 可在 ChatGPT、Perplexity、Gemini、Copilot、AI Overviews 上使用自定义提示词 来源
Lumar:在 AI Visibility 中(按账户开通)来源
JetOctopus:「JetOctopus 不跟踪 AI 回答中的引用、品牌提及或情感倾向」来源

AI 助手实际拿到的是什么

Neova 以 10 种 AI 爬虫(ChatGPT、Claude、Perplexity 等)的身份获取您的页面,检查您的 llms.txt 和 agent 文件,并展示每种爬虫拿到的内容。

其他工具怎么做

访客能看到的页面,对 AI 助手来说可能被屏蔽或是空白。现在您能看到了。

Screaming Frog:文档中未找到。来源
Sitebulb:文档中未找到。来源
Semrush:Site Audit 的提示「Llms.txt not found (AI Search)」和「Llms.txt file has formatting issues (AI Search)」来源
Ahrefs:只有一个免费生成器(「为您生成完美的 llms.txt 文件」)来源
Lumar:在 Lumar 免费的 Agentic Readiness Scanner 中,与抓取平台分开 来源
JetOctopus:文档中未找到。来源

找出并对比您的竞争对手

Neova 找出在相同搜索词上与您竞争的网站,抓取最接近的几个,把每项指标并排列出,按谁领先着色。

其他工具怎么做

不用电子表格,就能看到竞争对手在哪些方面超过您、超过多少。

Screaming Frog:文档中未找到。来源
Sitebulb:文档中未找到。来源
Semrush:Position Tracking:「Competitors Discovery Report 会显示在您的关键词上有排名的自然搜索竞争对手」来源
Ahrefs:新项目会「根据在相似关键词上有排名的网站获得竞争对手建议」来源
Lumar:在 AI Visibility 中:「品牌从 AI 服务商的回答中自动发现」,Lumar 把每个品牌归为 Own、Competitor、Other 或 Context。来源
JetOctopus:文档中未找到。来源

服务器日志,即使在 Cloudflare 后面

Neova 读取您的 Apache 或 Nginx 日志,或直接读取 Cloudflare 的日志,只统计经过验证的爬虫,让您看到 Googlebot 和 AI 爬虫真正抓取了什么。

其他工具怎么做

日志显示的是搜索引擎在您网站上的真实行为,而不是爬虫的推测。

Screaming Frog:一款独立产品 Screaming Frog Log File Analyser(Windows、macOS、Linux),用于「验证搜索引擎和 AI 爬虫」。来源
Sitebulb:FAQ:「Sitebulb 目前还不做日志文件分析,但这已在开发计划中,很快就会推出!」来源
Semrush:有,作为独立的 Enterprise 产品 来源
Ahrefs:Bot Analytics,一款独立工具,测试期间对付费套餐免费,从 Cloudflare、Vercel、CloudFront、AWS 负载均衡器或 Fastly「接收 HTTP 请求数据」来源
Lumar:包含在内,但基于按 URL 汇总的数据 来源
JetOctopus:所有套餐都包含,不是独立产品 来源

真实用户的 Core Web Vitals,附趋势

用您免费的 Chrome UX Report 密钥,Neova 读取真实 Chrome 用户的体验数据:从第一天起就有 40 周趋势,按页面组查看,按计划生成快照,并发出警报。

其他工具怎么做

实验室测试说明页面能有多快。真实用户数据说明它对您的访客实际有多快,而 Google 用的正是后者。

Screaming Frog:未找到应用内的 CWV 趋势图。来源
Sitebulb:「Historical Audit Data」Google 表格每次诊断一行,用于在 Looker Studio 中制作「时间序列数据或图表」,并包含 Core Web Vitals 区间值(更新日志,13 来源
Semrush:实验室数据(Lighthouse)来源
Ahrefs:Site Audit 的 Performance 报告 来源
Lumar:在 Site Speed 中:「每项 KPI 一张趋势图」(FCP、LCP、TBT、CLS),分为 Slow、Moderate、Fast,每次抓取一个数据点(实验室数据)来源
JetOctopus:定期 CWV 检查(「+Create a CWV schedule」)来源

Jira,省掉琐碎活

每张工单都带着页面、检查项和修复方法发送到 Jira,每次抓取后 Neova 都会让两边保持同步。

其他工具怎么做

团队在原来的地方照常工作。

Screaming Frog:文档中未找到。来源
Sitebulb:没有原生 Jira 集成 来源
Semrush:原生只有「Send to Trello」来源
Ahrefs:未找到 Jira 集成。来源
Lumar:Jira Cloud 集成 来源
JetOctopus:文档中未找到。来源

仪表盘

打开一个资源,再点「仪表盘」:Neova 了解的关于这个网站的一切都在一个界面上,您还可以按需创建任意多个自己的视图。

演示商店的仪表盘
一个界面看全站8 个分组、13 个标签页、39 个模块。每个数字都显示与上一次抓取相比的变化。
速度,回溯 40 周从第一天起就有真实 Chrome 用户的 Core Web Vitals,附 Google 的「良好」和「较差」分界线,也可按页面组查看。
点击与搜索每日点击和展示,与之前 28 天对比,以及 25 个跟踪的搜索词及其排名。
Google 更新对点击的影响两年的排名更新标在您的流量曲线上,每次更新前后一目了然。
AI 搜索哪些 AI 助手来访、每个拿到什么内容、AI Overviews,以及经过验证的爬虫。
内容一览title、description 和 H1 的长度、页面组,以及被链接最多的页面。
执行进度按状态和负责人查看行动计划;标为「已完成」但仍被标记的修复会变红。
自己动手最多 10 个仪表盘:新建一个或复制一个标签页,然后添加、移动、调整大小和删除模块。

替您盯着

Neova 不止于抓取。它在两次抓取之间持续关注您的网站,一有变化就告诉您:在电脑上、手机上,或团队的频道里。

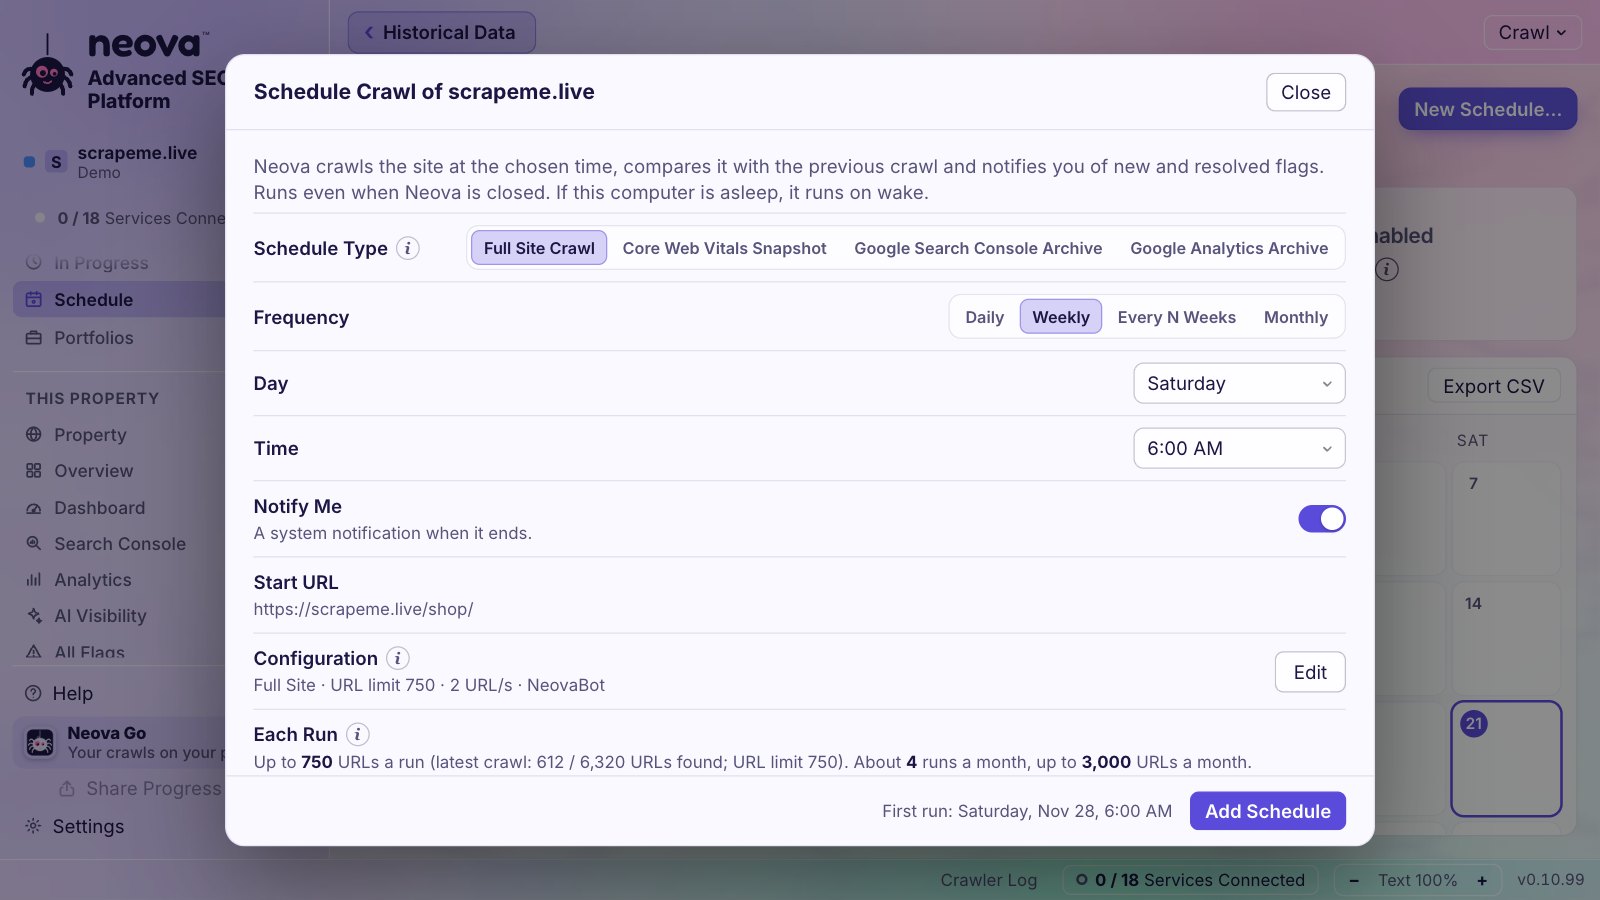
一个计划
计划任务多久一次、哪天几点,以及每次运行的费用。
Neova Go
Neova Go菜单栏、警报和您的手机。
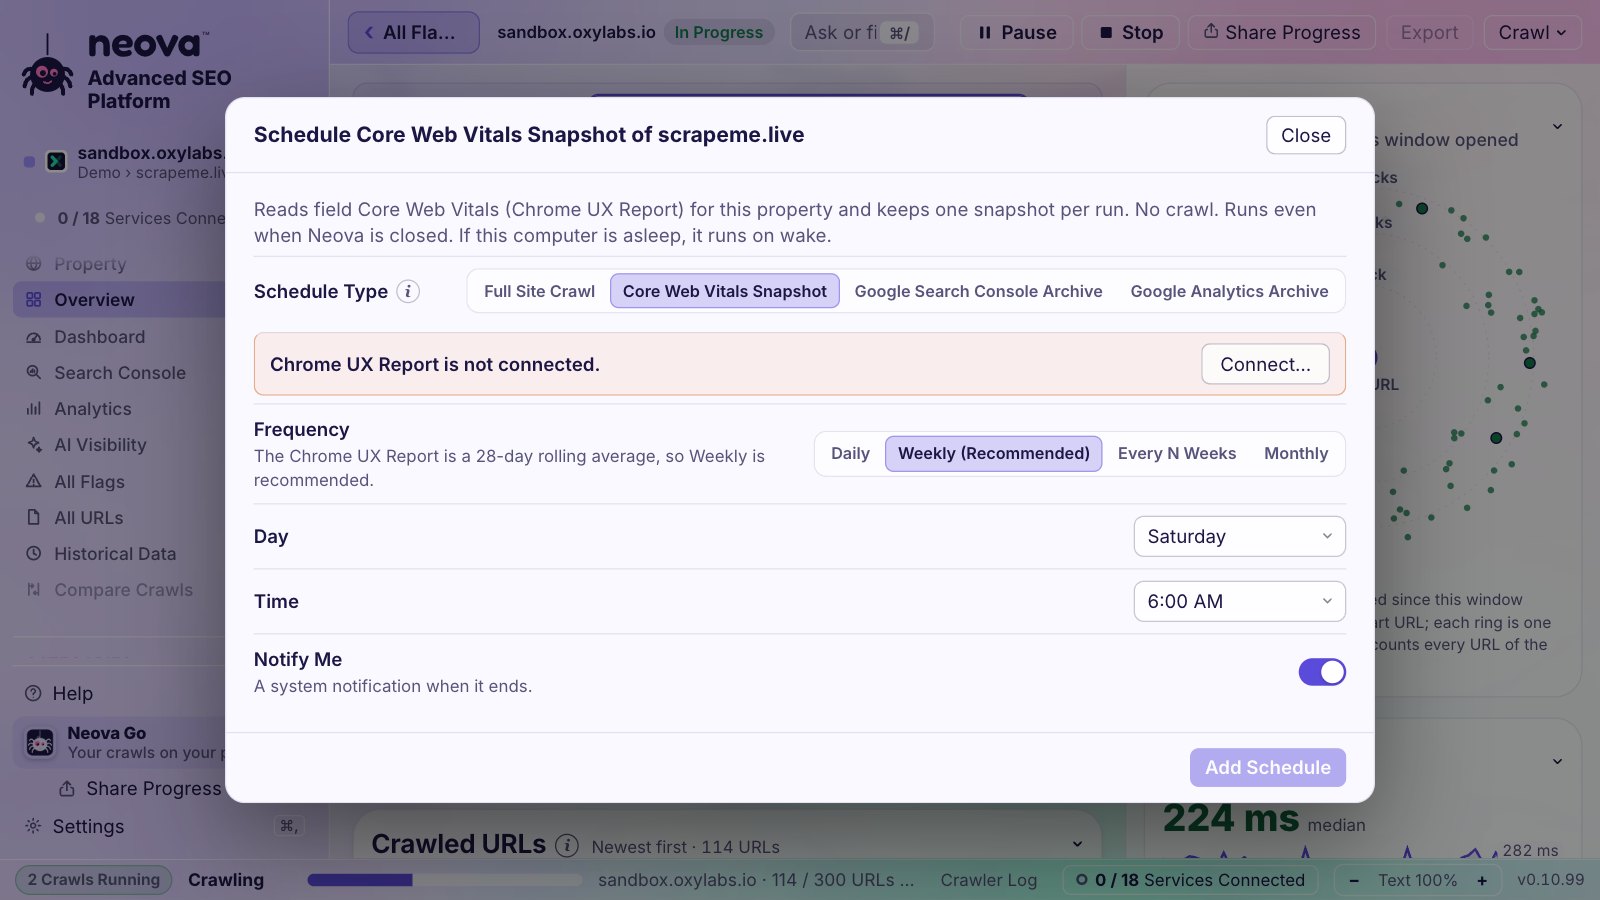
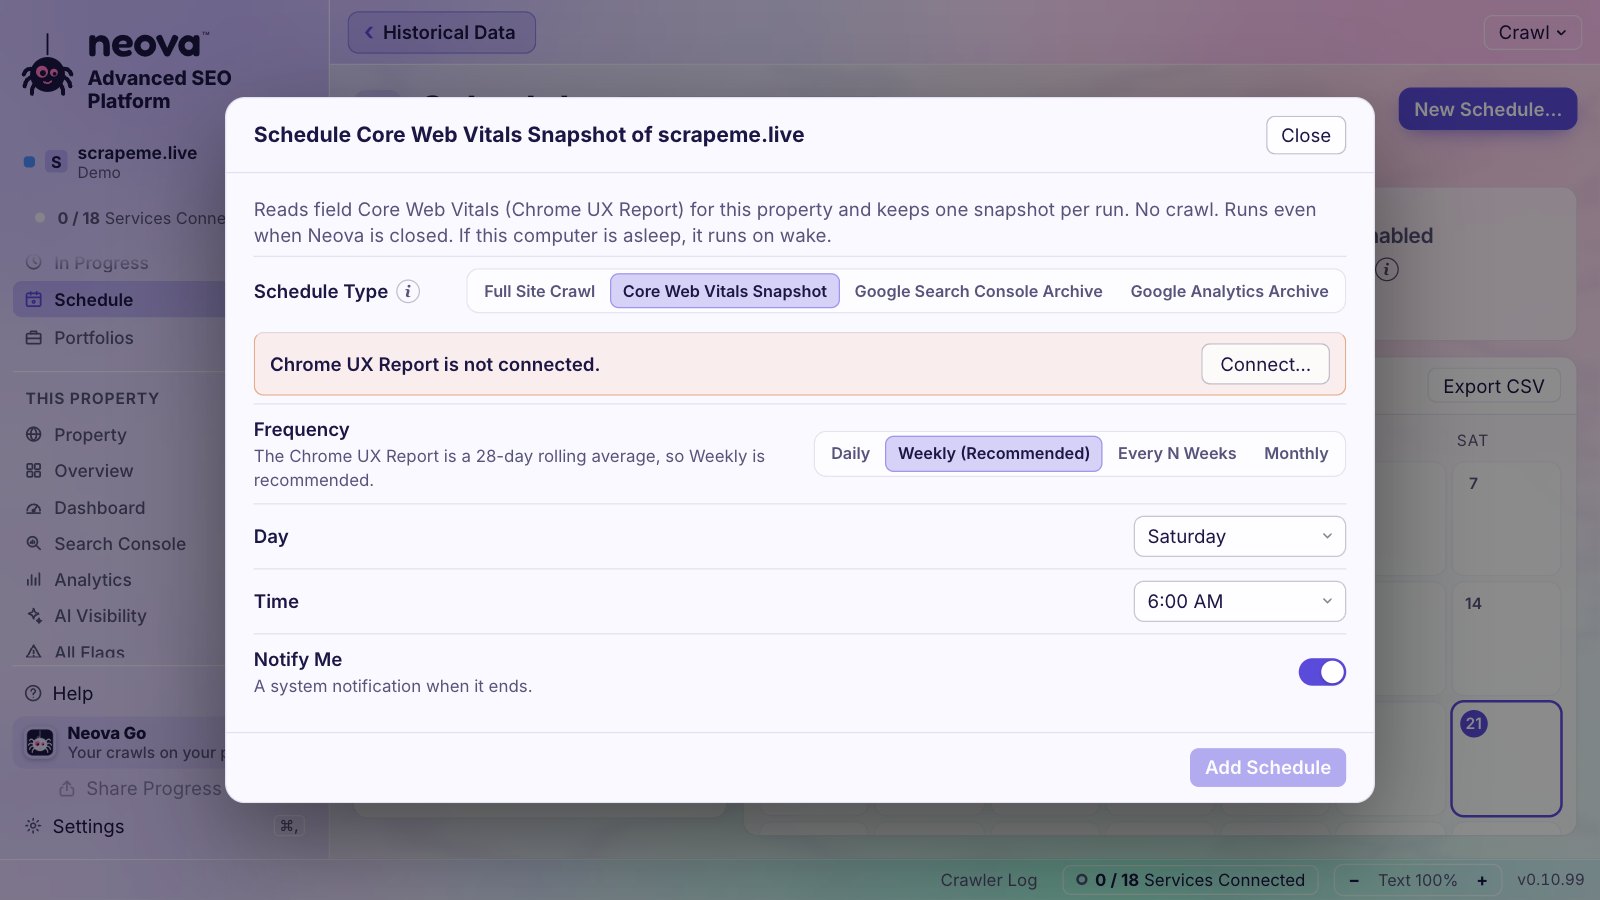
Core Web Vitals 快照
Core Web Vitals 快照按独立计划获取真实用户速度,无需抓取。
定时抓取每天、每周、每隔几周或每月,按资源设置,窗口关着也照常运行。提前 15 分钟提醒,可在菜单栏「推迟」或「跳过」,添加计划之前就能看到它的费用。
真正重要的警报Core Web Vitals 评级变化、点击量一周内下降 20% 或更多、某个跟踪的搜索词进入或跌出前 10 或下降 3 位、新一次抓取出现新标记。每次计划运行后检查,或在您点击「立即检查」时检查。
监视抓取只复查您的关键页面,不做发现,当状态、重定向、title、canonical、noindex、H1 或页面大小变化时向您发出警报。
Core Web Vitals 快照按计划获取真实 Chrome 用户的速度数据,无需抓取,并累积成一条可以逐周跟踪的趋势。
每天跟踪的搜索词每个资源最多 25 个来自 Search Console 的搜索词:7 天和 90 天内的排名、点击和展示,以及 Google 是否显示引用了您的 AI Overview。
Google 更新对点击的影响两年来 Google 的排名更新和故障事件标在您的每日点击曲线上,附每次更新前后的点击量。
每月一次完整诊断包含竞争对手的完整诊断,每月重复一次;Neova 会在下次打开时完成分析和 PDF。
警报随您而至菜单栏和手机上的 Neova Go、抓取结束时的通知,以及 Slack 和 Microsoft Teams,每个资源组合或资源都可以发到各自的频道。

Neova 还有

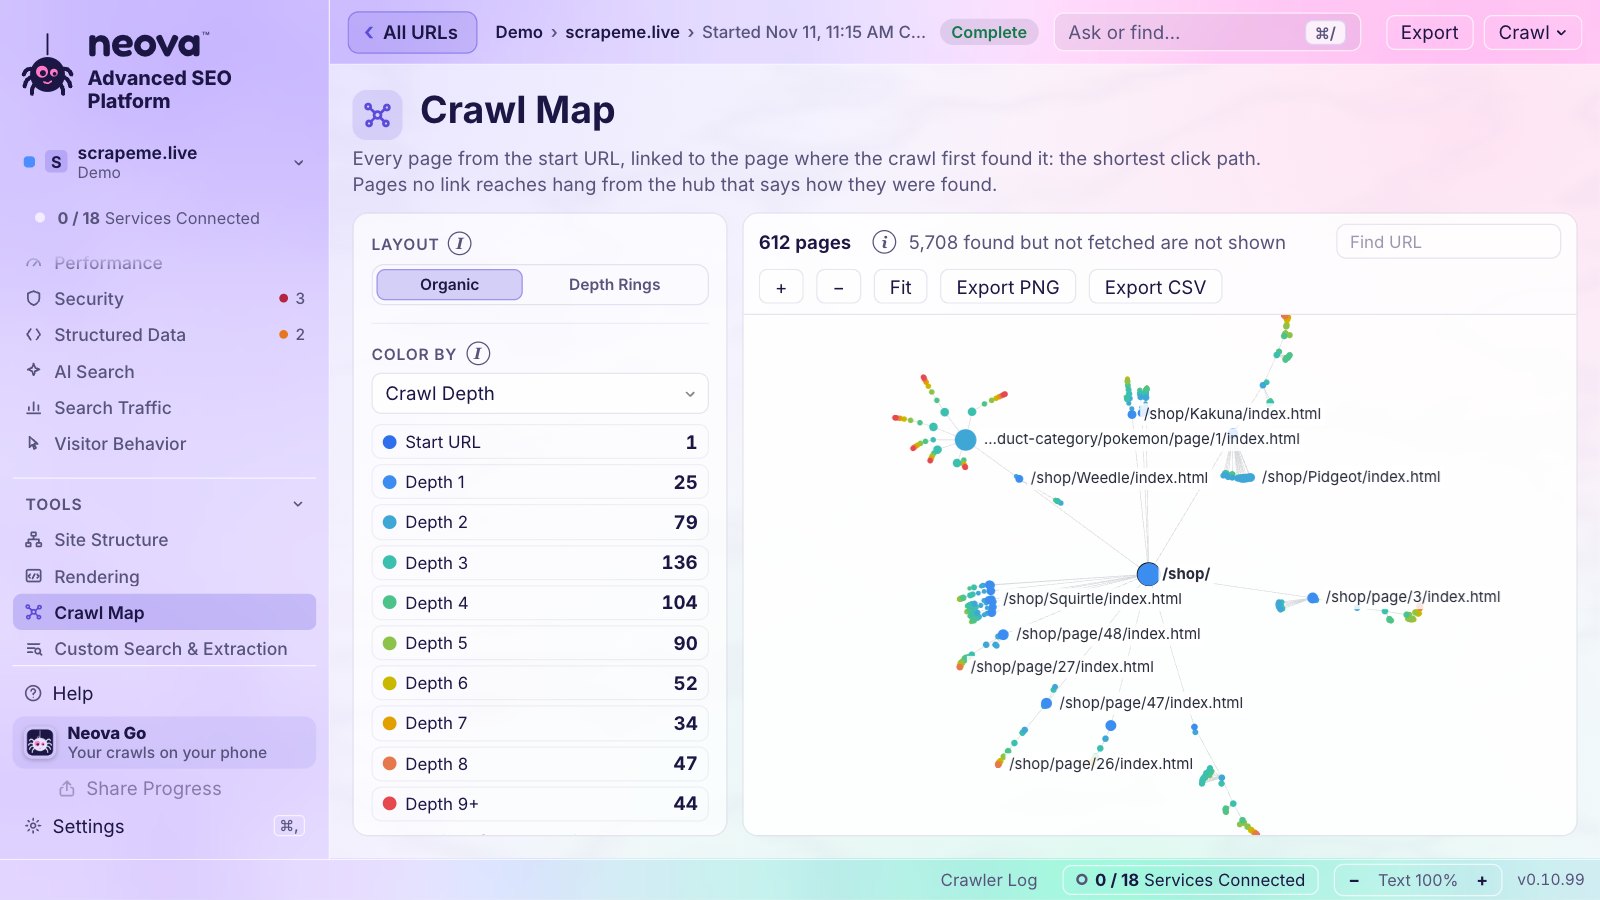
抓取地图
抓取地图每个页面最初是如何被发现的,按状态着色。
所有 URL
所有 URL每个 URL 及其状态、可索引性和大小。
历史数据
历史数据您的抓取和 Search Console 数据,在 Google 删除之后依然保留。
抓取日志实时显示抓取获取的每个 URL,附带彩色状态码和响应时间;步骤加粗,失败标红。一键复制,发给技术支持。
抓取被拦截,说清原因当网站拒绝抓取时,Neova 会说明原因(限速、防火墙、按国家屏蔽)和应对办法,并提供一个秘密的白名单请求头,交给 IT 部门即可。
诊断一次抓取读取抓取日志,指出出了什么问题:429、403、robots.txt 屏蔽、仅靠 JavaScript 的页面,并告诉您该改哪项设置。
URL 构成抓取过程中,发现的每个 URL 都归入且只归入一个类别,所以您总能知道多出来的几千个 URL 从哪里来。
可以实时跟进的抓取带箭头的步骤、最新 URL、实时抓取地图和响应时间图表,还有「分享进度」,让任何人都能跟进。
Search Console 和 Analytics 数据,永久保留Google 在 16 个月后删除 Search Console 数据,在 2 个月或 14 个月后删除 Analytics 事件数据。Neova 每个月按计划把两者的数据归档到您的电脑上:来自 Search Console 的页面、查询、每日数据和 Discover;来自 Analytics 的每日数据、自然搜索着陆页、渠道、来源和国家/地区。想保留多久就保留多久。
开始前心里有数先读取几个页面,告诉您站点地图列出了多少个 URL、预计有多少张图片,由您决定抓取的规模。
不会丢失的抓取页面优先、磁盘保护、退出时保存抓取、更新会等抓取完成,「继续」按原设置接着抓取。
先看费用DataForSEO 的费用在花钱之前就先估算,每次抓取都有上限。数据费用由您直接支付,按服务商的价格。
用真实数据试一试每个 Neova Online 账户都自带一个演示:一个商店和三个竞争对手,已经抓取完毕,每项设置都已填好。
您的密钥始终归您每个密钥、令牌和登录信息都存进系统钥匙串,绝不写入文件或显示在屏幕上。Neova 不内置自己的 API 密钥:您用什么付费,账单就直接给您。
支持 15 种语言界面和检查项库支持英语、法语、德语、西班牙语、葡萄牙语、意大利语、日语、荷兰语、波兰语、土耳其语、韩语、中文、俄语、印尼语和越南语。

可连接

31 项服务

Neova 可连接您已经在用的 31 项服务,从 Google Search Console 到 Slack、Jira 和您自己的云盘。每一项都是可选的。

Google
  • Google Search Console
  • Google Analytics
  • Chrome UX Report
  • Google Cloud
  • Gemini
Microsoft 与 Bing
  • Bing Webmaster Tools
  • OneDrive
  • Microsoft Teams
SEO 数据
  • DataForSEO
  • Semrush
  • Ahrefs
  • Majestic
  • Moz
  • SEO Gets
AI
  • Anthropic
  • OpenAI
  • Ollama
工单
  • Jira
  • Linear
  • Asana
  • ClickUp
  • monday.com
警报与日志
  • Slack
  • Microsoft Teams
  • Cloudflare
文件和存储
  • Google Drive
  • Dropbox
  • iCloud Drive
  • Proton Drive
  • kDrive
  • OneDrive
可打开它们的抓取
  • Screaming Frog
  • Sitebulb

标志归各自所有者所有,仅表示 Neova 可以连接这些服务。Neova 与其中任何一家都没有关联。

并排对比

78 项功能

每项功能,每款工具一个标记。点「显示详情」可看到每款工具具体怎么做,并附上该工具自己文档的出处页面。

在哪里抓取、怎么抓取Screaming Frog 15Sitebulb 13Semrush 10Ahrefs 10Lumar 13JetOctopus 13Neova 17共 17 项
功能Screaming FrogSitebulbSemrushAhrefsLumarJetOctopusNeova
桌面应用✓「运行 SEO Spider 需要 64 位操作系统。」来源✓仅限 Windows 和 macOS(「64 位版本的 Windows 10 或 11」)来源–文档中未找到。来源–只有网页应用,无需安装 来源–纯云端 SaaS,没有桌面应用 来源–只有云端 SaaS,没有桌面应用 来源✓Mac(Apple 芯片)、Windows 和 Linux
在浏览器中◐部署在您的服务器没有浏览器版或托管版。来源✓Sitebulb CloudSitebulb Cloud:「Sitebulb Cloud 让您通过网页浏览器使用桌面版的全部功能。」每位客户都有一台类似 yoursite.sitebulb.cloud 的服务器。来源✓网页应用完全基于浏览器:Semrush 称自己是「领先的在线可见度管理 SaaS 平台」。来源✓网页应用Ahrefs 只有云端版 来源✓网页应用基于浏览器的 SaaS:「我们以软件即服务(SaaS)方式,通过受支持的网页浏览器提供对应用的访问」来源✓网页应用基于浏览器的云平台 来源✓Neova Online任意浏览器中的 Neova Online,与桌面应用使用同一账户,保持同步
JavaScript 渲染✓「使用内置的 Chromium WRS 渲染网页,以抓取动态的、大量使用 JavaScript 的网站和框架,如 Angular、React 和 Vue.js。」仅限付费许可证。来源✓Chrome Crawler:「Sitebulb 使用 Evergreen Chromium 渲染引擎,和 Google 一样」来源✓有,限 Guru 或 Business 套餐(Semrush One Pro+ 或 Advanced)来源✓「Execute JavaScript」抓取设置 来源✓Page Rendering Service 来源✓「JavaScript 渲染抓取模式包含在套餐价格中(不另收费)」,但「一个 JS 渲染页面按两个普通抓取页面计」。来源✓Chrome,可用于所有页面或指定数量的页面
列表模式✓「Mode > List」:「检查预先定义的 URL 列表……」来源✓「URL List」抓取来源 来源✓「Import URLs from file」抓取来源 来源✓「Custom URL list」种子来源 来源✓URL 列表抓取来源 来源✓「URL list」抓取模式 来源✓列表抓取
XML 站点地图抓取✓「单独抓取 XML 站点地图或作为抓取的一部分,以找出缺失、不可索引和孤立页面」来源✓Crawl Sources「可以配置为同时抓取 XML 站点地图中的 URL 和/或提供的 URL 列表」。来源✓抓取来源「Robots.txt sitemap」和「Sitemap by URL」,但「Site Audit 一次只使用 1 个站点地图 URL」来源✓以「Auto-detected sitemaps」或「Specific sitemaps」作为 URL 来源 来源✓站点地图抓取来源,可单独使用或与网页抓取一起 来源✓「Only Sitemap」抓取模式,或把站点地图作为额外的 URL 来源 来源✓XML 站点地图可纳入抓取,也可单独抓取
包含与排除规则✓正则表达式「Configuration > Include」和「Configuration > Exclude」来源✓「Include & Exclude URLs」设置 来源✓「Allow subfolders」和「Disallow subfolders」规则,加上「Parameters to ignore」,让 Site Audit 在抓取时去掉 URL 参数。来源✓正则规则:「Only crawl URLs matching the pattern」和「Don't crawl URLs matching the pattern」,加上「Remove URL parameters」和 URL 重写规则。来源✓「Included Only URLs」和「Excluded URLs」字段(Ruby 正则 来源✓高级设置中的「Allow Pattern」和「Deny Pattern」规则,可写 URL 路径,或加「rx:」前缀写正则 来源✓包含、排除,以及适用于每次抓取的排除列表
抓取速度限制✓「通过并发线程数或每秒请求的 URL 数来控制 SEO Spider 的速度」(默认 5 个线程)。来源✓线程数或 Chrome 实例数,以及「Max HTML URLs per Second」来源✓三种抓取延迟选项 来源✓默认速度「限制为每分钟最多 30 个 URL」来源✓抓取速度按每秒 URL 数计(账户上限由 Lumar 设定),还可以「添加限制,在特定时段降低或提高抓取速度」。来源✓「速度由您选择(线程数)」来源✓按每秒请求数设置,网站吃力时会自动放慢
robots.txt 测试工具✓「自定义 robots.txt 配置,可以下载、编辑和测试网站的 robots.txt」来源◐「Virtual robots.txt」可获取线上文件、编辑后用您的版本抓取 来源◐没有 URL 测试工具。Robots.txt 报告会标记文件问题和「robots.txt 文件的任何变更」来源◐没有 robots.txt 测试工具。来源✓robots.txt Overwrite,用于在整个抓取中「在新 robots.txt 上线之前进行测试」来源✓免费的 Robots.txt Multi-tool「验证您的 robots.txt 文件,突出显示相互冲突的指令」,并按爬虫模拟规则 来源✓robots.txt 测试工具;遵守、忽略或使用草稿版本
自定义 User-Agent✓「内置 Googlebot、Bingbot、各种浏览器等 User-Agent 预设」,外加自定义 HTTP 请求 User-Agent 和单独的 Robots User-Agent。来源✓预设「包括 Google、Bing、Yahoo 和 Yandex」,外加「Custom User Agent」和自定义 robots.txt UA。来源◐只有三个固定选项 来源◐只有两个 AhrefsSiteAudit 字符串 来源✓「多种 User-Agent……」来源◐只有预设,「共有 5 个 User-Agent」来源✓任意 User-Agent,还可以以 AI 爬虫身份抓取
登录与身份验证✓「两种身份验证方式:基于标准的验证(包括 basic 和 digest 验证),以及基于网页表单的验证。」来源✓HTTP 身份验证和基于表单的身份验证,外加自定义 HTTP 请求头。来源◐只有 basic 验证:「Crawl with my credentials」用于「受 basic 访问验证保护」的网站,外加 Web Bot Auth 签名选项。来源◐只有 HTTP 身份验证,限 Advanced 及以上套餐 来源◐basic 验证(「在所有请求中使用 basic 验证附带验证凭据」)、自定义 DNS、IP 白名单,以及通过自定义请求头传递登录 cookie 来源◐「在 HTTP Auth 下输入用户名(登录名)」来源✓身份验证、请求头和表单
暂停与继续✓应用内暂停和继续(「抓取暂停后可以继续」)来源✓「Sitebulb 允许您暂停,然后在方便的时候继续」来源–文档中未找到。来源–文档中未找到。来源✓达到抓取上限时,可以「调整抓取设置、继续抓取或结束抓取」来源✓正在运行的抓取可以暂停和继续 来源✓暂停、继续,退出时先保存抓取
同时抓取多个网站✓每个抓取一个窗口FAQ:「打开多个 SEO Spider 实例,每个要抓取的域名一个」,或用列表模式加一份域名列表。来源◐Cloud:Medium 及以上桌面版把诊断排队(「它们会依次运行」)来源✓最多 5 个「Number of Audits Running at Once」来源–文档中未找到。来源✓无限制FAQ:「无论大小,所有抓取都可以同时运行」,以及「我们不限制您可抓取的不同域名数量」。来源✓不限「所有 JetOctopus 套餐的同时抓取数量都不受限制,且不额外收费。」项目和域名数量也不受限制。来源✓一个窗口 4 个最多同时抓取 4 个网站,各按各的速度,带内存保护(0.10.38)
URL 上限✓不限,需付费免费版:每次抓取 500 个 URL。来源✓1 万至 1000 万Lite「每次诊断 10,000 个 URL」来源✓2 万至 10 万每次诊断:免费版 100 个,Pro 和 Guru 20,000 个,Business 100,000 个。来源✓2.5 万至 500 万每月抓取额度 来源◐按套餐设定未公布套餐限制 来源✓100M+它「可以抓取超过 1 亿个 URL 的网站」来源✓无限制在您的电脑上,我们不设任何上限
抓取陷阱,实时发现◐没有专门的陷阱报告。来源◐提示「URL contains repetitive elements」(「通常是爬虫遇到使用相对 URL 的链接时造成的」)来源–文档中未找到。来源◐没有陷阱检测;靠可配置的上限来封顶,例如 来源✓「Pages with Repeated Paths 报告可识别由格式错误的链接产生无限 URL 而导致的爬虫陷阱」来源◐没有专门的爬虫陷阱报告 来源✓发现:每分钟更新新 URL 的来源,标记抓取陷阱,抓取过程中可选择保留、跳过或排除
页面组✓「Configuration > Segments」来源◐自动按 HTML 模板分组,以「按模板细分 SEO 问题」来源✓有,在 Semrush Enterprise Site Intelligence 中 来源✓按筛选条件(子文件夹、子域名)「Segment crawls」来源✓Segmentation:「基于 Lumar 丰富的指标创建自定义细分」,附细分趋势和 Monitor 警报 来源✓「我们不限制细分的数量」来源✓从 HTML 识别出的页面组,以及细分
抓取可视化✓力导向抓取图和目录图(2D 与 3D)、抓取树和目录树图、词云,以及语义内容聚类图(v22.0)。来源✓交互式「抓取地图」(获 2018 年 US Search Awards「Best Software Innovation」奖)、其他网站可视化、图表和时间线。来源◐图表,加上「Site Structure」视图,展示「子域名和子文件夹,以及各自的 URL 数和问题数」。来源✓针对可索引性、加载速度、重复和状态码「用图表可视化数据」来源◐仪表盘和每份报告中都有分布图、漏斗图和趋势图(「Trends & Segments」「Breakdown」标签页)。来源✓「JetOctopus 提供 97 份以上报告、381 张图表、26 个数据集」来源✓抓取地图
抓取对比✓「Mode > Compare」按标签页和筛选条件显示 Added、New、Removed 和 Missing 的 URL,另有 Change Detection 标签页和网站结构对比(需要许可证和数据库存储 来源✓「Audit Comparison」:「跟踪随时间的变化,找出与上次诊断相比有什么不同」来源✓「Compare Crawls」可以「并排对比您过去的任意一次网站诊断」,并列出已修复和新出现的问题 来源✓「Site Audit 可以对比任意两次抓取」来源✓每份报告都与上一次抓取对比 来源✓「您可以对比任意抓取,而不只是最近两次」,包含所有爬虫图表和数据表,也可按细分对比 来源✓比较抓取
内容Screaming Frog 8Sitebulb 5Semrush 4Ahrefs 3Lumar 5JetOctopus 4Neova 7共 8 项
功能Screaming FrogSitebulbSemrushAhrefsLumarJetOctopusNeova
重复与近似重复内容✓按 md5 哈希识别完全重复 来源✓相同的 HTML、技术上相同的 URL、重复的 title、description 和 H1 来源✓「如果 Site Audit 爬虫发现多个页面内容相似度达 85%,就会将其标记为重复内容。」另有重复的 title 和 description 来源✓针对 title、description、H1 和内容的重复报告 来源✓「Duplicate Pages」指具有「相同的 title、description 和几乎相同的内容」的页面 来源✓针对 title、description、H1、H2 和主体内容的「Duplication」报告,「可以选择重复百分比」来源✓重复与近似重复内容
单薄内容✓Content 类别中的「Low Content Pages」检查、每页字数,以及「Low Relevance Content」。来源✓「轻松检查单薄内容」来源✓警告「Pages with a low word count」(少于 200 词)来源✓字数少的页面 来源✓「Thin Pages」:「内容少于 Thin Page Threshold 但多于 Empty Page Threshold 的可索引页面」来源✓问题列表会对少于 100 词的页面标记「Low content words (11-100)」来源✓内容单薄和体积过大的页面
可读性✓「SEO Spider 使用 Flesch Kincaid 易读性分数评估可读性」来源✓「Check Readability」给出 Flesch Reading Ease 分数,外加 AFINN-111 情感分析。来源✓「Content not optimized (AI Search)」提示会检测「Low readability」来源–文档中未找到。来源–文档中未找到。来源–文档中未找到。来源✓可读性
拼写与语法✓对 HTML 页面做拼写和语法检查 来源◐拼写检查器,带各语言词典,并可根据 HTML lang 属性自动识别语言(Pro)。来源◐仅限 Content Toolkit 来源◐一个单独的免费 AI Grammar Checker,用于粘贴的文本(1,024 个字符)来源–文档中未找到。来源–文档中未找到。来源✓拼写与语法
自定义搜索与提取✓自定义源代码搜索,以及「Custom Extraction:使用 XPath、CSS Path 选择器或正则表达式从 URL 的 HTML 中抓取任意数据」来源✓按 CSS 选择器提取内容(点选式可视化选择器)来源–文档中未找到。来源◐无需设置的搜索 来源✓正则 Custom Extraction(30 个提取指标)来源✓「一次抓取中最多可配置 50 条自定义提取规则」来源✓搜索与提取
页面内容的 AI 审阅✓OpenAI, Gemini, Anthropic, Ollama直接通过 API 集成 OpenAI、Gemini、Anthropic 和 Ollama(LM Studio 通过 OpenAI 集成接入)来源◐MCP,只读抓取期间不会对页面内容运行 AI 提示词。来源◐一次一页Content Toolkit,一次一个页面 来源◐预设任务只有固定的 AI 任务:「Ask AI」和「Batch AI」撰写 title 和 meta description(Project Boost),外加 AI 内容检测 来源◐内置不能对页面内容使用用户自写的提示词。来源◐内置,MCP不会对每个页面运行用户提示词 来源✓Ollama, Anthropic, OpenAI44 项 AI 审阅检查,由 Ollama 在您自己的电脑上运行;Anthropic 和 OpenAI 密钥在「连接」中设置
语义相似度✓使用 OpenAI、Gemini 或 Ollama 的向量嵌入,「识别语义相似的页面和低相关性内容,并支持语义搜索和内容聚类图」来源◐没有内置功能。其网站上有一篇指南(2026年10月8日,客座作者)来源–文档中未找到。来源◐Duplicates 会把页面「按内容相似度分成聚类」来源✓Relevance Reporting 扩展 来源◐仅在 AI Internal Linker 内部使用,它「按分类字段和 AI 文本嵌入为页面配对」来源–暂未支持
内容检查项✓11Issues 库,Content 类别 来源✓29Hints 库:On Page 22 项、Duplicate Content 7 项(合计 29 项),外加 Spelling Errors 和可读性报告。来源✓共 140+ 项「可检查 140 多种网站问题」来源✓共 170+ 项在技术和页面类别中「扫描 170 多种问题」,外加自定义问题 来源✓43 个报告未公布总数。这是我们对其 API 报告列表的统计 来源✓共约 100 项约 100 项:问题扫描运行「约 100 项预置检查,覆盖抓取、日志和 Search Console,按严重程度分组」。来源✓8282 项内容检查,其中 20 项是 AI 审阅
技术 SEOScreaming Frog 14Sitebulb 13Semrush 9Ahrefs 10Lumar 14JetOctopus 9Neova 14共 14 项
功能Screaming FrogSitebulbSemrushAhrefsLumarJetOctopusNeova
状态码✓Response Codes 标签页:被 robots.txt 屏蔽、无响应、2XX、3XX、4XX 和 5XX,涵盖内部和外部 URL。来源✓「Status Code:HTTP 状态码(例如 来源✓错误「Pages returning 4XX status code」和「Pages returning 5XX status code」、DNS 和抓取失败,外加对返回 403 的外部链接的提示。来源✓非 200 页面「列在各自对应的问题下」(404、4XX、5XX、403、超时、失效重定向)来源✓针对 200 页面、301 和非 301 重定向、「4xx Errors」「5xx Errors」「Uncategorized HTTP Response Codes」以及失败 URL 的报告 来源✓抓取和日志中的状态码图表与数据表 来源✓有,处处按颜色区分
重定向与重定向链✓「找出临时和永久重定向,识别重定向链和循环」来源✓13 条 Redirects 提示(失效重定向、重定向循环、末尾斜杠和大小写重定向、meta refresh)来源✓「Redirect chains and loops」(Error)、「Pages with temporary redirects」「URLs with a permanent redirect」来源✓「Redirect chain」问题「报告经过一连串重定向的 URL」来源✓「Redirect Chains」(「重定向到另一个同样是重定向的 URL」)、「Redirect Loops」、失效重定向、JavaScript 和 meta refresh 重定向,以及「Max Redirections」报告。来源✓重定向链数据表,其中「还可以修改重定向链的跳转次数」来源✓22 项重定向检查,涵盖重定向链和循环
canonical✓Canonicals 标签页涵盖 canonical link 元素和 HTTP 响应头 来源✓Indexability 提示涵盖 canonical 标签 来源✓错误「Pages with a broken canonical link」「Pages with multiple canonical URLs」和「AMP pages with no canonical tag」来源✓「Canonical points to redirect」、canonical 指向 4XX 或 5XX、把非 canonical 页面指定为 canonical,以及 HTTP/HTTPS canonical 不一致等问题。来源✓「Conflicting Canonical Tags」(「HTML canonical 标签或 HTTP 响应头中的冲突」)、Canonical to Non-200、Pages without Canonical Tag、Unlinked Canonical Pages、Change 来源✓针对 rel=canonical,「我们制作了几份报告,涵盖最常见的问题」,另有一个针对独立移动子域名的专门模式。来源✓是
可索引性报告✓每个 URL 都标为「Indexable」或「Non-Indexable」,并附「Indexability Status」原因 来源✓「检查重叠或不一致的 robots 指令、canonical 问题和 robots.txt 配置错误」来源◐没有可索引性列或报告 来源✓可索引性问题类别和分布图 来源✓「Non-Indexable Pages」(「因 noindex 或 canonical 而无法被索引」),以及 noindex、已 canonical 到其他 URL 和被禁止抓取的报告 来源✓所有报告内置「Indexable」细分 来源✓145 项可索引性检查
分页✓针对 rel='next' 和 rel='prev' 的 Pagination 标签页 来源◐提示「Pagination URL has no incoming internal links」和「Query string contains paginated parameters」来源–文档中未找到。来源◐会读取 rel next/prev 用于重复分组,但没有记录任何分页问题 来源✓「Paginated 2+ Pages」来源✓在抓取和日志中检查分页页面的可抓取性 来源✓分页检查项
hreflang✓「诊断缺失的返回标签、不一致和错误的语言代码、非 200 响应的 hreflang 等」来源✓「检查 hreflang 标签是否有效、互相对应、唯一、一致并自我引用」来源◐International SEO 报告检查冲突、取值、失效链接和缺失标签,但「目前 Semrush 只检查网站的 HTML」(不检查站点地图或响应头)。来源✓标记无效代码、缺少自我引用、缺少返回标签、hreflang 指向失效或非 canonical 页面 来源✓15 份 hreflang 报告,例如 来源✓「Indexation」报告显示「抓取中发现的 hreflang 问题列表」来源✓37 项 hreflang 检查
结构化数据验证✓「提取结构化数据,并按 Schema.org 规范和 Google 富媒体搜索结果功能进行验证。」来源✓「同时按 Schema.org 和 Google 搜索功能指南(富媒体搜索结果)验证结构化数据」(Pro)。来源✓Markups 报告区分「invalid vs. 来源✓它「按 schema.org 词汇表和 Google 指南验证结构化数据」来源✓Rich Results Validation 扩展 来源◐只提取,不验证 来源✓15 项结构化数据检查
XML 站点地图诊断✓Sitemaps 检查:「URLs Not In Sitemap」「Orphan URLs」「Non-Indexable URLs In Sitemap」「XML Sitemap With Over 50k URLs」「XML Sitemap Over 50mb」「URLs In Multiple Sitem 来源✓9 条 XML Sitemaps 提示(4XX、5XX、noindex、已 canonical 到其他 URL、被禁止抓取、重定向、超时、URL 出现在多个站点地图中)、孤立页面检测,以及 XML 站点地图生成器。来源✓错误如「Format errors in sitemap.xml files」「Incorrect pages found in sitemap.xml」「Sitemap.xml files are too large」来源✓站点地图问题,如「Non-canonical page in sitemap」、站点地图中的 noindex、3XX、4XX 或 5XX 页面、超时的站点地图页面和格式无效(仅限 XML)。来源✓站点地图中不可索引、出错和重定向的 URL,失效或被禁止抓取的站点地图,URL 过多,空站点地图 来源✓站点地图报告,含孤立 URL 和非 200 URL、「Sitemaps problems by depth」和「Sitemap files」表 来源✓20 项 XML 站点地图检查
内链与链接得分✓「分析内链、链接数量、抓取深度,并计算内部 Link Score」来源✓「URL Rank(UR)是基于相对链接权重衡量内部页面强度的指标」来源✓Internal Linking 报告和每个页面的 ILR 来源✓Page Rating(PR)为每个 URL 的链接强度打分,「采用 1 到 100 的对数刻度」来源✓DeepRank:「衡量内部链接权重的指标,计算方式类似 Google 的基础 PageRank 算法」,范围 0 到 10 来源◐深入的链接分析(入链、锚文本、nofollow、Linking Explorer)来源✓链接得分和 51 项链接检查
孤立页面✓「要发现孤立页面,需要额外的 URL 来源,这些来源来自 XML 站点地图以及 Google Analytics 和 Search Console API 的集成。」来源✓孤立页面是「在诊断中发现、但不是由爬虫发现的 URL」,通过 XML 站点地图、Google Analytics、Search Console 或 URL 列表找到 来源✓提示「Orphaned pages (from Google Analytics)」和「Orphaned pages (in sitemap)」来源◐「Orphan page」涵盖没有内链指向、来自抓取种子或「在站点地图文件中找到」的 URL 来源✓按来源(Search Console、分析工具、站点地图、日志文件、URL 列表、反向链接)分列的孤立页面报告,例如 来源✓基于站点地图和 GSC URL 来源的「Orphan Pages」报告,可按来源筛选 来源✓孤立页面,来自 Search Console、Analytics 和 XML 站点地图
安全与 HTTPS✓「发现不安全的页面、混合内容、不安全的表单、缺失的安全响应头等」来源✓Security 报告检查 TLS 协议、加密套件和证书 来源◐HTTPS 检查(混合内容、证书、旧版 TLS、「Subdomains don't support HSTS」)来源◐HTTPS 检查,如「HTTPS page has internal links to HTTP」、HTTPS 到 HTTP 的重定向和混合内容 来源✓「HTTPS Pages without HSTS」、HTTP 页面、HTTPS 页面上的 HTTP 脚本、混合内容、HTTPS 到 HTTP 的链接 来源◐仅限 HTTPS 混合内容,如「Links to HTTP pages (mixed content)」和 HTTP 图片 来源✓29 项安全检查
AMP✓「抓取 AMP URL,并用官方集成的 AMP Validator 进行验证」来源✓19 条 AMP 提示(Pro)。来源✓有,仅限 Business 套餐 来源–文档中未找到。来源✓AMP 验证,例如「Invalid AMP Pages」(「未通过 AMP 验证器」)来源–文档中未找到。来源✓AMP 检查项
移动端✓「使用 Lighthouse 检查常见的移动端可用性问题」来源✓13 条 Mobile Friendly 提示 来源✓「Site Audit 默认使用 SiteAuditBot (Mobile) 抓取」来源✓「抓取移动网站…… 来源✓移动端配置报告(响应式、动态服务、独立移动网站)、「Discouraged Viewport Types」(「移动端兼容性差」)、独立移动网站的不一致 来源✓Googlebot Mobile 抓取「会暴露移动端可用性问题」,如「viewport 配置错误、字号不合规、点按目标」来源✓viewport 与移动端检查项
图片✓缺少 alt 文本和 alt 属性、「Over 100 kb」、超过 100 个字符的 alt 文本、「Incorrectly Sized Images」「Missing Size Attributes」、背景图片、缺失图片 t 来源✓「Images with missing alt text」「Has an anchored image with no alt text」「Transferred image size is over 100KB」「Properly size images」「Add dimensions to images」,以及 next 来源◐「Images without alt attributes」(Warning)来源✓「我们检查图片大小、加载时间和内容类型」,以及失效图片和 alt 属性(「Set」和「Not set」)来源✓「Broken Images」「Links with Images Missing Alt Tags」、无障碍 image-alt 规则,以及 Site Speed 中的 Lighthouse 图片审计(未设尺寸、屏幕外、未优化、非响应式 来源◐图片抓取(默认关闭)来源✓20 项图片检查,并按页面组抽样图片
速度与 Core Web VitalsScreaming Frog 3Sitebulb 1Semrush 1Ahrefs 4Lumar 4JetOctopus 3Neova 4共 4 项
功能Screaming FrogSitebulbSemrushAhrefsLumarJetOctopusNeova
Lighthouse✓「连接 PSI API,获取 Lighthouse 指标、速度优化建议、诊断信息和 Chrome 用户体验报告(CrUX)来源✓由内置 Chrome Crawler「在抓取的每一个网页上」运行 Lighthouse「Opportunities and Diagnostics」,另有 Web Vitals 实验室指标(LCP、CLS、TBT、TTI、FCP 来源✓Core Web Vitals 报告「由 Google 的 Lighthouse 工具驱动」(LCP、CLS、TBT)来源✓每个页面的 PageSpeed Insights,需要您自己的免费 Google API 密钥 来源✓在 Site Speed 中:「大规模的 Lighthouse 性能指标」,每个页面有优化建议和诊断报告,并内嵌 Lighthouse Viewer(2025年6月)。来源✓使用您自己密钥的 PageSpeed API(「每天上限为 30,000 次请求」)来源✓「新建抓取」中的 Lighthouse,27 项检查
真实用户的 Core Web Vitals✓通过 PageSpeed Insights API 来源–文档中未找到。来源–文档中未找到。来源✓每个页面的 CrUX LCP、INP、CLS 和 FID,附分级和分布 来源✓在 Site Speed 中:CRUX Domain Summary「显示主域名和其他已发现域名的 CrUX 指标」(CLS、FCP、INP、LCP、TTFB)。来源✓通过 PageSpeed API 来源✓真实 Chrome 用户的 LCP、INP 和 CLS,使用您的 Chrome UX Report 密钥
Core Web Vitals 趋势◐未找到应用内的 CWV 趋势图。来源◐「Historical Audit Data」Google 表格每次诊断一行,用于在 Looker Studio 中制作「时间序列数据或图表」,并包含 Core Web Vitals 分级数值(更新日志,13 来源◐实验室数据(Lighthouse)来源✓Site Audit Performance 报告 来源✓在 Site Speed 中:「每项 KPI 一张趋势图」(FCP、LCP、TBT、CLS),分为 Slow、Moderate、Fast,每次抓取一个数据点(实验室数据)来源◐定时 CWV 检查(「+Create a CWV schedule」)来源✓从第一天起的 40 周趋势,并可按页面组查看
定时 Core Web Vitals✓定时抓取可以使用 PSI API 来源◐定时和周期性诊断(Pro 和 Cloud)来源◐仅在定时 Site Audit(「Weekly」「Daily」)中提供,其 Core Web Vitals 报告用 Lighthouse 重测同样的 10 个页面。来源✓开启 PSI 后,每次抓取都会获取 CWV,包括定时抓取 来源✓定时 Site Speed 抓取,外加 Monitor 来源✓为移动端或桌面端 URL 列表「+Create a CWV schedule」,然后「通过电子邮件、Slack 或短信」发送不限数量的 CWV 警报。来源✓按计划生成 Core Web Vitals 快照,无需抓取,并附警报
无障碍Screaming Frog 1Sitebulb 1Semrush 0Ahrefs 0Lumar 1JetOctopus 0Neova 1共 1 项
功能Screaming FrogSitebulbSemrushAhrefsLumarJetOctopusNeova
无障碍检查项✓92Deque 的「开源 AXE 无障碍规则集」(需要 JavaScript 渲染)。来源✓95+「借助 Deque 的 axe 库,Sitebulb 可以运行 95 项以上自动化无障碍检查」来源◐需加购没有 axe,也没有规则数量。来源–文档中未找到。来源✓90+基于 axe:WCAG 2.2 A、AA、AAA,以及「axe 数字无障碍库中的最佳实践」来源–文档中未找到。来源✓114114 项无障碍检查:带渲染的 axe-core,加上 Neova 自己的检查项
AI 搜索Screaming Frog 0Sitebulb 0Semrush 4Ahrefs 3Lumar 4JetOctopus 2Neova 4共 4 项
功能Screaming FrogSitebulbSemrushAhrefsLumarJetOctopusNeova
AI 爬虫:能否访问,拿到的是什么◐没有专门的 AI 爬虫报告。来源◐未找到 AI 爬虫报告或 AI 爬虫预设 来源✓「Blocked from AI Search」检查 robots.txt 对 ChatGPT-User、OAI-SearchBot、Googlebot、Google-Extended、Perplexity-User、PerplexityBot、Claude-User、Claude-SearchBot 的规则。来源✓AI Discoverability 问题(2026年9月)来源✓「ChatGPT Blocked」(「在 robots.txt 中对 GPTBot 或 ChatGPT-User 的 User-Agent 标识屏蔽」)、Google AI Blocked(Google-Extended)、Bing AI Blocked、AI Bot Blocked、Common 来源✓免费的 Robots.txt Multi-tool 可以「在一处检查搜索引擎和 AI 爬虫的访问规则」,包括 GPTBot、ClaudeBot 和 PerplexityBot。来源✓每个 AI 爬虫可以抓取什么,以及 10 个 AI 助手实际拿到的内容
llms.txt–文档中未找到。来源–文档中未找到。来源✓Site Audit 提示「Llms.txt not found (AI Search)」和「Llms.txt file has formatting issues (AI Search)」来源◐只有一个免费生成器(「为您生成完美的 llms.txt 文件」)来源✓在 Lumar 免费的 Agentic Readiness Scanner 中,与抓取平台分开 来源–文档中未找到。来源✓llms.txt 和智能体文件
面向 AI 回答的检查项◐没有专门针对 AI 回答的检查。来源◐没有针对 AI 回答的检查。Response vs Render 报告的卖点是「准确识别 LLM 能看到什么」来源✓AI Search 检查:「Too much content」「Outdated Content」(Last-Modified 超过六个月)、「Low Semantic HTML Usage」「Content not optimized」(标题、长段落、r 来源✓AI Discoverability:「对 AI 爬虫而言太慢或太重」的页面、「Pages requiring JavaScript rendering」「Similar AI-generated content」来源✓GEO Content Evaluator 来源✓AI Page Optimizer 会针对查询扇出「将目标关键词与 title、meta 和正文内容匹配」,并检查「JavaScript 是否对 AI 智能体隐藏了您的内容」。来源✓45 项 AI 搜索检查
您的品牌在 ChatGPT 和 Perplexity 中的表现–文档中未找到。来源–文档中未找到。来源✓有,在 AI Visibility Toolkit 中($99/月)来源✓Brand Radar 自定义提示词,覆盖 ChatGPT、Perplexity、Gemini、Copilot、AI Overviews 来源✓在 AI Visibility 中(按账户开通)来源–「JetOctopus 不跟踪 AI 回答中的引用、品牌提及或情感倾向」来源✓最多 20 条您的提示词,在 ChatGPT 和 Perplexity 中查询,通过您的 DataForSEO 账户
搜索数据Screaming Frog 3Sitebulb 3Semrush 5Ahrefs 5Lumar 4JetOctopus 3Neova 6共 6 项
功能Screaming FrogSitebulbSemrushAhrefsLumarJetOctopusNeova
Google Search Console✓「连接 Google Search Analytics 和 URL Inspection API」来源✓FAQ:「展示次数、点击次数、点击率、平均排名」「批量关键词数据」「通过 URL Inspection API 获取可索引性数据」。来源✓GSC 可连接 Position Tracking、On Page SEO Checker、Backlink Audit、Organic Traffic Insights、My Reports 和 Project Dashboard 来源✓「Link Google Account」导入「最多最近 16 个月的数据」,并持续保存 来源✓仅限 Search Analytics 来源✓「JetOctopus 从 GSC API 拉取尽可能多的数据,并合并多个资源」来源✓Search Console,每次抓取对 200 个 URL 做 URL 检查,并保留超出 Google 16 个月期限的每个月数据
Google Analytics 4✓「可以连接 GA4 API,在抓取过程中直接拉取数据」来源✓「连接 GA4,把互动数据带入诊断 来源✓GA 可连接 Site Audit、Position Tracking、On Page SEO Checker、Backlink Audit、Organic Traffic Insights 和 My Reports 来源✓Web Analytics 导入 GA 数据 来源✓GA4 和 GA360:每个 URL 的访问次数、跳出率、浏览量和转化,可筛选为自然搜索、「Google or Bing Organic Search Landing Pages, or All」来源✓「该集成仅适用于 Google Analytics 4。来源✓Google Analytics 4
Bing Webmaster Tools◐Bingbot 仅作为 User-Agent 预设 来源◐Bing 仅作为 User-Agent 预设 来源◐仅限 Bing 排名跟踪 来源◐Site Audit 通过 IndexNow 推送变更(「Bing、Yep 和其他搜索引擎支持」)来源◐没有 Bing Webmaster Tools 来源◐日志和 robots.txt 测试工具中的 Bingbot(「Googlebot、Bingbot、GPTBot、ClaudeBot 和 40 多种其他爬虫的完整数据」)来源✓Bing Webmaster Tools,包括 Bing AI 引用
排名跟踪◐没有排名跟踪工具。GSC Search Analytics 集成提供每个 URL 的平均「Position」。来源◐没有排名跟踪工具。Keywords 报告使用 GSC 数据 来源✓Position Tracking「每天监控您网站的搜索排名」,可按设备和地点「细到邮政编码」,覆盖 Google、Bing、百度、ChatGPT Search 和 AI Mode。来源✓Rank Tracker:Google,「移动端和桌面端跟踪」,190 多个地点细到邮政编码,19 种 SERP 功能 来源◐没有排名跟踪工具;只有每个页面和查询的 GSC 排名。来源◐基于 GSC 的排名,没有 SERP 排名跟踪工具 来源✓每天 25 个来自 Search Console 的跟踪搜索;通过 DataForSEO 获取真实排名
关键词数据◐每个 URL 的 GSC Search Analytics 指标(日期范围和维度可配置)来源✓基于 Google Search Console 生成的 Keywords 报告(「enable Keyword Analysis」),含品牌关键词。来源✓自有关键词数据库 来源✓Keywords Explorer:「从 1100 亿已发现关键词中筛选出 287 亿个」,217 个地点,搜索量、Keyword Difficulty、流量潜力 来源✓每个页面的 GSC 查询、最多 2,000 个上传的目标查询,以及「来自第三方提供商」的搜索量(Relevance Reporting)来源◐仅有 GSC 查询和 Ahrefs 关键词指标 来源✓Search Console 查询;通过 DataForSEO 获取关键词差距
反向链接指标✓「把 Majestic、Ahrefs 和 Moz API 的外部链接指标拉入抓取」来源–未找到 Ahrefs、Majestic 或 Moz 集成。来源✓自有反向链接索引(43T+ 条反向链接)来源✓Ahrefs 自有索引(「35T Live backlinks」)来源✓Majestic 集成(「在 Lumar 中集成 Majestic 反向链接数据是免费的」)来源✓仅限 Ahrefs,免费 beta 来源✓您的 Ahrefs、Majestic、Moz 或 Semrush 密钥,或 DataForSEO
竞争对手Screaming Frog 0Sitebulb 0Semrush 1Ahrefs 2Lumar 1JetOctopus 1Neova 2共 2 项
功能Screaming FrogSitebulbSemrushAhrefsLumarJetOctopusNeova
竞争对手并排对比◐可以抓取任何网站并对比两次抓取 来源◐可以诊断任何域名(「Crawl unlimited domains」)来源◐每个竞争对手是一个单独的 Site Audit 项目(「Enter your competitor's URL」)来源✓Site Audit 把无法验证的网站作为未验证项目抓取(「Lite 套餐 5 个,Enterprise 套餐 100 个」)来源◐可以抓取任何域名(「我们不限制您可抓取的不同域名数量」)来源✓「您可以抓取任何竞争对手,获取其结构、页面类型和模板」来源✓「竞争对手」界面:每项指标并排显示,按谁领先着色
发现竞争对手–文档中未找到。来源–文档中未找到。来源✓Position Tracking:「Competitors Discovery Report 揭示在您的关键词上有排名的自然搜索竞争对手」来源✓新项目会「根据在相似关键词上有排名的网站给出竞争对手建议」来源✓在 AI Visibility 中:「品牌会从 AI 服务商的回答中自动发现」,Lumar 将每个品牌归为 Own、Competitor、Other 或 Context。来源–文档中未找到。来源✓通过 DataForSEO 找出主要和次要竞争对手;从不包括商店或电商平台
监控与警报Screaming Frog 3Sitebulb 3Semrush 2Ahrefs 3Lumar 4JetOctopus 4Neova 5共 5 项
功能Screaming FrogSitebulbSemrushAhrefsLumarJetOctopusNeova
计划抓取✓「在 SEO Spider 中安排抓取自动运行,可以只运行一次,也可以按选定的间隔运行」,支持 API、导出和 Looker Studio 来源✓「Sitebulb Pro 和 Cloud 用户可以设置 Projects,运行一次性或周期性的定时诊断」来源✓计划可设为「Weekly」「Daily」或「Once」来源✓Schedule 标签页可设置「日期、时间和时区」来源✓「为您的抓取设置计划(例如 来源✓「New scheduled crawl」,频率可选每天、每周、每两周或每月,可设开始日期和时区 来源✓计划会提前通知,可推迟或跳过(桌面应用)
变更检测✓Compare 模式中的「Change Detection」标签页,针对所选元素(title、description、H1、字数等)来源✓「Lost and Found 把本次诊断的关键 URL 指标和触发的提示与最近一次诊断进行对比」(Found、Lost、Remained)来源◐抓取之间的对比,Robots.txt 报告「会告诉您 Semrush 是否注意到您的 robots.txt 文件有任何变化」。来源✓Always-on audit:「现在可以看到网站在任何一天发生的所有变化」来源✓Changed Metrics 按 URL 显示「哪些指标在两次抓取之间发生了变化」,另有 Pages with Changed Title、Status Code 和 Canonical URLs 等报告。来源✓警报加自定义提取,「跟踪页面元素的变化,看是否符合预期值」来源✓两次抓取之间的内容变化;抓取过程中变化会实时高亮
警报与通知✓抓取完成后通过 Outlook、Gmail 或自定义 SMTP 发送电子邮件,附 Issues 表 来源✓「每次诊断完成时,Sitebulb 都会给您发一封友好的邮件」(按项目设置,可填多个地址)。来源✓设置定时后,Site Audit 会发送「自动邮件更新」来源✓Always-on audit 会「在有新页面受到错误级问题影响时」发邮件(自定义问题也算),另有抓取完成邮件、Rank Tracker 报告和 Ahrefs Alerts。来源✓关于抓取进度的 Crawl Email Alerts 来源✓针对日志、GSC、抓取和 Core Web Vitals 的无限量警报 来源✓系统通知、手机上的 Neova Go、Slack 和 Microsoft Teams;电子邮件即将推出
Slack 和 Microsoft Teams–文档中未找到。来源◐「Sitebulb Cloud 可以与 Slack 集成,让您在 Slack 中接收诊断进度通知」(仅限 Cloud,需管理员用户)来源◐Slack 仅用于 Traffic & Market 竞争对手警报 来源◐未找到原生的 Slack 或 Teams 警报(警报只发邮件)。来源✓在 Lumar Monitor 中:警报「在应用内或通过电子邮件、Slack 或 Microsoft Teams」发送 来源✓「通过电子邮件、Slack 或 MS Teams 接收实时通知」来源✓Slack 和 Microsoft Teams,可按频道设置,另有 webhook
在手机上–文档中未找到。来源–文档中未找到。来源◐一款只看排名的 iOS 应用 来源◐未找到手机应用。云端网页应用可在手机上使用 来源–文档中未找到。来源–文档中未找到。来源✓手机上的 Neova Go,Neova Online 也适配手机
报告、导出与工单Screaming Frog 4Sitebulb 4Semrush 6Ahrefs 5Lumar 5JetOctopus 4Neova 7共 7 项
功能Screaming FrogSitebulbSemrushAhrefsLumarJetOctopusNeova
PDF 报告◐未找到内置的 PDF 诊断报告。来源✓「可以为任意单份报告或整个诊断生成 PDF 报告,合成一份文档」,可选择报告、图表和表格。来源✓任何 Site Audit 标签页都可导出为 PDF 来源✓Report Builder:「点击 Print to PDF 按钮」来源◐未找到 PDF 诊断报告。来源✓「可以用 Export 按钮把 Logs、Crawler、GSC 和大多数其他板块的报告保存为 PDF」。来源✓品牌报告,带上您的 logo
带品牌的报告–文档中未找到。来源◐PDF 报告可按板块定制,其功能页上一条客户评价称赞「完全白标的 PDF 和 CSV 报告」来源✓有,需 Pro Report 附加组件(每份报告 $20/月)来源–「目前我们不允许对报告进行白标。」来源◐FAQ:「界面可以用您自己的 logo 进行白标」。来源◐应用本身不支持 来源✓品牌报告,并可按资源设置品牌
Excel、Google 表格、Looker Studio✓导出格式「CSV, Excel 97-2004 Workbook, Excel Workbook and Google Sheets」来源✓CSV 和 .xlsx 导出 来源✓Site Audit 可导出 Excel、CSV、PDF 来源✓电子表格格式的 CSV 导出、Google 表格导出(Keywords Explorer、Brand Radar、Bot Analytics)、适用于 Site Audit、Site Explorer、Rank Tra 的 Looker Studio 连接器 来源✓CSV 报告下载(另有适用于 Excel 的 CSV with Exploded Metric)、带模板的「Google 官方合作伙伴」Looker Studio 连接器,以及通过 Zapi 实现的 Google 表格仪表盘 来源✓导出到「Excel、Google Sheets、CSV 或 Google Data Studio (Looker)」来源✓Excel 工作簿(可转为 Google 表格),可直接用于 Looker Studio 的 CSV
导出位置✓本地文件夹;以 Google 表格形式保存到 Google Drive(手动或定时 来源✓CSV 和 .xlsx 导出,每次诊断后自动保存到本地文件夹,「或共享保存文件夹,例如 Dropbox 这样的云存储服务」来源✓Excel、CSV 和 PDF 文件 来源✓CSV 下载、Google 表格(部分报告)、通过打印生成 PDF、Looker Studio 连接器,外加 API v3 和 MCP 来源✓CSV 或 XML 报告下载、Parquet 格式的原始数据、BigQuery 和 Looker Studio 连接器、通过 Zapier 接入 Google 表格、BI 工具(Tableau、Power BI)、API 和 webhook 来源✓从数据表导出 CSV、Excel、Google 表格和站点地图文件,另有 Data Studio 连接器、BigQuery(「把抓取和 GSC 数据直接导出到 BigQuery」)、API 和 MCP。来源✓Google Drive、OneDrive、Dropbox、iCloud Drive、Proton Drive、kDrive、SFTP 或 FTPS,以及任意文件夹
自定义仪表盘✓v25.0 Dashboard 标签页:用小组件(图表、计数器、百分比、概览表、问题列表、细分图表……)「构建您自己的自定义仪表盘」来源◐通过 Data Studio(Looker Studio)来源✓My Reports 可构建自定义报告和 Online Dashboards 来源✓Report Builder 小组件,来自 Site Explorer、Rank Tracker、GSC、Brand Radar、Site Audit 来源✓在 Lumar Monitor 中:由所选项目和细分构建的看板和仪表盘(「跨多个网站」)来源◐未提到应用内的仪表盘构建器 来源✓仪表盘,外加最多 10 个您自己的仪表盘
先修什么✓每个问题都有类型(Issue、Warning、Opportunity)来源✓Hints 带有重要程度(Critical、High、Medium、Low、Insight)和类型(Issue、Opportunity、Potential Issue)来源✓按严重程度分为 Errors、Warnings 和 Notices 来源✓问题分为「Errors (red)」「Warnings (yellow)」和「Notices (blue)」,重要程度可按工作区修改 来源✓「每份报告都有一个权重」来源✓AI SEO Recommender 给出「一份简短、排好序的最大问题清单」,可按页面数或 GSC 展示次数重新排序。来源✓按损失的点击数排序的标记,以及行动计划
工单与 Jira–文档中未找到。来源◐没有原生 Jira 集成 来源◐只有原生的「Send to Trello」来源◐未找到 Jira 集成。来源✓Jira Cloud 集成 来源–文档中未找到。来源✓发送到 Jira 并保持同步;工单随抓取自动关闭和重新打开;可为 10 种跟踪工具导入文件
平台Screaming Frog 4Sitebulb 3Semrush 6Ahrefs 4Lumar 5JetOctopus 5Neova 7共 8 项
功能Screaming FrogSitebulbSemrushAhrefsLumarJetOctopusNeova
命令行✓「SEO Spider 可以完全通过命令行操作…… 来源–文档中未找到。来源–文档中未找到。来源–文档中未找到。来源✓Beta 版 CLI「oreo」(npx @deepcrawl/oreo)来源◐没有 CLI 工具;云服务通过 API 或 MCP 驱动,令牌「用于 CI 流水线、脚本和自动化智能体」(Codex CLI、Gemini CLI)。来源✓Neova CLI
REST API–FAQ:「简而言之,没有…… 来源–FAQ:「Sitebulb Cloud 有 API 吗?还没有。来源✓有,作为 Business 套餐的附加组件 来源✓Lite 及以上套餐提供 API v3,每月 200,000 到 2,000,000 单位,含 Site Audit、Site Explorer、Keywords Explorer、Rank Tracker 和 Brand Radar 端点。来源✓「Lumar GraphQL API 对所有用户开放」,遵循「合理使用政策」来源✓所有套餐:「可使用 JetOctopus 的所有核心功能,包括创建项目和抓取、图表数据、数据表和导出」。来源✓Neova Online 的 REST API,使用 API 密钥(0.10.38),另有 MCP 服务器和命令行
MCP 服务器✓自 v24.0 起(2026年5月19日)来源✓Sitebulb MCP,2026年9月9日推出(v10.0),适用于 Desktop 和 Cloud 来源✓Semrush MCP 支持「ChatGPT、Claude、Gemini、Perplexity、Cursor、Microsoft Copilot」来源✓Lite 及以上套餐提供远程 MCP 服务器 来源✓Lumar MCP 服务器(2026年7月23日)来源✓所有套餐,可读可写 来源✓MCP 服务器
团队账户◐每人一个许可证许可证按用户计算(「如果您的团队有五个人想使用 SEO Spider,就需要 5 个许可证」),5 个起有折扣。来源✓2 至 10+ 用户Cloud 套餐包含用户数(Mini 2 个、Small 5 个、Medium 10 个、Enterprise 10 个以上)来源✓每用户 $45 起「额外用户 $45/月起」来源✓每用户 $40 起含 1 个用户;可加购用户 来源✓4 种角色,SSO团队角色「Admin、Editor、Reporter 和 Viewer」,可按应用设置权限 来源✓用户数不限「项目和席位(用户)来源即将推出即将推出。目前每个账户一人使用
界面语言✓7「界面提供英语、西班牙语、德语、法语、意大利语、荷兰语和土耳其语」(7 种语言 来源–文档中未找到。来源✓14语言切换器中有 14 种 来源✓1515 种语言:英语、德语、西班牙语、法语、印尼语、意大利语、荷兰语、波兰语、葡萄牙语、瑞典语、土耳其语、乌克兰语、中文、日语和韩语。来源◐英语、日语未找到界面语言列表。来源–英语文档中未找到。来源✓1515 种语言
服务器日志◐Log File Analyser单独的产品 Screaming Frog Log File Analyser(Windows、macOS、Linux),用于「验证搜索引擎和 AI 爬虫」。来源–即将推出FAQ:「Sitebulb 目前还不做日志文件分析,但已在开发计划中,很快就会推出!」来源✓Enterprise有,作为单独的 Enterprise 产品 来源◐Bot AnalyticsBot Analytics 是单独的工具,付费套餐在 beta 期间免费,可从 Cloudflare、Vercel、CloudFront、AWS 负载均衡器或 Fastly「接收 HTTP 请求数据」来源◐已包含包含,但基于按 URL 汇总的数据 来源✓已包含每个套餐都包含,不是单独的产品 来源✓已包含已包含:Apache 和 Nginx 日志,直接读取 Cloudflare,只统计经过验证的爬虫
预发布环境与网站迁移✓「借助高级 URL Mapping 对比预发布环境和生产环境」来源✓使用 HTTP 或表单身份验证并调整 robots 设置来抓取预发布网站,然后在「任意两个 Projects」之间对比诊断。来源✓有,在 Semrush Enterprise Site Intelligence 中 来源◐「抓取预发布网站和受限网站…… 来源✓「抓取您的预发布或测试环境,并与线上网站对比」,支持 Test Site Domain、自定义 DNS、基本身份验证和覆盖 robots.txt。来源✓「对比预发布网站和线上网站的抓取,能帮助您构建一个没有错误的可用版本」来源✓预发布与生产环境对比,以及重定向映射表
打开其他爬虫的导出文件◐列表模式可从任意 .txt、.xls、.xlsx、.csv 或 .xml 文件读取 URL(「可以直接上传 Adwords 下载文件」)来源◐导入 URL 列表(.csv 或 .txt)来源◐Backlink Audit 可导入反向链接文件(CSV,「最大 50 MB」)来源–文档中未找到。来源◐把 CSV 导出文件作为抓取来源导入(Majestic、Ahrefs、Open Site Explorer、Screaming Frog Log File Analyser、Splunk、Logz.io 来源◐只有通用导入:「导入可以使用 CSV 或 TXT 格式的文件」,按 URL 键关联 来源✓打开 Screaming Frog 和 Sitebulb 的抓取,并对照线上网站评估
价格Screaming Frog 2Sitebulb 1Semrush 2Ahrefs 2Lumar 0JetOctopus 1Neova 2共 2 项
功能Screaming FrogSitebulbSemrushAhrefsLumarJetOctopusNeova
免费版✓500 个 URL「免费下载并抓取 500 个 URL」…… 来源–14 天试用没有免费版:「14 天免费试用」,功能等同 Pro,「无需信用卡,无需预先承诺」。来源✓100 个页面免费套餐:「1 个演示项目」「所有核心工具每天共 10 份报告」「无需信用卡」。来源✓每个项目 5,000Ahrefs Free(原 Webmaster Tools),适用于已验证的网站 来源–文档中未找到。来源◐7 天试用没有免费套餐;演示后可试用 7 天,无需信用卡 来源✓1,000 个 URL包含所有检查项的免费套餐;Desktop 免费 14 天,无需绑卡
价格✓每年 $279仅限桌面版,没有云端套餐 来源✓每月 $18 起Desktop Lite:每月 $18 / £12.50 / €15,或每年 $180 / £125 / €150。来源✓每月 $139 起SEO $139/月、Starter $199/月、Pro+ $299/月(按年付费 $117.33、$165.17、$248.17/月)来源✓每月 $29 起仅限云端:Starter $29/月、Lite $129、Standard $249、Advanced $449、Enterprise 需询价 来源–需询价没有公开价格:「我们根据您的具体需求为解决方案定价。来源✓每月 $349 起仅限云端,按年付费、按月计价(内部团队)来源✓每月 $19 起提供免费套餐;付费套餐每月 $19 起(美国价格)
✓有◐部分–其他工具:没有,或文档中未找到–Neova:暂未支持即将推出Neova:即将推出关于其他工具的每一条说明,都链接到其官网或文档中的出处页面。

Neova 不做什么

Screaming Frog、Sitebulb、Semrush、Ahrefs、Lumar 和 JetOctopus 各列:只写其官网和文档中明确说明的内容,于 2026年11月11日查阅,并逐项附上页面链接。「文档中未找到」表示我们没有找到,而不是做不到。Neova 一列:Neova 和 Neova Online 目前能做的事,以应用为准。Neova 有 141 项检查不在我们对比的 10 款 SEO 工具(Screaming Frog、Sitebulb、Semrush、Ahrefs、Lumar、Moz、SE Ranking、Seobility、Sitechecker 和 Conductor)公开的任何列表中:2026年10月25日,我们把每份列表逐条与 Neova 的检查项库进行了比对。此后新增的 67 项检查在完成比对前不计入。以上名称均为其所有者的商标;Neova 与它们均无关联。如有内容错误或过时,请写信至 hello@neova.app,我们会更正。