Screaming Frog i Sitebulb wyznaczyły poziom dla crawlerów SEO i wiele się od nich obu nauczyliśmy. Oto Neova obok nich oraz obok Semrush, Ahrefs, Lumar i JetOctopus, na podstawie ich własnej dokumentacji, z linkami.
4miejsca, w których jej używasz: Mac, Windows, Linux, dowolna przeglądarka
15języków
Crawl wielu witryn naraz
Aplikacja desktopowa
Przecrawluj klienta, jego konkurencję i własną witrynę za jednym razem. Do 4 witryn crawluje się jednocześnie w jednym oknie, każda we własnym tempie i z własnym limitem URL-i, a strażnik pamięci wstrzymuje kolejną, gdy komputerowi zaczyna brakować pamięci.
Dwa crawle, jedno okno2 trwające crawle na górze: kliknij jeden, żeby go obserwować.W tokuKażdy crawl, jego tempo, zajęte sloty i wolna pamięć.
Do 4 narazUruchom jeden crawl, potem następny: do 4 witryn crawluje się jednocześnie. Ustawienia › Crawl › Crawle naraz, domyślnie 2; kolejny czeka w kolejce na swoją kolej.
Każdy we własnym tempieKażdy crawl ma własną prędkość, limit URL-i i ustawienia, więc wolna witryna klienta nigdy nie spowalnia pozostałych.
Strażnik pamięciKażdy crawl rezerwuje potrzebną mu pamięć, więcej przy renderowaniu JavaScriptu. Gdy komputerowi zaczyna jej brakować, kolejny crawl czeka i podaje powód.
Jedno okno dla wszystkichPrzełączaj się między trwającymi crawlami na górze ekranu na żywo. W toku pokazuje je wszystkie, każdy z przyciskami Wstrzymaj, Zatrzymaj i Otwórz.
Screaming Frog: jeden crawl na kopię aplikacji: okno i jego pamięć dla każdej witryny. źródło Sitebulb: aplikacja desktopowa uruchamia audyty jeden po drugim; jednocześnie tylko w planach Medium i Enterprise Sitebulb Cloud. źródło
Zajrzyj do środka
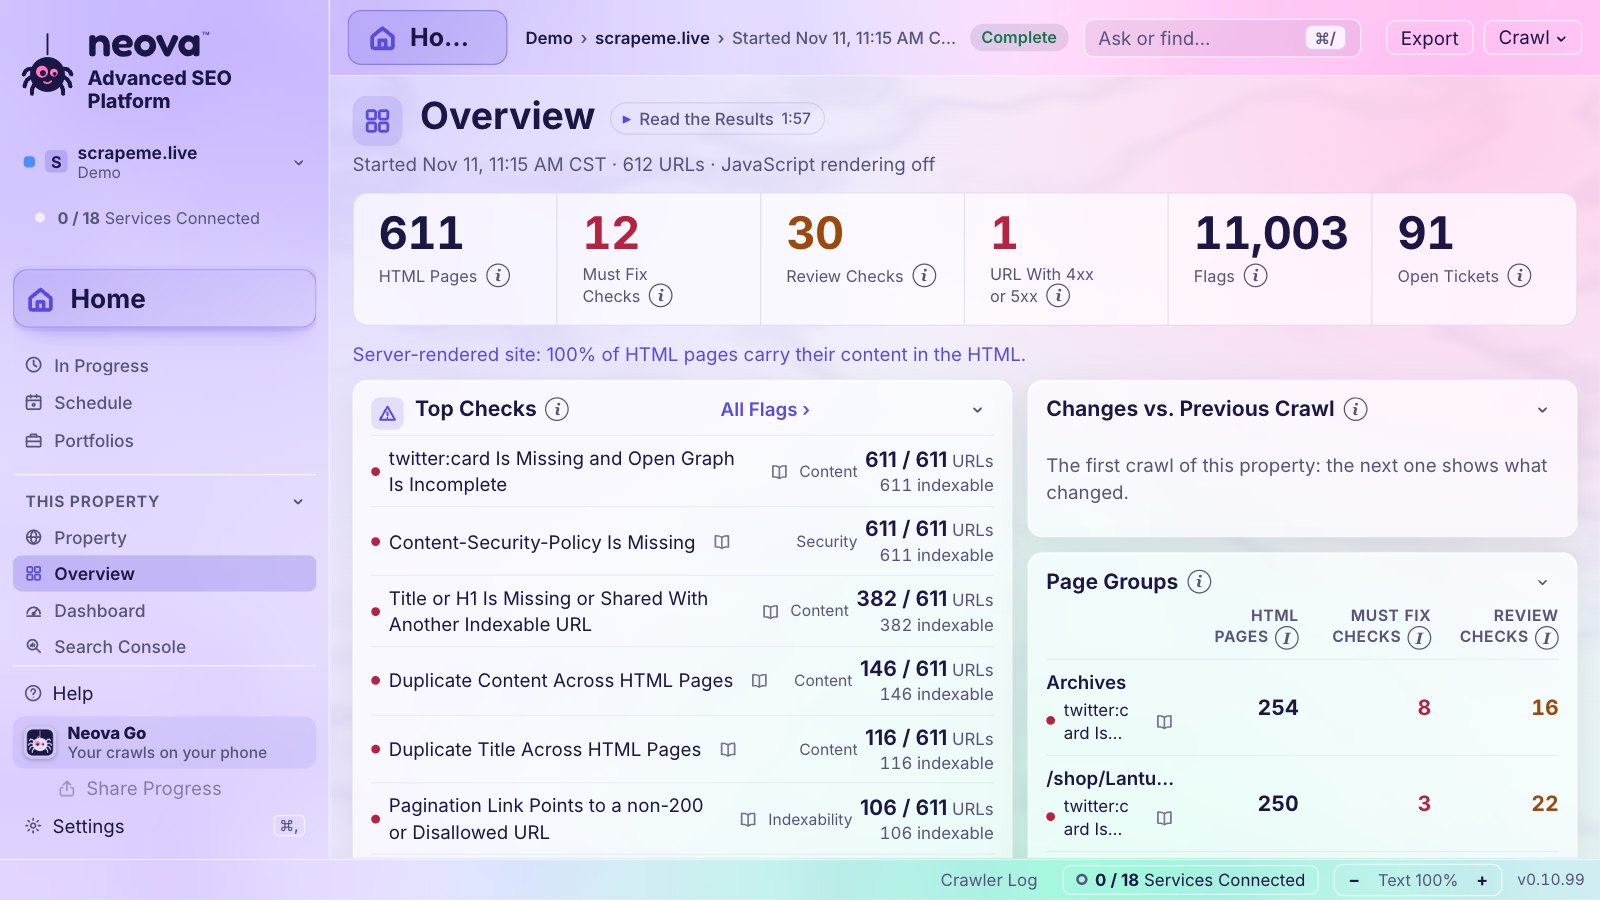
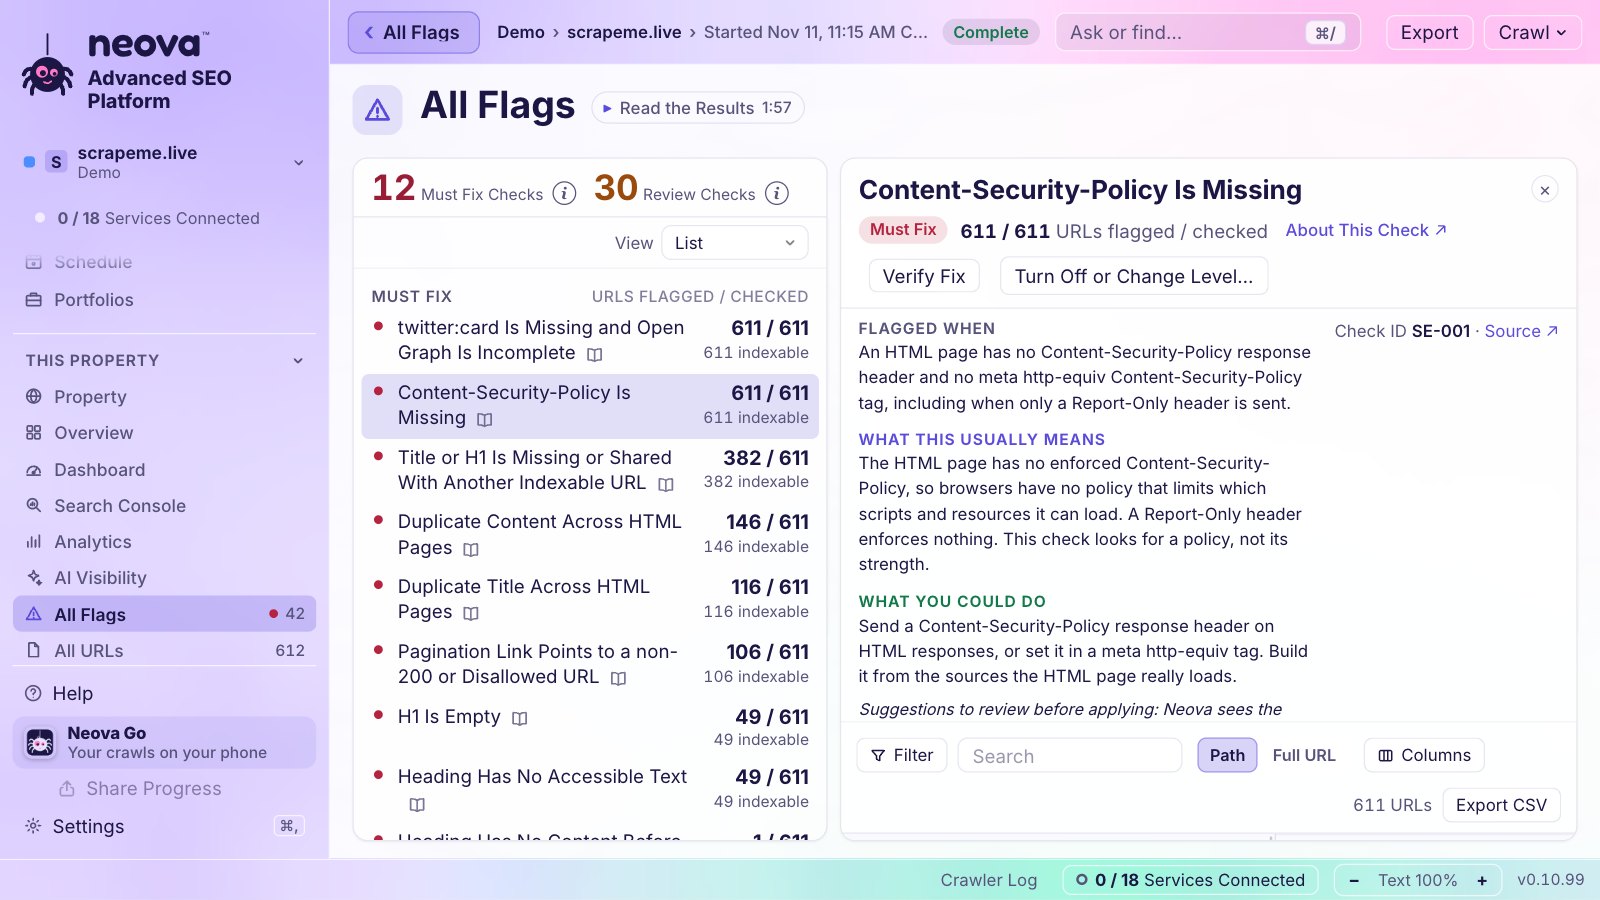
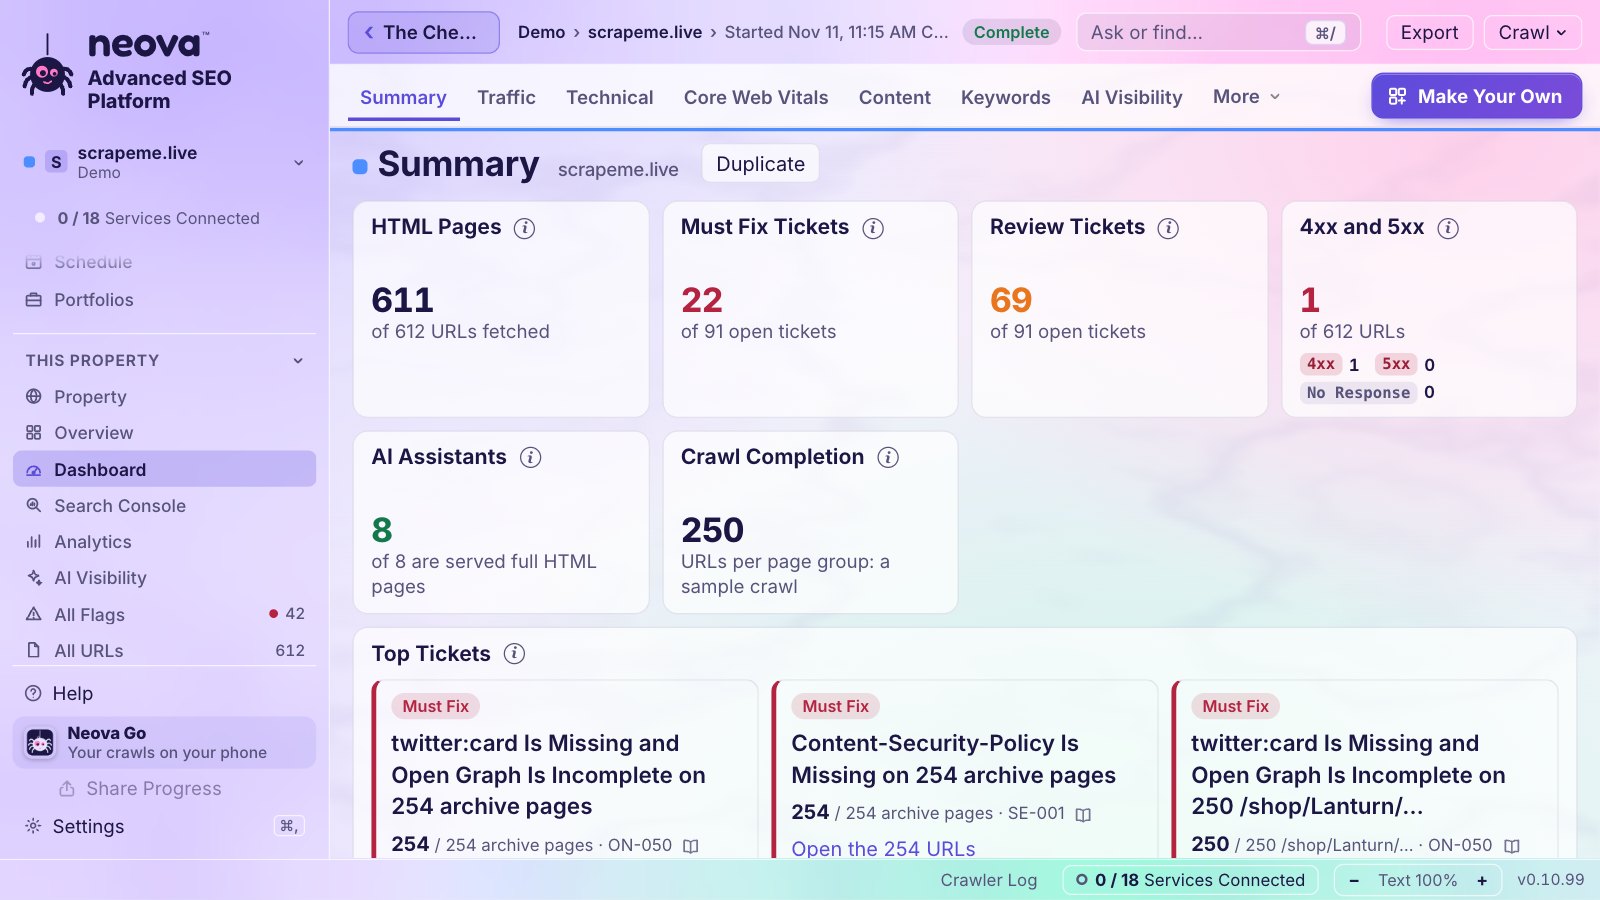
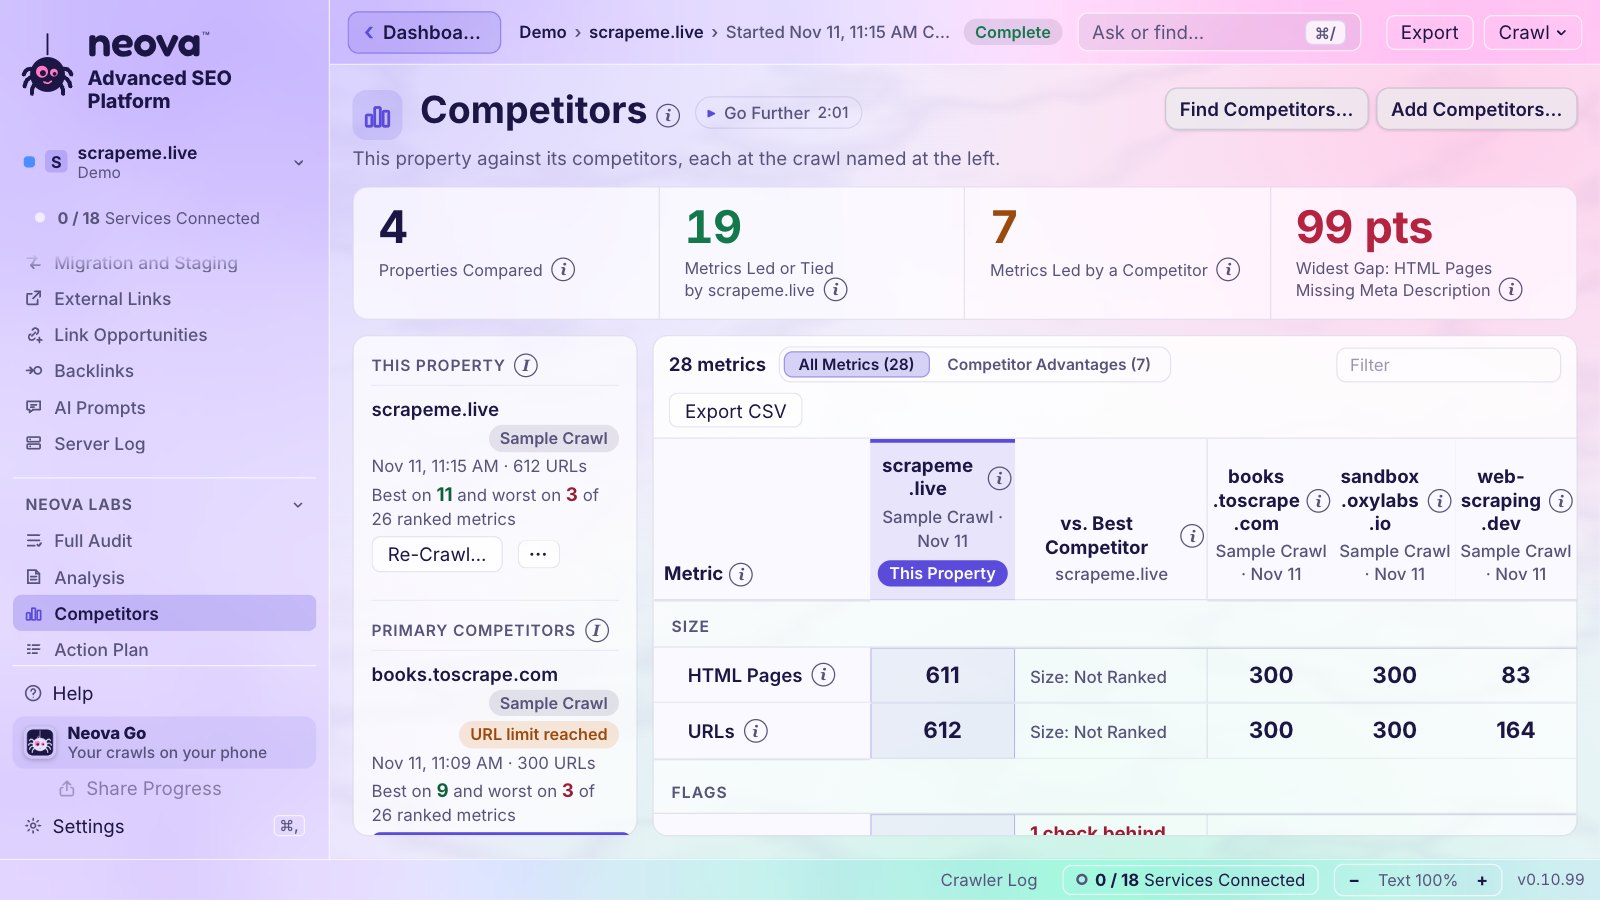
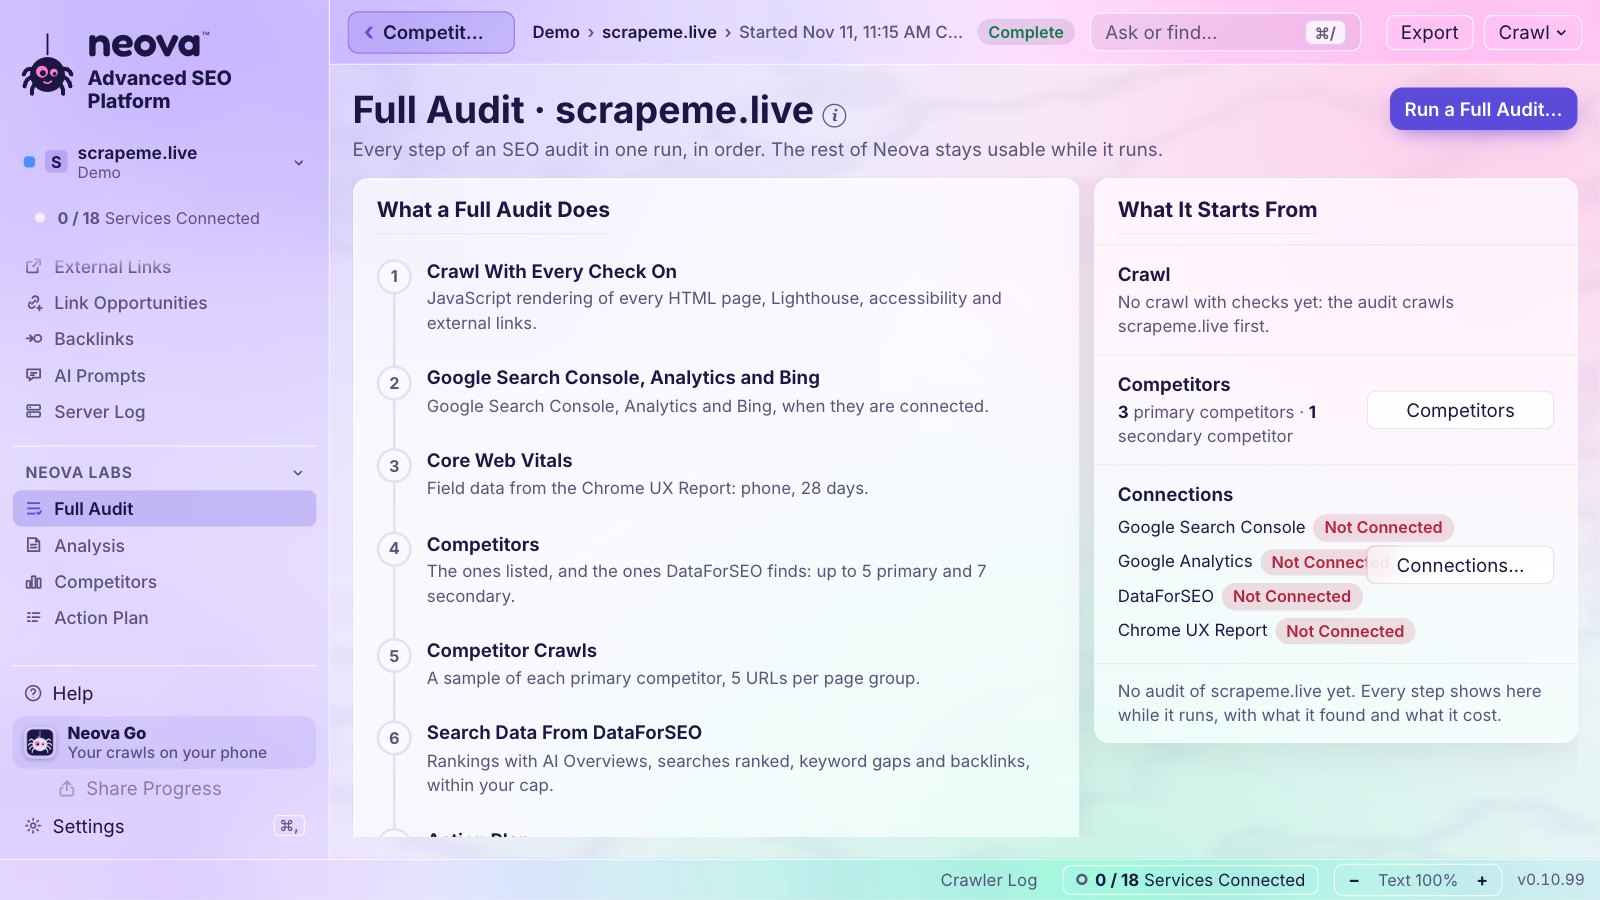
Neova na sklepie demo, od którego zaczyna każde konto Neova Online. Kliknij ekran, żeby zobaczyć go w pełnym rozmiarze.
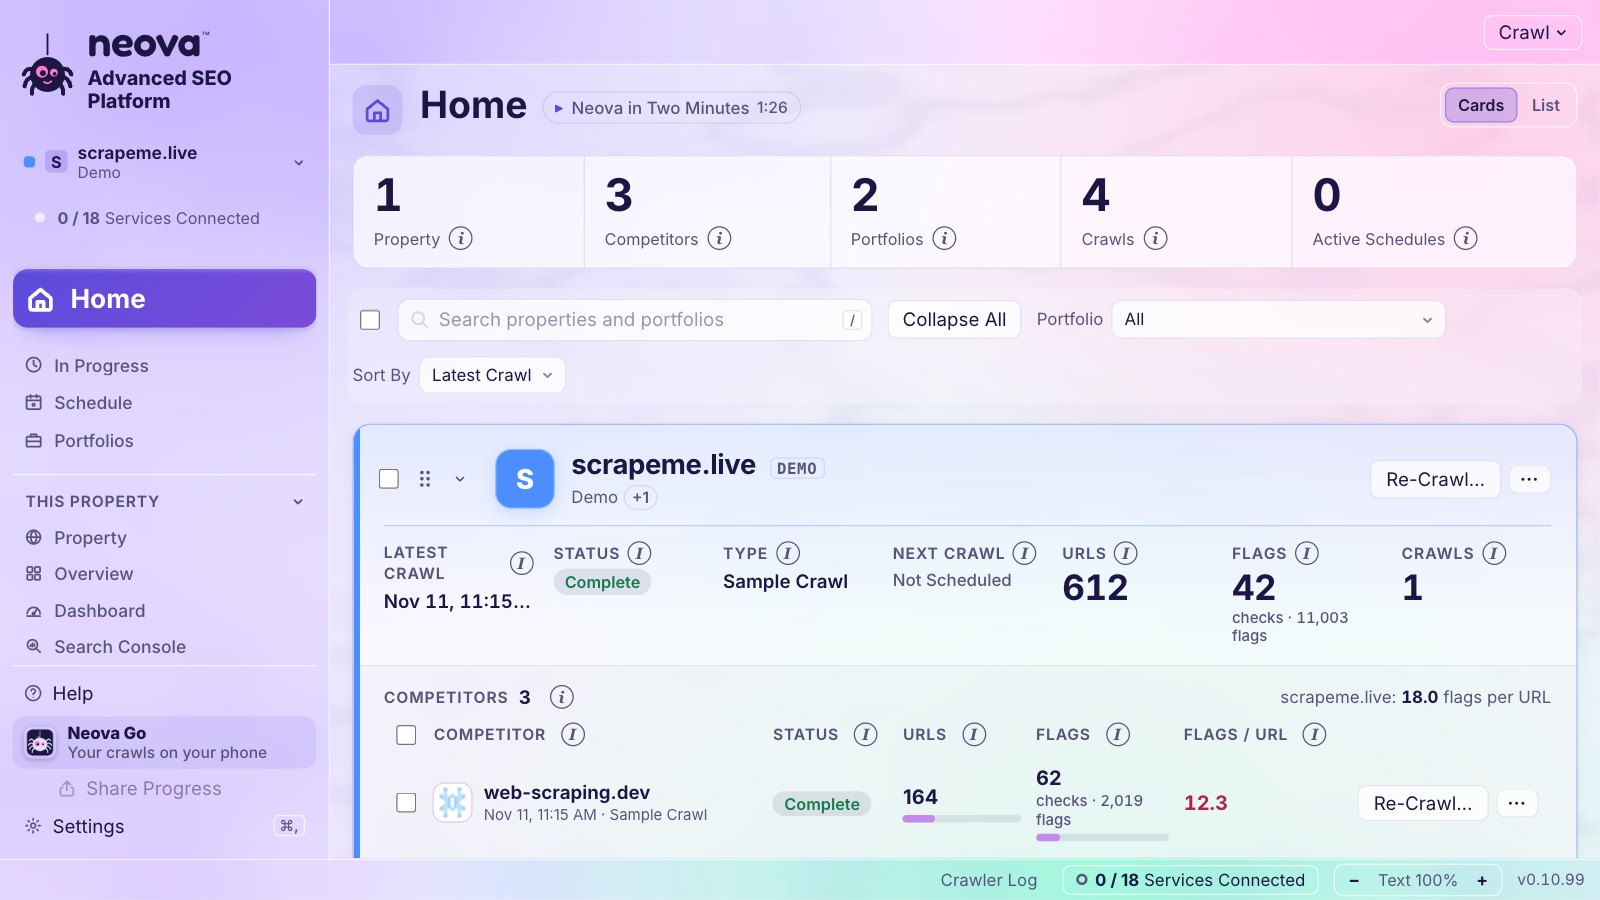
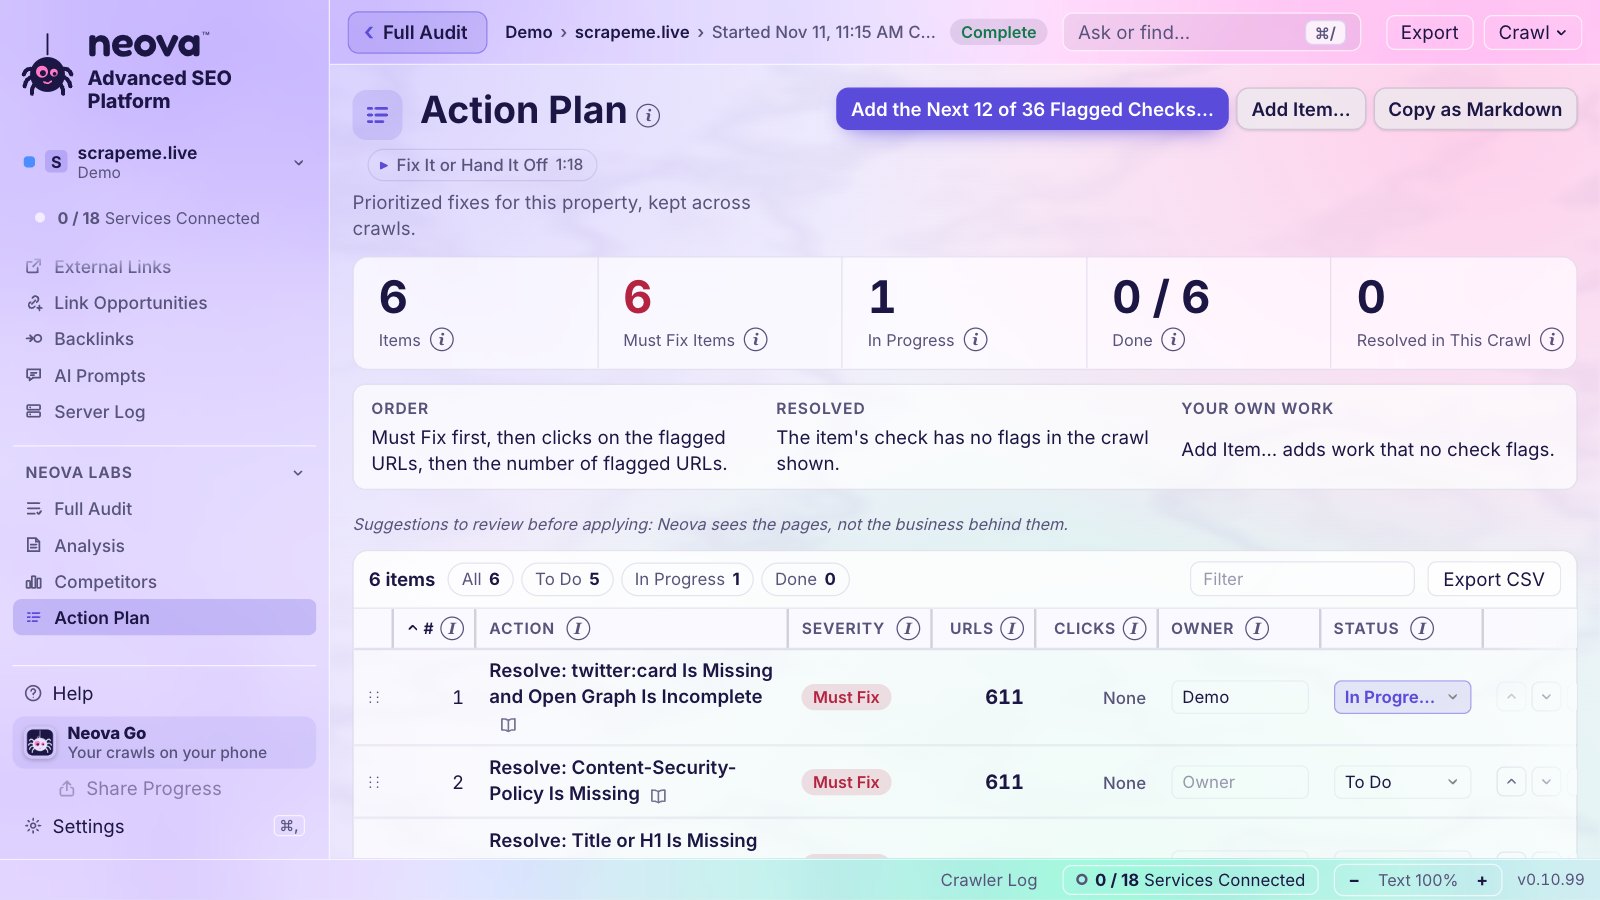
Strona głównaKażda usługa z konkurencją, URL-ami i uwagami na URL.Crawl na żywoEtapy, mapa crawla, czasy odpowiedzi i każdy URL, gdy tylko się pojawi.PrzeglądWitryna w skrócie: najważniejsze testy, zmiany, grupy stron.Wszystkie uwagiKażda uwaga z wyjaśnieniem, sposobem naprawy, źródłem i stronami.Dashboard13 kart, 39 bloków i twoje własne dashboardy.KonkurenciTwoja witryna obok konkurencji, metryka po metryce, pokolorowana według tego, kto prowadzi.Pełny audytCrawl, dane z wyszukiwania, konkurencja, plan i raport za jednym uruchomieniem.Plan działańKażda poprawka z osobą odpowiedzialną i statusem, wysłana do Jiry, jeśli chcesz.
Tylko w Neova
Sprawdzone w ich dokumentacji
Co robi Neova, a czego nie robi żadne z narzędzi Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar i JetOctopus, według ich własnej dokumentacji, przeczytanej 11 listopada 2026. Każda karta mówi prostymi słowami, co to jest i dlaczego ma znaczenie.
Udostępnij crawl na żywo komukolwiek
Udostępnij postęp daje ci link do trwającego crawla. Każdy otworzy go na telefonie lub komputerze, bez konta, i obejrzy na żywo: postęp, podział URL-i, mapę crawla, czasy odpowiedzi, przekierowania i błędy oraz powiadomienie, gdy crawl się skończy.
Szczegóły
Twój klient lub szef śledzi crawl bez logowania się gdziekolwiek i widzi ten crawl i nic więcej. Zatrzymaj udostępnianie kończy to od razu.
Screaming Frog: przegląd crawla w Looker Studio, zasilany Arkuszem Google aktualizowanym „za każdym razem, gdy uruchamia się zaplanowany crawl”, można wysłać e-mailem „dowolnym interesariuszom”. źródło Sitebulb: dashboardy Data Studio w Cloud otwierają się „bez konta Sitebulb” i aktualizują się „przy każdym crawlu” źródło Semrush: zaproszeni widzowie „nadal muszą założyć konto” źródło Ahrefs: klienci dostają wyniki „przez eksporty, zaplanowane raporty lub dashboardy Data Studio na żywo” źródło Lumar: „publiczne linki pozwalają każdemu oglądać crawle i raporty”, ważność „od 24 godzin do 6 miesięcy” źródło JetOctopus: nie znaleziono publicznego linku źródło
Udostępnij każdy crawl, zabezpieczony twoim kluczem
Opublikuj link do udostępnienia, a Neova zaszyfruje crawle witryny na twoim komputerze, zanim go opuszczą. Klucz jest tylko w linku, więc nawet nasz serwer nie może ich odczytać. Zatrzymaj udostępnianie, a link nic już nie otworzy.
Szczegóły
Przekaż klientowi cały audyt, każdą kartę i każdą tabelę, i zachowaj pełną kontrolę nad tym, kto go widzi i jak długo.
Screaming Frog: przegląd crawla w Looker Studio, zasilany Arkuszem Google aktualizowanym „za każdym razem, gdy uruchamia się zaplanowany crawl”, można wysłać e-mailem „dowolnym interesariuszom”. źródło Sitebulb: dashboardy Data Studio w Cloud otwierają się „bez konta Sitebulb” i aktualizują się „przy każdym crawlu” źródło Semrush: zaproszeni widzowie „nadal muszą założyć konto” źródło Ahrefs: klienci dostają wyniki „przez eksporty, zaplanowane raporty lub dashboardy Data Studio na żywo” źródło Lumar: „publiczne linki pozwalają każdemu oglądać crawle i raporty”, ważność „od 24 godzin do 6 miesięcy” źródło JetOctopus: nie znaleziono publicznego linku źródło
Twój komputer, twoja przeglądarka, twój telefon
Crawluj na własnym Macu, PC lub komputerze z Linuksem, otwieraj te same portfolio, ustawienia i crawle w Neova Online z dowolnej przeglądarki i miej wszystko na oku z telefonu. Jedno konto, zawsze zsynchronizowane.
Szczegóły
Crawlery desktopowe zostają na jednym komputerze, crawlery w chmurze w przeglądarce. Neova jest tam, gdzie ty, a twoje crawle zostają na twoim komputerze, chyba że zdecydujesz inaczej.
Screaming Frog: nie znaleziono w dokumentacji. źródło Sitebulb: aplikacja desktopowa plus Cloud w przeglądarce źródło Semrush: platforma w przeglądarce plus aplikacja na iOS tylko do pozycji źródło Ahrefs: tylko przeglądarka; Ahrefs pisze, że wyniki crawla można oglądać „z dowolnego miejsca o dowolnej porze” i „nawet ze smartfona” (2024). źródło Lumar: nie znaleziono w dokumentacji. źródło JetOctopus: nie znaleziono w dokumentacji. źródło
Neova Go: twoje witryny w kieszeni
Na telefonie ostatni crawl każdej usługi, Core Web Vitals, kliknięcia, śledzone wyszukiwania i następne uruchomienie, zabezpieczone kluczem, który nigdy nie opuszcza twojego komputera. Na pasku menu postęp crawla obok zegara oraz Odłóż lub Pomiń dla następnego zaplanowanego crawla.
Szczegóły
Wiesz, że crawl się skończył albo szablon zwolnił, bez otwierania laptopa.
Screaming Frog: nie znaleziono w dokumentacji. źródło Sitebulb: nie znaleziono w dokumentacji. źródło Semrush: aplikacja na iOS tylko do pozycji źródło Ahrefs: nie znaleziono aplikacji na telefon. Aplikacja webowa w chmurze działa na telefonach źródło Lumar: nie znaleziono w dokumentacji. źródło JetOctopus: nie znaleziono w dokumentacji. źródło
Tickety, które zamykają się same
Uwagi stają się ticketami, po jednym na test i grupę stron. Gdy następny crawl stwierdzi, że problem jest naprawiony, ticket się zamyka; jeśli problem wróci, ticket otwiera się ponownie. Wyślij do Jiry, a Jira nadąża.
Szczegóły
Twoi deweloperzy dostają jeden jasny ticket zamiast 4,000 URL-i i nikt nie goni ticketów naprawionych kilka tygodni temu.
Screaming Frog: nie znaleziono w dokumentacji. źródło Sitebulb: brak natywnej integracji z Jirą. Dev Handoff Skill, uruchamiany przez asystenta AI, zapisuje tickety „prosto do Jiry, Lineara, Asany, Monday lub ClickUp”. źródło Semrush: Site Audit może „wysyłać zadania na tablicę Trello” źródło Ahrefs: nie znaleziono funkcji Jiry ani ticketów. źródło Lumar: zadania tworzy się z raportów ręcznie i przesuwa „przeciągając i upuszczając zadania do różnych sekcji statusu” źródło JetOctopus: nie znaleziono w dokumentacji. źródło
Każdy test podaje swoje źródło
Każdy test mówi, na której stronie Google, W3C, web.dev lub innego oficjalnego źródła się opiera, z linkiem, i co z tym zrobić.
Szczegóły
Gdy deweloper pyta dlaczego, wysyłasz źródło, a nie swoją opinię.
Screaming Frog: wszystkie 8 sprawdzonych przewodników po problemach kończy się sekcją „Further Reading” z linkami do Google lub web.dev, ale jako lektura, a nie podstawa reguły źródło Sitebulb: wiele wskazówek kończy się sekcją „Further Reading” (Google, MDN, dokumentacja Lighthouse, także blogi), ale „Canonical points to a redirecting URL” nie podaje żadnego źródła. źródło Semrush: niektóre poprawki linkują do Google („zobacz ten artykuł Google”) źródło Ahrefs: niektóre strony pomocy linkują do Google („Ten przewodnik Google powie ci wszystko”), a strony problemów, takie jak „Hreflang to broken page”, nie podają żadnego zewnętrznego źródła. źródło Lumar: nie znaleziono w dokumentacji. źródło JetOctopus: nie znaleziono w dokumentacji. źródło
Bing Webmaster Tools, w tym cytowania w Bing AI
Neova czyta własne dane Binga o twojej witrynie, w tym to, jak często odpowiedzi AI Binga cytują twoje strony.
Szczegóły
Bing zasila wyszukiwanie ChatGPT i Copilota. Jego dane pokazują twoją widoczność w wyszukiwaniu AI.
Screaming Frog: Bingbot to tylko gotowy user agent źródło Sitebulb: Bing to tylko gotowy user agent źródło Semrush: tylko śledzenie pozycji w Bing źródło Ahrefs: Site Audit przesyła zmiany przez IndexNow („obsługiwane przez Bing, Yep i inne wyszukiwarki”) źródło Lumar: brak Bing Webmaster Tools źródło JetOctopus: Bingbot w logach i testerze robots.txt („Pełne dane o Googlebocie, Bingbocie, GPTBocie, ClaudeBocie i ponad 40 innych crawlerach”) źródło
Otwieraj crawle ze Screaming Frog i Sitebulb
Masz już crawl witryny ze Screaming Frog lub Sitebulb? Otwórz go w Neova, a jego strony zostaną ocenione testami Neova na tle żywej witryny.
Szczegóły
Zostań przy znanych narzędziach i dodaj Neova tam, gdzie pomaga, bez crawlowania dwa razy.
Screaming Frog: tryb listy czyta URL-e z dowolnego pliku .txt, .xls, .xlsx, .csv lub .xml („możesz bezpośrednio wgrać plik pobrany z Adwords”) źródło Sitebulb: importuje listy URL-i (.csv lub .txt) źródło Semrush: Backlink Audit importuje pliki z backlinkami (CSV, „do 50 MB”) źródło Ahrefs: nie znaleziono w dokumentacji. źródło Lumar: importuje eksporty CSV jako źródła crawla (Majestic, Ahrefs, Open Site Explorer, Screaming Frog Log File Analyser, Splunk, Logz.io źródło JetOctopus: tylko ogólny import: „Do importu możesz użyć pliku w formacie CSV lub TXT”, łączonego po kluczu URL źródło
Wbudowane, nie sprzedawane osobno
Inni też to mają, często jako dodatek lub osobny produkt z własną ceną. W Neova to część aplikacji. Tam, gdzie potrzebne są dane zewnętrzne, na przykład z DataForSEO lub Google, używasz własnego konta po jego własnej cenie, bez żadnych dopłat. Otwórz Co robią inni przy każdej pozycji, ze stroną ich dokumentacji.
Sprawdź, czy ChatGPT i Perplexity o tobie wspominają
Neova zadaje twoje własne pytania ChatGPT i Perplexity tak, jak zrobiłby to klient, i mówi ci, czy twoja marka pojawia się w odpowiedzi.
Co robią inni
Coraz więcej osób pyta asystentów AI, zanim zacznie szukać. Tak dowiesz się, czy tam istniejesz.
Screaming Frog: nie znaleziono w dokumentacji. źródło Sitebulb: nie znaleziono w dokumentacji. źródło Semrush: tak, w AI Visibility Toolkit (99 $/mies.) źródło Ahrefs: własne prompty Brand Radar w ChatGPT, Perplexity, Gemini, Copilot, AI Overviews źródło Lumar: w AI Visibility (włączane dla konta) źródło JetOctopus: „JetOctopus nie śledzi cytowań, wzmianek o marce ani wydźwięku w odpowiedziach AI” źródło
Co naprawdę dostają asystenci AI
Neova pobiera twoje strony jako 10 crawlerów AI (ChatGPT, Claude, Perplexity i inne), sprawdza twój llms.txt i pliki dla agentów i pokazuje, co dostaje każdy z nich.
Co robią inni
Strona, którą widzą twoi odwiedzający, może być zablokowana lub pusta dla asystenta AI. Teraz możesz to zobaczyć.
Screaming Frog: nie znaleziono w dokumentacji. źródło Sitebulb: nie znaleziono w dokumentacji. źródło Semrush: powiadomienia Site Audit „Llms.txt not found (AI Search)” i „Llms.txt file has formatting issues (AI Search)” źródło Ahrefs: tylko darmowy generator („zbuduje dla ciebie idealny plik llms.txt”) źródło Lumar: w darmowym Agentic Readiness Scanner od Lumar, oddzielnym od platformy do crawlowania źródło JetOctopus: nie znaleziono w dokumentacji. źródło
Twoja konkurencja, znaleziona i porównana
Neova znajduje witryny, które konkurują z tobą w tych samych wyszukiwaniach, crawluje najbliższe z nich i zestawia każdą metrykę obok siebie, pokolorowaną według tego, kto prowadzi.
Co robią inni
Widzisz, gdzie konkurent cię wyprzedza i o ile, bez arkusza kalkulacyjnego.
Screaming Frog: nie znaleziono w dokumentacji. źródło Sitebulb: nie znaleziono w dokumentacji. źródło Semrush: Position Tracking: „Competitors Discovery Report pokazuje organicznych konkurentów rankujących na twoje słowa kluczowe” źródło Ahrefs: nowe projekty „dostają propozycje konkurentów na podstawie witryn rankujących na podobne słowa kluczowe” źródło Lumar: w AI Visibility: „Marki są wykrywane automatycznie z odpowiedzi dostawców AI”, a Lumar klasyfikuje każdą jako Own, Competitor, Other lub Context. źródło JetOctopus: nie znaleziono w dokumentacji. źródło
Logi serwera, nawet za Cloudflare
Neova czyta twoje logi Apache lub Nginx albo bezpośrednio logi Cloudflare i liczy tylko zweryfikowane boty, więc widzisz, co Googlebot i crawlery AI naprawdę pobierają.
Co robią inni
Logi pokazują, co wyszukiwarki robią w twojej witrynie, a nie to, co zgaduje crawler.
Screaming Frog: osobny produkt, Screaming Frog Log File Analyser (Windows, macOS, Linux), do „weryfikacji botów wyszukiwarek i AI”. źródło Sitebulb: FAQ: „Sitebulb nie analizuje jeszcze plików logów, ale jest to w planach i wkrótce będzie dostępne!” źródło Semrush: tak, jako osobny produkt Enterprise źródło Ahrefs: Bot Analytics, osobne narzędzie, darmowe w becie w płatnych planach, „przyjmuje dane o żądaniach HTTP” z Cloudflare, Vercel, CloudFront, load balancerów AWS lub Fastly źródło Lumar: w zestawie, ale z podsumowań na URL źródło JetOctopus: w każdym planie, nie jako osobny produkt źródło
Core Web Vitals od prawdziwych użytkowników, z trendem
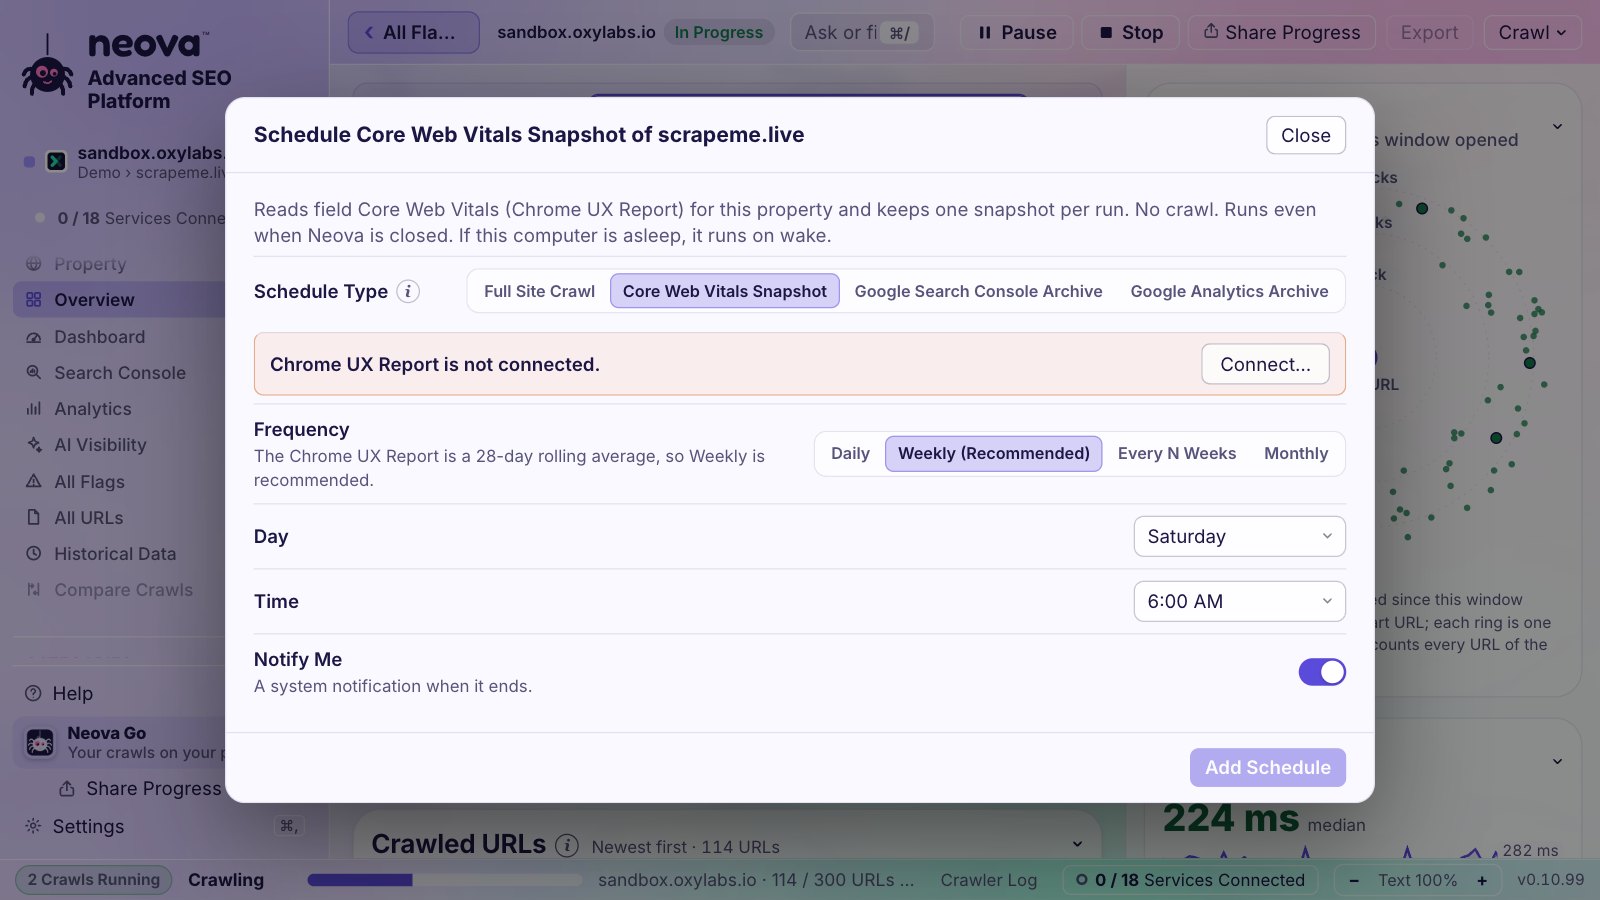
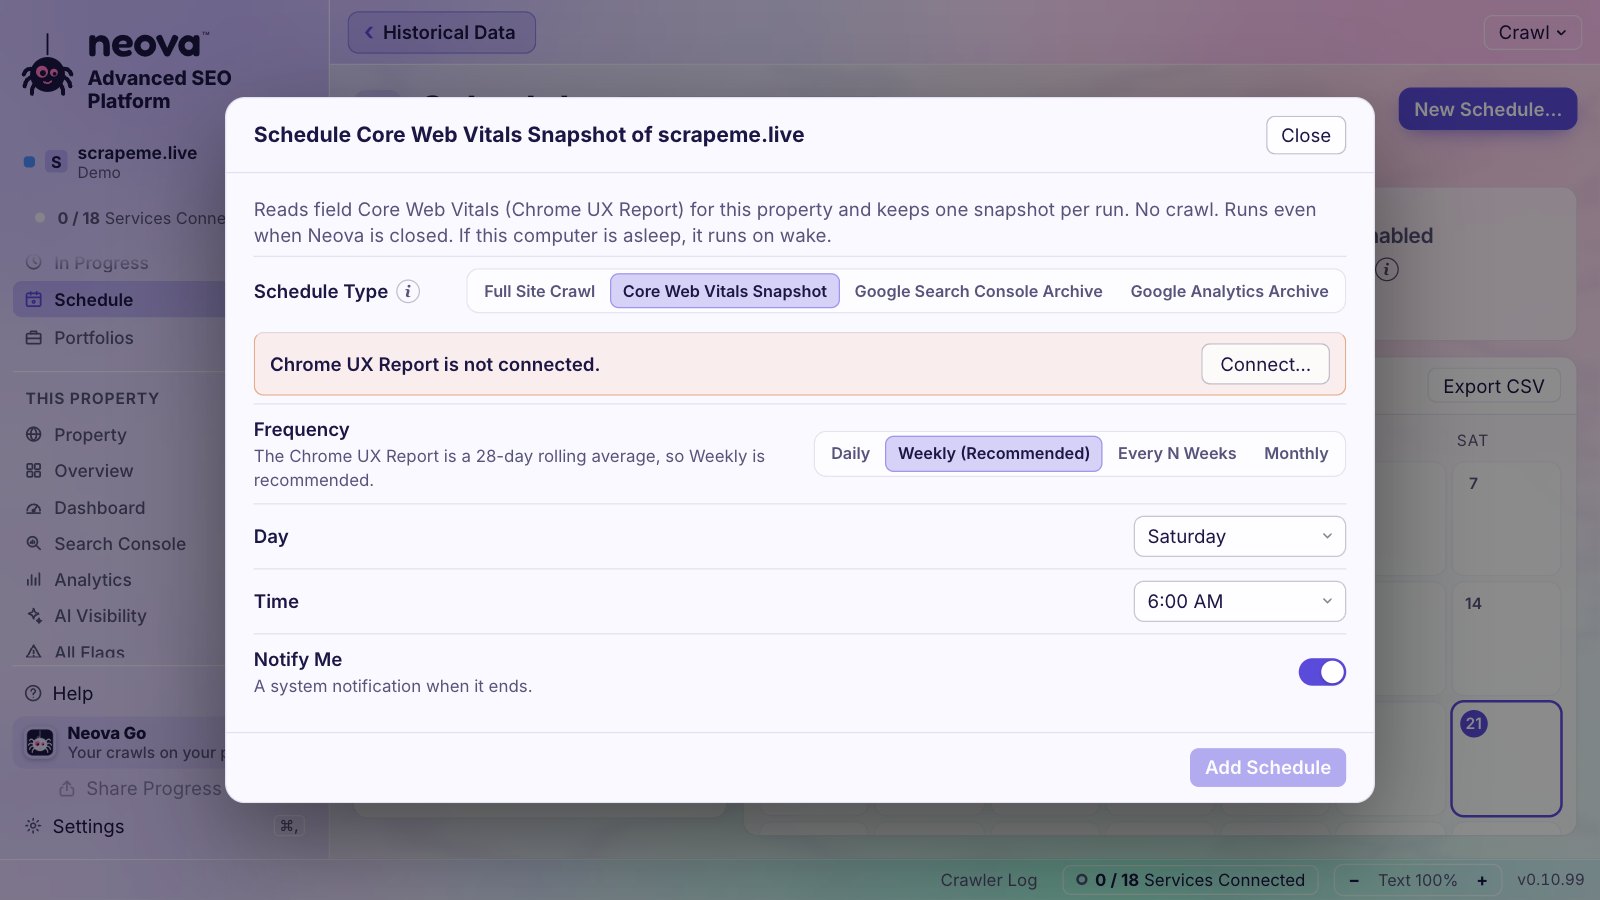
Z twoim darmowym kluczem Chrome UX Report Neova czyta, czego doświadczają prawdziwi użytkownicy Chrome: trend z 40 tygodni od pierwszego dnia, widok dla każdej grupy stron, migawki według harmonogramu i alerty.
Co robią inni
Testy laboratoryjne mówią, jak szybka mogłaby być strona. Dane od prawdziwych użytkowników mówią, jak szybka jest dla twoich odwiedzających, i tego właśnie używa Google.
Screaming Frog: nie znaleziono wykresu trendu CWV w aplikacji. źródło Sitebulb: Arkusz Google „Historical Audit Data” ma jeden wiersz na audyt dla „danych szeregów czasowych lub wykresów” w Looker Studio i zawiera wartości przedziałów Core Web Vitals (changelog, 13 źródło Semrush: dane laboratoryjne (Lighthouse) źródło Ahrefs: raport Performance w Site Audit źródło Lumar: w Site Speed: „wykres trendu dla każdego z KPI” (FCP, LCP, TBT, CLS), podział Slow, Moderate, Fast, jeden punkt na crawl (dane laboratoryjne) źródło JetOctopus: zaplanowane testy CWV („+Create a CWV schedule”) źródło
Jira bez żmudnej roboty
Każdy ticket trafia do Jiry ze swoimi stronami, testem i sposobem naprawy, a Neova synchronizuje oba po każdym crawlu.
Co robią inni
Twój zespół pracuje tam, gdzie już pracuje.
Screaming Frog: nie znaleziono w dokumentacji. źródło Sitebulb: brak natywnej integracji z Jirą źródło Semrush: tylko natywne „Send to Trello” źródło Ahrefs: nie znaleziono integracji z Jirą. źródło Lumar: integracja z Jira Cloud źródło JetOctopus: nie znaleziono w dokumentacji. źródło
Dashboard
Otwórz usługę, potem Dashboard: wszystko, co Neova wie o witrynie, na jednym ekranie, i tyle własnych widoków, ile potrzebujesz.
Twoja witryna na jednym ekranieOsiem grup, 13 kart, 39 bloków. Każda liczba pokazuje zmianę od poprzedniego crawla.
Szybkość, 40 tygodni wsteczCore Web Vitals prawdziwych użytkowników Chrome od pierwszego dnia, z progami dobry i słaby od Google, także dla każdej grupy stron.
Kliknięcia i wyszukiwaniaKliknięcia i wyświetlenia dziennie w porównaniu z poprzednimi 28 dniami oraz 25 śledzonych wyszukiwań z pozycjami.
Aktualizacje Google na tle twoich kliknięćDwa lata aktualizacji rankingu naniesione na twój ruch, z danymi przed i po każdej z nich.
Wyszukiwanie AIKtórzy asystenci AI odwiedzają witrynę, co dostaje każdy z nich, AI Overviews i zweryfikowane boty.
Treść w skrócieDługości title, description i H1, grupy stron i najczęściej linkowane strony.
ProgramPlan działań według statusu i osoby odpowiedzialnej; poprawka oznaczona jako Gotowe, która wciąż ma uwagę, robi się czerwona.
Stwórz własnyDo 10 dashboardów: zacznij od nowego lub skopiuj kartę, potem dodawaj, przesuwaj, zmieniaj rozmiar i usuwaj bloki.
Czuwa za ciebie
Neova nie kończy na crawlu. Obserwuje twoje witryny między crawlami i mówi ci, gdy coś się zmienia, na komputerze, telefonie lub kanałach twojego zespołu.
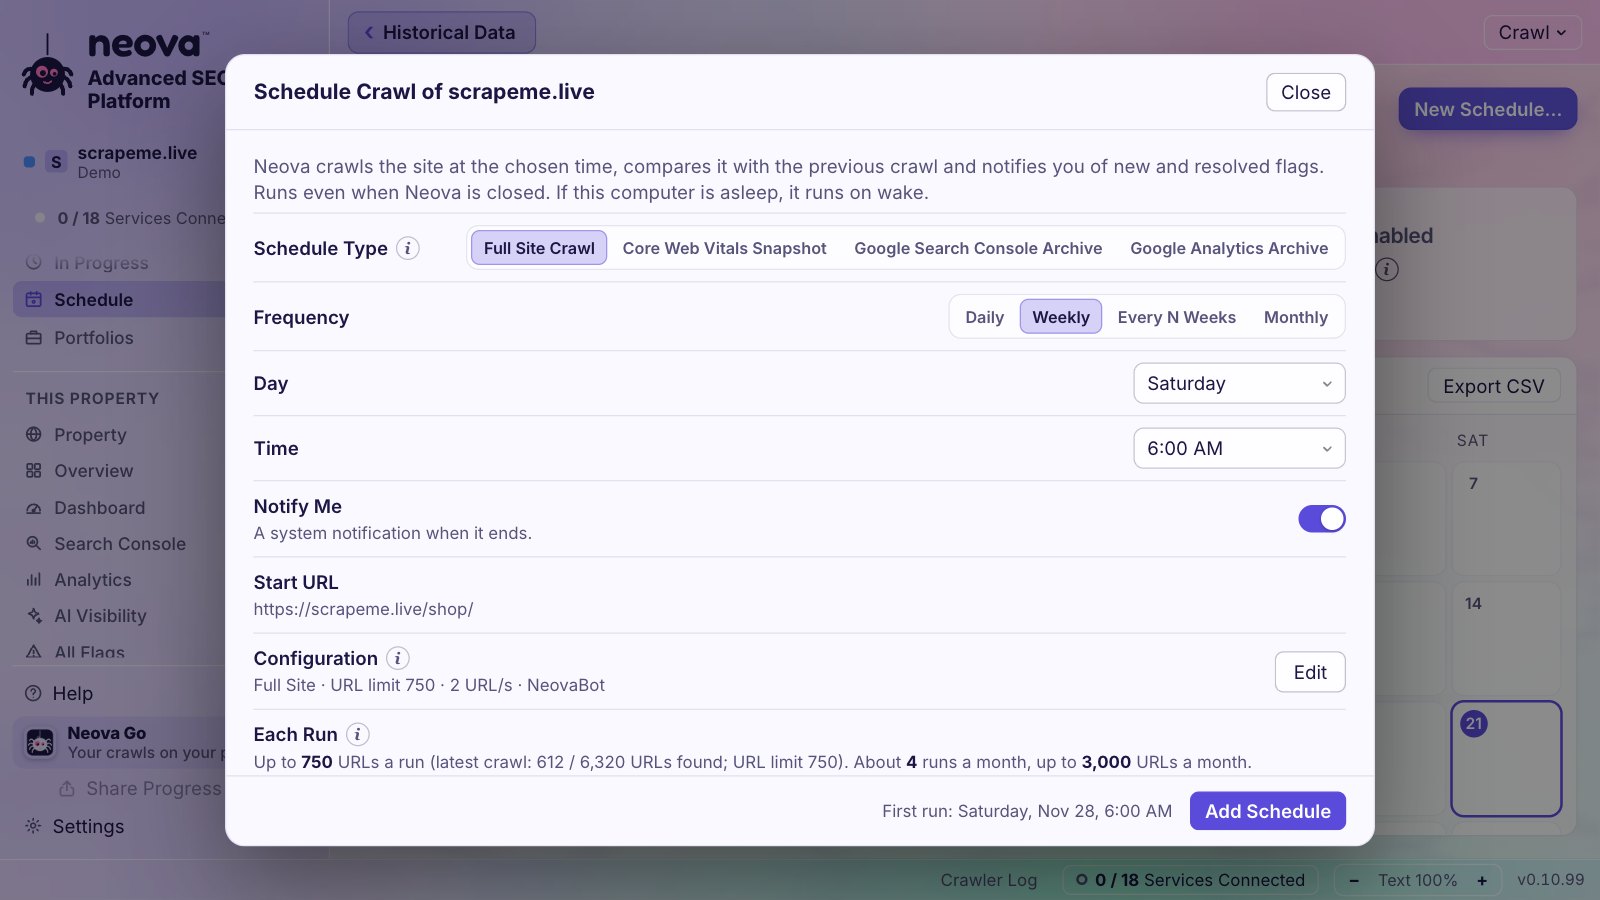
HarmonogramJak często, w jaki dzień i o której oraz ile kosztuje każde uruchomienie.Neova GoPasek menu, alerty i twój telefon.Migawki Core Web VitalsSzybkość od prawdziwych użytkowników według własnego harmonogramu, bez crawla.
Crawle według harmonogramuCodziennie, co tydzień, co kilka tygodni lub co miesiąc, dla każdej usługi, nawet przy zamkniętym oknie. Przypomnienie 15 minut wcześniej, Odłóż lub Pomiń z paska menu i koszt harmonogramu pokazany, zanim go dodasz.
Alerty, które mają znaczenieCore Web Vitals zmieniają ocenę, kliknięcia spadają o 20% lub więcej w tydzień, śledzone wyszukiwanie wchodzi do top 10 lub z niego wypada albo traci 3 pozycje, nowy crawl ma nowe uwagi. Sprawdzane po każdym zaplanowanym uruchomieniu lub gdy klikniesz Sprawdź teraz.
Crawl obserwacyjnySprawdza ponownie tylko twoje kluczowe strony, bez wyszukiwania nowych, i wysyła alert, gdy zmieni się status, przekierowanie, title, canonical, noindex, H1 lub rozmiar strony.
Migawki Core Web VitalsSzybkość u prawdziwych użytkowników Chrome według harmonogramu, bez crawla, dokładana do trendu, który możesz śledzić tydzień po tygodniu.
Śledzone wyszukiwania, codziennieDo 25 wyszukiwań na usługę z Search Console: pozycja z 7 i 90 dni, kliknięcia i wyświetlenia oraz to, czy Google pokazuje AI Overview, który cię cytuje.
Aktualizacje Google na tle twoich kliknięćDwa lata aktualizacji rankingu i incydentów Google naniesionych na twoje dzienne kliknięcia, z kliknięciami przed i po każdej z nich.
Pełny audyt co miesiącCały audyt, z konkurencją, powtarzany co miesiąc; Neova kończy analizę i PDF przy następnym uruchomieniu.
Alerty tam, gdzie jesteśNeova Go na pasku menu i na telefonie, powiadomienie, gdy crawl się kończy, oraz Slack i Microsoft Teams, przy czym każde portfolio lub każda usługa wysyła na własne kanały.
Również w Neova
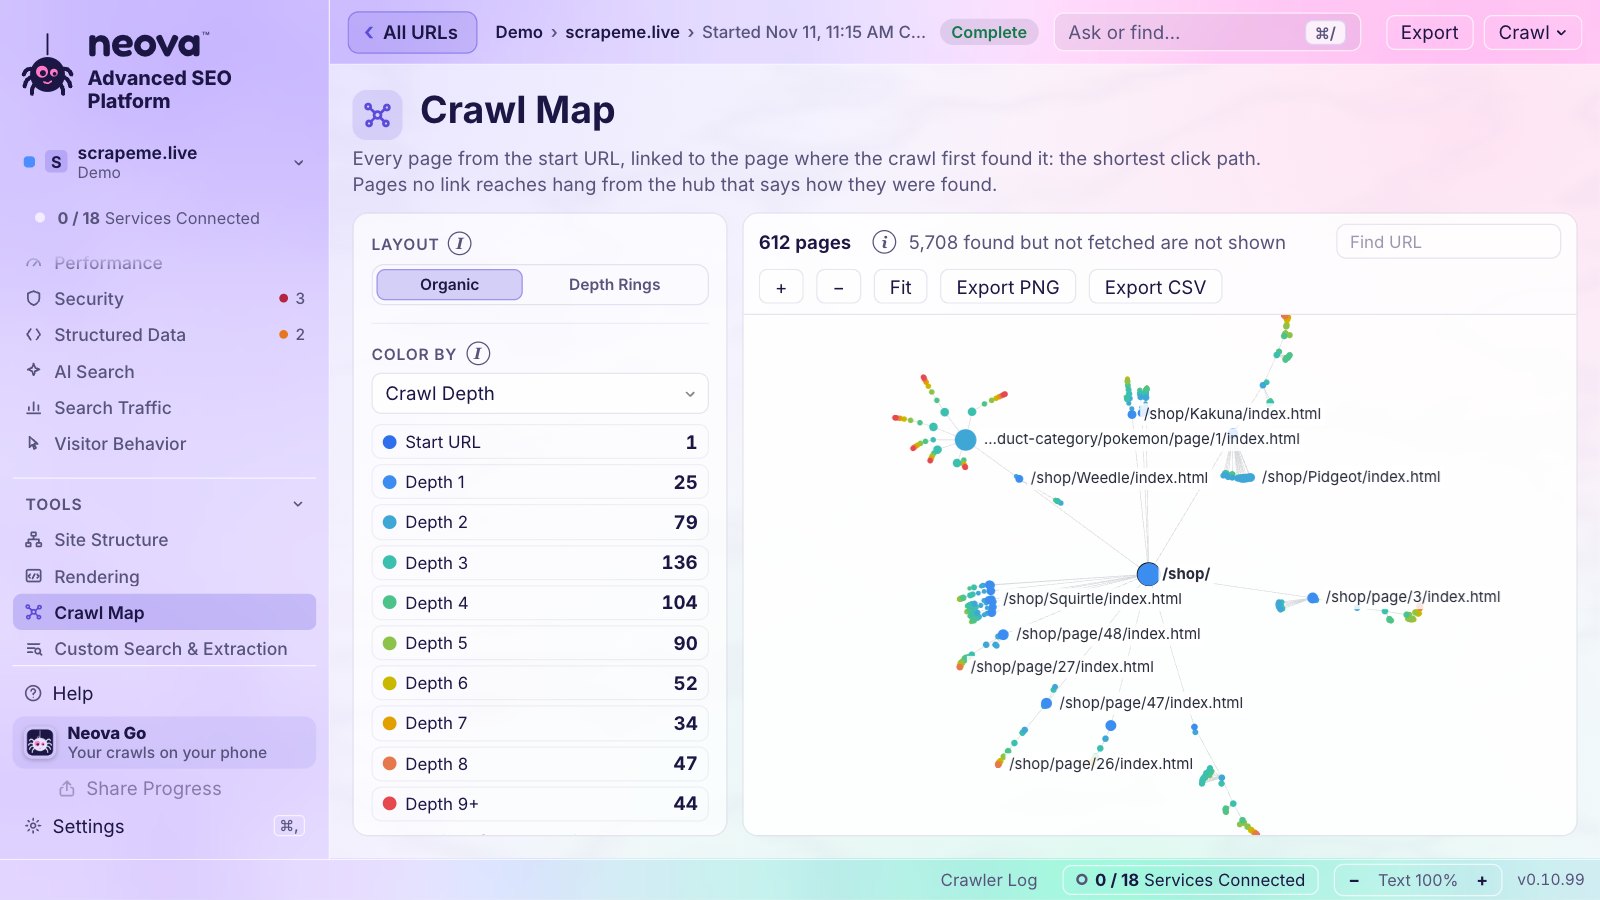
Mapa crawlaJak każda strona została po raz pierwszy znaleziona, pokolorowane według statusu.Wszystkie URLKażdy URL ze statusem, indeksowalnością i rozmiarem.Dane historyczneTwoje crawle i dane z Search Console, zachowane po tym, jak Google je usunie.
Log crawleraKażdy URL pobierany przez crawl, na żywo, z kolorowym kodem odpowiedzi i czasem odpowiedzi; etapy pogrubione, błędy na czerwono. Skopiuj go dla supportu jednym kliknięciem.
Zablokowany crawl wyjaśnionyGdy witryna odmawia crawla, Neova mówi dlaczego (limit żądań, firewall, blokada kraju) i co zrobić, z tajnym nagłówkiem do listy dozwolonych, który przekażesz działowi IT.
Diagnoza crawlaCzyta log crawla i nazywa, co poszło nie tak: odpowiedzi 429 i 403, blokady w robots.txt, strony tylko w JavaScripcie, z ustawieniem do zmiany.
Podział URLKażdy znaleziony URL trafia do dokładnie jednego koszyka, więc zawsze wiesz, skąd wzięły się dodatkowe tysiące, jeszcze w trakcie crawla.
Crawl na żywo, który możesz śledzićEtapy ze strzałkami, Najnowsze URL-e, mapa crawla na żywo i wykres czasów odpowiedzi, a do tego Udostępnij postęp, by każdy mógł go śledzić.
Search Console i Analytics, zachowane na dobreGoogle usuwa dane z Search Console po 16 miesiącach, a dane zdarzeń z Analytics po 2 lub 14. Neova archiwizuje każdy miesiąc obu na twoim komputerze, według harmonogramu: strony, zapytania, dni i Discover z Search Console; dni, organiczne strony docelowe, kanały, źródła i kraje z Analytics. Tak długo, jak chcesz.
Wiedz, zanim zacznieszNajpierw czyta kilka stron i mówi, ile URL-i wymieniają mapy stron i ilu obrazów się spodziewać, więc ty wybierasz wielkość crawla.
Crawl, którego nigdy nie straciszNajpierw strony, strażnik dysku, Zakończ zapisuje crawl, aktualizacje na niego czekają, a Wznów kontynuuje z jego własnymi ustawieniami.
Koszty pokazane z góryKoszty DataForSEO są szacowane, zanim cokolwiek zostanie wydane, z limitem dla każdego crawla. Rachunki za dane trafiają do ciebie, po cenie dostawcy.
Wypróbuj na prawdziwych danychKażde konto Neova Online zaczyna od Demo: sklep i trzech konkurentów, już przecrawlowanych, wszystkie ustawienia uzupełnione.
Twoje klucze zostają twojeKażdy klucz, token i dane logowania trafiają do pęku kluczy twojego systemu, nigdy do pliku ani na ekran. Neova nie dostarcza własnego klucza API: za to, za co płacisz, rachunek dostajesz ty.
W 15 językachOkno i biblioteka testów po angielsku, francusku, niemiecku, hiszpańsku, portugalsku, włosku, japońsku, niderlandzku, polsku, turecku, koreańsku, chińsku, rosyjsku, indonezyjsku i wietnamsku.
Współpracuje z
31 usług
Neova łączy się z 31 usługami, których już używasz, od Google Search Console po Slacka, Jirę i twój własny dysk w chmurze. Każda z nich jest opcjonalna.
Google
Google Search Console
Google Analytics
Chrome UX Report
Google Cloud
Gemini
Microsoft i Bing
Bing Webmaster Tools
OneDrive
Microsoft Teams
Dane SEO
DataForSEO
Semrush
Ahrefs
Majestic
Moz
SEO Gets
AI
Anthropic
OpenAI
Ollama
Tickety
Jira
Linear
Asana
ClickUp
monday.com
Alerty i logi
Slack
Microsoft Teams
Cloudflare
Pliki i pamięć
Dysk Google
Dropbox
iCloud Drive
Proton Drive
kDrive
OneDrive
Otwiera ich crawle
Screaming Frog
Sitebulb
Logo należą do ich właścicieli i pokazują jedynie, że Neova łączy się z tymi usługami. Neova nie jest powiązana z żadną z nich.
Obok siebie
78 funkcji
Każda funkcja, znacznik dla każdego narzędzia. Pokaż szczegóły dodaje, co każde z nich robi, ze stroną dokumentacji tego narzędzia, z której to pochodzi.
Gdzie i jak crawlujeScreaming Frog 15Sitebulb 13Semrush 10Ahrefs 10Lumar 13JetOctopus 13Neova 17z 17
Funkcja
Screaming Frog
Sitebulb
Semrush
Ahrefs
Lumar
JetOctopus
Neova
Aplikacja desktopowa
✓„Do uruchomienia SEO Spidera wymagany jest 64-bitowy system operacyjny”. źródło
✓Tylko Windows i macOS („64-bitowa wersja Windows 10 lub 11”) źródło
–Tylko aplikacja webowa, nic do instalowania źródło
–Tylko SaaS w chmurze, bez aplikacji desktopowej źródło
–Tylko SaaS w chmurze, bez aplikacji desktopowej źródło
✓Mac (Apple silicon), Windows i Linux
W przeglądarce
◐Na twoim serwerzebrak wersji przeglądarkowej lub hostowanej. źródło
✓Sitebulb CloudSitebulb Cloud: „Sitebulb Cloud daje ci wszystkie możliwości wersji Desktop, dostępne przez przeglądarkę”. Każdy klient dostaje serwer w rodzaju yoursite.sitebulb.cloud. źródło
✓Aplikacja webowaW pełni w przeglądarce: Semrush opisuje się jako „wiodąca platforma SaaS do zarządzania widocznością online”. źródło
✓Aplikacja webowaAhrefs działa tylko w chmurze źródło
✓Aplikacja webowaSaaS w przeglądarce: „Zapewniamy dostęp do Aplikacji przez obsługiwaną przeglądarkę w modelu software-as-a-service (SaaS)” źródło
✓Aplikacja webowaPlatforma chmurowa w przeglądarce źródło
✓Neova OnlineNeova Online w dowolnej przeglądarce, na tym samym koncie co aplikacja desktopowa, zawsze zsynchronizowana
Renderowanie JavaScript
✓„Renderuj strony za pomocą zintegrowanego Chromium WRS, aby crawlować dynamiczne witryny i frameworki bogate w JavaScript, takie jak Angular, React i Vue.js”. Tylko w płatnej licencji. źródło
✓Chrome Crawler: „Sitebulb używa silnika renderującego Evergreen Chromium, tak jak Google” źródło
✓Tak, w planach Guru lub Business (Semrush One Pro+ lub Advanced) źródło
✓„Tryb crawla z renderowaniem JavaScriptu jest wliczony w cenę planu (bez osobnej opłaty)”, ale „jedna strona renderowana JS liczy się jak dwie zwykłe przecrawlowane strony”. źródło
✓Chrome, dla każdej strony lub dla wybranej liczby stron
Tryb listy
✓„Mode > List”: „sprawdź z góry określoną listę URL-i…” źródło
✓Reguły „Allow subfolders” i „Disallow subfolders” oraz „Parameters to ignore”, dzięki którym Site Audit usuwa parametry URL podczas crawlowania. źródło
✓Reguły regex: „Only crawl URLs matching the pattern” i „Don't crawl URLs matching the pattern” oraz „Remove URL parameters” i reguły przepisywania URL-i. źródło
✓Pola „Included Only URLs” i „Excluded URLs” (regex w Ruby) źródło
✓Reguły „Allow Pattern” i „Deny Pattern” w ustawieniach zaawansowanych, jako ścieżki URL lub regex z prefiksem „rx:” źródło
✓Uwzględnianie, wykluczanie i lista wykluczeń dla każdego crawla
Limity prędkości crawla
✓„kontroluj prędkość SEO Spidera liczbą równoległych wątków lub liczbą URL-i żądanych na sekundę” (domyślnie 5 wątków). źródło
✓Liczba wątków lub instancji Chrome i „Max HTML URLs per Second” źródło
✓Domyślna prędkość jest „ograniczona do maksymalnie 30 URL-i na minutę” źródło
✓Prędkość crawla w URL-ach na sekundę (maksimum dla konta ustala Lumar), a do tego można „dodać ograniczenia, by zmniejszyć lub zwiększyć prędkość crawli w określonych godzinach”. źródło
✓robots.txt Overwrite do „testowania nowego robots.txt, zanim trafi na produkcję” w całym crawlu źródło
✓Darmowe Robots.txt Multi-tool „waliduje plik robots.txt, wyróżnia sprzeczne dyrektywy” i symuluje reguły dla każdego bota źródło
✓Tester robots.txt; respektuj, ignoruj lub użyj wersji roboczej
Własny user agent
✓„wbudowane gotowe user agenty dla Googlebota, Bingbota, różnych przeglądarek i innych” plus własny user agent żądań HTTP i osobny Robots User-Agent. źródło
✓Gotowe ustawienia „w tym Google, Bing, Yahoo i Yandex” plus „Custom User Agent” i własny UA dla robots.txt. źródło
◐tylko gotowe ustawienia, „W sumie jest 5 user agentów” źródło
✓Dowolny user agent oraz crawl jako crawler AI
Logowanie i uwierzytelnianie
✓„dwie formy uwierzytelniania: oparte na standardach, czyli uwierzytelnianie basic i digest, oraz uwierzytelnianie przez formularze internetowe”. źródło
✓Uwierzytelnianie HTTP i przez formularze plus własne nagłówki HTTP. źródło
◐tylko basic auth: „Crawl with my credentials” dla witryn „ukrytych za uwierzytelnianiem basic”, plus opcja podpisu Web Bot Auth. źródło
◐Tylko uwierzytelnianie HTTP, w planie Advanced i wyższych źródło
◐uwierzytelnianie basic („dołączaj dane uwierzytelniające do wszystkich żądań przy użyciu uwierzytelniania basic”), własny DNS, lista dozwolonych IP i cookies logowania przez własne nagłówki żądań źródło
✓Po osiągnięciu limitów crawla możesz „dostosować ustawienia crawla, wznowić crawl lub go zakończyć” źródło
✓Trwające crawle można wstrzymywać i wznawiać źródło
✓Wstrzymaj, Wznów, a Zakończ najpierw zapisuje crawl
Crawl wielu witryn naraz
✓Osobne okno na crawlFAQ: „Otwórz kilka instancji SEO Spidera, po jednej dla każdej domeny, którą chcesz crawlować”, albo użyj trybu listy z listą domen. źródło
◐Cloud: od planu MediumWersja desktopowa ustawia audyty w kolejce („będą uruchamiane jeden po drugim”) źródło
✓Bez limituFAQ: „możesz uruchamiać crawle, duże i małe, wszystkie jednocześnie” oraz „Nie ograniczamy liczby różnych domen, które możesz crawlować”. źródło
✓Bez ograniczeń„Równoczesne crawle są nieograniczone we wszystkich planach JetOctopus, bez dodatkowych opłat”. Projekty i domeny też są bez limitu. źródło
✓4 w jednym oknieDo 4 witryn naraz, każda we własnym tempie, ze strażnikiem pamięci (0.10.38)
Limity URL-i
✓Bez ograniczeń, płatnieWersja darmowa: 500 URL-i na crawl. źródło
✓Od 10K do 10MLite: „10,000 URL-i na audyt” źródło
✓Od 20K do 100KNa audyt: 100 za darmo, 20,000 w Pro i Guru, 100,000 w Business. źródło
✓Diagramy crawla i katalogów oparte na sile (2D i 3D), grafy drzewa crawla i katalogów, chmury słów i diagram semantycznych klastrów treści (v22.0). źródło
✓Interaktywne „mapy crawla” („Best Software Innovation” na US Search Awards 2018), inne wizualizacje witryny, wykresy i osie czasu. źródło
◐wykresy plus widok „Site Structure” z „subdomenami i podkatalogami, z liczbą URL-i i problemów w każdym”. źródło
✓„Wizualizuje dane na wykresach i diagramach” dla indeksowalności, szybkości ładowania, duplikatów i kodów odpowiedzi źródło
◐wykresy podziału, lejka i trendu na dashboardach i w każdym raporcie (karty „Trends & Segments”, „Breakdown”). źródło
✓„JetOctopus oferuje ponad 97 raportów, 381 wykresów, 26 zbiorów danych” źródło
✓Mapa crawla
Porównanie crawli
✓„Mode > Compare” pokazuje dodane, nowe, usunięte i brakujące URL-e dla każdej karty i filtra, kartę Change Detection i porównanie struktury witryny (wymaga licencji i zapisu w bazie danych) źródło
✓„Audit Comparison”: „Śledź zmiany w czasie, sprawdź, co jest inaczej od ostatniego audytu” źródło
✓„Compare Crawls” pozwala „zobaczyć dowolne wcześniejsze audyty witryny w porównaniu obok siebie” z problemami naprawionymi i nowymi źródło
✓„Site Audit pozwala porównać dowolne dwa crawle” źródło
✓Każdy raport porównuje z poprzednim crawlem źródło
✓„Możesz porównać dowolne crawle, nie tylko dwa ostatnie”, ze wszystkimi wykresami i tabelami danych crawlera, także według segmentu źródło
✓Własne wyszukiwanie w kodzie źródłowym i „Custom Extraction: pobieraj dowolne dane z HTML URL-a za pomocą XPath, selektorów CSS Path lub regex” źródło
✓Ekstrakcja treści selektorem CSS (wizualny selektor „wskaż i kliknij”) źródło
✓Regex Custom Extraction (30 metryk ekstrakcji) źródło
✓„w czasie crawla możesz skonfigurować do 50 własnych reguł ekstrakcji” źródło
✓Wyszukiwanie i ekstrakcja
Przegląd treści strony przez AI
✓OpenAI, Gemini, Anthropic, OllamaBezpośrednie integracje API z OpenAI, Gemini, Anthropic i Ollama (LM Studio przez integrację OpenAI) źródło
◐MCP, tylko odczytżadne prompty AI nie są uruchamiane na treści stron w czasie crawla. źródło
◐Jedna strona narazContent Toolkit, jedna strona naraz źródło
◐Gotowe zadaniatylko stałe zadania AI: „Ask AI” i „Batch AI” piszą title i meta description (Project Boost), plus wykrywanie treści AI źródło
◐Wbudowanebrak własnych promptów użytkownika dla treści stron. źródło
◐Wbudowane, MCPbrak promptów użytkownika uruchamianych na każdej stronie źródło
✓Ollama, Anthropic, OpenAI44 testy przeglądu AI uruchamiane przez Ollama na twoim komputerze; klucze Anthropic i OpenAI w Połączeniach
Podobieństwo semantyczne
✓Embeddingi wektorowe z OpenAI, Gemini lub Ollama „do wykrywania semantycznie podobnych stron i treści o niskiej trafności, a także do wyszukiwania semantycznego i diagramu klastrów treści” źródło
◐nic wbudowanego. Poradnik na ich stronie (8 października 2026, autor gościnny) źródło
✓Błędy „Pages returning 4XX status code” i „Pages returning 5XX status code”, błędy DNS i crawla, plus powiadomienie o linkach zewnętrznych zwracających 403. źródło
✓Strony z kodem innym niż 200 są „wymienione przy odpowiednim problemie” (404, 4XX, 5XX, 403, przekroczony czas, zepsute przekierowania) źródło
✓Raporty dla stron 200, przekierowań 301 i innych niż 301, „4xx Errors”, „5xx Errors”, „Uncategorized HTTP Response Codes” i nieudanych URL źródło
✓Wykresy kodów odpowiedzi i tabele danych w crawlach i logach źródło
✓Tak, wszędzie oznaczone kolorami
Przekierowania i łańcuchy
✓„Znajdź przekierowania tymczasowe i stałe, wykryj łańcuchy i pętle przekierowań” źródło
✓13 wskazówek Redirects (zepsute przekierowania, pętle przekierowań, przekierowania ukośnika na końcu i wielkości liter, meta refresh) źródło
✓„Redirect chains and loops” (Error), „Pages with temporary redirects”, „URLs with a permanent redirect” źródło
✓Problem „Redirect chain” „zgłasza URL, które prowadzą przez serię przekierowań” źródło
✓Raporty „Redirect Chains” („przekierowanie na inny URL, który też jest przekierowaniem”), „Redirect Loops”, zepsute przekierowania, przekierowania JavaScript i meta refresh oraz „Max Redirections”. źródło
✓Tabela danych łańcuchów przekierowań, w której „możesz też zmienić liczbę skoków w łańcuchu przekierowań” źródło
✓22 testy przekierowań, łańcuchów i pętli
Canonicale
✓Zakładka Canonicals obejmuje elementy link canonical i nagłówki HTTP źródło
✓Wskazówki Indexability obejmują tagi canonical źródło
✓Błędy „Pages with a broken canonical link”, „Pages with multiple canonical URLs” i „AMP pages with no canonical tag” źródło
✓Problemy takie jak „Canonical points to redirect”, canonical wskazujący na 4XX lub 5XX, strona niekanoniczna wskazana jako kanoniczna i niezgodność canonicala HTTP/HTTPS. źródło
✓„Conflicting Canonical Tags” („w tagach canonical w HTML albo w nagłówkach HTTP”), Canonical to Non-200, Pages without Canonical Tag, Unlinked Canonical Pages, Change źródło
✓Dla rel=canonical: „Stworzyliśmy kilka raportów z najczęstszymi problemami”, plus specjalny tryb dla osobnych subdomen mobilnych. źródło
✓Tak
Raport indeksowalności
✓Każdy URL jest „Indexable” albo „Non-Indexable” z powodem w „Indexability Status” źródło
✓„sprawdza nakładające się lub niespójne dyrektywy robots, problemy z canonicalami i błędy konfiguracji robots.txt” źródło
✓Kategoria problemów z indeksowalnością i wykres rozkładu źródło
✓Raporty „Non-Indexable Pages” („zablokowane przed indeksacją przez noindex lub canonical”), noindex, skanonikalizowane i zablokowane (disallow) źródło
✓Wbudowany segment „Indexable” dla wszystkich raportów źródło
✓145 testów indeksowalności
Paginacja
✓Zakładka Pagination dla rel=„next” i rel=„prev” źródło
◐wskazówki „Pagination URL has no incoming internal links” i „Query string contains paginated parameters” źródło
✓Sprawdza crawlowalność stron paginacji w crawlu i logach źródło
✓Testy paginacji
Hreflang
✓„Audytuj brakujące tagi zwrotne, niespójne i błędne kody języków, hreflang z odpowiedzią inną niż 200 i więcej” źródło
✓„sprawdza, czy tagi hreflang są poprawne, wzajemne, unikalne, spójne i wskazują same na siebie” źródło
◐Raport International SEO sprawdza konflikty, wartości, zepsute linki i brakujące tagi, ale „Obecnie Semrush sprawdza tylko HTML twojej witryny” (nie mapy stron ani nagłówki). źródło
✓Oznacza błędne kody, brak odwołania do siebie, brak tagów zwrotnych, hreflang do stron zepsutych lub niekanonicznych źródło
✓Testy Sitemaps: „URLs Not In Sitemap”, „Orphan URLs”, „Non-Indexable URLs In Sitemap”, „XML Sitemap With Over 50k URLs”, „XML Sitemap Over 50mb”, „URLs In Multiple Sitem źródło
✓9 wskazówek XML Sitemaps (4XX, 5XX, noindex, skanonikalizowane, zablokowane, przekierowanie, przekroczony czas, URL w wielu mapach stron), wykrywanie stron osieroconych i generator map stron XML. źródło
✓Błędy takie jak „Format errors in sitemap.xml files”, „Incorrect pages found in sitemap.xml”, „Sitemap.xml files are too large” źródło
✓Problemy z mapą strony takie jak „Non-canonical page in sitemap”, strony noindex, 3XX, 4XX lub 5XX w mapie strony, strony z mapy z przekroczonym czasem i błędny format (tylko XML). źródło
✓Nieindeksowalne, błędne i przekierowujące URL w mapach stron, zepsute lub zablokowane mapy stron, zbyt wiele URL, puste mapy stron źródło
✓Raport map stron z URL osieroconymi i z kodem innym niż 200, „Sitemaps problems by depth” i tabela „Sitemap files” źródło
✓20 testów map stron XML
Linki wewnętrzne i Link Score
✓„Analizuj linki wewnętrzne, liczbę linków, głębokość crawla i obliczaj wewnętrzny Link Score” źródło
✓„URL Rank, czyli UR, to miara wewnętrznej siły strony oparta na względnej wadze linków” źródło
✓Raport Internal Linking i ILR dla każdej strony źródło
✓Page Rating (PR) ocenia siłę linków każdego URL „w skali logarytmicznej od 1 do 100” źródło
✓DeepRank: „miara wagi linków wewnętrznych liczona podobnie jak podstawowy algorytm PageRank Google”, w skali od 0 do 10 źródło
◐dogłębna analiza linków (linki przychodzące, anchory, nofollow, Linking Explorer) źródło
✓Link Score i 51 testów linków
Strony osierocone
✓„Do wykrycia stron osieroconych potrzebne są dodatkowe źródła URL: mapy stron XML oraz integracja z API Google Analytics i Search Console.” źródło
✓Strony osierocone to „URL wykryte w audycie, ale NIE przez crawlera”, znalezione przez mapy stron XML, Google Analytics, Search Console lub listy URL źródło
✓Powiadomienia „Orphaned pages (from Google Analytics)” i „Orphaned pages (in sitemap)” źródło
◐„Orphan page” obejmuje URL bez przychodzących linków wewnętrznych, które pochodzą z URL startowych crawla albo zostały „znalezione w pliku mapy strony” źródło
✓Raporty stron osieroconych dla każdego źródła (Search Console, analityka, mapy stron, pliki logów, listy URL, backlinki), np. źródło
✓Raport „Orphan Pages” ze źródeł URL z mapy strony i GSC, z filtrem według źródła źródło
✓Strony osierocone, z Search Console, Analytics i map stron XML
Bezpieczeństwo i HTTPS
✓„Wykryj niezabezpieczone strony, mieszaną treść, niezabezpieczone formularze, brakujące nagłówki bezpieczeństwa i więcej” źródło
✓Raport Security sprawdza protokoły TLS, zestawy szyfrów i certyfikaty źródło
◐Testy HTTPS (mieszana treść, certyfikaty, stary TLS, „Subdomains don’t support HSTS”) źródło
◐Testy HTTPS takie jak „HTTPS page has internal links to HTTP”, przekierowania z HTTPS na HTTP i mieszana treść źródło
✓„HTTPS Pages without HSTS”, strony HTTP, skrypty HTTP na stronach HTTPS, mieszana treść, linki z HTTPS do HTTP źródło
◐Tylko mieszana treść HTTPS, np. „Links to HTTP pages (mixed content)” i obrazy HTTP źródło
✓29 testów bezpieczeństwa
AMP
✓„Crawluj URL AMP i waliduj je oficjalnym wbudowanym AMP Validator” źródło
✓Raporty konfiguracji mobilnej (responsywna, dynamiczna, osobna wersja mobilna), „Discouraged Viewport Types” („słaba zgodność z urządzeniami mobilnymi”), niezgodności osobnej wersji mobilnej źródło
✓Crawl jako Googlebot Mobile „ujawnia problemy z użytecznością mobilną”, takie jak „błędna konfiguracja viewportu, za mała czcionka, elementy dotykowe” źródło
✓Testy viewportu i wersji mobilnej
Obrazy
✓Brak tekstu alternatywnego i atrybutu alt, „Over 100 kb”, alt dłuższy niż 100 znaków, „Incorrectly Sized Images”, „Missing Size Attributes”, obrazy tła, brak image t źródło
✓„Images with missing alt text”, „Has an anchored image with no alt text”, „Transferred image size is over 100KB”, „Properly size images”, „Add dimensions to images”, next źródło
✓„Sprawdzamy rozmiar obrazów, czas ładowania i typy treści”, zepsute obrazy i atrybuty alt („Set” i „Not set”) źródło
✓„Broken Images”, „Links with Images Missing Alt Tags”, reguły dostępności image-alt i audyty obrazów Lighthouse w Site Speed (bez wymiarów, poza ekranem, niezoptymalizowane, nieresp źródło
✓20 testów obrazów i próbkowanie obrazów w każdej grupie stron
Szybkość i Core Web VitalsScreaming Frog 3Sitebulb 1Semrush 1Ahrefs 4Lumar 4JetOctopus 3Neova 4z 4
Funkcja
Screaming Frog
Sitebulb
Semrush
Ahrefs
Lumar
JetOctopus
Neova
Lighthouse
✓„Połącz się z API PSI, aby pobrać metryki Lighthouse, możliwości przyspieszenia, diagnostykę i Chrome User Experience Report (CrUX) źródło
✓Lighthouse „Opportunities and Diagnostics” uruchamiane „na każdej przecrawlowanej stronie” przez wbudowany Chrome Crawler, plus laboratoryjne metryki Web Vitals (LCP, CLS, TBT, TTI, FCP źródło
✓Raport Core Web Vitals „oparty na narzędziu Lighthouse od Google” (LCP, CLS, TBT) źródło
✓PageSpeed Insights dla każdej strony z twoim własnym darmowym kluczem Google API źródło
✓W Site Speed: „metryki wydajności Lighthouse na dużą skalę”, z raportami możliwości i diagnostyki dla każdej strony oraz wbudowanym Lighthouse Viewer (czerwiec 2025). źródło
✓API PageSpeed z twoim własnym kluczem („Twój limit wyniesie 30,000 zapytań dziennie”) źródło
✓LCP, INP i CLS prawdziwych użytkowników Chrome, z twoim kluczem Chrome UX Report
Trend Core Web Vitals
◐nie znaleziono wykresu trendu CWV w aplikacji. źródło
◐arkusz Google „Historical Audit Data” ma jeden wiersz na audyt, do „danych w szeregach czasowych lub wykresów” w Looker Studio, i zawiera przedziały Core Web Vitals (changelog, 13 źródło
◐nie znaleziono raportu crawlerów AI ani ustawienia wstępnego dla botów AI źródło
✓„Blocked from AI Search” sprawdza robots.txt dla ChatGPT-User, OAI-SearchBot, Googlebot, Google-Extended, Perplexity-User, PerplexityBot, Claude-User, Claude-SearchBot. źródło
✓Problemy AI Discoverability (wrzesień 2026) źródło
✓„ChatGPT Blocked” („zablokowane w robots.txt dla tokenów user agenta GPTBot lub ChatGPT-User”), Google AI Blocked (Google-Extended), Bing AI Blocked, AI Bot Blocked, Common źródło
✓Darmowe narzędzie Robots.txt Multi-tool pozwala „sprawdzić reguły dostępu dla wyszukiwarek i crawlerów AI w jednym miejscu”, w tym GPTBot, ClaudeBot i PerplexityBot. źródło
✓Co może pobrać każdy crawler AI i co naprawdę dostaje 10 asystentów AI
◐brak testów pod odpowiedzi AI. Raport Response vs Render ma pomóc „dokładnie ustalić, co widzą LLM-y” źródło
✓Testy AI Search: „Too much content”, „Outdated Content” (Last-Modified starszy niż sześć miesięcy), „Low Semantic HTML Usage”, „Content not optimized” (nagłówki, długie akapity, r źródło
✓AI Discoverability: strony „zbyt wolne lub ciężkie dla crawlerów AI”, „Pages requiring JavaScript rendering”, „Similar AI-generated content” źródło
✓AI Page Optimizer „dopasowuje docelowe słowa kluczowe do tytułu, meta i treści” pod query fan-out i sprawdza, „czy JavaScript ukrywa twoją treść przed agentami AI”. źródło
✓GA4 i GA360: wizyty, współczynnik odrzuceń, odsłony i konwersje dla każdego URL, z filtrem na ruch organiczny, „Google or Bing Organic Search Landing Pages, or All” źródło
✓„integracja działa tylko z Google Analytics 4. źródło
✓Google Analytics 4
Bing Webmaster Tools
◐Bingbot to tylko ustawienie wstępne user agenta źródło
◐Bing to tylko ustawienie wstępne user agenta źródło
◐Bingbot w logach i testerze robots.txt („Pełne dane o Googlebot, Bingbot, GPTBot, ClaudeBot i 40+ innych crawlerach”) źródło
✓Bing Webmaster Tools, w tym cytowania w Bing AI
Śledzenie pozycji
◐brak trackera pozycji. Integracja z GSC Search Analytics daje średnią „Position” dla każdego URL. źródło
◐brak trackera pozycji. Raport Keywords korzysta z danych GSC źródło
✓Position Tracking „codziennie monitoruje pozycje twojej witryny w wyszukiwarce” według urządzenia i lokalizacji „aż do kodu pocztowego”, w Google, Bing, Baidu, ChatGPT Search i AI Mode. źródło
✓Rank Tracker: Google, „śledzenie na mobile i desktopie”, 190+ lokalizacji aż do kodu ZIP, 19 funkcji SERP źródło
◐brak trackera pozycji; tylko pozycja z GSC dla strony i zapytania. źródło
◐Pozycje na podstawie GSC, bez trackera pozycji w SERP źródło
✓25 śledzonych wyszukiwań dziennie z Search Console; prawdziwe pozycje przez DataForSEO
Dane słów kluczowych
◐Metryki GSC Search Analytics dla każdego URL (konfigurowalny zakres dat i wymiary) źródło
✓Raport Keywords zbudowany na Google Search Console („enable Keyword Analysis”), ze słowami kluczowymi marki. źródło
✓Keywords Explorer: „28.7B słów kluczowych wybranych ze 110B wykrytych”, 217 lokalizacji, wolumen, Keyword Difficulty, potencjał ruchu źródło
✓Zapytania GSC dla każdej strony, do 2,000 przesłanych zapytań docelowych i wolumen wyszukiwań, który „pochodzi od zewnętrznego dostawcy” (Relevance Reporting) źródło
◐Tylko zapytania GSC i metryki słów kluczowych Ahrefs źródło
✓Zapytania z Search Console; luki słów kluczowych przez DataForSEO
Metryki backlinków
✓„Pobieraj metryki linków zewnętrznych z API Majestic, Ahrefs i Moz do crawla” źródło
–Nie znaleziono integracji z Ahrefs, Majestic ani Moz. źródło
✓Własny indeks backlinków (43T+ backlinków) źródło
✓Własny indeks Ahrefs („35T Live backlinks”) źródło
✓Integracja z Majestic („Integracja danych o backlinkach Majestic z Lumar jest darmowa”) źródło
✓Position Tracking: „Competitors Discovery Report pokazuje konkurentów organicznych, którzy mają pozycje na twoje słowa kluczowe” źródło
✓Nowe projekty „dostają propozycje konkurentów na podstawie witryn, które mają pozycje na podobne słowa kluczowe” źródło
✓W AI Visibility: „Marki są wykrywane automatycznie z odpowiedzi dostawców AI”, a Lumar klasyfikuje każdą jako Own, Competitor, Other lub Context. źródło
✓„New scheduled crawl” z częstotliwością codzienną, tygodniową, co dwa tygodnie lub miesięczną, datą startu i strefą czasową źródło
✓Harmonogramy z wcześniejszym powiadomieniem, Przełóż i Pomiń (aplikacja desktopowa)
Wykrywanie zmian
✓Zakładka „Change Detection” w trybie Compare dla wybranych elementów (tytuły, opisy, H1, liczba słów i więcej) źródło
✓„Lost and Found porównuje kluczowe metryki URL i wskazówki z bieżącego audytu z ostatnim poprzednim audytem” (Found, Lost, Remained) źródło
◐porównanie crawla z crawlem, a raport Robots.txt „powie ci, czy Semrush zauważył jakiekolwiek zmiany w twoim pliku robots.txt”. źródło
✓Always-on audit: „teraz możesz zobaczyć wszystko, co zmieniło się na twojej witrynie dowolnego dnia” źródło
✓Changed Metrics pokazuje, „które metryki zmieniły się między crawlami” dla każdego URL, plus raporty takie jak Pages with Changed Title, Status Code i Canonical URLs. źródło
✓Alerty plus własna ekstrakcja, by „śledzić zmiany elementów na stronie i sprawdzać, czy zgadzają się z oczekiwanymi wartościami” źródło
✓Zmiany treści między crawlami; zmiany podświetlają się w trakcie crawla
Alerty i powiadomienia
✓E-mail po zakończeniu crawla przez Outlook, Gmail lub własny SMTP, z tabelą Issues źródło
✓„Sitebulb wyśle ci miły e-mail za każdym razem, gdy audyt się zakończy” (ustawiane dla projektu, można podać kilka adresów). źródło
✓Site Audit wysyła „automatyczne aktualizacje e-mailem”, gdy jest zaplanowany źródło
✓Always-on audit wysyła e-mail, „jeśli nowa strona zostanie dotknięta problemem poziomu error” (także własne problemy), plus e-maile o zakończeniu crawla, raporty Rank Tracker i Ahrefs Alerts. źródło
◐„Sitebulb Cloud można zintegrować ze Slackiem, aby dostawać powiadomienia Slack o postępie audytów” (tylko Cloud, użytkownik z uprawnieniami administratora) źródło
◐Slack tylko dla alertów o konkurencji w Traffic & Market źródło
◐nie znaleziono natywnych alertów w Slacku ani Teams (alerty idą e-mailem). źródło
✓W Lumar Monitor: alerty „w aplikacji albo przez e-mail, Slack lub Microsoft Teams” źródło
✓„Otrzymuj powiadomienia w czasie rzeczywistym przez e-mail, Slack lub MS Teams” źródło
✓Slack i Microsoft Teams, dla każdego kanału, plus webhooki
✓Eksporty CSV w formatach arkuszy, eksport do Arkuszy Google (Keywords Explorer, Brand Radar, Bot Analytics), konektory Looker Studio dla Site Audit, Site Explorer, Rank Tra źródło
✓Pobieranie raportów CSV (plus CSV z Exploded Metric dla Excela), konektor Looker Studio „oficjalnego partnera Google” z szablonami i dashboardy w Arkuszach Google przez Zapi źródło
✓Eksport do „Excel, Google Sheets, CSV lub Google Data Studio (Looker)” źródło
✓Skoroszyt Excel (do Arkuszy Google), CSV gotowy dla Looker Studio
Miejsca eksportu
✓Folder lokalny; Google Drive jako Arkusze Google (ręcznie lub według harmonogramu źródło
✓Eksporty CSV i .xlsx zapisywane automatycznie po każdym audycie do folderu lokalnego „LUB współdzielonego folderu, np. w usłudze chmurowej takiej jak Dropbox” źródło
✓Pobieranie CSV, Arkusze Google (niektóre raporty), PDF przez drukowanie, konektory Looker Studio, plus API v3 i MCP źródło
✓Pobieranie raportów CSV lub XML, surowe dane jako pliki Parquet, konektory BigQuery i Looker Studio, Arkusze Google przez Zapier, narzędzia BI (Tableau, Power BI), API i webhook źródło
✓CSV, Excel, Arkusze Google i pliki map stron z tabel danych, plus konektor Data Studio, BigQuery („Eksportuj dane z crawla i GSC bezpośrednio do BigQuery”), API i MCP. źródło
✓Zakładka Dashboard w v25.0: „zbuduj własne dashboardy” z widżetów (wykresy, liczniki, procenty, tabele przeglądowe, lista problemów, wykres segmentów...) źródło
◐brak narzędzia CLI; usługa w chmurze sterowana przez API lub MCP, z tokenami „dla pipeline’ów CI, skryptów i zautomatyzowanych agentów” (Codex CLI, Gemini CLI). źródło
✓API v3 od planu Lite wzwyż, od 200,000 do 2,000,000 jednostek miesięcznie, z endpointami Site Audit, Site Explorer, Keywords Explorer, Rank Tracker i Brand Radar. źródło
✓„Lumar GraphQL API jest dostępne dla wszystkich użytkowników” w ramach „zasad uczciwego korzystania” źródło
✓Wszystkie plany: „dostęp do wszystkich podstawowych funkcji JetOctopus, w tym tworzenia projektów i crawli, danych wykresów, tabel danych i eksportów”. źródło
✓REST API Neova Online z kluczami API (0.10.38), plus serwer MCP i wiersz poleceń
◐Licencja na osobęlicencje są na użytkownika („Jeśli pięć osób z twojego zespołu chce korzystać z SEO Spider, potrzebujesz 5 licencji”), rabaty od 5. źródło
✓Od 2 do 10+ użytkownikówPlany Cloud obejmują użytkowników (Mini 2, Small 5, Medium 10, Enterprise 10+) źródło
✓Od $45 za użytkownika„Dodatkowi użytkownicy od $45/mies.” źródło
✓Od $40 za użytkownika1 użytkownik w cenie; dodatkowi użytkownicy źródło
✓4 role, SSORole w zespole „Admin, Editor, Reporter i Viewer” z uprawnieniami dla każdej aplikacji źródło
✓Bez limitu użytkowników„Projekty i miejsca (użytkownicy) źródło
WkrótceJuż wkrótce. Dziś jedna osoba na konto
Języki interfejsu
✓7„GUI jest dostępne po angielsku, hiszpańsku, niemiecku, francusku, włosku, niderlandzku i turecku” (7 języków źródło
✓1515 języków: angielski, niemiecki, hiszpański, francuski, indonezyjski, włoski, niderlandzki, polski, portugalski, szwedzki, turecki, ukraiński, chiński, japoński i koreański. źródło
◐Angielski, japońskinie znaleziono listy języków interfejsu. źródło
–AngielskiNie znaleziono w ich dokumentacji. źródło
✓1515 języków
Logi serwera
◐Log File Analyserosobny produkt, Screaming Frog Log File Analyser (Windows, macOS, Linux), do „weryfikacji botów wyszukiwarek i botów AI”. źródło
–WkrótceFAQ: „Sitebulb nie robi jeszcze analizy plików logów, ale to jest w planach i wkrótce będzie dostępne!” źródło
✓EnterpriseTak, jako osobny produkt Enterprise źródło
◐Bot AnalyticsBot Analytics, osobne narzędzie, darmowe w becie w płatnych planach, „przyjmuje dane o żądaniach HTTP” z Cloudflare, Vercel, CloudFront, load balancerów AWS lub Fastly źródło
◐W ceniew cenie, ale z podsumowań dla każdego URL źródło
✓W cenieW każdym planie, nie jako osobny produkt źródło
✓W cenieW cenie: logi Apache i Nginx, Cloudflare odczytywany bezpośrednio, tylko zweryfikowane boty
Staging i migracje
✓„Porównaj staging ze środowiskiem produkcyjnym za pomocą zaawansowanego URL Mapping” źródło
✓Crawl witryn staging z uwierzytelnianiem HTTP lub formularzem i zmienionymi ustawieniami robots, a potem porównanie audytów z „dowolnych dwóch Projects”. źródło
✓Tak, w Semrush Enterprise Site Intelligence źródło
◐„Crawluj witryny staging i z ograniczonym dostępem... źródło
✓„przecrawluj środowisko staging lub testowe i porównaj je z działającą witryną”, z Test Site Domain, własnym DNS, basic auth i nadpisaniem robots.txt. źródło
✓„Porównanie crawla witryny staging i działającej pomoże ci zbudować wersję bez błędów” źródło
✓Staging a produkcja i mapa przekierowań
Otwiera eksporty innych crawlerów
◐tryb listy czyta URL z dowolnego pliku .txt, .xls, .xlsx, .csv lub .xml („możesz bezpośrednio wgrać plik pobrany z Adwords”) źródło
✓Od $29 miesięcznieTylko w chmurze: Starter $29/mies., Lite $129, Standard $249, Advanced $449, Enterprise na zapytanie źródło
–Na zapytanieBrak publicznych cen: „Wyceniamy nasze rozwiązania według twoich indywidualnych potrzeb. źródło
✓Od $349 miesięcznieTylko w chmurze, miesięcznie przy rozliczeniu rocznym (in-house) źródło
✓Od $19 miesięczniePlan darmowy; plany płatne od $19 miesięcznie (cena w USA)
✓Tak◐Częściowo–Inne narzędzia: nie lub nie znaleziono w ich dokumentacji–Neova: jeszcze nieWkrótceNeova: już wkrótceKażda odpowiedź o innych narzędziach prowadzi do strony ich witryny lub dokumentacji, z której pochodzi.
Czego Neova nie robi
Brak własnej bazy słów kluczowych i backlinków: Ahrefs, Semrush, SE Ranking i Moz mają swoje, a Neova korzysta zamiast tego z twoich kluczy i twojej Search Console. Używaj jej razem z tymi pakietami, nie zamiast nich.
Już wkrótce: konta zespołowe i alerty e-mailem (dziś alerty przychodzą przez system, Neova Go, Slack i Microsoft Teams).
Jeszcze bez podobieństwa semantycznego.
Kolumny Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar i JetOctopus: tylko to, co podaje ich własna witryna i dokumentacja, sprawdzone 11 listopada 2026, z linkiem do każdej strony. „Nie znaleziono w ich dokumentacji” znaczy, że my tego nie znaleźliśmy, a nie że się tego nie da zrobić. Kolumna Neova: to, co dziś robią Neova i Neova Online, odczytane z aplikacji. 141 testów Neova nie ma na żadnej z opublikowanych list 10 narzędzi SEO, które porównaliśmy (Screaming Frog, Sitebulb, Semrush, Ahrefs, Lumar, Moz, SE Ranking, Seobility, Sitechecker i Conductor): każdą listę zestawiliśmy pozycja po pozycji z biblioteką Neova 25 października 2026. 67 testów dodanych od tego czasu nie jest liczonych, dopóki nie zostaną porównane. Te nazwy są znakami towarowymi ich właścicieli; Neova nie jest powiązana z żadnym z nich. Jeśli jakiś wiersz jest błędny lub nieaktualny, napisz na hello@neova.app, a poprawimy go.




 Google Search Console
 Google Analytics
 Chrome UX Report
 Google Cloud
 Gemini
 Bing Webmaster Tools
 OneDrive
 Microsoft Teams
 DataForSEO
 Semrush
 Ahrefs
 Majestic
 Moz
 SEO Gets
 Anthropic
 OpenAI
 Ollama
 Jira
 Linear
 Asana
 ClickUp
 monday.com
 Slack
 Cloudflare
 Dysk Google
 Dropbox
 iCloud Drive
 Proton Drive
 kDrive
 Screaming Frog
 Sitebulb
 Lumar
 JetOctopus