页面速度监控:看哪些指标、阈值与性能回退
网站很少一下子变慢。一条新的跟踪代码管理器规则、一张更大的首屏图片、一次插件更新:每一项都要多花几百毫秒,直到评级变红才有人注意到。页面速度监控是一种习惯:按计划用同样的方式测量同样的页面,事先定好阈值,让变慢在上线当周就被发现。
什么是页面速度监控
速度测试一次回答一个问题。页面速度监控按三条规则重复这项测试:同样的页面、同样的设置,以及为每个数字写下的阈值。没有前两条,每一处差异都可能来自测试本身,而不是网站。没有第三条,就没人知道何时该行动。
| 速度测试 | 监控 | |
|---|---|---|
| 页面 | 不限 | 固定列表 |
| 设置 | 默认 | 固定并写下来 |
| 运行次数 | 一次 | 按计划 |
| 结果 | 一个分数 | 一条趋势 |
| 操作 | 看一眼 | 达到阈值时警报 |
如果要一次性测试很多页面,批量页面速度测试指南是更好的起点。本指南讲的是之后的事。
值得关注的数字
把少数几个数字看好,而不是盯着报告里的每个数字。下面这些都有公开的阈值,来自 web.dev 和 TTFB 指南,均按实际用户数据的第 75 百分位计算:
| 数值 | 良好 | 较差 | 是否为 Core Web Vital |
|---|---|---|---|
| TTFB | 0.8 秒或以下 | 超过 1.8 秒 | – |
| FCP | 1.8 秒或以下 | 超过 3 秒 | – |
| LCP | 2.5 秒或以下 | 超过 4 秒 | ✓ |
| INP | 200 毫秒或以下 | 超过 500 毫秒 | ✓ |
| CLS | 0.1 或以下 | 超过 0.25 | ✓ |
TTFB 不是 Core Web Vitals 指标,但它的每一毫秒都会加到 FCP 和 LCP 上,因此它是服务器或缓存发生变化的最早预警。SEO ProCheck 的 TTFB 术语条目解释了它包含哪些部分。另外两个实验室数字值得加上:页面总大小和主线程时间,因为更重的脚本或图片一上线,它们就会变化。
实际用户数据与实验室:两种监控
速度可以在真实访问中测量,也可以在受控测试中测量。监控两者都需要,各司其职:
| 实测 | 实验室 | |
|---|---|---|
| 来源 | 真实 Chrome 用户 | 一次模拟加载 |
| 示例 | Chrome UX Report | Lighthouse |
| 延迟 | 最多 28 天 | 几分钟 |
| 能测量 INP | ✓ | – |
| 发布之前 | – | ✓ |
| 能解释原因 | ◐ | ✓ |
| Google 使用的数据 | ✓ | – |
实际用户数据告诉您访客是否受到影响;实验室数据告诉您原因,并能在变化影响访客之前发现它。Core Web Vitals 监控指南深入介绍了实际用户数据这一侧,Lighthouse 监控指南介绍了实验室这一侧。
多久检查一次
节奏要与每个数据来源的变化速度相匹配。每小时检查一次实际用户数据,看到的只是同一个 28 天平均值:
| 内容 | 频率 | 原因 |
|---|---|---|
| 关键模板的实验室测试 | 每次发布 | 最先发现性能回退 |
| 服务器响应,关键页面 | 每天 | 缓存和主机变化很快 |
| 实际用户 Core Web Vitals | 每周 | 28 天平均值 |
| 带速度检查的完整抓取 | 按月 | 发现新的慢页面 |
| Search Console 报告 | 按月 | Google 的分组视图 |
从同一地点、用同一设备配置、在服务器空闲的时段测试。在备份任务运行时做的测试,报告的就是备份。
阈值与性能预算
性能预算是团队在开工前约定的限制:每个模板一个数字,任何发布都不得超过。Google 的性能预算指南把它们分为时间限制、大小限制和基于规则的限制(例如 Lighthouse 得分)。一个商品模板的预算示例:
| 预算 | 限制 | 种类 |
|---|---|---|
| LCP,实验室,手机 | 2.5 s | 时间 |
| TTFB | 0.8 s | 时间 |
| JavaScript,压缩后 | 300 KB | 大小 |
| 首屏图片 | 200 KB | 大小 |
| 第三方请求 | 10 | 数量 |
| Lighthouse 性能 | 90 | 得分 |
这些数字只是示例;请以今天的数值为基础,留出一些余量来设定您自己的预算。分两步发警报:数字接近预算 10% 以内时发出警告,超过时判定失败。Lighthouse CI 可以在每个拉取请求上执行预算,让沉重的改动在合并前就失败。
在发布后发现性能回退
大多数变慢都随部署而来。把每次发布当作一次测试:
- 发布前:对每个改动过的模板的一个页面运行实验室测试,并保留结果。
- 发布后:用同样的设置运行同样的测试。比较多次运行的中位数,而不是拿一次运行对比一次运行。
- 检查服务器:关键页面的响应时间;部署后缓存未预热,可能在一小时内看起来像性能回退。
- 关注实际用户数据:每周读数大约一周后开始变化。
- 写下发布日期,与趋势放在一起,这样三周后的转折就能追溯原因。
| 发布之后 | 实验室 | 实测 |
|---|---|---|
| 1 小时 | ✓ | – |
| 1 天 | ✓ | – |
| 1 周 | ✓ | ◐ |
| 4 周 | ✓ | ✓ |
如果性能回退是真的,请在实际用户数据窗口被慢访问填满之前回滚或修复。SEO ProCheck 的服务器响应时间优化指南介绍了服务器端的修复方法。
整站速度:我们自己的数字
测试几个模板很快。要关注每个页面的速度,就需要一次抓取。我们在自己的网站上验证过:2026年10月17日 Neova 对 seoprocheck.com 的完整抓取在 61 分钟内获取了 10,222 个 URL,以礼貌的速度约每秒 2.8 个 URL。
| seoprocheck.com,2026年10月17日 | 值 |
|---|---|
| 已获取 URL | 10,222 |
| 返回 200 的 HTML 页面 | 4,561 |
| 抓取时间 | 61 分钟 |
| 页面正文(原始) | 1.66 GB |
这就是监控要分工的原因:每月或每周做一次完整抓取,找出网站任何地方的慢页面;每天检查一份关键页面的短名单。数千个页面的响应时间分布还能显示单次测试看不到的东西:一堆快栏目中的某个慢栏目。
用 Neova 做页面速度监控
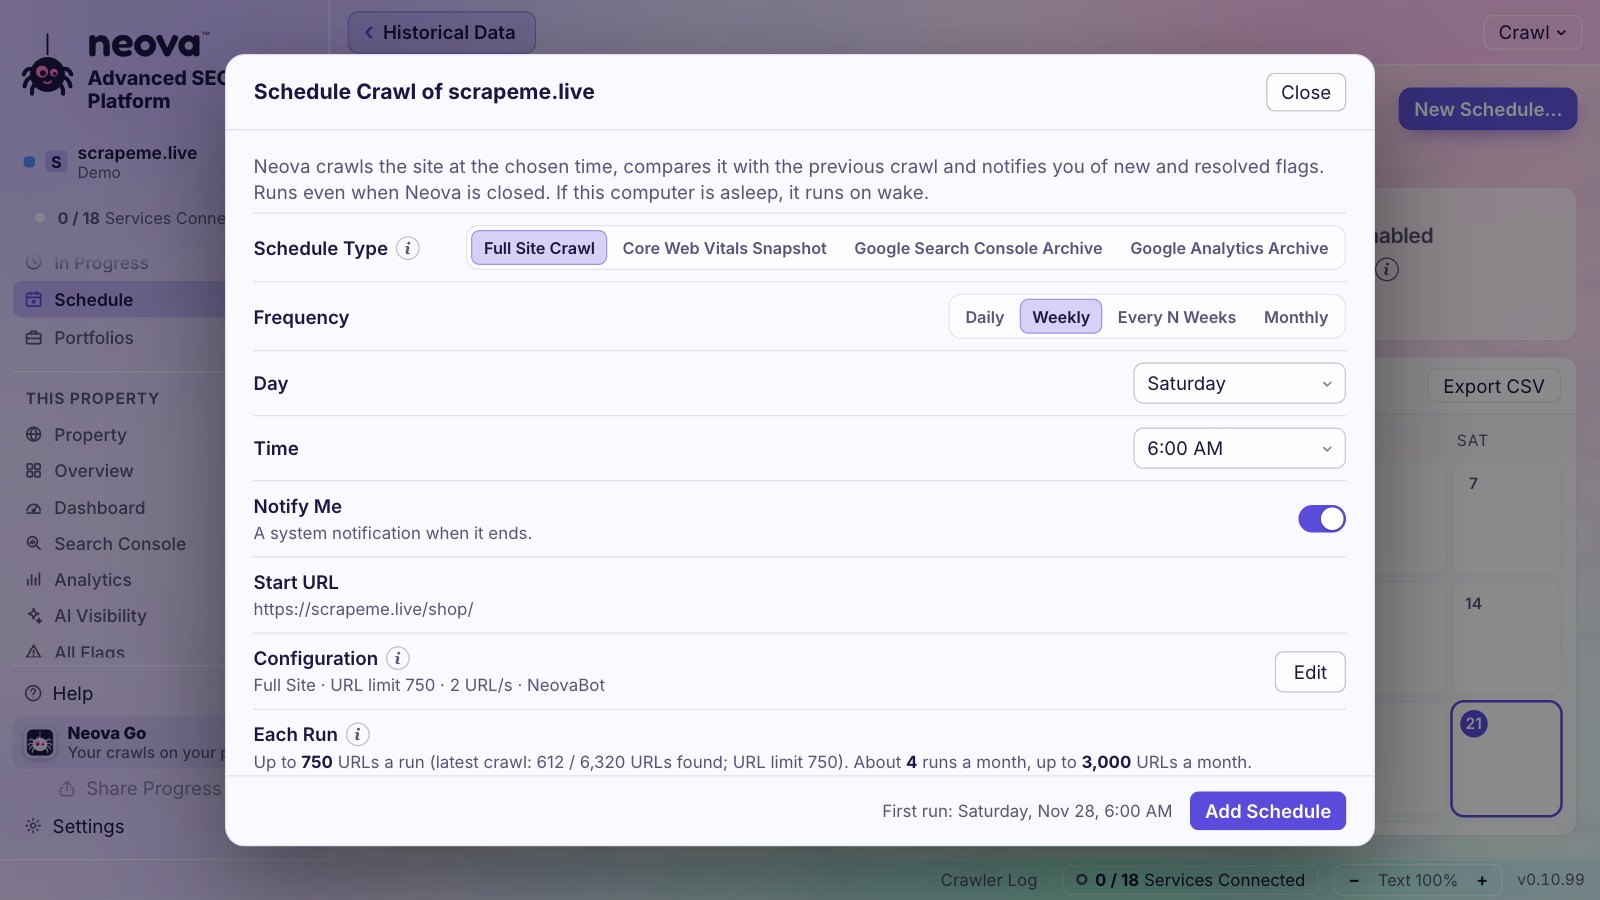
- 计划抓取按资源的设置每天、每周、每 N 周或每月运行整站抓取,关闭窗口也照常运行,并在您添加计划之前说明它的用量。
- 实时响应时间:抓取进行时显示响应时间的中位数、第 90 百分位和最慢值,并列出最慢的 10 个页面。
- 按页面组运行 Lighthouse 会在抓取期间对每个页面组的一个 HTML 页面运行 Lighthouse 实验室检查,在“新建抓取”中开启。
- Core Web Vitals 快照使用您自己的 Chrome UX Report 密钥按计划读取真实用户数据,默认每天一次,也可每周或每月一次,第一天就有 40 周的趋势。
- 警报规则会在 Core Web Vitals 评级变化,以及新抓取出现新标记时发出警报。
警报会以系统通知、手机上的 Neova Go 以及 Slack 或 Microsoft Teams 消息的形式送达。如果您在“设置 › 外观 › 宠物”中选了宠物,它会对抓取事件发出提醒,例如计划抓取开始,或抓取结束时报告其必须修复的检查项。
44 项性能检查中与速度相关的检查:
- 实验室数据或实际用户数据中的服务器响应时间较慢
- 服务器响应慢可能限制抓取速度
- 网络负载超过 Lighthouse 的通过界限
- 未启用文本压缩
- 静态资源没有缓存有效期或有效期不足 30 天
- 主线程工作超过 2 秒
- JavaScript 渲染超过 4 秒
帮助页面计划任务与监控介绍了设置方法。全部 694 项检查都可在免费套餐中运行,每次抓取最多 1,000 个 URL。
常见问题
什么是页面速度监控?
按计划用同样的设置测量同样的页面,把每个结果保存为趋势,并在某个数字越过您事先设定的阈值时采取行动。
应该监控哪些页面速度数字?
来自实际用户数据的 LCP、INP 和 CLS,用于了解 Google 使用的数据;TTFB 作为来自服务器的早期预警;以及实验室中的页面大小和主线程时间,在用户感受到之前发现更重的代码。
多久测试一次页面速度?
每次发布时对关键模板做实验室测试,每天检查关键页面的服务器响应,每周查看实际用户 Core Web Vitals,每月做一次带速度检查的完整抓取。
为什么什么都没改,我的速度分数却变了?
实验室测试会随网络、硬件、其他进程以及变化的广告或脚本而波动。从同一地点、用同一设备配置运行多次,并比较中位数。
什么是性能预算?
事先按模板约定、任何发布都不得超过的限制:时间(如 LCP 2.5 秒)、大小(如 300 KB 的 JavaScript)或得分。